
Photon ist einer von mehreren Kostentreibern bei Databricks, die Sie verstehen sollten, bevor Sie einen Workload optimieren.
Auf klassischen Clustern verbraucht Photon-aktiviertes Compute rund doppelt so viele Databricks Units (DBUs) wie vergleichbares Compute ohne Photon, wobei der genaue Multiplikator je nach Instanztyp variiert. Manche Workloads laufen schnell genug durch, um die höhere DBU-Rate auszugleichen. Andere werden schneller und kosten trotzdem mehr – die Laufzeit allein verrät also nicht, ob Photon Geld spart.
LakeSentry führt Photon in einer Community-Analyse zur Databricks-Preisgestaltung als einen der Kostentreiber hinter Preisüberraschungen an, die aus der Preisliste nicht offensichtlich hervorgehen. Der zusätzliche DBU-Verbrauch zahlt sich nur aus, wenn der Workload im Gegenzug genug Beschleunigung bekommt.
Dieser Leitfaden konzentriert sich auf Databricks Photon: wie es die Kosten beeinflusst, wo der Break-even-Punkt liegt und wie Sie feststellen, ob das Aktivieren einen Workload günstiger macht.
Das Wichtigste in Kürze
- Auf klassischen Clustern braucht Photon mehr als eine 2-fache Beschleunigung, um die höhere DBU-Rate auszugleichen.
- Scans, Aggregationen und Joins können diese Schwelle überschreiten, während Python-UDFs, kurze Jobs und Workloads mit breiten Shuffles oft darunter bleiben.
- Sie zahlen die Photon-Rate auch dann, wenn nur ein Teil des Workloads über Photon läuft.
- Prüfen Sie die Photon-Abdeckung im Bereich "Aggregated task time" des Query-Profils und vergleichen Sie anschließend die tatsächlichen DBU-Summen vor und nach dem Aktivieren von Photon.
Was ist Databricks Photon?
Databricks Photon ist eine Query-Engine, die die Performance für unterstützte Spark-Datenverarbeitung verbessert. Sie führt unterstützte Operationen in nativem C++ aus, während Sparks Catalyst-Optimizer weiterhin die Query-Planung übernimmt.
Ein wichtiger Unterschied liegt darin, wie Photon Daten verarbeitet. Statt Zeile für Zeile zu arbeiten, verarbeitet es Batches spaltenbasierter Daten über unterstützte Datentypen hinweg und nutzt Single-Instruction-Multiple-Data-(SIMD)-Instruktionen, um mehrere Werte mit einer einzigen CPU-Instruktion zu verarbeiten. Das reduziert den Overhead des JVM-Ausführungspfads und beschleunigt Operationen wie Scans, Filter, Aggregationen, Joins und Sortierungen – sofern Photon sie unterstützt.
Photon ersetzt Spark nicht, sondern fungiert als native Ausführungsschicht unterhalb desselben Spark-Programmiermodells. Ihre Spark- oder SQL-Queries durchlaufen weiterhin Catalyst für die Planung; unterstützte Teile des physischen Plans können dann in Photon laufen. Nicht unterstützte Operationen fallen auf die Standard-Spark-Runtime zurück.
Dieser letzte Punkt ist für die Kosten entscheidend. Photon zu aktivieren bedeutet nicht, dass jede Operation eines Jobs über Photon läuft. Der Operator-Mix bestimmt, wie viel des Workloads Photon nutzen kann – messen Sie das also, bevor Sie Performance oder Kosten beurteilen.
Der DBU-Multiplikator und die Break-even-Rechnung
Wenn Photon auf einem klassischen Cluster etwa 2× so viele DBUs verbraucht, muss ein Job mehr als 2× schneller laufen, bevor die höhere Compute-Rate zu einer Ersparnis wird. Diese Schwelle sollten Sie im Hinterkopf behalten, wenn Sie sich einen Photon-Benchmark ansehen.
Nehmen Sie einen Job, der normalerweise 60 Minuten läuft. Bei 1,5-facher Beschleunigung bringt Photon ihn auf 40 Minuten, doch durch die 2-fache DBU-Rate verbrauchen Sie trotzdem rund 33 % mehr DBUs. Steigern Sie die Beschleunigung auf 3×, ist der Job in 20 Minuten fertig und verbraucht etwa zwei Drittel der DBUs. Das ist eine Ersparnis von rund 33 %. Bei 2× heben sich kürzere Laufzeit und höhere DBU-Rate gegenseitig auf.
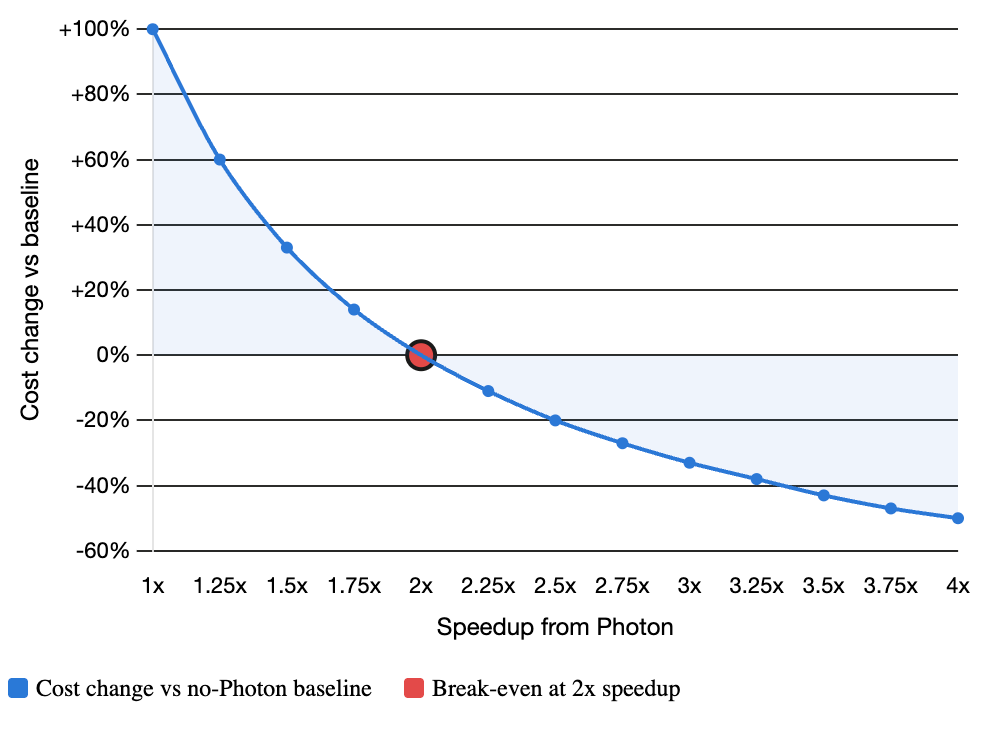
Wo Sie landen, hängt stark davon ab, was die Query tatsächlich tut. Ein scan-lastiger Job, der Parquet oder Delta mit selektiven Filtern liest, gibt Photon reichlich native Ausführungsarbeit. Dasselbe gilt für eine große Aggregation über eine Faktentabelle oder einen Hash-Join, bei dem eine Seite per Broadcast verteilt werden kann. Das sind die Workloads, bei denen veröffentlichte Benchmarks Beschleunigungen oberhalb des 2×-Break-even-Punkts gezeigt haben.
Das Bild ändert sich, wenn Photon den teuren Teil des Jobs gar nicht beschleunigen kann. Eine Python-UDF kann die Ausführung zurück durch JVM und Python schicken. Ein kurzer Job verbringt womöglich mehr Zeit mit Planung und Scheduling als mit der eigentlichen Ausführung. Ein breiter Shuffle kann seine Laufzeit damit verbringen, Daten durchs Netzwerk zu bewegen oder auf die Festplatte zu warten. Den CPU-Anteil schneller zu machen hilft wenig, wenn der Job nicht auf die CPU wartet.
Die folgende Tabelle setzt den 2×-Break-even-Punkt in Kontext und zeigt, welche Workload-Typen ihn voraussichtlich überschreiten und welche nicht.
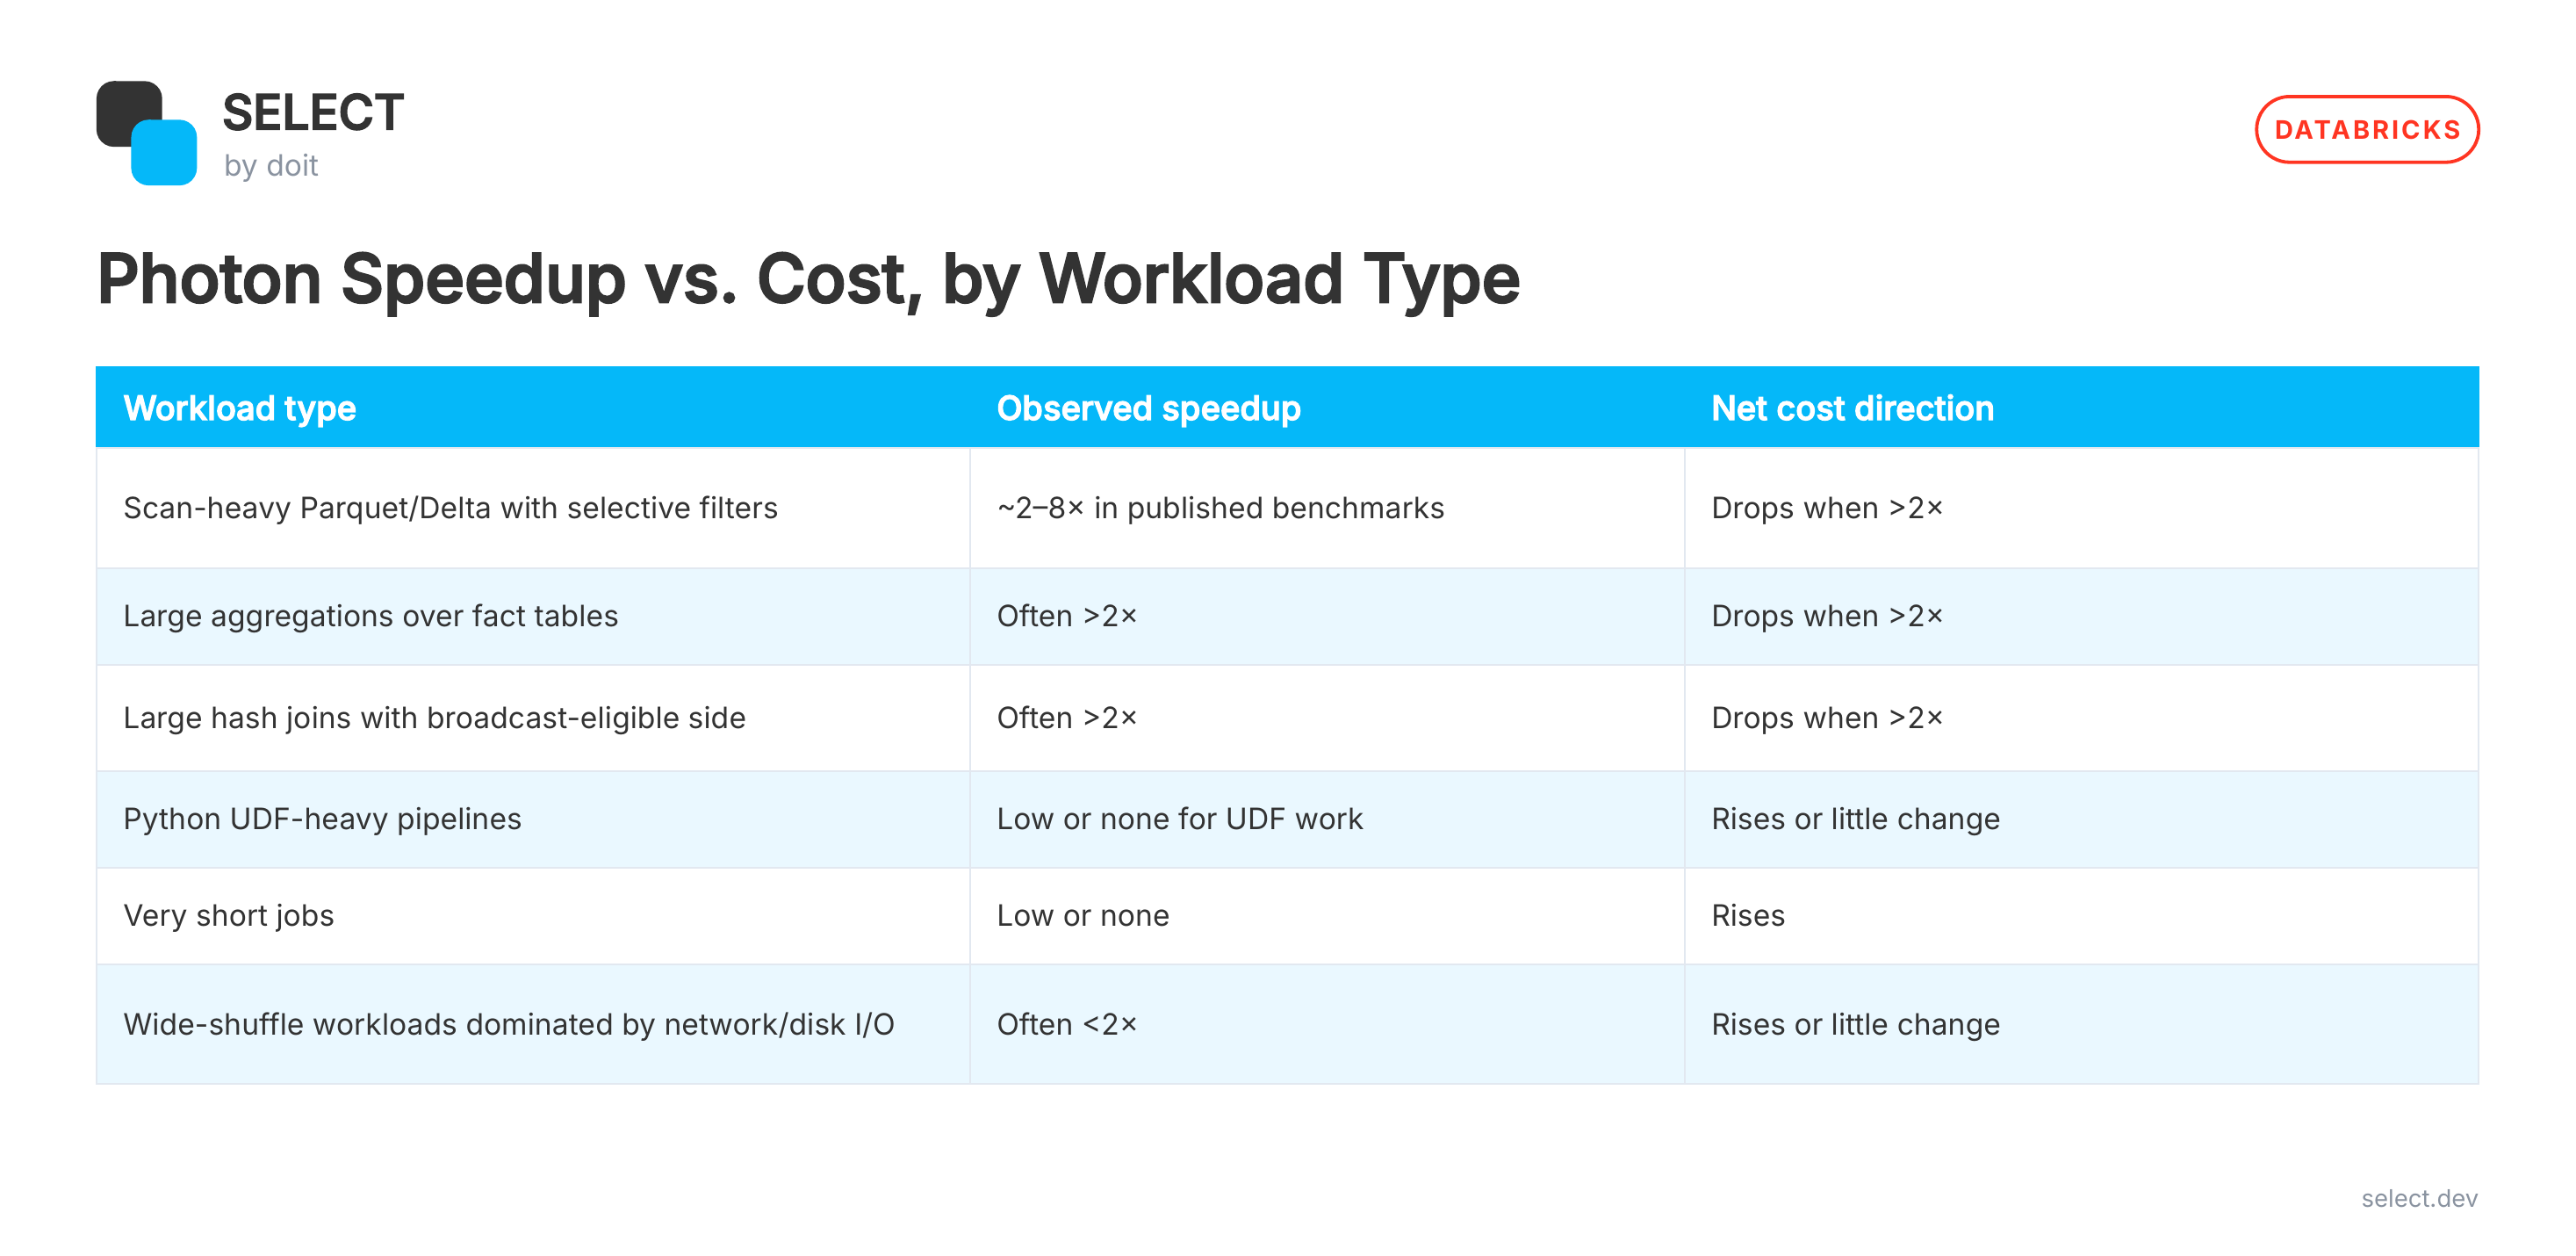
Die Kostenrichtung geht von einem rund 2-fachen Photon-DBU-Multiplikator auf vergleichbarem Classic-Cluster-Compute aus. Die tatsächlichen DBU-Raten variieren je nach Instanztyp – entscheidend ist daher die gemessene Beschleunigung.
Die 2×-Schwelle liefert Ihnen die Rechnung. Der Ausführungsplan verrät, ob Ihr Job eine realistische Chance hat, sie zu überschreiten.
Operator-Abdeckung: Was läuft nativ und was fällt zurück?Welche Operatoren führt Photon nativ aus, und welche fallen zurück?
Photon führt nicht jeden Spark-Operator aus. Manche Operatoren laufen nativ, andere fallen auf die JVM zurück. Sie zahlen trotzdem die Photon-aktivierte Compute-Rate, auch wenn der teure Teil des Workloads nicht nativ läuft.
Nehmen Sie eine Query, die eine große Delta-Lake-Tabelle liest, die meisten Zeilen herausfiltert, den Rest aggregiert und das Ergebnis per Join mit einer anderen Tabelle verknüpft. Das sind genau die Operationen, bei denen Photon echte CPU-Arbeit optimieren kann. Fügen Sie nun mittendrin eine Python-UDF ein. Dieser Teil nimmt einen anderen Ausführungspfad – und wenn der Job die meiste Zeit in der UDF verbringt, kommt Photon am Flaschenhals gar nicht an. Ein Photon-aktivierter Cluster bedeutet nicht, dass die gesamte Query in Photon läuft. Der physische Plan entscheidet, welche Teile es tatsächlich tun.
Für gängige Daten-Workloads kann Photon Parquet- und Delta-Scans, Filter, Projektionen, Aggregationen und Hash-Joins nativ ausführen. Window-Funktionen und Sortierungen werden ebenfalls unterstützt, genauso wie gängige String-Operationen. Python- und Scala-UDFs fallen zurück, während einige Regex-, MAP``/``STRUCT-, Streaming-Sink- und CSV/JSON-Operationen von der konkreten Operation und der Databricks-Runtime-Version abhängen. Ersetzen Sie wo möglich eine UDF durch eine eingebaute Spark-SQL-Funktion, um mehr Arbeit auf dem nativen Pfad zu halten. Wenn die Scan-Zeit den Job dominiert, beeinflusst das Layout Ihrer Tabellen, was Photon scannen muss. Liquid Clustering ist für diesen Teil des Problems einen Blick wert.
Die folgende Tabelle zeigt, welche Workloads Photon nativ ausführen kann und wo es zurückfällt:
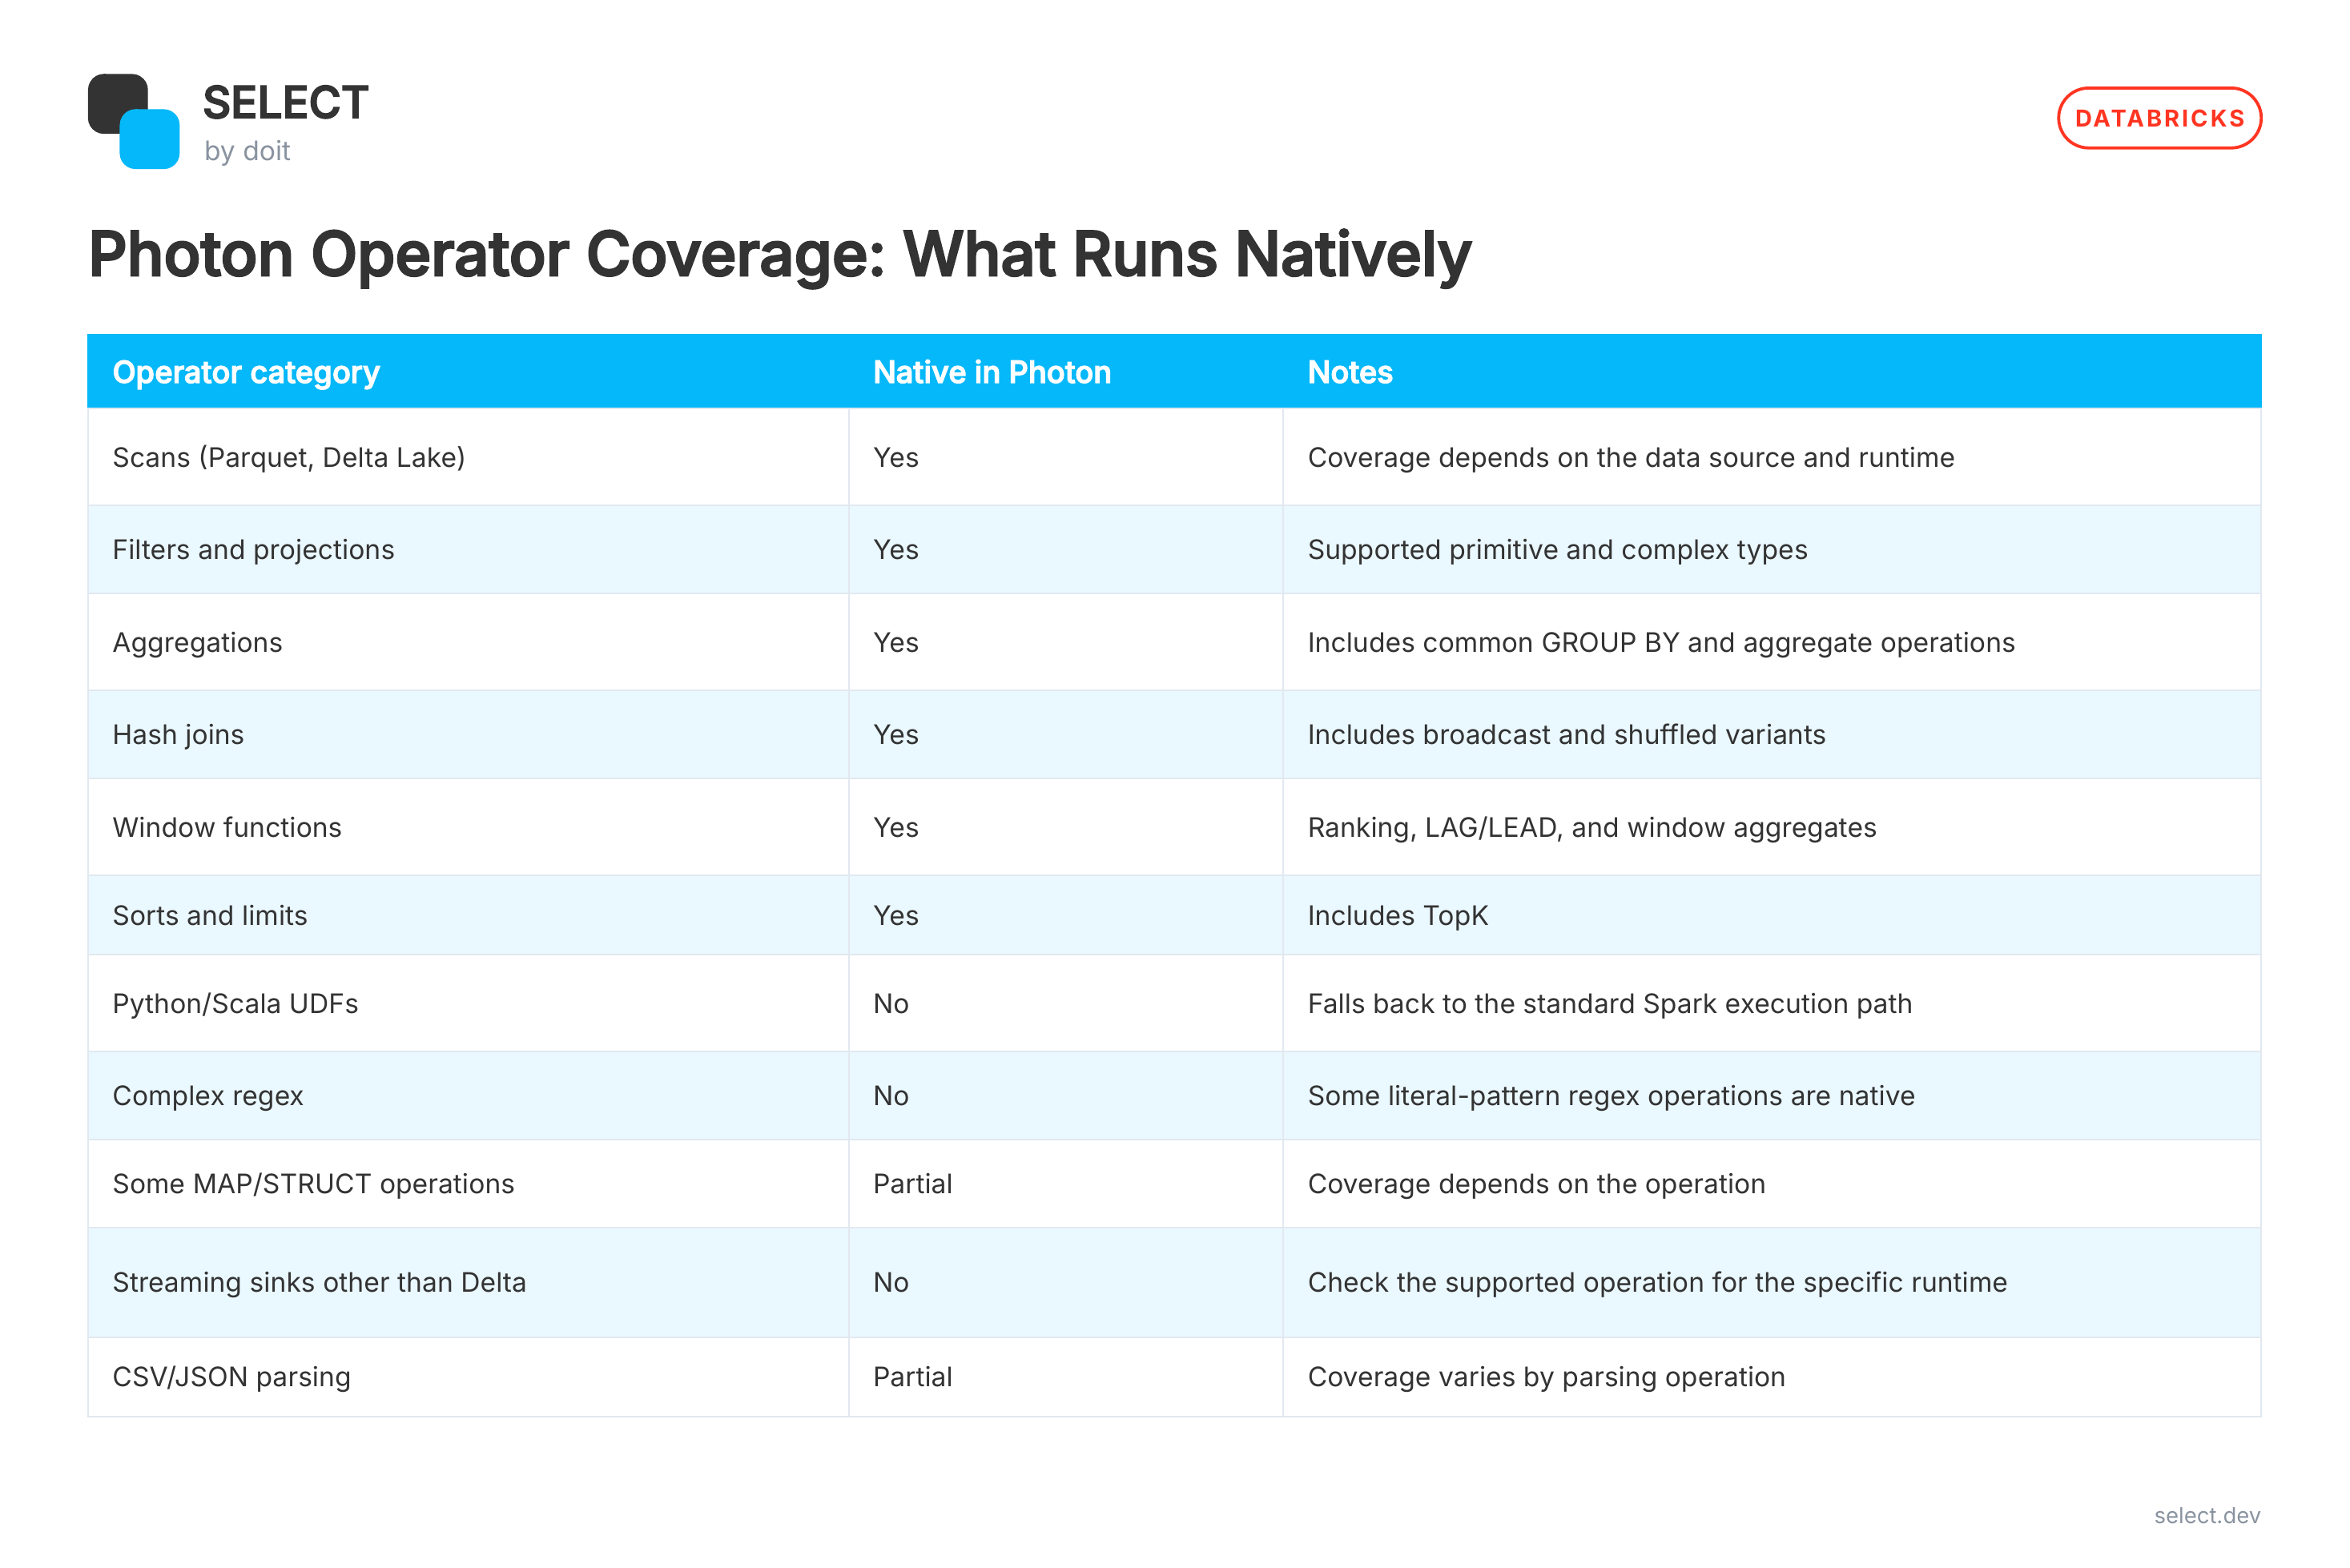
Das Query-Profil und der physische Plan zeigen, was in Ihrem eigenen Job passiert ist. Finden Sie die Operatoren, die die meiste Laufzeit verbrauchen, und prüfen Sie dann, ob sie über Photon liefen oder zurückgefallen sind. Das ist der Nachweis, den Sie brauchen, um zu beurteilen, ob Photon wirklich geholfen hat.
Wie sich Photon auf verschiedenen Compute-Ebenen verhält
Wo Sie den Workload ausführen, beeinflusst, wie Photon konfiguriert ist und wie abgerechnet wird. Das ist relevant, wenn derselbe Job zwischen klassischem Cluster, SQL Warehouse und Serverless wechselt und die Zahlen plötzlich nicht mehr zusammenpassen.
Bei Databricks-SQL-Warehouses ist Photon auf der Classic-Stufe standardmäßig aktiviert. Die Stufen Pro und Serverless laufen ausschließlich mit Photon. Wenn Sie SQL-Analytics betreiben, lohnt sich die Frage, ob Photon aktiviert ist, also kaum. Die bessere Frage ist, was das Query-Profil sagt und ob die Arbeit, die Photon tatsächlich leistet, das Compute rechtfertigt.
So aktivieren Sie Photon auf klassischen Clustern
Auf klassischen Clustern ist Photon für All-Purpose- und Jobs-Compute standardmäßig aktiviert; die Einstellung "Use Photon Acceleration" schaltet es ab. Wenn Sie Compute über die API erstellen, können Sie runtime_engine: "PHOTON" explizit setzen. Der Instanztyp muss Photon trotzdem unterstützen.
Der 2×-DBU-Vergleich von vorhin ist auf klassischen Clustern besonders nützlich. Wenn Sie verstehen wollen, was Photon mit einem wiederkehrenden ETL-Job macht, führen Sie denselben Workload auf demselben Instanztyp einmal mit und einmal ohne Photon aus. Betrachten Sie sowohl Laufzeit als auch DBUs. Ein schnellerer Job ist nur dann interessant, wenn er schnell genug wird, um die höhere Rate wettzumachen.
Photon auf Serverless Compute
Auf Serverless Compute ist Photon standardmäßig aktiviert, aber Sie verwalten keinen Cluster, wählen keine VM-Familie und schalten die Runtime nicht um. Databricks übernimmt diese Ebene für Sie. Der Haken: Serverless nutzt ein anderes Preismodell, sodass sich die 2×-Rechnung vom klassischen Cluster nicht direkt übertragen lässt. Lakebase läuft auf demselben Serverless-Modell – gut zu wissen, wenn Sie es neben Photon-Workloads auf klassischen Clustern kalkulieren; die Preisstrukturen sind nicht dieselben.
Der Preisunterschied ist relevant, wenn Workloads zwischen Compute-Ebenen wechseln. Die Engine kann gleich bleiben, während sich die Wirtschaftlichkeit darunter ändert. Wenn ein Job auf einem Photon-aktivierten klassischen Cluster günstig ist, heißt das nicht, dass er auf Serverless dasselbe Kostenprofil hat. Die Compute-Ebene ist Teil der Rechnung. Wenn Sie diese Rechnung über Ihre gesamte Databricks-Umgebung hinweg durchgehen, deckt Databricks Cost Optimization die übrigen Stellhebel ab – von Auto-Termination und Compute-Dimensionierung bis zu Tabellen-Layout und Governance.
Das Query-Profil lesen und die Photon-Abdeckung messen
Wenn Sie wissen wollen, ob Photon die Performance wirklich verbessert hat, beginnen Sie beim Query-Profil, nicht bei der verstrichenen Zeit. Das Profil zeigt, wo der Workload seine Zeit verbracht hat und welche Teile des Plans die Engine genutzt haben.
Ein Workload kann früher fertig sein und trotzdem wenig über die Wirtschaftlichkeit verraten. Wenn der Großteil der Task-Zeit in Photon-native Scans, Joins oder Aggregationen floss, hat die Beschleunigung eine klare Erklärung. Sind die teuren Operatoren auf den Standard-Ausführungspfad zurückgefallen oder ging die meiste Zeit in Shuffle und I/O, trägt die Engine für den entscheidenden Teil wenig bei.
So sieht das im Query-Profil aus:
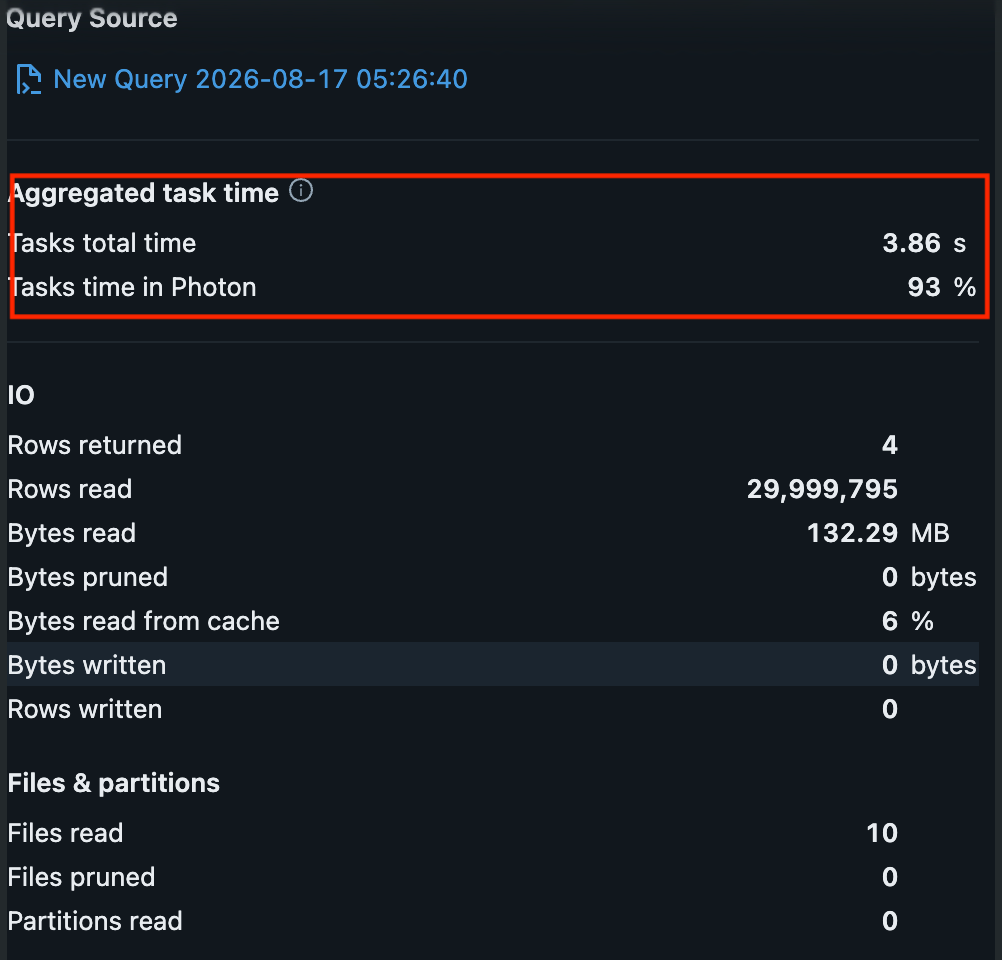
In diesem Beispiel liefen 93 % der Task-Zeit über Photon. Die Query las 29.999.795 Zeilen aus 10 Dateien, bei insgesamt 3,86 Sekunden Task-Zeit. Das ist ein starkes Signal, dass Photon den Großteil der Task-Ausführung übernommen hat.
Die entscheidende Zahl ist nicht nur der Prozentsatz. Schauen Sie sich daneben an, was die Query tatsächlich getan hat. Die 93 % sind ein klarer Erfolg, weil die teuren Operatoren – der Scan und die Aggregation – beide nativ liefen. So eindeutig sieht es nicht immer aus. Angenommen, eine andere Query verbringt 70 % ihrer Zeit in einer Python-UDF oder wartet auf einen breiten Shuffle. Photon dort einzuschalten ändert am eigentlichen Flaschenhals nichts, egal wie die Laufzeit hinterher aussieht. Der Prozentsatz sagt erst dann etwas aus, wenn Sie wissen, was er misst.
Hier zahlt sich auch die Operator-Abdeckung aus dem letzten Abschnitt aus: Es geht nicht darum zu zählen, wie viele Operatoren Photon nutzen, sondern herauszufinden, wohin die Task-Zeit tatsächlich geflossen ist.
So erklären Sie auch überraschende Ergebnisse im Nachhinein. Ein Job kann eine spürbare Laufzeitverbesserung zeigen, obwohl der Großteil der teuren Arbeit außerhalb von Photon liegt. Ein anderer erzielt einen größeren Zugewinn, weil seine größten Operatoren nativ laufen. Dieselbe Laufzeitmetrik, unterschiedliche Gründe darunter – und das Profil verrät Ihnen, welchen Fall Sie vor sich haben.
Für wiederkehrende ETL- und SQL-Workloads ist das der Check, bevor Sie entscheiden, ob Photon seine DBUs wert ist: die teuren Operatoren finden, prüfen, welchen Pfad sie genommen haben, und das Ganze mit Laufzeit und Kosten verknüpfen.
Photon-Kosten mit SELECT messen
Ein schnellerer Photon-Workload ist nicht automatisch ein günstigerer. Sie müssen die Laufzeitverbesserung mit den DBUs und Infrastrukturkosten verknüpfen, bevor Sie von einem Erfolg sprechen können.
Mit SELECT führen Sie Databricks-Ausgaben auf Jobs, Cluster und Warehouses zurück – mit DBU-Verbrauch und zugrunde liegenden Infrastrukturkosten in derselben Ansicht. Vergleichen Sie für einen wiederkehrenden ETL-Job äquivalente Läufe vor und nach der Photon-Änderung. Betrachten Sie Performance, DBUs und Gesamtkosten zusammen. Wird der Job zwar schneller fertig, treibt die höhere Photon-Rate die Kosten aber nach oben, hat sich die Beschleunigung nicht bezahlt gemacht. Dieselbe Zuordnung deckt auch die Kosten für AI Model Serving in Agent Bricks ab, falls Photon nur ein Teil eines größeren Workloads ist.
Die 2-fache DBU-Rate von vorhin liefert den Richtwert. Ein Workload auf einem klassischen Cluster braucht rund eine 2-fache Beschleunigung für den Break-even. SELECT liefert Ihnen Nutzungs- und Kostendaten auf Job-Ebene, damit Sie sehen, wo Ihr Workload tatsächlich landet, statt allein anhand der Laufzeit zu schätzen.
Das Query-Profil zeigt, wo die Engine geholfen hat. SELECT zeigt die DBUs und Infrastrukturkosten hinter dieser Verbesserung. Zusammen zeigen sie, ob ein wiederkehrender ETL- oder SQL-Workload günstiger wird, während er schneller wird. Buchen Sie eine Demo und führen Sie diesen Vergleich mit Ihren eigenen Photon-aktivierten Jobs durch.
Häufig gestellte Fragen
Funktioniert Photon mit meinem bestehenden Spark-Code?
Ja. Photon läuft unterhalb desselben Spark-Programmiermodells, Sie müssen Ihre Spark-Jobs also nicht umschreiben. Ihre bestehenden DataFrame- und SQL-Workloads können Photon nutzen, wenn ihr physischer Plan auf unterstützte native Operatoren abgebildet werden kann. Prüfen sollten Sie vor allem die Operator-Abdeckung – besonders, wenn Ihre Pipeline stark auf UDFs oder andere Operationen setzt, die auf den Standard-Spark-Ausführungspfad zurückfallen.
Warum werden meine Python-UDFs mit aktiviertem Photon nicht schneller?
Weil Photon beliebige Python-UDFs nicht nativ ausführt, läuft die UDF über den Standard-Ausführungspfad von Spark und Python – Photon kann den Python-Code selbst also nicht optimieren. Ist die UDF Ihr Flaschenhals, ändert das Aktivieren von Photon wenig. Ersetzen Sie die UDF wo möglich durch eine eingebaute SQL-Funktion. Ist eine Python-UDF unvermeidbar, kann eine pandas_udf etwas Python/JVM-Overhead reduzieren, macht die UDF aber nicht Photon-nativ.
Wie prüfe ich, welcher Anteil meiner Query auf Photon lief?
Öffnen Sie das Query-Profil der abgeschlossenen Query und gehen Sie zu Aggregated task time → Tasks time in Photon. Dieser Prozentsatz zeigt, wie viel Task-Zeit über Photon lief. Prüfen Sie anschließend die Operator-Aufschlüsselung, um zu sehen, wohin die restliche Zeit geflossen ist. Der Prozentsatz allein reicht nicht – Sie müssen auch wissen, ob Photon den teuren Teil des Workloads übernommen hat.
Kostet Photon mehr als die Standard-Databricks-Runtime?
Auf klassischen Clustern ja. Photon-aktiviertes Compute hat eine höhere DBU-Rate als vergleichbares Compute ohne Photon. Der genaue Multiplikator hängt vom Instanztyp ab, aber rund 2× ist die nützliche Zahl für die Kostenrechnung. Das heißt, der Workload braucht rund eine 2-fache Beschleunigung für den Break-even.
Unterstützt Photon GPU-Beschleunigung?
Nein. Photon ist eine CPU-basierte native Ausführungs-Engine, keine GPU-Engine. Sie beschleunigt unterstützte Spark-Operationen durch native CPU-Ausführung. Wenn Ihr Workload GPU-Compute für Machine Learning oder einen anderen GPU-spezifischen Workload benötigt, ersetzt Photon kein GPU-fähiges Compute.