
Photon è uno dei diversi fattori di costo di Databricks che vale la pena comprendere prima di ottimizzare un workload.
Sui cluster classici, il compute con Photon abilitato consuma le Databricks Unit (DBU) a un ritmo circa doppio rispetto al compute equivalente senza Photon, anche se il moltiplicatore esatto varia in base al tipo di istanza. Alcuni workloads terminano abbastanza in fretta da compensare la tariffa DBU più alta. Altri diventano più veloci ma continuano a costare di più, quindi il solo tempo di esecuzione non basta a capire se Photon sta facendo risparmiare.
LakeSentry, in un'analisi del pricing di Databricks segnalata dalla community, indica Photon come uno dei fattori di costo alla base delle sorprese di prezzo che il listino non rende evidenti. Il consumo extra di DBU ripaga solo quando il workload ottiene in cambio uno speedup sufficiente.
Questa guida si concentra su Databricks Photon: come incide sui costi, dove si colloca il punto di pareggio e come capire se abilitarlo rende un workload più economico.
TL;DR
- Sui cluster classici, Photon ha bisogno di uno speedup superiore a 2× per compensare la tariffa DBU più alta.
- Scansioni, aggregazioni e join possono superare quella soglia, mentre le UDF Python, i job brevi e i workloads con shuffle estesi spesso restano al di sotto.
- La tariffa Photon si paga anche quando solo una parte del workload passa effettivamente da Photon.
- Verifichi la copertura di Photon nel pannello Aggregated task time del query profile, poi confronti i totali effettivi di DBU prima e dopo l'abilitazione di Photon.
Che cos'è Databricks Photon?
Databricks Photon è un motore di query che migliora le prestazioni delle elaborazioni dati Spark supportate. Esegue le operazioni supportate in C++ nativo, mentre l'ottimizzatore Catalyst di Spark continua a occuparsi della pianificazione delle query.
Una differenza importante da notare è il modo in cui Photon elabora i dati. Invece di eseguire una riga alla volta, lavora su batch di dati colonnari per i tipi di dato supportati e usa istruzioni Single Instruction Multiple Data (SIMD) per elaborare più valori con una singola istruzione CPU. Questo riduce l'overhead del percorso di esecuzione nella JVM e accelera operazioni come scansioni, filtri, aggregazioni, join e ordinamenti, quando Photon le supporta.
Photon non sostituisce Spark: agisce come livello di esecuzione nativo sotto lo stesso modello di programmazione Spark. Le query Spark o SQL passano comunque da Catalyst per la pianificazione, dopodiché le parti supportate del piano fisico possono girare in Photon. Le operazioni non supportate ricadono sul runtime Spark standard.
Quest'ultimo punto è importante per i costi. Abilitare Photon non significa che ogni operazione di un job passi da Photon. Il mix di operatori determina quanta parte del workload può usare Photon, quindi va misurato prima di giudicare prestazioni o costi.
Il moltiplicatore DBU e il calcolo del break-even
Se Photon consuma circa 2× i DBU su un cluster classico, un job deve girare oltre 2× più velocemente perché la tariffa di compute più alta si traduca in un risparmio. È questa la soglia da tenere a mente quando si guarda un benchmark di Photon.
Prendiamo un job che normalmente dura 60 minuti. Con uno speedup di 1,5×, Photon lo porta a 40 minuti, ma la tariffa DBU 2× significa che si consumano comunque circa il 33% di DBU in più. Portando lo speedup a 3×, il job termina in 20 minuti consumando circa due terzi dei DBU: un risparmio di circa il 33%. A 2×, il tempo di esecuzione più breve e la tariffa DBU più alta si annullano a vicenda.
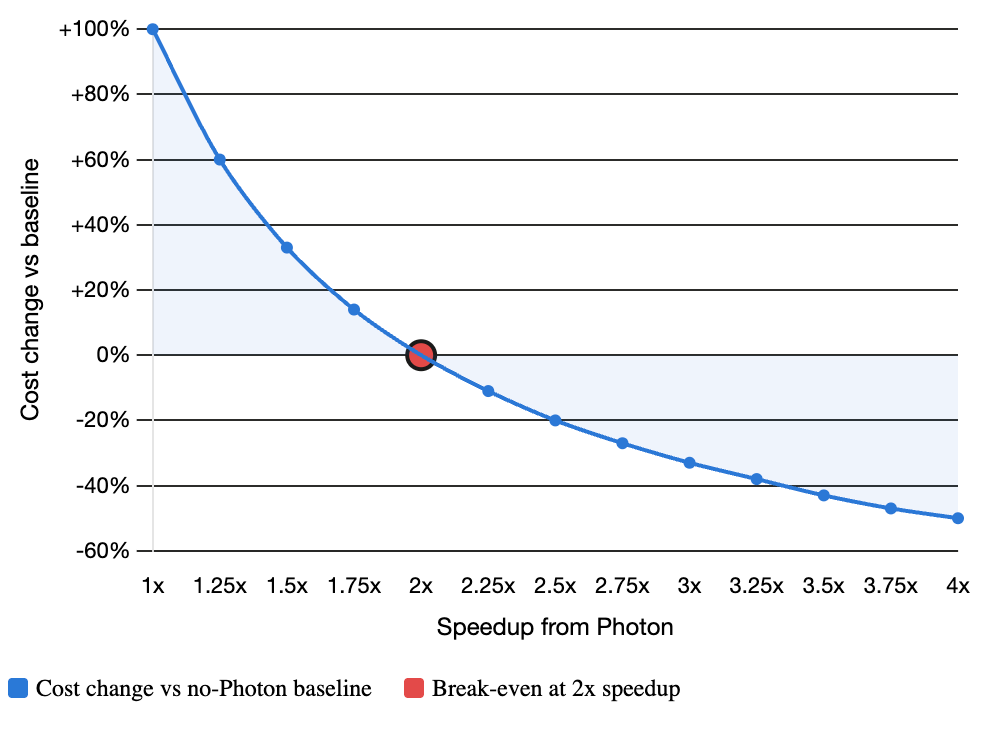
Il risultato dipende molto da ciò che la query sta effettivamente facendo. Un job dominato dalle scansioni che legge Parquet o Delta con filtri selettivi offre a Photon parecchio lavoro di esecuzione nativa. Lo stesso vale per una grande aggregazione su una fact table o per un hash join in cui un lato può essere trasmesso in broadcast. Sono questi i workloads per cui i benchmark pubblicati hanno mostrato speedup superiori al punto di pareggio di 2×.
Il quadro cambia quando la parte costosa del job non è qualcosa che Photon può accelerare. Una UDF Python può riportare l'esecuzione sulla JVM e su Python. Un job breve può passare più tempo in pianificazione e scheduling che in esecuzione vera e propria. Uno shuffle esteso può passare il suo wall time a spostare dati sulla rete o in attesa del disco. Rendere più veloce la parte CPU serve a poco quando non è la CPU che il job sta aspettando.
La tabella qui sotto mette in contesto il punto di pareggio di 2×, mostrando quali tipologie di workload hanno buone probabilità di superarlo e quali no.
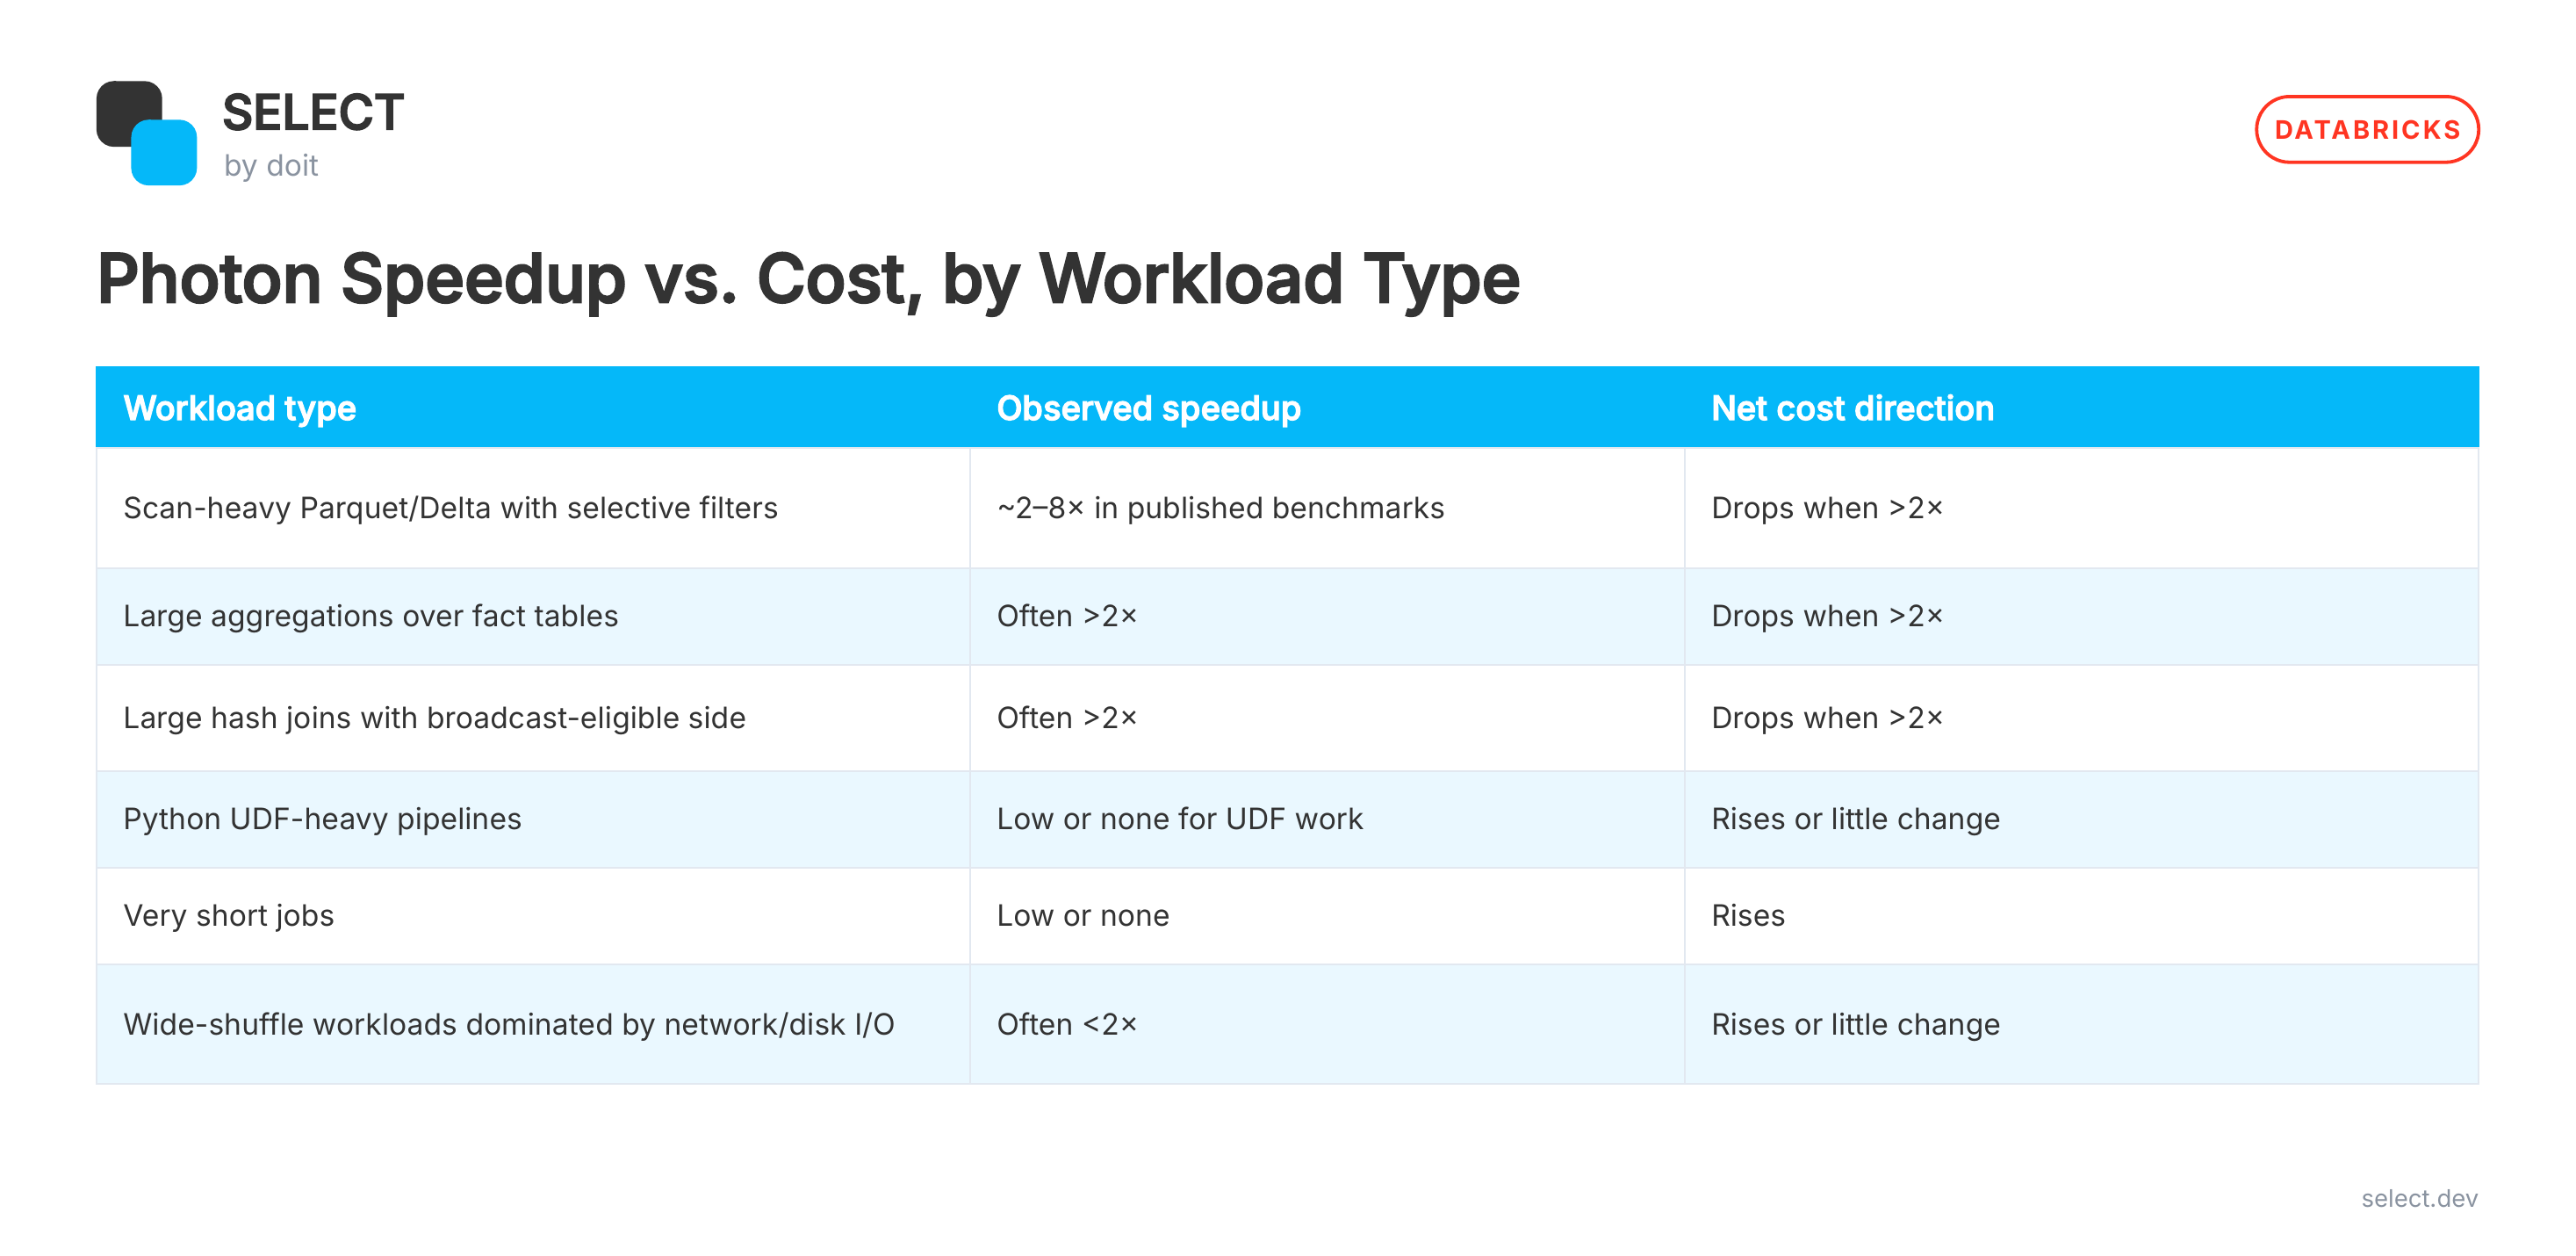
La direzione del costo presuppone un moltiplicatore DBU di Photon di circa 2× rispetto al compute equivalente su cluster classico. Le tariffe DBU effettive variano in base al tipo di istanza, quindi è lo speedup misurato a determinare il risultato.
La soglia di 2× dà i numeri. Il piano di esecuzione dice se il job ha una possibilità realistica di superarla.
Copertura degli operatori: cosa gira in modo nativo e cosa fa fallbackQuali operatori Photon esegue in modo nativo e quali fanno fallback?
Photon non esegue tutti gli operatori Spark. Alcuni girano in modo nativo, altri ricadono sulla JVM. La tariffa del compute con Photon abilitato si paga comunque, anche quando la parte costosa del workload non gira in modo nativo.
Prendiamo una query che legge una grande tabella Delta Lake, filtra via la maggior parte delle righe, aggrega ciò che resta e fa join del risultato con un'altra tabella. Sono il tipo di operazioni in cui Photon ha un vero lavoro CPU da ottimizzare. Ora inseriamo nel mezzo una UDF Python. Quel pezzo prende un percorso di esecuzione diverso, e se è nella UDF che il job passa la maggior parte del tempo, Photon non tocca il collo di bottiglia. Un cluster con Photon abilitato non significa che l'intera query giri in Photon. È il piano fisico a decidere quali parti lo fanno davvero.
Per i workloads dati più comuni, Photon può eseguire in modo nativo scansioni Parquet e Delta, filtri, proiezioni, aggregazioni e hash join. Sono supportati anche le window function e gli ordinamenti, insieme alle operazioni comuni sulle stringhe. Le UDF Python e Scala fanno fallback, mentre alcune operazioni su regex, MAP``/``STRUCT, streaming sink e CSV/JSON dipendono dall'operazione specifica e dalla versione del Databricks Runtime. Dove possibile, conviene sostituire una UDF con una funzione Spark SQL integrata per mantenere più lavoro sul percorso nativo. Se il tempo di scansione domina il job, il layout delle tabelle influisce su ciò che Photon deve scansionare. Il Liquid Clustering merita uno sguardo per quel lato del problema.
La tabella qui sotto mostra i workloads che Photon può eseguire in modo nativo e dove fa fallback:
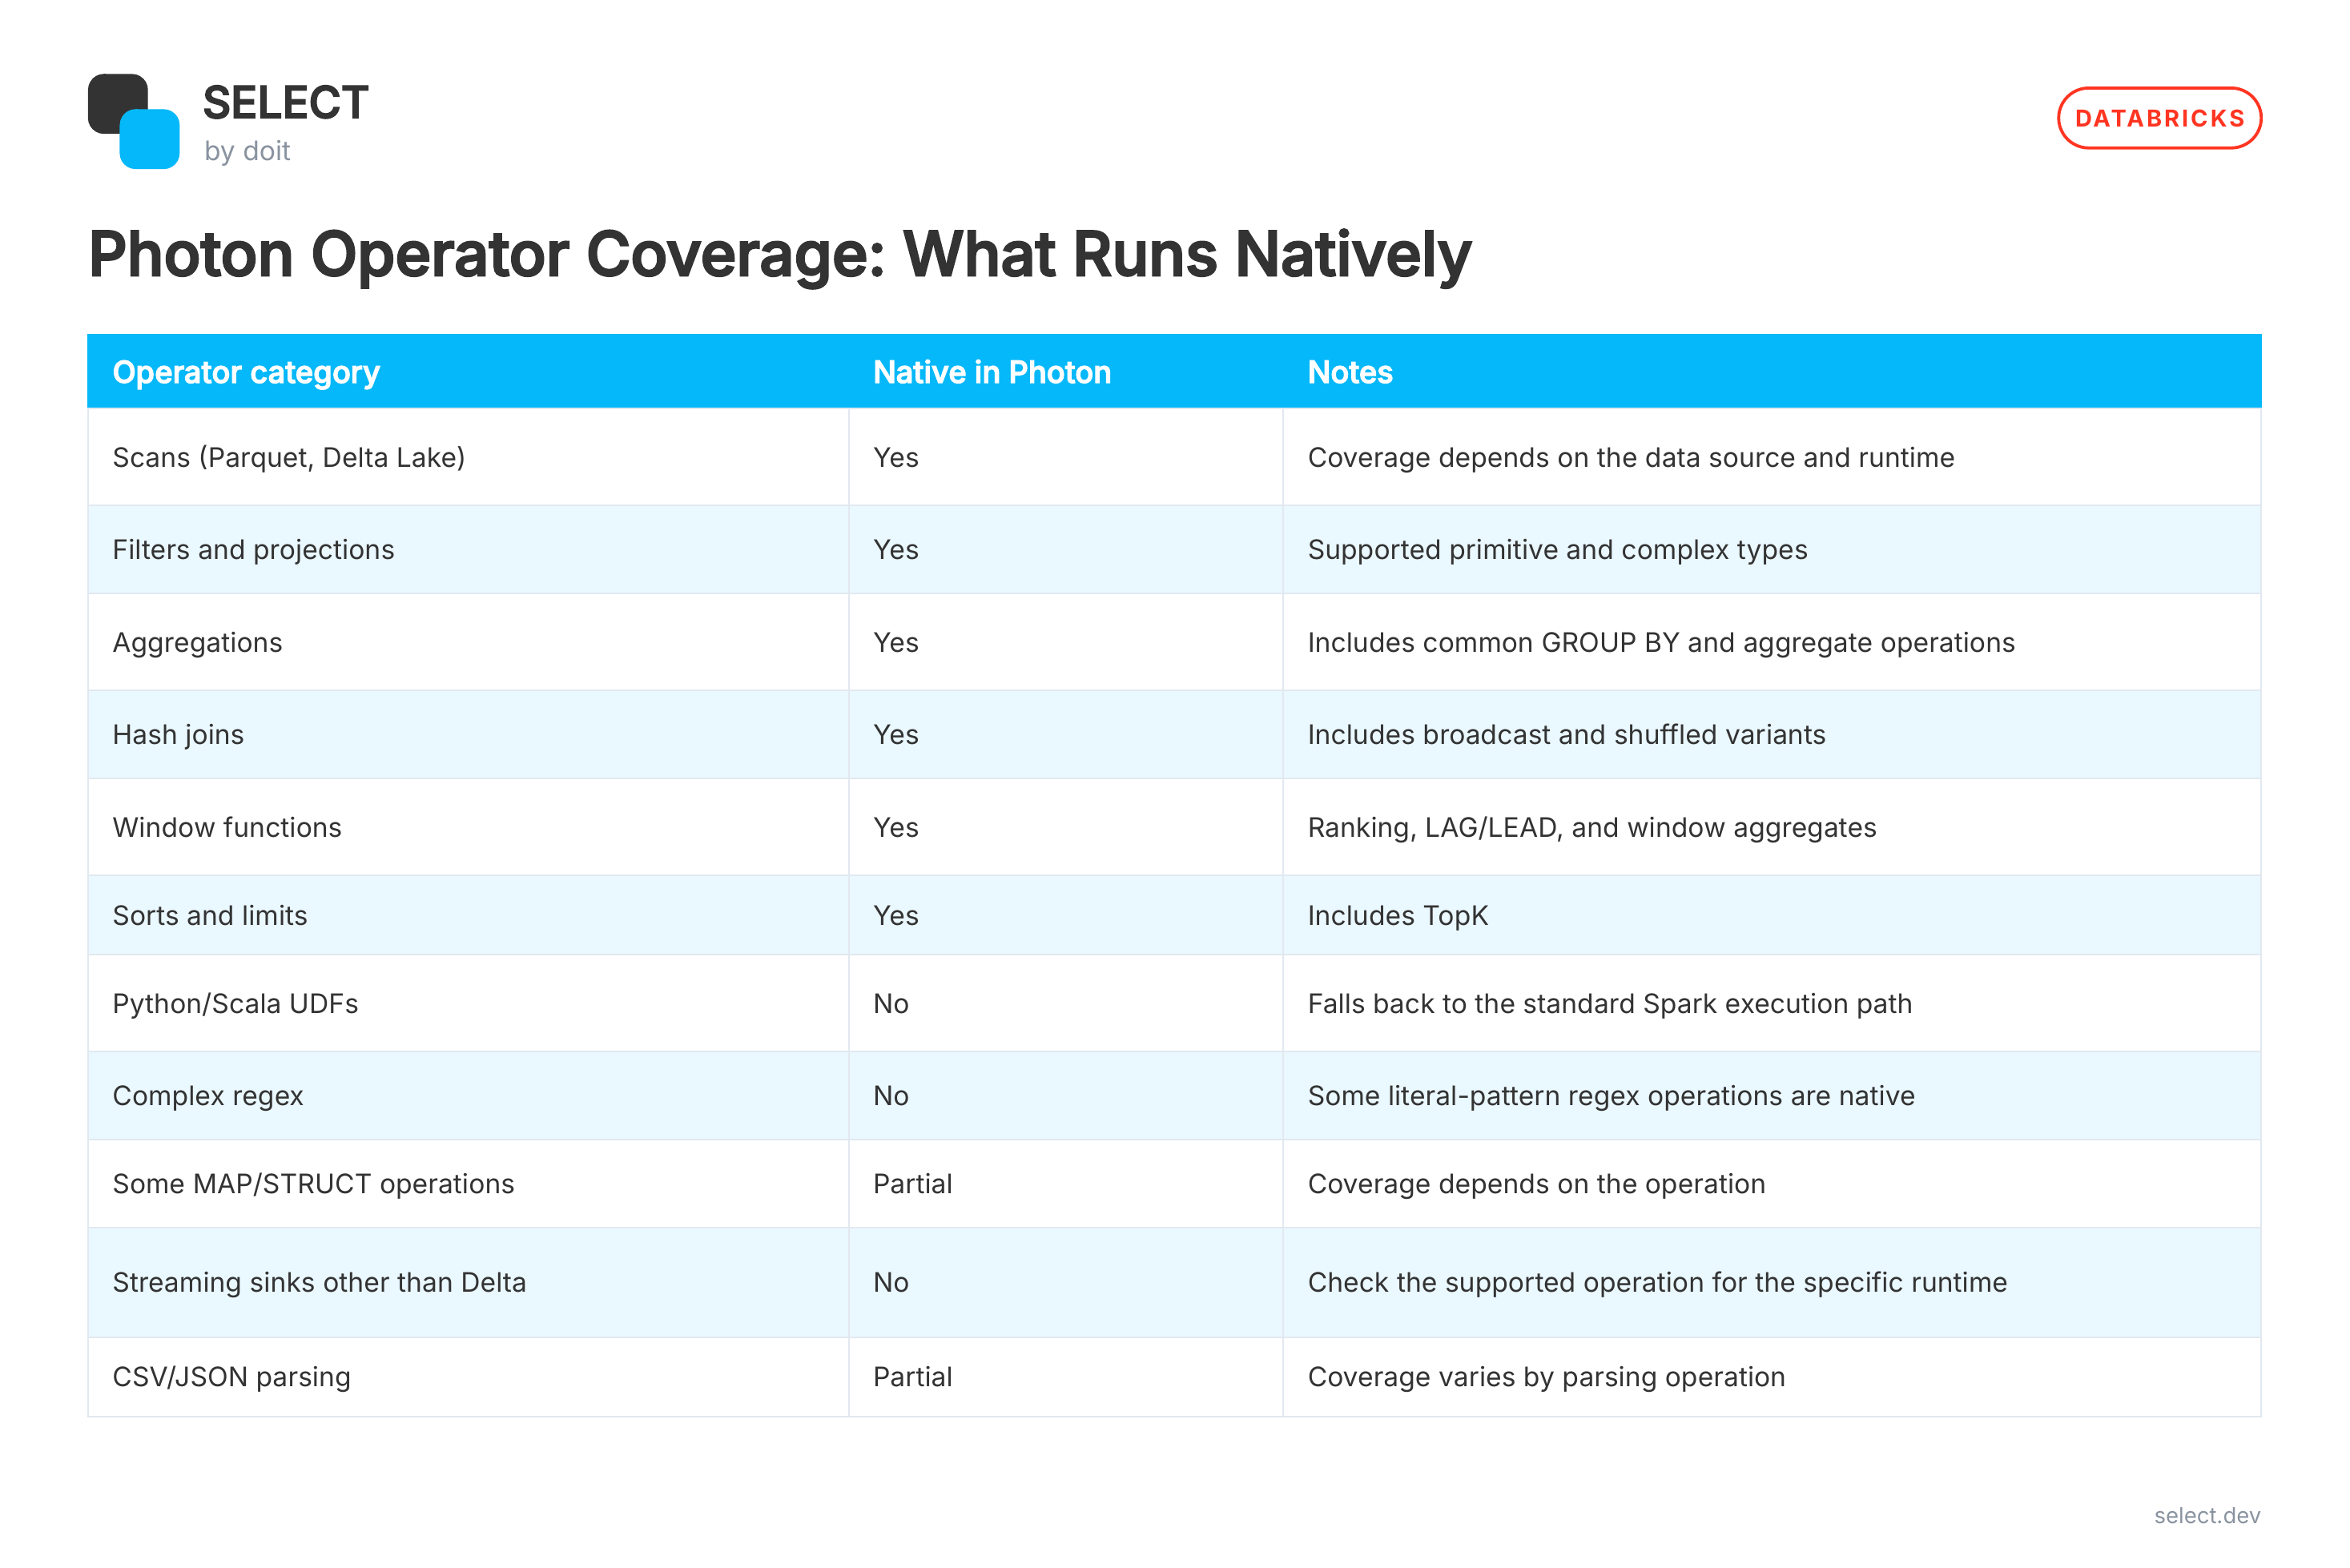
Il query profile e il piano fisico mostrano cosa è successo sul proprio job. Individui gli operatori che consumano più tempo di esecuzione, poi verifichi se sono passati da Photon o hanno fatto fallback. È questa la prova che serve per capire se Photon ha davvero aiutato.
Come si comporta Photon sulle diverse superfici di compute
Dove si esegue il workload cambia il modo in cui Photon è configurato e come funziona la fatturazione. È un aspetto che conta quando lo stesso job si sposta tra un cluster classico, un SQL warehouse e il serverless, e all'improvviso i numeri non tornano.
Con i SQL warehouse di Databricks, Photon è attivo di default sul tier Classic. I tier Pro e Serverless funzionano esclusivamente con Photon. Quindi, se esegue analisi SQL, chiedersi se Photon è abilitato ha poco senso. La domanda migliore è cosa dice il query profile e se il lavoro che Photon sta effettivamente svolgendo basta a giustificare il compute.
Come abilitare Photon sui cluster classici
Sui cluster classici, Photon è abilitato di default per il compute all-purpose e per i job, e l'impostazione Use Photon Acceleration lo disattiva. Se crea il compute tramite API, può impostare esplicitamente runtime_engine: "PHOTON". Il tipo di istanza deve comunque supportare Photon.
Il confronto 2× sui DBU visto prima è particolarmente utile sui cluster classici. Se vuole capire che effetto ha Photon su un job ETL ricorrente, esegua lo stesso workload sullo stesso tipo di istanza con e senza Photon. Osservi sia il tempo di esecuzione sia i DBU. Un job più veloce è interessante solo se diventa abbastanza veloce da ripagare la tariffa più alta.
Photon sul compute serverless
Sul compute serverless, Photon è abilitato di default, ma non si gestisce un cluster, non si sceglie la famiglia di VM e non si attiva o disattiva il runtime. Di quel livello si occupa Databricks. Il punto è che il serverless usa un modello di pricing diverso, quindi il calcolo 2× dei cluster classici non si trasferisce direttamente. Lakebase gira sullo stesso modello serverless: vale la pena tenerlo a mente se lo sta confrontando con i workloads Photon su cluster classici; le strutture di pricing non sono le stesse.
La differenza di pricing conta quando i workloads si spostano tra superfici di compute. Il motore può restare lo stesso mentre l'economia sottostante cambia. Se un job costa poco su un cluster classico con Photon abilitato, non significa che spostarlo sul serverless produrrà lo stesso profilo di costo. La superficie di compute fa parte del calcolo. Se sta facendo questo calcolo sull'intero ambiente Databricks, Databricks Cost Optimization copre le altre leve, dall'auto-termination e dal dimensionamento del compute fino al layout delle tabelle e alla governance.
Leggere il query profile per misurare la copertura di Photon
Per sapere se Photon ha davvero migliorato le prestazioni, parta dal query profile, non dal tempo trascorso. Il profilo mostra dove il workload ha passato il tempo e quali parti del piano hanno usato il motore.
Un workload può terminare prima e dire comunque ben poco sull'aspetto economico. Se la maggior parte del tempo di task è andata a scansioni, join o aggregazioni native di Photon, lo speedup ha una spiegazione chiara. Se gli operatori costosi hanno fatto fallback sul percorso di esecuzione standard, o la maggior parte del tempo è andata in shuffle e I/O, il motore non sta facendo molto per la parte che conta.
Ecco come appare nel query profile:
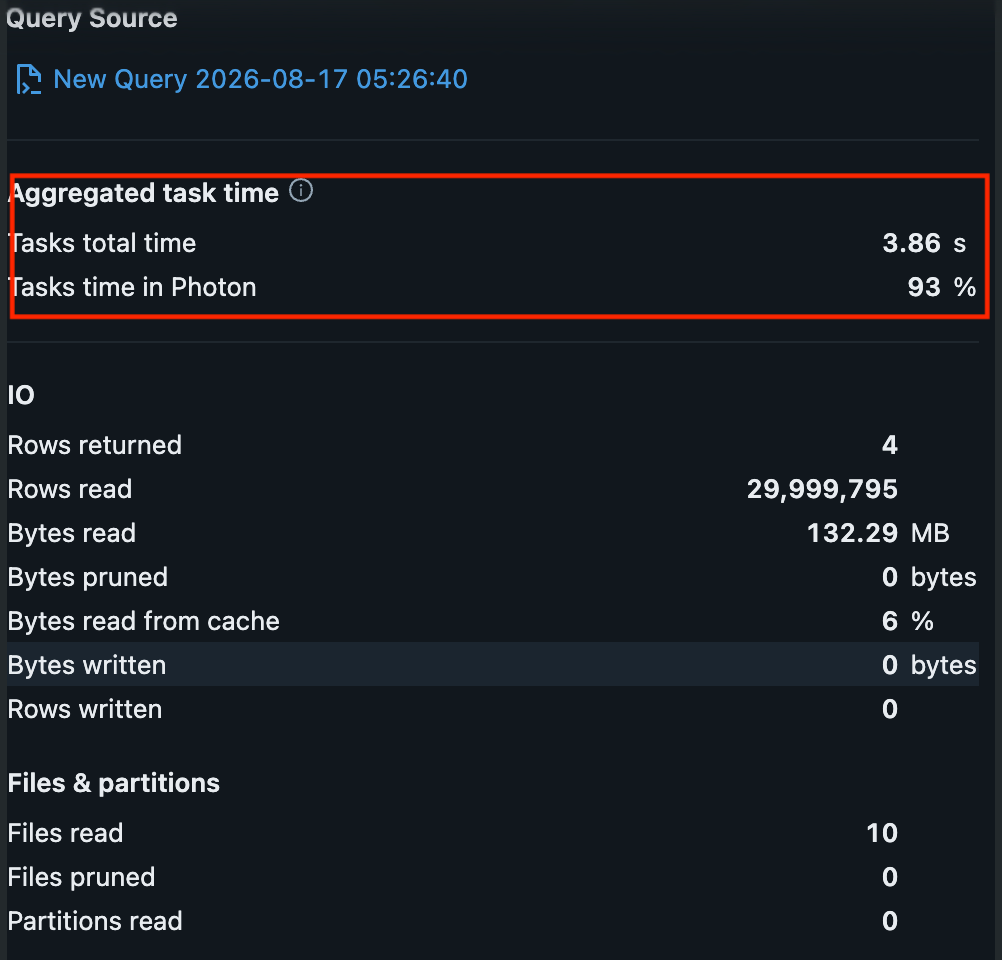
In questo esempio, il 93% del tempo di task è passato da Photon. La query ha letto 29.999.795 righe su 10 file, con 3,86 secondi di tempo di task totale. È un segnale forte che Photon ha gestito la maggior parte dell'esecuzione dei task.
Il numero importante non è solo la percentuale. Guardi anche cosa stava effettivamente facendo la query. Quel 93% è una vittoria netta perché gli operatori costosi, la scansione e l'aggregazione, sono stati eseguiti entrambi in modo nativo. Non sempre il quadro sarà così netto. Supponiamo che un'altra query passi il 70% del tempo in una UDF Python o in attesa di uno shuffle esteso. Abilitare Photon lì non tocca il vero collo di bottiglia, a prescindere da come appare il tempo di esecuzione dopo. La percentuale dice qualcosa solo quando si sa cosa sta misurando.
È qui che la copertura degli operatori vista nella sezione precedente torna utile: non si tratta di contare quanti operatori usano Photon, ma di trovare dove è andato davvero il tempo di task.
È anche così che si spiegano a posteriori i risultati sorprendenti. Un job può mostrare un miglioramento significativo del tempo di esecuzione mentre la maggior parte del lavoro costoso resta fuori da Photon. Un altro può ottenere un guadagno maggiore perché i suoi operatori principali girano in modo nativo. Stessa metrica di runtime, ragioni diverse sotto la superficie, e il profilo è ciò che dice quale delle due si ha davanti.
Per i workloads ETL e SQL ricorrenti, questo è il controllo da fare prima di decidere se Photon si guadagna i suoi DBU: individuare gli operatori costosi, vedere quale percorso hanno preso e collegare il tutto a tempo di esecuzione e costo.
Misurare il costo di Photon con SELECT
Un workload Photon più veloce non è automaticamente più economico. Prima di dichiararlo un successo, bisogna collegare il miglioramento del tempo di esecuzione ai DBU e ai costi dell'infrastruttura.
SELECT permette di ricondurre la spesa Databricks a job, cluster e warehouse, con il consumo di DBU e i costi dell'infrastruttura sottostante nella stessa vista. Per un job ETL ricorrente, confronti esecuzioni equivalenti prima e dopo la modifica di Photon. Metta a confronto insieme prestazioni, DBU e costo totale. Se il job termina più in fretta ma la tariffa Photon più alta fa salire il costo, lo speedup non si è ripagato. La stessa attribuzione copre i costi di serving dei modelli AI in Agent Bricks se Photon è solo un tassello di un workload più ampio.
La tariffa DBU 2x vista prima fornisce la base di riferimento. Un workload su cluster classico ha bisogno di circa uno speedup 2x per andare in pareggio. SELECT fornisce i dati di utilizzo e costo a livello di job per vedere dove si colloca davvero il workload, invece di stimarlo dal solo tempo di esecuzione.
Il query profile mostra dove il motore ha aiutato. SELECT mostra i DBU e i costi di infrastruttura dietro quel miglioramento. Insieme, mostrano se un workload ETL o SQL ricorrente sta diventando più economico man mano che diventa più veloce. Prenoti una demo per fare questo confronto sui propri job con Photon abilitato.
Domande frequenti
Photon funziona con il codice Spark esistente?
Sì. Photon gira sotto lo stesso modello di programmazione Spark, quindi non serve riscrivere i job Spark per usarlo. I workloads DataFrame e SQL esistenti possono usare Photon quando il loro piano fisico corrisponde a operatori nativi supportati. La cosa principale da verificare è la copertura degli operatori, soprattutto se la pipeline si basa molto su UDF o altre operazioni che fanno fallback sul percorso di esecuzione Spark standard.
Perché le UDF Python non sono più veloci con Photon abilitato?
Poiché Photon non esegue in modo nativo UDF Python arbitrarie, la UDF passa dal percorso di esecuzione standard Spark e Python, quindi Photon non può ottimizzare il codice Python in sé. Se la UDF è il collo di bottiglia, abilitare Photon cambierà poco. Dove possibile, conviene sostituire la UDF con una funzione SQL integrata. Se una UDF Python è inevitabile, una pandas_udf può ridurre parte dell'overhead Python/JVM, ma non rende la UDF nativa per Photon.
Come verifico quale percentuale della query è stata eseguita su Photon?
Apra il query profile completato e vada su Aggregated task time → Tasks time in Photon. Quella percentuale indica quanta parte del tempo di task è passata da Photon. Poi controlli la ripartizione per operatore per vedere dove è andato il tempo rimanente. La percentuale da sola non basta: bisogna anche sapere se Photon ha gestito la parte costosa del workload.
Photon costa più del Databricks Runtime standard?
Sui cluster classici, sì. Il compute con Photon abilitato ha una tariffa DBU più alta rispetto al compute equivalente senza Photon. Il moltiplicatore esatto dipende dal tipo di istanza, ma circa 2× è il numero utile per il calcolo dei costi. Significa che il workload ha bisogno di circa uno speedup 2× per andare in pareggio.
Photon supporta l'accelerazione GPU?
No. Photon è un motore di esecuzione nativo basato su CPU, non un motore di esecuzione GPU. Accelera le operazioni Spark supportate usando l'esecuzione nativa su CPU. Se il workload richiede compute GPU per il machine learning o un altro workload specifico per GPU, Photon non sostituisce il compute con GPU abilitata.