
Photonは、ワークロードを最適化する前に理解しておくべきDatabricksのコスト要因のひとつです。
クラシッククラスターでは、Photon対応コンピュートは同等の非Photonコンピュートと比べて約2倍のレートでDatabricks Unit(DBU)を消費します(正確な倍率はインスタンスタイプによって異なります)。高いDBUレートを相殺できるほど速く完了するワークロードもあれば、速くなってもコストが増えるワークロードもあるため、実行時間だけではPhotonがコスト削減につながっているかどうかは判断できません。
LakeSentryは、コミュニティ発のDatabricks料金分析の中で、料金表からは見えにくい想定外のコストの要因のひとつとしてPhotonを挙げています。追加のDBU消費が割に合うのは、ワークロードがそれに見合う高速化を得られる場合だけです。
本ガイドでは、Databricks Photonがコストにどう影響するか、損益分岐点はどこにあるか、そしてPhotonを有効化することでワークロードが安くなるかどうかを見極める方法を解説します。
要点まとめ
- クラシッククラスターでは、Photonの高いDBUレートを相殺するには2倍を超える高速化が必要です。
- スキャン、集計、結合はこのしきい値を超えられる一方、Python UDF、短時間ジョブ、大規模シャッフルを伴うワークロードは下回ることが少なくありません。
- ワークロードの一部しかPhotonで実行されない場合でも、Photonのレートが課金されます。
- クエリプロファイルのAggregated task timeパネルでPhotonのカバレッジを確認し、Photon有効化前後の実際のDBU合計を比較しましょう。
Databricks Photonとは?
Databricks Photonは、対応するSparkのデータ処理のパフォーマンスを向上させるクエリエンジンです。クエリプランニングは引き続きSparkのCatalystオプティマイザーが担当し、対応する操作はネイティブC++で実行されます。
特に押さえておきたいのが、Photonのデータ処理方式です。1行ずつ実行するのではなく、対応するデータ型のカラムナーデータをバッチ単位で処理し、SIMD(Single Instruction Multiple Data)命令を使って1つのCPU命令で複数の値を処理します。これによりJVM実行パスのオーバーヘッドが削減され、Photonが対応している場合、スキャン、フィルター、集計、結合、ソートといった操作が高速化されます。
PhotonはSparkを置き換えるものではなく、同じSparkプログラミングモデルの下で動作するネイティブ実行レイヤーとして機能します。SparkやSQLのクエリは引き続きCatalystでプランニングされ、物理プランのうち対応する部分がPhotonで実行されます。非対応の操作は標準のSparkランタイムにフォールバックします。
この最後の点がコストに大きく影響します。Photonを有効化しても、ジョブ内のすべての操作がPhotonで実行されるわけではありません。ワークロードのどれだけがPhotonを利用できるかはオペレーターの構成次第なので、パフォーマンスやコストを判断する前に計測が必要です。
DBU倍率と損益分岐点の計算
クラシッククラスターでPhotonが約2倍のDBUを消費するなら、高いコンピュートレートが削減につながるには、ジョブが2倍以上速く実行される必要があります。Photonのベンチマークを見るときは、このラインを念頭に置いてください。
通常60分かかるジョブを例に取りましょう。1.5倍の高速化なら40分に短縮されますが、2倍のDBUレートのため、DBU消費は約33%増えます。高速化を3倍まで引き上げれば、ジョブは20分で完了し、DBU消費は約3分の2になります。これはおよそ33%の削減です。ちょうど2倍では、実行時間の短縮と高いDBUレートが相殺されます。
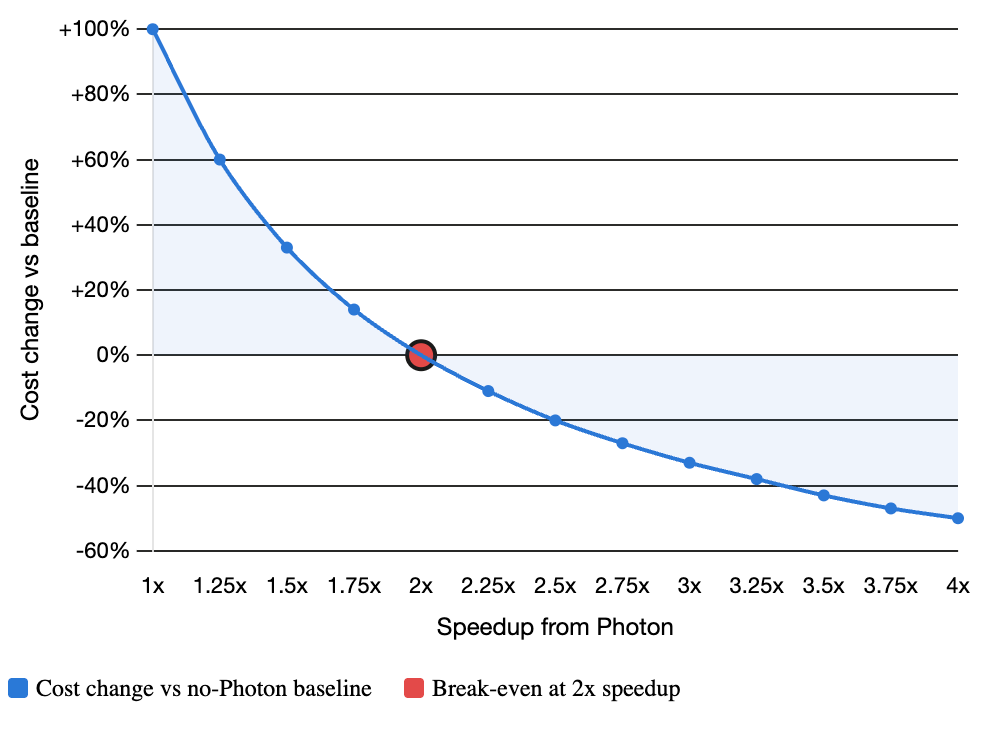
どこに落ち着くかは、クエリが実際に何をしているかに大きく左右されます。選択的なフィルターでParquetやDeltaを読み込むスキャン中心のジョブでは、Photonにネイティブ実行の仕事が十分にあります。ファクトテーブルに対する大規模な集計や、片側をブロードキャストできるハッシュ結合も同様です。公開されているベンチマークで2倍の損益分岐点を超える高速化が示されているのは、こうしたワークロードです。
ジョブの高コスト部分がPhotonで高速化できないものだと、状況は変わります。Python UDFは実行をJVMとPythonに戻してしまいます。短時間のジョブでは、実際の実行よりもプランニングやスケジューリングに時間がかかることがあります。大規模なシャッフルでは、ネットワーク越しのデータ移動やディスク待ちに実時間の大半を費やすことがあります。ジョブの待ち時間の原因がCPUでないなら、CPU部分を高速化してもあまり効果はありません。
以下の表は、2倍の損益分岐点を踏まえて、どのようなワークロードがそれを超えやすく、どのようなものが超えにくいかを示しています。
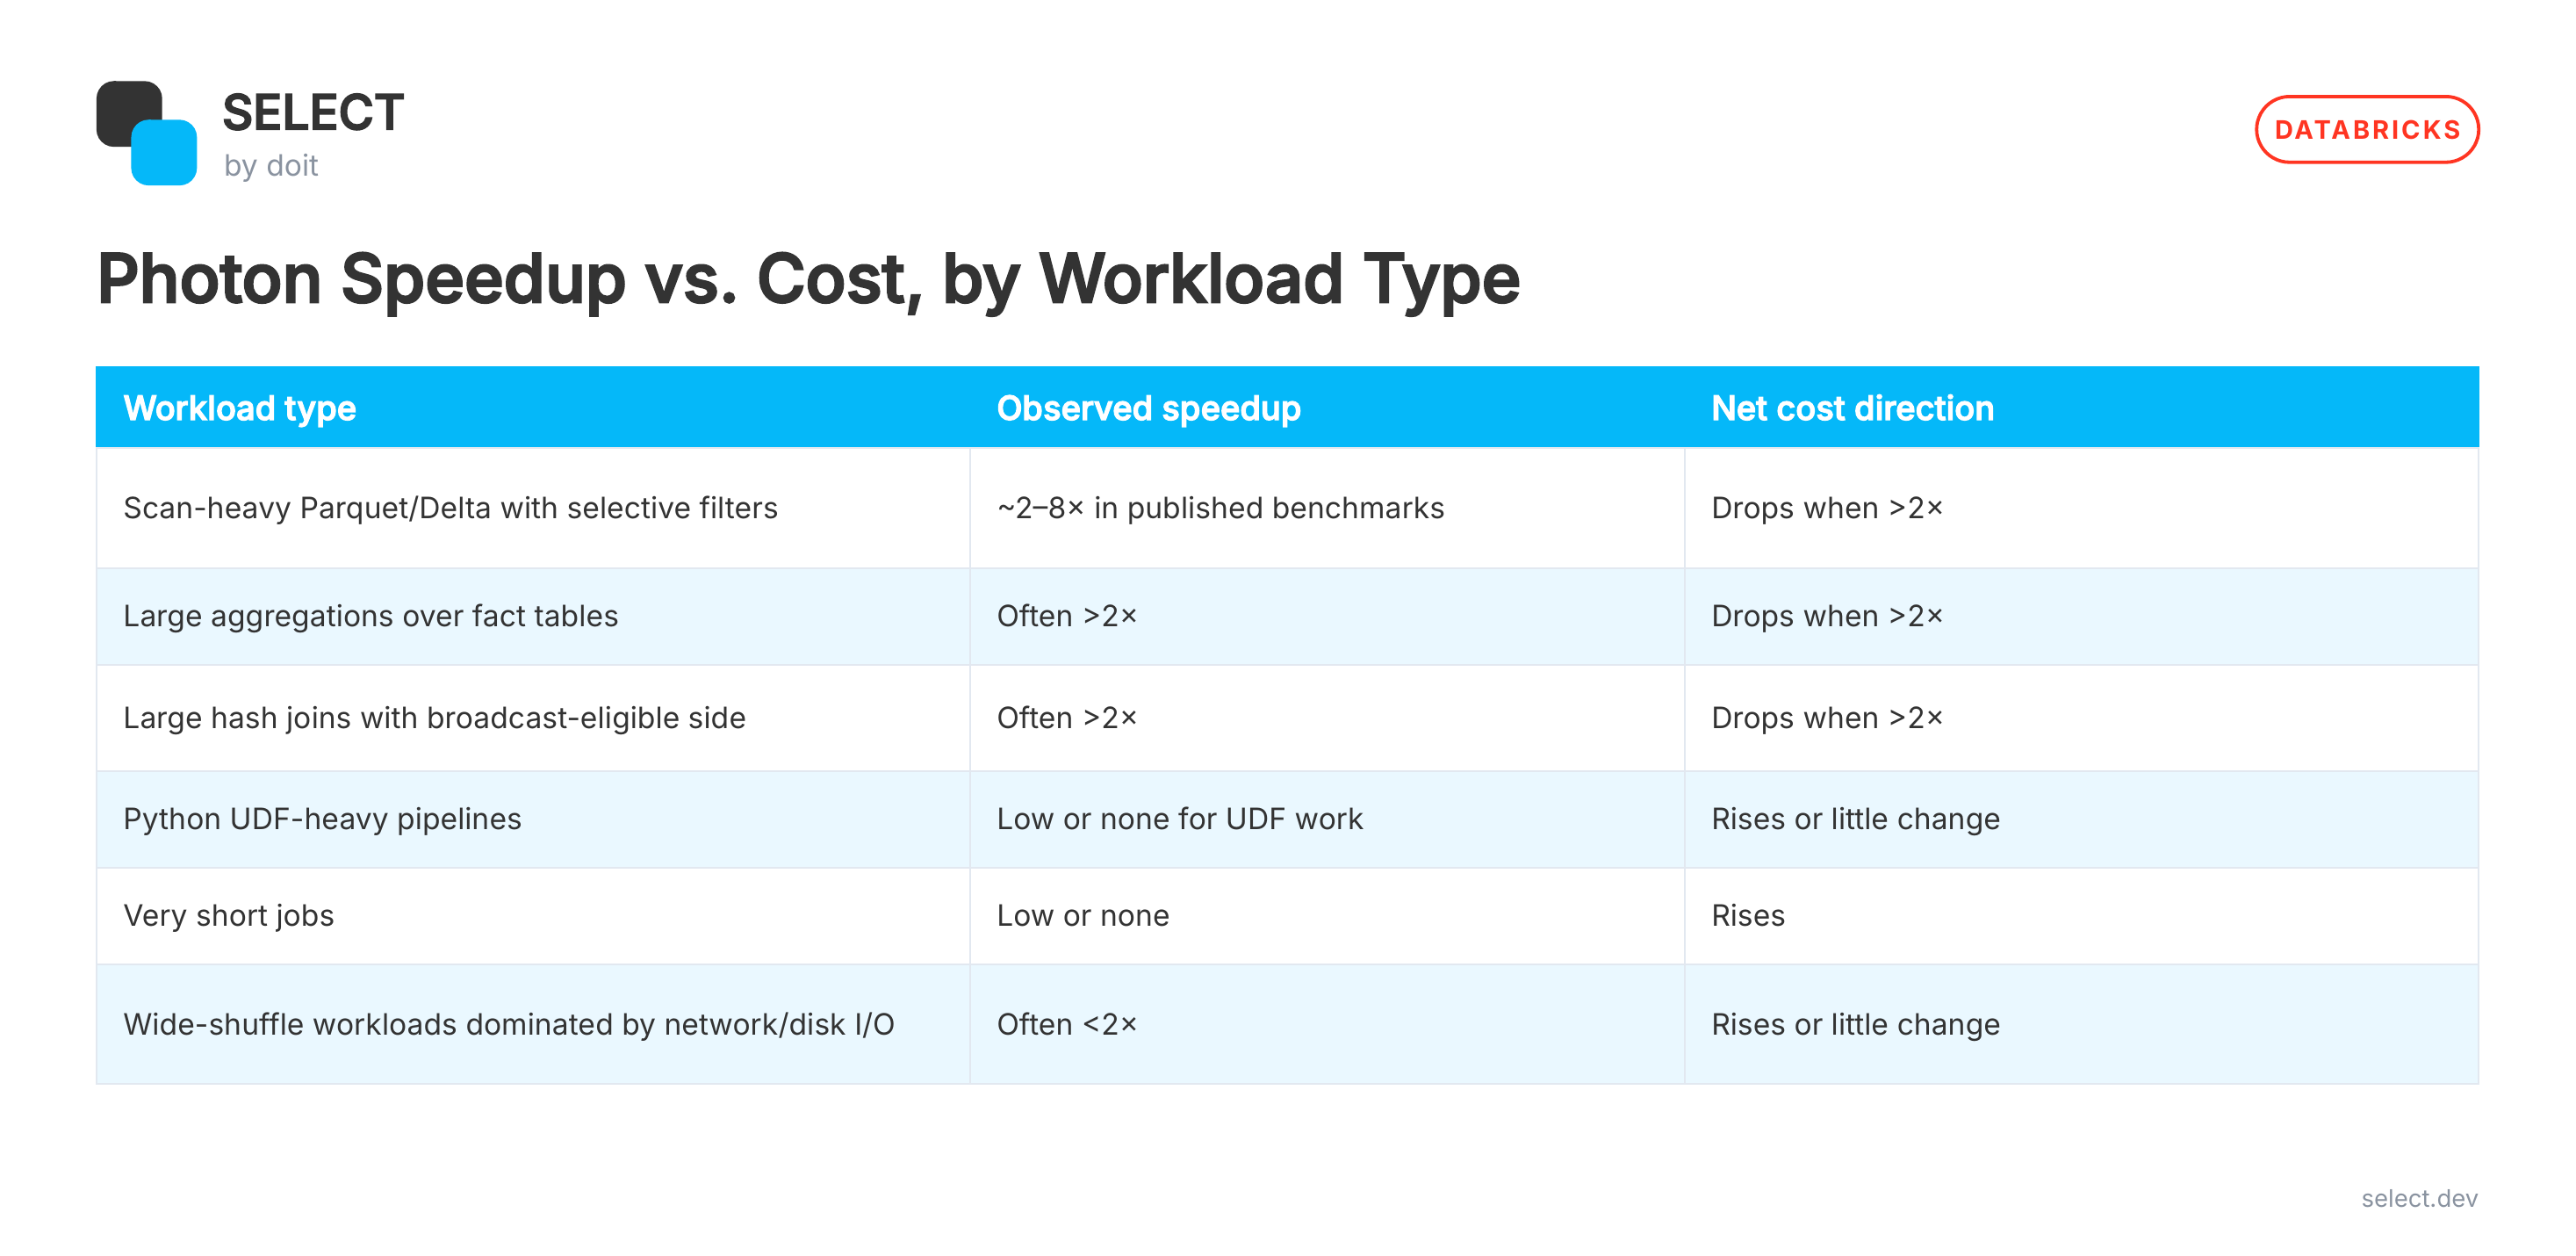
コストの方向性は、同等のクラシッククラスターコンピュートに対してPhotonのDBU倍率が約2倍であることを前提としています。実際のDBUレートはインスタンスタイプによって異なるため、結果を決めるのは計測された高速化率です。
2倍のしきい値が計算の基準になります。実行プランを見れば、ジョブが現実的にそれを超えられる見込みがあるかどうかがわかります。
オペレーターカバレッジ:Photonがネイティブ実行するオペレーターと、フォールバックするオペレーターは?
PhotonはすべてのSparkオペレーターを実行するわけではありません。ネイティブに実行されるオペレーターもあれば、JVMにフォールバックするものもあります。ワークロードの高コスト部分がネイティブ実行されていない場合でも、Photon対応コンピュートのレートが課金されます。
大きなDelta Lakeテーブルを読み込み、大半の行をフィルターで除外し、残りを集計して、その結果を別のテーブルに結合するクエリを考えてみましょう。これらはまさに、Photonが最適化できる実質的なCPU処理を伴う操作です。ここで、途中にPython UDFを入れてみます。その部分は別の実行パスを通るため、UDFがジョブの時間の大半を占めるなら、Photonはボトルネックに手を付けられません。Photon対応クラスターだからといって、クエリ全体がPhotonで実行されるわけではありません。どの部分が実際にPhotonで実行されるかは、物理プランが決めます。
一般的なデータワークロードでは、PhotonはParquetおよびDeltaのスキャン、フィルター、プロジェクション、集計、ハッシュ結合をネイティブに実行できます。ウィンドウ関数やソート、一般的な文字列操作にも対応しています。PythonとScalaのUDFはフォールバックし、一部の正規表現、MAP``/``STRUCT、ストリーミングシンク、CSV/JSON操作は、具体的な操作内容とDatabricks Runtimeのバージョンに依存します。可能であればUDFをSpark SQLの組み込み関数に置き換え、より多くの処理をネイティブパスに残しましょう。スキャン時間がジョブの大半を占める場合は、テーブルのレイアウトがPhotonのスキャン対象に影響します。その面ではLiquid Clusteringを検討する価値があります。
以下の表は、Photonがネイティブ実行できるワークロードと、フォールバックする箇所を示しています:
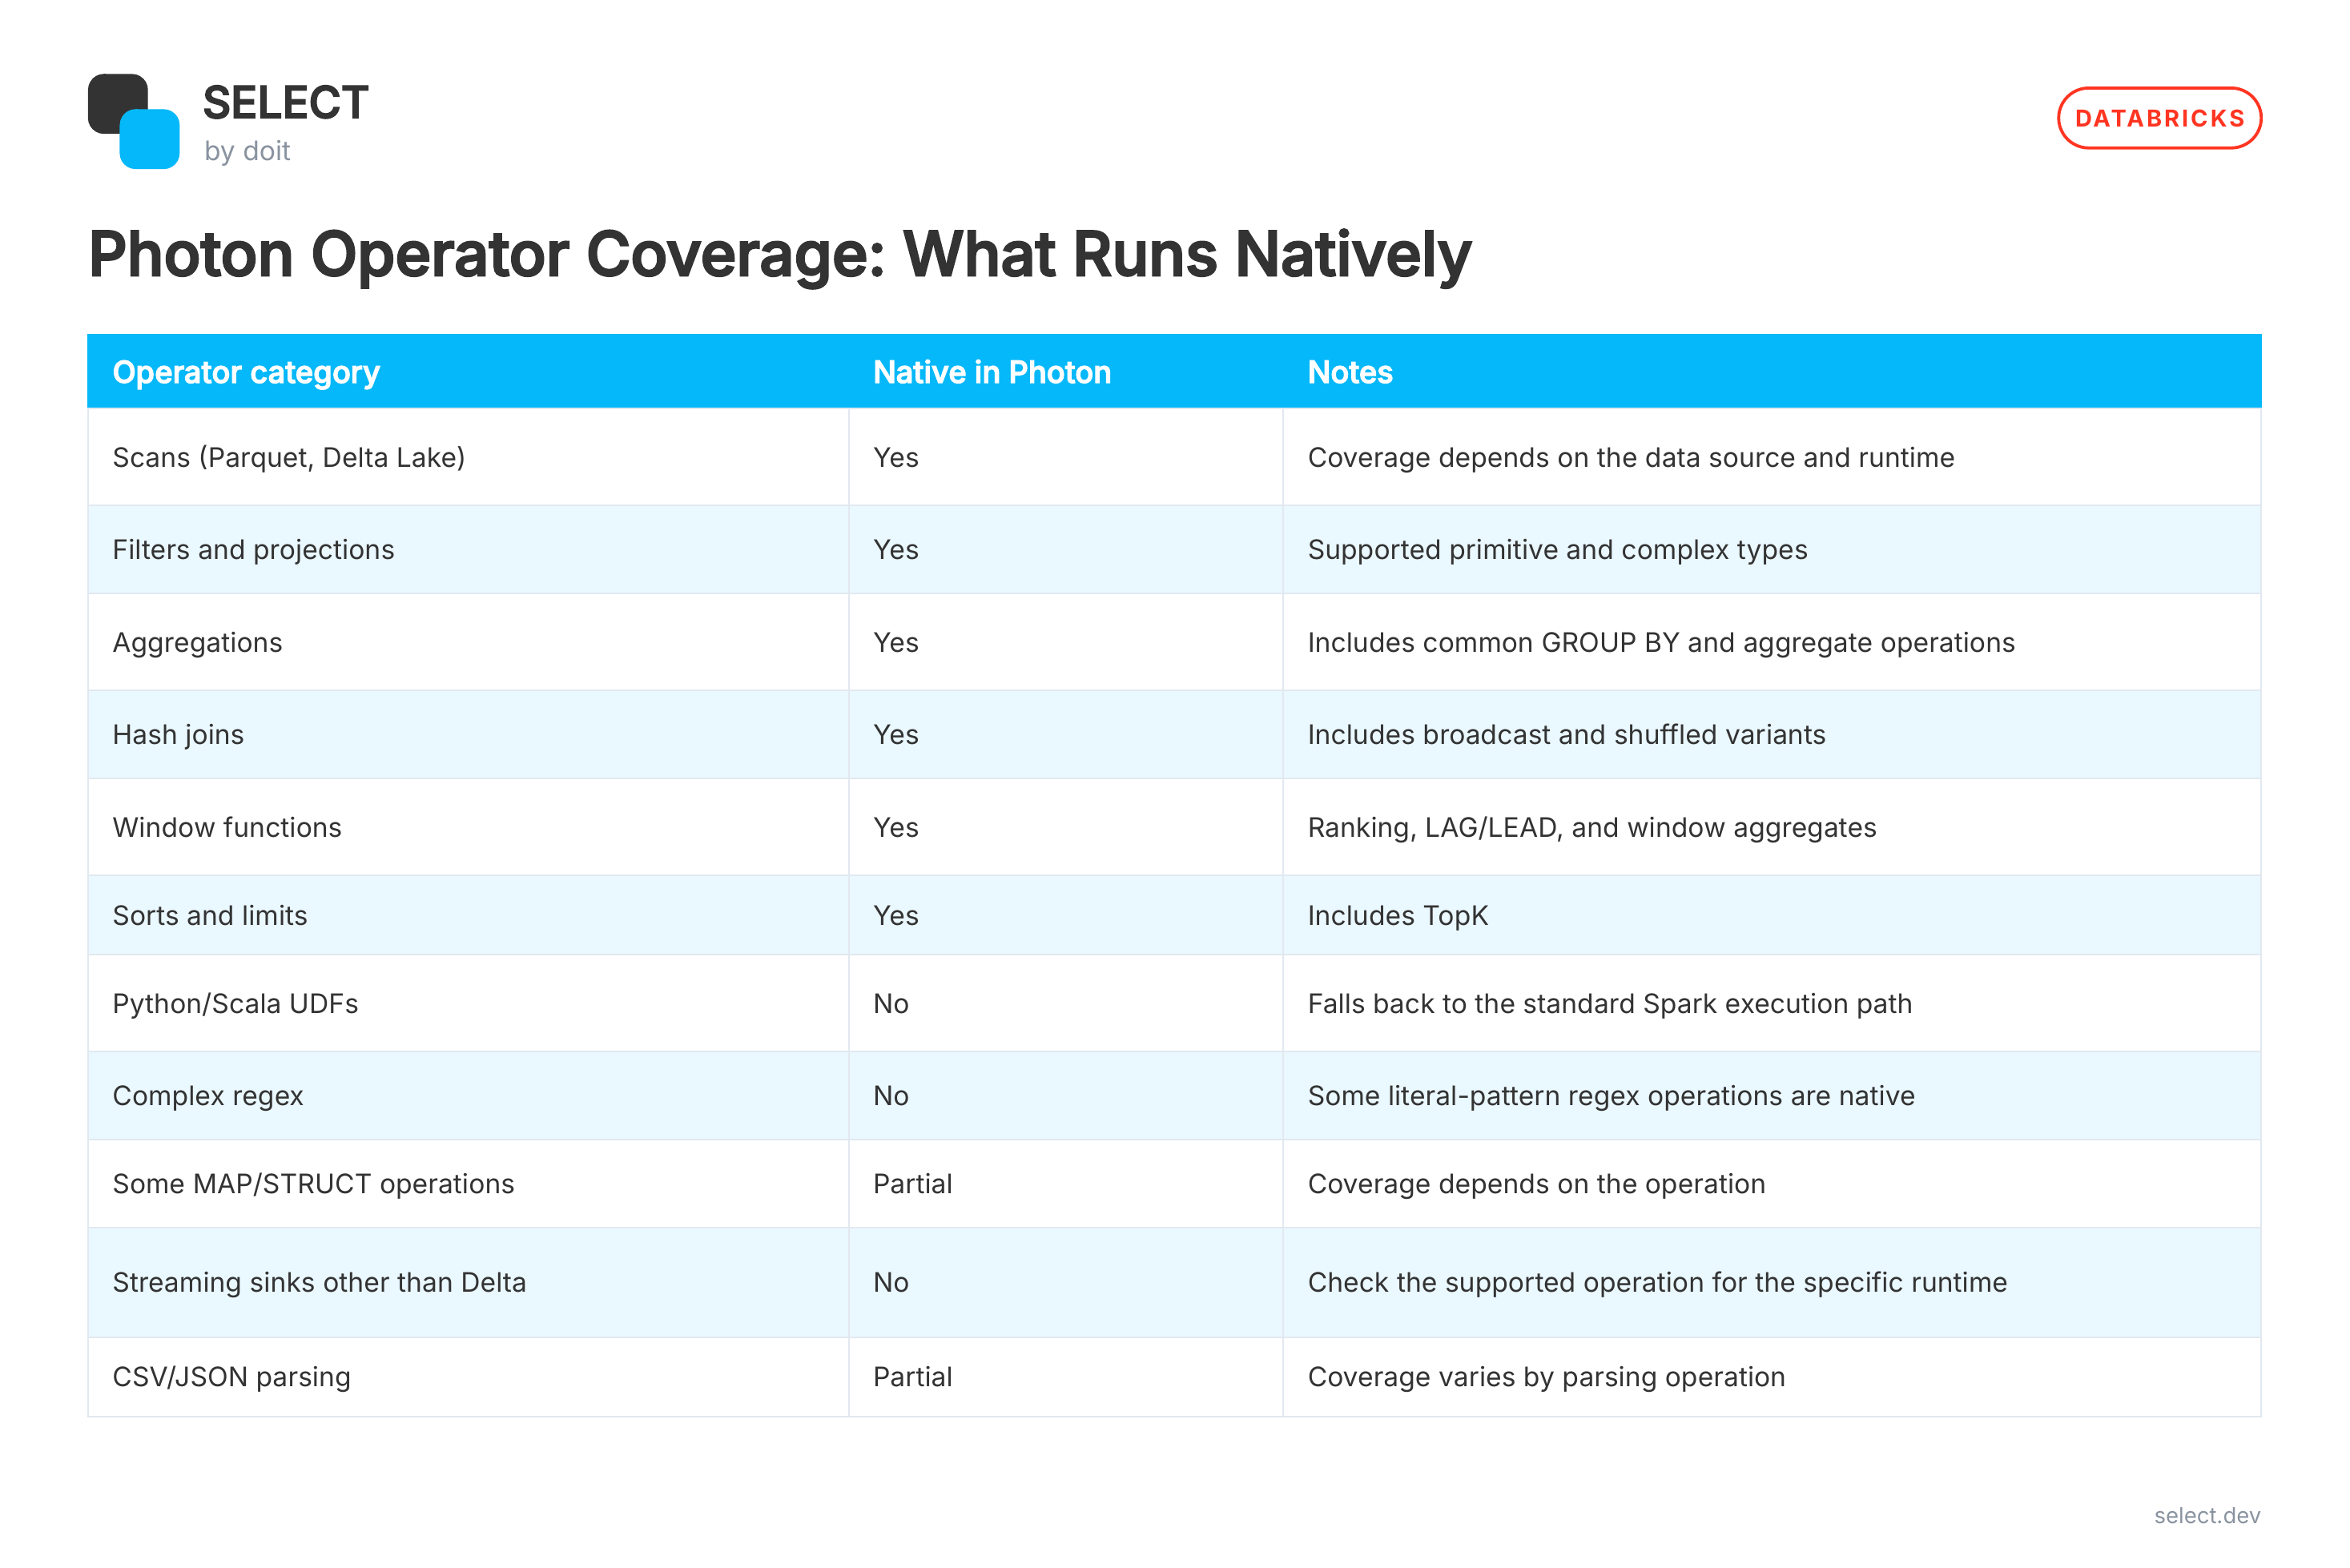
クエリプロファイルと物理プランを見れば、自分のジョブで何が起きたかがわかります。実行時間を最も消費しているオペレーターを特定し、それがPhotonで実行されたのか、フォールバックしたのかを確認してください。Photonが本当に効果を発揮したかどうかを判断するには、この裏付けが必要です。
コンピュート環境ごとのPhotonの挙動
ワークロードをどこで実行するかによって、Photonの設定方法と課金の仕組みが変わります。同じジョブがクラシッククラスター、SQL Warehouse、サーバーレスの間を移動して、突然数字が合わなくなるとき、この点が重要になります。
Databricks SQL Warehouseでは、ClassicティアでPhotonがデフォルトで有効になっています。ProおよびServerlessティアはPhoton専用です。そのため、SQL分析を実行している場合、Photonが有効かどうかを問う意味はあまりありません。むしろ問うべきは、クエリプロファイルが何を示しているか、そしてPhotonが実際に行っている処理がそのコンピュートに見合うかどうかです。
クラシッククラスターでPhotonを有効にする方法
クラシッククラスターでは、All-PurposeコンピュートとJobsコンピュートでPhotonがデフォルトで有効になっており、「Use Photon Acceleration」設定でオフにできます。API経由でコンピュートを作成する場合は、runtime_engine: "PHOTON" を明示的に指定できます。いずれの場合も、インスタンスタイプがPhotonに対応している必要があります。
先ほどの2倍のDBU比較は、クラシッククラスターで特に役立ちます。定期的なETLジョブに対するPhotonの影響を把握したいなら、同じインスタンスタイプでPhotonあり・なしの両方で同じワークロードを実行してください。実行時間とDBUの両方を見ます。ジョブが速くなっても、意味があるのは高いレートを回収できるほど速くなった場合だけです。
サーバーレスコンピュートでのPhoton
サーバーレスコンピュートでもPhotonはデフォルトで有効ですが、クラスターの管理、VMファミリーの選択、ランタイムの切り替えは行いません。そのレイヤーはDatabricksが担います。注意点は、サーバーレスは異なる料金モデルを採用しているため、2倍というクラシッククラスターの計算がそのまま当てはまらないことです。Lakebaseも同じサーバーレスモデルで動作します。クラシッククラスターのPhotonワークロードと並べて料金を検討する場合は、料金体系が同じではない点に留意してください。
この料金の違いは、ワークロードがコンピュート環境間を移動するときに重要になります。エンジンは同じでも、その下の経済性は変わり得ます。Photon対応のクラシッククラスターで安く済んでいるジョブでも、サーバーレスに移せば同じコストプロファイルになるとは限りません。コンピュート環境自体が計算の一部なのです。Databricks環境全体でこの計算に取り組んでいるなら、Databricks Cost Optimizationが、自動終了やコンピュートのサイジングからテーブルレイアウト、ガバナンスまで、その他の最適化手段を解説しています。
クエリプロファイルでPhotonカバレッジを計測する
Photonが本当にパフォーマンスを改善したかを知りたいなら、経過時間ではなくクエリプロファイルから始めてください。プロファイルを見れば、ワークロードがどこに時間を費やし、プランのどの部分がエンジンを使ったかがわかります。
ワークロードが早く終わっても、経済性についてはほとんど何もわからないことがあります。タスク時間の大半がPhotonネイティブのスキャン、結合、集計に費やされていれば、高速化には明確な説明がつきます。高コストのオペレーターが標準実行パスにフォールバックしていたり、時間の大半がシャッフルやI/Oに費やされていたりするなら、肝心な部分でエンジンはほとんど仕事をしていません。
クエリプロファイルでは次のように表示されます:
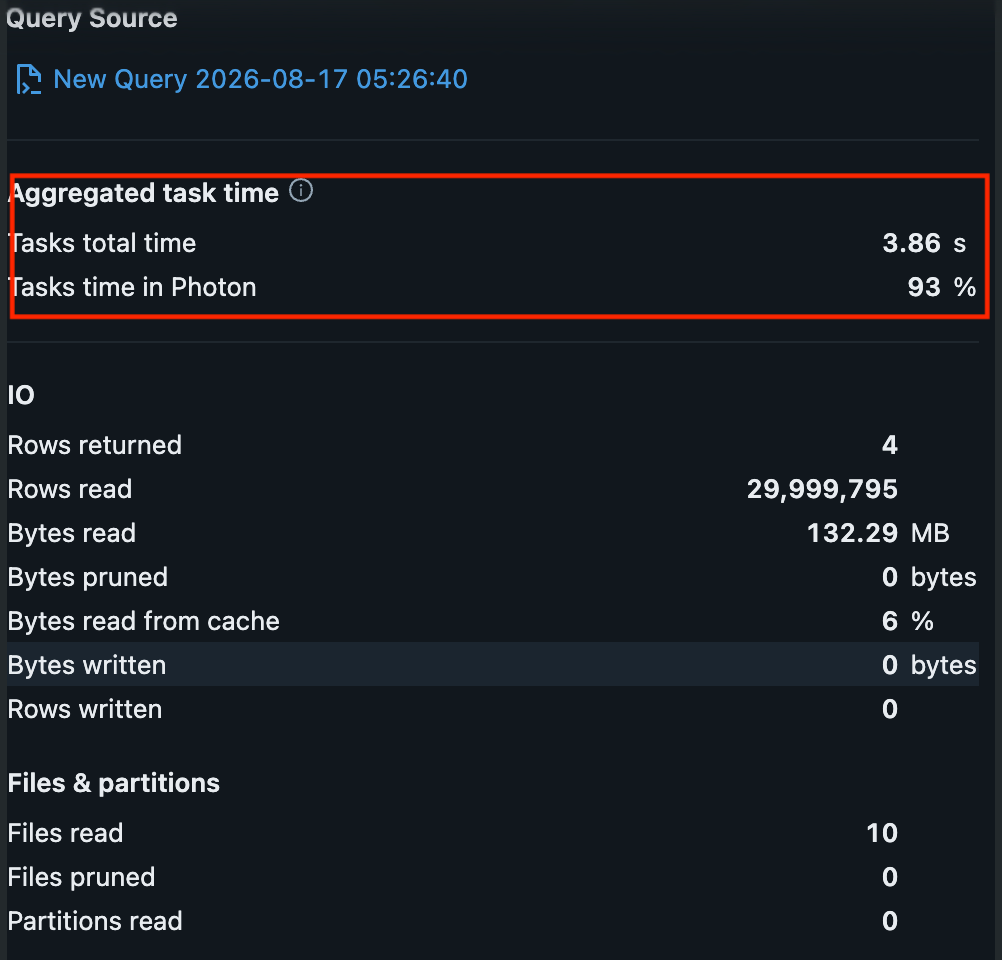
この例では、タスク時間の93%がPhotonで処理されています。クエリは10ファイルにまたがる29,999,795行を読み込み、総タスク時間は3.86秒でした。タスク実行の大半をPhotonが担ったことを示す強いシグナルです。
重要なのはパーセンテージだけではありません。クエリが実際に何をしていたかを併せて見てください。この93%という結果が明確な成功と言えるのは、高コストのオペレーターであるスキャンと集計の両方がネイティブ実行されたからです。いつもこれほどきれいにいくとは限りません。たとえば、別のクエリが時間の70%をPython UDFや大規模シャッフルの待ちに費やしているとします。そこでPhotonを有効にしても、その後の実行時間がどう見えようと、実際のボトルネックには手が届きません。パーセンテージが意味を持つのは、それが何を測っているかを理解してからです。
前のセクションで見たオペレーターカバレッジが活きるのもここです。Photonを使うオペレーターの数を数えるのではなく、タスク時間が実際にどこに費やされたかを突き止めることが重要です。
事後に意外な結果を説明できるのも、この見方があればこそです。高コストな処理の大半がPhotonの外にあっても、実行時間が目に見えて改善するジョブもあります。一方で、最大のオペレーターがネイティブ実行されるために、より大きな改善を得るジョブもあります。同じ実行時間の指標でも、その裏にある理由は異なります。どちらを見ているのかを教えてくれるのがプロファイルです。
定期的なETLやSQLのワークロードでは、PhotonがそのDBUに見合うかを判断する前に、このチェックを実行してください。高コストのオペレーターを特定し、どのパスを通ったかを確認し、それを実行時間とコストに結び付けます。
SELECTでPhotonのコストを計測する
Photonでワークロードが速くなっても、自動的に安くなるわけではありません。削減効果があったと判断する前に、実行時間の改善をDBUとインフラコストに結び付ける必要があります。
SELECTを使えば、Databricksの支出をジョブ、クラスター、ウェアハウスまで遡って追跡でき、DBU消費と基盤インフラのコストを同じビューで確認できます。定期的なETLジョブについては、Photon変更前後の同等の実行を比較してください。パフォーマンス、DBU、総コストをまとめて比較します。ジョブが速く終わっても、高いPhotonレートでコストが上がるなら、その高速化は元が取れていません。Photonがより大きなワークロードの一部にすぎない場合でも、同じコスト帰属の仕組みでAgent BricksのAIモデルサービングコストまでカバーできます。
先ほどの2倍のDBUレートが基準になります。クラシッククラスターのワークロードが損益分岐に達するには、およそ2倍の高速化が必要です。SELECTはジョブ単位の使用量とコストのデータを提供するので、実行時間だけから推測するのではなく、ワークロードが実際にどこに位置するかを確認できます。
クエリプロファイルはエンジンがどこで役立ったかを示します。SELECTはその改善の裏にあるDBUとインフラコストを示します。両方を合わせれば、定期的なETLやSQLのワークロードが速くなるにつれて安くなっているかどうかがわかります。ご自身のPhoton対応ジョブでこの比較を実行するには、デモを予約してください。
よくある質問
Photonは既存のSparkコードで動作しますか?
はい。Photonは同じSparkプログラミングモデルの下で動作するため、利用のためにSparkジョブを書き換える必要はありません。既存のDataFrameやSQLワークロードは、物理プランが対応するネイティブオペレーターにマッピングされればPhotonを利用できます。主に確認すべきはオペレーターカバレッジで、特にパイプラインがUDFなど、標準のSpark実行パスにフォールバックする操作に大きく依存している場合は注意が必要です。
Photonを有効にしてもPython UDFが速くならないのはなぜですか?
Photonは任意のPython UDFをネイティブ実行しないため、UDFは標準のSparkとPythonの実行パスを通ります。そのためPhotonはPythonコード自体を最適化できません。UDFがボトルネックなら、Photonを有効にしてもほとんど変わりません。可能であれば、UDFを組み込みのSQL関数に置き換えてください。Python UDFが避けられない場合、pandas_udfを使えばPython/JVM間のオーバーヘッドを一部削減できますが、UDFがPhotonネイティブになるわけではありません。
クエリの何パーセントがPhotonで実行されたかを確認するには?
完了したクエリプロファイルを開き、Aggregated task time → Tasks time in Photonを確認してください。このパーセンテージが、Photonで処理されたタスク時間の割合を示します。次にオペレーターの内訳を見て、残りの時間がどこに費やされたかを確認します。パーセンテージだけでは不十分です。ワークロードの高コスト部分をPhotonが処理したかどうかも知る必要があります。
Photonは標準のDatabricks Runtimeよりコストが高いのですか?
クラシッククラスターでは、そのとおりです。Photon対応コンピュートは、同等の非PhotonコンピュートよりもDBUレートが高くなります。正確な倍率はインスタンスタイプによりますが、コスト計算にはおよそ2倍という数字が目安になります。つまり、損益分岐にはおよそ2倍の高速化が必要です。
PhotonはGPUアクセラレーションに対応していますか?
いいえ。PhotonはCPUベースのネイティブ実行エンジンであり、GPU実行エンジンではありません。対応するSparkの操作をネイティブCPU実行で高速化します。機械学習などGPU固有のワークロードでGPUコンピュートが必要な場合、PhotonはGPU対応コンピュートの代わりにはなりません。