
Photon es uno de los varios factores de costo de Databricks que conviene entender antes de optimizar un workload.
En clusters clásicos, el cómputo con Photon habilitado consume Databricks Units (DBUs) a aproximadamente el doble de la tasa del cómputo equivalente sin Photon, aunque el multiplicador exacto varía según el tipo de instancia. Algunos workloads terminan lo suficientemente rápido como para compensar esa tasa de DBU más alta. Otros se aceleran y aun así cuestan más, por lo que el tiempo de ejecución por sí solo no te dice si Photon está ahorrando dinero.
LakeSentry, en un análisis reportado por la comunidad sobre los precios de Databricks, señala a Photon como uno de los factores de costo detrás de las sorpresas en la facturación que la tabla de precios no deja en evidencia. El consumo extra de DBUs solo vale la pena cuando el workload obtiene suficiente aceleración a cambio.
Esta guía se centra en Databricks Photon: cómo afecta el costo, dónde está el punto de equilibrio y cómo saber si habilitarlo hace que un workload salga más barato.
TL;DR
- En clusters clásicos, Photon necesita una aceleración de más de 2× para compensar su tasa de DBU más alta.
- Los scans, las agregaciones y los joins pueden superar ese umbral, mientras que las UDFs de Python, los jobs cortos y los workloads con shuffles amplios suelen quedar por debajo.
- Pagas la tasa de Photon incluso cuando solo una parte del workload se ejecuta a través de Photon.
- Revisa la cobertura de Photon en el panel Aggregated task time del query profile y luego compara los totales reales de DBU antes y después de habilitar Photon.
¿Qué es Databricks Photon?
Databricks Photon es un motor de consultas que mejora el rendimiento del procesamiento de datos de Spark compatible.Ejecuta las operaciones compatibles en C++ nativo, mientras que el optimizador Catalyst de Spark sigue encargándose de la planificación de las consultas.
Una diferencia importante a tener en cuenta es cómo procesa los datos Photon. En lugar de ejecutar una fila a la vez, trabaja sobre lotes de datos columnares para los tipos de datos compatibles y usa instrucciones Single Instruction Multiple Data (SIMD) para procesar múltiples valores con una sola instrucción de CPU. Así se reduce la sobrecarga de la ruta de ejecución de la JVM y se acelera el procesamiento de operaciones como scans, filtros, agregaciones, joins y ordenamientos, cuando Photon las soporta.
Photon no reemplaza a Spark, sino que actúa como una capa de ejecución nativa debajo del mismo modelo de programación de Spark. Tus consultas de Spark o SQL siguen pasando por Catalyst para la planificación, y luego las partes compatibles del plan físico pueden ejecutarse en Photon. Las operaciones no compatibles recurren al runtime estándar de Spark.
Esa última parte importa para el costo. Habilitar Photon no significa que cada operación de un job pase por Photon. La mezcla de operadores determina qué porción del workload puede usar Photon, así que hay que medirlo antes de juzgar el rendimiento o el costo.
El multiplicador de DBU y la fórmula del punto de equilibrio
Si Photon consume aproximadamente 2× los DBUs en un cluster clásico, un job necesita correr más de 2× más rápido para que la tasa de cómputo más alta se convierta en un ahorro. Ese es el umbral que debes tener presente cuando mires un benchmark de Photon.
Imagina un job que normalmente corre 60 minutos. Con una aceleración de 1.5×, Photon lo baja a 40 minutos, pero la tasa de DBU de 2× significa que igual consumes alrededor de un 33% más de DBUs. Lleva la aceleración a 3× y el job termina en 20 minutos, consumiendo cerca de dos tercios de los DBUs. Eso es aproximadamente un 33% de ahorro. En 2×, el menor tiempo de ejecución y la tasa de DBU más alta se anulan entre sí.
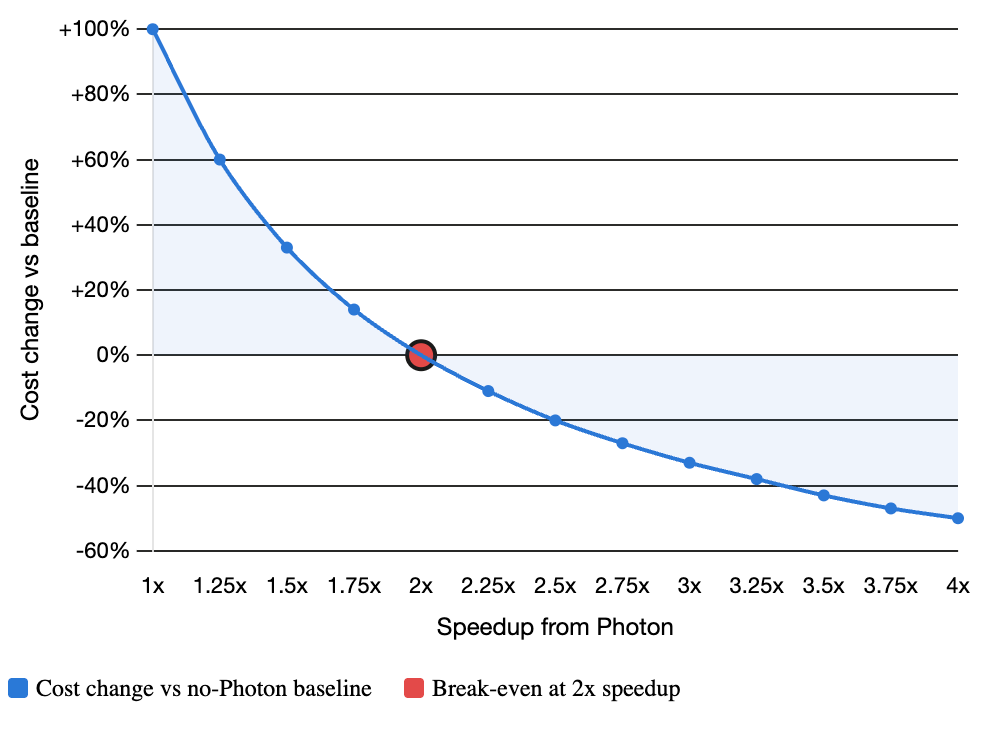
El resultado depende mucho de lo que realmente esté haciendo la consulta. Un job intensivo en scans que lee Parquet o Delta con filtros selectivos le da a Photon bastante trabajo de ejecución nativa. Lo mismo ocurre con una agregación grande sobre una tabla de hechos o un hash join donde un lado puede hacerse broadcast. Esos son los workloads donde los benchmarks publicados han mostrado aceleraciones por encima del punto de equilibrio de 2×.
El panorama cambia cuando la parte costosa del job no es algo que Photon pueda acelerar. Una UDF de Python puede devolver la ejecución a la JVM y a Python. Un job corto puede pasar más tiempo en planificación y scheduling que en ejecución real. Un shuffle amplio puede gastar su tiempo moviendo datos por la red o esperando el disco. Acelerar la porción de CPU no ayuda mucho cuando la CPU no es lo que el job está esperando.
La tabla a continuación pone en contexto el punto de equilibrio de 2×, mostrando qué tipos de workloads probablemente lo superen y cuáles no.
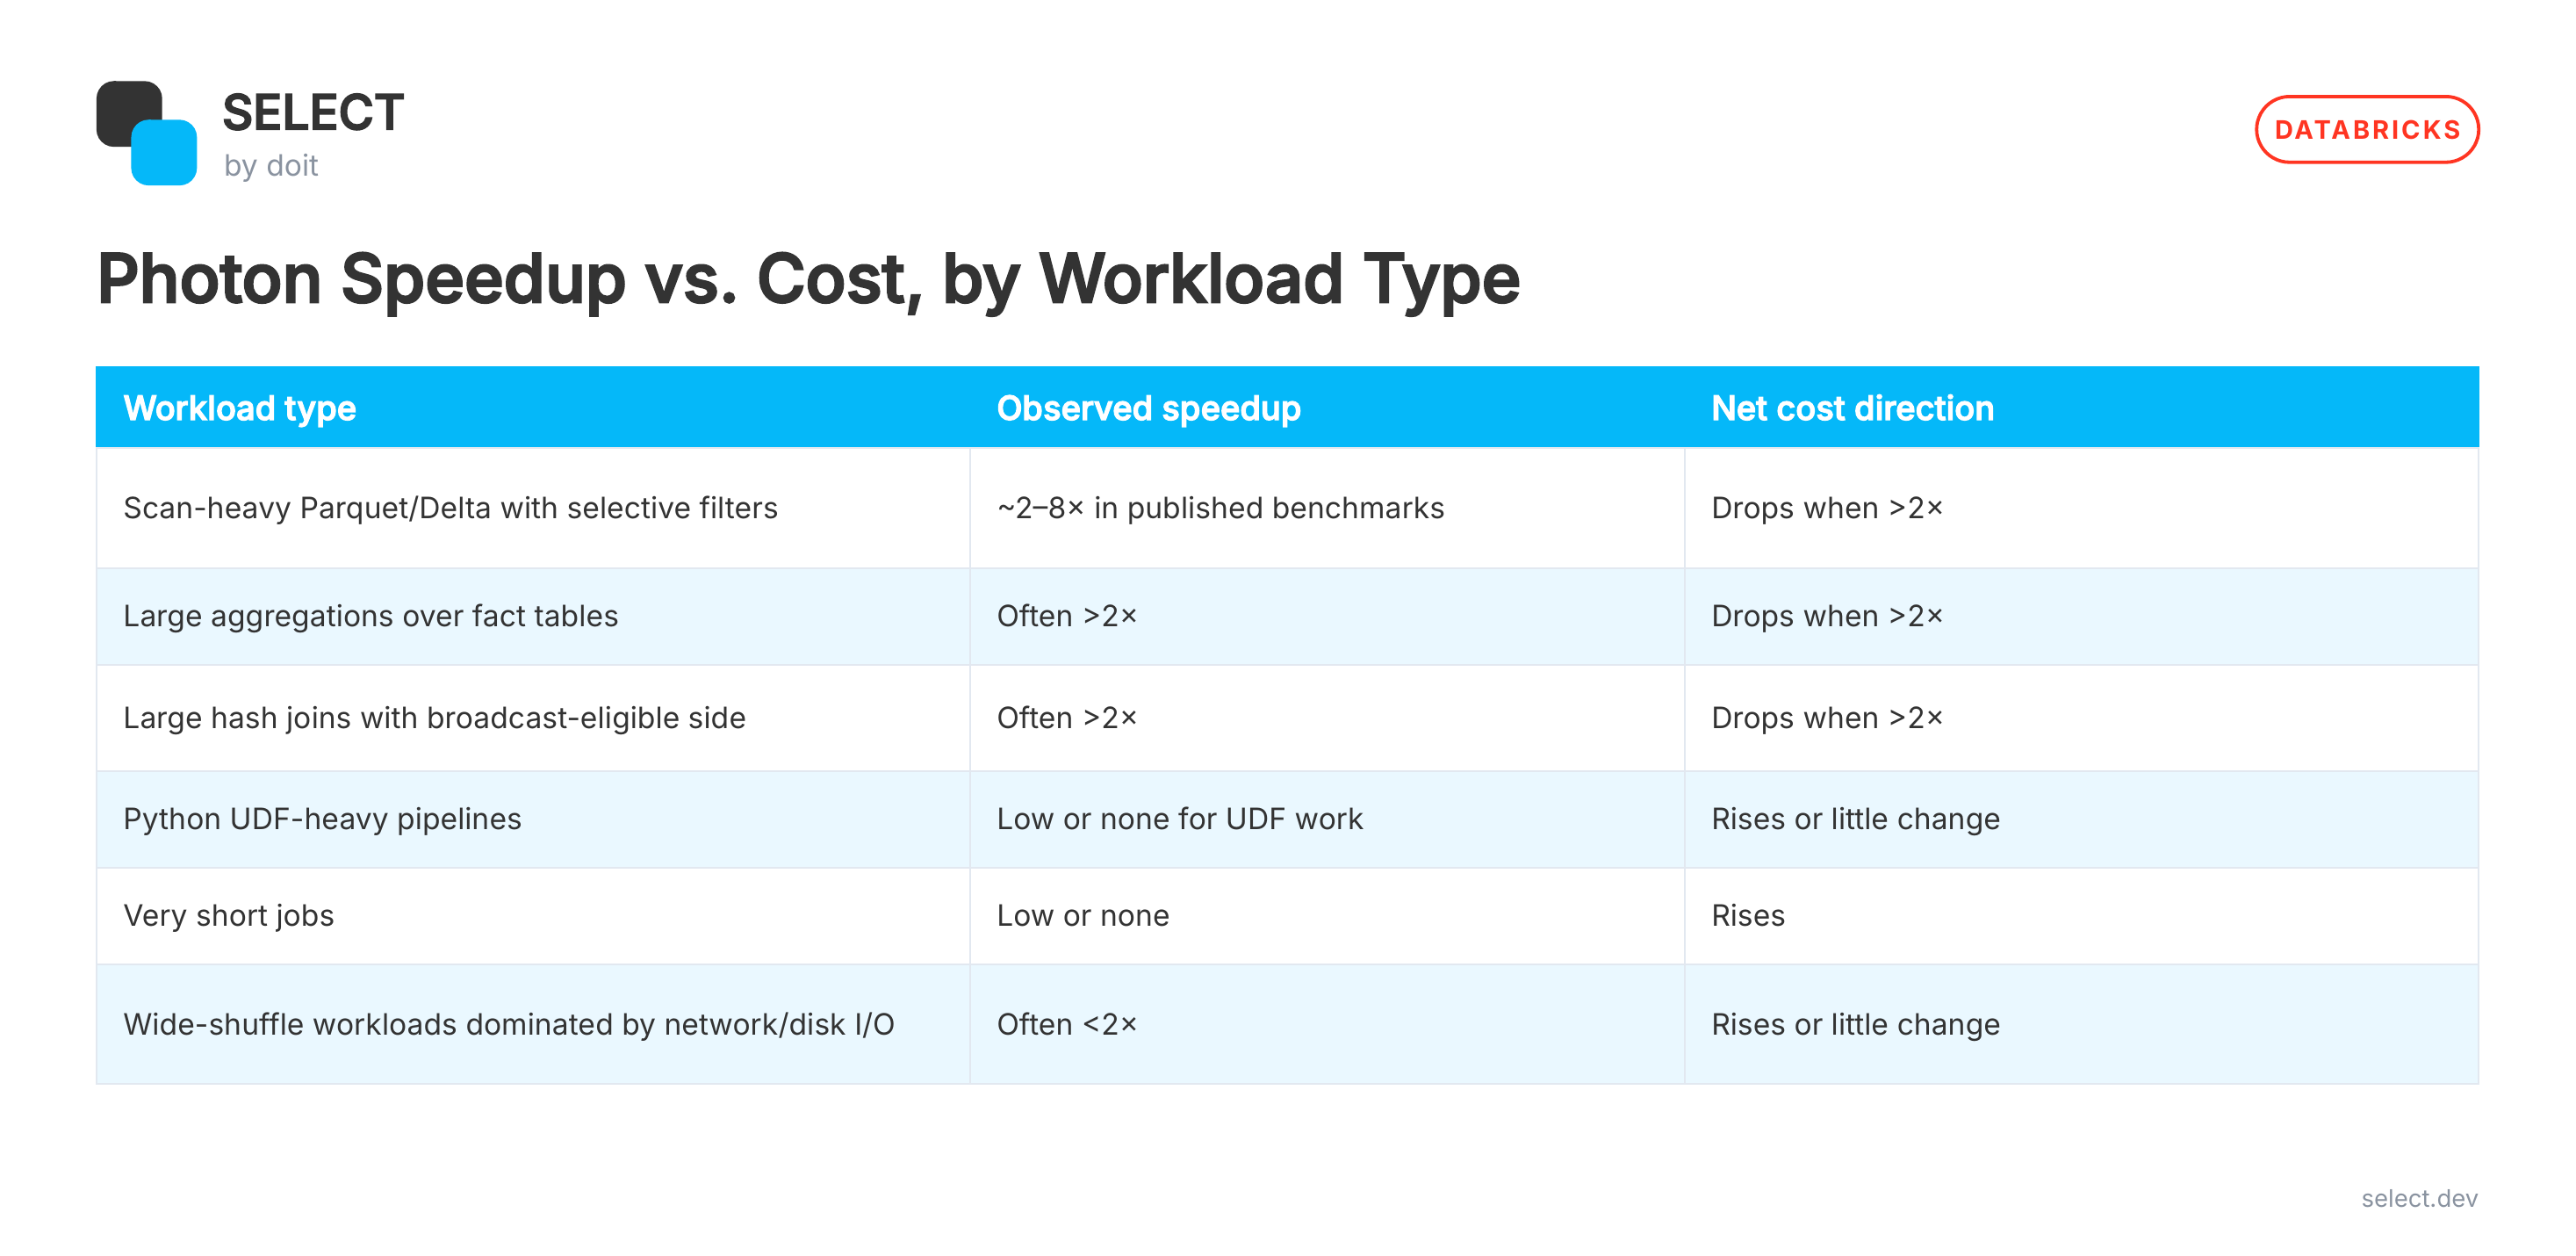
La dirección del costo asume un multiplicador de DBU de Photon de aproximadamente 2× sobre el cómputo equivalente en clusters clásicos. Las tasas reales de DBU varían según el tipo de instancia, así que la aceleración medida es lo que determina el resultado.
El umbral de 2× te da el cálculo. El plan de ejecución te dice si tu job tiene posibilidades reales de superarlo.
Cobertura de operadores: qué se ejecuta de forma nativa y qué hace fallback¿Qué operadores ejecuta Photon de forma nativa y cuáles hacen fallback?
Photon no ejecuta todos los operadores de Spark. Algunos corren de forma nativa y otros recurren a la JVM. Y sigues pagando la tasa de cómputo con Photon habilitado incluso cuando la parte costosa del workload no se ejecuta de forma nativa.
Imagina una consulta que lee una tabla grande de Delta Lake, filtra la mayoría de las filas, agrega lo que queda y une el resultado con otra tabla. Esas son el tipo de operaciones donde Photon tiene trabajo real de CPU que optimizar. Ahora mete una UDF de Python en el medio. Esa pieza toma una ruta de ejecución diferente, y si la UDF es donde el job pasa la mayor parte del tiempo, Photon no toca el cuello de botella. Un cluster con Photon habilitado no significa que toda la consulta se ejecute en Photon. El plan físico decide qué partes realmente lo hacen.
Para workloads de datos comunes, Photon puede ejecutar de forma nativa scans de Parquet y Delta, filtros, proyecciones, agregaciones y hash joins. Las funciones de ventana y los ordenamientos también son compatibles, junto con operaciones comunes de strings. Las UDFs de Python y Scala hacen fallback, mientras que algunas operaciones de regex, MAP``/``STRUCT, sinks de streaming y CSV/JSON dependen de la operación específica y de la versión de Databricks Runtime. Donde puedas, reemplaza una UDF por una función integrada de Spark SQL para mantener más trabajo en la ruta nativa. Si el tiempo de scan domina el job, la forma en que están organizadas tus tablas afecta lo que Photon tiene que escanear. Vale la pena mirar Liquid Clustering para ese lado del problema.
La tabla a continuación muestra los workloads que Photon puede ejecutar de forma nativa y dónde hace fallback:
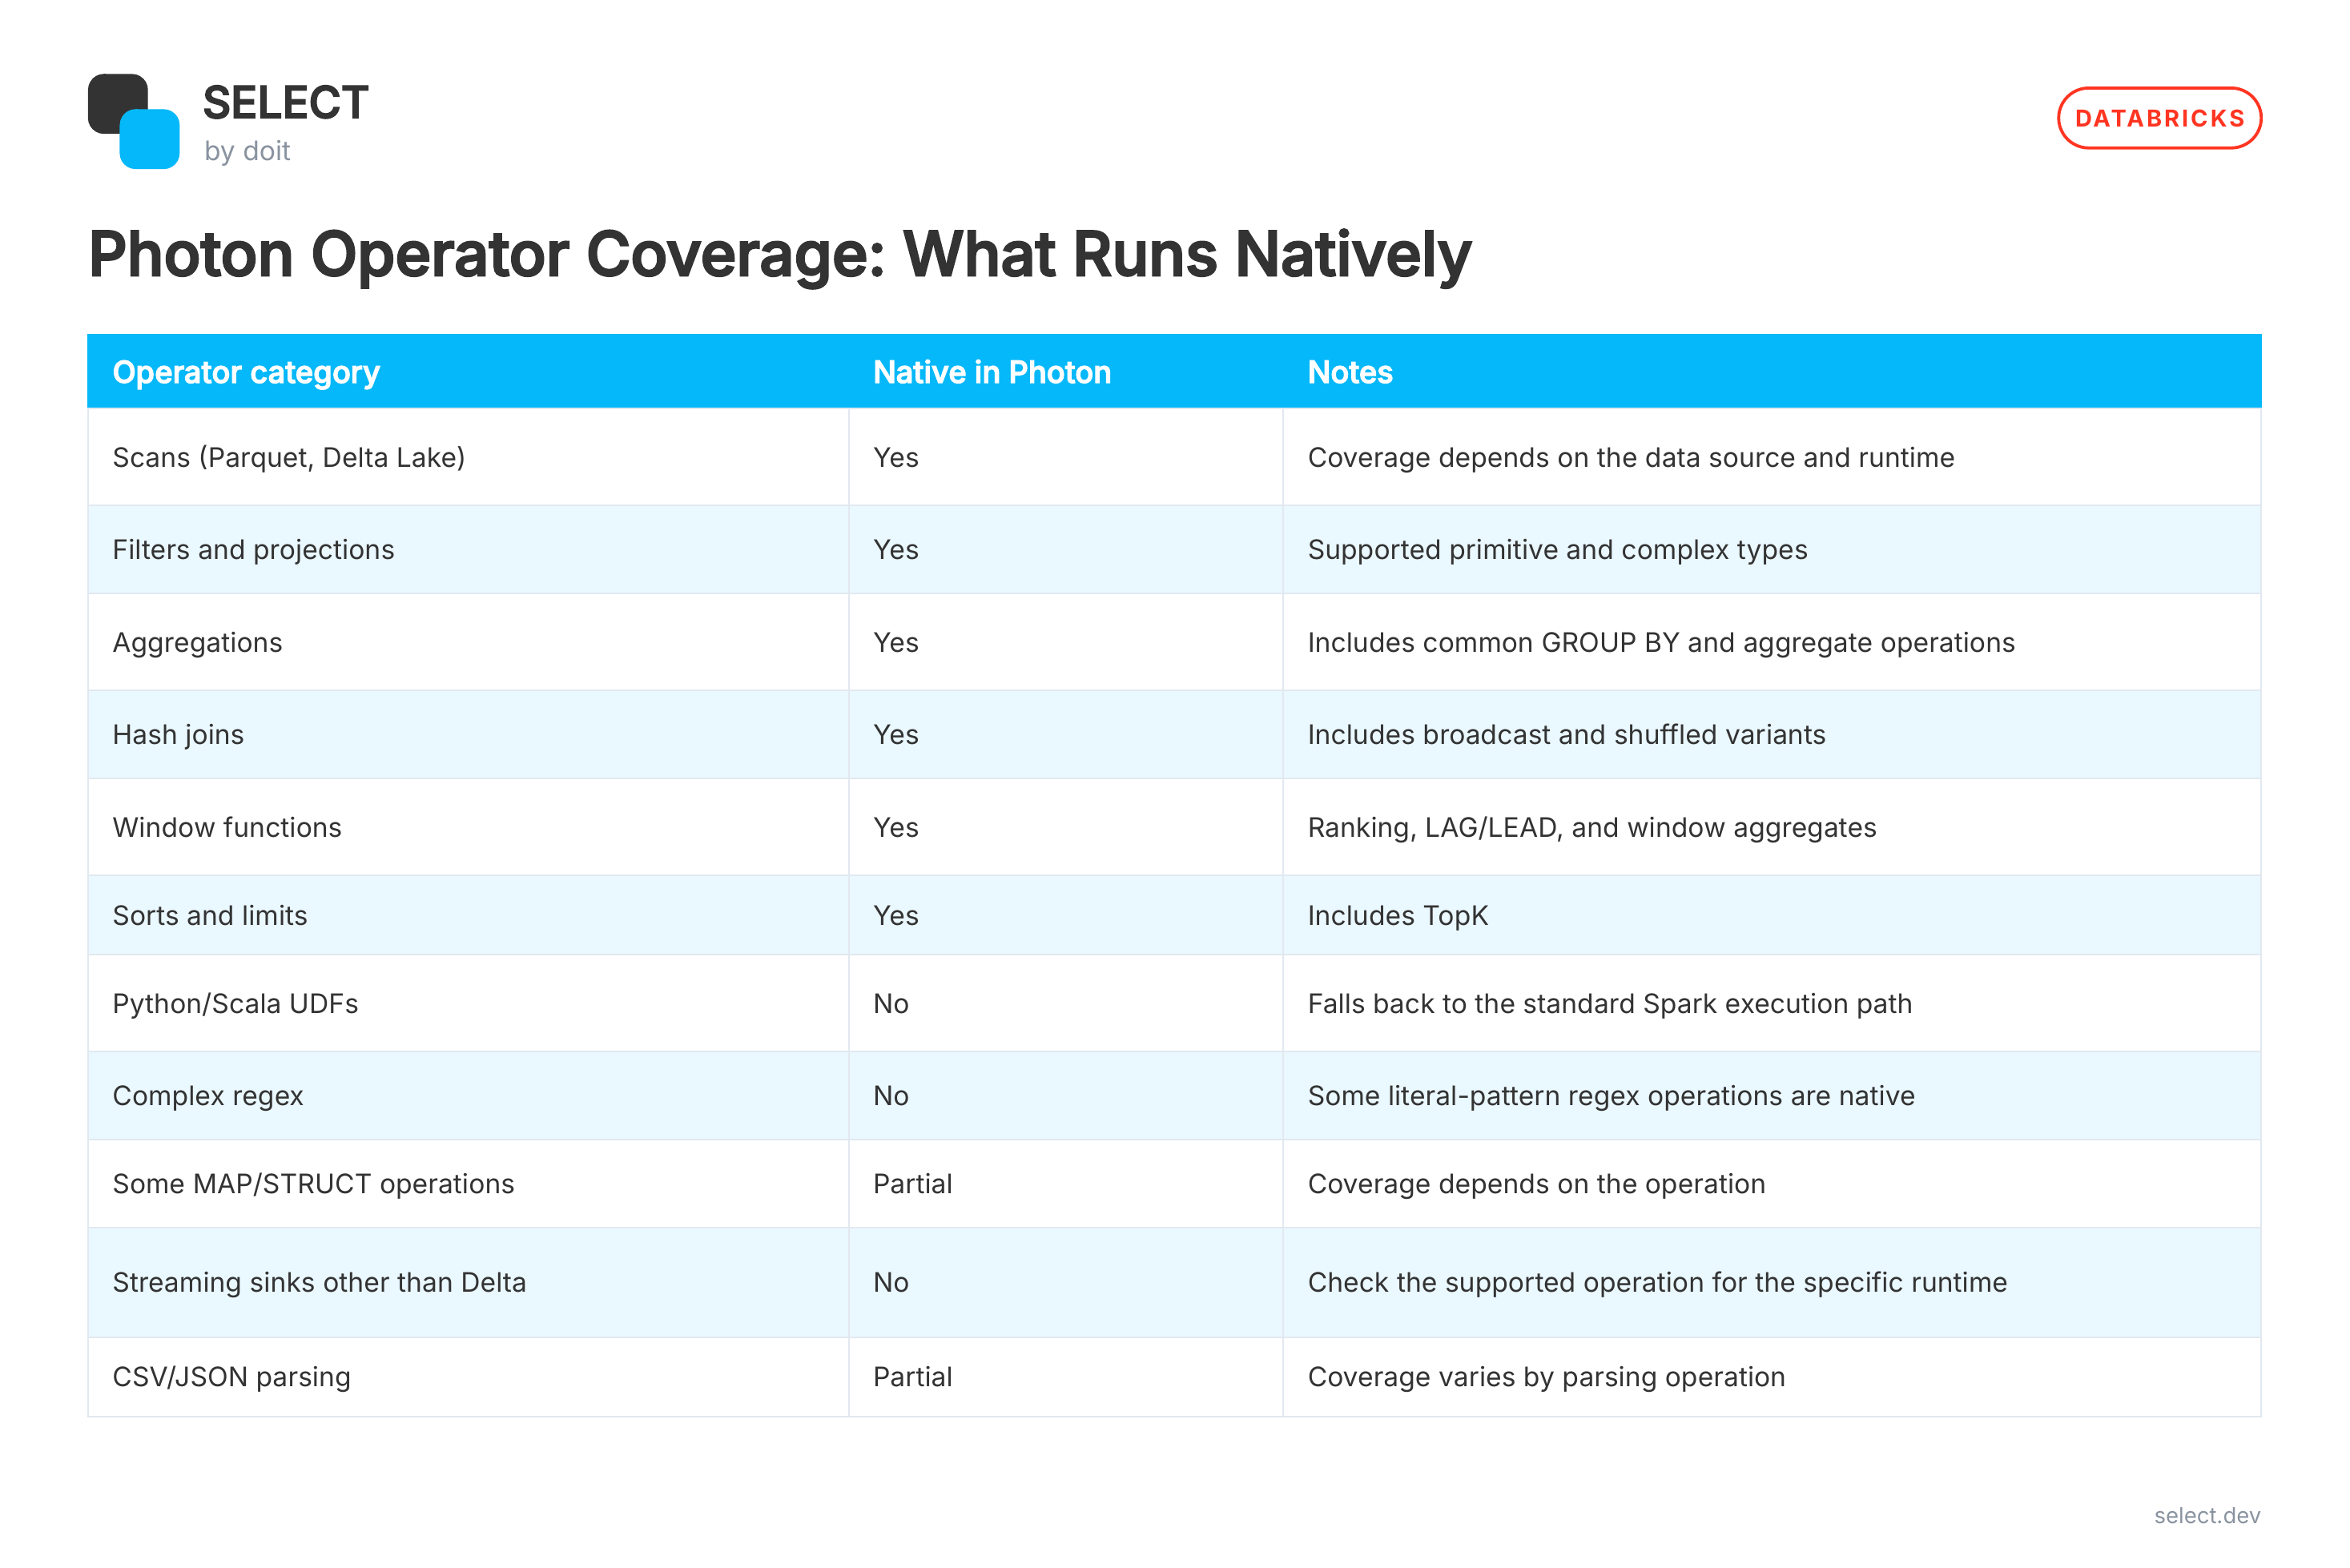
El query profile y el plan físico muestran qué pasó en tu propio job. Identifica los operadores que consumen la mayor parte del tiempo de ejecución y luego verifica si pasaron por Photon o hicieron fallback. Esa es la evidencia que necesitas para saber si Photon realmente ayudó.
Cómo se comporta Photon en las distintas superficies de cómputo
Dónde ejecutas el workload cambia cómo se configura Photon y cómo funciona la facturación. Eso importa cuando el mismo job se mueve entre un cluster clásico, un SQL warehouse y serverless, y de repente los números no cuadran.
Con los SQL warehouses de Databricks, Photon viene habilitado por defecto en el nivel Classic. Los niveles Pro y Serverless son exclusivamente Photon. Así que, si ejecutas analítica SQL, no tiene mucho sentido preguntarse si Photon está habilitado. La mejor pregunta es qué dice el query profile y si el trabajo que Photon realmente está haciendo alcanza para justificar el cómputo.
Cómo habilitar Photon en clusters clásicos
En clusters clásicos, Photon está habilitado por defecto para el cómputo all-purpose y de jobs, y la opción Use Photon Acceleration lo desactiva. Si creas el cómputo a través de la API, puedes establecer runtime_engine: "PHOTON" de forma explícita. El tipo de instancia aún necesita ser compatible con Photon.
La comparación de 2× DBU de antes es especialmente útil en clusters clásicos. Si quieres entender qué le está haciendo Photon a un job de ETL recurrente, ejecuta el mismo workload en el mismo tipo de instancia con y sin Photon. Mira tanto el tiempo de ejecución como los DBUs. Un job más rápido solo es interesante si se acelera lo suficiente como para pagar la tasa más alta.
Photon en cómputo serverless
En cómputo serverless, Photon está habilitado por defecto, pero no administras un cluster, no eliges la familia de VM ni activas o desactivas el runtime. Databricks se encarga de esa capa por ti. El detalle es que serverless usa un modelo de precios diferente, así que el cálculo de 2× del cluster clásico no se traslada directamente. Lakebase corre sobre ese mismo modelo serverless, algo que conviene tener presente si lo estás cotizando junto a workloads de Photon en clusters clásicos; las estructuras de precios no son las mismas.
La diferencia de precios importa cuando los workloads se mueven entre superficies de cómputo. El motor puede ser el mismo mientras la economía cambia por debajo. Que un job sea barato en un cluster clásico con Photon habilitado no significa que moverlo a serverless produzca el mismo perfil de costo. La superficie de cómputo es parte del cálculo. Si estás haciendo ese cálculo en todo tu entorno de Databricks, Databricks Cost Optimization cubre las otras palancas, desde la terminación automática y el dimensionamiento del cómputo hasta la organización de tablas y la gobernanza.
Cómo leer el query profile para medir la cobertura de Photon
Si quieres saber si Photon realmente mejoró el rendimiento, empieza por el query profile, no por el tiempo transcurrido. El perfil muestra dónde pasó su tiempo el workload y qué partes del plan usaron el motor.
Un workload puede terminar antes y aun así decirte muy poco sobre la economía. Si la mayor parte del tiempo de tareas se fue en scans, joins o agregaciones nativas de Photon, la aceleración tiene una explicación clara. Si los operadores costosos hicieron fallback a la ruta de ejecución estándar, o la mayor parte del tiempo se fue en shuffle e I/O, el motor no está haciendo mucho por la parte que importa.
Así se ve en el query profile:
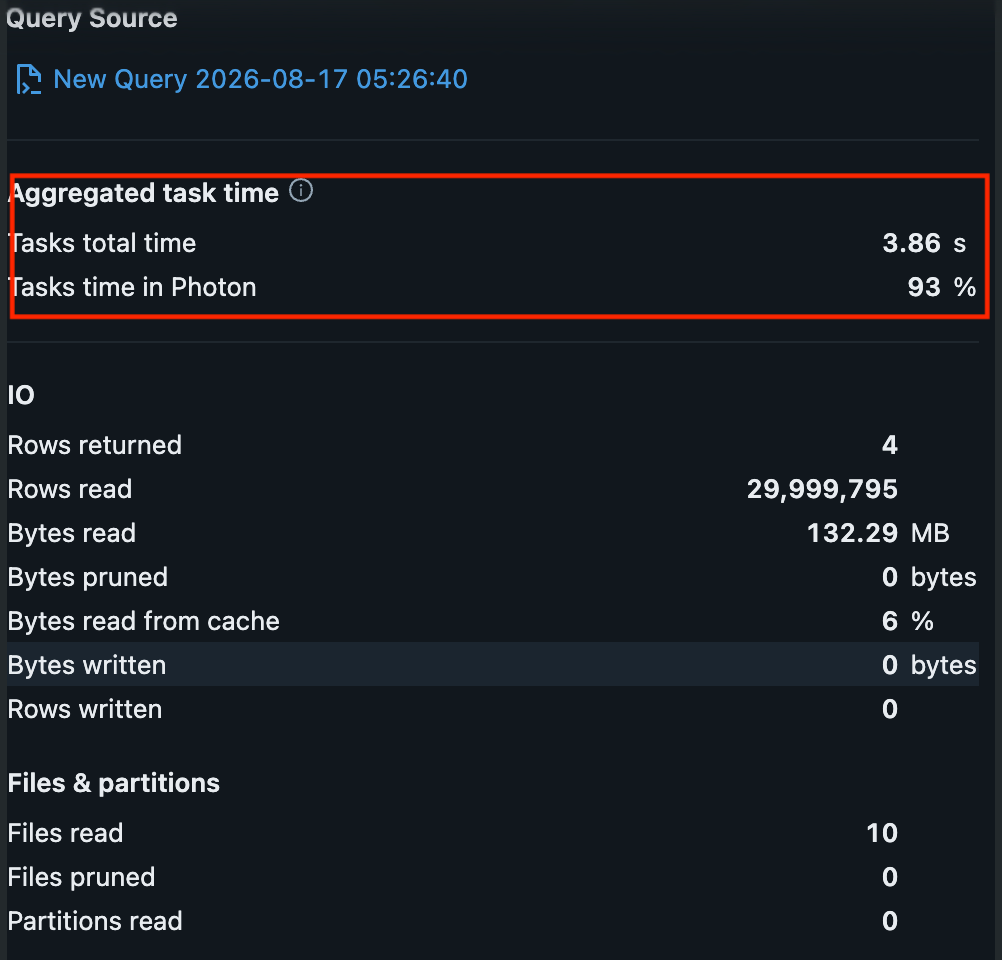
En este ejemplo, el 93% del tiempo de tareas pasó por Photon. La consulta leyó 29,999,795 filas en 10 archivos, con 3.86 segundos de tiempo total de tareas. Es una señal clara de que Photon manejó la mayor parte de la ejecución de las tareas.
El número importante no es solo el porcentaje. Mira también qué estaba haciendo realmente la consulta. Ese resultado del 93% es una victoria clara porque los operadores costosos, el scan y la agregación, corrieron ambos de forma nativa. No siempre se verá tan claro. Supón que otra consulta pasa el 70% de su tiempo en una UDF de Python o esperando un shuffle amplio. Activar Photon ahí no toca el cuello de botella real, sin importar cómo se vea el tiempo de ejecución después. El porcentaje solo te dice algo cuando sabes qué está midiendo.
Ahí es también donde rinde la cobertura de operadores de la sección anterior: no se trata de contar cuántos operadores usan Photon, sino de encontrar a dónde se fue realmente el tiempo de tareas.
Así también se explican a posteriori los resultados sorprendentes. Un job puede mostrar una mejora significativa en tiempo de ejecución mientras la mayor parte del trabajo costoso queda fuera de Photon. Otro puede lograr una ganancia mayor porque sus operadores más grandes corren de forma nativa. La misma métrica de tiempo de ejecución, razones distintas por debajo, y el perfil es lo que te dice cuál de los dos casos estás viendo.
Para workloads recurrentes de ETL y SQL, esta es la verificación que debes hacer antes de decidir si Photon se gana sus DBUs: encuentra los operadores costosos, mira qué ruta tomaron y conéctalo de vuelta con el tiempo de ejecución y el costo.
Medir el costo de Photon con SELECT
Un workload más rápido con Photon no es automáticamente más barato. Necesitas conectar la mejora en el tiempo de ejecución con los DBUs y el costo de infraestructura antes de darlo por ganado.
SELECT te permite rastrear el gasto de Databricks hasta los jobs, clusters y warehouses, con el consumo de DBU y los costos de infraestructura subyacentes en la misma vista. Para un job de ETL recurrente, compara ejecuciones equivalentes antes y después del cambio a Photon. Compara rendimiento, DBUs y costo total en conjunto. Si el job termina más rápido pero la tasa más alta de Photon eleva el costo, la aceleración no se pagó por sí sola. La misma atribución cubre los costos de servir modelos de IA en Agent Bricks si Photon es solo una pieza de un workload más grande.
La tasa de 2x DBU de antes te da la línea base. Un workload en un cluster clásico necesita aproximadamente una aceleración de 2x para alcanzar el punto de equilibrio. SELECT te da los datos de uso y costo a nivel de job para ver dónde cae realmente tu workload, en lugar de estimarlo solo a partir del tiempo de ejecución.
El query profile muestra dónde ayudó el motor. SELECT muestra los DBUs y el costo de infraestructura detrás de esa mejora. Juntos, muestran si un workload recurrente de ETL o SQL se está volviendo más barato a medida que se acelera. Agenda una demo para hacer esa comparación con tus propios jobs con Photon habilitado.
Preguntas frecuentes
¿Photon funciona con mi código de Spark existente?
Sí. Photon corre debajo del mismo modelo de programación de Spark, así que no necesitas reescribir tus jobs de Spark para usarlo. Tus workloads existentes de DataFrame y SQL pueden usar Photon cuando su plan físico se mapea a operadores nativos compatibles. Lo principal que debes verificar es la cobertura de operadores, especialmente si tu pipeline depende mucho de UDFs u otras operaciones que hacen fallback a la ruta de ejecución estándar de Spark.
¿Por qué mis UDFs de Python no son más rápidas con Photon habilitado?
Como Photon no ejecuta UDFs arbitrarias de Python de forma nativa, la UDF corre a través de la ruta de ejecución estándar de Spark y Python, así que Photon no puede optimizar el código Python en sí. Si la UDF es tu cuello de botella, habilitar Photon no cambiará mucho. Donde sea posible, reemplaza la UDF por una función SQL integrada. Si una UDF de Python es inevitable, una pandas_udf puede reducir parte de la sobrecarga Python/JVM, pero no hace que la UDF sea nativa de Photon.
¿Cómo verifico qué porcentaje de mi consulta se ejecutó en Photon?
Abre el query profile de la consulta completada y ve a Aggregated task time → Tasks time in Photon. Ese porcentaje te dice cuánto tiempo de tareas pasó por Photon. Luego revisa el desglose de operadores para ver a dónde se fue el tiempo restante. El porcentaje por sí solo no basta. También necesitas saber si Photon manejó la parte costosa del workload.
¿Photon cuesta más que el Databricks Runtime estándar?
En clusters clásicos, sí. El cómputo con Photon habilitado tiene una tasa de DBU más alta que el cómputo equivalente sin Photon. El multiplicador exacto depende del tipo de instancia, pero aproximadamente 2× es el número útil para el cálculo de costos. Eso significa que el workload necesita aproximadamente una aceleración de 2× para alcanzar el punto de equilibrio.
¿Photon soporta aceleración por GPU?
No. Photon es un motor de ejecución nativa basado en CPU, no un motor de ejecución en GPU. Acelera las operaciones de Spark compatibles usando ejecución nativa en CPU. Si tu workload requiere cómputo en GPU para machine learning u otro workload específico de GPU, Photon no reemplaza el cómputo con GPU habilitada.