
O Photon é um dos vários fatores de custo do Databricks que vale a pena entender antes de otimizar um workload.
Em clusters clássicos, o compute com Photon habilitado consome Databricks Units (DBUs) a aproximadamente o dobro da taxa do compute equivalente sem Photon, embora o multiplicador exato varie conforme o tipo de instância. Alguns workloads terminam rápido o suficiente para compensar essa taxa maior de DBU. Outros ficam mais rápidos e, mesmo assim, custam mais — ou seja, o tempo de execução sozinho não diz se o Photon está economizando dinheiro.
A LakeSentry, em uma análise do pricing do Databricks reportada pela comunidade, aponta o Photon como um dos fatores por trás de surpresas de custo que a tabela de preços não deixa óbvias. O consumo extra de DBU só vale a pena quando o workload ganha velocidade suficiente em troca.
Este guia foca no Databricks Photon: como ele afeta o custo, onde fica o ponto de break-even e como saber se habilitá-lo torna um workload mais barato.
TL;DR
- Em clusters clássicos, o Photon precisa de mais de 2× de speedup para compensar sua taxa maior de DBU.
- Scans, agregações e joins conseguem superar esse limiar, enquanto UDFs em Python, jobs curtos e workloads com shuffle amplo costumam ficar abaixo dele.
- Você paga a taxa do Photon mesmo quando apenas parte do workload roda pelo Photon.
- Verifique a cobertura do Photon no painel Aggregated task time do query profile e depois compare os totais reais de DBU antes e depois de habilitar o Photon.
O que é o Databricks Photon?
O Databricks Photon é uma engine de consultas que melhora a performance do processamento de dados do Spark com suporte. Ela executa as operações suportadas em C++ nativo, enquanto o otimizador Catalyst do Spark continua cuidando do planejamento das consultas.
Uma diferença importante é a forma como o Photon processa os dados. Em vez de executar uma linha por vez, ele trabalha com lotes de dados colunares entre os tipos de dados suportados e usa instruções Single Instruction Multiple Data (SIMD) para processar vários valores com uma única instrução de CPU. Isso reduz o overhead do caminho de execução da JVM e acelera o processamento de operações como scans, filtros, agregações, joins e ordenações, quando o Photon as suporta.
O Photon não substitui o Spark; ele atua como uma camada de execução nativa por baixo do mesmo modelo de programação do Spark. Suas queries em Spark ou SQL continuam passando pelo Catalyst para o planejamento, e aí as partes suportadas do plano físico podem rodar no Photon. Operações sem suporte caem de volta para o runtime padrão do Spark.
Essa última parte importa para o custo. Habilitar o Photon não significa que toda operação de um job roda pelo Photon. O mix de operadores determina quanto do workload pode usar o Photon, então você precisa medir isso antes de julgar performance ou custo.
O multiplicador de DBU e a matemática do break-even
Se o Photon consome aproximadamente 2× os DBUs em um cluster clássico, um job precisa rodar mais de 2× mais rápido para que a taxa de compute mais alta vire economia. É essa a linha para ter em mente ao olhar um benchmark do Photon.
Pegue um job que normalmente roda por 60 minutos. Com speedup de 1,5×, o Photon reduz para 40 minutos, mas a taxa de 2× em DBU significa que você ainda consome cerca de 33% mais DBUs. Leve o speedup para 3×, e o job termina em 20 minutos, consumindo cerca de dois terços dos DBUs. Isso dá aproximadamente 33% de economia. Em 2×, o tempo de execução menor e a taxa maior de DBU se anulam.
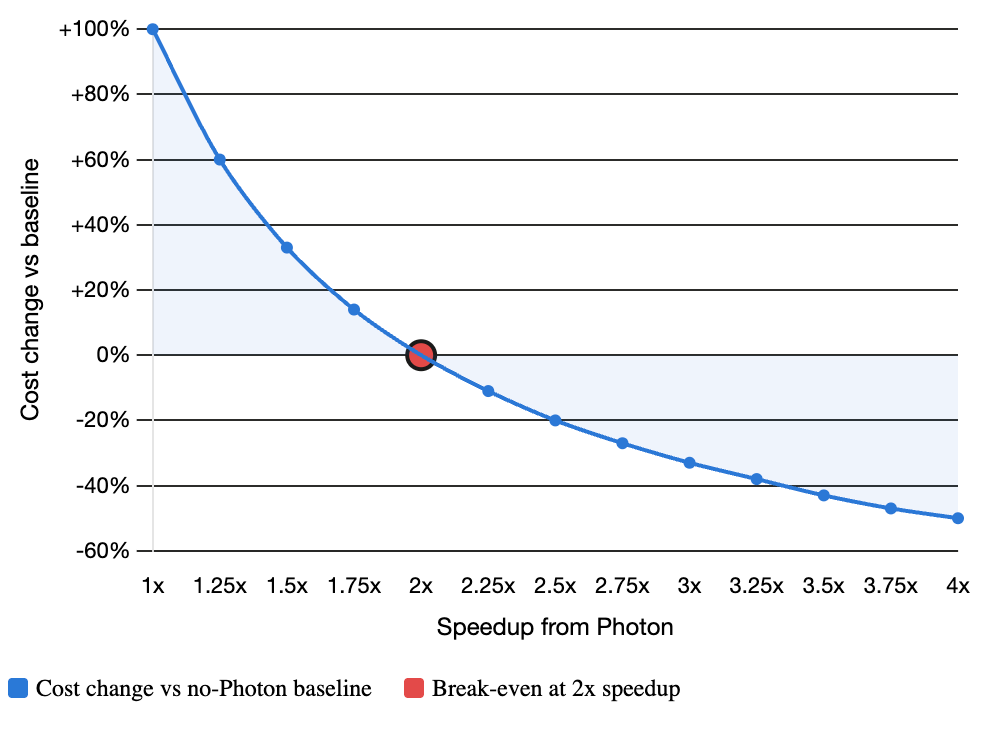
Onde você vai parar depende muito do que a query está realmente fazendo. Um job pesado em scans, lendo Parquet ou Delta com filtros seletivos, dá ao Photon bastante trabalho de execução nativa. O mesmo vale para uma agregação grande sobre uma tabela fato ou um hash join em que um dos lados pode ser enviado via broadcast. Esses são os workloads em que benchmarks publicados mostraram speedups acima do ponto de break-even de 2×.
O cenário muda quando a parte cara do job não é algo que o Photon consegue acelerar. Uma UDF em Python pode empurrar a execução de volta pela JVM e pelo Python. Um job curto pode gastar mais tempo em planejamento e agendamento do que em execução de fato. Um shuffle amplo pode passar o tempo todo movendo dados pela rede ou esperando por disco. Deixar a parte de CPU mais rápida não ajuda muito quando não é a CPU que está travando o job.
A tabela abaixo coloca o ponto de break-even de 2× em contexto, mostrando quais perfis de workload têm chance de superá-lo e quais não.
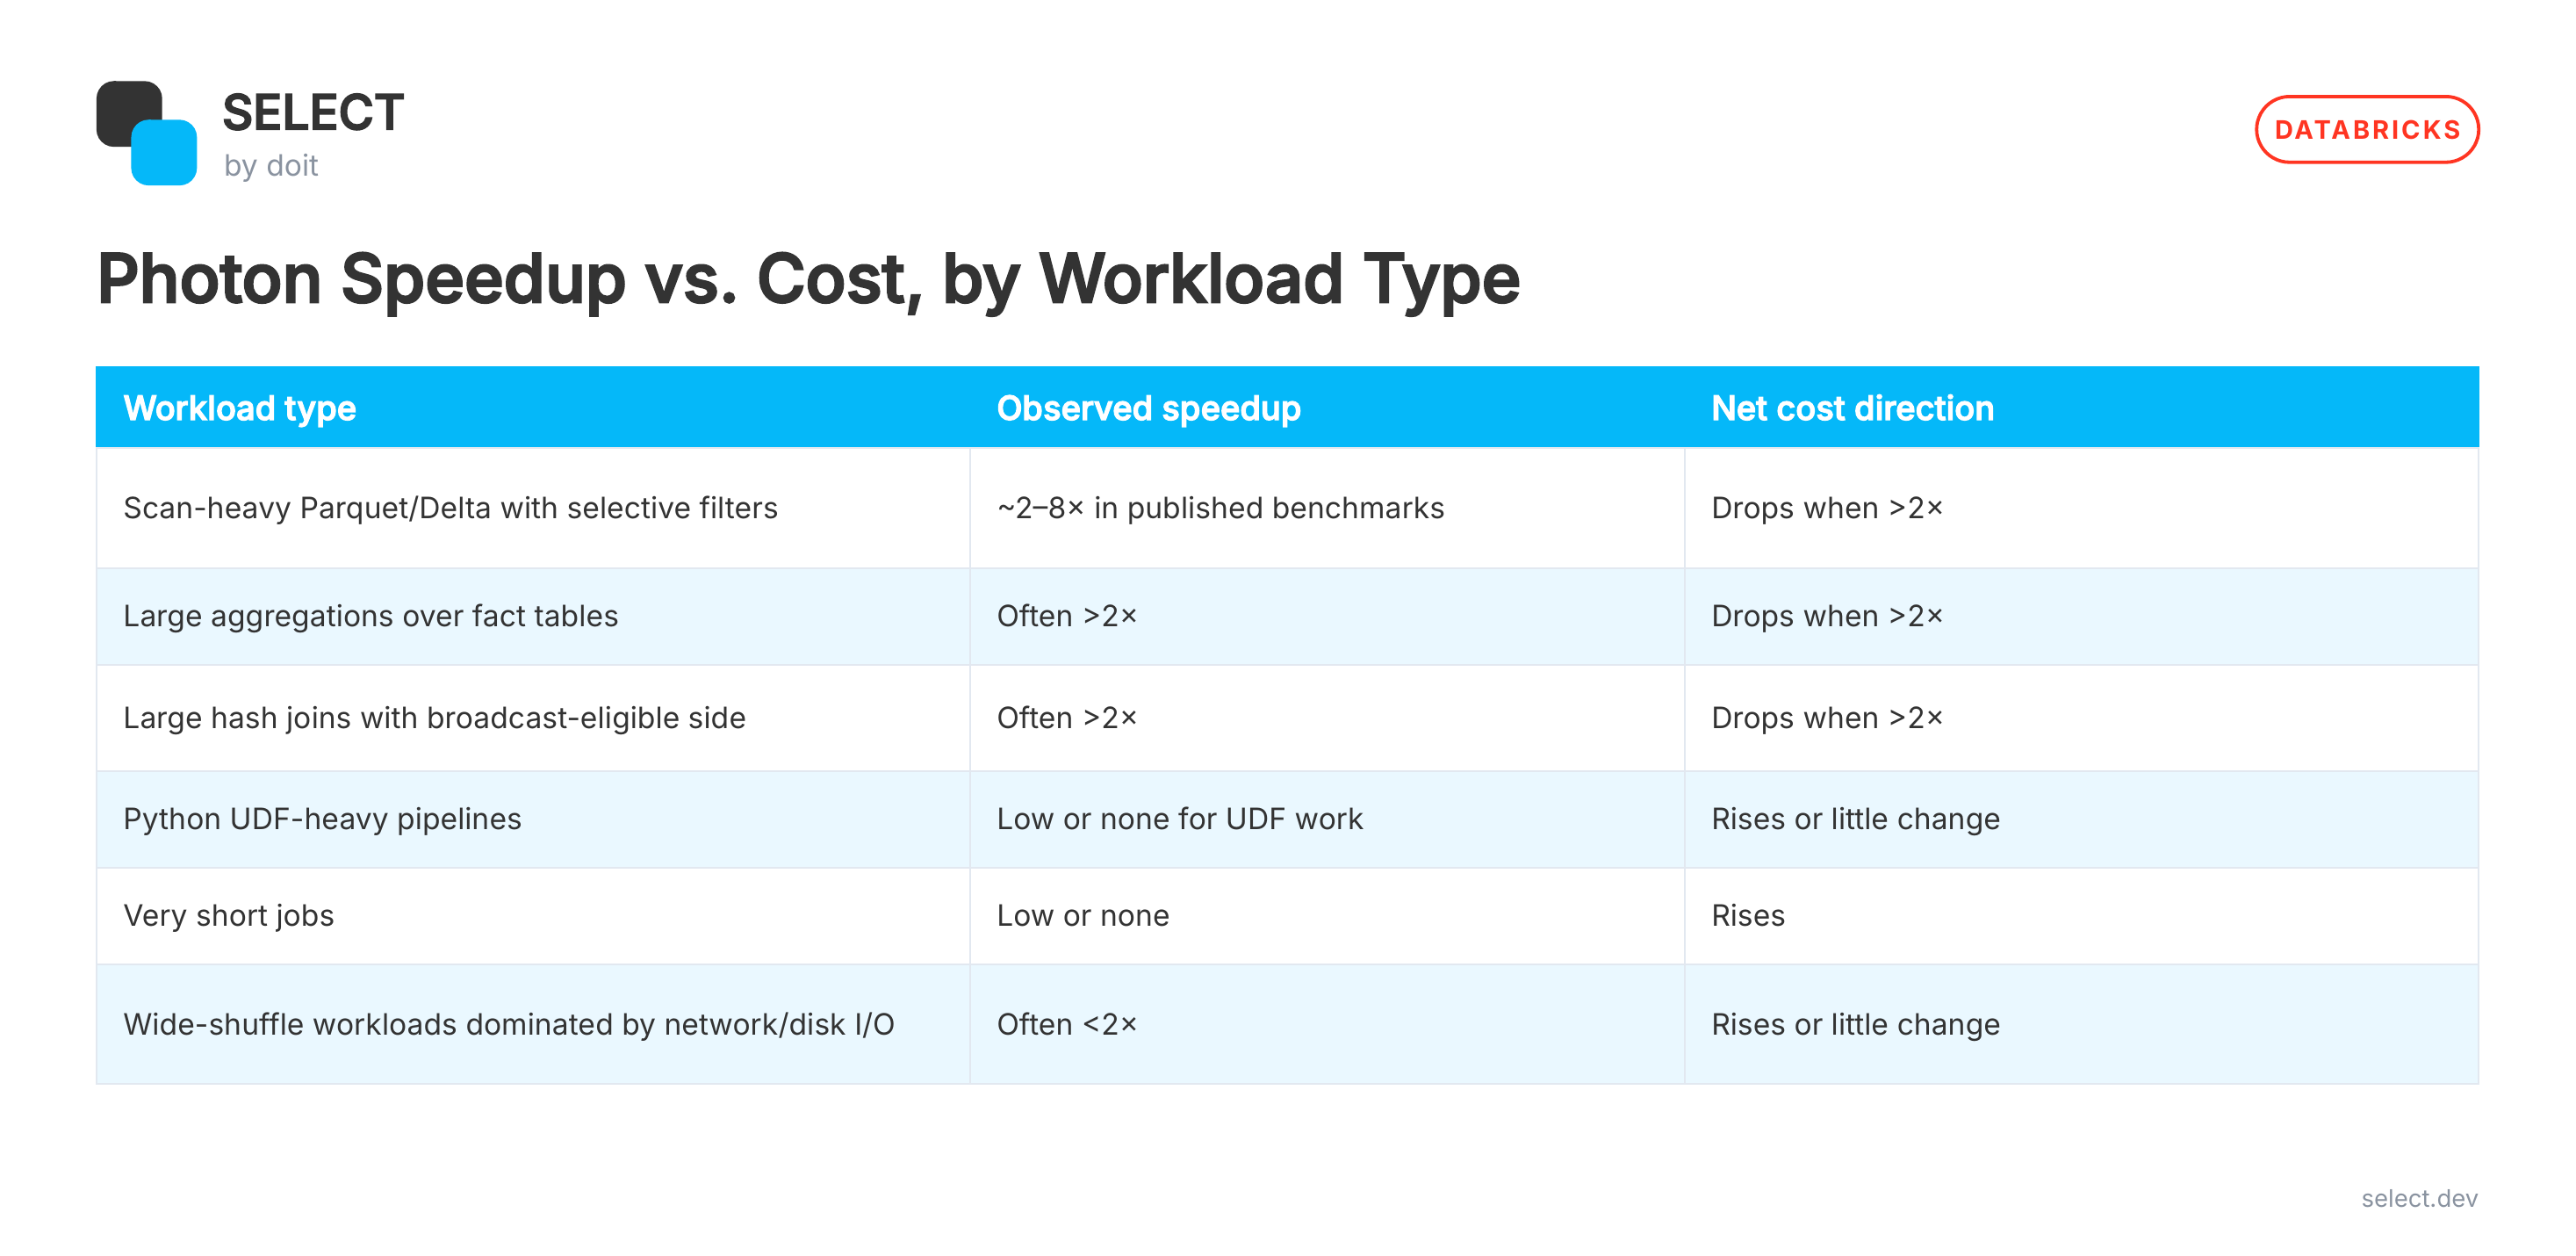
A direção do custo assume um multiplicador de DBU do Photon de aproximadamente 2× sobre o compute equivalente em cluster clássico. As taxas reais de DBU variam por tipo de instância, então é o speedup medido que determina o resultado.
O limiar de 2× dá a você a matemática. O plano de execução diz se o seu job tem chance real de superá-lo.
Cobertura de operadores: o que roda nativamente e o que faz fallbackQuais operadores o Photon executa nativamente e quais fazem fallback?
O Photon não executa todos os operadores do Spark. Alguns rodam nativamente e outros fazem fallback para a JVM. Você continua pagando a taxa de compute com Photon habilitado mesmo quando a parte cara do workload não está rodando nativamente.
Pegue uma query que lê uma tabela grande do Delta Lake, filtra a maioria das linhas, agrega o que sobra e faz join do resultado com outra tabela. Esses são os tipos de operação em que o Photon tem trabalho real de CPU para otimizar. Agora coloque uma UDF em Python no meio. Esse trecho segue um caminho de execução diferente, e se a UDF é onde o job gasta a maior parte do tempo, o Photon não toca no gargalo. Um cluster com Photon habilitado não significa que a query inteira roda no Photon. É o plano físico que decide quais partes realmente rodam.
Para workloads de dados comuns, o Photon consegue executar nativamente scans de Parquet e Delta, filtros, projeções, agregações e hash joins. Funções de janela e ordenações também têm suporte, junto com operações comuns de string. UDFs em Python e Scala fazem fallback, enquanto algumas operações de regex, MAP``/``STRUCT, sinks de streaming e CSV/JSON dependem da operação específica e da versão do Databricks Runtime. Sempre que possível, substitua uma UDF por uma função nativa do Spark SQL para manter mais trabalho no caminho nativo. Se o tempo de scan domina o job, a forma como suas tabelas estão organizadas afeta o que o Photon precisa escanear. Vale dar uma olhada no Liquid Clustering para esse lado do problema.
A tabela abaixo mostra os workloads que o Photon consegue executar nativamente e onde ele faz fallback:
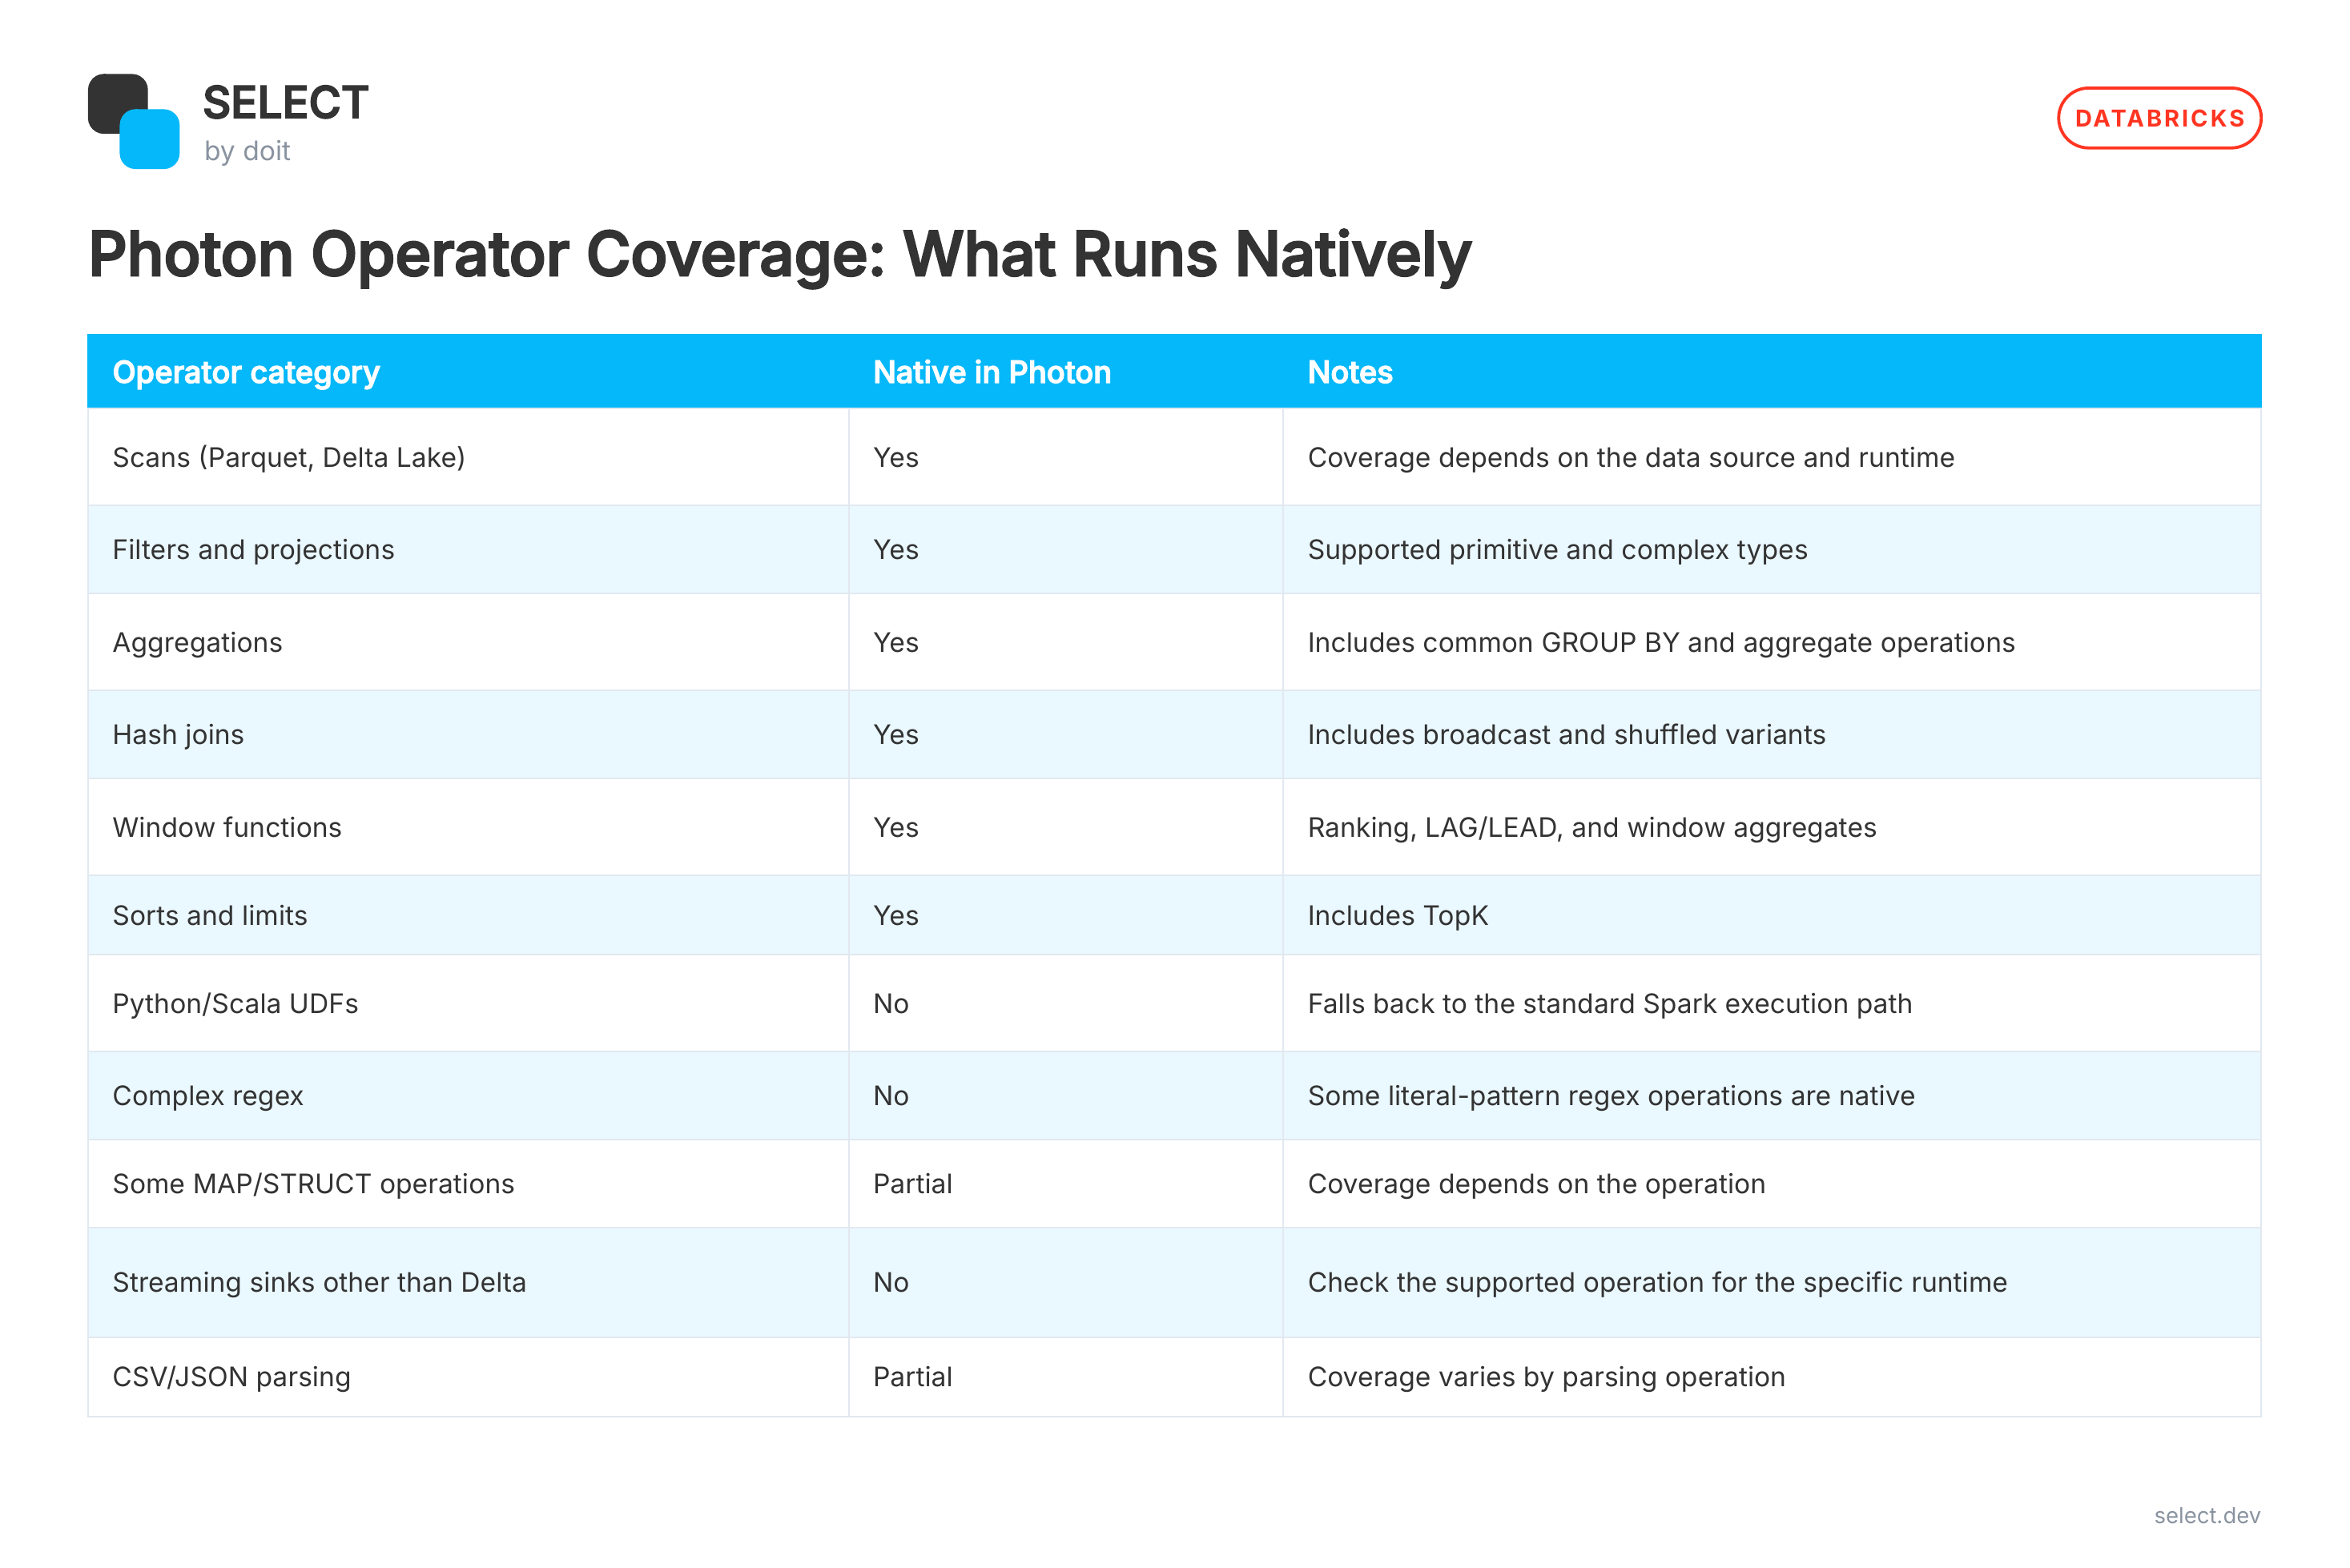
O query profile e o plano físico mostram o que aconteceu no seu próprio job. Encontre os operadores que consomem mais tempo de execução e verifique se eles rodaram pelo Photon ou fizeram fallback. Essa é a evidência de que você precisa para saber se o Photon realmente ajudou.
Como o Photon se comporta nas diferentes superfícies de compute
Onde você roda o workload muda como o Photon é configurado e como funciona a cobrança. Isso importa quando o mesmo job passa de um cluster clássico para um SQL warehouse e para serverless e, de repente, os números não batem.
Nos SQL warehouses do Databricks, o Photon vem habilitado por padrão no tier Classic. Os tiers Pro e Serverless são exclusivamente Photon. Então, se você está rodando analytics em SQL, não faz muito sentido perguntar se o Photon está habilitado. A pergunta melhor é o que o query profile diz e se o trabalho que o Photon está de fato fazendo é suficiente para justificar o compute.
Como habilitar o Photon em clusters clássicos
Em clusters clássicos, o Photon vem habilitado por padrão para compute all-purpose e de jobs, e a configuração Use Photon Acceleration o desativa. Se você está criando compute via API, pode definir runtime_engine: "PHOTON" explicitamente. O tipo de instância ainda precisa suportar Photon.
A comparação de 2× em DBU vista antes é especialmente útil em clusters clássicos. Se você quer entender o que o Photon está fazendo com um job de ETL recorrente, rode o mesmo workload no mesmo tipo de instância com e sem Photon. Olhe tanto o tempo de execução quanto os DBUs. Um job mais rápido só é interessante se ficar rápido o suficiente para pagar pela taxa mais alta.
Photon em compute serverless
Em compute serverless, o Photon vem habilitado por padrão, mas você não gerencia cluster, não escolhe a família de VM nem alterna o runtime. O Databricks cuida dessa camada por você. O detalhe é que o serverless usa um modelo de pricing diferente, então o cálculo de 2× dos clusters clássicos não se transfere diretamente. O Lakebase roda nesse mesmo modelo serverless — vale ter em mente se você estiver comparando o preço dele com workloads Photon em clusters clássicos; as estruturas de preço não são as mesmas.
A diferença de pricing importa quando workloads migram entre superfícies de compute. A engine pode continuar a mesma enquanto a economia muda por baixo. Se um job é barato em um cluster clássico com Photon habilitado, isso não significa que movê-lo para serverless vai produzir o mesmo perfil de custo. A superfície de compute faz parte do cálculo. Se você está fazendo esse cálculo em todo o seu ambiente Databricks, o guia Databricks Cost Optimization cobre as outras alavancas, de auto-termination e dimensionamento de compute a layout de tabelas e governança.
Lendo o query profile para medir a cobertura do Photon
Se você quer saber se o Photon realmente melhorou a performance, comece pelo query profile, não pelo tempo decorrido. O profile mostra onde o workload gastou seu tempo e quais partes do plano usaram a engine.
Um workload pode terminar mais cedo e, ainda assim, dizer muito pouco sobre a economia. Se a maior parte do tempo de task foi para scans, joins ou agregações nativos do Photon, o speedup tem uma explicação clara. Se os operadores caros fizeram fallback para o caminho de execução padrão, ou se a maior parte do tempo foi para shuffle e I/O, a engine não está fazendo muito pela parte que importa.
Veja como isso aparece no query profile:
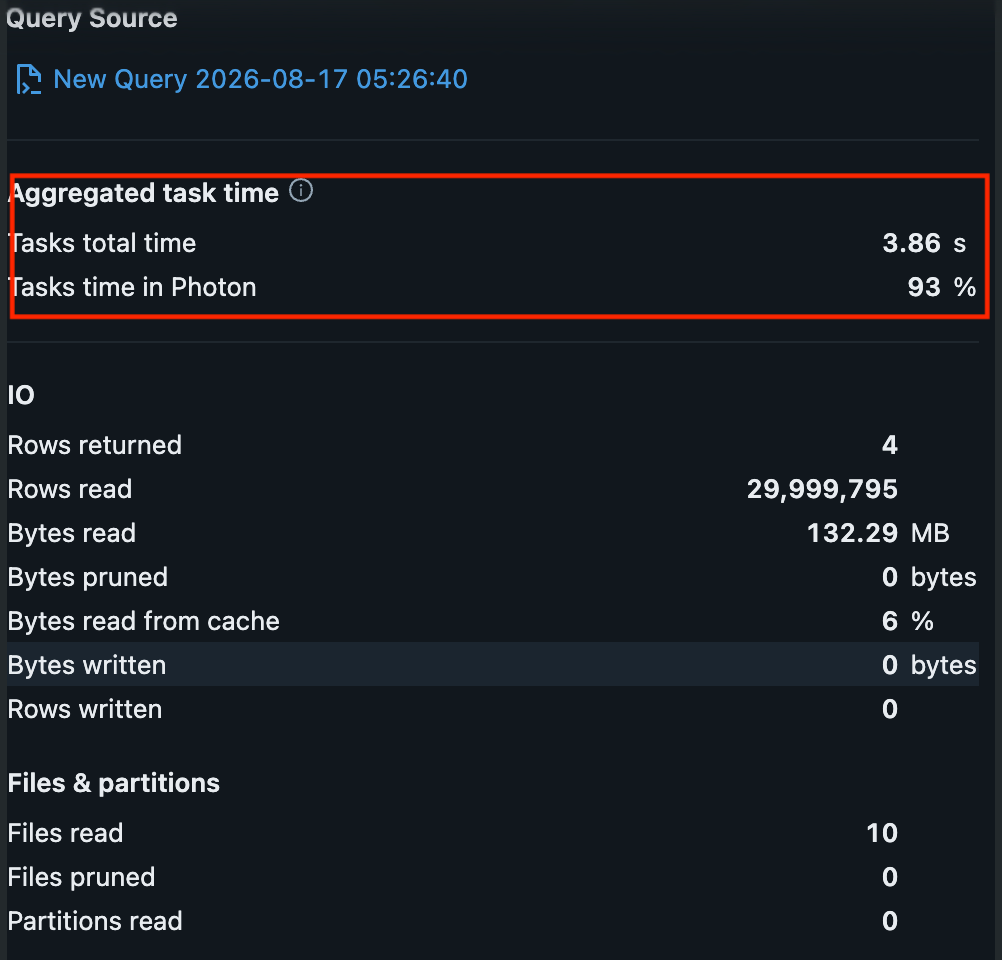
Neste exemplo, 93% do tempo de task passou pelo Photon. A query leu 29.999.795 linhas em 10 arquivos, com 3,86 segundos de tempo total de task. Esse é um sinal forte de que o Photon cuidou da maior parte da execução.
O número importante não é só a porcentagem. Olhe também o que a query estava realmente fazendo. Aquele resultado de 93% é uma vitória limpa porque os operadores caros, o scan e a agregação, rodaram nativamente. Nem sempre vai ser tão limpo assim. Imagine outra query que gasta 70% do tempo em uma UDF em Python ou esperando por um shuffle amplo. Ligar o Photon ali não toca no gargalo real, não importa como fique o tempo de execução depois. A porcentagem só diz algo quando você sabe o que ela está medindo.
É aqui também que a cobertura de operadores da seção anterior se paga: não se trata de contar quantos operadores usam o Photon, e sim de descobrir para onde o tempo de task realmente foi.
É assim também que você explica resultados surpreendentes depois que eles acontecem. Um job pode mostrar uma melhoria significativa de tempo de execução enquanto a maior parte do trabalho caro fica fora do Photon. Outro pode ganhar mais porque seus maiores operadores rodam nativamente. Mesma métrica de runtime, razões diferentes por baixo, e é o profile que diz qual dos dois você está vendo.
Para workloads recorrentes de ETL e SQL, essa é a verificação a fazer antes de decidir se o Photon vale os DBUs que consome: encontre os operadores caros, veja qual caminho eles seguiram e conecte isso de volta ao tempo de execução e ao custo.
Medindo o custo do Photon com o SELECT
Um workload Photon mais rápido não é automaticamente mais barato. Você precisa conectar a melhoria de tempo de execução aos DBUs e ao custo de infraestrutura antes de declarar vitória.
O SELECT permite rastrear os gastos do Databricks até jobs, clusters e warehouses, com consumo de DBU e custos de infraestrutura subjacentes na mesma visão. Para um job de ETL recorrente, compare execuções equivalentes antes e depois da mudança para o Photon. Compare performance, DBUs e custo total em conjunto. Se o job termina mais rápido, mas a taxa maior do Photon eleva o custo, o speedup não se pagou. A mesma atribuição cobre custos de serving de modelos de IA no Agent Bricks, caso o Photon seja apenas uma peça de um workload maior.
A taxa de 2x em DBU vista antes dá a você a referência. Um workload em cluster clássico precisa de aproximadamente 2x de speedup para empatar. O SELECT entrega os dados de uso e custo por job para você ver onde seu workload realmente está, em vez de estimar só pelo tempo de execução.
O query profile mostra onde a engine ajudou. O SELECT mostra os DBUs e o custo de infraestrutura por trás dessa melhoria. Juntos, eles mostram se um workload recorrente de ETL ou SQL está ficando mais barato à medida que fica mais rápido. Agende uma demo para rodar essa comparação com seus próprios jobs habilitados para Photon.
Perguntas frequentes
O Photon funciona com meu código Spark existente?
Sim. O Photon roda por baixo do mesmo modelo de programação do Spark, então você não precisa reescrever seus jobs Spark para usá-lo. Seus workloads existentes de DataFrame e SQL podem usar o Photon quando o plano físico deles corresponde a operadores nativos suportados. O principal ponto a verificar é a cobertura de operadores, especialmente se o seu pipeline depende muito de UDFs ou de outras operações que fazem fallback para o caminho de execução padrão do Spark.
Por que minhas UDFs em Python não ficam mais rápidas com o Photon habilitado?
Como o Photon não executa UDFs arbitrárias em Python nativamente, a UDF roda pelo caminho de execução padrão do Spark e do Python, então o Photon não consegue otimizar o código Python em si. Se a UDF é o seu gargalo, habilitar o Photon não vai mudar muita coisa. Sempre que possível, substitua a UDF por uma função SQL nativa. Se uma UDF em Python for inevitável, uma pandas_udf pode reduzir parte do overhead entre Python e JVM, mas não torna a UDF nativa no Photon.
Como verifico qual porcentagem da minha query rodou no Photon?
Abra o query profile da query concluída e vá em Aggregated task time → Tasks time in Photon. Essa porcentagem mostra quanto do tempo de task passou pelo Photon. Depois, verifique o detalhamento por operador para ver para onde foi o tempo restante. A porcentagem sozinha não basta. Você também precisa saber se o Photon cuidou da parte cara do workload.
O Photon custa mais que o Databricks Runtime padrão?
Em clusters clássicos, sim. O compute com Photon habilitado tem uma taxa de DBU maior que o compute equivalente sem Photon. O multiplicador exato depende do tipo de instância, mas aproximadamente 2× é o número útil para o cálculo de custo. Isso significa que o workload precisa de aproximadamente 2× de speedup para empatar.
O Photon suporta aceleração por GPU?
Não. O Photon é uma engine de execução nativa baseada em CPU, não uma engine de execução em GPU. Ele acelera operações Spark suportadas usando execução nativa de CPU. Se o seu workload exige compute com GPU para machine learning ou outro workload específico de GPU, o Photon não substitui compute habilitado para GPU.