
Einen KI-Agenten zum Laufen zu bringen, ist nicht mehr der schwierige Teil. Sie können einen Retrieval-Augmented-Generation-Loop (RAG) an einen Modell-Endpoint anschließen, ihm zwei Tools geben und haben bis zur Mittagspause etwas Überzeugendes am Laufen. Die Monate gehen dort verloren, wo derselbe Agent ein Security-Review bestehen und in ein Budget passen muss, das jemand freigibt.
Databricks Agent Bricks ist für genau dieses zweite Problem gebaut. Es verlagert die Arbeit rund um einen Agenten in die Databricks-Plattform: Modellauswahl, Retrieval, Memory und Policy-Durchsetzung laufen auf Unity Catalog, derselben Governance-Schicht, die bereits entscheidet, wer Ihre Tabellen lesen darf.
TL;DR
- Databricks Agent Bricks ist eine Plattform zum Erstellen, Betreiben und Steuern produktiver KI-Agenten auf Ihren eigenen Daten.
- Laut Databricks macht der Agent-Loop selbst "nur 1 % der Arbeit" aus – über alle mehr als 100.000 Agenten hinweg, die auf der Plattform gebaut wurden. Deployment, Security, Evaluierung, Monitoring, Kontext und Kosten sind die übrigen 99 %.
- Agent Bricks gliedert diese Arbeit in drei Bereiche: Choice – welche Modelle und Frameworks Sie nutzen können, Context – was der Agent tatsächlich weiß, und Control – was der Agent tun darf.
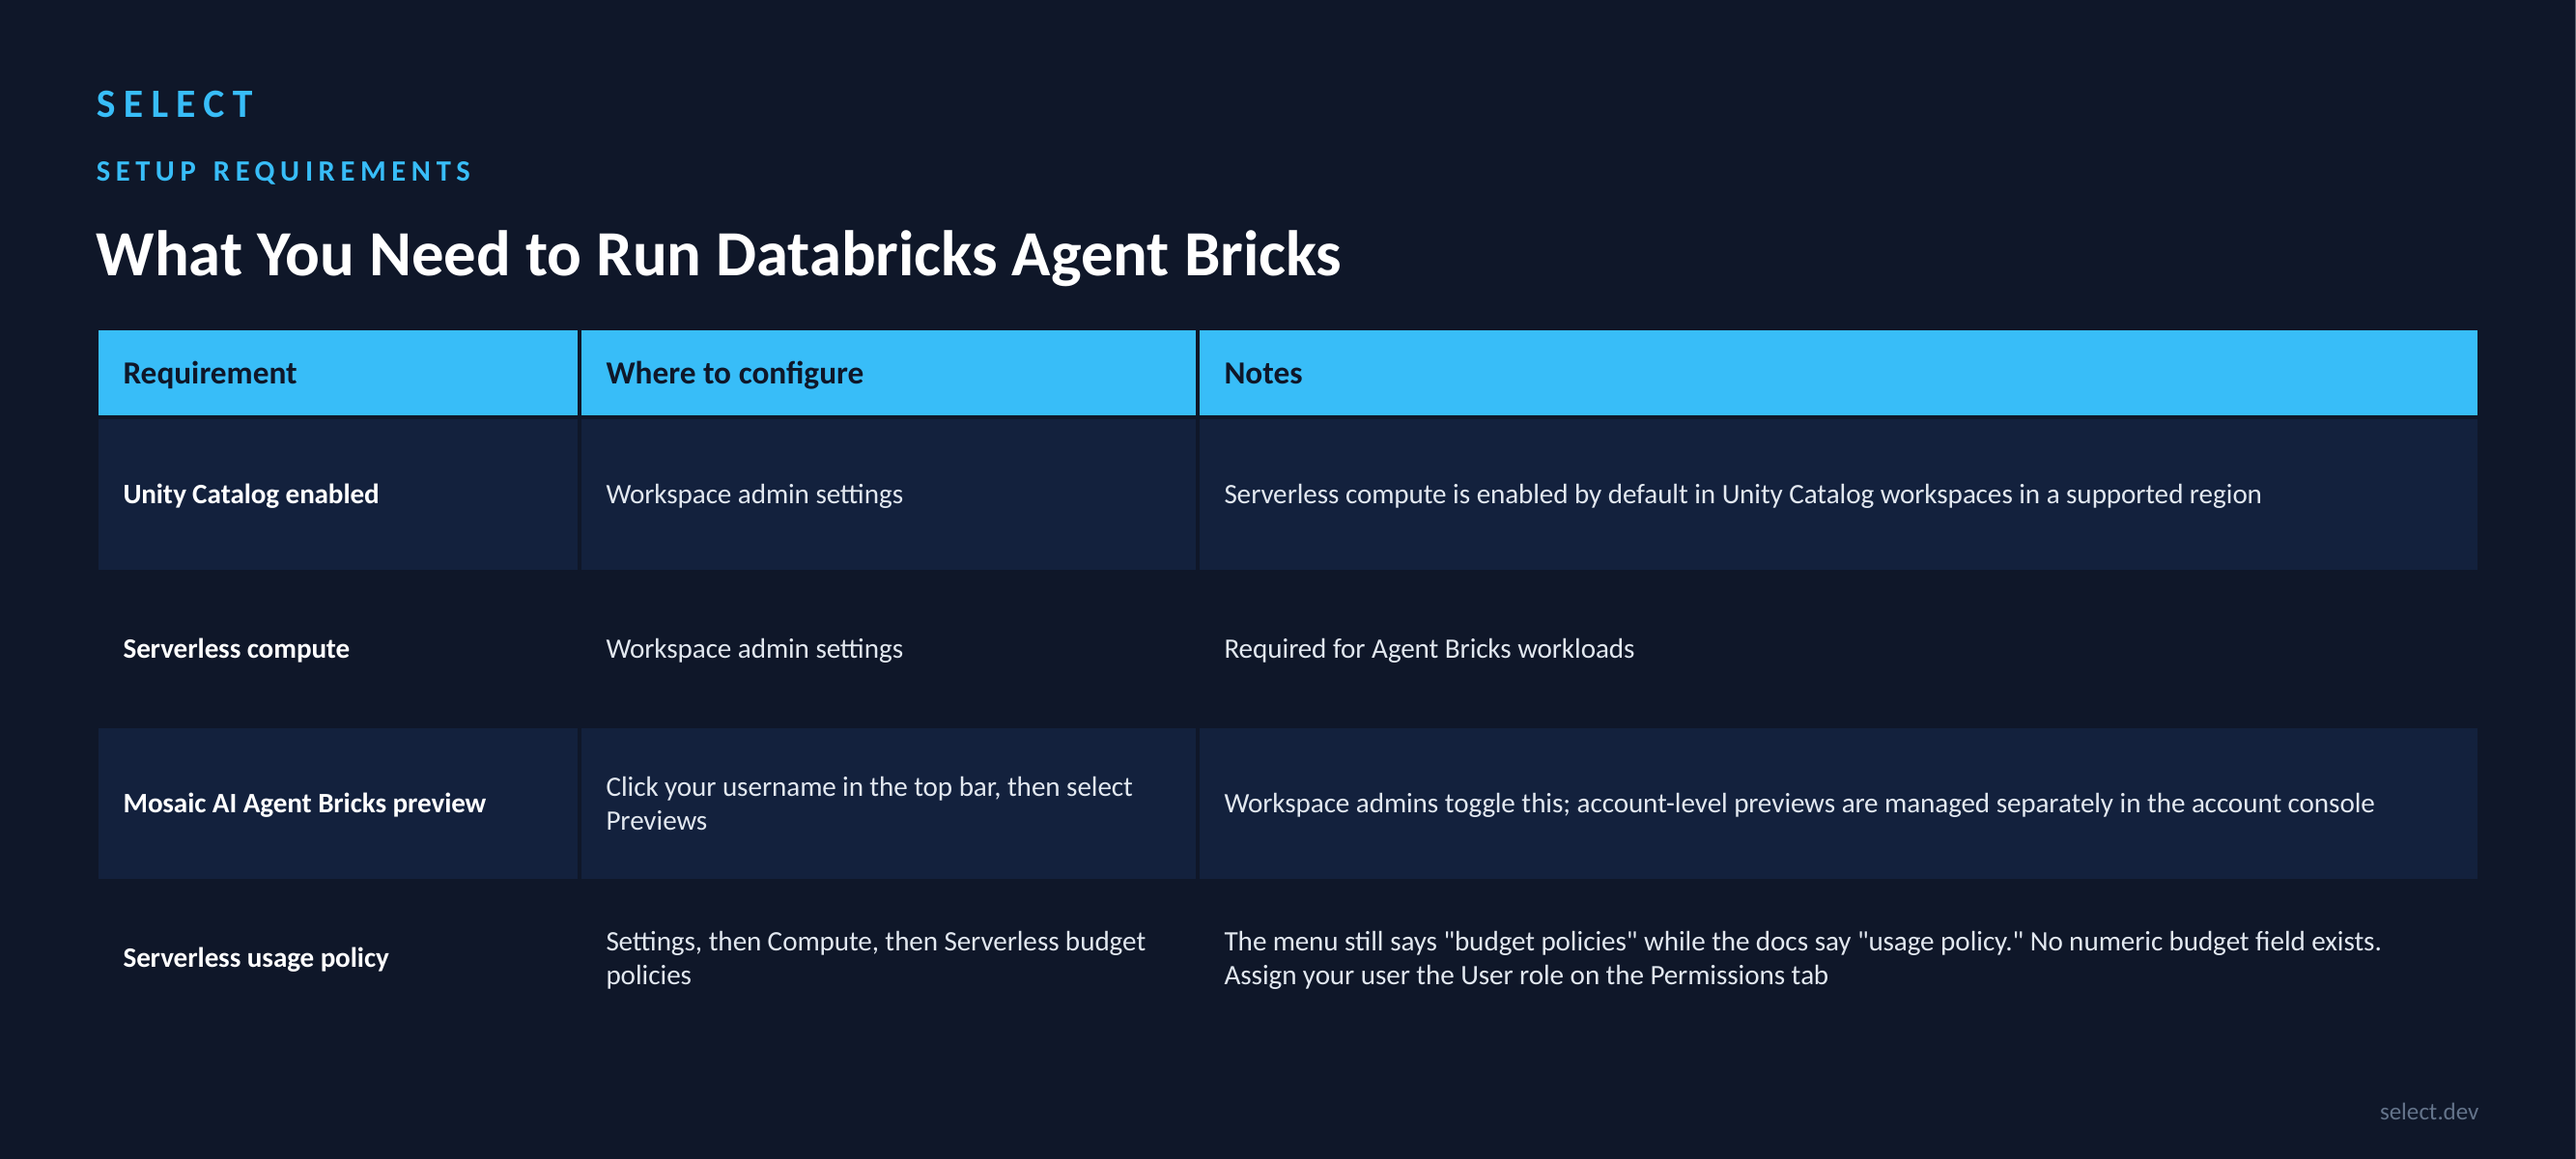
- Zum Betrieb benötigen Sie Unity Catalog, Serverless Compute, den Preview-Schalter für Mosaic AI Agent Bricks und eine Serverless Usage Policy.
Warum bleiben Enterprise-Agenten vor dem Launch stecken?
Der Agent-Loop ist der Teil, den Teams hinbekommen. Alles drumherum ist der Punkt, an dem Enterprise-Agenten ins Stocken geraten. Nach mehr als 100.000 auf der Plattform gebauten Agenten beziffert Databricks den eigentlichen Agent-Loop auf "nur 1 % der Arbeit", während die übrigen 99 % auf "die versteckten technischen Schulden agentischer Systeme: Token-Kapazität, Deployment, Security, Evaluierung, Monitoring, Kontext, Sharing" entfallen.
Jeder Punkt auf dieser Liste taucht erst auf, wenn die Demo bereits läuft. Sie haben einen Assistenten auf Ihrem eigenen Laptop laufen – und dann beginnen die Fragen.
- Auf welches Modell weicht er aus, wenn der primäre Anbieter Sie per Rate Limit ausbremst?
- Wer darf das Tool aufrufen, das in Produktionstabellen schreibt?
- Woher wissen Sie, dass sich die Antworten nach der Prompt-Änderung von letzter Woche verbessert haben?
- Was passiert mit dem Konversationsstatus, wenn der Serving-Prozess neu startet?
- Auf welches Budget laufen die Token-Kosten?
Nichts davon ist der Agent-Loop – und all das steht zwischen Ihnen und der Produktion.
Ein Databricks-Community-Beitrag vom Juli 2025 formuliert es noch drastischer und nennt den Sprung vom Prototyp in die Produktion den Ort, "an dem KI-Projekte sterben". Derselbe Community-Beitrag macht Komplexität, schwache Evaluierung, steigende Kosten, Governance-Lücken und verstreutes Tooling dafür verantwortlich.
Agent Bricks ist Databricks' Antwort auf diese 99 % – es übernimmt Deployment, Security, Evaluierung, Monitoring und Kosten außerhalb des Agent-Loops. Es ist so gebaut, dass diese Arbeit Teil der Databricks-Plattform wird, auf der Ihre Daten ohnehin schon laufen.
Was ist Databricks Agent Bricks?
Agent Bricks ist Databricks' Plattform zum Erstellen, Betreiben und Steuern produktiver KI-Agenten auf Ihren eigenen Daten. Die Infrastruktur, die diese Agenten benötigen, ist Teil der Plattform.
Databricks hat das Produkt am 11. Juni 2025 auf dem Data + AI Summit als Beta vorgestellt; der Zugang liegt weiterhin hinter einem Workspace-Preview-Schalter, den ein Admin aktivieren muss. Laut Databricks wurden seitdem über 100.000 Agenten darauf gebaut, die inzwischen mehr als 1 Billiarde Tokens pro Jahr verarbeiten; zu den Kunden zählen AstraZeneca, 7-Eleven, Fox Corporation und Block.
Der Unterschied zu einem universellen Agenten-Framework liegt darin, wo die umgebende Maschinerie angesiedelt ist. Bei einem Framework wählen Sie einen Modellanbieter, verdrahten einen Vector Store, ergänzen eine Orchestrierungsbibliothek, bauen Evaluierung und Tracing auf und halten die Governance über all das hinweg selbst konsistent. Agent Bricks behandelt Modellzugriff, Datenkontext und Policy-Durchsetzung als Plattformdienste auf Unity Catalog, der bereits die Berechtigungen und die Lineage für die Tabellen hält, die Ihre Agenten lesen.
Der Datenzugriff eines Agenten entspricht damit dem Zugriff des anfragenden Nutzers, durchgesetzt von demselben Katalog, der alles andere steuert. Es gibt kein zweites Berechtigungsmodell, das gepflegt werden müsste.
Wie deckt Agent Bricks die 99 % ab?
Choice, Context und Control sind die drei Problemfelder, um die Databricks die Plattform organisiert. Choice beantwortet die Frage nach dem Lock-in auf ein Modell oder ein Framework. Context beantwortet das Problem von Agenten, die Ihre Geschäftsdefinitionen und Dokumente nicht erreichen. Control beantwortet das Problem von Agenten, die mehr Privilegien als Aufsicht haben.
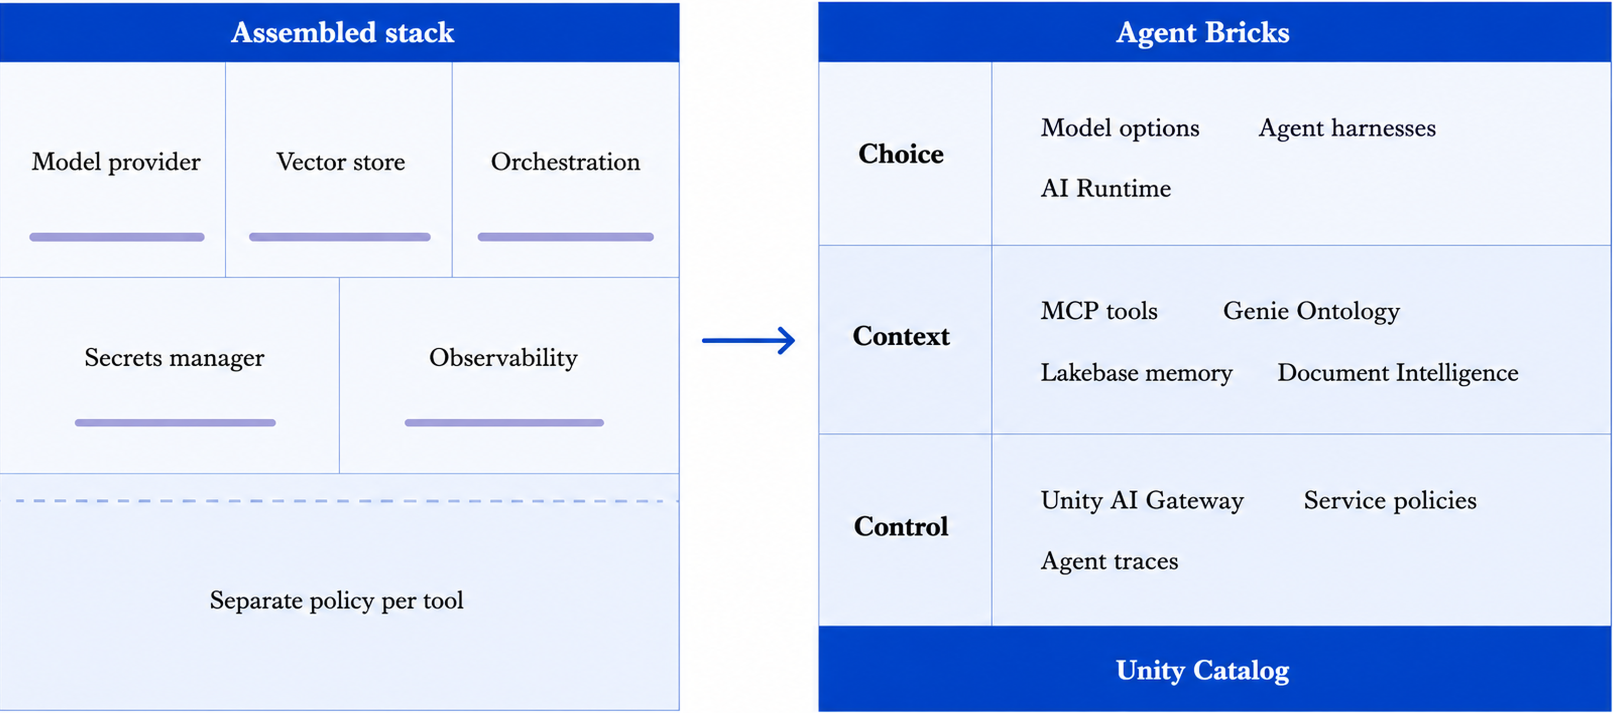
Choice: welche Modelle und Frameworks Sie nutzen können
Sie sind weder auf ein Modell noch auf ein Agenten-Framework festgelegt. Databricks setzt auf "Modellvielfalt, um die richtige Balance aus Qualität und Latenz zu finden".
Ein Subagent, der Fragen nur an den richtigen Spezialisten weiterleitet, braucht nicht das Modell, das die finale Antwort formuliert. Für beides Frontier-Preise zu zahlen, ist eine häufige Quelle vermeidbarer Ausgaben.
Zu den über Agent Bricks erreichbaren Modellen zählen OpenAI, Anthropic, Gemini, Qwen, Kimi und Grok. Bei den Frameworks unterstützt Databricks nach eigener Aussage "jedes Agenten-Harness, das Entwickler nutzen möchten – von Open-Source-Frameworks wie LangGraph, Agno und CrewAI bis hin zu Harnesses wie dem Claude Code SDK oder den OpenAI Agent SDKs".
Passt keines der verfügbaren Modelle, können Sie mit AI Runtime eigene Large Language Models (LLMs) auf Ihren Daten trainieren. Databricks nennt Merck und First American als Kunden, die genau das tun.
Context: was der Agent tatsächlich weiß
Kontext ist alles, worauf ein Agent jenseits der Modellgewichte zugreift: Ihre Tools, Ihre Geschäftsdefinitionen, Ihre Dokumente und das, was er sich aus dem bisherigen Gesprächsverlauf merkt. Databricks beschreibt LLMs als "leistungsstarke Reasoning-Maschinen", die "den richtigen Kontext abrufen und verarbeiten können müssen, um fachlich korrekte Entscheidungen zu treffen". Ein Modell, das die richtige Zahl aus der falschen Tabelle liefert, ist der am schwersten zu erkennende Fall – denn die Antwort sieht korrekt aus.
Tools erreichen den Agenten über Unity Catalog, der entscheidet, wer welches Tool nutzen darf. Managed-OAuth-Konnektoren implementieren das Model Context Protocol (MCP), einen offenen Standard, um Modellen Tools und Daten zugänglich zu machen; Databricks nutzt sie, um "externe Dienste wie GitHub, Atlassian und Glean sicher als Tools unter Governance anzubinden". Sie vergeben die Berechtigung für ein Tool einmal, und jeder Agent, der es aufruft, erbt diese Berechtigung – das erspart es Ihnen, Zugangsdaten in jeden Agenten einzeln zu verdrahten.
Genie Ontology bringt Ihre Geschäftsdefinitionen in die Datensicht des Agenten ein. Document Intelligence parst, extrahiert und klassifiziert Dokumente über SQL-native AI-Funktionen und stellt sie unter Governance – so werden Verträge und PDFs abfragbar. Und das durch Lakebase gestützte Agenten-Memory liefert "Memory, Konversationsverlauf und Status" für langlaufende Workflows. Auf der Lakebase-Produktseite heißt das: Chat-Sitzungen und Nachrichten eines Agenten bleiben erhalten, sodass "Nutzer Konversationen fortsetzen können und Ihr Agent über frühere Turns hinweg auch über Deployments hinaus schlussfolgern kann".
Kontext hilft Ihnen allerdings nicht, wenn das Retrieval langsam ist oder mehr Daten scannt als nötig – und das führt zurück zum Datenlayout der Tabellen, die Agenten lesen.
Databricks berichtet, dass Agenten, die in diesem Geschäftskontext verankert sind, "70 % höhere Genauigkeit als Standard-RAG und eine 30-prozentige Verbesserung bei mehrstufigen Workflows" erzielen, und führt den Zugewinn auf die Kombination aus Unity-Catalog-Metadaten und Genie Spaces zurück.
Genie Ontology ist eines von vier Genie-Produkten, und alle berechnen sowohl LLM-Nutzung als auch Compute. Laden Sie unser kostenloses E-Book Databricks Genie Explained herunter und erfahren Sie, was jedes davon leistet und kostet.
Control: was der Agent tun darf
Control umfasst, was ein Agent tun darf – eine umfassendere Frage als die, was er sehen darf. Der Unterschied zählt am meisten, sobald ein Agent schreiben kann: Ein fehlerhafter Lesezugriff legt Daten offen, ein fehlerhafter Schreibzugriff verändert sie.
Agenten gehören "zu den privilegiertesten Akteuren in einem Unternehmen, mit Zugriff auf sensible Daten" – so Databricks' eigene Einschätzung.
Unity AI Gateway ist die Durchsetzungsschicht. Agenten erben die Identität des anfragenden Nutzers über On-Behalf-of Token Passing, sodass Identität Ende-zu-Ende durchgesetzt wird – ohne Service-Account, der stellvertretend für den Nutzer agiert. Guardrails prüfen auf personenbezogene Daten, unsichere Inhalte, Prompt Injection, Datenexfiltration und Halluzinationen.
Über den Zugriff hinaus steuern kontextuelle Service-Policies die Aktionen. Sie befinden sich in der Beta, rechnen Sie also mit Änderungen. Sie definieren sie in SQL als Unity-Catalog-Funktionen, und sie können Operationen wie "Dateien ändern, Code pushen, auf Unternehmenssysteme zugreifen oder mit sensiblen Informationen interagieren" erlauben, verweigern oder genehmigungspflichtig machen. Policies greifen abhängig von Nutzer, Agent, Modell, MCP-Dienst, aufgerufenem Tool oder dem Inhalt von Anfrage und Antwort. Wenn ein Mensch freigeben soll, bevor ein Agent in ein Produktions-Repository pusht, schreiben Sie das als Policy – und die Plattform setzt es durch.
Unified Tracing erfasst Modellinteraktionen und MCP-Tool-Aktivität in einer zentralen Telemetrieschicht unter Governance. Traces landen im Lakehouse für Analysen und in Lakewatch, Databricks' agentischem Produkt für Security Information and Event Management (SIEM), für Untersuchungen.
Control deckt auch die Ausgaben ab. Unity AI Gateway unterstützt Budgets und harte Ausgabenlimits, die "Anfragen automatisch stoppen, wenn Budgets überschritten werden". Diese Durchsetzung greift tatsächlich – und sie endet an einer klaren Grenze, auf die der Abschnitt zur Kostentransparenz weiter unten eingeht.
Was brauchen Sie, um Agent Bricks zu betreiben?
Ihr Workspace braucht vier Dinge.
- Unity Catalog aktiviert. Wenn Sie diese Schicht noch nicht aufgebaut haben, lesen Sie zuerst, was Unity Catalog ist und was es kostet.
- Serverless Compute verfügbar. Databricks aktiviert dies standardmäßig in Unity-Catalog-Workspaces in einer unterstützten Region.
- Die Mosaic AI Agent Bricks Preview eingeschaltet. Das erledigt ein Workspace-Admin über das Previews-Panel.
- Zugriff auf eine Serverless Usage Policy. Die Knowledge-Assistant-Dokumentation formuliert das als "Zugriff auf eine Serverless Usage Policy mit einem Budget ungleich null".
An dieser vierten Anforderung bleiben die meisten hängen. Dort steht "Budget ungleich null" – aber es gibt keinen Betrag, den man eintragen könnte. Serverless Usage Policies sind "Tags, die auf jede Serverless-Compute-Aktivität angewendet werden"; ein Databricks-Mitarbeiter bestätigte in einem Community-Thread, dass sie "Tagging-Mechanismen für die Kostenzuordnung sind, keine Ausgabenlimits". Erstellen Sie die Policy unter Settings, dann Compute, dann Serverless budget policies, und geben Sie Ihrem Nutzer auf dem Permissions-Tab die Rolle User.
Die Regionsabdeckung ändert sich laufend – prüfen Sie sie, bevor Sie sich auf eine Region festlegen. Stand August 2026 läuft Agent Bricks direkt in neun AWS-Regionen und zwölf Azure-Regionen; vier weitere auf AWS und dreizehn weitere auf Azure sind über Cross-Geography-Routing erreichbar. Aktuelle Listen finden Sie in den Feature-Verfügbarkeitstabellen für AWS und Azure unter "Agent features availability".
Was sind reale Use Cases für Agent Bricks?
Drei Agent-Bricks-Produkte decken die gängigen Formen produktiver Arbeit ab: Knowledge Assistant beantwortet Fragen zu Ihren Dokumenten, Document Intelligence extrahiert Struktur daraus, und der Supervisor Agent koordiniert mehrere Agenten gleichzeitig.
Knowledge Assistant beantwortet Fragen auf Basis Ihrer Dokumente. Hawaiian Electric hat damit eine bestehende Open-Source-Implementierung ersetzt. Joel Wasson, Manager of Enterprise Data and Analytics, berichtete: "Agent Bricks hat unsere ursprüngliche Open-Source-Implementierung sowohl bei LLM-as-Judge- als auch bei menschlichen Evaluierungsmetriken deutlich übertroffen."
Prüfen Sie zuerst die Ingestion-Limits. Dateien über 100 MB sowie PDF- oder Office-Dokumente mit mehr als 500 Seiten werden übersprungen, und ein Assistent verarbeitet höchstens 10 Wissensquellen.
Document Intelligence verwandelt unstrukturierte Dokumente in strukturierte Felder. Bei AstraZeneca berichtete Joseph Roemer, Head of Data & AI, Commercial IT: "Unsere Teams konnten mehr als 400.000 klinische Studiendokumente durchgehen und strukturierte Datenpunkte extrahieren – ohne eine einzige Zeile Code zu schreiben." Beide Kundenzitate stammen aus der Launch-Mitteilung zu Agent Bricks.
Supervisor Agent koordiniert ein Multi-Agenten-System. Er verteilt Arbeit über Genie Agents, Agent-Endpoints, Unity-Catalog-Funktionen, MCP-Server und benutzerdefinierte Agenten, sodass ein einziger Endpoint spezialisierte Domänen abdecken kann. Ein Supervisor umfasst höchstens 50 Agenten, Endnutzer brauchen expliziten Zugriff auf jeden Subagenten, mit dem sie interagieren, und die Verfügbarkeit der Websuche hängt von Region und Sicherheitskonfiguration ab.
Was verrät Ihnen Agent Bricks nicht über die Kosten?
Agent Bricks zeigt Ihnen, welche Personen und welche Agenten Ihr KI-Budget verbrauchen. Es zeigt Ihnen nicht, aus welchem Workspace, Job, Cluster oder Model-Serving-Endpoint diese Ausgaben stammen – und dieser blinde Fleck wächst mit zunehmenden Agenten-Workloads.
Unity AI Gateway setzt Budgets und harte Ausgabenlimits durch und verfolgt den Token-Verbrauch über Nutzer, Teams, Anwendungen und Modellanbieter hinweg. Wenn Ihre Frage lautet "welches Team verbrennt das Modellbudget", beantwortet die Plattform sie.
Diese Budgets und Limits gelten für Agenten, Tools, Modelle und MCP-Dienste. An die darunterliegenden Compute-Kosten pro Job und Cluster reichen sie nicht heran. Jeder Agenten-Lauf verbraucht Serverless Compute, bei dem die Infrastruktur in die DBU-Rate eingerechnet ist, und die Netzwerk- und Storage-Kosten, die dieser Workload erzeugt, landen weiterhin auf Ihrer Cloud-Rechnung.
Diese zweite Ebene ist der Grund, warum wir SELECT. gebaut haben. Jeder Databricks-Workload erzeugt eine parallele Ebene an Cloud-Infrastrukturkosten, die Databricks im Hintergrund bereitstellt, dazu kommen die zugehörigen Netzwerk- und Cloud-Storage-Kosten. Ihr Cloud-Anbieter stellt diese direkt in Rechnung, das eigene Reporting von Databricks zeigt sie nicht – und die tatsächlichen Gesamtkosten bleiben ohne dediziertes Tooling außer Reichweite.
Model Serving ist der Punkt, an dem das am meisten schmerzt – und genau das erzeugt Agent Bricks. Da Databricks zu einem zentralen Ort für KI-Modelltraining und Inferenz geworden ist, sehen wir Model-Serving-Kosten rasant wachsen – mit noch weniger nativer Transparenz und weniger Kontrollmöglichkeiten als bei klassischen Workloads.
Jedes Framework zur Databricks-Kostenoptimierung muss beide Ebenen zusammenführen. SELECT for Databricks verbindet sich über einen Read-only Service Principal und passt – so DoiT – Cluster-Konfigurationen an, um die Kosten aller Workloads um bis zu 30 % zu senken.
Teams, die Databricks betreiben und granulare Transparenz über die Kosten von AI Model Serving wollen, können SELECT in rund 20 Minuten anbinden. Jetzt Demo buchen.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Databricks Agent Bricks und Mosaic AI?
Mosaic AI ist Databricks' umfassendere KI-Produktschicht und deckt Model Serving, Foundation-Model-APIs, Vektorsuche und die zugrunde liegende Agenten-Infrastruktur ab. Agent Bricks ist das darauf aufsetzende Produkt zum Bauen von Agenten, das den Loop, die Tool-Anbindung, Evaluierung und Optimierung für Sie übernimmt.
Was sind die vier Typen von Agent-Bricks-Agenten?
Databricks hat Agent Bricks mit vier Agententypen gestartet. Knowledge Assistant beantwortet Fragen auf Basis von Unternehmensdaten, Information Extraction verwandelt Dokumente in strukturierte Felder, Supervisor Agent ermöglicht Multi-Agenten-Systeme, und Custom LLM Agent transformiert Text für individuelle Aufgaben. Information Extraction ist inzwischen unter Document Intelligence angesiedelt, der übergreifenden Funktion für Parsing, Extraktion und Klassifizierung – weshalb dieser Artikel drei statt vier Formen produktiver Arbeit behandelt.
Unterstützt Agent Bricks LangGraph und andere Frameworks?
Ja. Databricks gibt an, "jedes Agenten-Harness, das Entwickler nutzen möchten" zu unterstützen, und nennt Open-Source-Frameworks wie LangGraph, Agno und CrewAI sowie Harnesses wie das Claude Code SDK und die OpenAI Agent SDKs. Omnigent wird ebenfalls unterstützt.
Wie handhabt Agent Bricks das Agenten-Memory?
Über die native Integration mit Lakebase, das laut Databricks "Memory, Konversationsverlauf und Status für langlaufende Workflows" bereitstellt. Databricks positioniert Lakebase als persistenten Speicher für Chat-Sitzungen und Nachrichten eines Agenten, sodass "Nutzer Konversationen fortsetzen können und Ihr Agent über frühere Turns hinweg auch über Deployments hinaus schlussfolgern kann".
Welche Zugriffsvoraussetzungen gelten für Agent Bricks?
Ein Workspace mit aktiviertem Unity Catalog, verfügbarem Serverless Compute, Zugriff auf Model Serving, Zugriff auf eine Serverless Usage Policy und ein Standort in einer unterstützten Region. Außerdem muss ein Workspace-Admin die Mosaic AI Agent Bricks Preview aktivieren.
Wie viele Agenten wurden auf Agent Bricks gebaut?
Laut Databricks wurden seit dem Launch im Juni 2025 über 100.000 Agenten gebaut, die mehr als 1 Billiarde Tokens pro Jahr verarbeiten.