
AIエージェントを動かすこと自体は、もはや難しい部分ではありません。検索拡張生成(RAG)のループをモデルのエンドポイントにつなぎ、ツールを2つ持たせれば、昼までにはそれらしく動くものが出来上がります。時間がかかるのはその先です。同じエージェントがセキュリティレビューを通過し、誰かが承認してくれる予算に収まるまでに、何か月も費やされます。
Databricks Agent Bricksは、この2つ目の課題のために作られました。エージェントを取り巻く作業をDatabricksプラットフォーム内に移すことで、モデル選択、検索、メモリ、ポリシー適用のすべてがUnity Catalog上で動作します。誰がどのテーブルを読めるかをすでに管理している、まさに同じガバナンスレイヤーです。
TL;DR
- Databricks Agent Bricksは、自社データ上で本番AIエージェントを構築・運用・統制するためのプラットフォームです。
- Databricksによると、同社プラットフォーム上で構築された10万を超えるエージェント全体で、エージェントループ自体は「作業のわずか1%」に過ぎません。残りの99%は、デプロイ、セキュリティ、評価、モニタリング、コンテキスト、コストです。
- Agent Bricksはこの作業を3つの柱に整理しています。Choice(選択)はどのモデルとフレームワークを使えるか、Context(コンテキスト)はエージェントが実際に何を知っているか、Control(コントロール)はエージェントに何が許されているか、です。
- 実行には、Unity Catalog、サーバーレスコンピュート、Mosaic AI Agent Bricksのプレビュー有効化、そしてサーバーレス使用ポリシーが必要です。
なぜエンタープライズのエージェントはリリース前に頓挫するのか
エージェントループは、どのチームもうまく作れる部分です。頓挫するのは、その周りを取り巻くすべてです。自社プラットフォーム上で10万を超えるエージェントが構築された経験を踏まえ、Databricksはコアとなるエージェントループを「作業のわずか1%」と見積もっており、残りの99%は「エージェントシステムに潜む隠れた技術的負債、すなわちトークンキャパシティ、デプロイ、セキュリティ、評価、モニタリング、コンテキスト、共有」に費やされるとしています。
このリストの項目はすべて、デモが動いた後にやってきます。自分のノートPC上でアシスタントが動き出した途端、こうした問いが押し寄せるのです。
- プライマリのプロバイダーにレート制限をかけられたら、どのモデルにフォールバックするのか?
- 本番テーブルに書き込むツールを呼び出せるのは誰か?
- 先週のプロンプト変更後に回答が改善したと、どうやって確認するのか?
- サービングプロセスが再起動したら、会話の状態はどうなるのか?
- トークンの支出は誰の予算に計上されるのか?
これらはどれもエージェントループではありませんが、すべてが本番化への壁として立ちはだかります。
2025年7月のDatabricks Communityの投稿はさらに率直で、プロトタイプから本番への飛躍を「AIプロジェクトの墓場」と呼んでいます。このコミュニティ発の記事は、複雑さ、脆弱な評価、増大するコスト、ガバナンスの欠落、ばらばらなツール群をその原因として挙げています。
Agent Bricksは、この99%に対するDatabricksの答えです。つまり、エージェントループの外側にあるデプロイ、セキュリティ、評価、モニタリング、コストを引き受けます。こうした作業を、すでにデータを運用しているDatabricksプラットフォームの一部にするために作られているのです。
Databricks Agent Bricksとは?
Agent Bricksは、自社データ上で本番AIエージェントを構築・運用・統制するためのDatabricksのプラットフォームです。エージェントに必要なインフラは、プラットフォームに標準で備わっています。
Databricksは2025年6月11日のData + AI Summitでベータ版として発表し、現在もアクセスには管理者によるワークスペースのプレビュー設定の有効化が必要です。Databricksによると、発表以来10万を超えるエージェントが構築され、現在では年間1,000兆を超えるトークンを処理しており、顧客としてAstraZeneca、7-Eleven、Fox Corporation、Blockなどを挙げています。
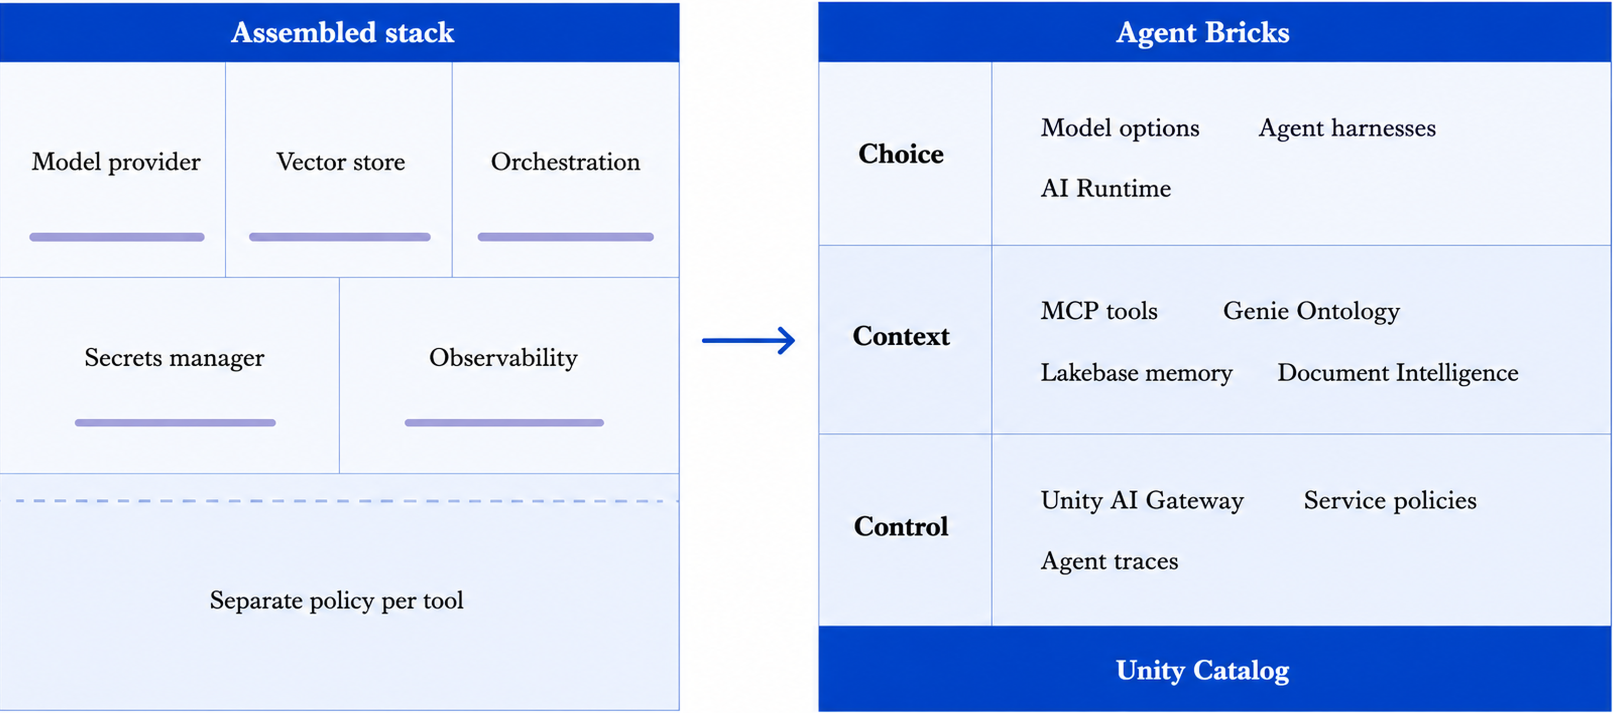
汎用のエージェントフレームワークとの違いは、周辺機構がどこにあるかです。フレームワークの場合、モデルプロバイダーを選び、ベクターストアをつなぎ、オーケストレーションライブラリを追加し、評価とトレーシングを構築し、その全体でガバナンスの一貫性を自ら維持しなければなりません。Agent Bricksは、モデルアクセス、データコンテキスト、ポリシー適用を、Unity Catalog上にあるプラットフォームサービスとして扱います。Unity Catalogには、エージェントが読み取るテーブルの権限とリネージがすでに保持されています。
したがって、エージェントのデータアクセスはリクエストしたユーザーのアクセス権そのものであり、他のすべてを統制しているのと同じカタログによって適用されます。維持すべき第二の権限モデルは存在しません。
Agent Bricksは99%をどうカバーするのか
Databricksは、プラットフォームをChoice、Context、Controlという3つの課題を軸に構成しています。Choiceは、1つのモデルや1つのフレームワークへのロックインに対する答えです。Contextは、自社のビジネス定義やドキュメントに届かないエージェントに対する答えです。Controlは、監視を上回る権限を持つエージェントに対する答えです。
Choice:どのモデルとフレームワークを使えるか
1つのモデルや1つのエージェントフレームワークに縛られることはありません。Databricksは「品質とレイテンシの最適なバランスを取るためのモデルの多様性」を念頭に開発しています。
質問を適切なスペシャリストに振り分けるだけのサブエージェントに、最終回答を作成するモデルは必要ありません。両方にフロンティアモデル並みの料金を払うことは、避けられる無駄な支出の典型例です。
Agent Bricks経由で利用できるモデルには、OpenAI、Anthropic、Gemini、Qwen、Kimi、Grokが含まれます。フレームワークについては、Databricksは「LangGraph、Agno、CrewAIといったオープンソースフレームワークから、Claude Code SDKやOpenAI Agent SDKといったハーネスまで、開発者が使いたいあらゆるエージェントハーネス」をサポートすると述べています。
利用可能なモデルのどれも合わない場合は、AI Runtimeを使って自社データで独自の大規模言語モデル(LLM)をトレーニングできます。Databricksは、これを実践している顧客としてMerckとFirst Americanを挙げています。
Context:エージェントが実際に知っていること
コンテキストとは、モデル自体の重み以外にエージェントが到達できるすべて、つまりツール、ビジネス定義、ドキュメント、そして会話の中でそれまでに記憶した内容を指します。DatabricksはLLMを「強力な推論マシン」と表現し、「ビジネス上正しい判断を下すには、適切なコンテキストを取得・処理する能力が必要」だとしています。間違ったテーブルから正しい数値を返すモデルは、答えが一見正しく見えるだけに、最も見抜きにくいケースです。
ツールはUnity Catalogを通じてエージェントに届き、誰がどのツールを使えるかを決めるのもUnity Catalogです。マネージドOAuthコネクタは、モデルにツールとデータを公開するためのオープン標準であるModel Context Protocol(MCP)を実装しており、Databricksはこれを使って「GitHub、Atlassian、Gleanといった外部サービスを統制されたツールとして安全に接続」しています。ツールに一度権限を設定すれば、それを呼び出すすべてのエージェントがその権限を継承するため、エージェントごとに認証情報を個別に組み込む手間が省けます。
Genie Ontologyは、ビジネス定義をエージェントのデータ認識に反映させます。Document Intelligenceは、SQLネイティブのAI関数を通じてドキュメントの解析・抽出・分類・統制を行い、契約書やPDFをクエリ可能なデータに変えます。さらに、Lakebaseを基盤とするエージェントメモリが、長時間実行されるワークフローに「メモリ、会話履歴、状態」を提供します。Lakebaseの製品ページによれば、これはエージェントのチャットセッションとメッセージが永続化されることを意味し、「ユーザーは会話を再開でき、エージェントはデプロイをまたいで過去のやり取りをもとに推論できる」のです。
検索が遅かったり、必要以上のデータをスキャンしたりすれば、コンテキストは役に立ちません。そしてそれは、エージェントが読み取るテーブルのデータレイアウトの問題に帰着します。
Databricksによると、エージェントをこうしたビジネスコンテキストに基づかせることで「標準的なRAGより70%高い精度と、マルチステップワークフローでの30%の改善」が得られ、その効果はUnity CatalogのメタデータとGenie Spacesの組み合わせによるものだとしています。
Genie Ontologyは4つのGenie製品の1つで、いずれもLLM使用量とコンピュートの両方に課金が発生します。無料ebookDatabricks Genie Explainedをダウンロードして、各製品の機能とコストをご確認ください。
Control:エージェントに何が許されているか
Controlは、エージェントが何をしてよいかを扱います。これは、何を見てよいかよりも広い問いです。この違いが最も重要になるのは、エージェントが書き込みできるようになったときです。誤った読み取りはデータを漏えいさせますが、誤った書き込みはデータを書き換えてしまうからです。
Databricks自身の評価によれば、エージェントは「機密データにアクセスできる、企業内で最も高い権限を持つアクターの一つ」です。
Unity AI Gatewayが、その適用レイヤーです。エージェントはon-behalf-ofトークンパッシングを通じてリクエスト元ユーザーのアイデンティティを継承するため、アイデンティティはエンドツーエンドで適用され、ユーザーの代わりを務めるサービスアカウントは存在しません。ガードレールは、個人を特定できる情報、安全でないコンテンツ、プロンプトインジェクション、データ流出、ハルシネーションをスクリーニングします。
アクセスにとどまらず、コンテキストに応じたサービスポリシーがアクションを制御します。これらはベータ版のため、今後の変更が見込まれます。ポリシーはUnity Catalog関数としてSQLで定義し、「ファイルの変更、コードのプッシュ、企業システムへのアクセス、機密情報の操作」といった操作を許可、拒否、または承認必須にできます。ポリシーは、ユーザー、エージェント、モデル、MCPサービス、呼び出されるツール、あるいはリクエストとレスポンスの内容に基づいて適用されます。エージェントが本番リポジトリにプッシュする前に人間の承認を求めたいなら、それをポリシーとして記述すれば、プラットフォームが強制してくれます。
統合トレーシングは、モデルとのやり取りとMCPツールのアクティビティを、統制された単一のテレメトリーレイヤーに記録します。トレースは分析用にLakehouseへ、調査用にはDatabricksのエージェント型セキュリティ情報イベント管理(SIEM)製品であるLakewatchへ送られます。
Controlは支出もカバーします。Unity AI Gatewayは、「予算を超過するとリクエストを自動的に停止する」予算とハード支出上限をサポートしています。この制御は実際に機能しますが、効くのはある境界までです。その点は、後述のコスト可視性のセクションで取り上げます。
Agent Bricksの実行に必要なものは?
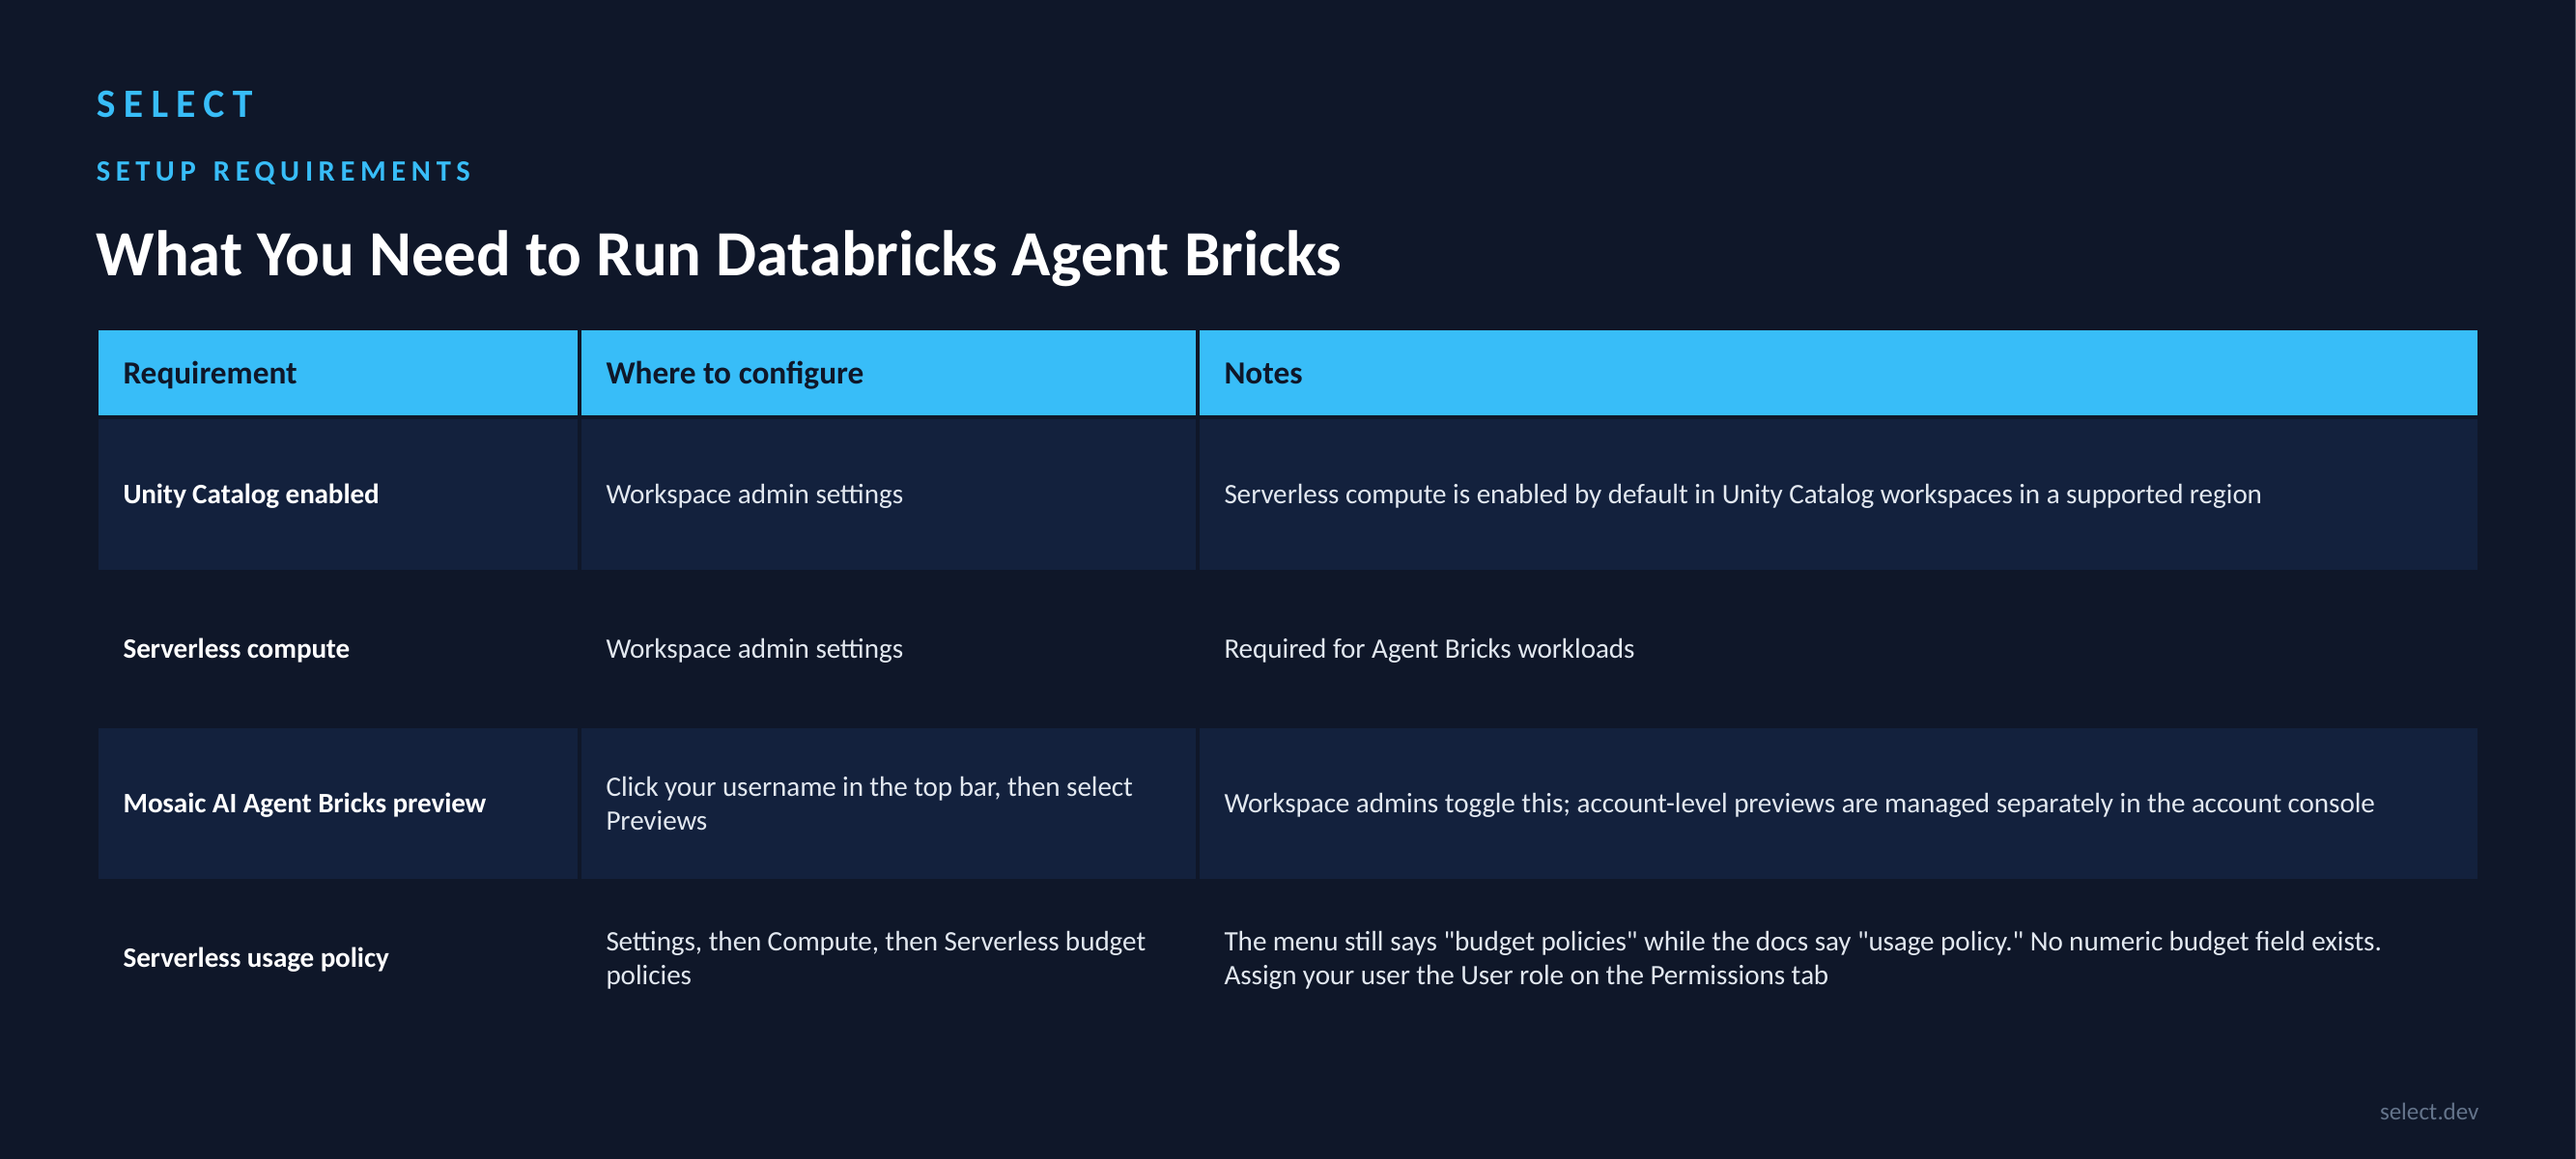
ワークスペースに必要なのは次の4つです。
- Unity Catalogが有効であること。 このレイヤーをまだ構築していない場合は、Unity Catalogとは何か、コストはいくらかから始めてください。
- サーバーレスコンピュートが利用可能であること。 サポート対象リージョンのUnity Catalogワークスペースでは、Databricksがデフォルトで有効化しています。
- Mosaic AI Agent Bricksプレビューが有効であること。 ワークスペース管理者がPreviewsパネルから行います。
- サーバーレス使用ポリシーへのアクセス。 Knowledge Assistantのドキュメントでは「ゼロではない予算が設定されたサーバーレス使用ポリシーへのアクセス」と表現されています。
多くの人がつまずくのは、この4つ目の要件です。「ゼロではない予算」とありますが、入力すべき金額はどこにもありません。サーバーレス使用ポリシーとは「あらゆるサーバーレスコンピュートのアクティビティに適用されるタグ」であり、Databricksの社員もコミュニティスレッドで「支出上限ではなく、コスト配賦のためのタグ付けの仕組み」だと認めています。ポリシーは「Settings」→「Compute」→「Serverless budget policies」で作成し、「Permissions」タブで自分のユーザーにUserロールを付与してください。
リージョンのカバレッジは随時変わるため、決定前に必ず確認してください。2026年8月時点で、Agent BricksはAWSの9リージョンとAzureの12リージョンでそのまま利用でき、さらにAWSの4リージョンとAzureの13リージョンでクロスジオグラフィールーティング経由で利用できます。最新のリストは、AWSおよびAzureの機能提供状況の表の「Agent features availability」にあります。
Agent Bricksの実際のユースケースは?
3つのAgent Bricks製品が、本番業務の代表的な形をカバーしています。Knowledge Assistantはドキュメントに基づいて質問に回答し、Document Intelligenceはドキュメントから構造を抽出し、Supervisor Agentは複数のエージェントを同時に調整します。
Knowledge Assistantは、ドキュメントに基づいて質問に回答します。Hawaiian Electricは、既存のオープンソース実装の置き換えにこれを使用しました。同社のエンタープライズデータ&アナリティクス担当マネージャーであるJoel Wasson氏は、「Agent Bricksは、LLM-as-judgeと人手評価の両方の精度指標において、当初のオープンソース実装を大きく上回りました」と報告しています。
まず取り込みの制限を確認してください。100MBを超えるファイルと、500ページを超えるPDFまたはOfficeドキュメントはスキップされ、1つのアシスタントが扱えるナレッジソースは最大10個です。
Document Intelligenceは、非構造化ドキュメントを構造化フィールドに変換します。AstraZenecaでは、コマーシャルIT部門のデータ&AI責任者であるJoseph Roemer氏が「私たちのチームは、コードを一行も書くことなく、40万件を超える臨床試験文書を解析し、構造化データポイントを抽出できました」と報告しています。両顧客のコメントは、いずれもAgent Bricksのローンチリリースからの引用です。
Supervisor Agentは、マルチエージェントシステムを調整します。Genie Agents、エージェントエンドポイント、Unity Catalog関数、MCPサーバー、カスタムエージェントの間で作業をルーティングするため、単一のエンドポイントで複数の専門領域をまたぐことができます。1つのスーパーバイザーが扱えるエージェントは最大50で、エンドユーザーにはやり取りする各サブエージェントへの明示的なアクセス権が必要です。また、Web検索の利用可否はリージョンとセキュリティ構成に依存します。
Agent Bricksがコストについて教えてくれないことは?
Agent Bricksは、どのユーザーとどのエージェントがAI予算を使っているかを教えてくれます。しかし、その支出がどのワークスペース、ジョブ、クラスター、モデルサービングエンドポイントから発生したかは教えてくれません。この死角は、エージェントのworkloadsが増えるほど広がっていきます。
Unity AI Gatewayは予算とハード支出上限を強制し、ユーザー、チーム、アプリケーション、モデルプロバイダーをまたいでトークン消費を追跡します。「どのチームがモデル予算を消費しているのか」という問いであれば、プラットフォームが答えてくれます。
これらの予算と上限が適用されるのは、エージェント、ツール、モデル、MCPサービスです。その下にあるジョブ別・クラスター別のコンピュートコストには届きません。エージェントの実行はすべてサーバーレスコンピュートを消費し、そこではインフラコストがDBUレートに織り込まれており、そのworkloadが生み出すネットワークとストレージの費用は、変わらずクラウドの請求書に計上されます。
この第二のレイヤーこそ、私たちがSELECTを作った理由です。あらゆるDatabricksのworkloadは、Databricksが裏側でプロビジョニングするクラウドインフラ支出の並行レイヤーと、それに伴うネットワークおよびクラウドストレージのコストを生み出します。これらはクラウドプロバイダーから直接請求され、Databricks自身のレポートには表示されないため、専用のツールなしには真の総所有コストは把握できません。
モデルサービングは、この問題が最も深刻になる領域であり、まさにAgent Bricksが生み出すものです。DatabricksがAIモデルのトレーニングと推論の主要な拠点になるにつれ、モデルサービングのコストは急速に増大しており、従来のworkloadsと比べてもネイティブな可視性と制御手段はさらに乏しいのが現状です。
どのようなDatabricksコスト最適化フレームワークであっても、この2つのレイヤーを突き合わせる必要があります。SELECT for Databricksは読み取り専用のサービスプリンシパルで接続し、DoiTによれば、クラスター構成を調整することで全workloadsのコストを最大30%削減します。
Databricksを運用していて、AIモデルサービングコストの詳細な可視性を求めるチームは、約20分でSELECTを接続できます。デモを予約する。
よくある質問
Databricks Agent BricksとMosaic AIの違いは何ですか?
Mosaic AIは、Model Serving、基盤モデルAPI、ベクター検索、そして基盤となるエージェントインフラをカバーする、Databricksのより広範なAI製品レイヤーです。Agent Bricksはその上に位置するエージェント構築製品で、ループ、ツール連携、評価、最適化を代わりに処理します。
Agent Bricksの4種類のエージェントとは何ですか?
Databricksは、Agent Bricksを4つのエージェントタイプとともに発表しました。Knowledge Assistantは企業データに基づく質問回答、Information Extractionはドキュメントの構造化フィールドへの変換、Supervisor Agentはマルチエージェントシステムの実現、Custom LLM Agentはカスタムタスク向けのテキスト変換を担います。Information Extractionはその後、解析・抽出・分類を包括するDocument Intelligenceの傘下に移りました。本記事で本番業務の形を4つではなく3つとして扱っているのはそのためです。
Agent BricksはLangGraphやその他のフレームワークをサポートしていますか?
はい。Databricksは「開発者が使いたいあらゆるエージェントハーネス」をサポートすると述べており、LangGraph、Agno、CrewAIなどのオープンソースフレームワークに加え、Claude Code SDKやOpenAI Agent SDKといったハーネスを挙げています。Omnigentもサポートされています。
Agent Bricksはエージェントのメモリをどう扱いますか?
Lakebaseとのネイティブ統合を通じて扱います。Databricksはこれを、長時間実行されるワークフローに「メモリ、会話履歴、状態」を提供するものと説明しています。DatabricksはLakebaseを、エージェントのチャットセッションとメッセージの永続ストレージと位置づけており、「ユーザーは会話を再開でき、エージェントはデプロイをまたいで過去のやり取りをもとに推論できる」としています。
Agent Bricksのアクセス要件は何ですか?
Unity Catalogが有効なワークスペース、サーバーレスコンピュートが利用可能であること、Model Servingへのアクセス、サーバーレス使用ポリシーへのアクセス、そしてサポート対象リージョンにあることです。さらに、ワークスペース管理者がMosaic AI Agent Bricksプレビューを有効化する必要があります。
Agent Bricksで構築されたエージェントの数は?
Databricksによると、2025年6月のローンチ以来10万を超えるエージェントが構築され、年間1,000兆を超えるトークンを処理しています。