
Faire fonctionner un agent IA n'est plus la partie difficile. Vous pouvez brancher une boucle de génération augmentée par récupération (RAG) sur un endpoint de modèle, lui confier deux outils et obtenir un résultat convaincant avant la pause déjeuner. Ce qui prend des mois, c'est de faire passer ce même agent par une revue de sécurité, puis de l'inscrire dans un budget que quelqu'un acceptera de valider.
Databricks Agent Bricks a été conçu pour ce second problème. Il intègre le travail qui entoure un agent à la plateforme Databricks : choix du modèle, récupération, mémoire et application des politiques s'exécutent sur Unity Catalog, la même couche de gouvernance qui décide déjà qui peut lire vos tables.
TL;DR
- Databricks Agent Bricks est une plateforme pour créer, exécuter et gouverner des agents IA en production sur vos propres données.
- Databricks indique que la boucle de l'agent elle-même ne représente "que 1 % du travail" sur les plus de 100 000 agents créés sur sa plateforme. Déploiement, sécurité, évaluation, monitoring, contexte et coûts constituent les 99 % restants.
- Agent Bricks organise ce travail en trois volets. Choice désigne les modèles et frameworks utilisables, Context ce que l'agent sait réellement, et Control ce que l'agent a le droit de faire.
- Pour l'exécuter, il vous faut Unity Catalog, du compute serverless, l'activation de la préversion Mosaic AI Agent Bricks et une politique d'utilisation serverless.
Pourquoi les agents d'entreprise calent-ils avant la mise en production ?
La boucle de l'agent est la partie que les équipes réussissent. C'est tout ce qui l'entoure qui fait caler les agents d'entreprise. Après plus de 100 000 agents créés sur sa plateforme, Databricks évalue la boucle centrale de l'agent à "à peine 1 % du travail", les 99 % restants allant à "la dette technique cachée des systèmes agentiques : capacité en tokens, déploiement, sécurité, évaluation, monitoring, contexte, partage".
Chaque élément de cette liste arrive une fois que la démo fonctionne déjà. Vous avez un assistant qui tourne sur votre propre ordinateur portable, puis les questions commencent.
- Sur quel modèle bascule-t-il lorsque le fournisseur principal vous limite en débit ?
- Qui a le droit d'invoquer l'outil qui écrit dans les tables de production ?
- Comment savez-vous que ses réponses se sont améliorées après la modification de prompt de la semaine dernière ?
- Qu'advient-il de l'état de la conversation lorsque le processus de serving redémarre ?
- Sur quel budget atterrit la dépense en tokens ?
Rien de tout cela ne relève de la boucle de l'agent, et tout cela se dresse entre vous et la production.
Un post de la communauté Databricks de juillet 2025 est plus direct encore : le passage du prototype à la production y est qualifié d'endroit "où les projets IA vont mourir". Ce même article communautaire met en cause la complexité, une évaluation insuffisante, des coûts croissants, des lacunes de gouvernance et un outillage dispersé.
Agent Bricks est la réponse de Databricks à ces 99 % : il prend en charge le déploiement, la sécurité, l'évaluation, le monitoring et les coûts en dehors de la boucle de l'agent. Il est conçu pour intégrer ce travail à la plateforme Databricks, là où vos données tournent déjà.
Qu'est-ce que Databricks Agent Bricks ?
Agent Bricks est la plateforme de Databricks pour créer, exécuter et gouverner des agents IA en production sur vos propres données. L'infrastructure dont ces agents ont besoin est livrée avec la plateforme.
Databricks l'a lancé en bêta au Data + AI Summit le 11 juin 2025, et l'accès reste conditionné à un toggle de préversion qu'un administrateur de workspace doit activer. Databricks indique que plus de 100 000 agents y ont été créés depuis, traitant désormais plus d'un million de milliards de tokens par an, et cite AstraZeneca, 7-Eleven, Fox Corporation et Block parmi ses clients.
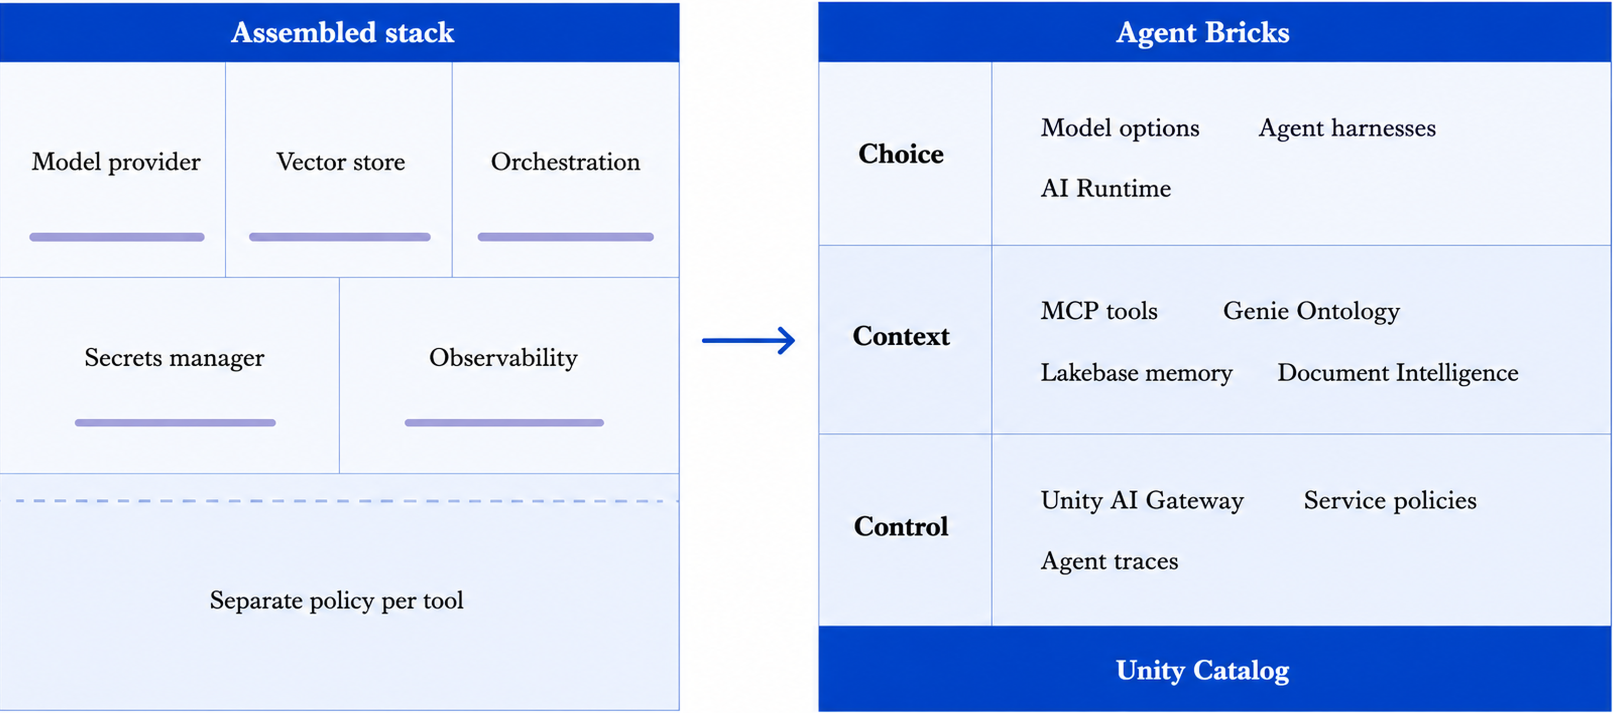
La différence avec un framework d'agents généraliste tient à l'endroit où vit la machinerie environnante. Avec un framework, vous choisissez un fournisseur de modèles, branchez un vector store, ajoutez une bibliothèque d'orchestration, construisez l'évaluation et le tracing, et maintenez vous-même une gouvernance cohérente sur l'ensemble. Agent Bricks traite l'accès aux modèles, le contexte des données et l'application des politiques comme des services de plateforme reposant sur Unity Catalog, qui détient déjà les permissions et le lineage des tables que vos agents lisent.
L'accès d'un agent aux données est donc celui de l'utilisateur à l'origine de la requête, appliqué par le même catalogue qui gouverne tout le reste. Il n'y a pas de second modèle de permissions à maintenir.
Comment Agent Bricks couvre-t-il les 99 % ?
Choice, Context et Control sont les trois problèmes autour desquels Databricks organise la plateforme. Choice répond au risque d'être verrouillé sur un seul modèle ou un seul framework. Context répond au cas des agents coupés de vos définitions métier et de vos documents. Control répond à celui des agents qui disposent de plus de privilèges que de supervision.
Choice : les modèles et frameworks utilisables
Vous n'êtes enfermé ni dans un modèle ni dans un framework d'agents. Databricks mise sur "la diversité des modèles afin de trouver le bon équilibre entre qualité et latence".
Un sous-agent qui se contente de router les questions vers le bon spécialiste n'a pas besoin du modèle qui rédige la réponse finale. Payer le prix d'un modèle frontier pour les deux est une source courante de dépenses évitables.
Les modèles accessibles via Agent Bricks incluent OpenAI, Anthropic, Gemini, Qwen, Kimi et Grok. Côté frameworks, Databricks déclare prendre en charge "n'importe quel harnais d'agent que les développeurs souhaitent utiliser, des frameworks open source comme LangGraph, Agno ou CrewAI aux harnais comme le Claude Code SDK ou les OpenAI Agent SDKs".
Si aucun des modèles disponibles ne convient, AI Runtime vous permet d'entraîner des Large Language Models (LLM) personnalisés sur vos propres données. Databricks cite Merck et First American parmi les clients qui le font.
Context : ce que l'agent sait réellement
Le contexte, c'est tout ce à quoi un agent accède au-delà des poids du modèle : vos outils, vos définitions métier, vos documents et ce qu'il retient des échanges précédents de la conversation. Databricks décrit les LLM comme de "puissantes machines à raisonner" qui "ont besoin de pouvoir récupérer et traiter le bon contexte pour prendre des décisions correctes du point de vue métier". Un modèle qui renvoie le bon chiffre depuis la mauvaise table est le cas le plus difficile à détecter, parce que la réponse semble correcte.
Les outils sont exposés à l'agent via Unity Catalog, qui décide qui peut utiliser quel outil. Des connecteurs OAuth managés implémentent le Model Context Protocol (MCP), un standard ouvert pour exposer outils et données aux modèles, et Databricks s'en sert pour "connecter de manière sécurisée des services externes comme GitHub, Atlassian et Glean en tant qu'outils gouvernés". Vous accordez une permission à un outil une seule fois et chaque agent qui l'appelle en hérite, ce qui évite de câbler des identifiants dans chaque agent séparément.
Genie Ontology porte vos définitions métier dans la vision que l'agent a des données. Document Intelligence analyse, extrait, classifie et gouverne les documents via des fonctions IA natives SQL, ce qui transforme contrats et PDF en données interrogeables. Et la mémoire d'agent adossée à Lakebase fournit "mémoire, historique de conversation et état" pour les workflows de longue durée. Sur la page produit Lakebase, cela signifie que les sessions de chat et les messages d'un agent persistent, afin que "les utilisateurs puissent reprendre leurs conversations et que votre agent puisse raisonner sur les échanges précédents d'un déploiement à l'autre".
Le contexte ne vous sert à rien si la récupération est lente ou scanne plus de données que nécessaire, et cela renvoie à l'organisation des données dans les tables que les agents lisent.
Databricks indique qu'ancrer les agents dans ce contexte métier apporte "une précision supérieure de 70 % par rapport au RAG standard et une amélioration de 30 % sur les workflows multi-étapes", et attribue ce gain à la combinaison des métadonnées Unity Catalog et des Genie Spaces.
Genie Ontology est l'un des quatre produits Genie, et ceux-ci facturent à la fois l'usage des LLM et le compute. Téléchargez notre ebook gratuit, Databricks Genie Explained, pour découvrir ce que fait chacun d'eux et ce qu'il coûte.
Control : ce que l'agent a le droit de faire
Control couvre ce qu'un agent peut faire, une question plus large que ce qu'il peut voir. La différence compte surtout dès qu'un agent peut écrire : une mauvaise lecture fait fuiter des données, une mauvaise écriture les modifie.
Les agents comptent parmi "les acteurs les plus privilégiés d'une entreprise, avec un accès à des données sensibles", selon l'évaluation de Databricks elle-même.
Unity AI Gateway est la couche chargée d'appliquer ces règles. Les agents héritent de l'identité de l'utilisateur à l'origine de la requête via le passage de token on-behalf-of, de sorte que l'identité est appliquée de bout en bout, sans compte de service se substituant à l'utilisateur. Des garde-fous filtrent les informations personnelles identifiables, les contenus dangereux, l'injection de prompt, l'exfiltration de données et les hallucinations.
Au-delà de l'accès, les politiques de service contextuelles contrôlent les actions. Elles sont en bêta, attendez-vous donc à ce qu'elles évoluent. Vous les définissez en SQL sous forme de fonctions Unity Catalog, et elles peuvent autoriser, refuser ou exiger une approbation pour des opérations telles que "modifier des fichiers, pousser du code, accéder à des systèmes d'entreprise ou interagir avec des informations sensibles". Les politiques s'appliquent selon l'utilisateur, l'agent, le modèle, le service MCP, l'outil invoqué ou le contenu de la requête et de la réponse. Si vous voulez qu'un humain valide avant qu'un agent pousse vers un dépôt de production, vous l'écrivez sous forme de politique et la plateforme l'applique.
Le tracing unifié capture les interactions avec les modèles et l'activité des outils MCP dans une seule couche de télémétrie gouvernée. Les traces atterrissent dans le Lakehouse pour l'analyse et dans Lakewatch, le produit SIEM (security information and event management) agentique de Databricks, pour l'investigation.
Control couvre aussi la dépense. Unity AI Gateway prend en charge des budgets et des plafonds de dépense stricts qui "arrêtent automatiquement les requêtes lorsque les budgets sont dépassés". Cette application est bien réelle, mais elle s'arrête à une frontière précise, que la section ci-dessous sur la visibilité des coûts aborde en détail.
De quoi avez-vous besoin pour exécuter Agent Bricks ?
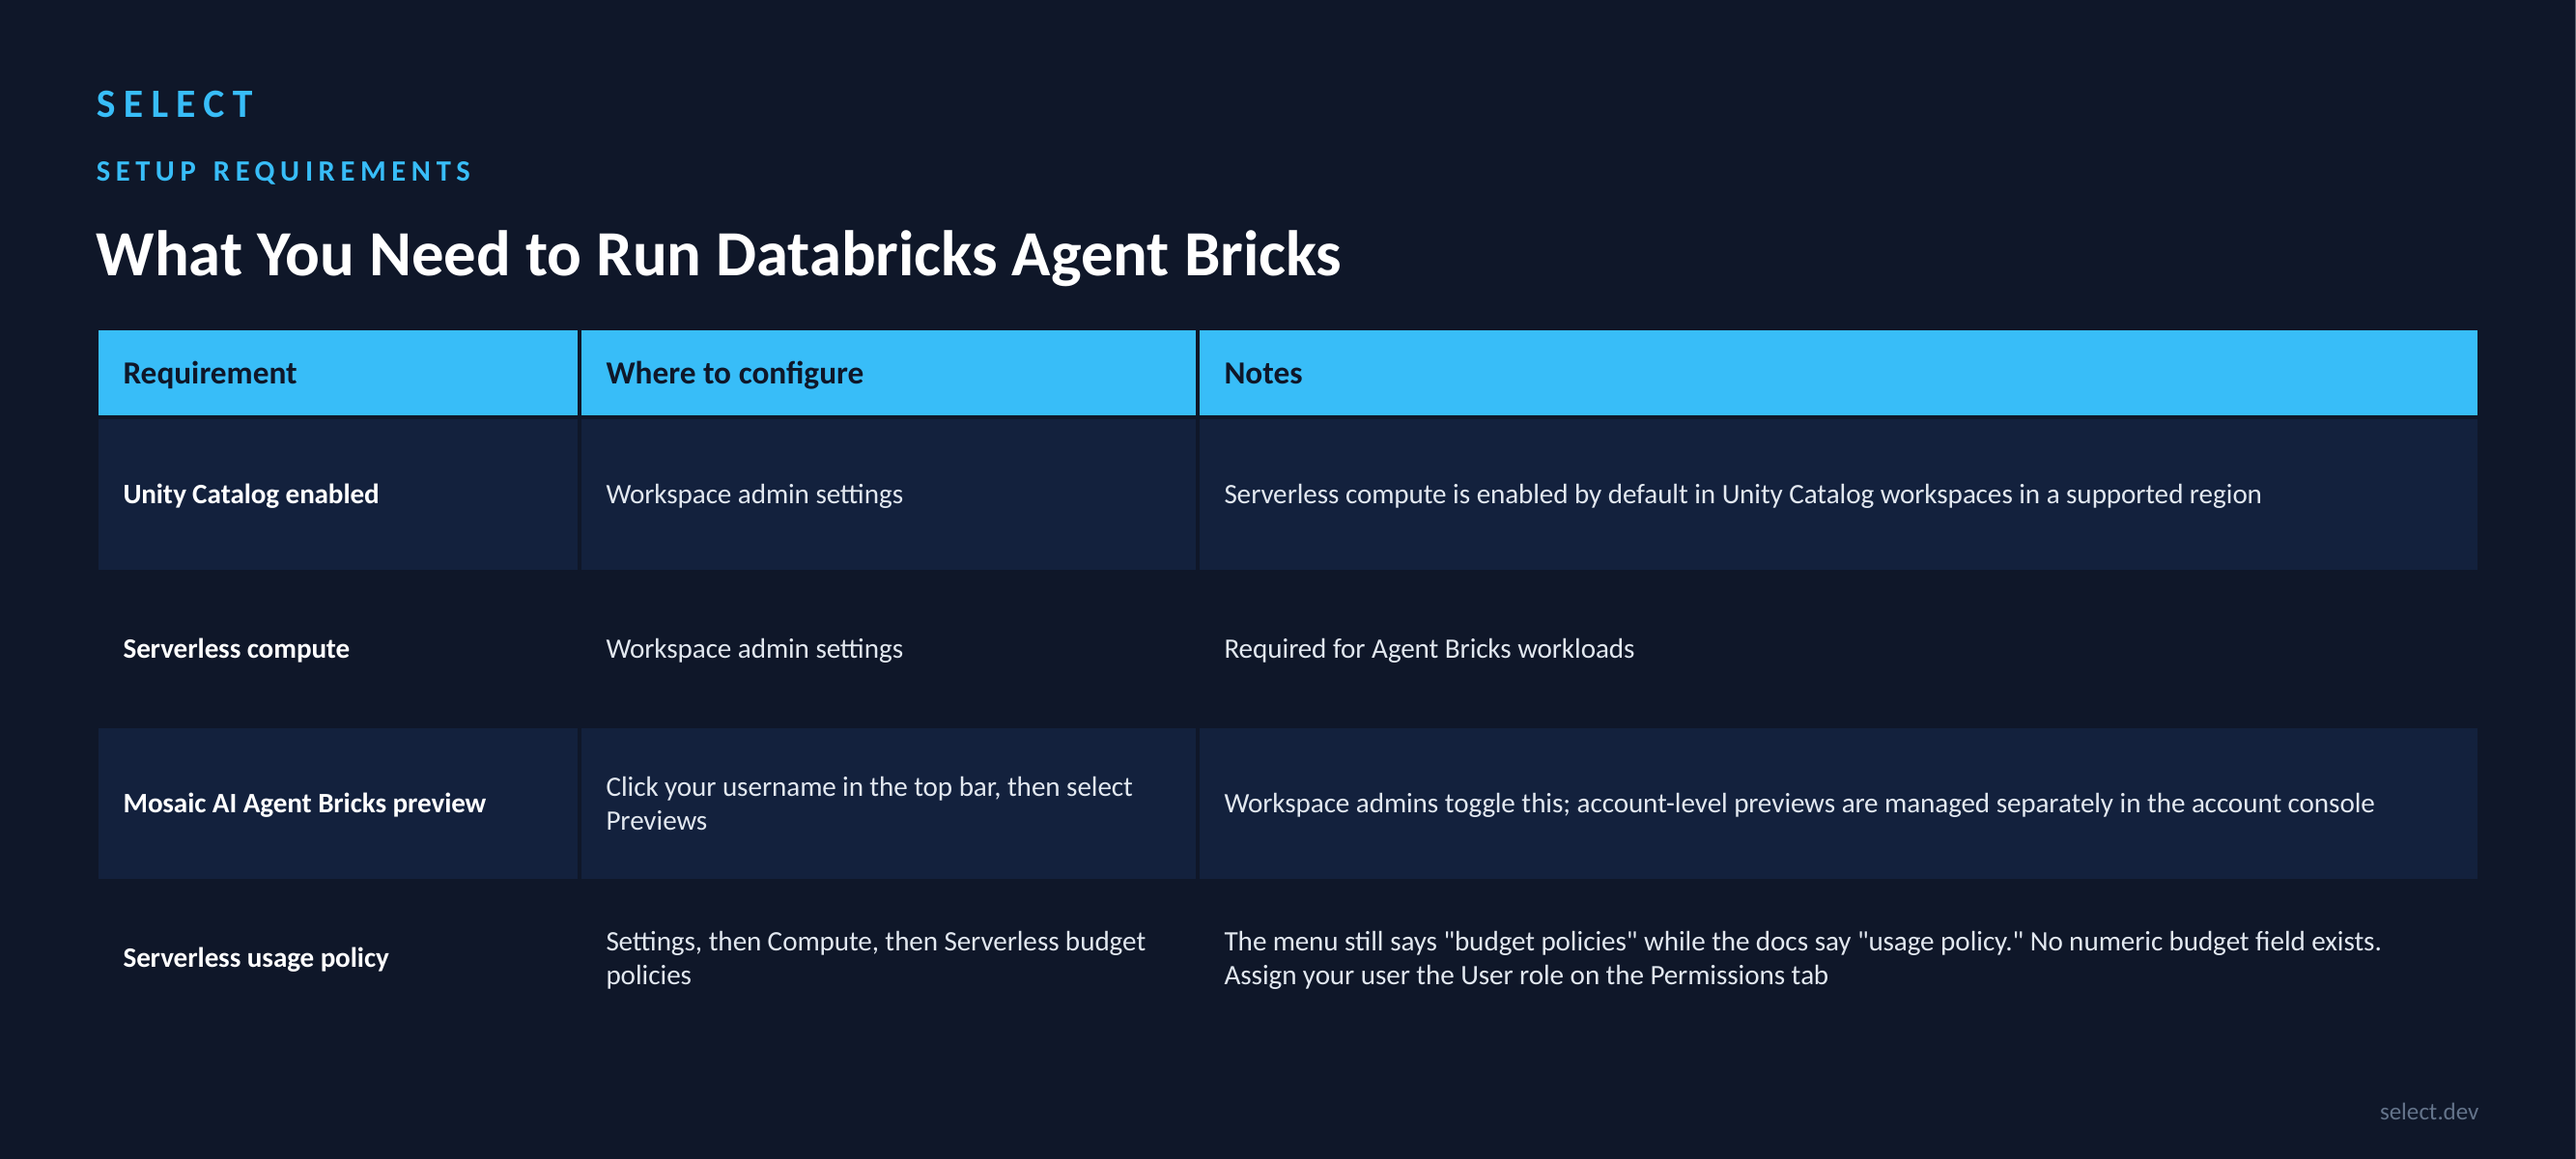
Votre workspace a besoin de quatre choses.
- Unity Catalog activé. Si vous n'avez pas encore mis cette couche en place, commencez par ce qu'est Unity Catalog et ce qu'il coûte.
- Compute serverless disponible. Databricks l'active par défaut dans les workspaces Unity Catalog situés dans une région prise en charge.
- La préversion Mosaic AI Agent Bricks activée. Un administrateur de workspace le fait depuis le panneau Previews.
- L'accès à une politique d'utilisation serverless. La documentation du Knowledge Assistant le formule ainsi : "accès à une politique d'utilisation serverless avec un budget non nul".
Cette quatrième exigence est celle qui bloque le plus. On lit "budget non nul", et il n'y a aucun montant à saisir. Les politiques d'utilisation serverless sont "des tags appliqués à toute activité de compute serverless", dont un employé de Databricks a confirmé dans un fil communautaire qu'il s'agit de "mécanismes de tagging pour l'attribution des coûts, pas de plafonds de dépense". Créez la politique sous Settings, puis Compute, puis Serverless budget policies, et attribuez à votre utilisateur le rôle User dans l'onglet Permissions.
La couverture régionale évolue, vérifiez-la donc avant de vous engager sur une région. En août 2026, Agent Bricks tourne directement dans neuf régions AWS et douze régions Azure, avec quatre régions supplémentaires sur AWS et treize sur Azure via le routage inter-géographies. Les listes à jour figurent dans les tableaux de disponibilité des fonctionnalités AWS et Azure, sous "Agent features availability".
Quels sont les cas d'usage réels d'Agent Bricks ?
Trois produits Agent Bricks couvrent les formes courantes du travail en production. Knowledge Assistant répond à des questions sur vos documents, Document Intelligence en extrait la structure et Supervisor Agent en coordonne plusieurs à la fois.
Knowledge Assistant répond à des questions ancrées dans vos documents. Hawaiian Electric l'a utilisé pour remplacer une implémentation open source existante. Son responsable data et analytics d'entreprise, Joel Wasson, a rapporté qu'"Agent Bricks a nettement surpassé notre implémentation open source d'origine, tant sur les métriques de précision LLM-as-judge que sur l'évaluation humaine".
Vérifiez d'abord les limites d'ingestion. Les fichiers de plus de 100 Mo et les documents PDF ou Office de plus de 500 pages sont ignorés, et un assistant accepte au maximum 10 sources de connaissances.
Document Intelligence transforme des documents non structurés en champs structurés. Chez AstraZeneca, Joseph Roemer, Head of Data & AI, Commercial IT, a rapporté que "nos équipes ont pu analyser plus de 400 000 documents d'essais cliniques et en extraire des points de données structurés — sans écrire une seule ligne de code". Les deux citations clients proviennent du communiqué de lancement d'Agent Bricks.
Supervisor Agent coordonne un système multi-agents. Il route le travail entre Genie Agents, endpoints d'agents, fonctions Unity Catalog, serveurs MCP et agents personnalisés, de sorte qu'un seul endpoint peut couvrir plusieurs domaines spécialisés. Un superviseur accepte au maximum 50 agents, les utilisateurs finaux ont besoin d'un accès explicite à chaque sous-agent avec lequel ils interagissent, et la disponibilité de la recherche web dépend de la région et de la configuration de sécurité.
Que ne vous dit pas Agent Bricks sur les coûts ?
Agent Bricks vous dit quelles personnes et quels agents dépensent votre budget IA. Il ne vous dit pas de quel workspace, job, cluster ou endpoint de model serving provient cette dépense, et cet angle mort s'élargit à mesure que les workloads agentiques grandissent.
Unity AI Gateway applique budgets et plafonds de dépense stricts, et suit la consommation de tokens par utilisateurs, équipes, applications et fournisseurs de modèles. Si votre question est "quelle équipe brûle le budget modèles", la plateforme y répond.
Ces budgets et plafonds s'appliquent aux agents, outils, modèles et services MCP. Ils n'atteignent pas le coût de compute par job et par cluster situé en dessous. Chaque exécution d'agent consomme du compute serverless, où l'infrastructure est intégrée au tarif DBU, et le réseau et le stockage générés par ce workload atterrissent toujours sur votre facture cloud.
Cette seconde couche est la raison pour laquelle nous avons créé SELECT. Chaque workload Databricks génère en parallèle une couche de dépenses d'infrastructure cloud que Databricks provisionne en coulisses, ainsi que des coûts associés de réseau et de stockage cloud. Votre fournisseur cloud les facture directement, le reporting natif de Databricks ne les montre pas, et le coût total de possession réel reste hors de portée sans outillage dédié.
C'est sur le model serving que cela fait le plus mal, et c'est exactement ce que génère Agent Bricks. Databricks étant devenu un lieu de prédilection pour l'entraînement et l'inférence de modèles IA, nous voyons les coûts de model serving croître rapidement, avec encore moins de visibilité native et de contrôles que pour les workloads traditionnels.
Tout framework d'optimisation des coûts Databricks doit réconcilier ces deux couches. SELECT for Databricks se connecte via un service principal en lecture seule et, selon DoiT, ajuste les configurations de clusters pour réduire les coûts de tous les workloads jusqu'à 30 %.
Les équipes utilisant Databricks qui souhaitent une visibilité granulaire sur les coûts de model serving IA peuvent connecter SELECT en 20 minutes environ. Réservez une démo.
Questions fréquentes
Quelle est la différence entre Databricks Agent Bricks et Mosaic AI ?
Mosaic AI est la couche produit IA globale de Databricks, couvrant Model Serving, les API de modèles de fondation, la recherche vectorielle et l'infrastructure d'agents sous-jacente. Agent Bricks est le produit de création d'agents qui repose dessus et gère pour vous la boucle, le câblage des outils, l'évaluation et l'optimisation.
Quels sont les quatre types d'agents Agent Bricks ?
Databricks a lancé Agent Bricks avec quatre types d'agents. Knowledge Assistant répond à des questions ancrées dans les données d'entreprise, Information Extraction transforme les documents en champs structurés, Supervisor Agent permet les systèmes multi-agents et Custom LLM Agent transforme du texte pour des tâches personnalisées. Information Extraction est depuis passé sous Document Intelligence, la capacité englobante pour l'analyse, l'extraction et la classification, raison pour laquelle cet article couvre trois formes de travail en production plutôt que quatre.
Agent Bricks prend-il en charge LangGraph et d'autres frameworks ?
Oui. Databricks déclare prendre en charge "n'importe quel harnais d'agent que les développeurs souhaitent utiliser", en citant des frameworks open source dont LangGraph, Agno et CrewAI, aux côtés de harnais comme le Claude Code SDK et les OpenAI Agent SDKs. Omnigent est également pris en charge.
Comment Agent Bricks gère-t-il la mémoire des agents ?
Via une intégration native avec Lakebase, que Databricks décrit comme fournissant "mémoire, historique de conversation et état pour les workflows de longue durée". Databricks positionne Lakebase comme le stockage persistant des sessions de chat et des messages d'un agent, afin que "les utilisateurs puissent reprendre leurs conversations et que votre agent puisse raisonner sur les échanges précédents d'un déploiement à l'autre".
Quelles sont les conditions d'accès à Agent Bricks ?
Un workspace avec Unity Catalog activé, du compute serverless disponible, l'accès à Model Serving, l'accès à une politique d'utilisation serverless et une localisation dans une région prise en charge. Un administrateur de workspace doit également activer la préversion Mosaic AI Agent Bricks.
Combien d'agents ont été créés sur Agent Bricks ?
Databricks indique que plus de 100 000 agents ont été créés depuis le lancement en juin 2025, traitant plus d'un million de milliards de tokens par an.