
Fazer um agente de IA funcionar deixou de ser a parte difícil. Você pode conectar um loop de geração aumentada por recuperação (RAG) a um endpoint de modelo, dar duas ferramentas a ele e ter algo convincente rodando antes do almoço. Fazer esse mesmo agente passar por uma revisão de segurança e caber em um orçamento que alguém vai aprovar — é aí que os meses se perdem.
O Databricks Agent Bricks foi criado para esse segundo problema. Ele leva para dentro da plataforma Databricks todo o trabalho que envolve um agente, de modo que escolha de modelo, recuperação, memória e aplicação de políticas rodam no Unity Catalog, a mesma camada de governança que já decide quem pode ler suas tabelas.
Resumo
- O Databricks Agent Bricks é uma plataforma para criar, executar e governar agentes de IA em produção com seus próprios dados.
- A Databricks relata que o loop do agente em si é "apenas 1% do trabalho" nos mais de 100.000 agentes criados na sua plataforma. Deploy, segurança, avaliação, monitoramento, contexto e custo são os outros 99%.
- O Agent Bricks organiza esse trabalho em três partes. Choice é quais modelos e frameworks você pode usar, Context é o que o agente realmente sabe e Control é o que o agente tem permissão para fazer.
- Para executá-lo, você precisa do Unity Catalog, de computação serverless, do toggle de preview do Mosaic AI Agent Bricks e de uma política de uso serverless.
Por que os agentes corporativos travam antes de entrar em produção?
O loop do agente é a parte que as equipes acertam. Tudo o que o cerca é onde os agentes corporativos travam. Depois de mais de 100.000 agentes criados em sua plataforma, a Databricks estima que o loop central do agente é "apenas 1% do trabalho", com os outros 99% indo para "a dívida técnica oculta dos sistemas agênticos: capacidade de tokens, deploy, segurança, avaliação, monitoramento, contexto, compartilhamento".
Cada item dessa lista aparece depois que a demo já funciona. Você tem um assistente rodando no seu próprio laptop, e então começam as perguntas.
- Para qual modelo ele faz fallback quando o provedor principal aplica rate limit?
- Quem tem permissão para invocar a ferramenta que escreve em tabelas de produção?
- Como você sabe que as respostas dele melhoraram depois da mudança de prompt da semana passada?
- O que acontece com o estado da conversa quando o processo de serving reinicia?
- No orçamento de quem cai o gasto com tokens?
Nada disso é o loop do agente, e tudo isso está entre você e a produção.
Um post da Databricks Community de julho de 2025 é ainda mais direto, chamando o salto do protótipo para a produção de "onde os projetos de IA vão para morrer". A mesma publicação da comunidade aponta como culpados a complexidade, a avaliação fraca, os custos crescentes, as lacunas de governança e o ferramental disperso.
O Agent Bricks é a resposta da Databricks para esses 99%, ou seja, ele cuida de deploy, segurança, avaliação, monitoramento e custo fora do loop do agente. Ele foi construído para transformar esse trabalho em parte da plataforma Databricks, onde seus dados já rodam.
O que é o Databricks Agent Bricks?
O Agent Bricks é a plataforma da Databricks para criar, executar e governar agentes de IA em produção com seus próprios dados. A infraestrutura de que esses agentes precisam já vem com a plataforma.
A Databricks o lançou no Data + AI Summit em 11/06/2025 em Beta, e o acesso ainda depende de um toggle de preview do workspace que um administrador precisa ativar. A Databricks relata que mais de 100.000 agentes foram criados nele desde então, processando agora mais de 1 quatrilhão de tokens por ano, e cita AstraZeneca, 7-Eleven, Fox Corporation e Block entre seus clientes.
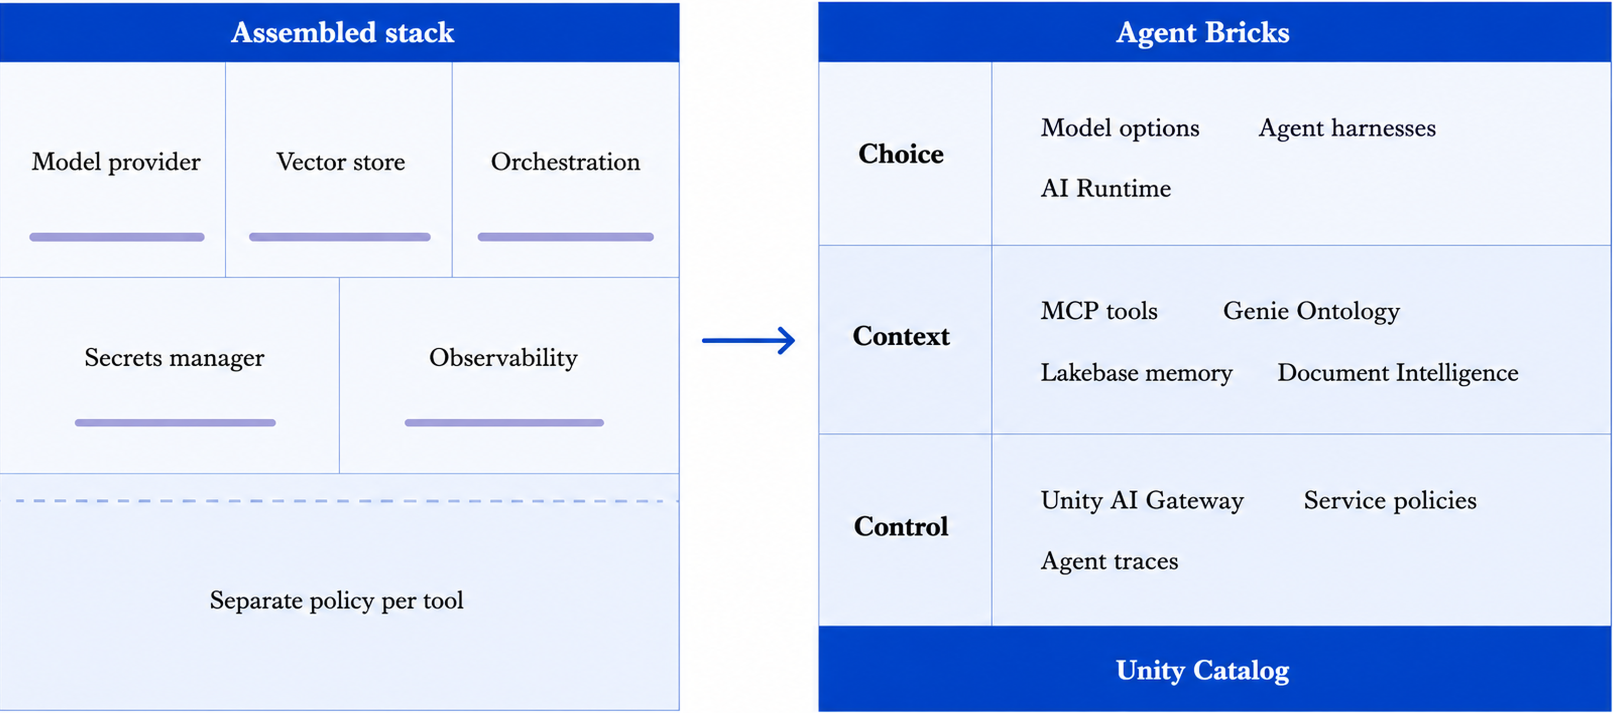
A diferença em relação a um framework de agentes de uso geral está no lugar onde vive toda a engrenagem ao redor. Com um framework, você escolhe um provedor de modelo, conecta um vector store, adiciona uma biblioteca de orquestração, constrói avaliação e tracing e mantém a governança coerente em tudo isso por conta própria. O Agent Bricks trata acesso a modelos, contexto de dados e aplicação de políticas como serviços da plataforma apoiados no Unity Catalog, que já guarda as permissões e a linhagem das tabelas que seus agentes leem.
Assim, o acesso de um agente aos dados é o acesso do usuário que fez a solicitação, aplicado pelo mesmo catálogo que governa todo o resto. Não há um segundo modelo de permissões para manter.
Como o Agent Bricks cobre os 99%?
Choice, Context e Control são os três problemas em torno dos quais a Databricks organiza a plataforma. Choice responde ao risco de ficar preso a um único modelo ou framework. Context responde a agentes que não alcançam suas definições de negócio e documentos. Control responde a agentes com mais privilégios do que supervisão.
Choice: quais modelos e frameworks você pode usar
Você não fica preso a um único modelo ou framework de agentes. A Databricks constrói com foco em "diversidade de modelos para encontrar o equilíbrio certo entre qualidade e latência".
Um subagente que apenas roteia perguntas para o especialista certo não precisa do modelo que redige a resposta final. Pagar preços de modelos de fronteira pelos dois é uma fonte comum de gasto evitável.
Os modelos acessíveis pelo Agent Bricks incluem OpenAI, Anthropic, Gemini, Qwen, Kimi e Grok. Quanto aos frameworks, a Databricks afirma suportar "qualquer agent harness que os desenvolvedores queiram usar, de frameworks open source como LangGraph, Agno e CrewAI a harnesses como o Claude Code SDK ou os OpenAI Agent SDKs".
Se nenhum dos modelos disponíveis servir, o AI Runtime permite treinar Large Language Models (LLMs) personalizados com seus próprios dados. A Databricks cita Merck e First American entre os clientes que fazem isso.
Context: o que o agente realmente sabe
Contexto é tudo o que um agente alcança além dos pesos do próprio modelo: suas ferramentas, suas definições de negócio, seus documentos e o que ele lembra de momentos anteriores da conversa. A Databricks descreve os LLMs como "máquinas de raciocínio poderosas" que "precisam da capacidade de recuperar e processar o contexto certo para tomar decisões corretas do ponto de vista do negócio". Um modelo que retorna o número certo da tabela errada é o caso mais difícil de detectar, porque a resposta parece boa.
As ferramentas chegam ao agente pelo Unity Catalog, que é quem decide quem pode usar qual ferramenta. Conectores OAuth gerenciados implementam o Model Context Protocol (MCP), um padrão aberto para expor ferramentas e dados a modelos, e a Databricks os usa para "conectar com segurança serviços externos como GitHub, Atlassian e Glean como ferramentas governadas". Você concede permissão a uma ferramenta uma única vez e todo agente que a chama herda essa permissão, o que evita configurar credenciais em cada agente separadamente.
A Genie Ontology leva suas definições de negócio para a visão que o agente tem dos dados. O Document Intelligence analisa, extrai, classifica e governa documentos por meio de funções de IA nativas de SQL, o que transforma contratos e PDFs em algo que você pode consultar. E a memória de agente com suporte do Lakebase fornece "memória, histórico de conversas e estado" para workflows de longa duração. Na página do produto Lakebase, isso significa que as sessões de chat e as mensagens de um agente persistem, de modo que "os usuários podem retomar conversas e seu agente pode raciocinar sobre interações anteriores entre deploys".
Contexto não ajuda em nada se a recuperação for lenta ou varrer mais dados do que o necessário, e isso nos leva de volta ao layout dos dados das tabelas que os agentes leem.
A Databricks relata que ancorar os agentes nesse contexto de negócio entrega "70% mais precisão do que o RAG padrão e uma melhoria de 30% em workflows de múltiplas etapas", e credita o ganho à combinação dos metadados do Unity Catalog com os Genie Spaces.
A Genie Ontology é um dos quatro produtos Genie, e todos cobram tanto pelo uso de LLM quanto pela computação. Baixe nosso ebook gratuito, Databricks Genie Explained, para ver o que cada um faz e quanto custa.
Control: o que o agente tem permissão para fazer
Control cobre o que um agente pode fazer, uma pergunta mais ampla do que o que ele pode ver. A diferença importa principalmente quando um agente pode escrever, porque uma leitura ruim vaza dados, mas uma escrita ruim os altera.
Os agentes são "alguns dos atores mais privilegiados de uma empresa, com acesso a dados sensíveis", na avaliação da própria Databricks.
O Unity AI Gateway é a camada responsável pela aplicação das políticas. Os agentes herdam a identidade do usuário solicitante por meio de on-behalf-of token passing, então a identidade é garantida de ponta a ponta, sem conta de serviço no lugar do usuário. Guardrails filtram informações de identificação pessoal, conteúdo inseguro, injeção de prompt, exfiltração de dados e alucinações.
Além do acesso, as políticas contextuais de serviço controlam ações. Elas estão em Beta, então espere mudanças. Você as define em SQL como funções do Unity Catalog, e elas podem permitir, negar ou exigir aprovação para operações como "modificar arquivos, enviar código, acessar sistemas corporativos ou interagir com informações sensíveis". As políticas se aplicam com base no usuário, no agente, no modelo, no serviço MCP, na ferramenta invocada ou no conteúdo da solicitação e da resposta. Se você quiser que um humano aprove antes de um agente fazer push para um repositório de produção, basta escrever isso como uma política e a plataforma a aplica.
O tracing unificado captura interações com modelos e atividade de ferramentas MCP em uma única camada de telemetria governada. Os traces caem no Lakehouse para análise e no Lakewatch, o produto agêntico de security information and event management (SIEM) da Databricks, para investigação.
Control também cobre gastos. O Unity AI Gateway suporta orçamentos e limites rígidos de gasto que "interrompem automaticamente as solicitações quando os orçamentos são excedidos". Essa aplicação é real, mas para em uma fronteira específica, que a seção de visibilidade de custos abaixo retoma.
O que você precisa para executar o Agent Bricks?
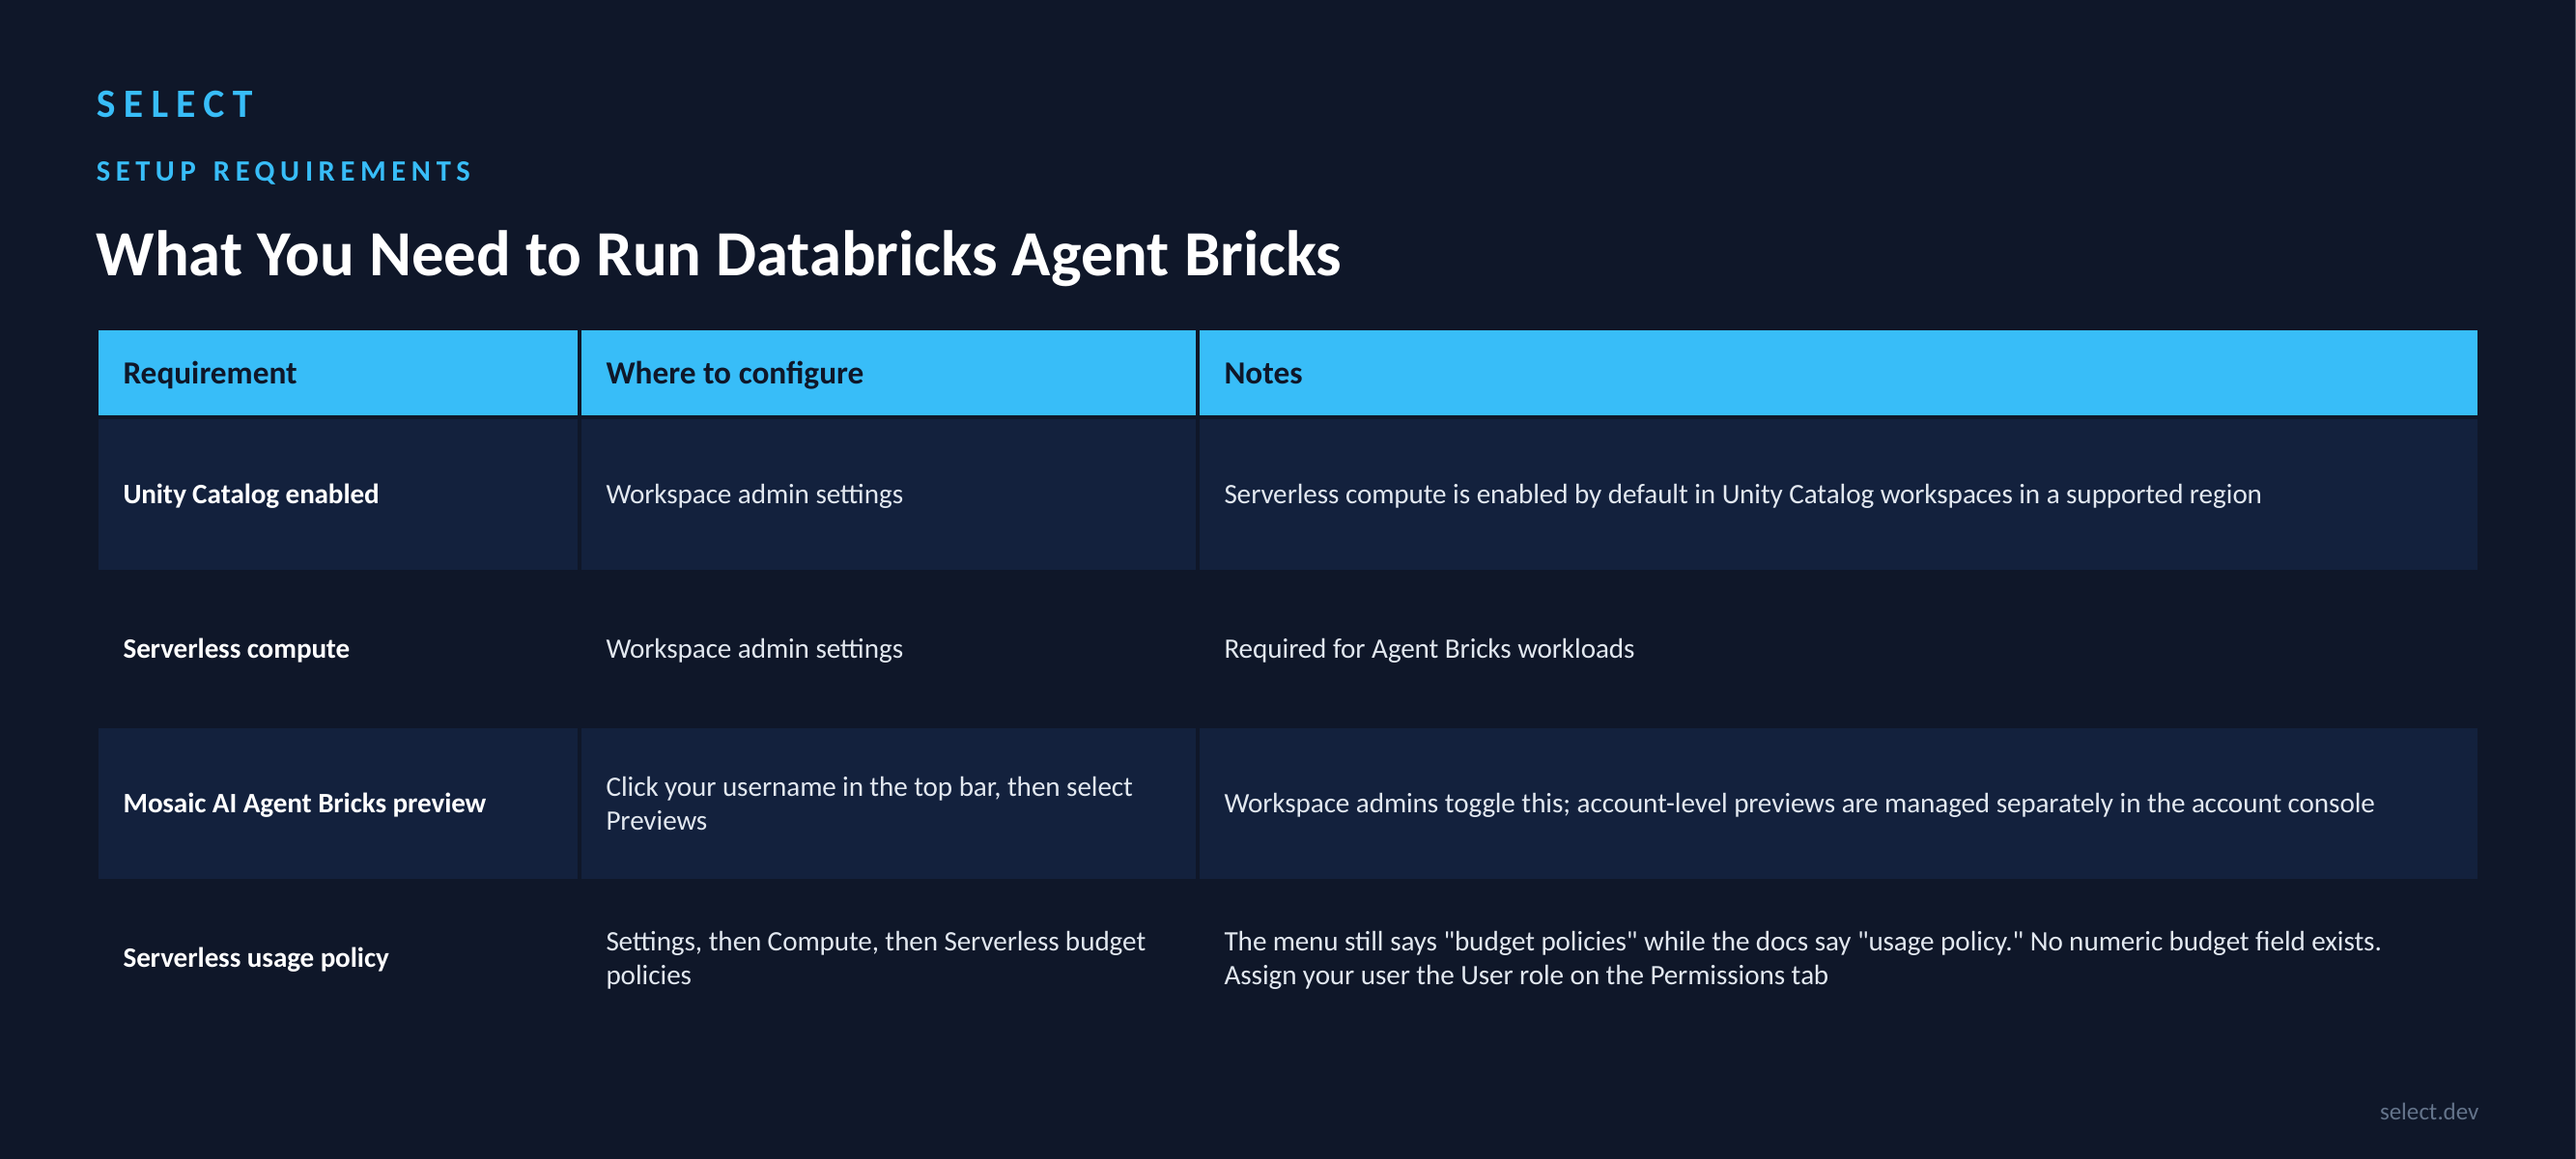
Seu workspace precisa de quatro coisas.
- Unity Catalog habilitado. Se você ainda não montou essa camada, comece por o que é o Unity Catalog e quanto ele custa.
- Computação serverless disponível. A Databricks habilita isso por padrão em workspaces com Unity Catalog em uma região suportada.
- O preview do Mosaic AI Agent Bricks ativado. Um administrador do workspace faz isso no painel de Previews.
- Acesso a uma política de uso serverless. A documentação do Knowledge Assistant descreve isso como "acesso a uma política de uso serverless com orçamento diferente de zero".
Esse quarto requisito é o que costuma travar as pessoas. Está escrito "orçamento diferente de zero", mas não há nenhum campo para informar valor. Políticas de uso serverless são "tags aplicadas a qualquer atividade de computação serverless", o que um funcionário da Databricks confirmou em uma thread da comunidade: são "mecanismos de tagueamento para atribuição de custos, não limites de gasto". Crie a política em Settings, depois Compute e, em seguida, Serverless budget policies, e conceda ao seu usuário a função User na aba Permissions.
A cobertura de regiões muda, então verifique antes de se comprometer com uma. Em agosto de 2026, o Agent Bricks roda diretamente em nove regiões da AWS e doze do Azure, com mais quatro na AWS e mais treze no Azure via roteamento entre geografias. As listas atuais estão nas tabelas de disponibilidade de recursos da AWS e do Azure, em "Agent features availability".
Quais são os casos de uso reais do Agent Bricks?
Três produtos do Agent Bricks cobrem os formatos mais comuns de trabalho em produção. O Knowledge Assistant responde perguntas sobre seus documentos, o Document Intelligence extrai estrutura deles e o Supervisor Agent coordena vários ao mesmo tempo.
Knowledge Assistant responde perguntas ancoradas nos seus documentos. A Hawaiian Electric o usou para substituir uma implementação open source existente. Seu gerente de dados e analytics corporativos, Joel Wasson, relatou que "o Agent Bricks superou significativamente nossa implementação open source original tanto nas métricas de precisão de LLM-as-judge quanto na avaliação humana".
Verifique primeiro os limites de ingestão. Arquivos acima de 100 MB e documentos PDF ou Office com mais de 500 páginas são ignorados, e um assistente aceita no máximo 10 fontes de conhecimento.
Document Intelligence transforma documentos não estruturados em campos estruturados. Na AstraZeneca, Joseph Roemer, Head of Data & AI, Commercial IT, relatou que "nossas equipes conseguiram analisar mais de 400.000 documentos de ensaios clínicos e extrair dados estruturados — sem escrever uma única linha de código". As duas citações de clientes vêm do comunicado de lançamento do Agent Bricks.
Supervisor Agent coordena um sistema multiagente. Ele roteia trabalho entre Genie Agents, endpoints de agentes, funções do Unity Catalog, servidores MCP e agentes personalizados, de modo que um único endpoint pode abranger domínios especializados. Um supervisor aceita no máximo 50 agentes, os usuários finais precisam de acesso explícito a cada subagente com que interagem, e a disponibilidade de busca na web depende da região e da configuração de segurança.
O que o Agent Bricks não mostra sobre custos?
O Agent Bricks mostra quais pessoas e quais agentes estão consumindo seu orçamento de IA. Ele não mostra de qual workspace, job, cluster ou endpoint de model serving veio esse gasto, e esse ponto cego se amplia à medida que os workloads de agentes crescem.
O Unity AI Gateway aplica orçamentos e limites rígidos de gasto e rastreia o consumo de tokens entre usuários, equipes, aplicações e provedores de modelos. Se a sua pergunta é "qual equipe está queimando o orçamento de modelos", a plataforma responde.
Esses orçamentos e limites se aplicam a agentes, ferramentas, modelos e serviços MCP. Eles não alcançam o custo de computação por job e cluster na camada de baixo. Cada execução de agente consome computação serverless, em que a infraestrutura está embutida na taxa de DBU, e a rede e o armazenamento gerados por esse workload continuam caindo na sua fatura de nuvem.
Essa segunda camada é o motivo pelo qual criamos o SELECT. Todo workload do Databricks gera uma camada paralela de gastos com infraestrutura de nuvem que a Databricks provisiona por baixo dos panos, junto com os custos associados de rede e armazenamento em nuvem. Seu provedor de nuvem cobra isso diretamente, os relatórios da própria Databricks não mostram, e o verdadeiro custo total de propriedade fica fora de alcance sem ferramentas dedicadas.
É no model serving que isso mais dói, e é exatamente o que o Agent Bricks gera. À medida que o Databricks se consolida como um dos principais destinos para treinamento e inferência de modelos de IA, vemos os custos de model serving crescendo rapidamente, com ainda menos visibilidade nativa e menos controles do que os workloads tradicionais.
Qualquer framework de otimização de custos do Databricks precisa conciliar as duas camadas. O SELECT para Databricks se conecta por meio de um service principal somente leitura e, segundo a DoiT, ajusta configurações de cluster para reduzir os custos de todos os workloads em até 30%.
Equipes que usam Databricks e querem visibilidade granular dos custos de model serving de IA podem conectar o SELECT em cerca de 20 minutos. Agende uma demo.
Perguntas frequentes
Qual é a diferença entre o Databricks Agent Bricks e o Mosaic AI?
O Mosaic AI é a camada mais ampla de produtos de IA da Databricks, cobrindo Model Serving, APIs de foundation models, vector search e a infraestrutura de agentes subjacente. O Agent Bricks é o produto de criação de agentes que fica por cima dela e cuida do loop, da conexão de ferramentas, da avaliação e da otimização para você.
Quais são os quatro tipos de agentes do Agent Bricks?
A Databricks lançou o Agent Bricks com quatro tipos de agentes. O Knowledge Assistant responde perguntas ancoradas em dados corporativos, o Information Extraction transforma documentos em campos estruturados, o Supervisor Agent habilita sistemas multiagente e o Custom LLM Agent transforma texto para tarefas personalizadas. Desde então, o Information Extraction passou a fazer parte do Document Intelligence, o recurso guarda-chuva para análise, extração e classificação, razão pela qual este artigo cobre três formatos de trabalho em produção em vez de quatro.
O Agent Bricks suporta LangGraph e outros frameworks?
Sim. A Databricks afirma suportar "qualquer agent harness que os desenvolvedores queiram usar", citando frameworks open source como LangGraph, Agno e CrewAI, além de harnesses como o Claude Code SDK e os OpenAI Agent SDKs. O Omnigent também é suportado.
Como o Agent Bricks lida com a memória do agente?
Por meio de integração nativa com o Lakebase, que, segundo a Databricks, fornece "memória, histórico de conversas e estado" para workflows de longa duração. A Databricks posiciona o Lakebase como armazenamento persistente para as sessões de chat e mensagens de um agente, de modo que "os usuários podem retomar conversas e seu agente pode raciocinar sobre interações anteriores entre deploys".
Quais são os requisitos de acesso do Agent Bricks?
Um workspace com Unity Catalog habilitado, computação serverless disponível, acesso ao Model Serving, acesso a uma política de uso serverless e localização em uma região suportada. Um administrador do workspace também precisa ativar o preview do Mosaic AI Agent Bricks.
Quantos agentes já foram criados no Agent Bricks?
A Databricks relata que mais de 100.000 agentes foram criados desde o lançamento em junho de 2025, processando mais de 1 quatrilhão de tokens por ano.