
Far funzionare un agente AI non è più la parte difficile. Si può collegare un loop di retrieval-augmented generation (RAG) a un endpoint del modello, dargli due tool e avere qualcosa di convincente in funzione prima di pranzo. I mesi se ne vanno invece a far superare a quello stesso agente una security review e a inserirlo in un budget che qualcuno sia disposto ad approvare.
Databricks Agent Bricks nasce per quel secondo problema. Sposta tutto il lavoro che circonda un agente dentro la piattaforma Databricks, così la scelta del modello, il retrieval, la memoria e l'enforcement delle policy girano tutti su Unity Catalog, lo stesso layer di governance che già decide chi può leggere le Sue tabelle.
TL;DR
- Databricks Agent Bricks è una piattaforma per creare, eseguire e governare agenti AI in produzione sui propri dati.
- Databricks riporta che il loop dell'agente in sé è "appena l'1% del lavoro" sugli oltre 100.000 agenti costruiti sulla sua piattaforma. Deployment, sicurezza, valutazione, monitoraggio, contesto e costi sono il restante 99%.
- Agent Bricks organizza questo lavoro in tre parti. Choice riguarda quali modelli e framework si possono usare, Context è ciò che l'agente sa davvero e Control è ciò che l'agente è autorizzato a fare.
- Per usarlo servono Unity Catalog, il compute serverless, il toggle di anteprima Mosaic AI Agent Bricks e una serverless usage policy.
Perché gli agenti enterprise si bloccano prima del rilascio?
Il loop dell'agente è la parte che i team riescono a fare bene. È tutto ciò che gli sta attorno a far arenare gli agenti enterprise. Dopo oltre 100.000 agenti costruiti sulla sua piattaforma, Databricks stima il loop core dell'agente in "appena l'1% del lavoro", mentre il restante 99% va al "debito tecnico nascosto dei sistemi agentici: capacità di token, deployment, sicurezza, valutazione, monitoraggio, contesto, condivisione".
Ogni voce di quell'elenco arriva dopo che la demo funziona già. L'assistente gira sul Suo laptop, e poi iniziano le domande.
- Su quale modello fa fallback quando il provider principale applica il rate limiting?
- Chi è autorizzato a invocare il tool che scrive sulle tabelle di produzione?
- Come si fa a sapere se le risposte sono migliorate dopo la modifica al prompt della settimana scorsa?
- Che fine fa lo stato della conversazione quando il processo di serving si riavvia?
- Su quale budget ricade la spesa in token?
Niente di tutto questo è il loop dell'agente, eppure è tutto ciò che La separa dalla produzione.
Un post della Databricks Community di luglio 2025 è ancora più diretto e definisce il salto dal prototipo alla produzione "il punto in cui i progetti AI vanno a morire". Lo stesso articolo, pubblicato dalla community, punta il dito su complessità, valutazioni deboli, costi in aumento, lacune di governance e tooling frammentato.
Agent Bricks è la risposta di Databricks a quel 99%: gestisce deployment, sicurezza, valutazione, monitoraggio e costi al di fuori del loop dell'agente. È costruito per rendere questo lavoro parte della piattaforma Databricks su cui girano già i Suoi dati.
Che cos'è Databricks Agent Bricks?
Agent Bricks è la piattaforma di Databricks per creare, eseguire e governare agenti AI in produzione sui propri dati. L'infrastruttura di cui questi agenti hanno bisogno è inclusa nella piattaforma.
Databricks l'ha lanciata al Data + AI Summit l'11 giugno 2025 in Beta, e l'accesso è ancora vincolato a un toggle di anteprima del workspace che un amministratore deve attivare. Databricks riporta che da allora sono stati costruiti oltre 100.000 agenti, che oggi elaborano più di un milione di miliardi di token all'anno, e cita AstraZeneca, 7-Eleven, Fox Corporation e Block tra i suoi clienti.
La differenza rispetto a un framework per agenti general-purpose sta nella collocazione di tutta la meccanica circostante. Con un framework si sceglie un model provider, si collega un vector store, si aggiunge una libreria di orchestrazione, si costruiscono valutazione e tracing e si mantiene da soli una governance coerente su tutto. Agent Bricks tratta accesso ai modelli, contesto dei dati ed enforcement delle policy come servizi di piattaforma che poggiano su Unity Catalog, che contiene già i permessi e la lineage delle tabelle lette dai Suoi agenti.
L'accesso ai dati di un agente coincide quindi con quello dell'utente che fa la richiesta, applicato dallo stesso catalogo che governa tutto il resto. Non c'è un secondo modello di permessi da mantenere.
Come copre Agent Bricks il restante 99%?
Choice, Context e Control sono i tre problemi attorno a cui Databricks organizza la piattaforma. Choice risponde al rischio di restare vincolati a un solo modello o a un solo framework. Context risponde agli agenti che non riescono ad accedere alle definizioni di business e ai documenti aziendali. Control risponde agli agenti che hanno più privilegi che supervisione.
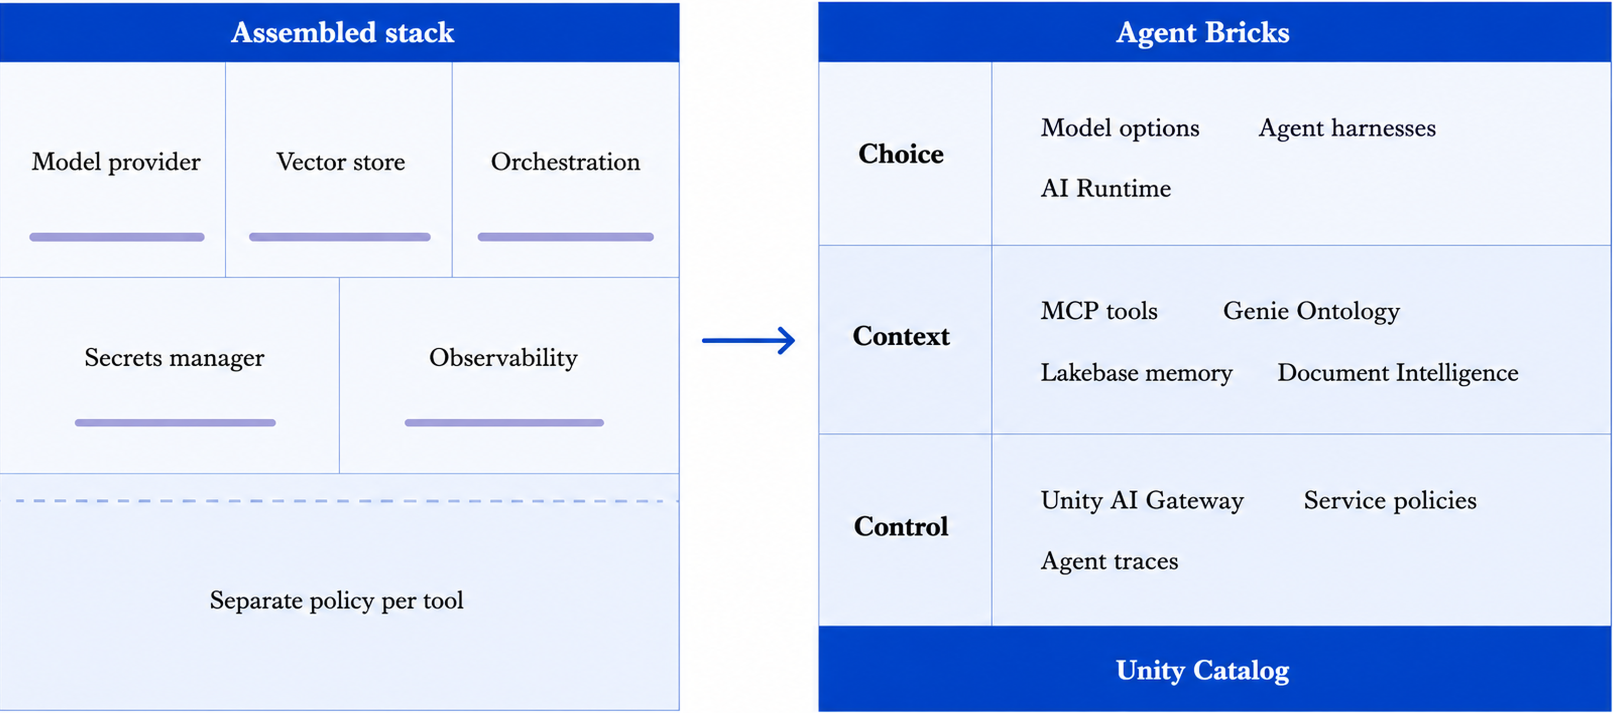
Choice: quali modelli e framework si possono usare
Non si è vincolati a un unico modello né a un unico framework per agenti. Databricks punta sulla "diversità di modelli per trovare il giusto equilibrio tra qualità e latenza".
Un subagente che si limita a instradare le domande allo specialista giusto non ha bisogno del modello che redige la risposta finale. Pagare prezzi da modello frontier per entrambi è una fonte comune di spesa evitabile.
I modelli raggiungibili tramite Agent Bricks includono OpenAI, Anthropic, Gemini, Qwen, Kimi e Grok. Quanto ai framework, Databricks dichiara di supportare "qualsiasi agent harness gli sviluppatori vogliano usare, dai framework open source come LangGraph, Agno e CrewAI a harness come il Claude Code SDK o gli OpenAI Agent SDK".
Se nessuno dei modelli disponibili fa al caso Suo, AI Runtime permette di addestrare Large Language Model (LLM) personalizzati sui propri dati. Databricks cita Merck e First American tra i clienti che lo fanno.
Context: che cosa sa davvero l'agente
Il contesto è tutto ciò che un agente raggiunge oltre i pesi del modello: i tool, le definizioni di business, i documenti e ciò che ricorda dai turni precedenti della conversazione. Databricks descrive gli LLM come "potenti macchine di ragionamento" che "hanno bisogno di recuperare ed elaborare il contesto giusto per prendere decisioni corrette dal punto di vista del business". Un modello che restituisce il numero giusto dalla tabella sbagliata è il caso più difficile da intercettare, perché la risposta sembra corretta.
I tool arrivano all'agente tramite Unity Catalog, che è ciò che decide chi può usare quale tool. I connettori OAuth gestiti implementano il Model Context Protocol (MCP), uno standard aperto per esporre tool e dati ai modelli, e Databricks li usa per "collegare in modo sicuro servizi esterni come GitHub, Atlassian e Glean come tool governati". Si assegnano i permessi a un tool una volta sola e ogni agente che lo invoca li eredita, evitando di cablare le credenziali in ciascun agente separatamente.
Genie Ontology porta le definizioni di business nella vista che l'agente ha dei dati. Document Intelligence analizza, estrae, classifica e governa i documenti tramite funzioni AI native in SQL, trasformando contratti e PDF in qualcosa di interrogabile. E la memoria degli agenti basata su Lakebase fornisce "memoria, cronologia delle conversazioni e stato" per i workflow di lunga durata. Sulla pagina prodotto di Lakebase, questo significa che le sessioni di chat e i messaggi di un agente persistono, così "gli utenti possono riprendere le conversazioni e l'agente può ragionare sui turni precedenti attraverso i deploy".
Il contesto non serve a nulla se il retrieval è lento o scansiona più dati del necessario, e questo riporta al layout dei dati delle tabelle lette dagli agenti.
Databricks riporta che ancorare gli agenti a questo contesto di business produce "un'accuratezza superiore del 70% rispetto alla RAG standard e un miglioramento del 30% nei workflow multi-step", e attribuisce il risultato alla combinazione dei metadati di Unity Catalog e dei Genie Spaces.
Genie Ontology è uno dei quattro prodotti Genie, che fatturano sia l'uso degli LLM sia il compute. Scarichi il nostro ebook gratuito, Databricks Genie Explained, per scoprire cosa fa ciascuno e quanto costa.
Control: che cosa l'agente è autorizzato a fare
Control riguarda ciò che un agente può fare, una questione più ampia di ciò che può vedere. La differenza conta soprattutto quando un agente può scrivere, perché una lettura sbagliata fa trapelare i dati, mentre una scrittura sbagliata li modifica.
Gli agenti sono "tra gli attori più privilegiati in un'azienda, con accesso a dati sensibili", secondo la valutazione della stessa Databricks.
Unity AI Gateway è il layer di enforcement. Gli agenti ereditano l'identità dell'utente richiedente tramite on-behalf-of token passing, così l'identità è applicata end-to-end, senza alcun service account a fare le veci dell'utente. I guardrail filtrano informazioni di identificazione personale, contenuti non sicuri, prompt injection, esfiltrazione di dati e allucinazioni.
Oltre all'accesso, le contextual service policy controllano le azioni. Sono in Beta, quindi è prevedibile che cambino. Si definiscono in SQL come funzioni di Unity Catalog e possono consentire, negare o richiedere approvazione per operazioni come "modificare file, fare push di codice, accedere a sistemi enterprise o interagire con informazioni sensibili". Le policy si applicano in base all'utente, all'agente, al modello, al servizio MCP, al tool invocato o al contenuto di richiesta e risposta. Se desidera che una persona dia l'approvazione prima che un agente faccia push su un repository di produzione, lo definisce come policy e la piattaforma la applica.
Il tracing unificato cattura le interazioni con i modelli e l'attività dei tool MCP in un unico layer di telemetria governato. Le trace finiscono nel Lakehouse per l'analisi e in Lakewatch, il prodotto di security information and event management (SIEM) agentico di Databricks, per le indagini.
Control copre anche la spesa. Unity AI Gateway supporta budget e tetti di spesa rigidi che "bloccano automaticamente le richieste quando i budget vengono superati". Quell'enforcement è reale, ma si ferma a un confine preciso, di cui si occupa la sezione sulla visibilità dei costi più avanti.
Che cosa serve per usare Agent Bricks?
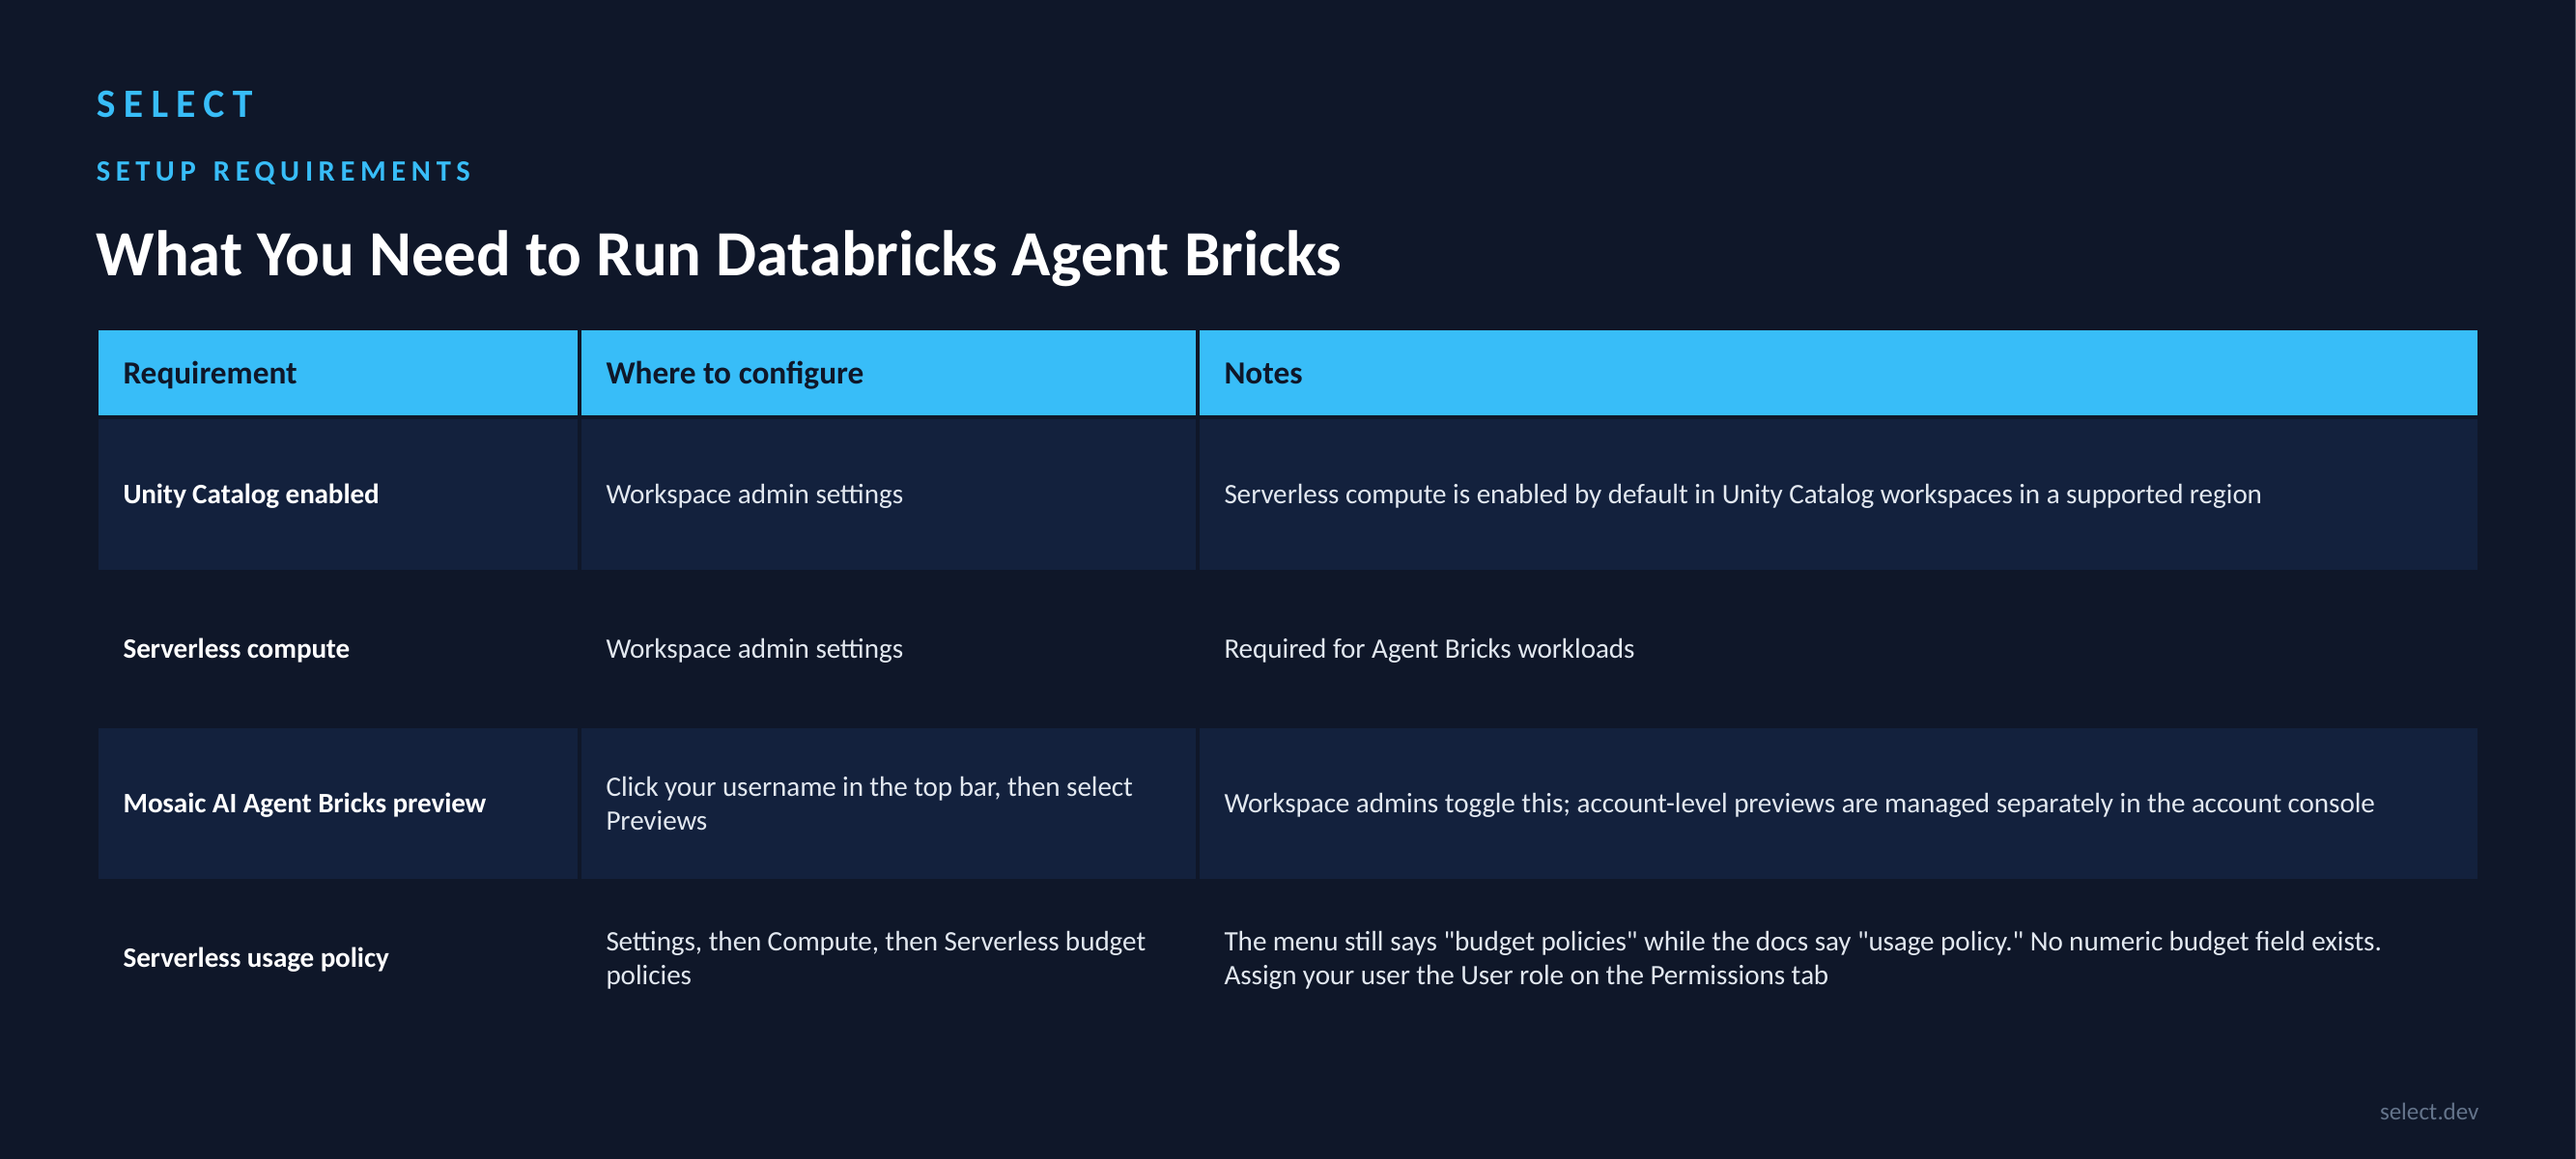
Il Suo workspace deve avere quattro cose.
- Unity Catalog abilitato. Se non ha ancora predisposto quel layer, parta da cos'è Unity Catalog e quanto costa.
- Compute serverless disponibile. Databricks lo abilita di default nei workspace Unity Catalog nelle region supportate.
- L'anteprima Mosaic AI Agent Bricks attivata. Lo fa un amministratore del workspace dal pannello Previews.
- Accesso a una serverless usage policy. La documentazione di Knowledge Assistant la formula come "accesso a una serverless usage policy con budget diverso da zero".
È sul quarto requisito che ci si incaglia. Dice "budget diverso da zero", ma non c'è alcun importo da inserire. Le serverless usage policy sono "tag applicati a qualsiasi attività di compute serverless", e un dipendente Databricks ha confermato in un thread della community che si tratta di "meccanismi di tagging per l'attribuzione dei costi, non di tetti di spesa". Crei la policy in Settings, poi Compute, poi Serverless budget policies, e assegni al Suo utente il ruolo User nella scheda Permissions.
La copertura delle region cambia nel tempo, quindi la verifichi prima di sceglierne una. Ad agosto 2026, Agent Bricks è disponibile direttamente in nove region AWS e dodici region Azure, con altre quattro su AWS e altre tredici su Azure raggiungibili tramite cross-geography routing. Gli elenchi aggiornati si trovano nelle tabelle di disponibilità delle funzionalità per AWS e Azure, alla voce "Agent features availability".
Quali sono i casi d'uso reali di Agent Bricks?
Tre prodotti Agent Bricks coprono le forme più comuni di lavoro in produzione. Knowledge Assistant risponde a domande sui documenti, Document Intelligence ne estrae la struttura e Supervisor Agent ne coordina diversi contemporaneamente.
Knowledge Assistant risponde a domande ancorate ai documenti aziendali. Hawaiian Electric lo ha usato per sostituire un'implementazione open source esistente. Il loro manager of enterprise data and analytics, Joel Wasson, ha riferito che "Agent Bricks ha superato nettamente la nostra implementazione open source originale sia nelle metriche di accuratezza LLM-as-judge sia in quelle di valutazione umana".
Verifichi prima i limiti di ingestion. I file sopra i 100 MB e i documenti PDF o Office oltre le 500 pagine vengono saltati, e un singolo assistente accetta al massimo 10 knowledge source.
Document Intelligence trasforma documenti non strutturati in campi strutturati. In AstraZeneca, Joseph Roemer, Head of Data & AI, Commercial IT, ha riferito che "i nostri team sono riusciti ad analizzare oltre 400.000 documenti di trial clinici ed estrarre data point strutturati, senza scrivere una sola riga di codice". Entrambe le citazioni dei clienti provengono dal comunicato di lancio di Agent Bricks.
Supervisor Agent coordina un sistema multi-agente. Instrada il lavoro tra Genie Agents, endpoint di agenti, funzioni Unity Catalog, server MCP e agenti personalizzati, così un singolo endpoint può coprire domini specializzati. Un supervisor accetta al massimo 50 agenti, gli utenti finali hanno bisogno di accesso esplicito a ciascun subagente con cui interagiscono e la disponibilità della ricerca web dipende dalla region e dalla configurazione di sicurezza.
Che cosa non Le dice Agent Bricks sui costi?
Agent Bricks Le dice quali persone e quali agenti stanno consumando il budget AI. Non Le dice da quale workspace, job, cluster o endpoint di model serving proviene quella spesa, e questo punto cieco si allarga man mano che i workloads degli agenti crescono.
Unity AI Gateway applica budget e tetti di spesa rigidi e traccia il consumo di token per utenti, team, applicazioni e model provider. Se la domanda è "quale team sta bruciando il budget dei modelli", la piattaforma risponde.
Quei budget e quei tetti si applicano ad agenti, tool, modelli e servizi MCP. Non arrivano al costo del compute per job e cluster sottostante. Ogni esecuzione di un agente consuma compute serverless, dove l'infrastruttura è inglobata nella tariffa DBU, e il networking e lo storage generati da quel workload finiscono comunque sulla bolletta cloud.
È per quel secondo layer che abbiamo creato SELECT. Ogni workload Databricks genera un layer parallelo di spesa per infrastruttura cloud di cui Databricks effettua il provisioning dietro le quinte, insieme ai relativi costi di networking e cloud storage. Il provider cloud li fattura direttamente, il reporting nativo di Databricks non li mostra e, senza strumenti dedicati, il vero total cost of ownership resta fuori portata.
Il model serving è il punto in cui questa lacuna pesa di più, ed è esattamente ciò che Agent Bricks genera. Ora che Databricks è diventata una delle piattaforme di riferimento per il training e l'inferenza dei modelli AI, vediamo i costi di model serving crescere rapidamente, con ancora meno visibilità nativa e meno controlli rispetto ai workloads tradizionali.
Qualsiasi framework di ottimizzazione dei costi Databricks deve riconciliare entrambi i layer. SELECT for Databricks si connette tramite un service principal in sola lettura e, riporta DoiT, regola le configurazioni dei cluster per ridurre i costi di tutti i workloads fino al 30%.
I team che usano Databricks e vogliono una visibilità granulare sui costi di AI model serving possono connettere SELECT in circa 20 minuti. Prenoti una demo.
Domande frequenti
Qual è la differenza tra Databricks Agent Bricks e Mosaic AI?
Mosaic AI è il layer di prodotti AI più ampio di Databricks, che copre Model Serving, le API dei foundation model, la vector search e l'infrastruttura sottostante per gli agenti. Agent Bricks è il prodotto per la creazione di agenti che vi poggia sopra e gestisce al posto Suo il loop, il collegamento dei tool, la valutazione e l'ottimizzazione.
Quali sono i quattro tipi di agenti di Agent Bricks?
Databricks ha lanciato Agent Bricks con quattro tipi di agenti. Knowledge Assistant risponde a domande ancorate ai dati aziendali, Information Extraction trasforma i documenti in campi strutturati, Supervisor Agent abilita sistemi multi-agente e Custom LLM Agent trasforma il testo per attività personalizzate. Da allora Information Extraction è confluito in Document Intelligence, la capability che raccoglie parsing, estrazione e classificazione, ed è per questo che l'articolo copre tre forme di lavoro in produzione anziché quattro.
Agent Bricks supporta LangGraph e altri framework?
Sì. Databricks dichiara di supportare "qualsiasi agent harness gli sviluppatori vogliano usare", citando framework open source come LangGraph, Agno e CrewAI, insieme a harness come il Claude Code SDK e gli OpenAI Agent SDK. Anche Omnigent è supportato.
Come gestisce Agent Bricks la memoria degli agenti?
Tramite l'integrazione nativa con Lakebase, che secondo Databricks fornisce "memoria, cronologia delle conversazioni e stato per i workflow di lunga durata". Databricks posiziona Lakebase come storage persistente per le sessioni di chat e i messaggi di un agente, così "gli utenti possono riprendere le conversazioni e l'agente può ragionare sui turni precedenti attraverso i deploy".
Quali sono i requisiti di accesso per Agent Bricks?
Un workspace con Unity Catalog abilitato, compute serverless disponibile, accesso a Model Serving, accesso a una serverless usage policy e la collocazione in una region supportata. Un amministratore del workspace deve inoltre abilitare l'anteprima Mosaic AI Agent Bricks.
Quanti agenti sono stati costruiti su Agent Bricks?
Databricks riporta che dal lancio di giugno 2025 sono stati costruiti oltre 100.000 agenti, che elaborano più di un milione di miliardi di token all'anno.