
TLDR
- DCM Projects sind Snowflakes native, deklarative Methode, Objekte als Code zu verwalten. Sie schreiben
DEFINE <object>stattCREATE <object>(zum BeispielDEFINE DATABASE), und Snowflake ermittelt, was geändert werden muss. - Der Ablauf: Definitionen bearbeiten, planen, dann deployen. Der Plan ist ein rein lesendes Diff. Das Deploy wendet ihn an.
- DCM löscht, was Sie nicht mehr definieren. Eine Zeile gelöscht, eine Datenbank weg. Lesen Sie den Plan.
- Eine
manifest.ymlplus Jinja liefert IhnenDEV,QAundPRODaus einem einzigen Satz von Dateien. - DCM kann Tabellen und Views verwalten, sollte es aber meiner Meinung nach nicht, wenn Sie bereits dbt einsetzen. Lassen Sie DCM die Plattform verantworten (Rollen, Datenbanken, Warehouses, Grants) und dbt das, was in den Datenbanken steckt.
- Das Rollen- und Datenbankdesign stammt aus dem Snowflake-Setup-Guide von dbt Labs, dem Hunderte dbt-Projekte gefolgt sind. Das Repo nimmt ein paar Verbesserungen vor und gießt alles in Code.
- Hier ist das GitHub-Repo, auf dem dieser Artikel basiert – mit CI/CD über GitHub Actions, die
ACCOUNTADMINnie anfasst.
Wie es dazu kam
Wenn Sie schon eine Weile mit Snowflake arbeiten, haben Sie Ihre Account-Infrastruktur vermutlich auf eine von drei Arten verwaltet:
- Click-Ops. Jemand mit
ACCOUNTADMINerstellt an einem Dienstag ein Objekt in Snowsight. Niemand weiß mehr, warum. Drei Jahre später traut sich keiner, es zu löschen. - Migrationsskripte:
V1__create_roles.sql,V2__grant_things.sql,V47__fix_the_grant_from_V2.sql. Tools wie schemachange führen sie der Reihe nach aus. Das funktioniert, aber der "aktuelle Zustand" Ihres Accounts ist die Summe aus 47 Dateien – viel Spaß beim Lesen. - Terraform. Deklarativ und mächtig. Bringt aber HCL mit, einen Provider, den man aktuell halten muss, und eine State-Datei, die gespeichert, gesperrt und gelegentlich operiert werden will. Für viele Datenteams ist das eine ganz neue Disziplin, nur um ein Warehouse anzulegen.
DCM Projects sind Snowflakes Antwort darauf. Sie bekommen das deklarative Modell von Terraform, aber die Sprache ist SQL, und der State lebt in Snowflake.
Die Blaupause: die Grant-Statements, die alle kopiert haben
Bevor wir zu DCM kommen: Ehre, wem Ehre gebührt. Wenn Sie Snowflake für dbt eingerichtet haben, haben Sie vermutlich Claire Carrolls Beitrag Setting up Snowflake — the exact grant statements we run im dbt Discourse gelesen. Hunderte dbt-Projekte wurden nach dieser Vorlage aufgesetzt. Ich selbst habe sie öfter befolgt, als ich zählen kann.
Das Design ist simpel, und genau deshalb funktioniert es:
- Eine
raw-Datenbank für eingehende Daten und eineanalytics-Datenbank für modellierte Daten. - Eine
loader-Rolle, die inrawschreibt, einetransformer-Rolle, dierawliest undanalyticsaufbaut, und einereporter-Rolle, dieanalyticsliest – und sonst nichts. - Future Grants, damit neue Schemas und Tabellen lesbar sind, ohne dass jemand einen Finger rühren muss.
Das Problem war nie das Design. Das Problem ist, dass es eine Liste von Statements ist, die man einmal in ein Worksheet kopiert. Sechs Monate später kann niemand sagen, ob der Account noch dazu passt, und die Erweiterung für die "Dev-Umgebung" am Ende des Beitrags bleibt eine Übungsaufgabe für die Leser.
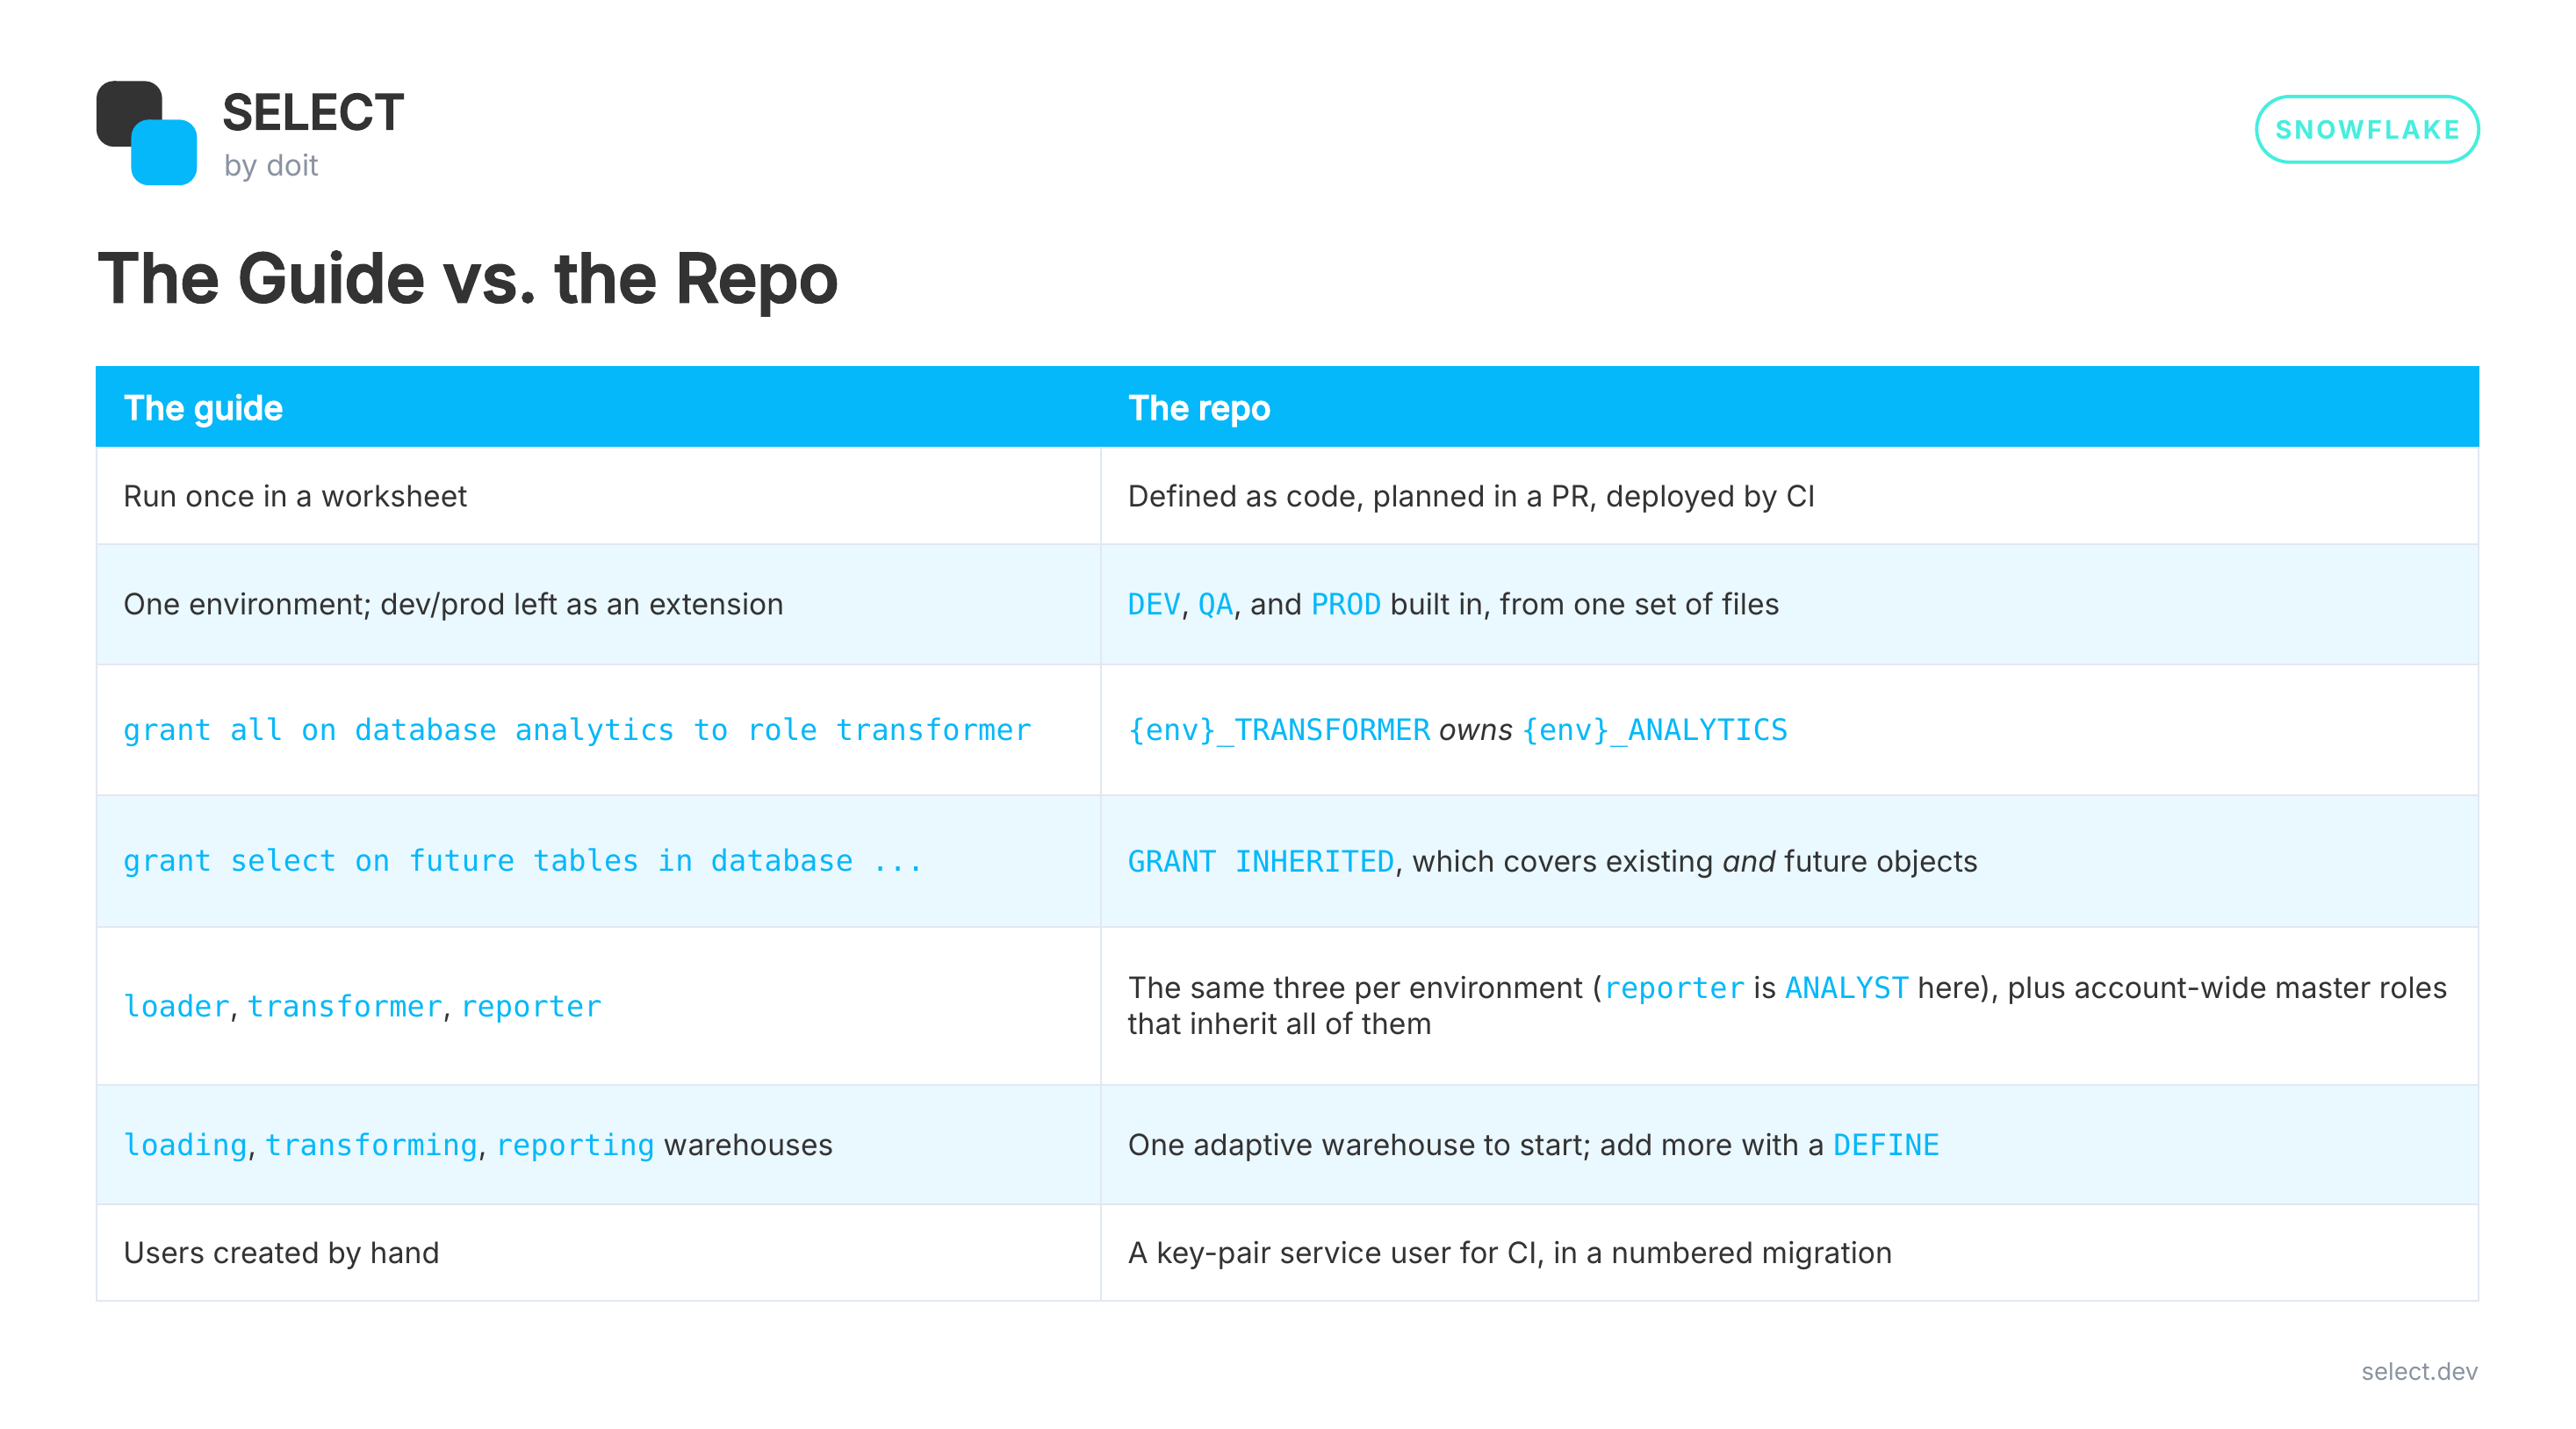
Das Starter-Repo behält Claires Grundgerüst bei und ändert ein paar Dinge:
Warum Inherited Grants die Future Grants ablösen
Die Zeile zu den Grants ist die wichtigste Änderung, also schauen wir genauer hin.
Future Grants waren lange das richtige Werkzeug! Sie sind der Grund, warum Claires Setup so wartungsarm ist. Aber sie haben drei Probleme, und wer Snowflake ein paar Jahre betreibt, ist über mindestens eines davon gestolpert:
- Sie gelten nur für die Zukunft. Ein Future Grant bewirkt nichts für bereits existierende Tabellen, weshalb jedes Setup ihn mit einem
grant select on all tables-Statement kombiniert. Das sind zwei Statements pro Privileg – und zwei Dinge, an die man denken muss. - Future Grants auf Schema-Ebene überschreiben die auf Datenbank-Ebene. Fügt jemand einen Future Grant auf einem Schema hinzu, ignoriert Snowflake für dieses Schema die Future Grants auf Datenbank-Ebene. Ihre
reporter-Rolle bekommt dort still und leise keine neuen Tabellen mehr – und es gibt keinerlei Fehlermeldung. - Sie sind eine einmalige Kopie, keine Regel. Ein Future Grant wird auf jedes Objekt bei dessen Erstellung angewendet. Wird der Future Grant später widerrufen oder geändert, behält jedes bereits betroffene Objekt das alte Privileg. Der sichtbare Grant beschreibt nicht mehr den Zugriff, den die Leute tatsächlich haben.
Ein Inherited Grant ist ein einziges Statement auf einem Container (Account, Datenbank oder Schema) und gilt für jedes passende Objekt darin – existierend und zukünftig:
GRANT INHERITED SELECT ON ALL TABLES IN DATABASE {{ env }}_ANALYTICS TO ROLE {{ env }}_ANALYST;Das ersetzt den Future Grant, den on all-Grant und die Pro-Schema-Variante von beidem – komplett. Wenn Sie wissen wollen, warum jemand eine Tabelle lesen kann, zeigen die Spalten IS_INHERITED und INHERITED_FROM in SHOW GRANTS auf den verantwortlichen Grant.
Außerdem passt das Konzept perfekt zu DCM. Ein deklaratives Tool will eine Zeile, die die Regel beschreibt. "Analysten dürfen alles in ANALYTICS lesen" ist jetzt eine Zeile, nicht sechs.
Ein paar Trade-offs, die Sie kennen sollten:
- Keine Ausnahmen. Sie können das Privileg nicht für eine einzelne Tabelle widerrufen. Snowflakes Dokumentation warnt, dass der Revoke scheinbar erfolgreich ist, während die Rolle den Zugriff über den Inherited Grant behält. Braucht eine Tabelle andere Zugriffsrechte, gehört sie in ein anderes Schema oder eine andere Datenbank.
- Wird ein Objekt in einen Container verschoben oder geklont, ändert sich, wer es sehen kann – ganz ohne ein
GRANT-Statement. Das ist der Sinn der Sache, aber gehen Sie mit Klonen bewusst um. OWNERSHIPkann nicht vererbt werden. Ownership bleibt ein gewöhnlicher Grant.- Es braucht ein Account-Flag,
FEATURE_RBAC_INHERITED_GRANTS, das nurACCOUNTADMINsetzen kann. Mehr dazu unten beim Bootstrap.
Was ist ein DCM Project in Snowflake?
Zwei Dinge:
- Ein Ordner mit Dateien. Eine
manifest.ymlund einige.sql-Dateien vollerDEFINE-Statements. - Ein DCM-Project-Objekt in Snowflake. Es lebt wie jedes andere Objekt in einem Schema und hält die Deployment-Historie fest.
Hier das Layout aus meinem Starter-Repo:
platform/ dcm/ manifest.yml sources/definitions/ roles.sql databases.sql warehouses.sql grants.sql migrations/ 000_bootstrap.sql 001_ci_deployer.sqlEine Datei pro Objekttyp ist meine Konvention, keine DCM-Regel. Snowflake liest alles unter sources/ – organisieren Sie es also so, wie es für Sie am besten funktioniert.
DEFINE statt CREATE
Das ist der eigentliche Perspektivwechsel. Mit einem Migrationsskript schreiben Sie Anweisungen:
CREATE ROLE IF NOT EXISTS DEV_LOADER;ALTER ROLE DEV_LOADER SET COMMENT = 'Owns DEV_RAW';Mit DCM schreiben Sie den Zielzustand:
DEFINE ROLE DEV_LOADER COMMENT = 'Owns DEV_RAW. Used by ingestion tools.';Existiert die Rolle nicht, erstellt DCM sie. Existiert sie mit einem anderen Kommentar, ändert DCM sie. Passt sie bereits, tut DCM nichts. Sie schreiben nie wieder IF NOT EXISTS, und Sie schreiben nie wieder ein ALTER, um etwas zu reparieren, das Sie letzte Woche geschrieben haben.
Grants funktionieren genauso. Sie schreiben kein DEFINE für einen Grant, Sie deklarieren ihn einfach:
DEFINE DATABASE DEV_RAW  COMMENT = 'Landing zone. Schemas and tables are created by ingestion tools.';
GRANT OWNERSHIP ON DATABASE DEV_RAW TO ROLE DEV_LOADER;
Erst Plan, dann Deploy
Jede Änderung durchläuft zwei Schritte. Mit der Snowflake CLI:
snow dcm plan --from platform/dcm --target DEV \ --connection my_account --role PLATFORM_DEPLOYERDer Plan vergleicht Ihre Dateien mit dem Zustand im Account und sagt Ihnen genau, was er erstellen, ändern und löschen würde. Er ändert nichts.
[Screenshot: Plan-Ausgabe beim Hinzufügen einer Datenbank]
Zufrieden? Dann deployen:
snow dcm deploy --from platform/dcm --target DEV --alias add_marketing_db \ --connection my_account --role PLATFORM_DEPLOYERDer --alias ist optional, aber bitte nutzen Sie ihn. Ohne Alias ist Ihre Deployment-Historie eine Liste automatisch generierter Namen, die niemand lesen kann. Mit Alias liest sich snow dcm list-deployments wie ein Changelog: add_marketing_db, analyst_read_on_analytics, drop_legacy_loader.
All das geht auch in SQL (EXECUTE DCM PROJECT ... PLAN), und Snowsight Workspaces bietet eine UI dafür. Ich lebe im Terminal, deshalb sehen Sie hier die CLI.
DCM löscht, was Sie nicht mehr definieren
Das ist der Teil, der Ihnen auf die Füße fallen kann.
Entfernen Sie ein DEFINE, das zuvor deployt wurde, löscht das nächste Deploy dieses Objekt.
Für ein deklaratives Tool ist das korrektes Verhalten. Die Dateien sind der Account. Aber zwei Gewohnheiten sind damit Pflicht:
- Planen Sie immer, bevor Sie deployen. Ein unerwartetes
DROPim Plan bedeutet, dass eine Definition verloren gegangen ist – nicht, dass DCM besonders hilfsbereit sein will. - Lesen Sie den Plan in Ihrem PR. Wie ich das automatisiere, erkläre ich weiter unten.
Und noch etwas: Snowflakes Dokumentation sagt offen, dass ein fehlgeschlagenes Deploy eine teilweise Ausführung hinterlassen kann. Es ist keine einzige große Transaktion. Korrigieren Sie die Definition und führen Sie Plan → Deploy erneut aus, statt von Hand nachzubessern.
DEV, QA und PROD aus einem Satz von Dateien
Niemand will drei Kopien von roles.sql. Die manifest.yml definiert Targets, und jedes Target zeigt auf ein eigenes Project-Objekt und übergibt eigene Templating-Variablen:
manifest_version: 2type: DCM_PROJECTdefault_target: DEV
targets:  DEV:    account_identifier: ABCDEFG-XY12345    project_name: PLATFORM.DCM.DEV_PLATFORM_DCM    project_owner: PLATFORM_DEPLOYER    templating_config: DEV  # QA and PROD look the same
templating:  configurations:    DEV:
Code aufklappen
Jede Definition verwendet dann {{ env }} als Präfix:
DEFINE DATABASE {{ env }}_RAW  COMMENT = 'Landing zone. Schemas and tables are created by ingestion tools.';
DEFINE DATABASE {{ env }}_ANALYTICS  COMMENT = 'Modelled data. Schemas and tables are created by transformation tools.';
GRANT OWNERSHIP ON DATABASE {{ env }}_RAW TO ROLE {{ env }}_LOADER;GRANT OWNERSHIP ON DATABASE {{ env }}_ANALYTICS TO ROLE {{ env }}_TRANSFORMER;
Deployen Sie mit --target DEV, erhalten Sie DEV_RAW. Deployen Sie mit --target PROD, erhalten Sie PROD_RAW. Dieselben Dateien.
Der knifflige Teil: accountweite Objekte
Manche Objekte gehören zu keiner Umgebung. In meinem Template teilen sich alle drei Umgebungen einen Account, ein Warehouse und eine Reihe von "Master"-Rollen wie LOADER, die DEV_LOADER, QA_LOADER und PROD_LOADER erben.
Würde ich COMPUTE_XS ohne Bedingung definieren, würden alle drei Targets es beanspruchen, und die Deploys der einzelnen Targets würden sich darum streiten. Accountweite Objekte werden daher in genau einem Target definiert – mit einem Jinja-if und einer Schleife:
{% if env == 'PROD' %}{% set envs = ['DEV', 'QA', 'PROD'] %}
DEFINE WAREHOUSE COMPUTE_XS  WAREHOUSE_TYPE = 'ADAPTIVE'  MAX_QUERY_PERFORMANCE_LEVEL = XSMALL  QUERY_THROUGHPUT_MULTIPLIER = 2  COMMENT = 'Sole compute warehouse for loads and transforms.';
{% for e in envs %}GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_LOADER;GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_TRANSFORMER;GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_ANALYST;{% endfor %}{% endif %}
Der Haken: Dieser PROD-Block vergibt Grants an DEV_LOADER und QA_LOADER, also müssen DEV und QA vor PROD deployt werden. Die Deploy-Reihenfolge wird Teil Ihres Prozesses – und Ihrer CI.
Steckt jede Umgebung in einem eigenen Account, entfällt das Problem – dann braucht aber jeder Account eine eigene Kopie der accountweiten Objekte. Wählen Sie Ihren Trade-off.
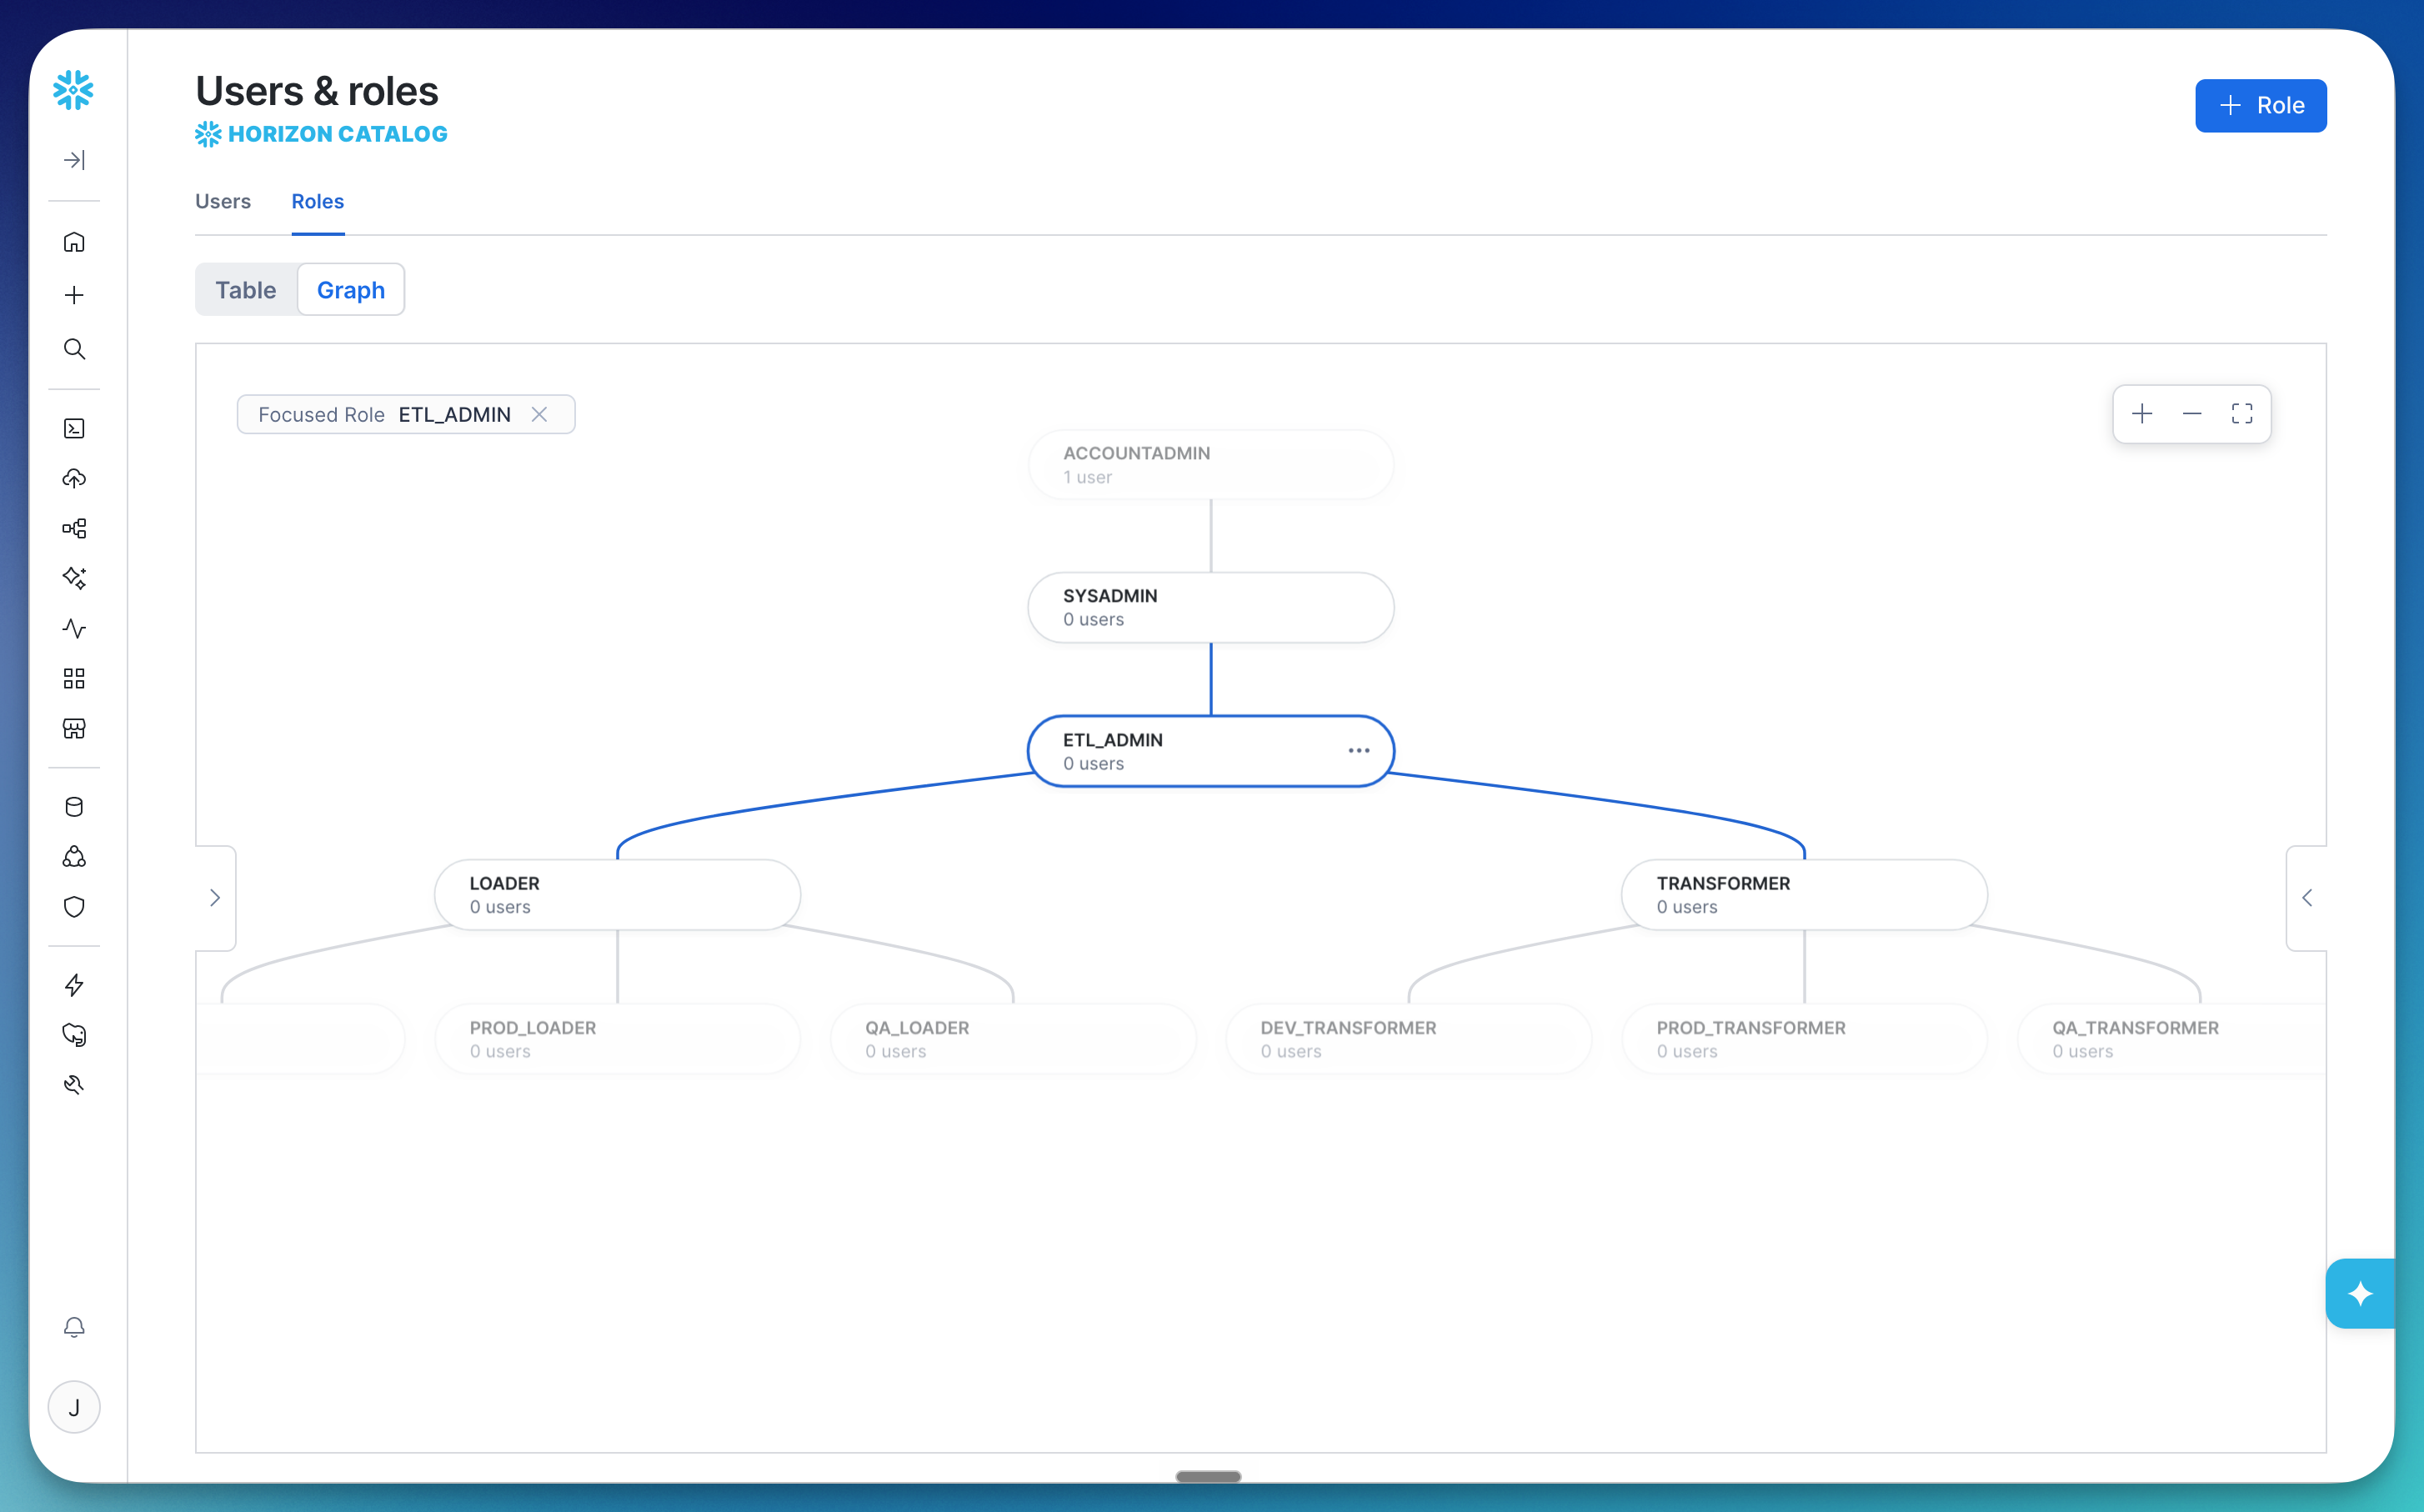
So sieht das Rollenmodell aus, das am Ende aus dem Template entsteht:
Zusätzlich erhält die Deployer-Rolle die umgebungsspezifischen Rollen direkt:
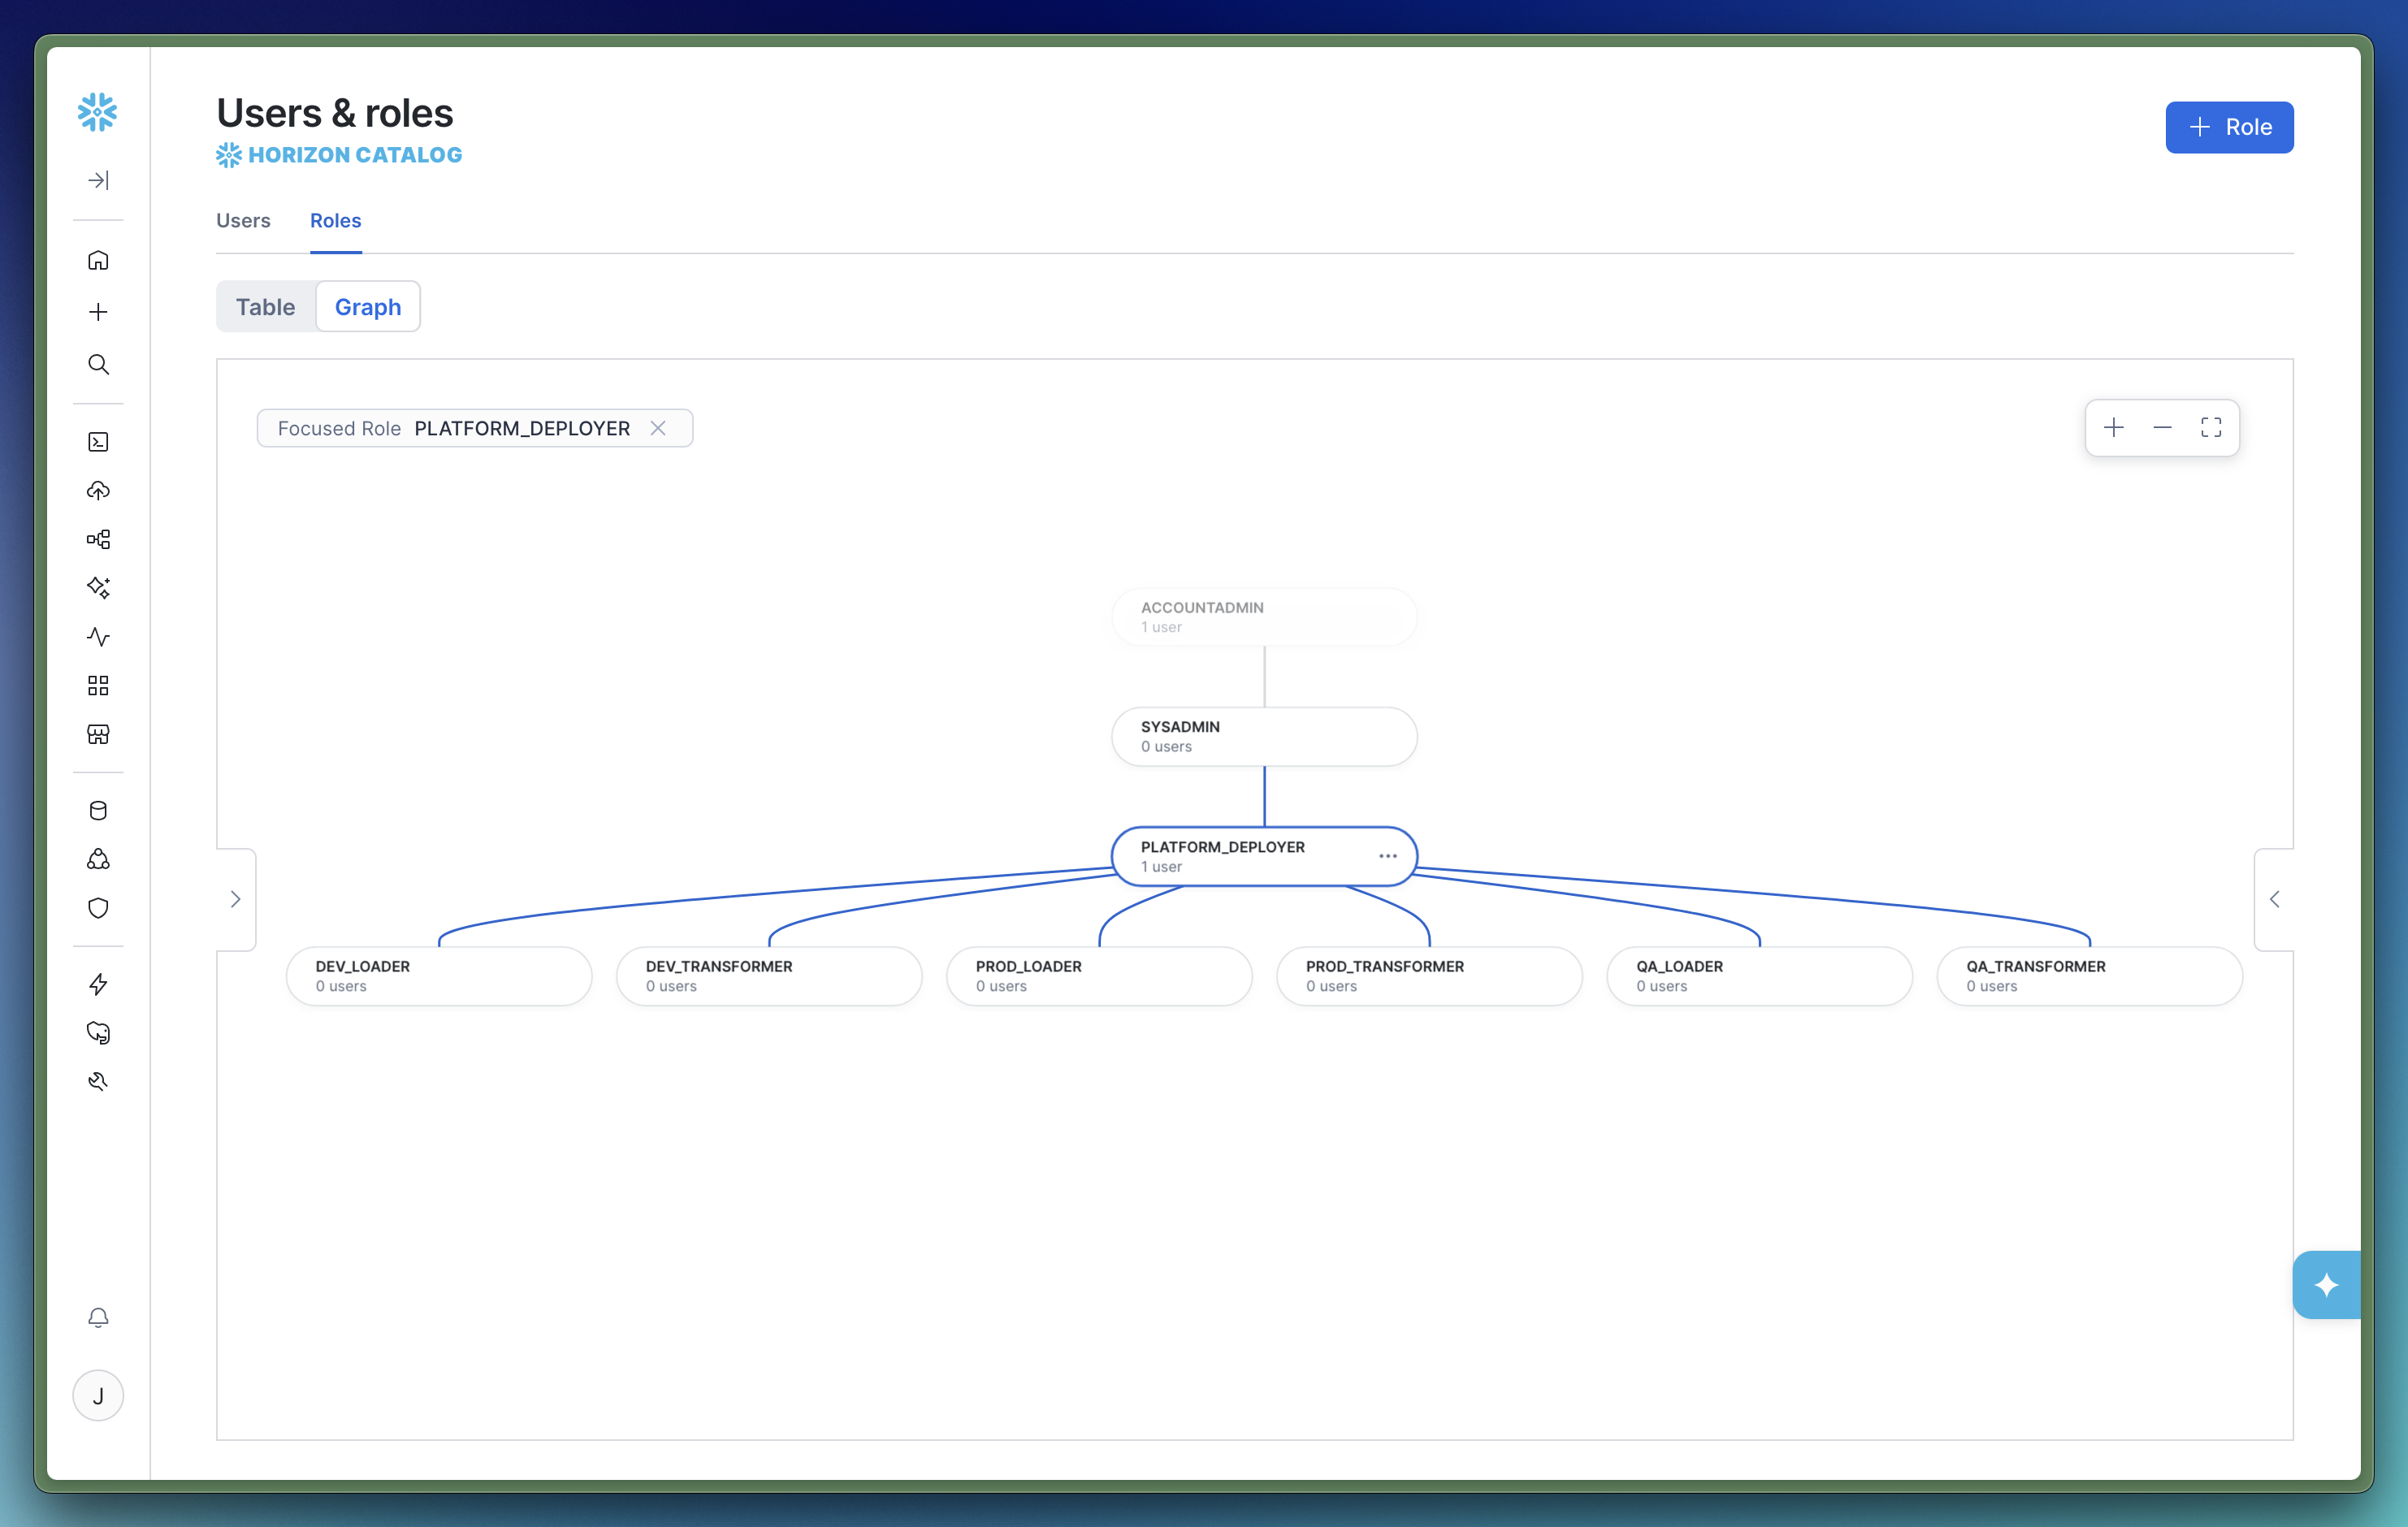
Ihr Ingestion-Tool verbindet sich als {env}_LOADER. dbt verbindet sich als {env}_TRANSFORMER. Analysten bekommen {env}_ANALYST – diese Rolle kann ANALYTICS lesen und sieht RAW überhaupt nicht.
Wenn Sie dbt nutzen, überlassen Sie ihm Tabellen und Schemas in der Analytics-DB
DCM unterstützt eine lange Liste von Objekttypen: Datenbanken, Schemas, Tabellen, Views, Dynamic Tables, Tasks, Stages, Funktionen, Prozeduren, Masking Policies, Tags und mehr.
Warum nutzt mein Template es dann nur für Rollen, Datenbanken, Warehouses und Grants?
Weil dbt Ihre Tabellen und Views bereits verwaltet, wenn Sie dbt einsetzen – samt Lineage, Tests und Dokumentation. Stecken Sie dieselbe Tabelle zusätzlich in eine DCM-Definition, haben Sie plötzlich zwei Tools, die beide glauben, die Tabelle gehöre ihnen. Eines davon wird irgendwann löschen, was das andere gebaut hat.
Deshalb ziehe ich eine klare Grenze:
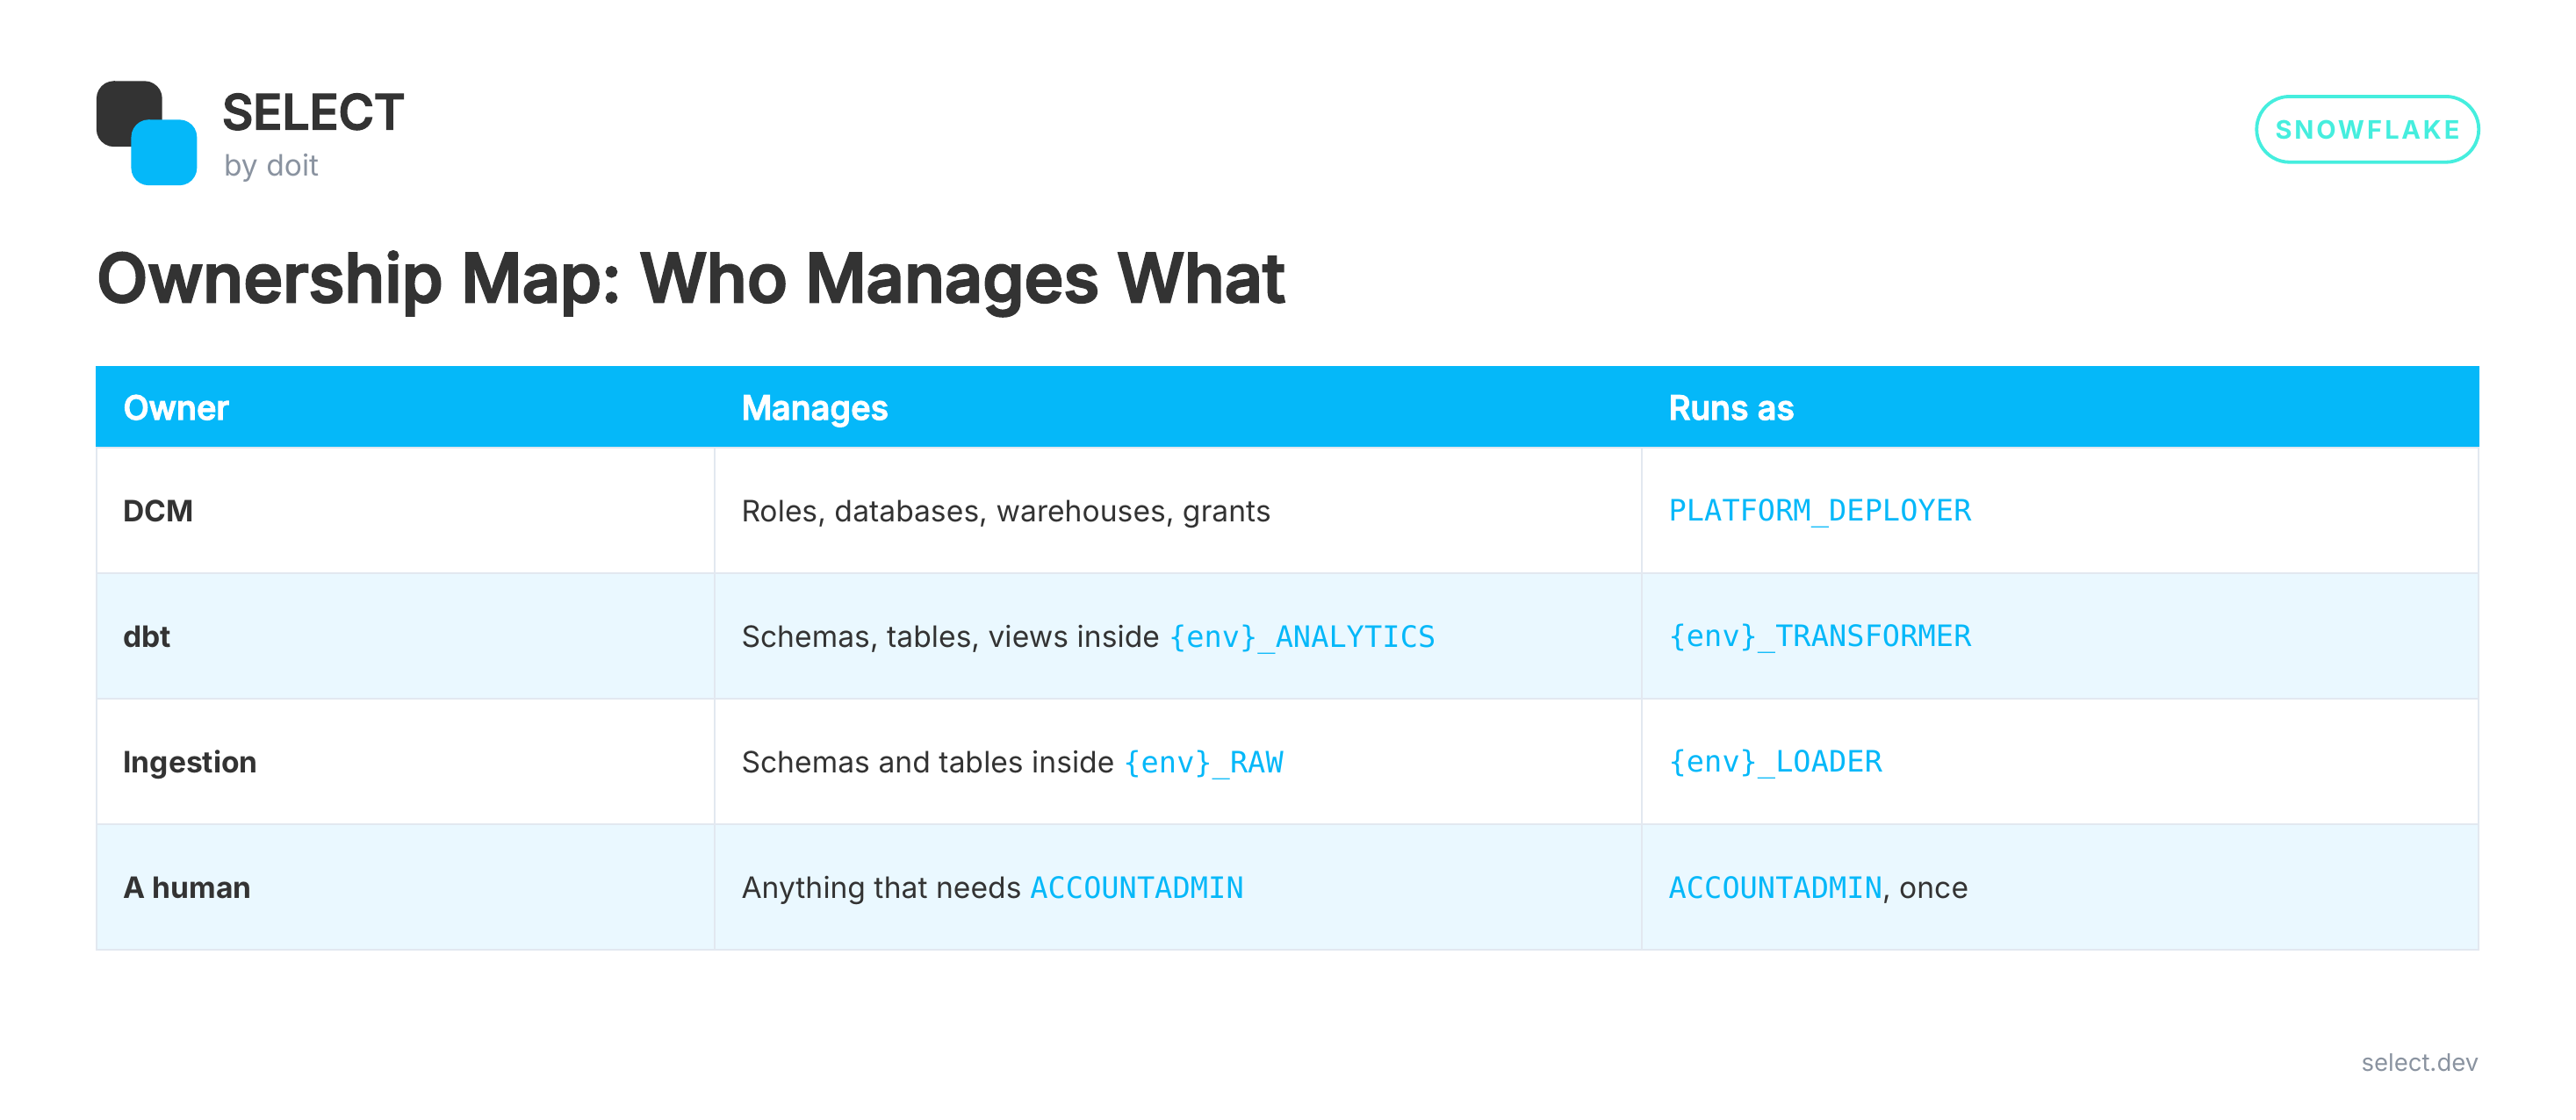
Kein Objekt hat zwei Eigentümer. Wenn Sie kein dbt einsetzen oder Objekte haben, die kein Transformationstool verwaltet (Stages, File Formats, Network Rules), ist DCM dafür bestens geeignet. Die Regel lautet "ein Eigentümer pro Objekt", nicht "DCM macht nur Rollen".
Das Henne-Ei-Problem: Bootstrapping
DCM braucht eine Rolle, mit der es deployt, und ein Project-Objekt, in das es deployt. Irgendetwas muss beides anlegen, und dieses Irgendetwas braucht ACCOUNTADMIN.
Meine Regel für das gesamte Repo:
CI/CD darf niemals
ACCOUNTADMINbenötigen.
Alles, was ACCOUNTADMIN doch braucht, kommt in eine nummerierte SQL-Datei, die ein Mensch genau einmal ausführt:
USE ROLE ACCOUNTADMIN;
ALTER ACCOUNT SET FEATURE_RBAC_INHERITED_GRANTS = 'ENABLED';
CREATE ROLE IF NOT EXISTS PLATFORM_DEPLOYER  COMMENT = 'CI/CD deployment role for DCM.';
GRANT CREATE ROLE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT CREATE DATABASE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT CREATE WAREHOUSE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT MANAGE GRANTS ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT ROLE PLATFORM_DEPLOYER TO ROLE SYSADMIN;
CREATE DATABASE IF NOT EXISTS PLATFORM;CREATE SCHEMA IF NOT EXISTS PLATFORM.DCM;
Code aufklappen
(Leicht gekürzt. Die vollständige Datei liegt im Repo.)
Danach erledigt PLATFORM_DEPLOYER alles. Und hier eine Gewohnheit, die ich sehr schätze: Übergeben Sie --role PLATFORM_DEPLOYER auch lokal. Wenn eine Änderung heimlich mehr Privilegien braucht, scheitert sie auf Ihrem Laptop – und nicht in der CI an einem Freitagnachmittag.
Stolperfallen, in die ich getappt bin – damit Ihnen das erspart bleibt
Inherited Grants in DCM sind als Preview gekennzeichnet. Snowflakes Liste der unterstützten DCM-Objekte markiert Inherited Grants und MANAGE GRANTS auf Container-Ebene als Preview-Features. Bei mir haben sie zuverlässig funktioniert, aber prüfen Sie die Dokumentation, bevor Sie Produktionszugriffe darauf verwetten.
Sperren Sie den Deployer nicht aus. Wenn DCM die Ownership von DEV_RAW an DEV_LOADER übergibt, gehört sie PLATFORM_DEPLOYER nicht mehr. Beim nächsten Deploy kann DCM nicht verwalten, worauf es keinen Zugriff hat. Die Lösung ist eine Zeile pro Rolle:
GRANT ROLE {{ env }}_LOADER TO ROLE PLATFORM_DEPLOYER;GRANT ROLE {{ env }}_TRANSFORMER TO ROLE PLATFORM_DEPLOYER;account_identifier im Manifest expandiert keine Umgebungsvariablen. Schreiben Sie den Identifier direkt hinein. Genau das erlaubt DCM, Sie zu warnen, wenn Sie gerade in den falschen Account deployen wollen – und wer als Consultant mit mehreren Kunden-Accounts jongliert, will genau dieses Feature.
Templaten Sie keine Secrets. Snowflake sagt es klipp und klar: Templating-Variablen sind nicht für Zugangsdaten gedacht.
CI/CD mit GitHub Actions
Hier kommt alles zusammen. Zwei Workflows:
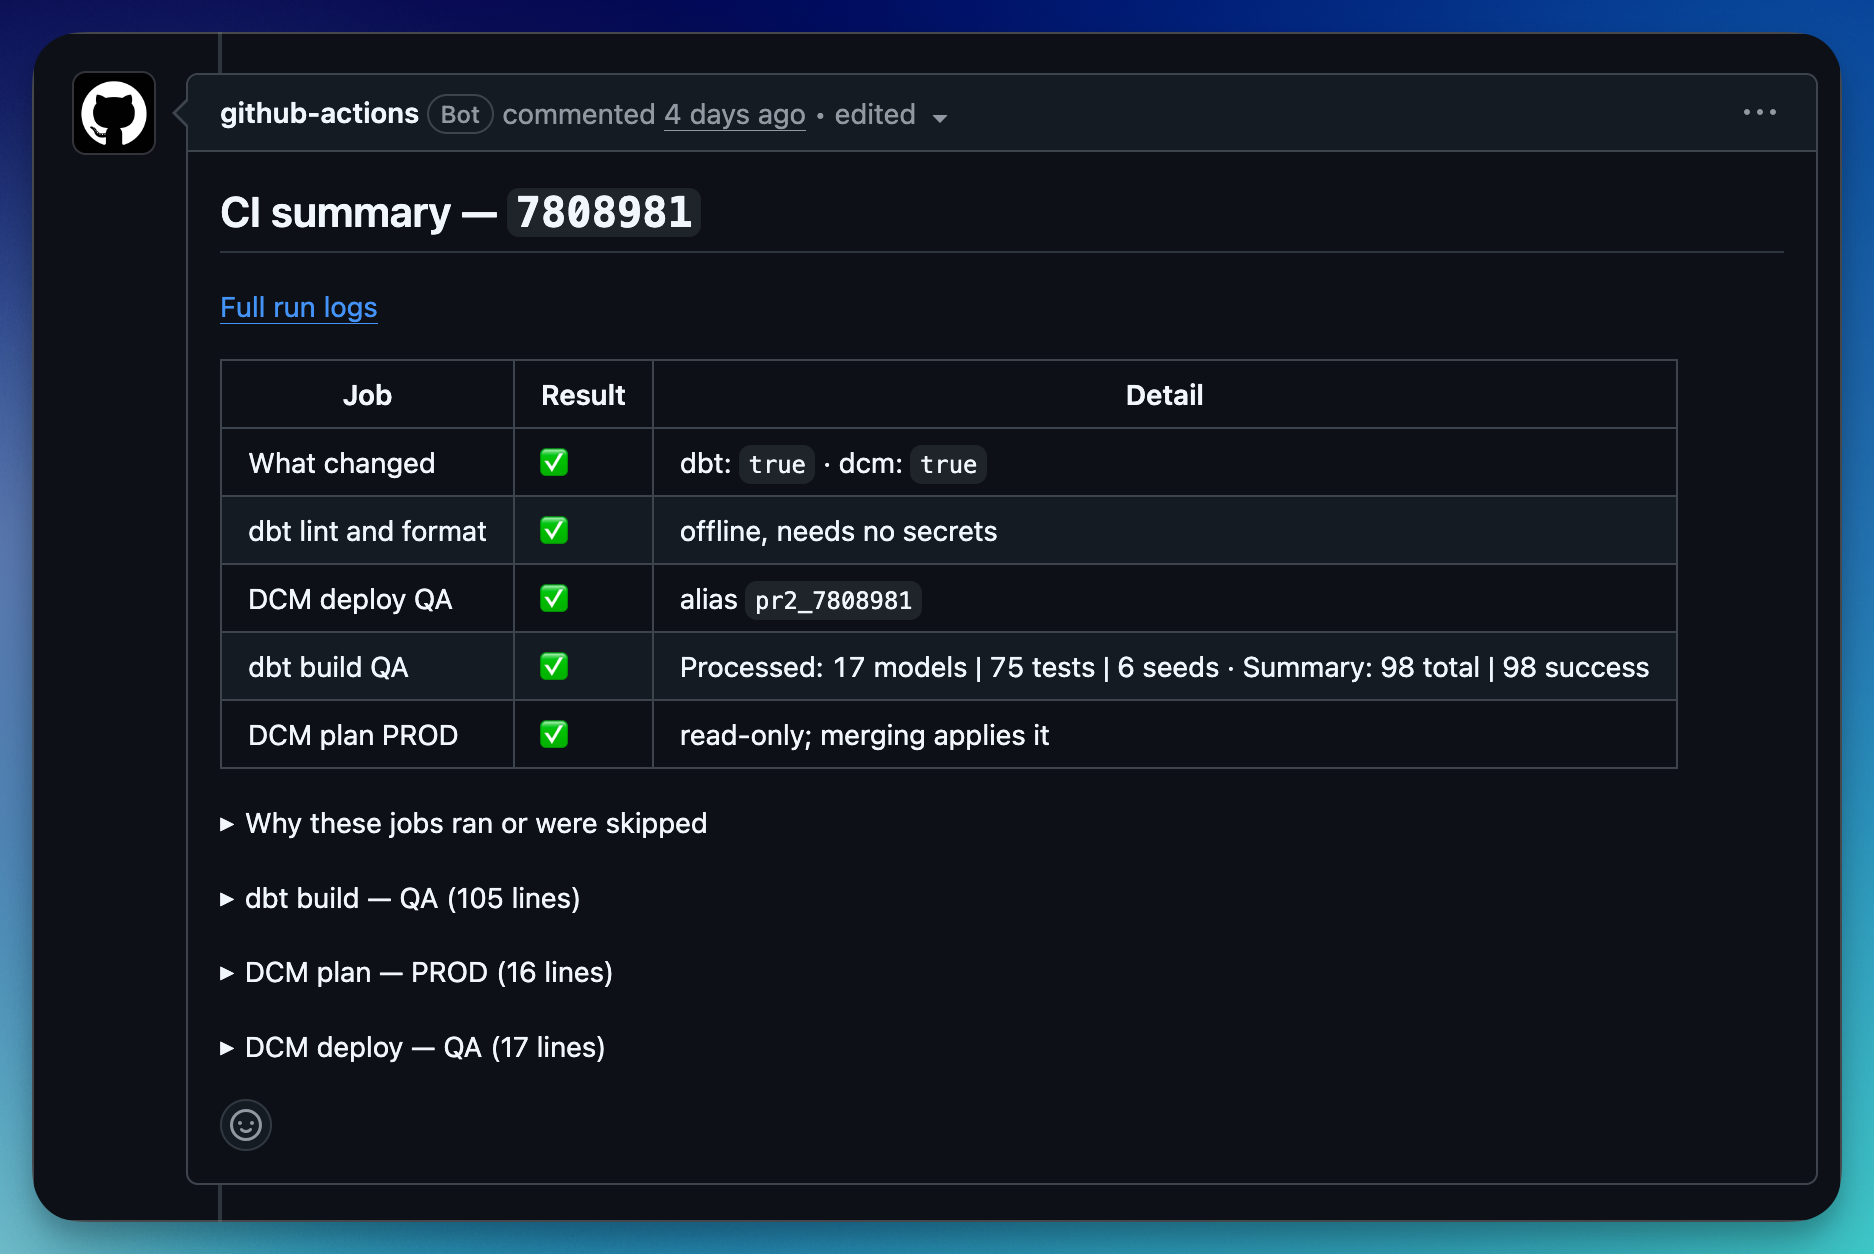
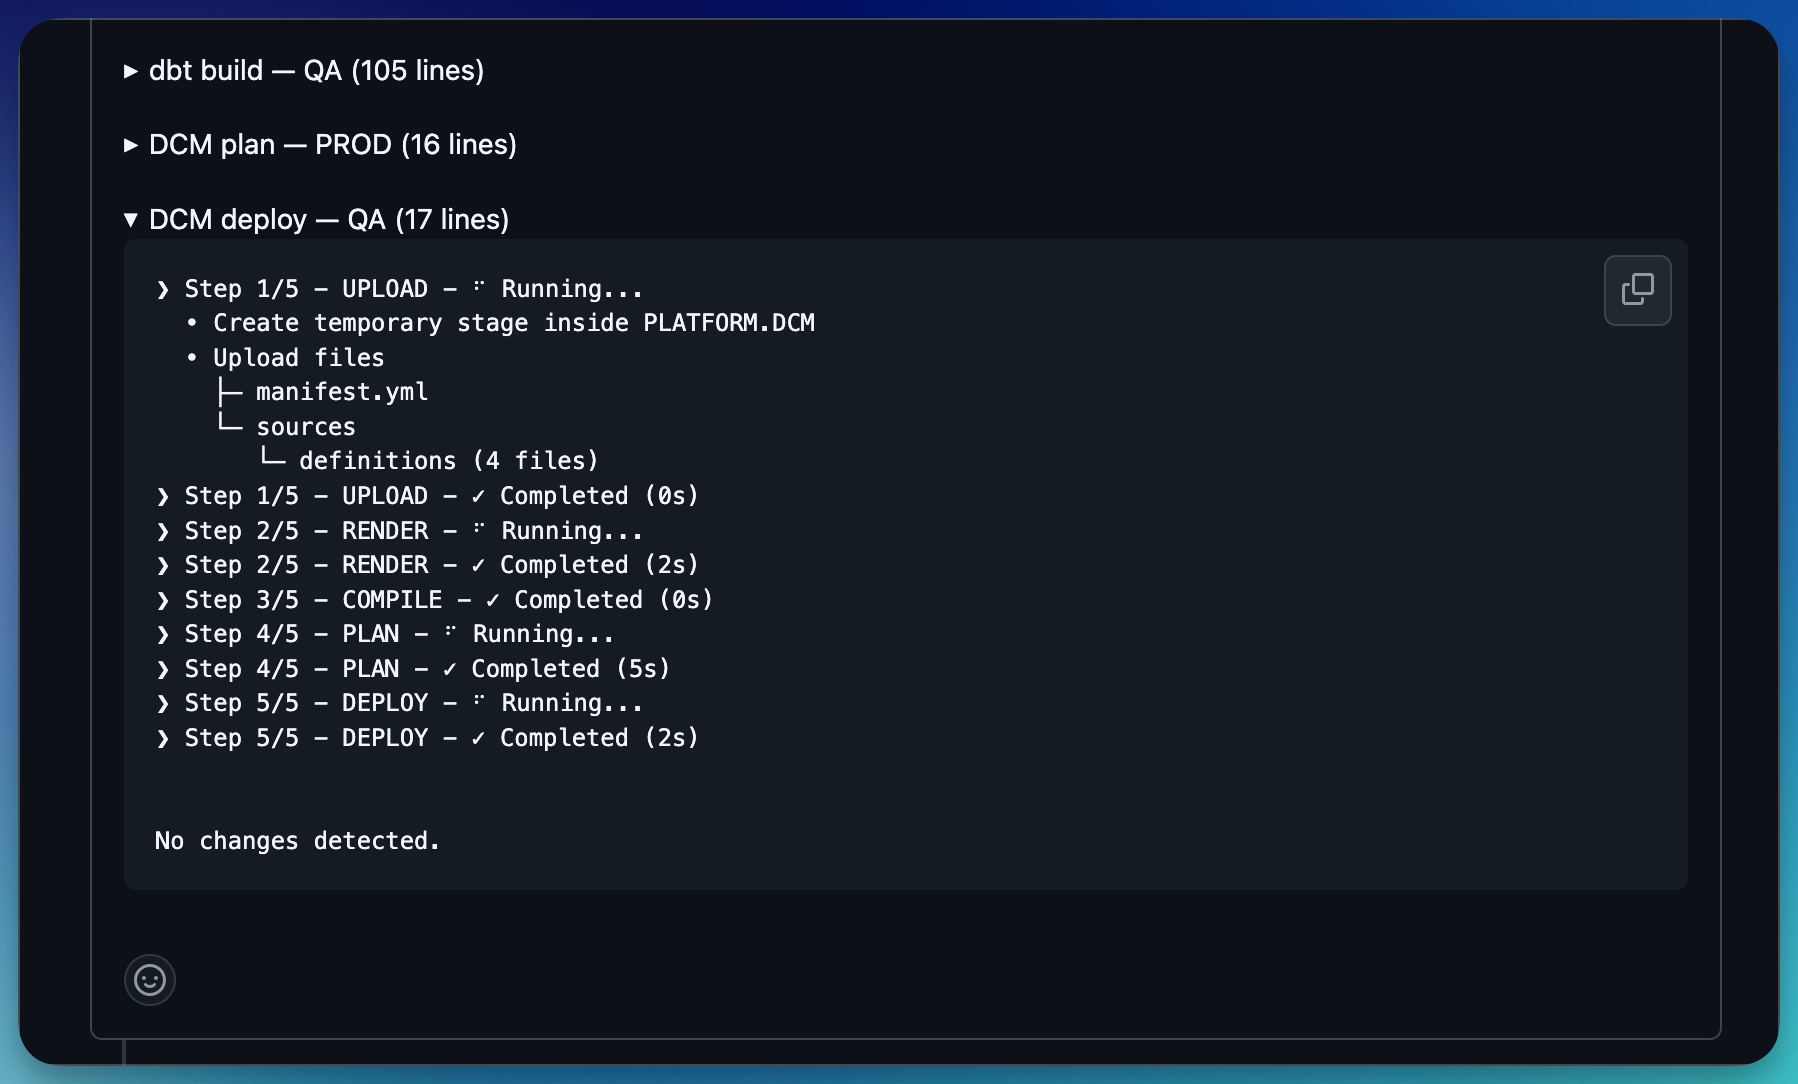
Bei einem Pull Request:
- Plan und Deploy nach
QA. - Plan für
PRODerstellen und als PR-Kommentar posten.
Beim Merge in main:
- Plan und Deploy für
DEV, dannQA, dannPROD– in genau dieser Reihenfolge.
Der PR-Kommentar ist für mich das Highlight. Reviewer müssen nicht darauf vertrauen, dass eine Änderung sicher ist. Sie sehen genau, was mit der Produktion passieren wird – inklusive jedes DROP –, bevor sie auf Merge klicken. Und der Job bearbeitet seinen vorherigen Kommentar, statt einen neuen hinzuzufügen, sodass ein PR mit zehn Pushes trotzdem nur einen Plan-Kommentar hat.
[Screenshot: PROD-Plan als PR-Kommentar]
Die CI authentifiziert sich als User vom Typ TYPE = SERVICE mit Key-Pair-Authentifizierung. Dieser User hat die Rolle PLATFORM_DEPLOYER – und sonst nichts. Jedes Deploy bekommt den Commit als Alias (main_9fd3c1a), sodass sich jedes Deployment in Snowflake direkt auf einen Merge zurückverfolgen lässt.
DCM Projects in Snowsight
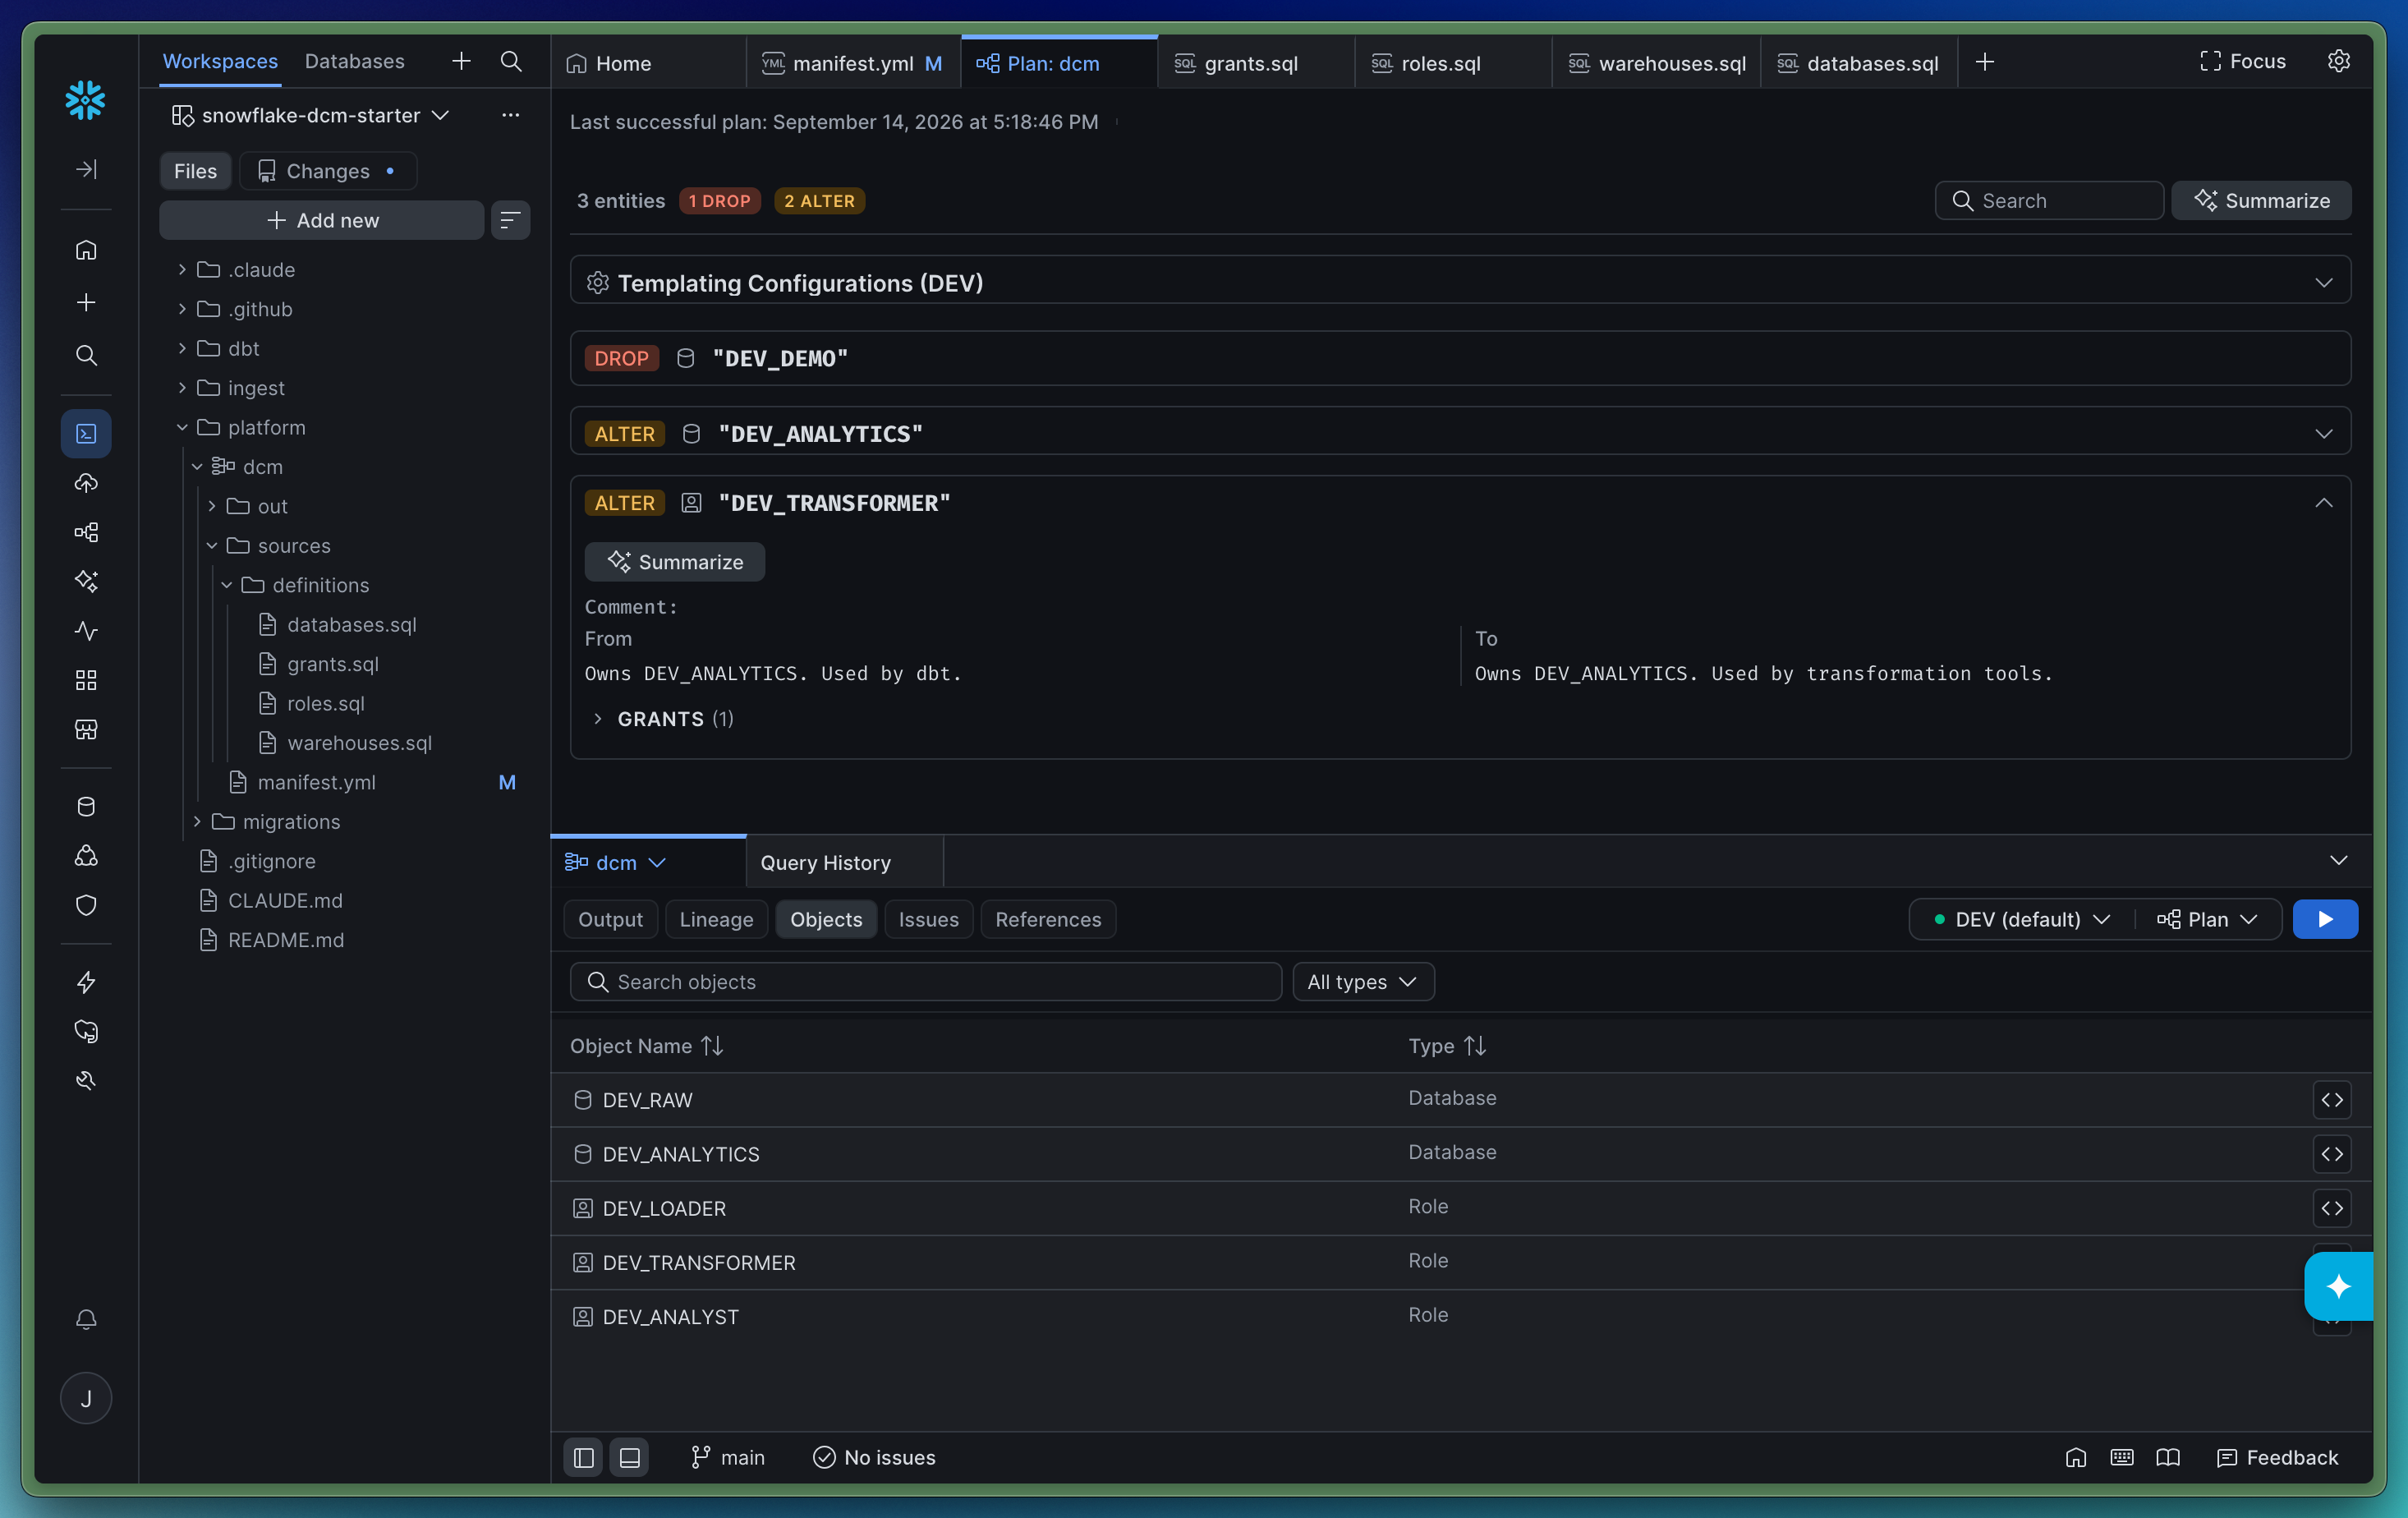
Snowflake Workspaces bietet eine wirklich gelungene UI, um DCM Projects zu verwalten, zu planen und zu deployen. Ohne zu tief einzusteigen, schauen wir uns einfach ein paar Screenshots an.
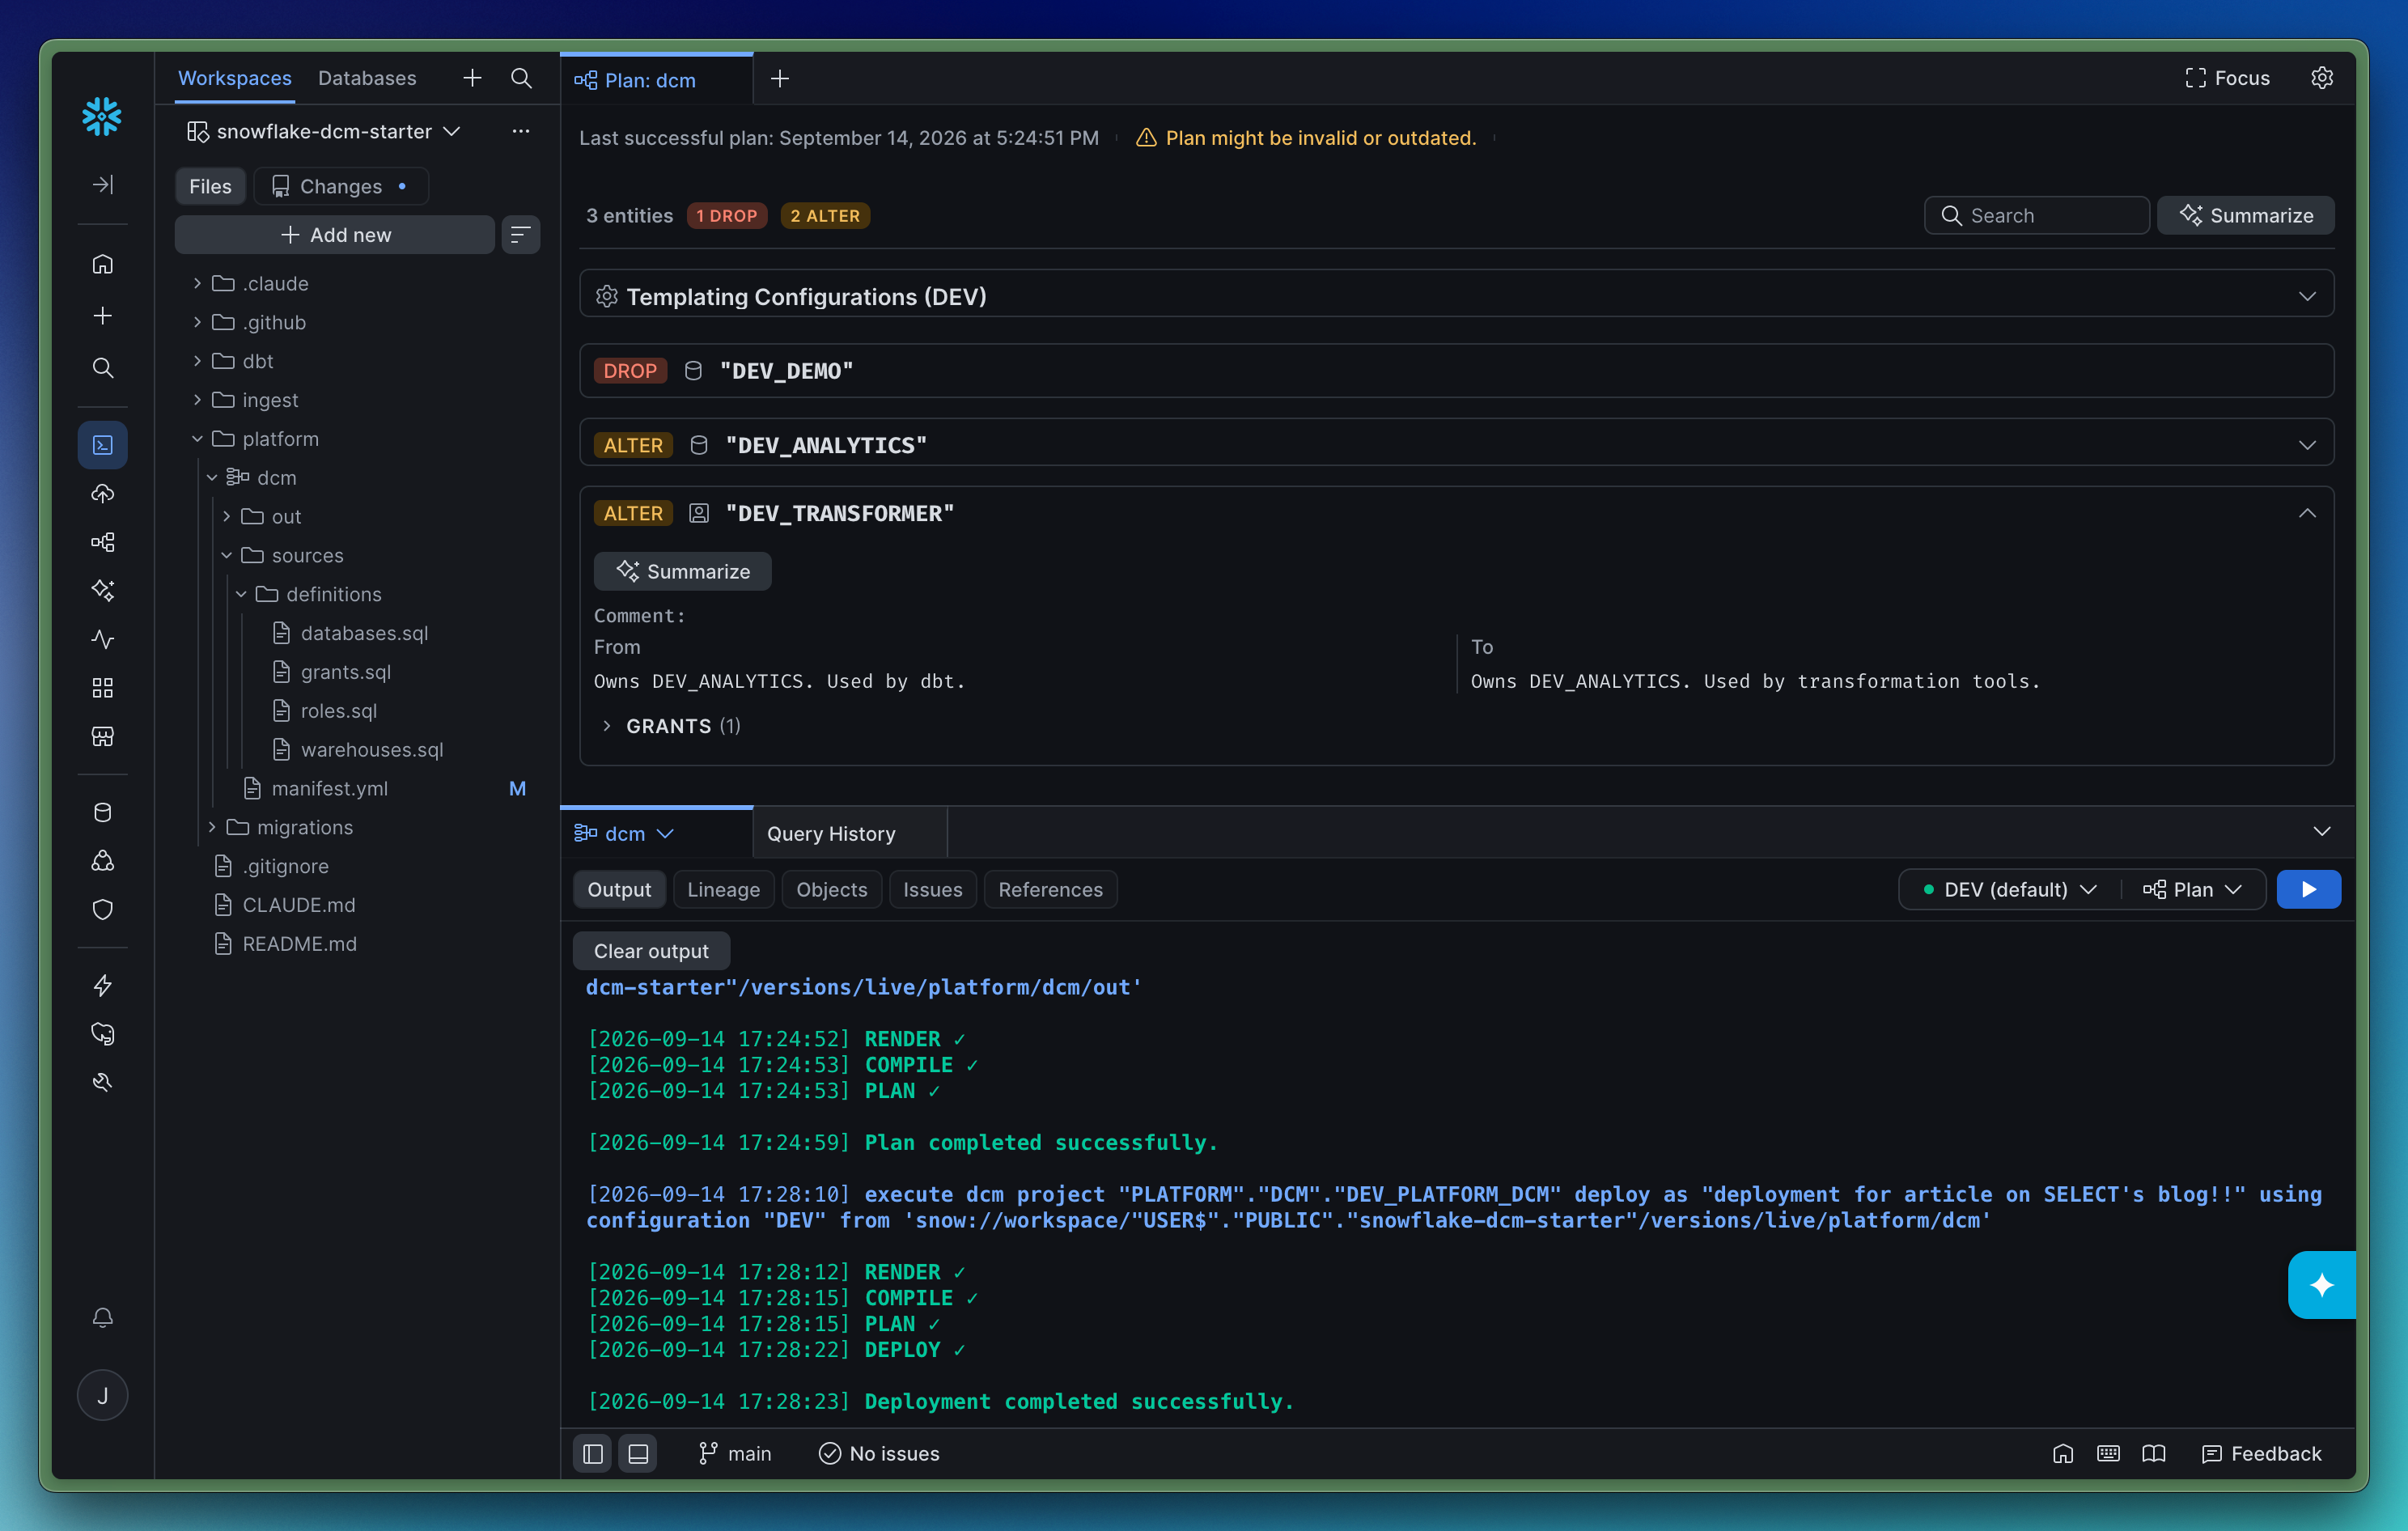
Beim Ausführen eines Plans öffnet sich ein Tab, der den Plan erläutert:
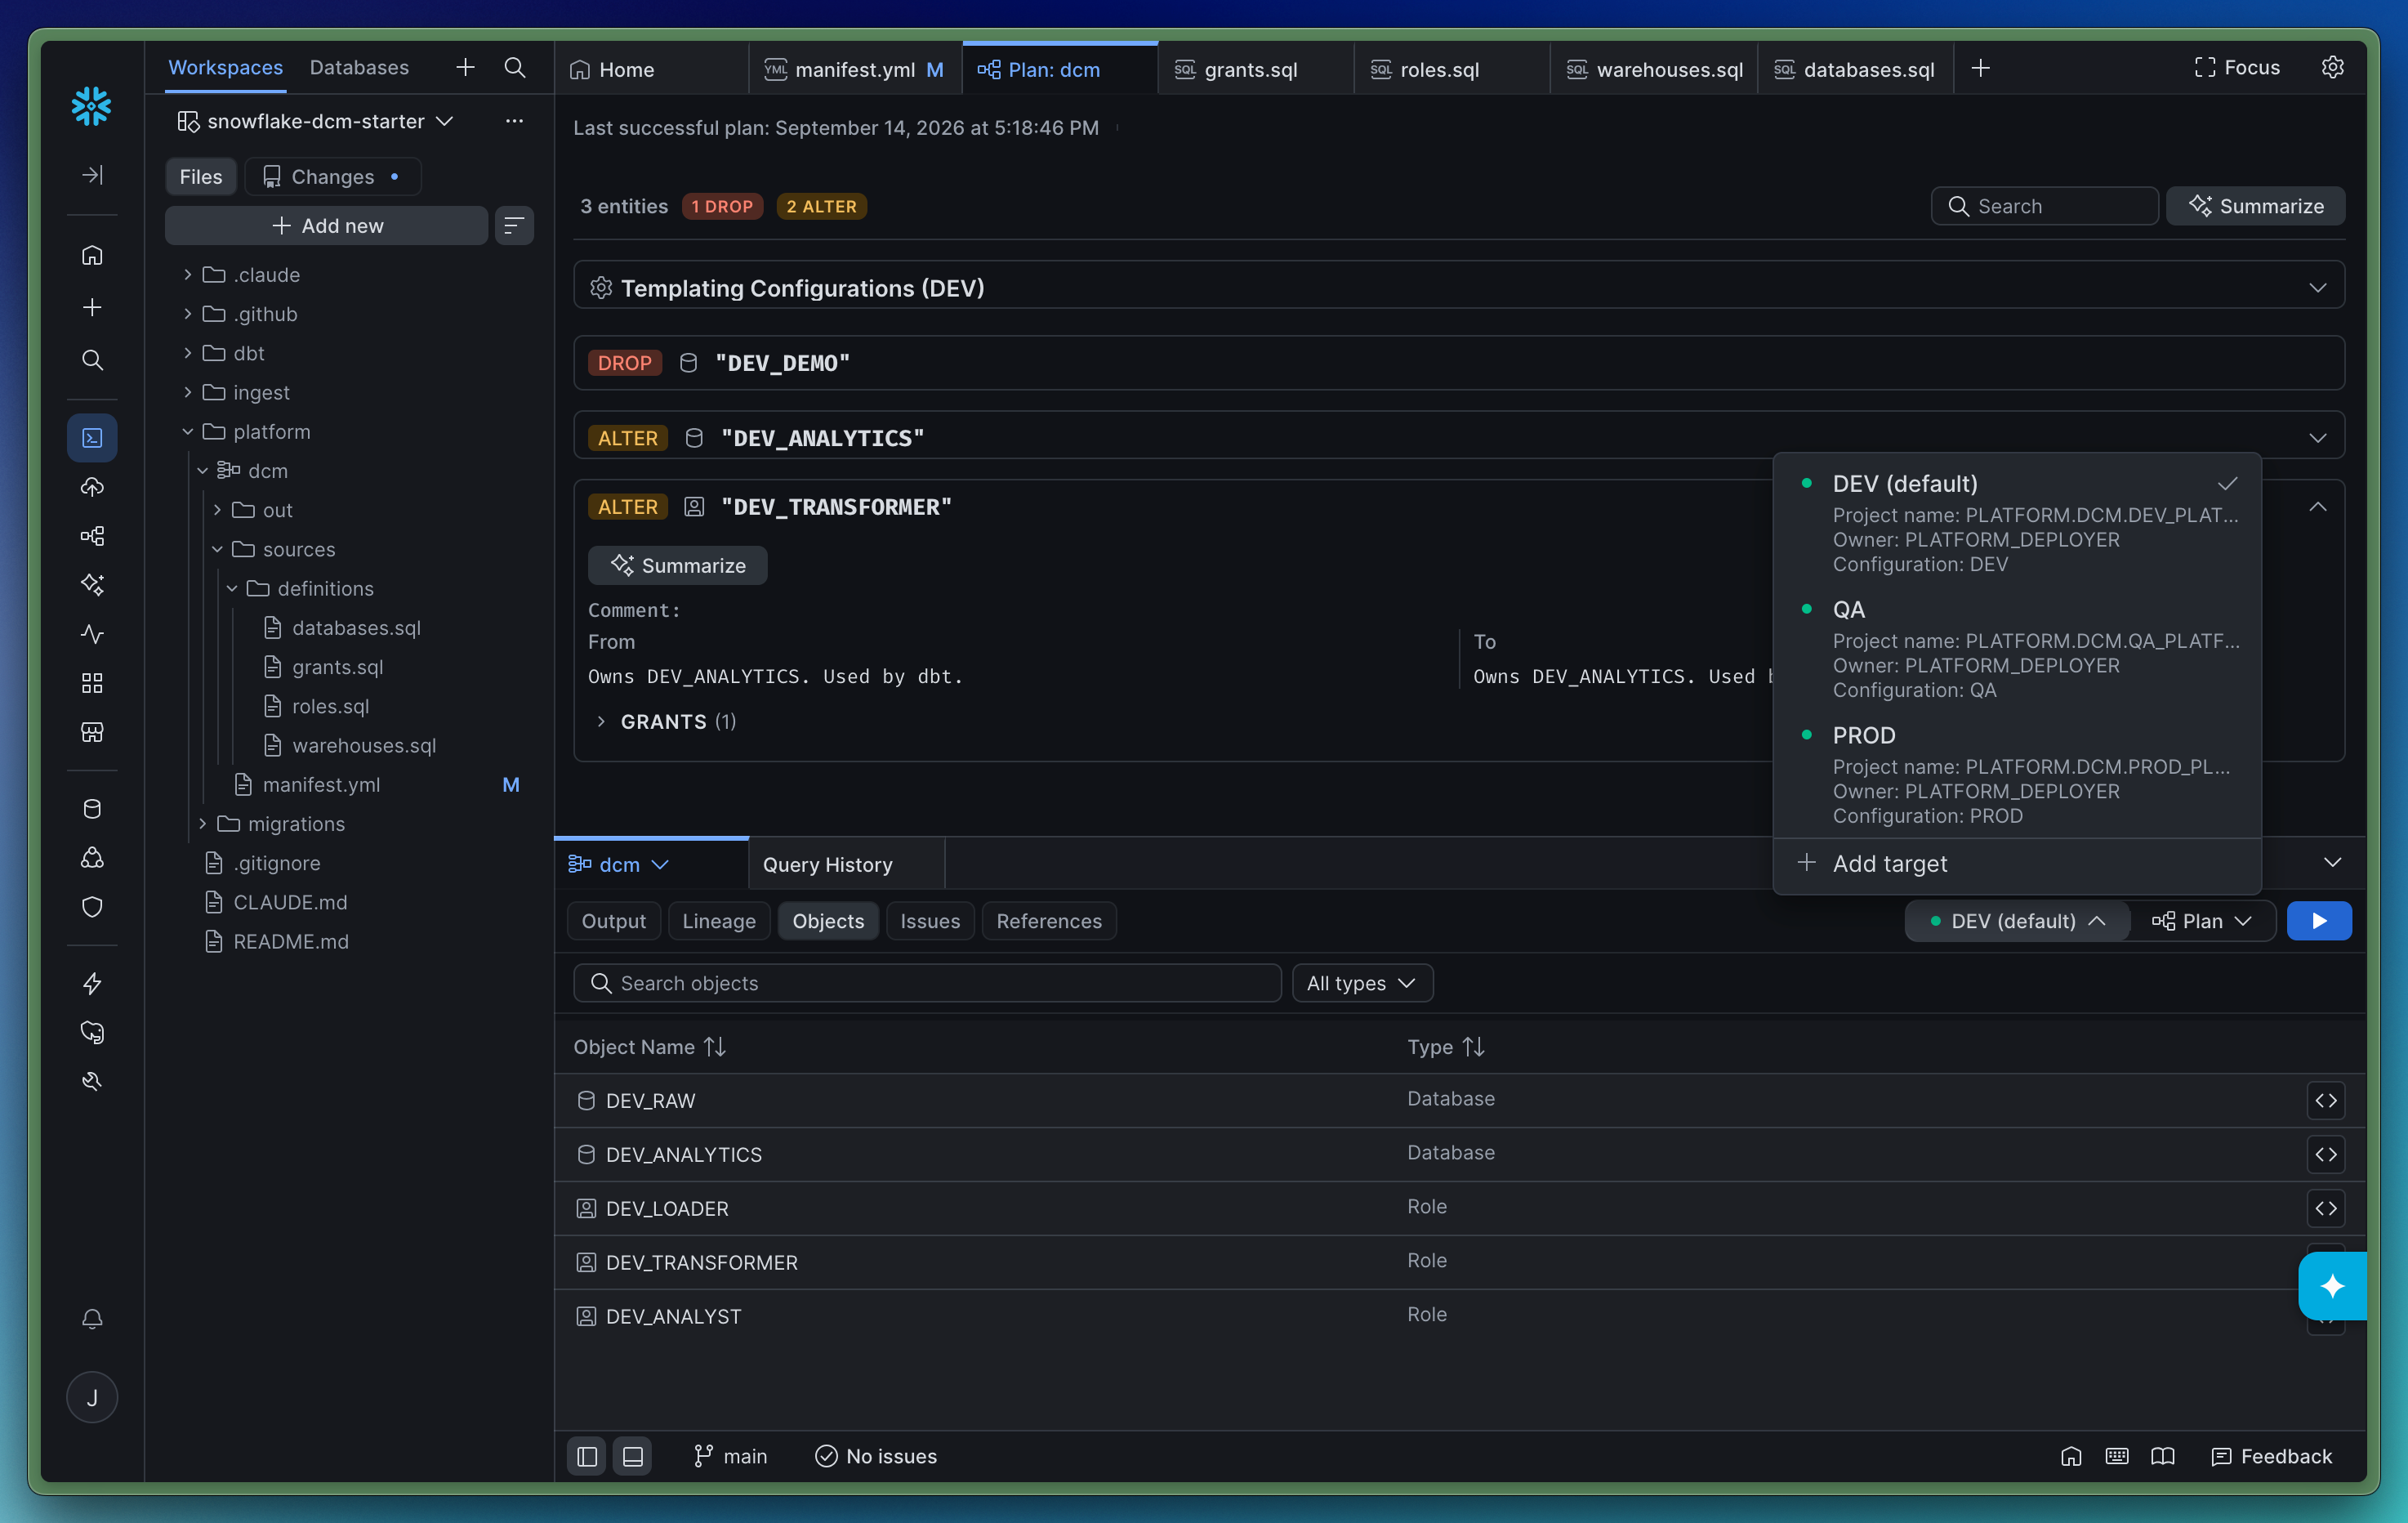
Die Umgebung wechseln Sie über den Picker:
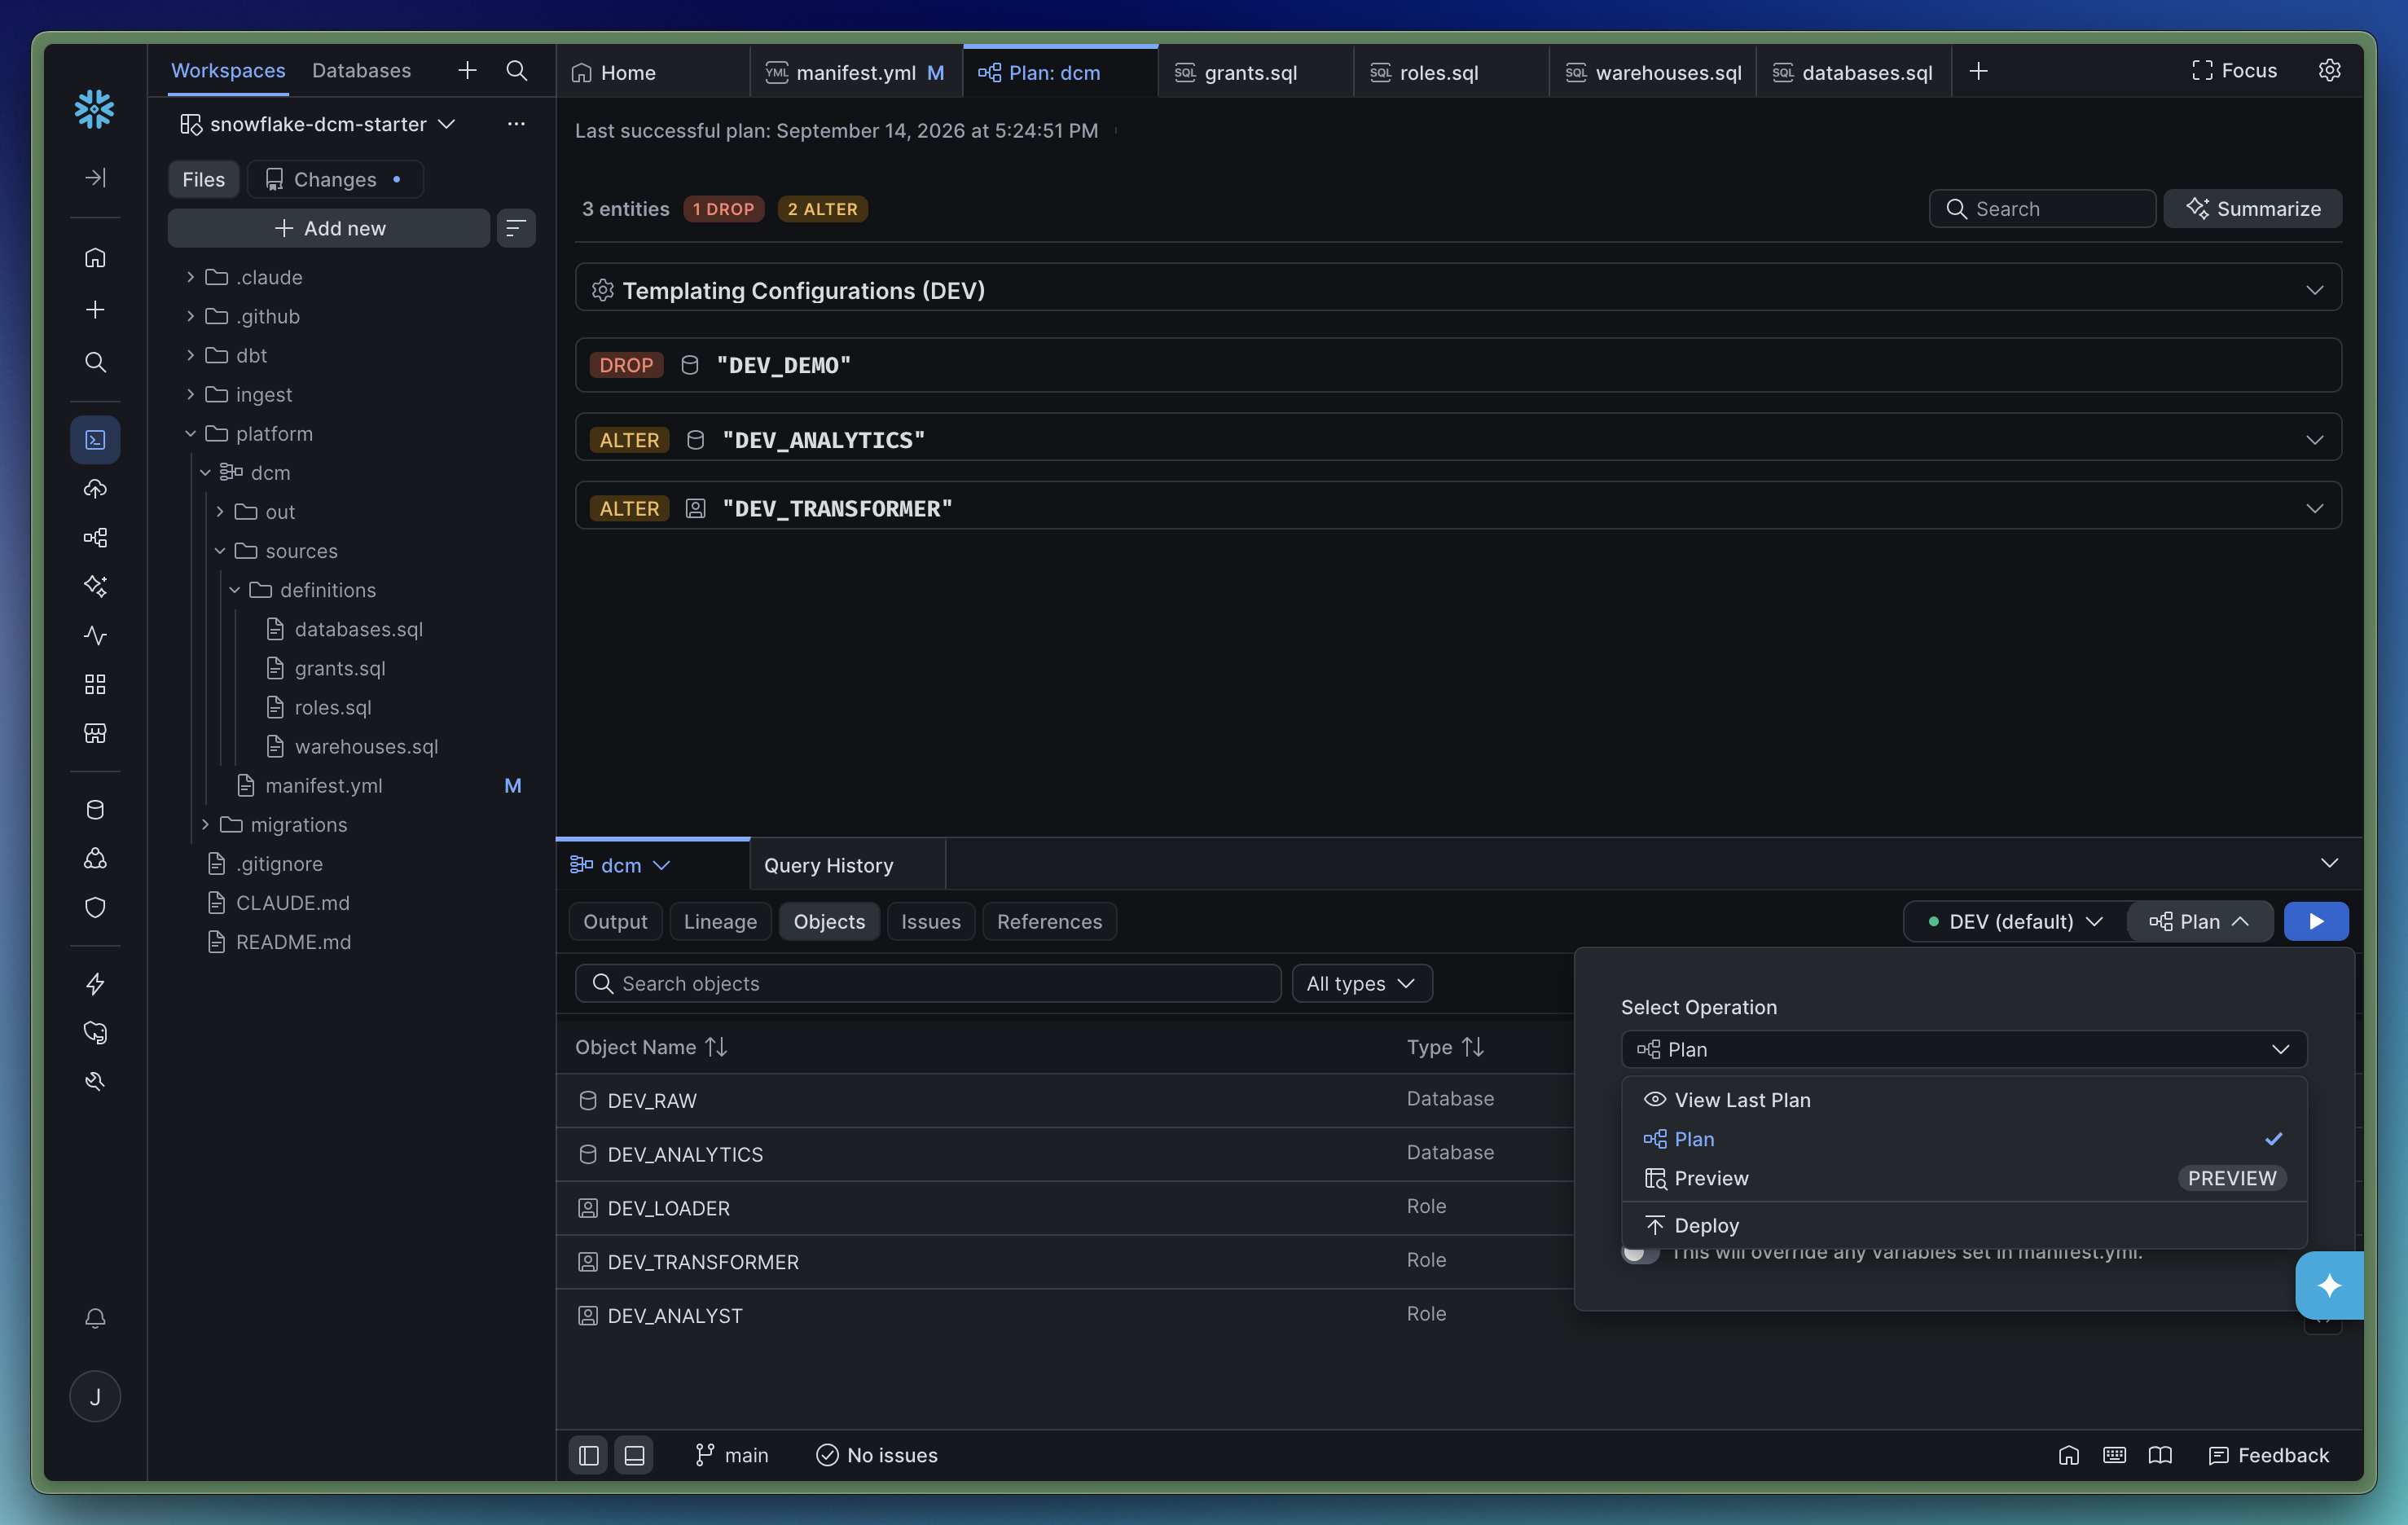
Wenn Sie bereit zum Deployen sind, klicken Sie einfach auf das Plan-Dropdown und wählen Deploy:
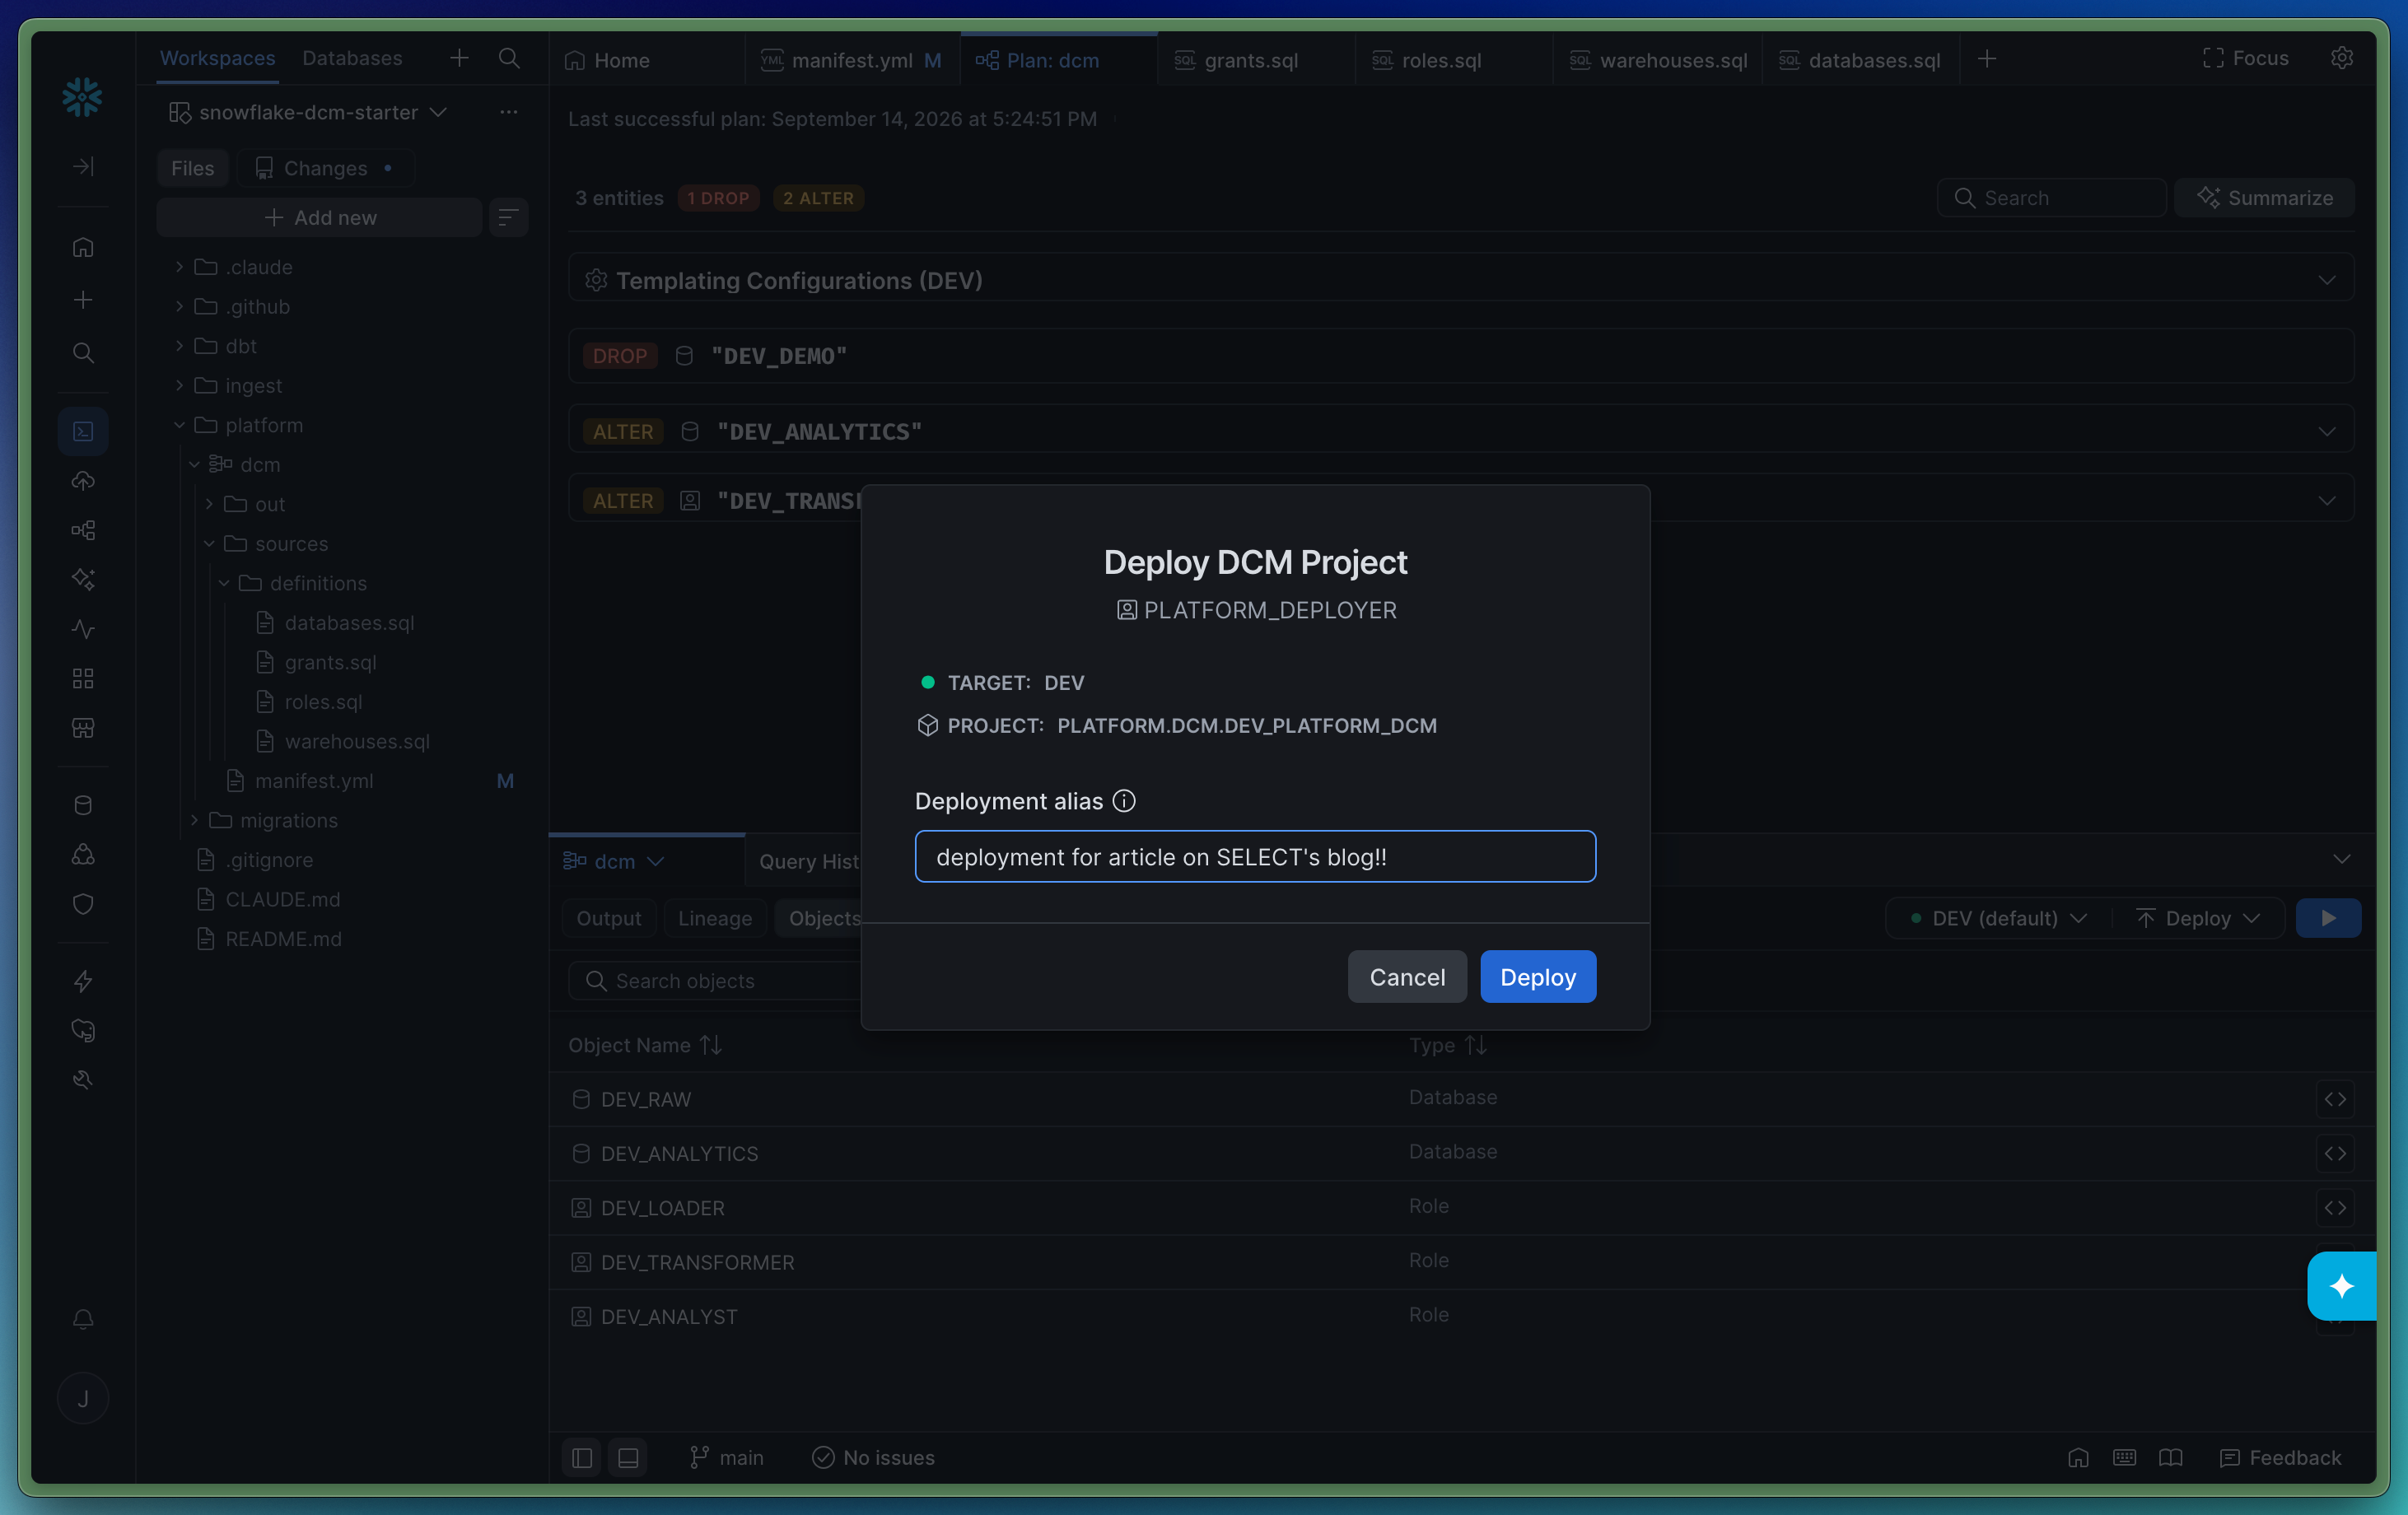
Sobald der Vorgang abgeschlossen ist, erscheint oben in der Bildschirmmitte eine Toast-Meldung, die das erfolgreiche Deployment bestätigt.
Der Output-Tab zeigt Ihnen die CLI-Ausgabe aller Läufe:

Hätten wir einen DAG aus Dynamic Tables oder Tasks, würde er im Lineage-Tab erscheinen – dieses Projekt enthält aber keine.
DCM lokal über die CLI ausführen
Ich persönlich arbeite komplett in Visual Studio Code. Hier der schnelle Überblick, wie ein Deployment in VS Code aussieht. dcm ist ein Sub-Command des snow-CLI-Befehls. Solange Sie also die snow CLI installiert haben, haben Sie DCM bereits! Hier zeige ich snow dcm plan und snow dcm deploy in einem einzigen Screenshot.
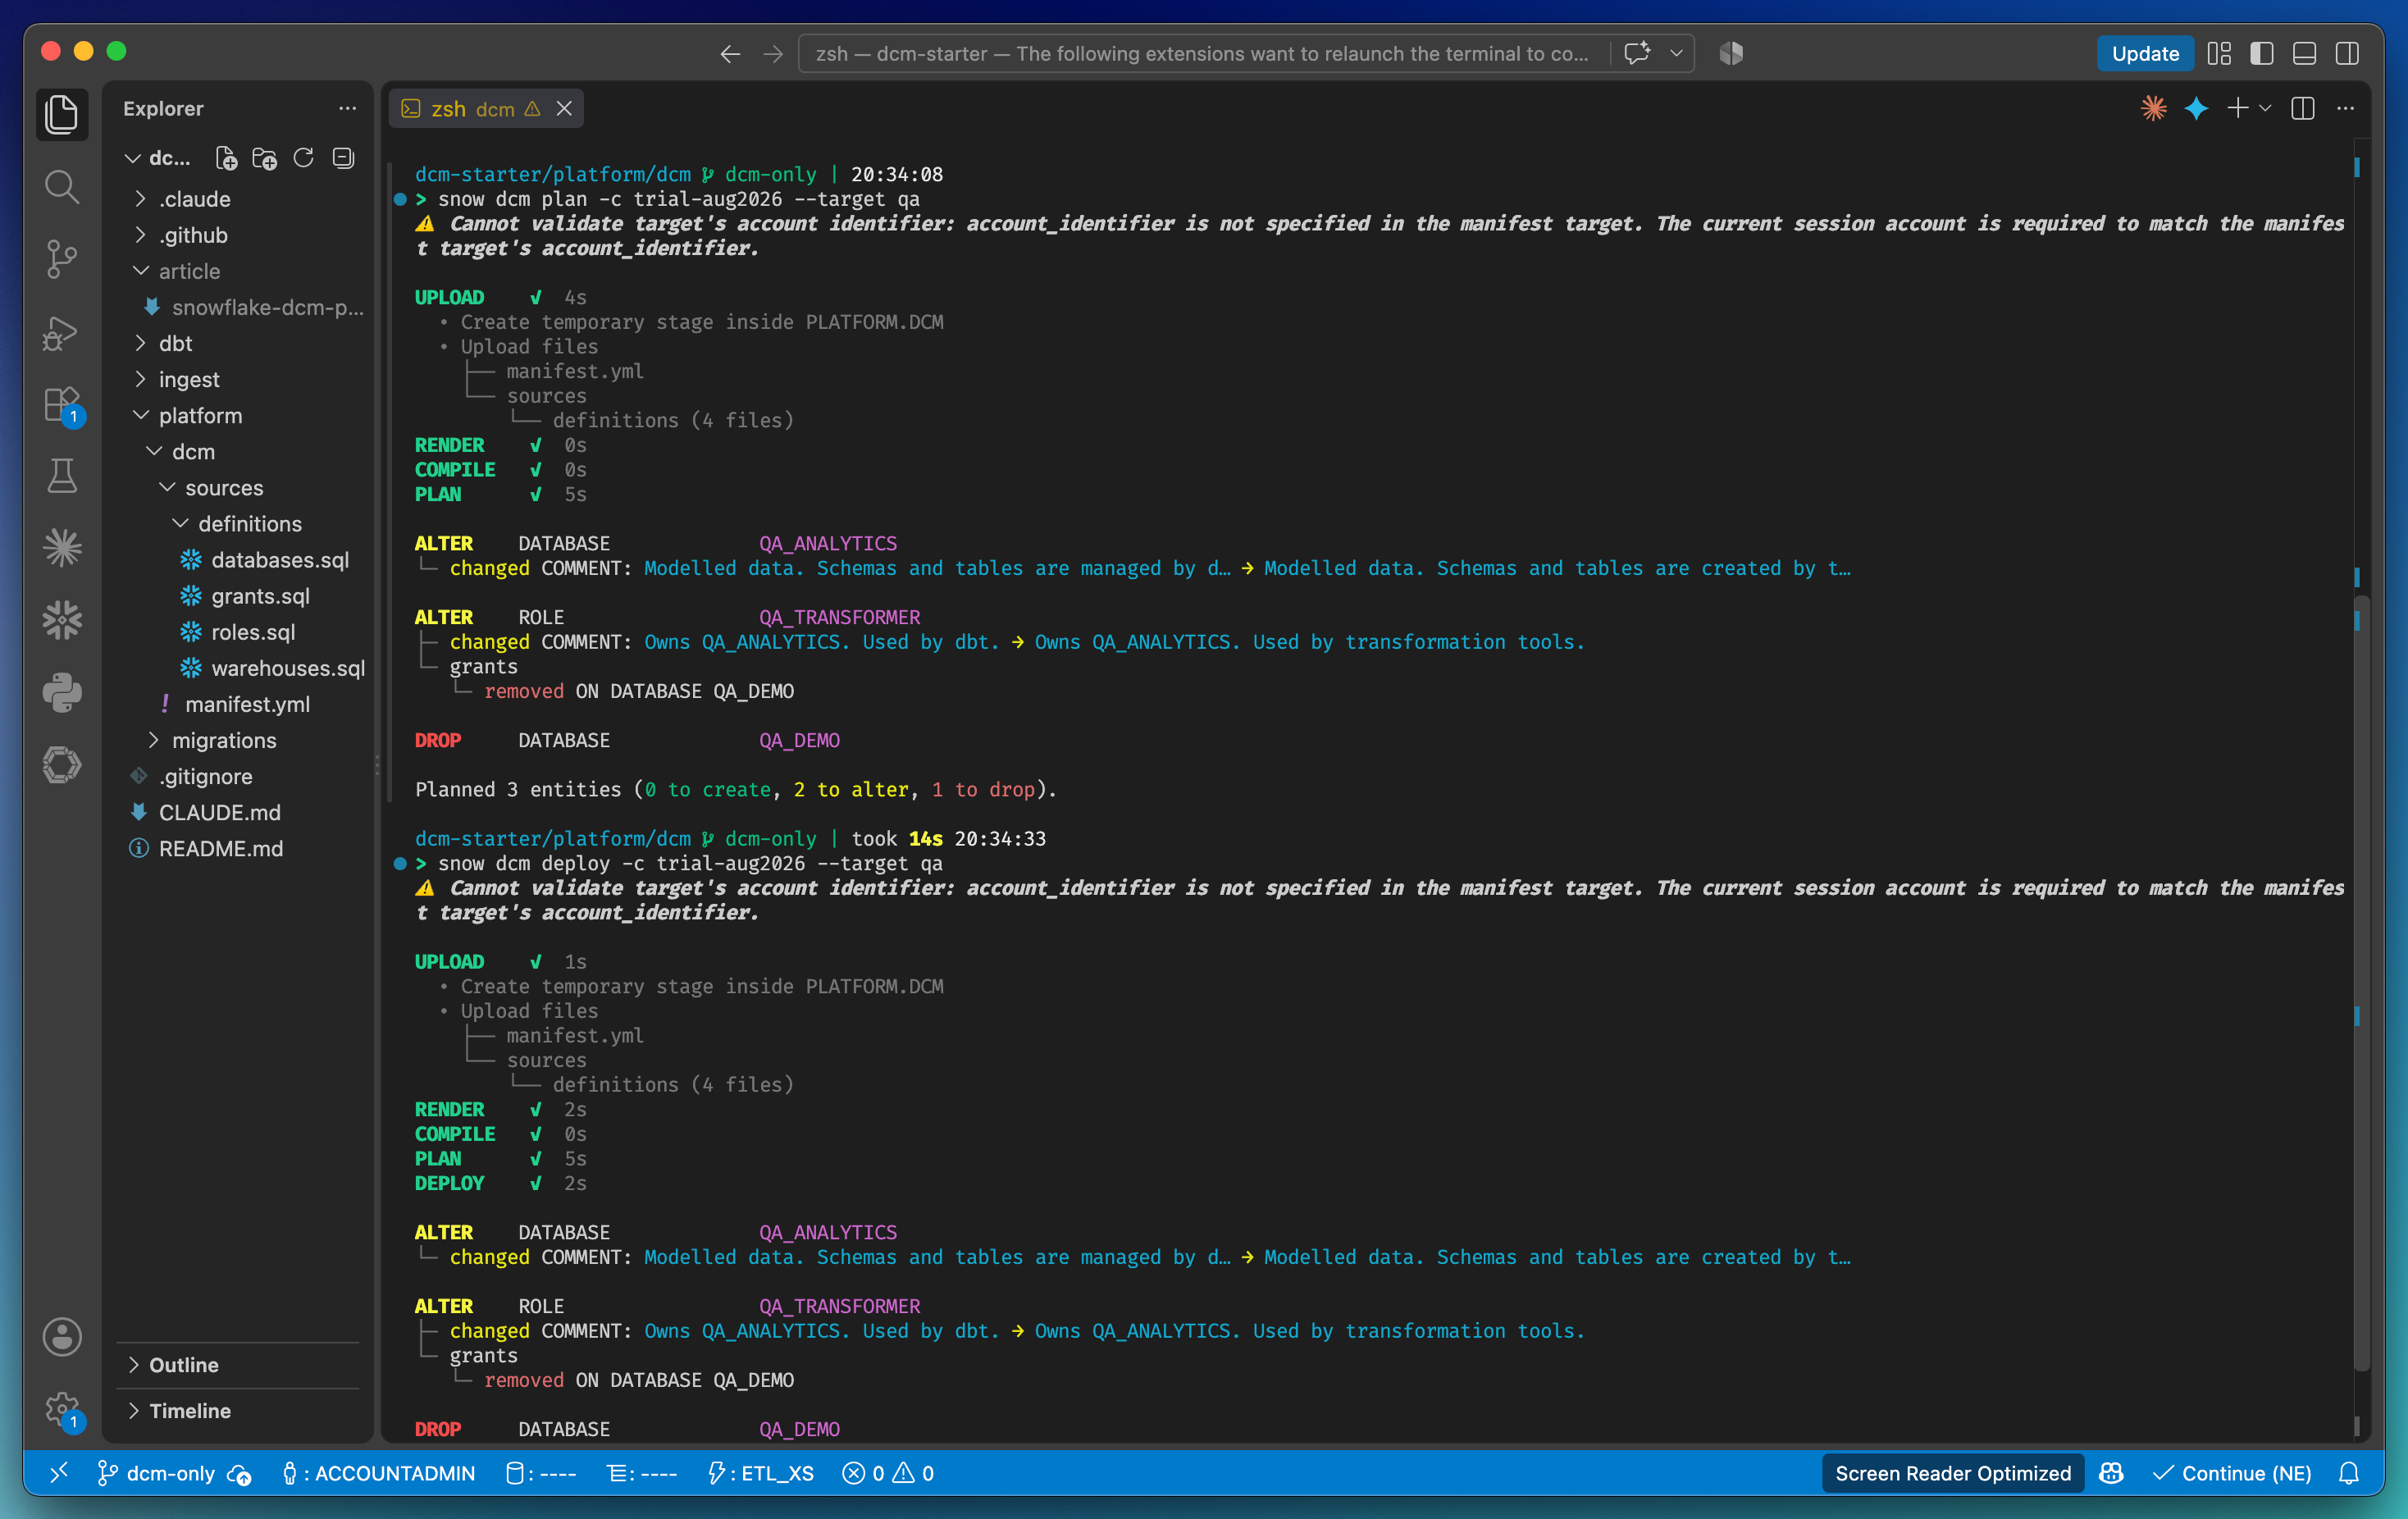
Jetzt kann ich lokal an den Dateien iterieren, in meiner Dev-Umgebung deployen und einen PR öffnen, der QA plant und deployt und den Plan gegen Prod laufen lässt. Ein ausgesprochen entwicklerfreundlicher Workflow!
DCM im Vergleich zu den Alternativen
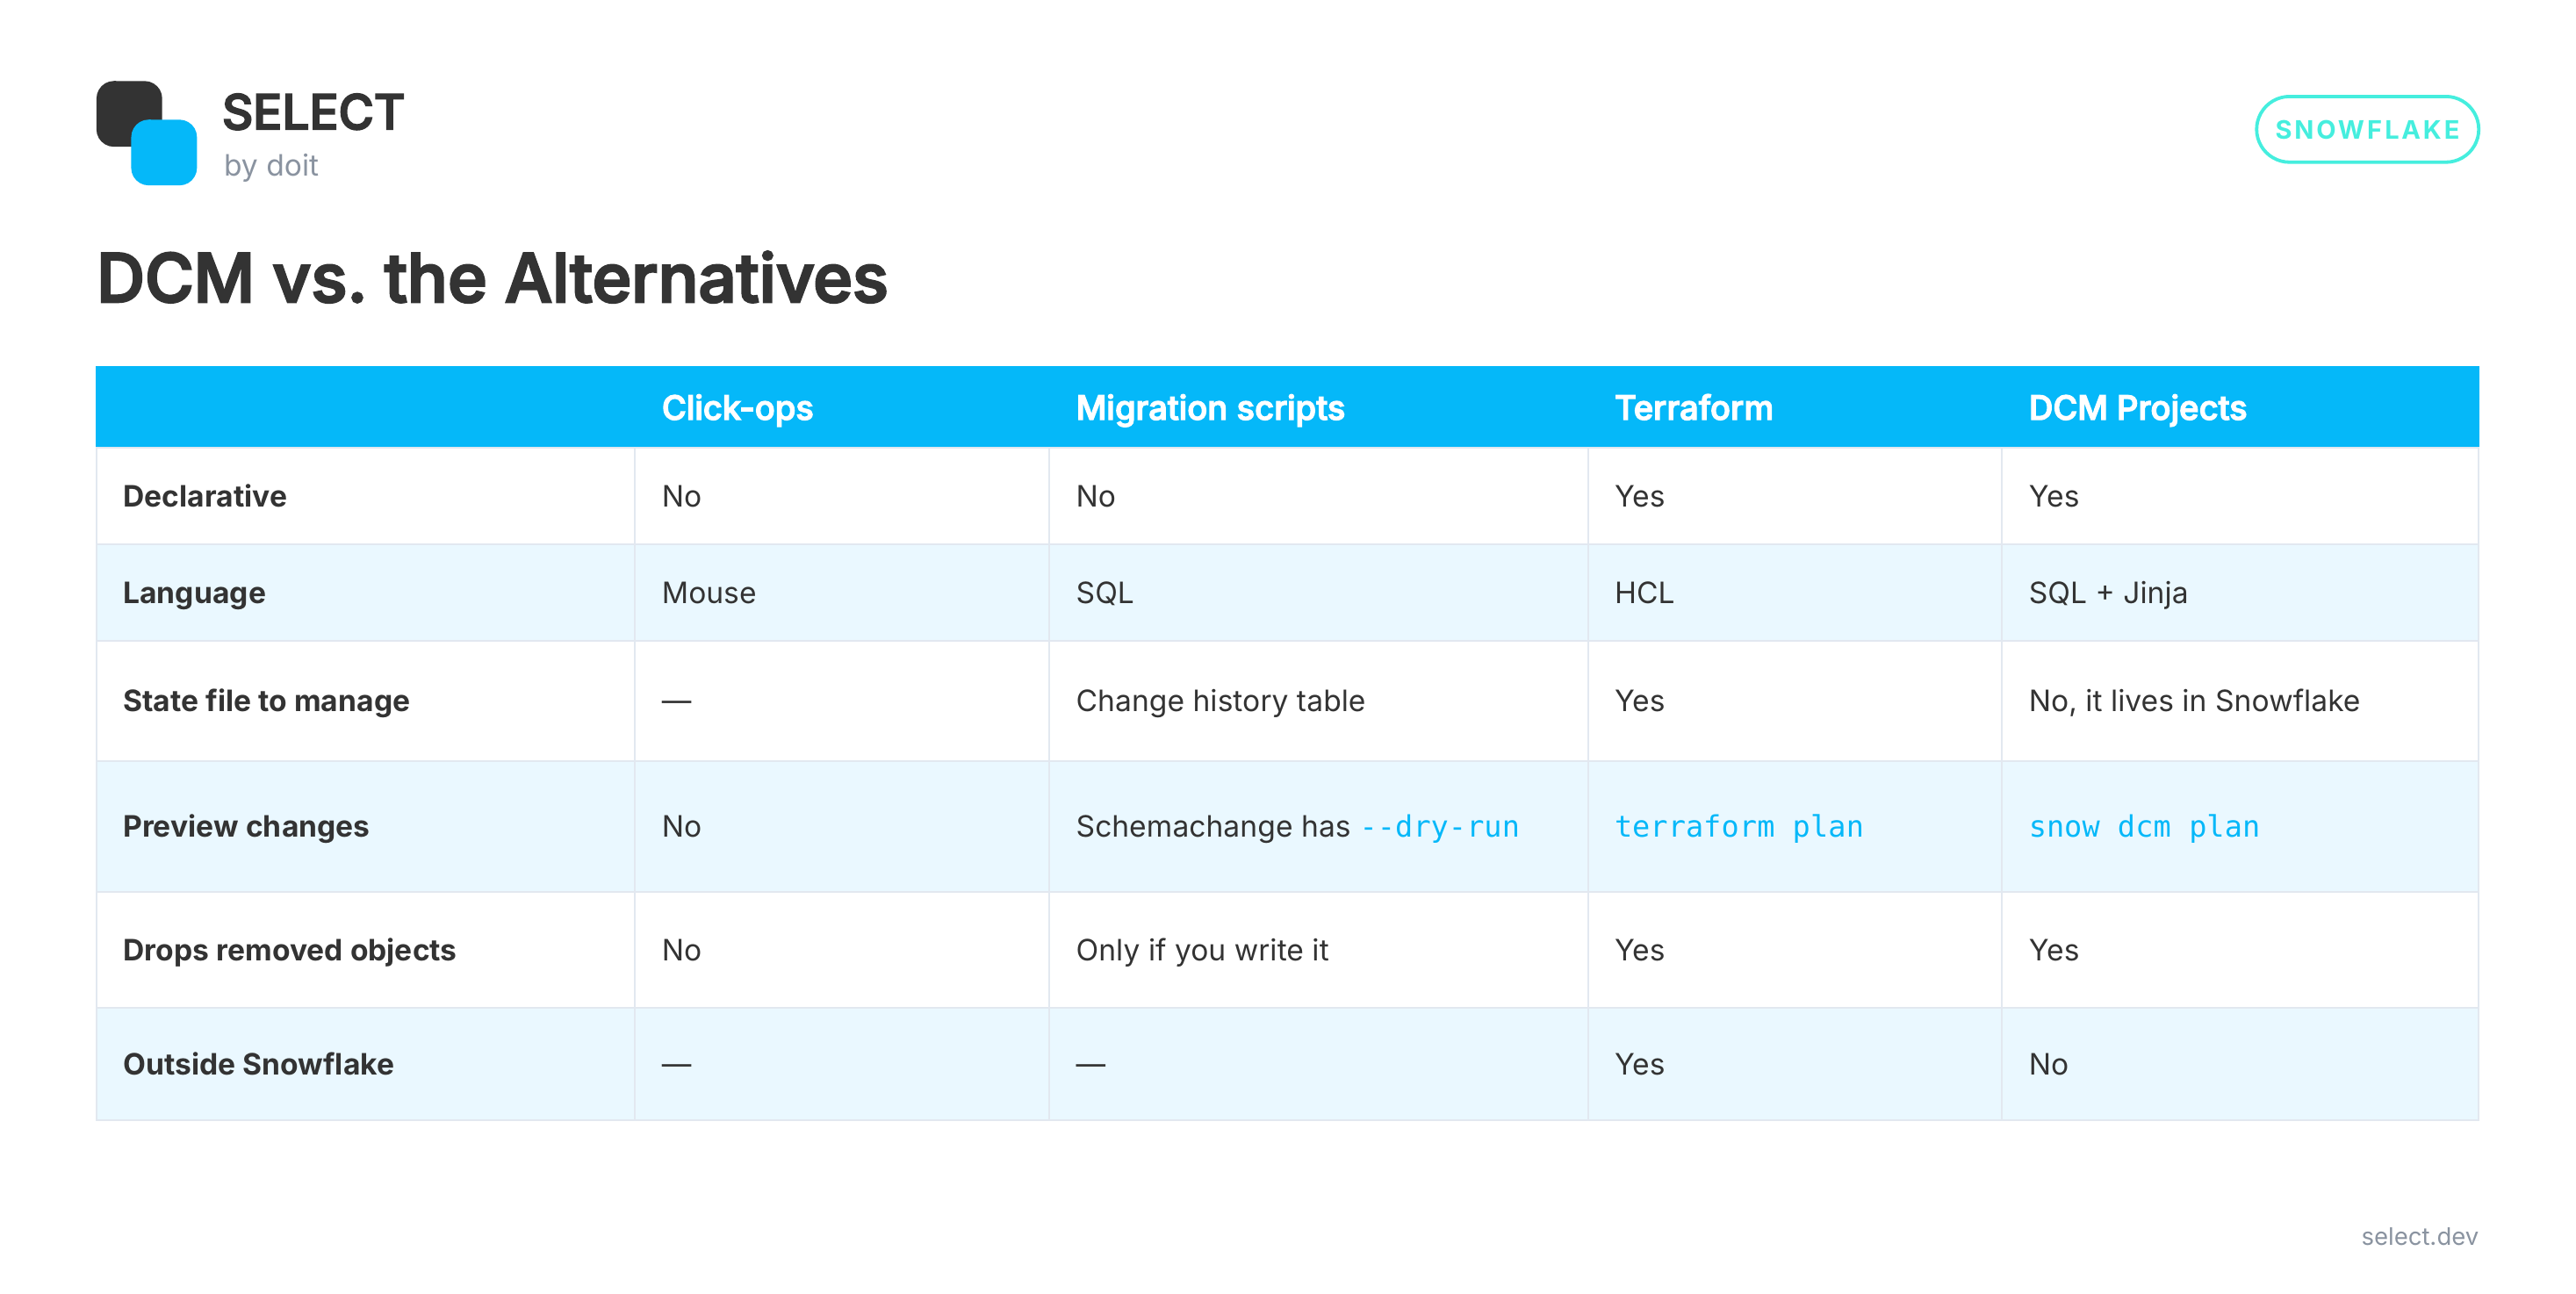
Wenn Sie AWS, Snowflake und Ihr DNS in einem gemeinsamen Terraform-Repo verwalten, ergibt Terraform weiterhin Sinn. Wenn die Infrastruktur Ihres Teams im Wesentlichen aus Snowflake besteht und Ihr Team bereits SQL spricht, ist DCM der reibungsärmste Weg, den ich gefunden habe.
Probieren Sie es selbst aus
All das habe ich in ein Starter-Repo gepackt: https://github.com/jeff-skoldberg-gmds/snowflake-dcm-starter.
Es enthält die Definitionen, die Bootstrap-Migrationen, beide GitHub-Actions-Workflows und Claude-Code-Skills. Führen Sie /project-setup aus, und es führt Sie Schritt für Schritt durch Account, Manifest, Bootstrap, das erste Deploy und die CI – jeder Schritt wird einzeln abgehakt.
Es enthält außerdem leere ingest/- und dbt/-Ordner, denn DCM ist nur das Fundament. Bauen Sie ein Mono-Repo für Ihre Snowflake-Plattform, das auch das Laden und Transformieren von Daten umfasst. Die Rollen und Datenbanken warten auf Ihre Pipelines.
Und jetzt: ausprobieren – und sagen Sie mir, ob sich Infrastructure as Code in Snowflake immer noch wie eine lästige Pflicht anfühlt!