
TL;DR
- Les DCM Projects sont la solution native et déclarative de Snowflake pour gérer vos objets sous forme de code. Vous écrivez
DEFINE <object>au lieu deCREATE <object>(par exempleDEFINE DATABASE), et Snowflake détermine ce qui doit changer. - Le cycle : modifier les définitions, planifier, puis déployer. Le plan est un diff en lecture seule. Le déploiement l'applique.
- DCM supprime ce que vous cessez de définir. Une ligne supprimée, une base de données en moins. Lisez le plan.
- Un
manifest.ymlet un peu de Jinja suffisent pour obtenirDEV,QAetPRODà partir d'un seul jeu de fichiers. - DCM peut gérer les tables et les vues, mais à mon avis il ne devrait pas dès lors que vous utilisez déjà dbt. Laissez DCM gérer la plateforme (rôles, bases de données, warehouses, grants) et dbt gérer ce qui se trouve dans les bases.
- Le design des rôles et des bases de données reprend le guide de configuration Snowflake de dbt Labs, suivi par des centaines de projets dbt. Le repo y apporte quelques améliorations et le transforme en code.
- Voici le repo GitHub sur lequel s'appuie cet article, avec une CI/CD via GitHub Actions qui ne touche jamais à
ACCOUNTADMIN.
Comment en est-on arrivé là
Si vous utilisez Snowflake depuis un moment, vous avez probablement géré l'infrastructure de votre compte de l'une de ces trois façons :
- Le click-ops. Quelqu'un avec
ACCOUNTADMINcrée un objet dans Snowsight un mardi. Personne ne se souvient pourquoi. Trois ans plus tard, personne n'ose le supprimer. - Les scripts de migration :
V1__create_roles.sql,V2__grant_things.sql,V47__fix_the_grant_from_V2.sql. Des outils comme schemachange les exécutent dans l'ordre. Ça fonctionne, mais l'état actuel de votre compte est la somme de 47 fichiers, et bon courage pour lire ça. - Terraform. Déclaratif et puissant. Mais il apporte aussi HCL, un provider à maintenir à jour, et un fichier d'état à stocker, verrouiller et, de temps en temps, opérer à cœur ouvert. Pour beaucoup d'équipes data, c'est toute une discipline à apprendre juste pour créer un warehouse.
Les DCM Projects sont la réponse de Snowflake. Vous obtenez le modèle déclaratif de Terraform, mais le langage est le SQL, et l'état vit dans Snowflake.
Le modèle de départ : les grants que tout le monde a copiés
Avant d'entrer dans DCM, rendons à César ce qui est à César. Si vous avez configuré Snowflake pour dbt, il y a fort à parier que vous ayez lu l'article de Claire Carroll Setting up Snowflake — the exact grant statements we run sur le Discourse de dbt. Des centaines de projets dbt ont été mis en place en suivant ce schéma. Je l'ai moi-même suivi un nombre incalculable de fois.
Le design est simple, et c'est pour cela qu'il fonctionne :
- Une base
rawpour les données entrantes, et une baseanalyticspour les données modélisées. - Un rôle
loaderqui écrit dansraw, un rôletransformerqui litrawet construitanalytics, et un rôlereporterqui litanalyticset rien d'autre. - Des future grants, pour que les nouveaux schémas et tables soient lisibles sans que personne ne lève le petit doigt.
Le problème n'a jamais été le design. Le problème, c'est qu'il s'agit d'une liste d'instructions que l'on colle une fois dans un worksheet. Six mois plus tard, personne ne peut dire si le compte y correspond encore, et l'extension environnement de dev en bas de l'article est laissée en exercice au lecteur.
Le repo de démarrage conserve donc la structure de Claire et change quelques éléments :
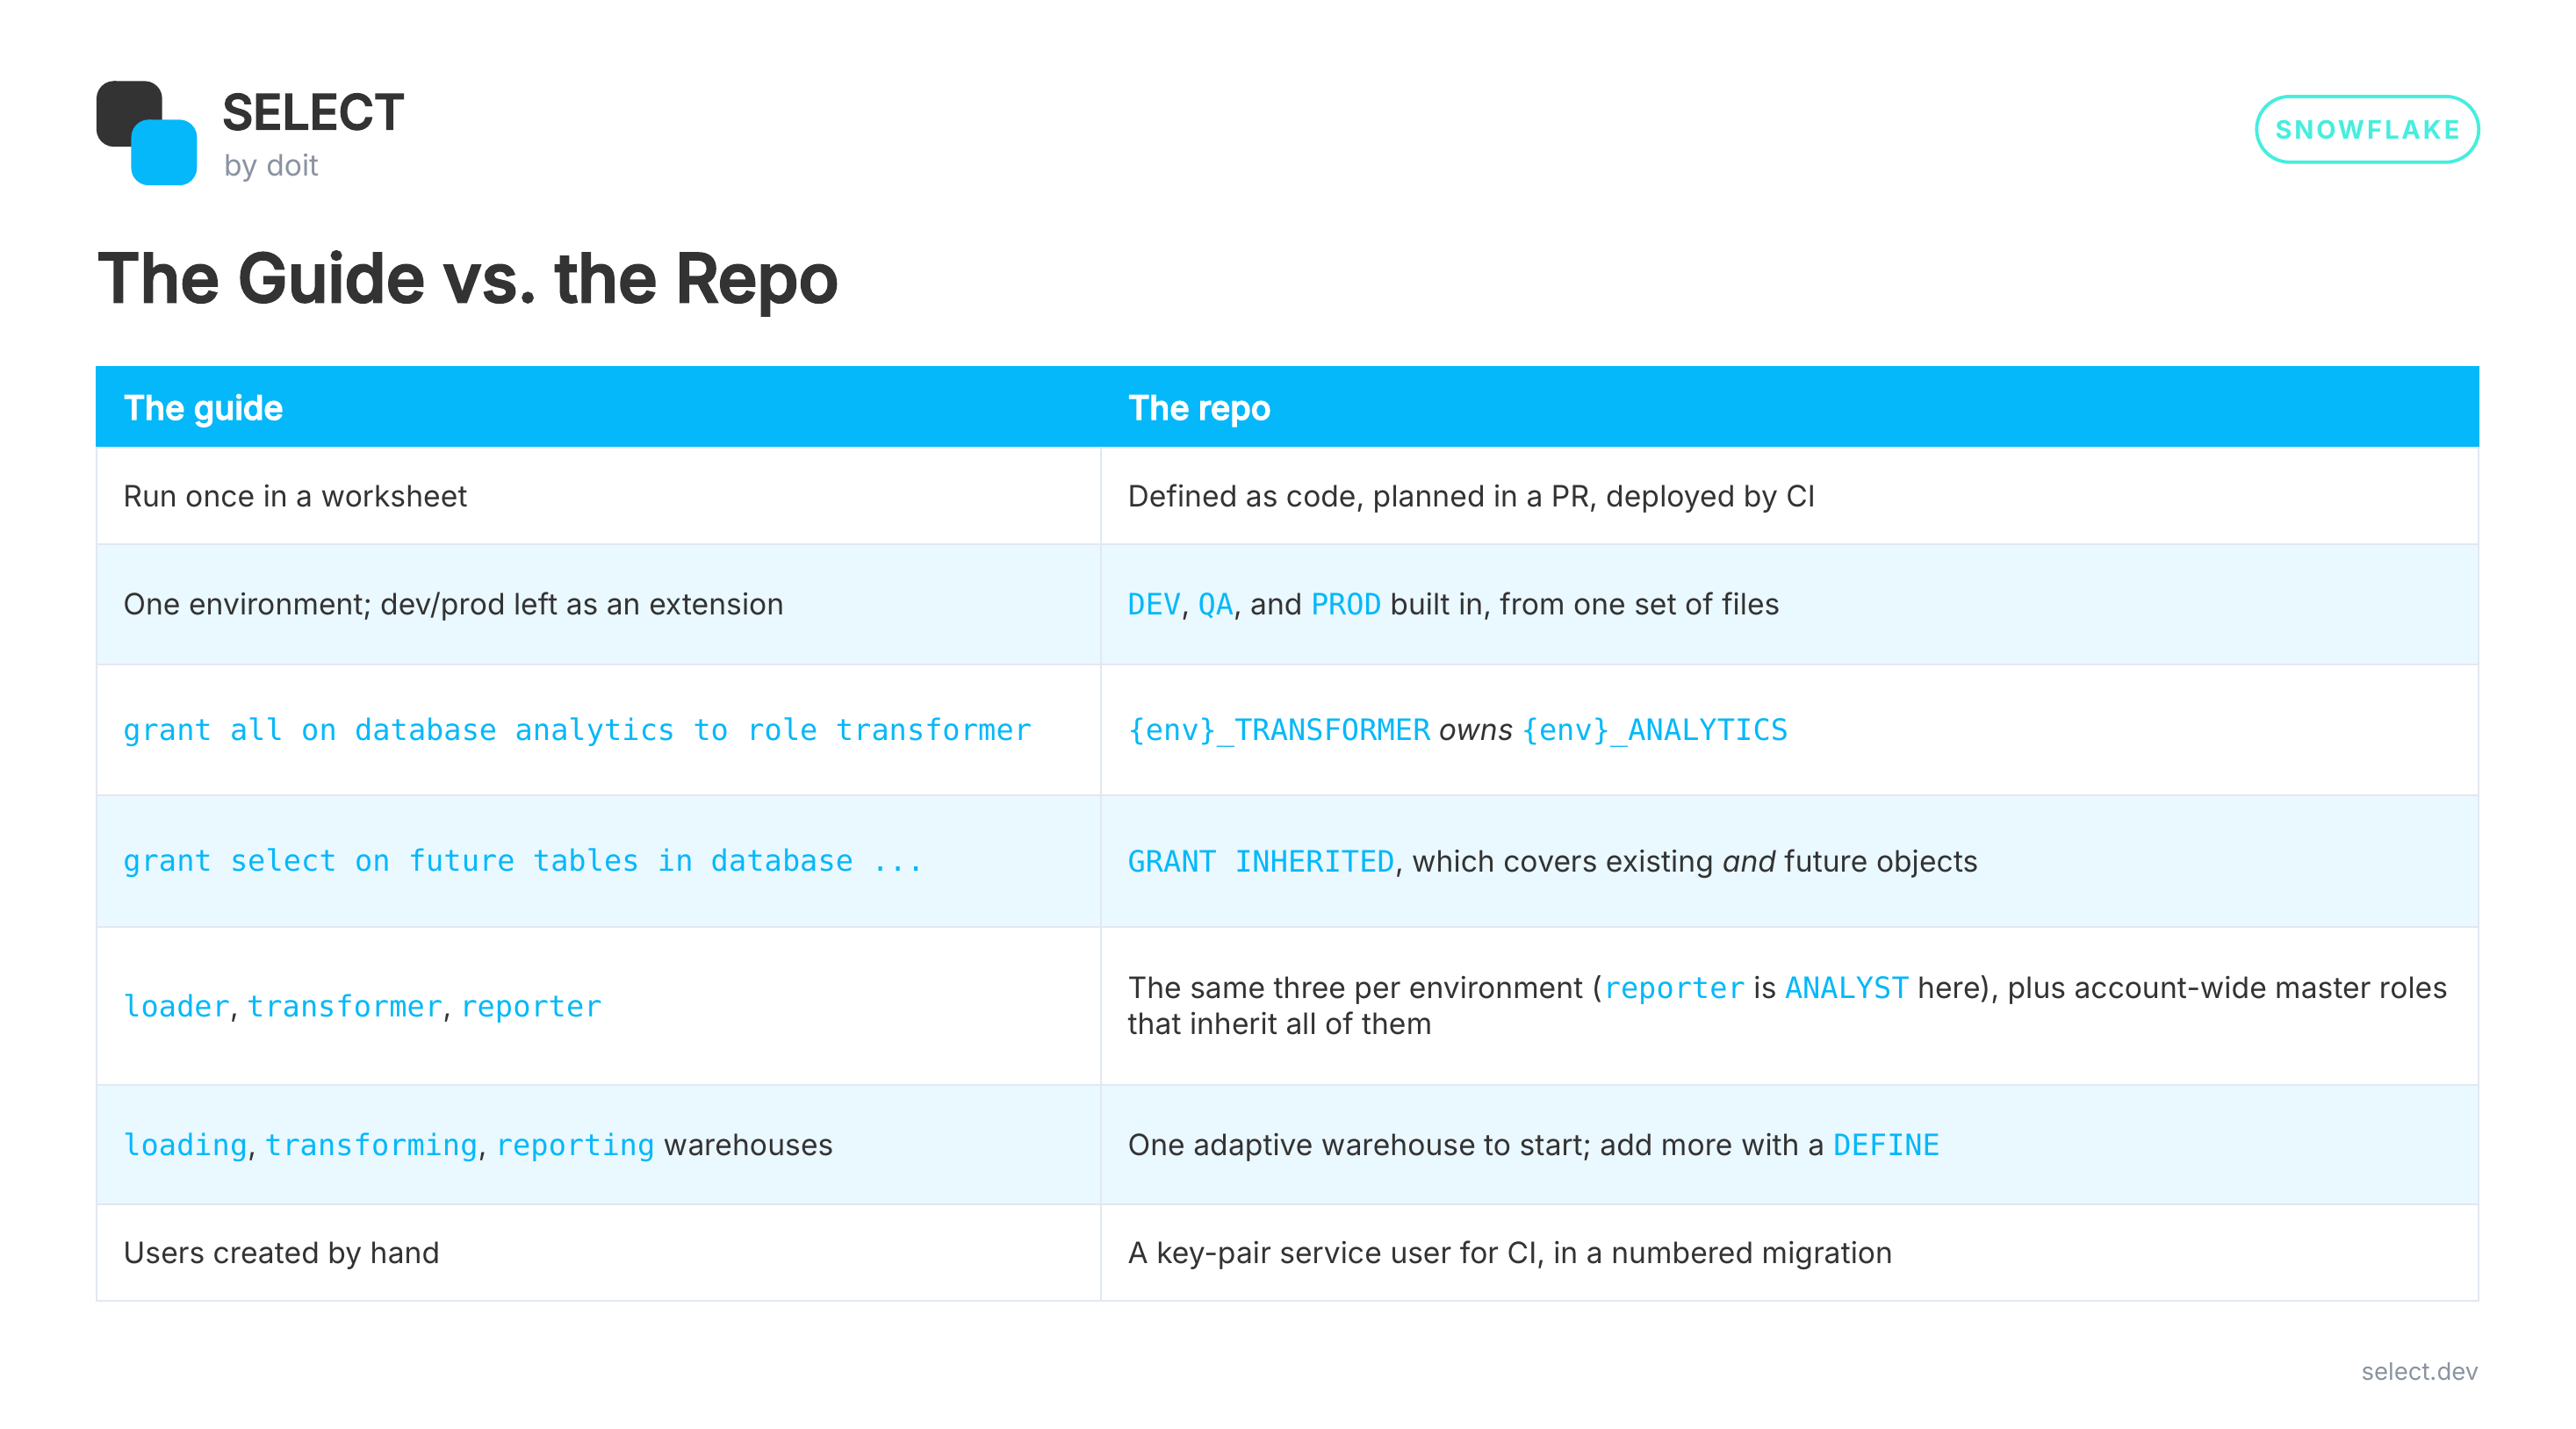
Pourquoi les inherited grants remplacent les future grants
Cette ligne sur les grants est le changement le plus important, alors creusons un peu.
Les future grants ont longtemps été le bon outil ! C'est ce qui rend le setup de Claire si peu coûteux à maintenir. Mais ils posent trois problèmes, et quiconque administre Snowflake depuis quelques années en a rencontré au moins un :
- Ils ne couvrent que le futur. Un future grant ne fait rien pour les tables qui existent déjà, donc chaque setup l'associe à une instruction
grant select on all tables. Cela fait deux instructions par privilège, et deux choses à retenir. - Les future grants au niveau schéma écrasent ceux au niveau base. Si quelqu'un ajoute un future grant sur un schéma, Snowflake ignore les future grants définis au niveau de la base pour ce schéma. Votre rôle
reportercesse discrètement de recevoir les nouvelles tables à cet endroit, sans la moindre erreur. - C'est une copie ponctuelle, pas une règle. Un future grant est appliqué à chaque objet au moment de sa création. Révoquez ou modifiez le future grant plus tard : tous les objets qu'il a déjà touchés conservent l'ancien privilège. Le grant que vous voyez ne décrit plus les accès dont les gens disposent réellement.
Un inherited grant, c'est une seule instruction sur un conteneur (le compte, une base de données ou un schéma), et elle s'applique à chaque objet correspondant qu'il contient, existant ou futur :
GRANT INHERITED SELECT ON ALL TABLES IN DATABASE {{ env }}_ANALYTICS TO ROLE {{ env }}_ANALYST;Voilà le remplaçant, à lui seul, du future grant, du grant on all et de la version par schéma de chacun. Quand vous voulez savoir pourquoi quelqu'un peut lire une table, SHOW GRANTS dispose des colonnes IS_INHERITED et INHERITED_FROM, qui pointent vers le grant responsable.
C'est aussi un choix naturel pour DCM. Un outil déclaratif veut une ligne qui énonce la règle. Les analystes peuvent tout lire dans ANALYTICS tient désormais en une ligne, pas six.
Quelques compromis à connaître :
- Pas d'exceptions. Vous ne pouvez pas révoquer le privilège sur une table pour l'exclure. La documentation Snowflake prévient que la révocation semble réussir alors que le rôle conserve l'accès via l'inherited grant. Si une table nécessite des accès différents, sa place est dans un autre schéma ou une autre base.
- Déplacer ou cloner un objet dans un conteneur change qui peut le voir, sans la moindre instruction
GRANT. C'est le but, mais soyez vigilant avec les clones. OWNERSHIPne peut pas être hérité. La propriété reste un grant classique.- Un paramètre de compte est requis,
FEATURE_RBAC_INHERITED_GRANTS, que seulACCOUNTADMINpeut activer. On y revient dans la partie bootstrap ci-dessous.
Qu'est-ce qu'un DCM Project dans Snowflake ?
Deux choses :
- Un dossier de fichiers. Un
manifest.ymlet des fichiers.sqlremplis d'instructionsDEFINE. - Un objet DCM project dans Snowflake. Il vit dans un schéma comme n'importe quel autre objet et conserve l'historique des déploiements.
Voici l'arborescence de mon repo de démarrage :
platform/ dcm/ manifest.yml sources/definitions/ roles.sql databases.sql warehouses.sql grants.sql migrations/ 000_bootstrap.sql 001_ci_deployer.sqlUn fichier par type d'objet, c'est ma convention, pas une règle de DCM. Snowflake lit tout ce qui se trouve sous sources/, alors organisez le tout comme bon vous semble.
DEFINE, pas CREATE
Tout le changement de paradigme est là. Avec un script de migration, vous écrivez des instructions :
CREATE ROLE IF NOT EXISTS DEV_LOADER;ALTER ROLE DEV_LOADER SET COMMENT = 'Owns DEV_RAW';Avec DCM, vous écrivez l'état final :
DEFINE ROLE DEV_LOADER COMMENT = 'Owns DEV_RAW. Used by ingestion tools.';Si le rôle n'existe pas, DCM le crée. S'il existe avec un commentaire différent, DCM le modifie. S'il correspond déjà, DCM ne fait rien. Vous n'écrirez plus jamais de IF NOT EXISTS, ni d'ALTER pour corriger ce que vous avez écrit la semaine dernière.
Les grants fonctionnent de la même manière. Vous ne faites pas de DEFINE sur un grant, vous l'énoncez, tout simplement :
DEFINE DATABASE DEV_RAW  COMMENT = 'Landing zone. Schemas and tables are created by ingestion tools.';
GRANT OWNERSHIP ON DATABASE DEV_RAW TO ROLE DEV_LOADER;
Planifier, puis déployer
Chaque changement passe par deux étapes. Avec la CLI Snowflake :
snow dcm plan --from platform/dcm --target DEV \ --connection my_account --role PLATFORM_DEPLOYERLe plan compare vos fichiers à ce qui se trouve dans le compte et vous indique précisément ce qu'il créerait, modifierait et supprimerait. Il ne change rien.
[capture d'écran : sortie du plan pour l'ajout d'une base de données]
Satisfait du résultat ? Déployez :
snow dcm deploy --from platform/dcm --target DEV --alias add_marketing_db \ --connection my_account --role PLATFORM_DEPLOYERLe --alias est optionnel, mais utilisez-le, vraiment. Sans alias, votre historique de déploiements est une liste de noms auto-générés que personne ne peut lire. Avec, snow dcm list-deployments se lit comme un changelog : add_marketing_db, analyst_read_on_analytics, drop_legacy_loader.
Tout cela est aussi faisable en SQL (EXECUTE DCM PROJECT ... PLAN), et les Workspaces de Snowsight proposent une interface dédiée. Je passe ma vie dans le terminal, donc c'est la CLI que vous verrez ici.
DCM supprime ce que vous cessez de définir
C'est la partie qui peut vous jouer des tours.
Si vous retirez un DEFINE déjà déployé, le prochain déploiement supprime l'objet concerné.
C'est le comportement attendu d'un outil déclaratif. Les fichiers sont le compte. Mais cela rend deux habitudes non négociables :
- Toujours planifier avant de déployer. Un
DROPinattendu dans le plan signifie qu'une définition a disparu, pas que DCM vous rend service. - Lire le plan dans votre PR. J'explique plus bas comment j'automatise cela.
Une dernière chose : la documentation Snowflake est claire sur le fait qu'un déploiement en échec peut vous laisser avec une exécution partielle. Ce n'est pas une seule grande transaction. Corrigez la définition et relancez plan → deploy, plutôt que de rafistoler à la main.
DEV, QA et PROD à partir d'un seul jeu de fichiers
Personne ne veut trois copies de roles.sql. Le manifest.yml définit des targets, et chaque target pointe vers son propre objet projet et transmet ses propres variables de templating :
manifest_version: 2type: DCM_PROJECTdefault_target: DEV
targets:  DEV:    account_identifier: ABCDEFG-XY12345    project_name: PLATFORM.DCM.DEV_PLATFORM_DCM    project_owner: PLATFORM_DEPLOYER    templating_config: DEV  # QA and PROD look the same
templating:  configurations:    DEV:
Afficher le code
Ensuite, chaque définition utilise {{ env }} comme préfixe :
DEFINE DATABASE {{ env }}_RAW  COMMENT = 'Landing zone. Schemas and tables are created by ingestion tools.';
DEFINE DATABASE {{ env }}_ANALYTICS  COMMENT = 'Modelled data. Schemas and tables are created by transformation tools.';
GRANT OWNERSHIP ON DATABASE {{ env }}_RAW TO ROLE {{ env }}_LOADER;GRANT OWNERSHIP ON DATABASE {{ env }}_ANALYTICS TO ROLE {{ env }}_TRANSFORMER;
Déployez avec --target DEV et vous obtenez DEV_RAW. Déployez avec --target PROD et vous obtenez PROD_RAW. Les mêmes fichiers.
Le point délicat : les objets au niveau du compte
Certains objets n'appartiennent à aucun environnement. Dans mon template, les trois environnements partagent un seul compte, un seul warehouse et un ensemble de rôles maîtres comme LOADER, qui héritent de DEV_LOADER, QA_LOADER et PROD_LOADER.
Si je définissais COMPUTE_XS sans condition, les trois targets le revendiqueraient, et chaque déploiement se le disputerait. Les objets au niveau du compte sont donc définis dans exactement un target, avec un if Jinja et une boucle :
{% if env == 'PROD' %}{% set envs = ['DEV', 'QA', 'PROD'] %}
DEFINE WAREHOUSE COMPUTE_XS  WAREHOUSE_TYPE = 'ADAPTIVE'  MAX_QUERY_PERFORMANCE_LEVEL = XSMALL  QUERY_THROUGHPUT_MULTIPLIER = 2  COMMENT = 'Sole compute warehouse for loads and transforms.';
{% for e in envs %}GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_LOADER;GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_TRANSFORMER;GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_ANALYST;{% endfor %}{% endif %}
Le piège : ce bloc PROD accorde des privilèges à DEV_LOADER et QA_LOADER, donc DEV et QA doivent être déployés avant PROD. L'ordre de déploiement devient une partie de votre process, et de votre CI.
Si vous placez chaque environnement dans son propre compte, le problème disparaît, mais chaque compte a alors besoin de sa propre copie des objets au niveau du compte. À vous de choisir votre compromis.
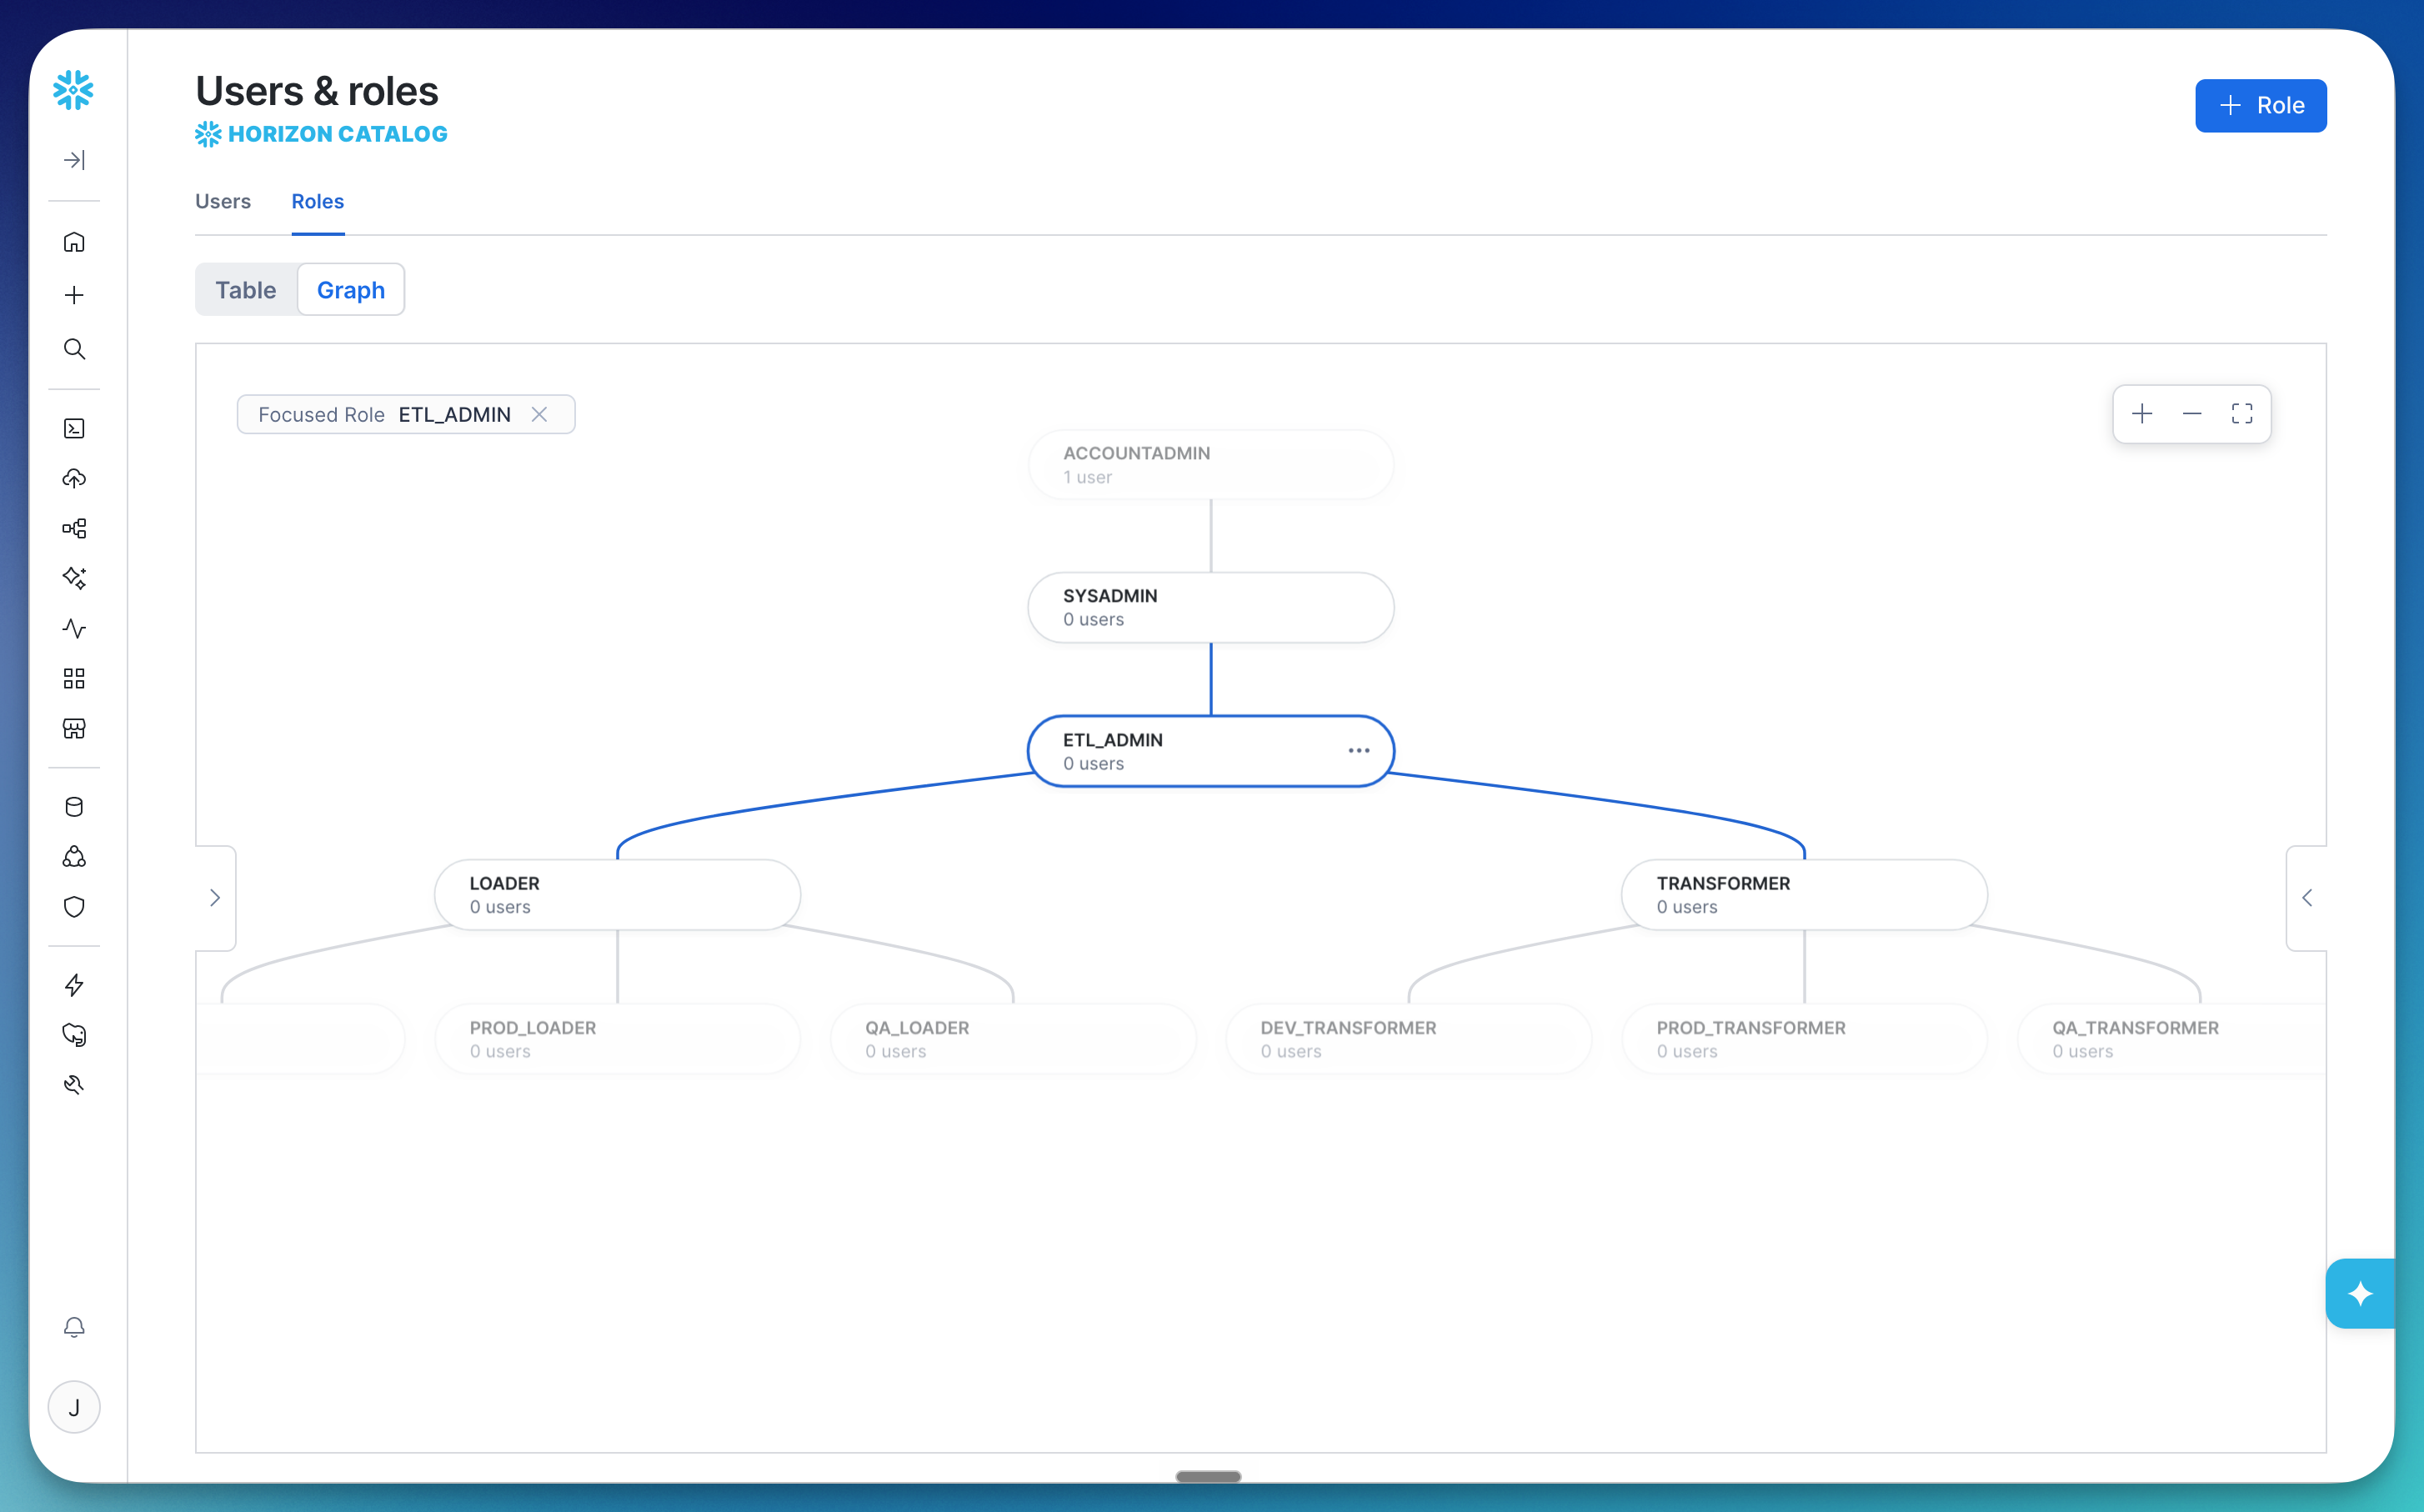
Voici le modèle de rôles auquel aboutit le template :
Et le rôle Deployer reçoit directement les rôles propres à chaque environnement :
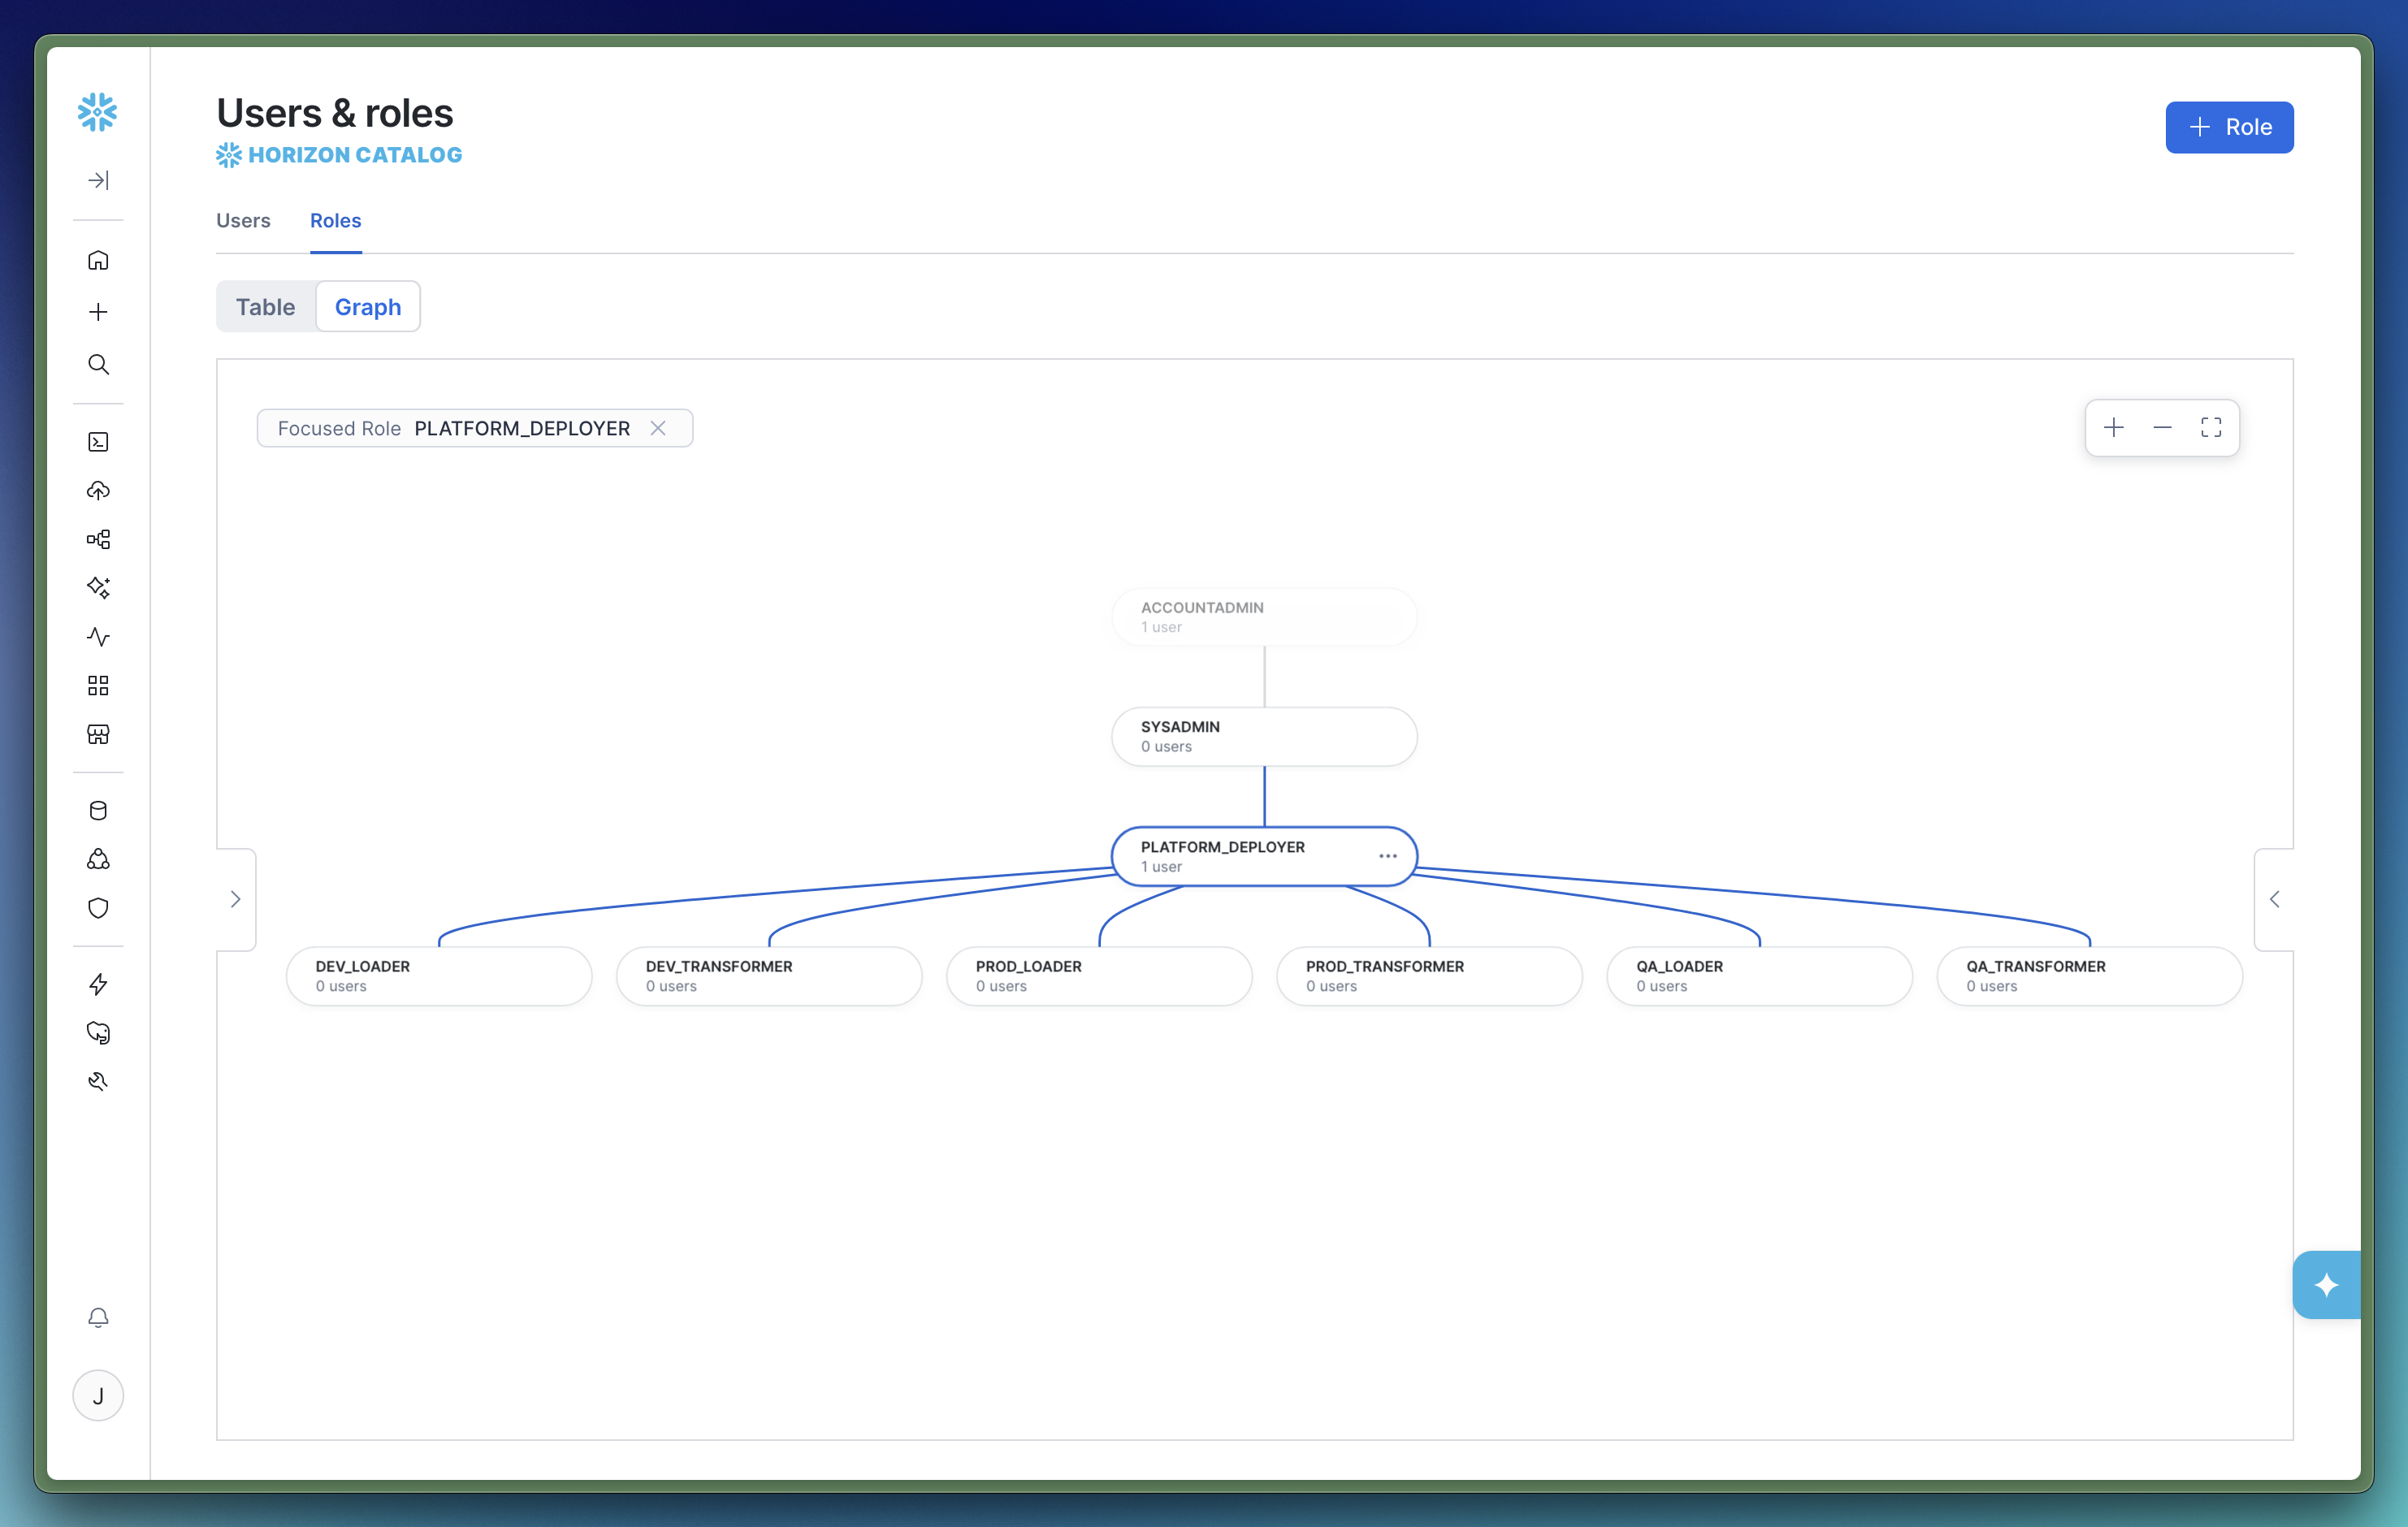
Votre outil d'ingestion se connecte en tant que {env}_LOADER. dbt se connecte en tant que {env}_TRANSFORMER. Les analystes reçoivent {env}_ANALYST, qui peut lire ANALYTICS et ne voit pas du tout RAW.
Si vous utilisez dbt, laissez-lui la propriété des tables et des schémas de la base Analytics
DCM prend en charge une longue liste de types d'objets : bases de données, schémas, tables, vues, dynamic tables, tasks, stages, fonctions, procédures, masking policies, tags, et plus encore.
Alors pourquoi mon template ne l'utilise-t-il que pour les rôles, les bases de données, les warehouses et les grants ?
Parce que si vous utilisez dbt, dbt gère déjà vos tables et vos vues, avec le lineage, les tests et la documentation. Mettez la même table dans une définition DCM et vous avez désormais deux outils qui pensent chacun en être propriétaire. L'un finira par supprimer ce que l'autre a construit.
Je trace donc une ligne nette :
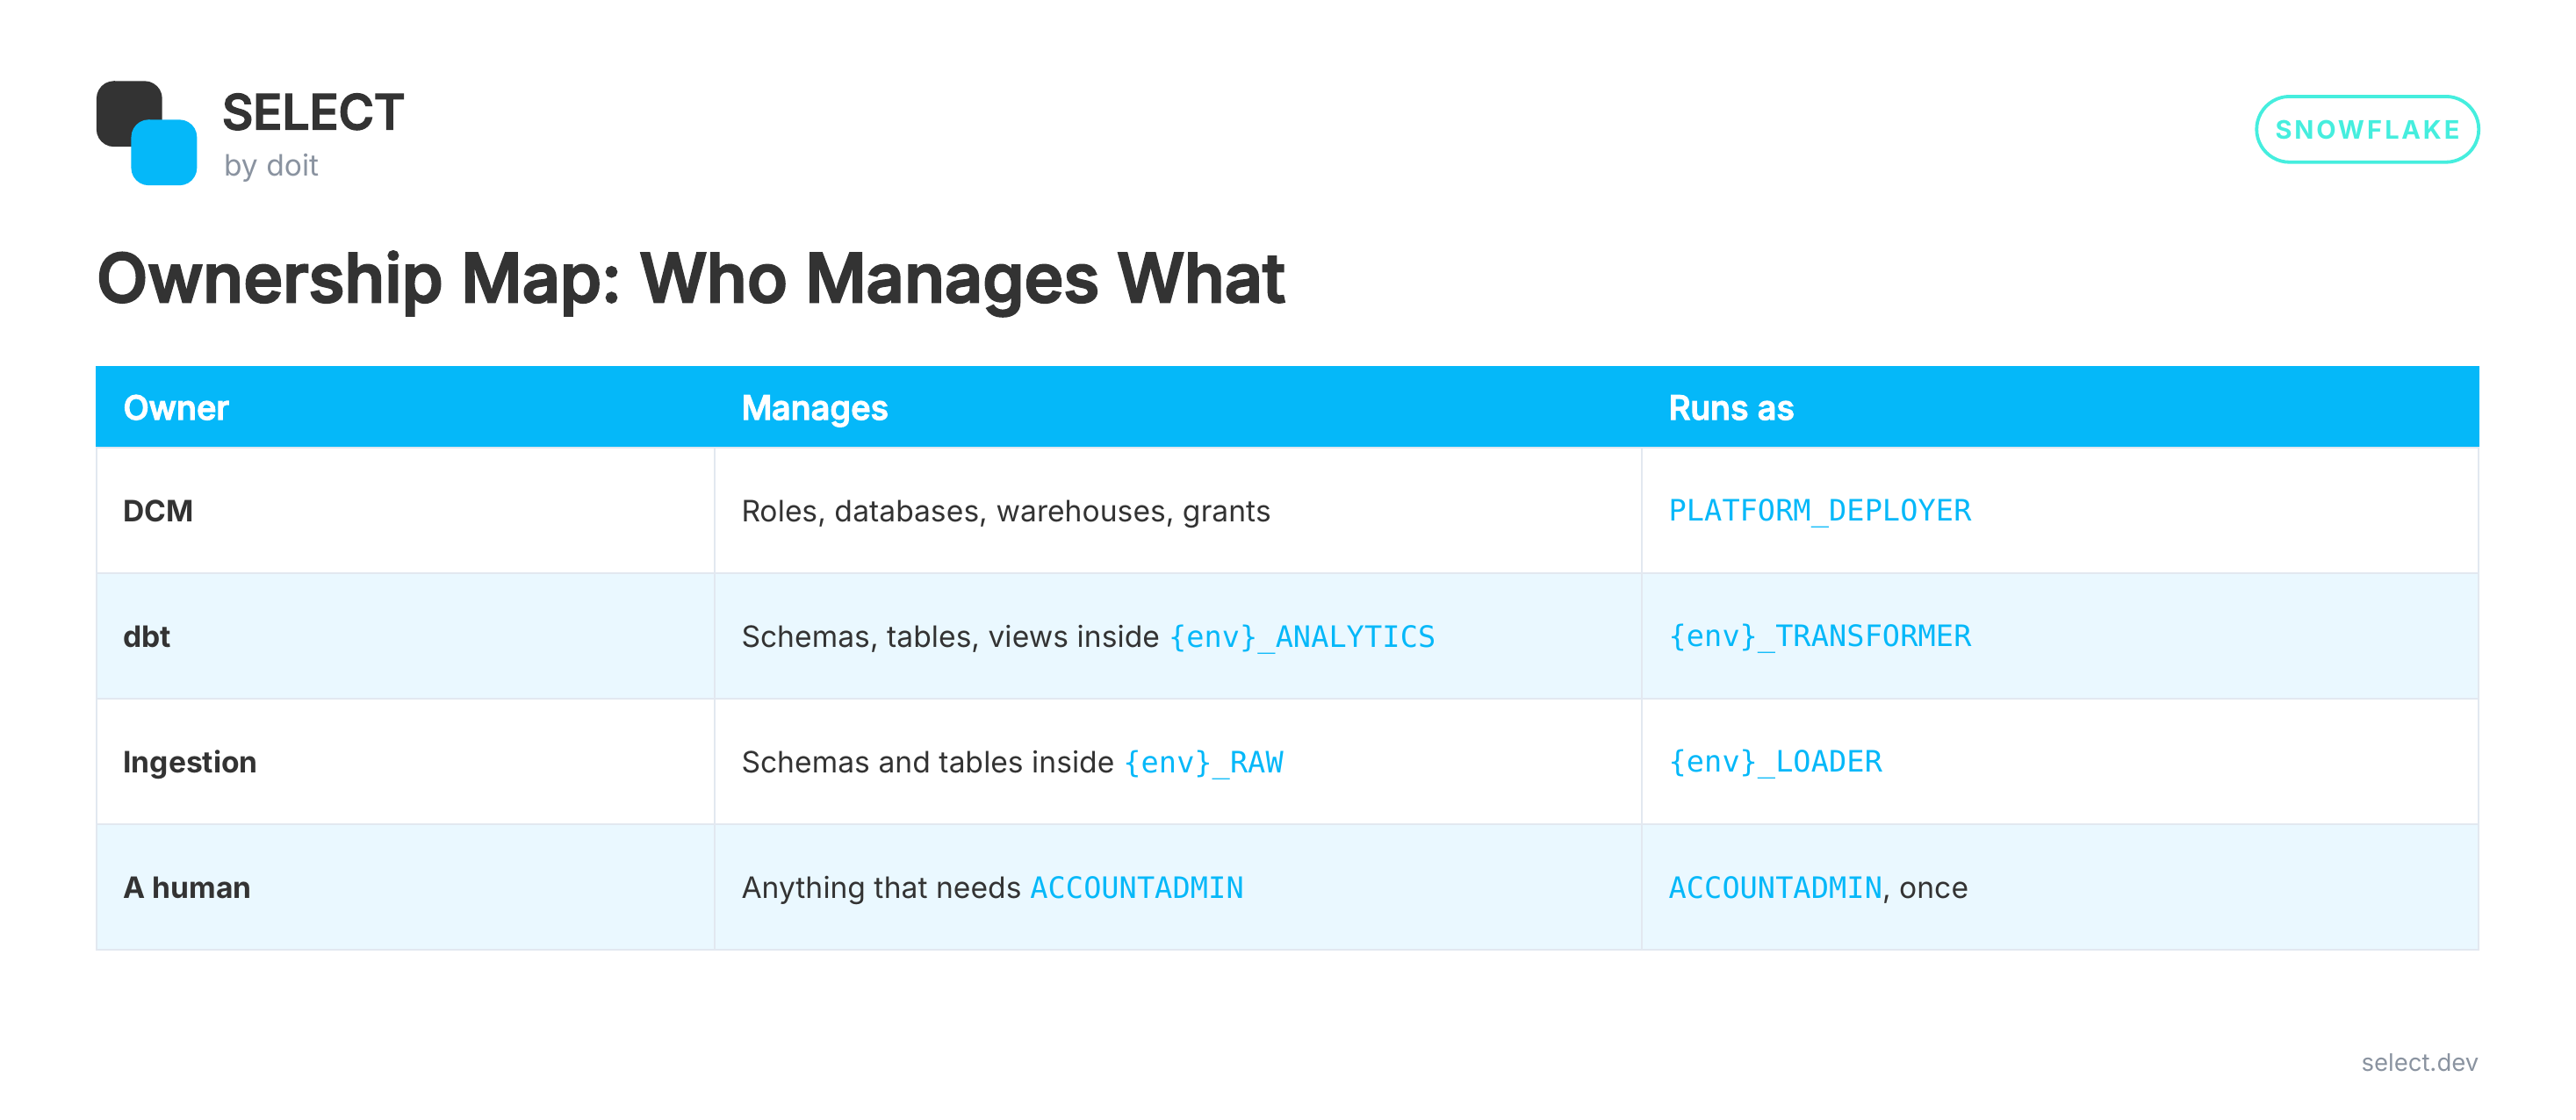
Aucun objet n'a deux propriétaires. Si vous n'utilisez pas dbt, ou si vous avez des objets qu'aucun outil de transformation ne gère (stages, file formats, network rules), DCM est un excellent endroit pour les héberger. La règle, c'est un propriétaire par objet, pas DCM ne gère que les rôles.
La poule et l'œuf : le bootstrap
DCM a besoin d'un rôle pour déployer et d'un objet projet dans lequel déployer. Quelque chose doit les créer, et ce quelque chose a besoin d'ACCOUNTADMIN.
Ma règle pour l'ensemble du repo :
La CI/CD ne doit jamais avoir besoin d'
ACCOUNTADMIN.
Tout ce qui en a besoin va donc dans un fichier SQL numéroté qu'un humain exécute exactement une fois :
USE ROLE ACCOUNTADMIN;
ALTER ACCOUNT SET FEATURE_RBAC_INHERITED_GRANTS = 'ENABLED';
CREATE ROLE IF NOT EXISTS PLATFORM_DEPLOYER  COMMENT = 'CI/CD deployment role for DCM.';
GRANT CREATE ROLE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT CREATE DATABASE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT CREATE WAREHOUSE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT MANAGE GRANTS ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT ROLE PLATFORM_DEPLOYER TO ROLE SYSADMIN;
CREATE DATABASE IF NOT EXISTS PLATFORM;CREATE SCHEMA IF NOT EXISTS PLATFORM.DCM;
Afficher le code
(Légèrement raccourci. Le fichier complet est dans le repo.)
Ensuite, PLATFORM_DEPLOYER fait tout. Et voici une habitude que j'adore : passez --role PLATFORM_DEPLOYER en local aussi. Si un changement a secrètement besoin de privilèges supplémentaires, il échoue sur votre laptop plutôt qu'en CI un vendredi après-midi.
Les pièges dans lesquels je suis tombé pour vous les épargner
Les inherited grants dans DCM sont marqués comme preview. La liste des objets DCM pris en charge par Snowflake signale les inherited grants et le MANAGE GRANTS au niveau conteneur comme des fonctionnalités en preview. Ils ont bien fonctionné pour moi, mais vérifiez la documentation avant de miser vos accès de production dessus.
Ne mettez pas le deployer à la porte. Quand DCM transfère la propriété de DEV_RAW à DEV_LOADER, PLATFORM_DEPLOYER n'en est plus propriétaire. Au déploiement suivant, DCM ne peut pas gérer ce qu'il ne peut pas atteindre. La correction tient en une ligne par rôle :
GRANT ROLE {{ env }}_LOADER TO ROLE PLATFORM_DEPLOYER;GRANT ROLE {{ env }}_TRANSFORMER TO ROLE PLATFORM_DEPLOYER;account_identifier dans le manifest n'interprète pas les variables d'environnement. Écrivez l'identifiant en dur. C'est ce qui permet à DCM de vous avertir quand vous êtes sur le point de déployer sur le mauvais compte — et si vous êtes consultant et jonglez entre les comptes clients, c'est une fonctionnalité dont vous ne voudrez plus vous passer.
Pas de secrets dans les templates. Snowflake le dit sans détour : les variables de templating ne sont pas faites pour les identifiants.
CI/CD avec GitHub Actions
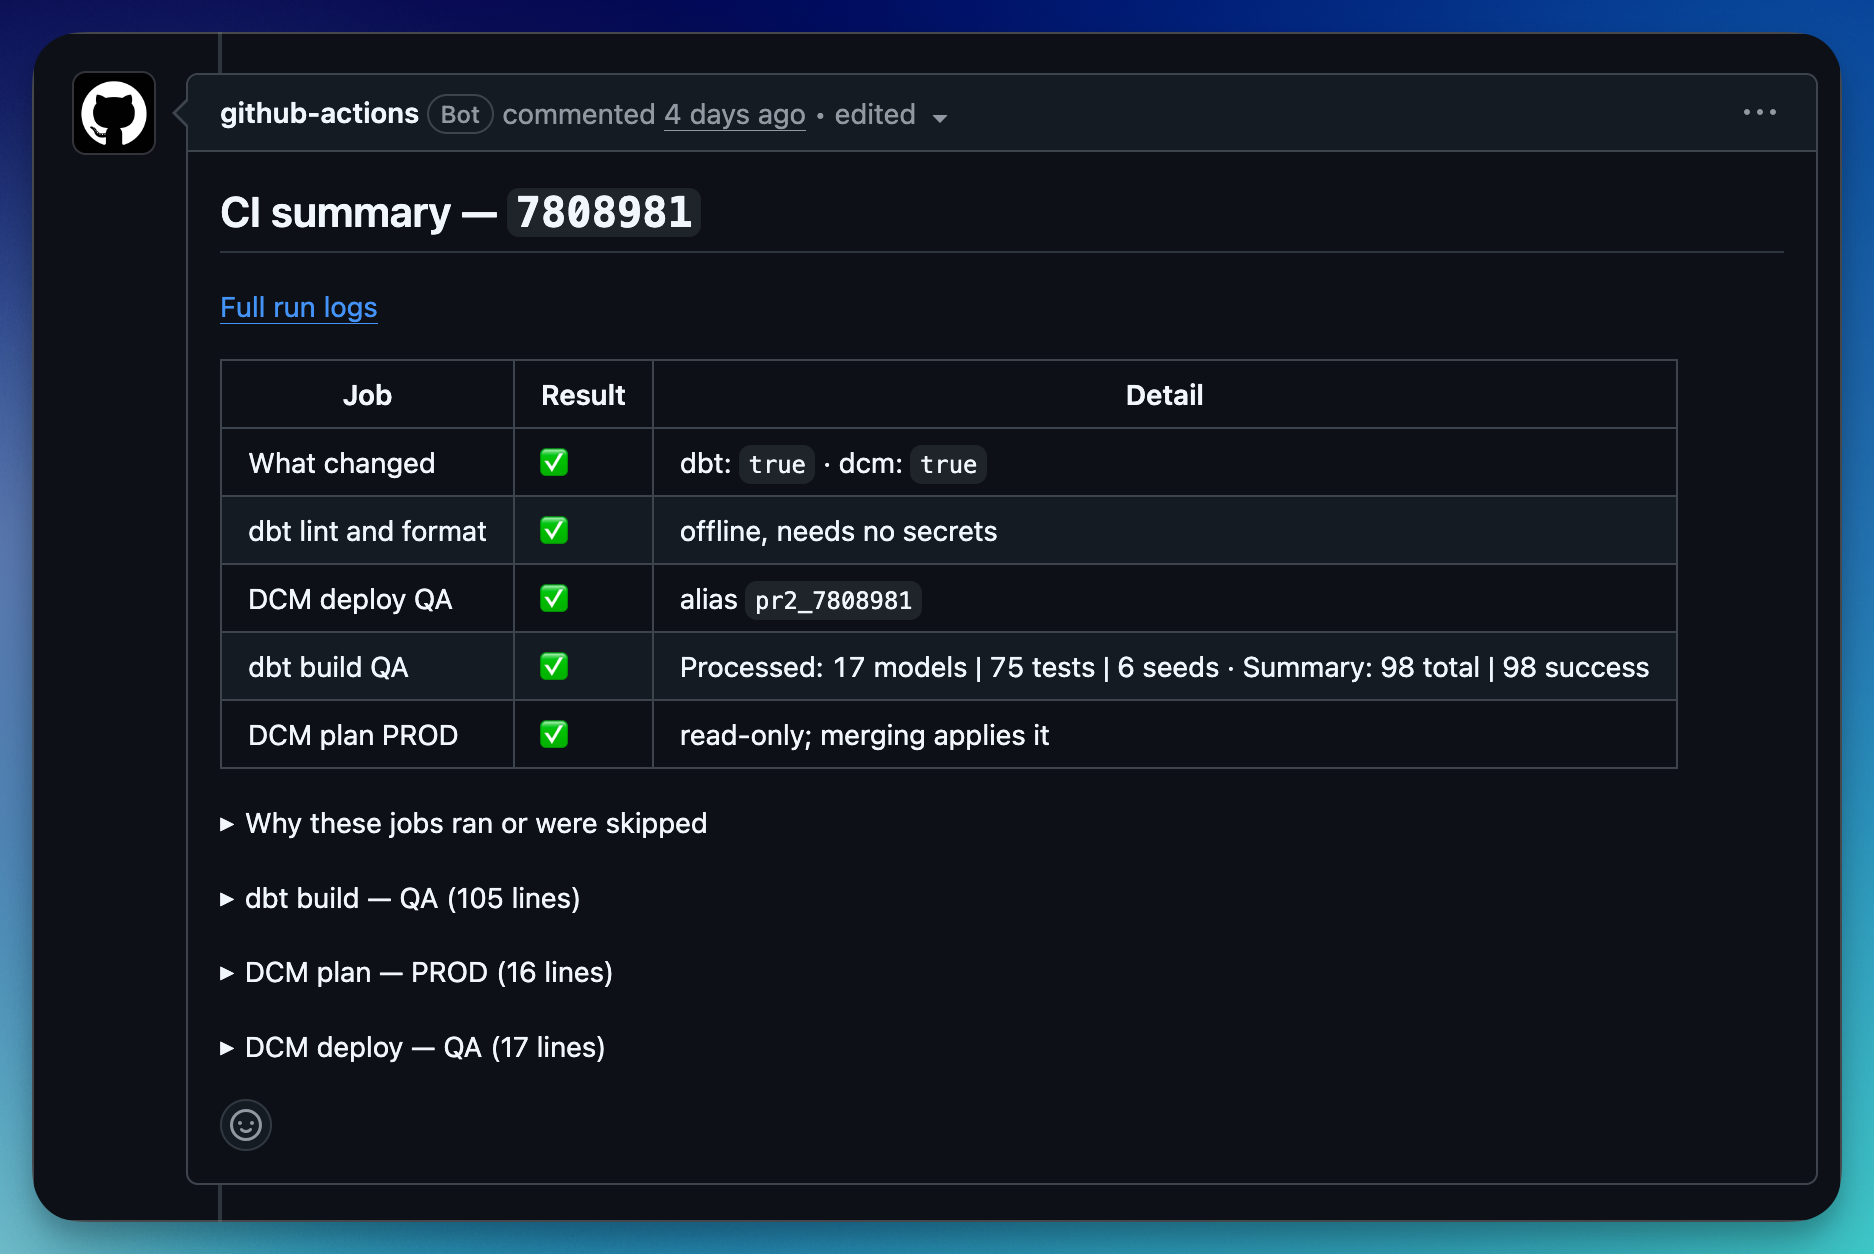
C'est ici que tout se rejoint. Deux workflows :
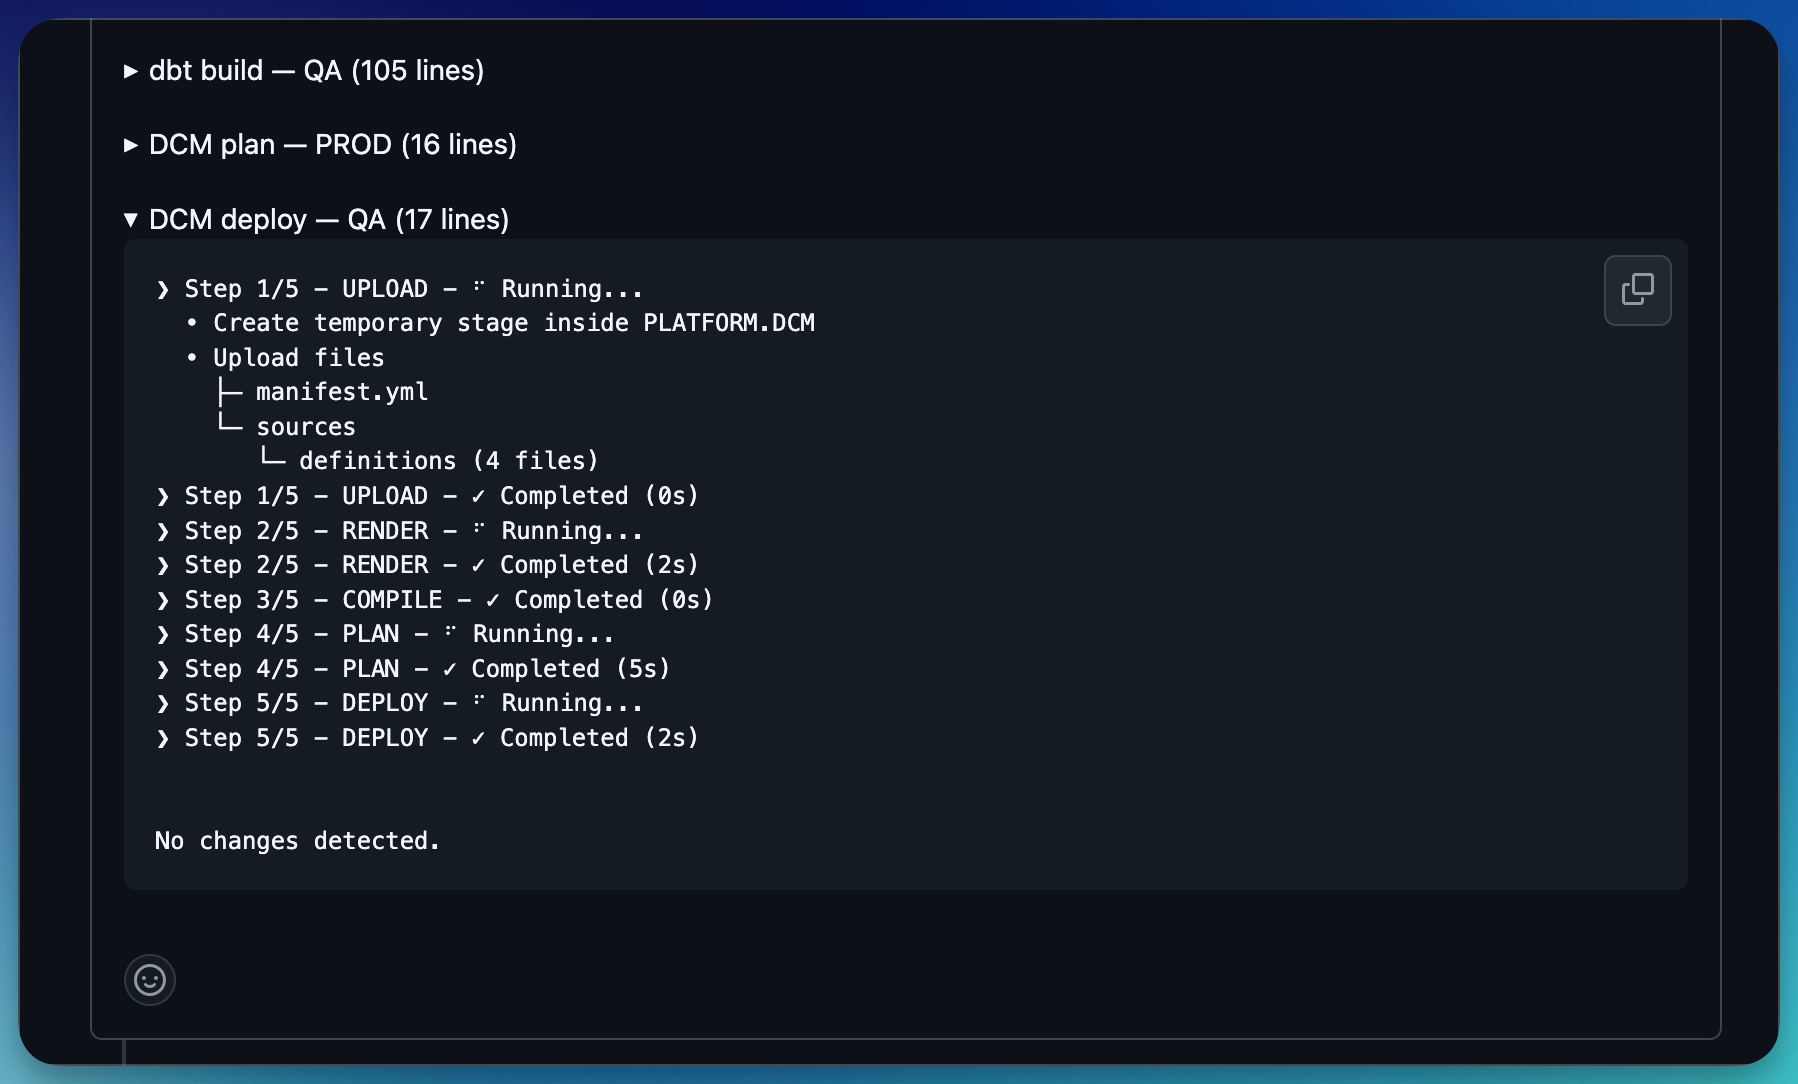
Sur une pull request :
- Plan et déploiement vers
QA. - Plan de
PRODet publication du plan en commentaire de la PR.
Au merge sur main :
- Plan et déploiement de
DEV, puisQA, puisPROD, dans cet ordre.
Le commentaire de PR est ma partie préférée. Les reviewers n'ont pas à croire sur parole qu'un changement est sûr. Ils voient exactement ce qui arrivera en production, y compris le moindre DROP, avant de cliquer sur merge. Et le job modifie son commentaire précédent au lieu d'en ajouter un nouveau : une PR avec dix pushes n'a toujours qu'un seul commentaire de plan.
[capture d'écran : plan PROD publié en commentaire de PR]
La CI s'authentifie en tant qu'utilisateur TYPE = SERVICE avec une authentification par paire de clés. Cet utilisateur détient PLATFORM_DEPLOYER et rien d'autre. Chaque déploiement est aliasé avec le commit (main_9fd3c1a), si bien que tout déploiement dans Snowflake remonte directement à un merge.
Les DCM Projects dans Snowsight
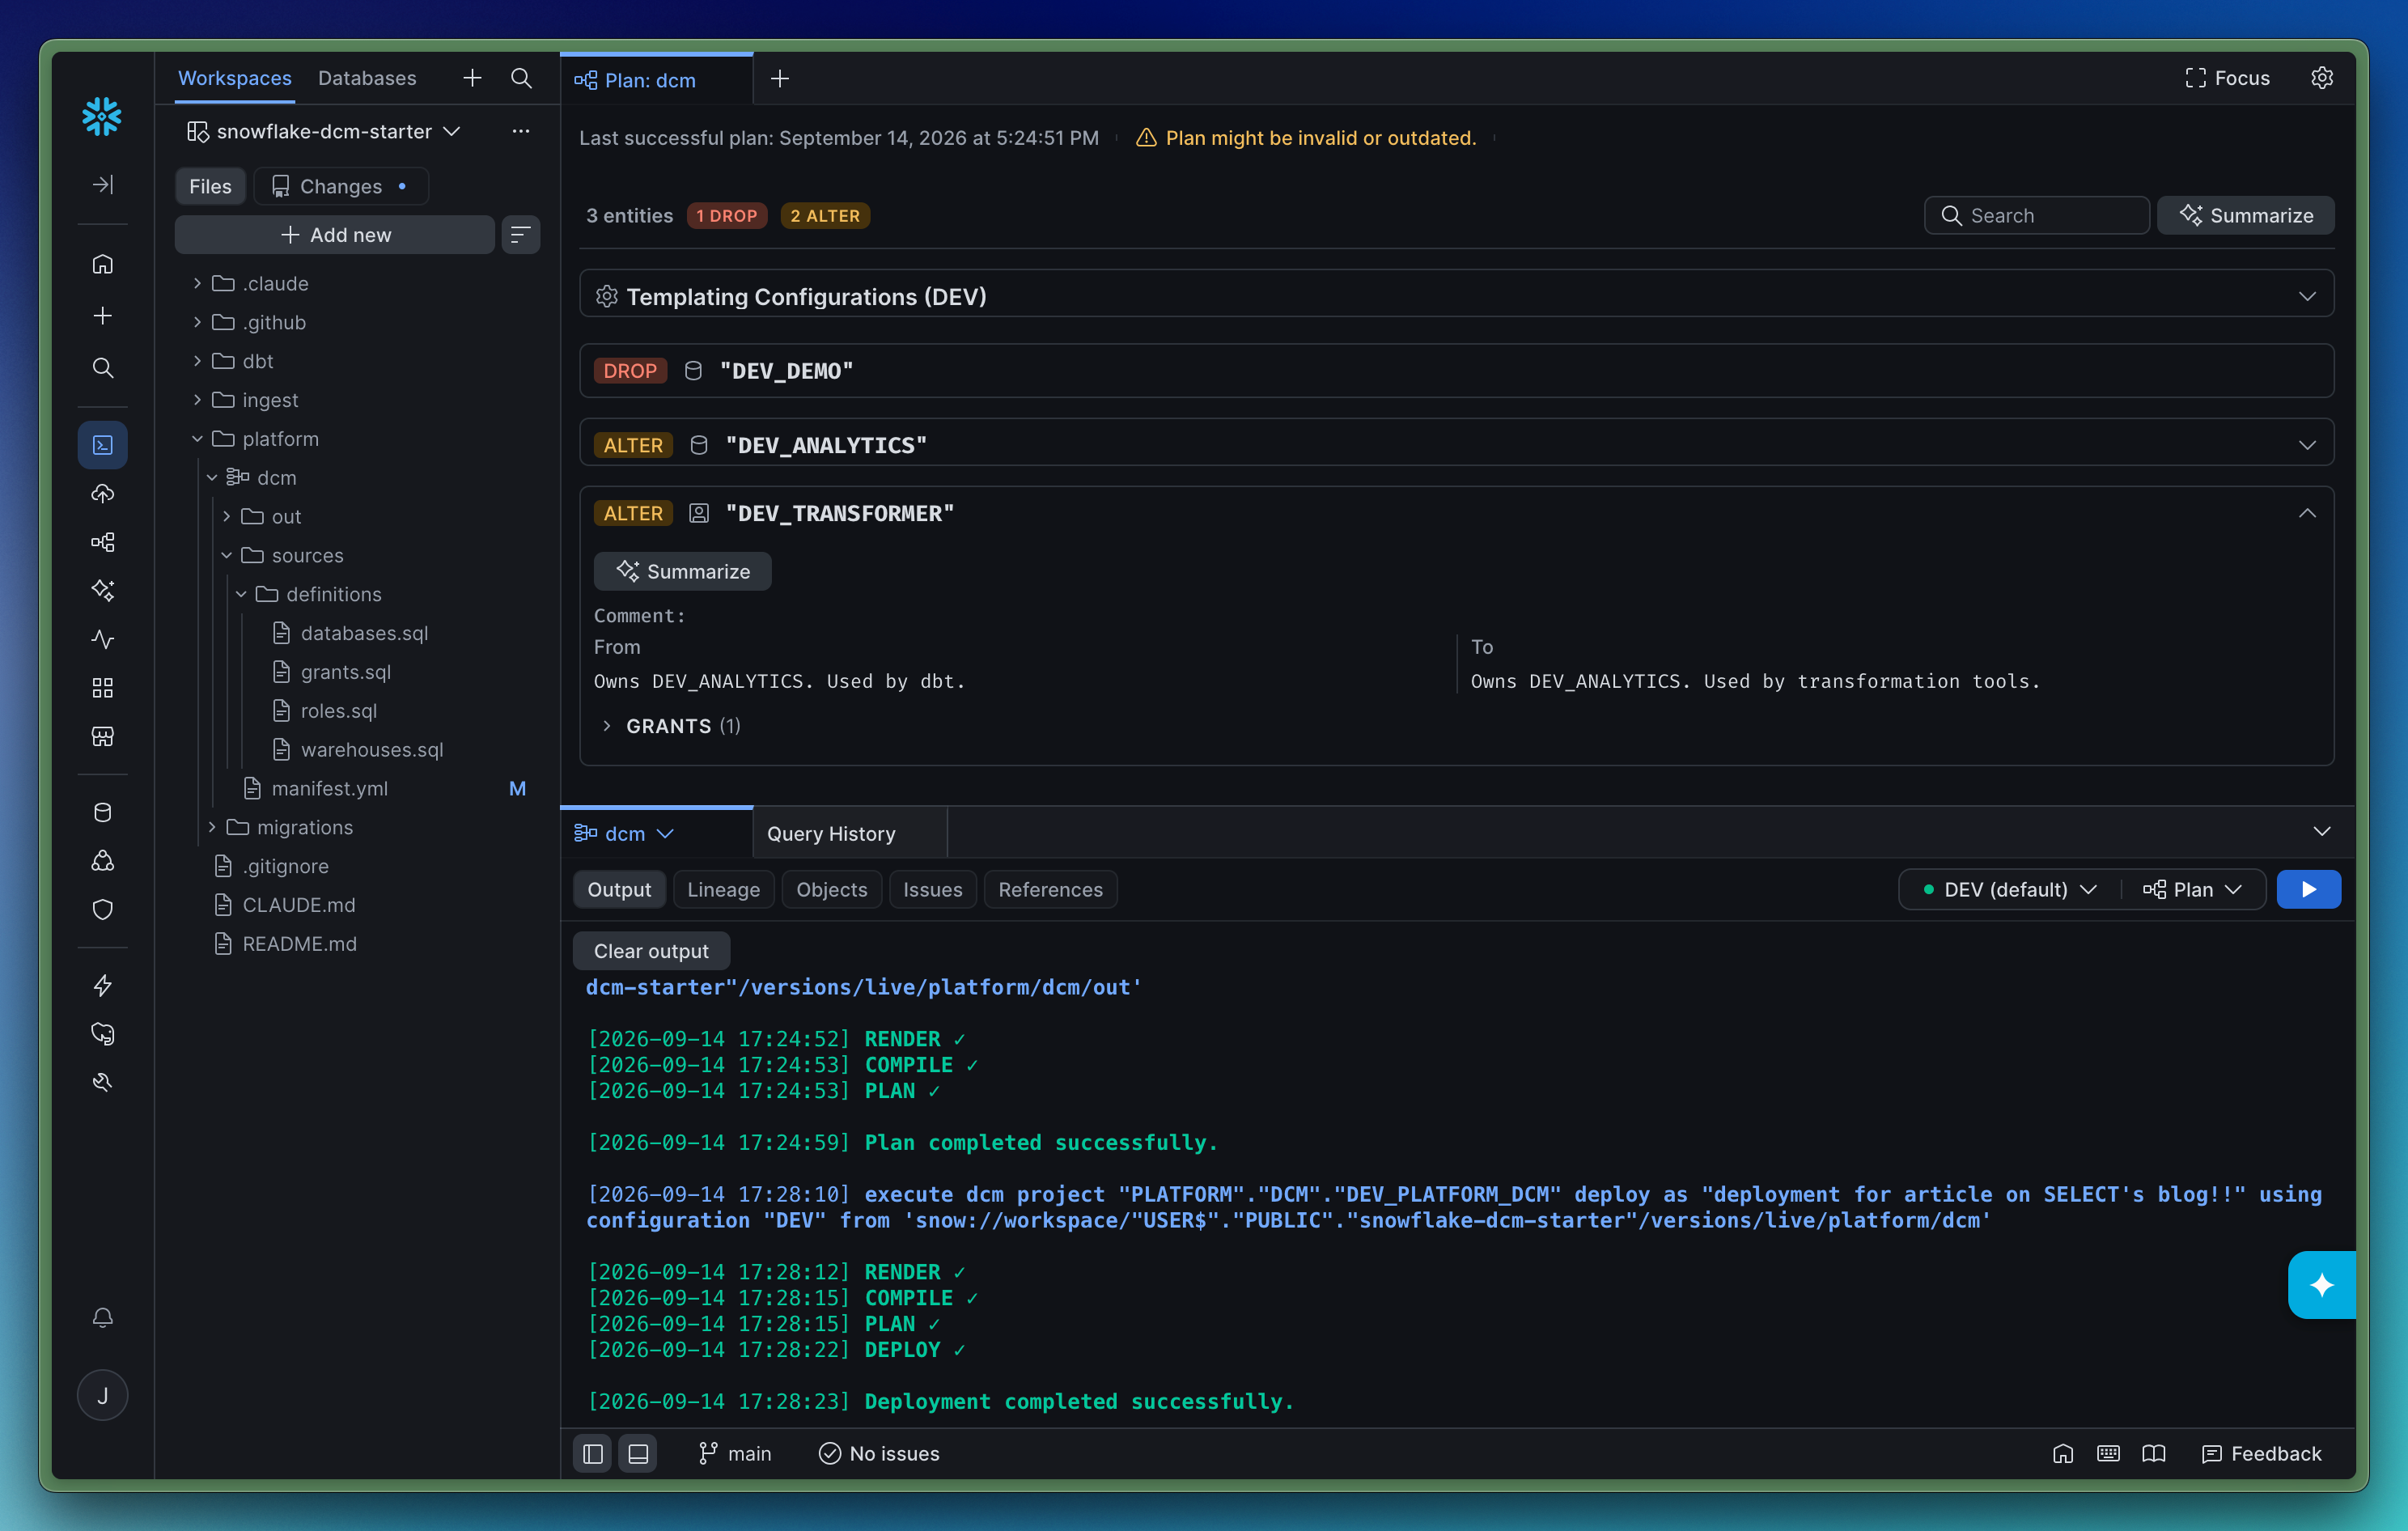
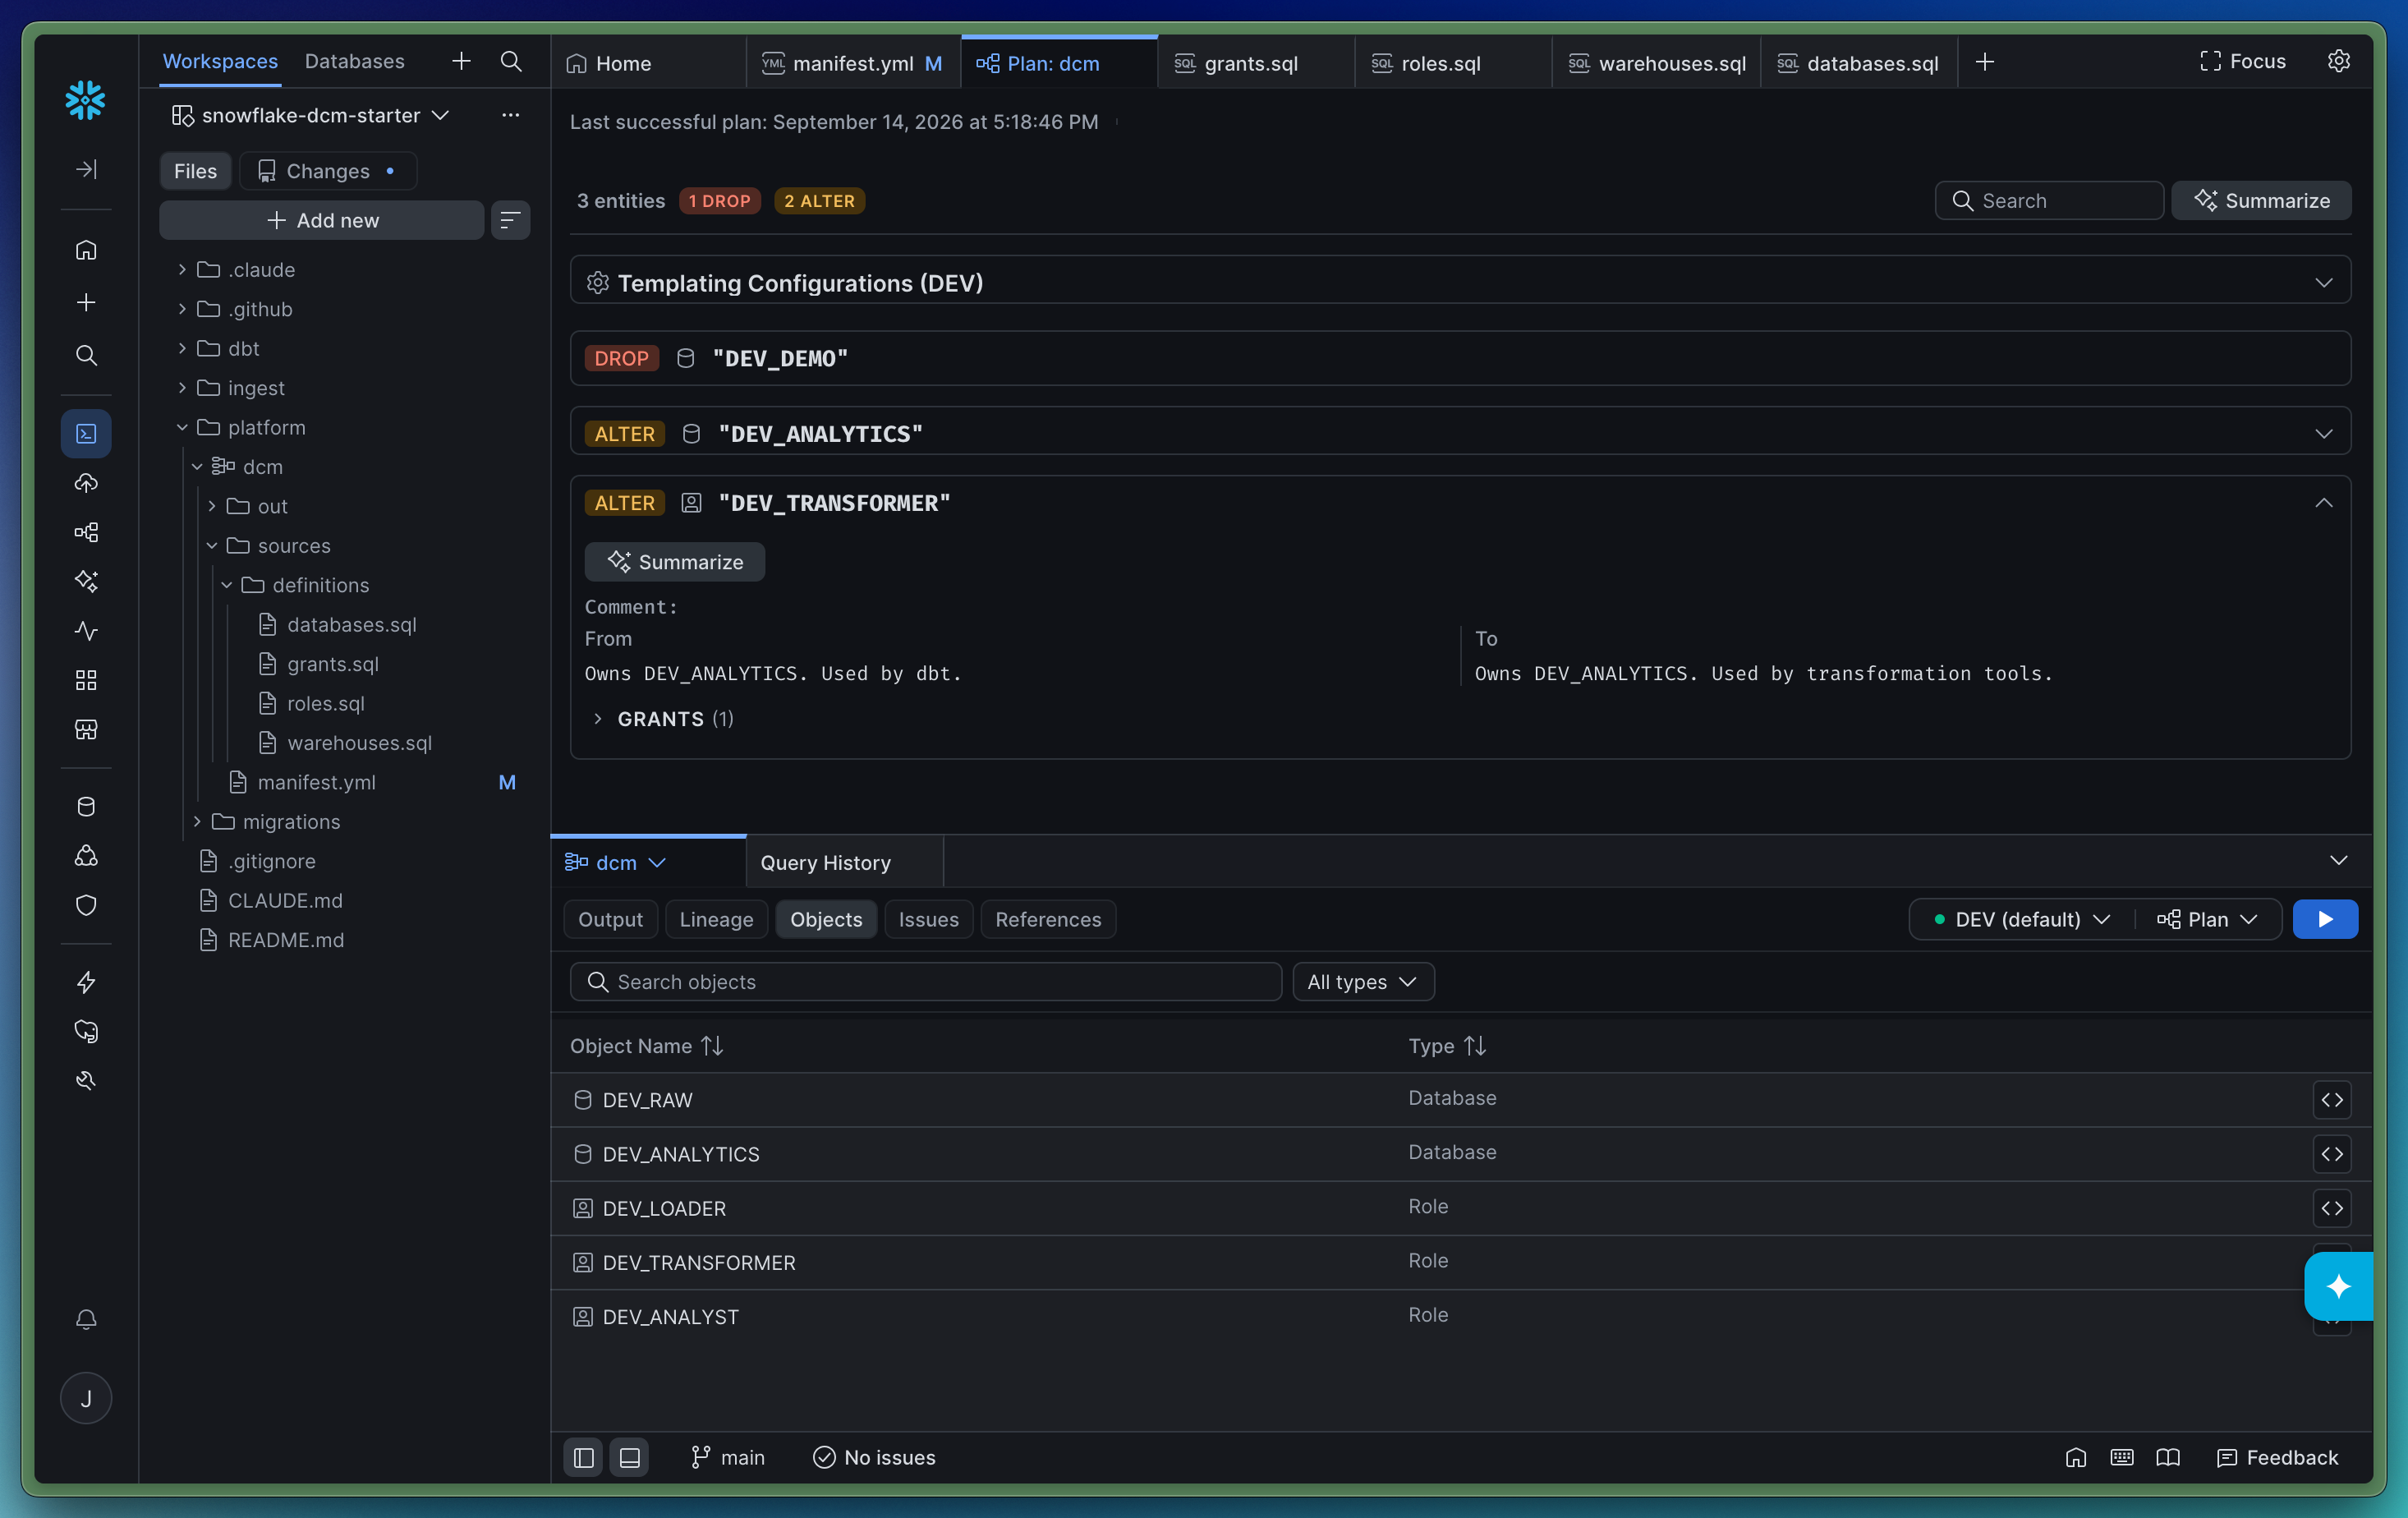
Les Workspaces de Snowflake offrent une interface vraiment réussie pour gérer, planifier et déployer les DCM projects. Sans entrer dans les détails, passons simplement en revue quelques captures d'écran.
Lancer un plan ouvre un onglet qui l'explique :
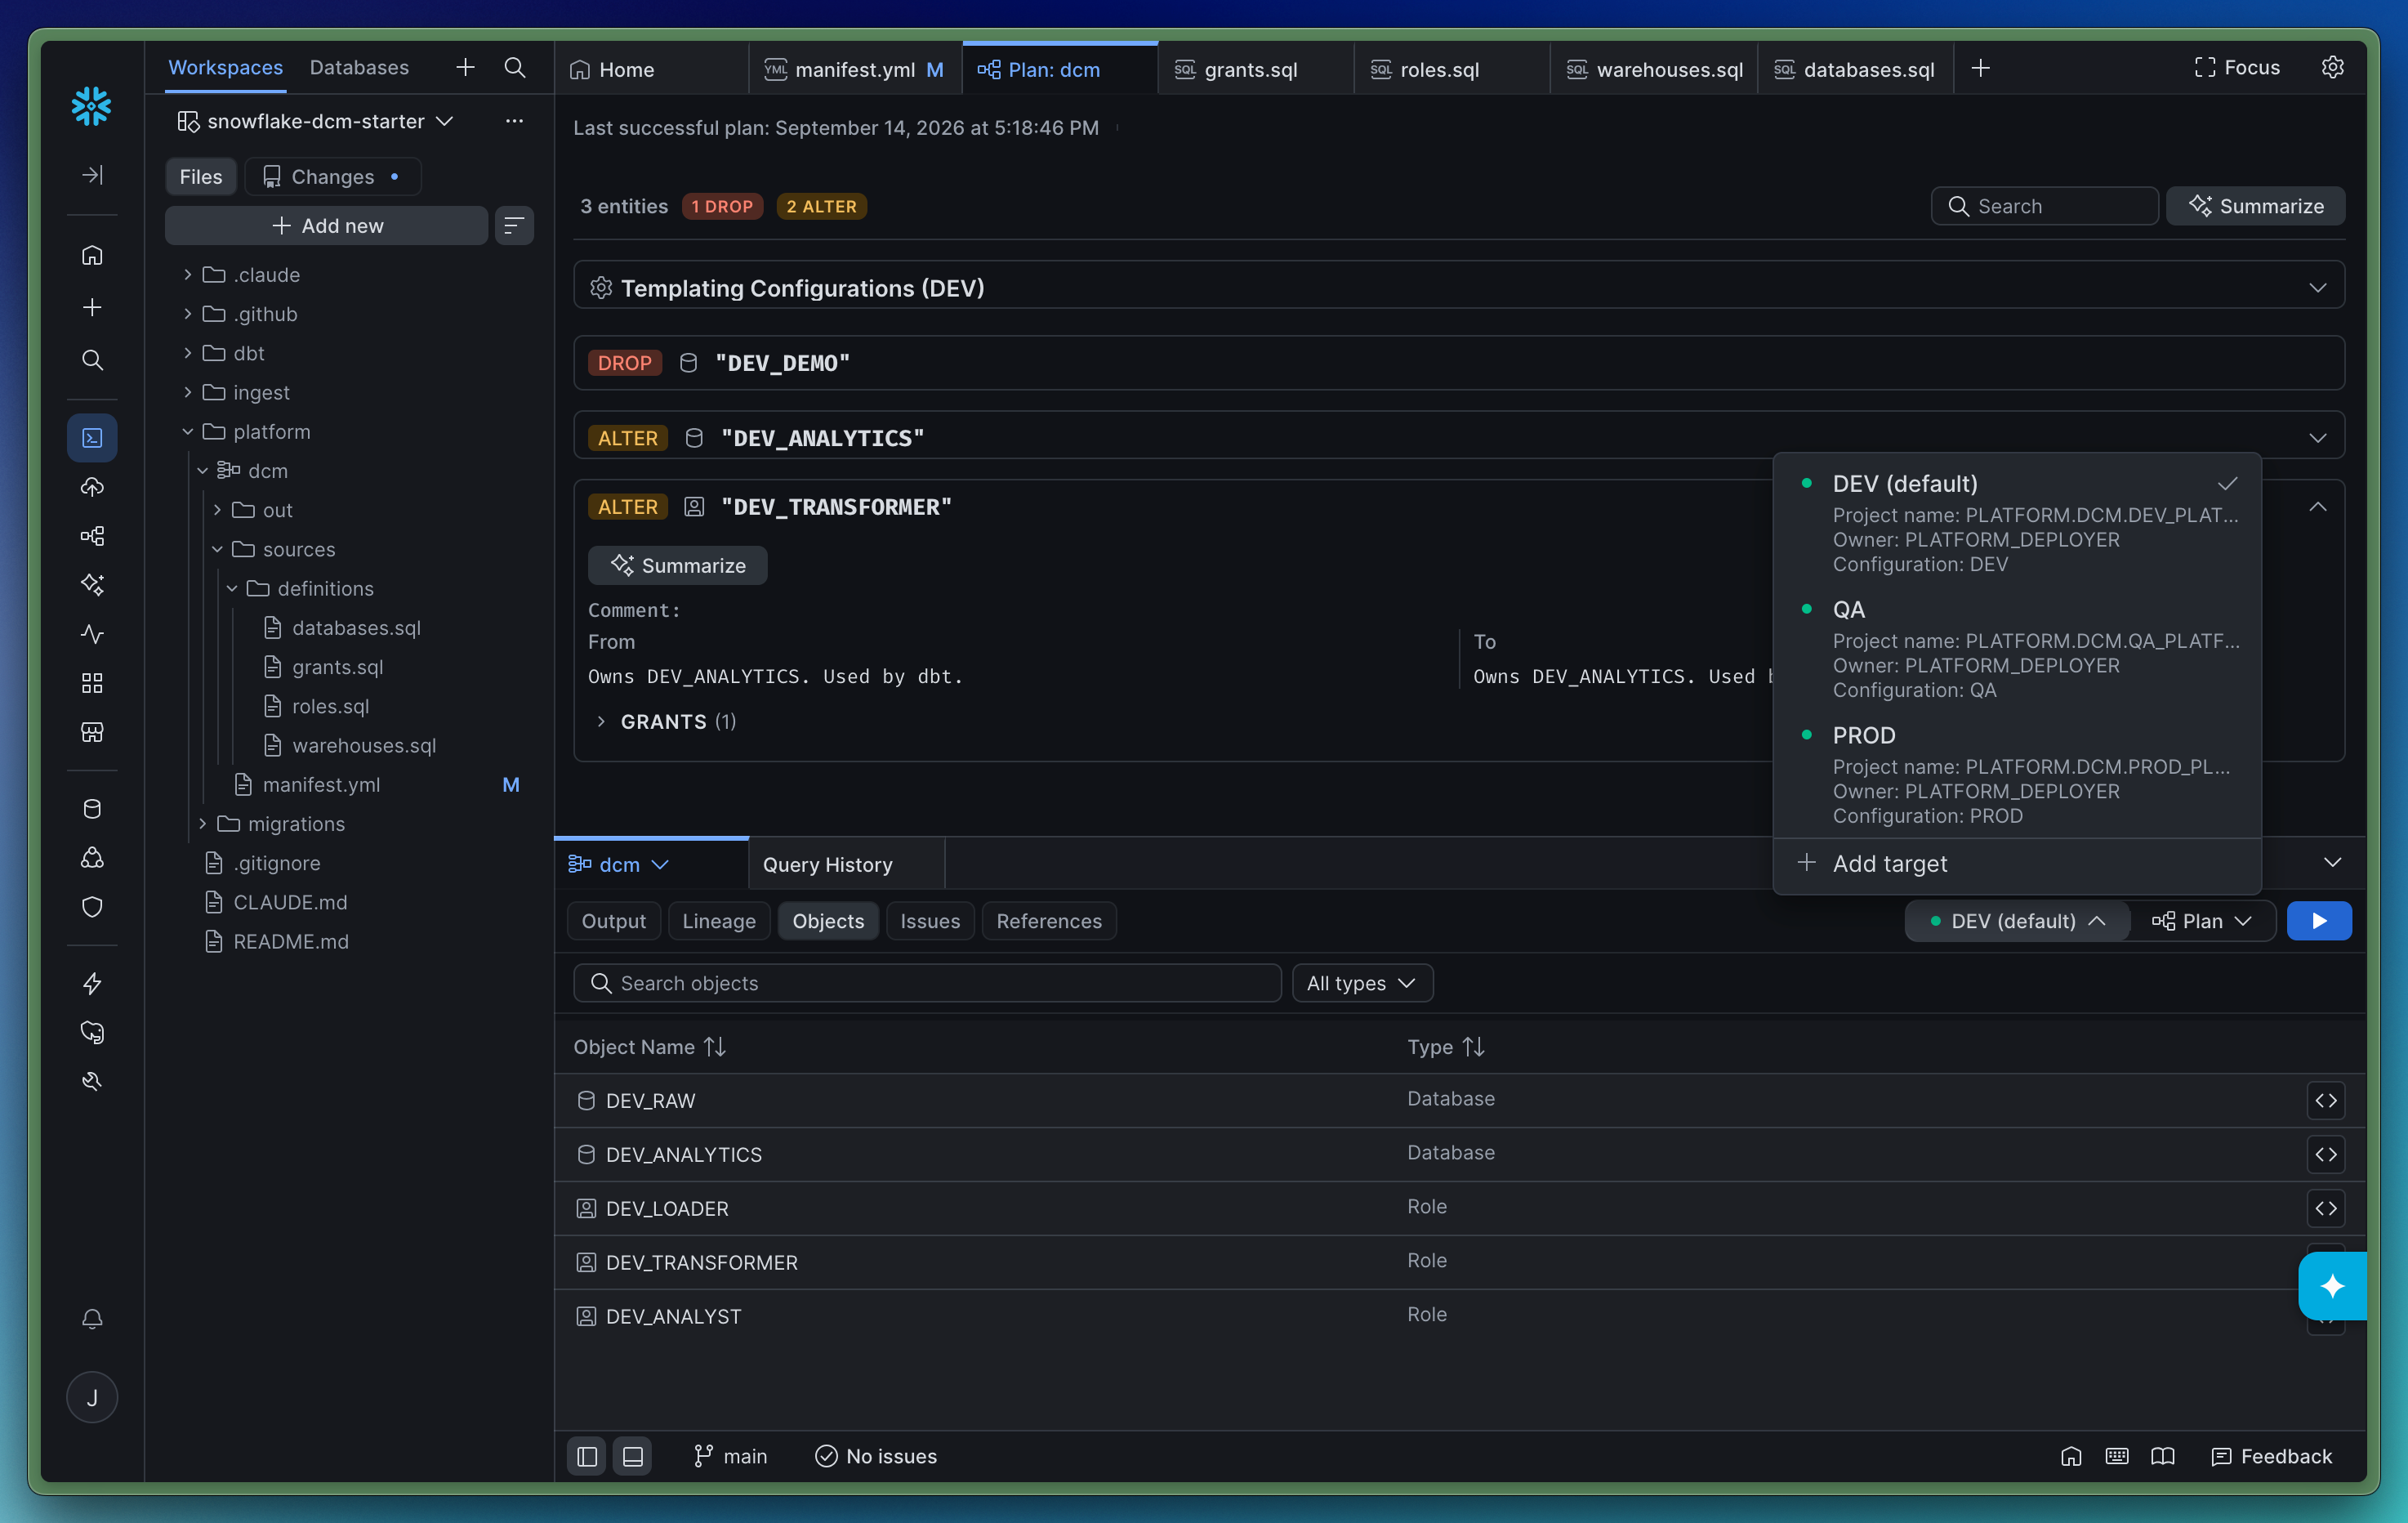
Vous pouvez changer d'environnement via le sélecteur :
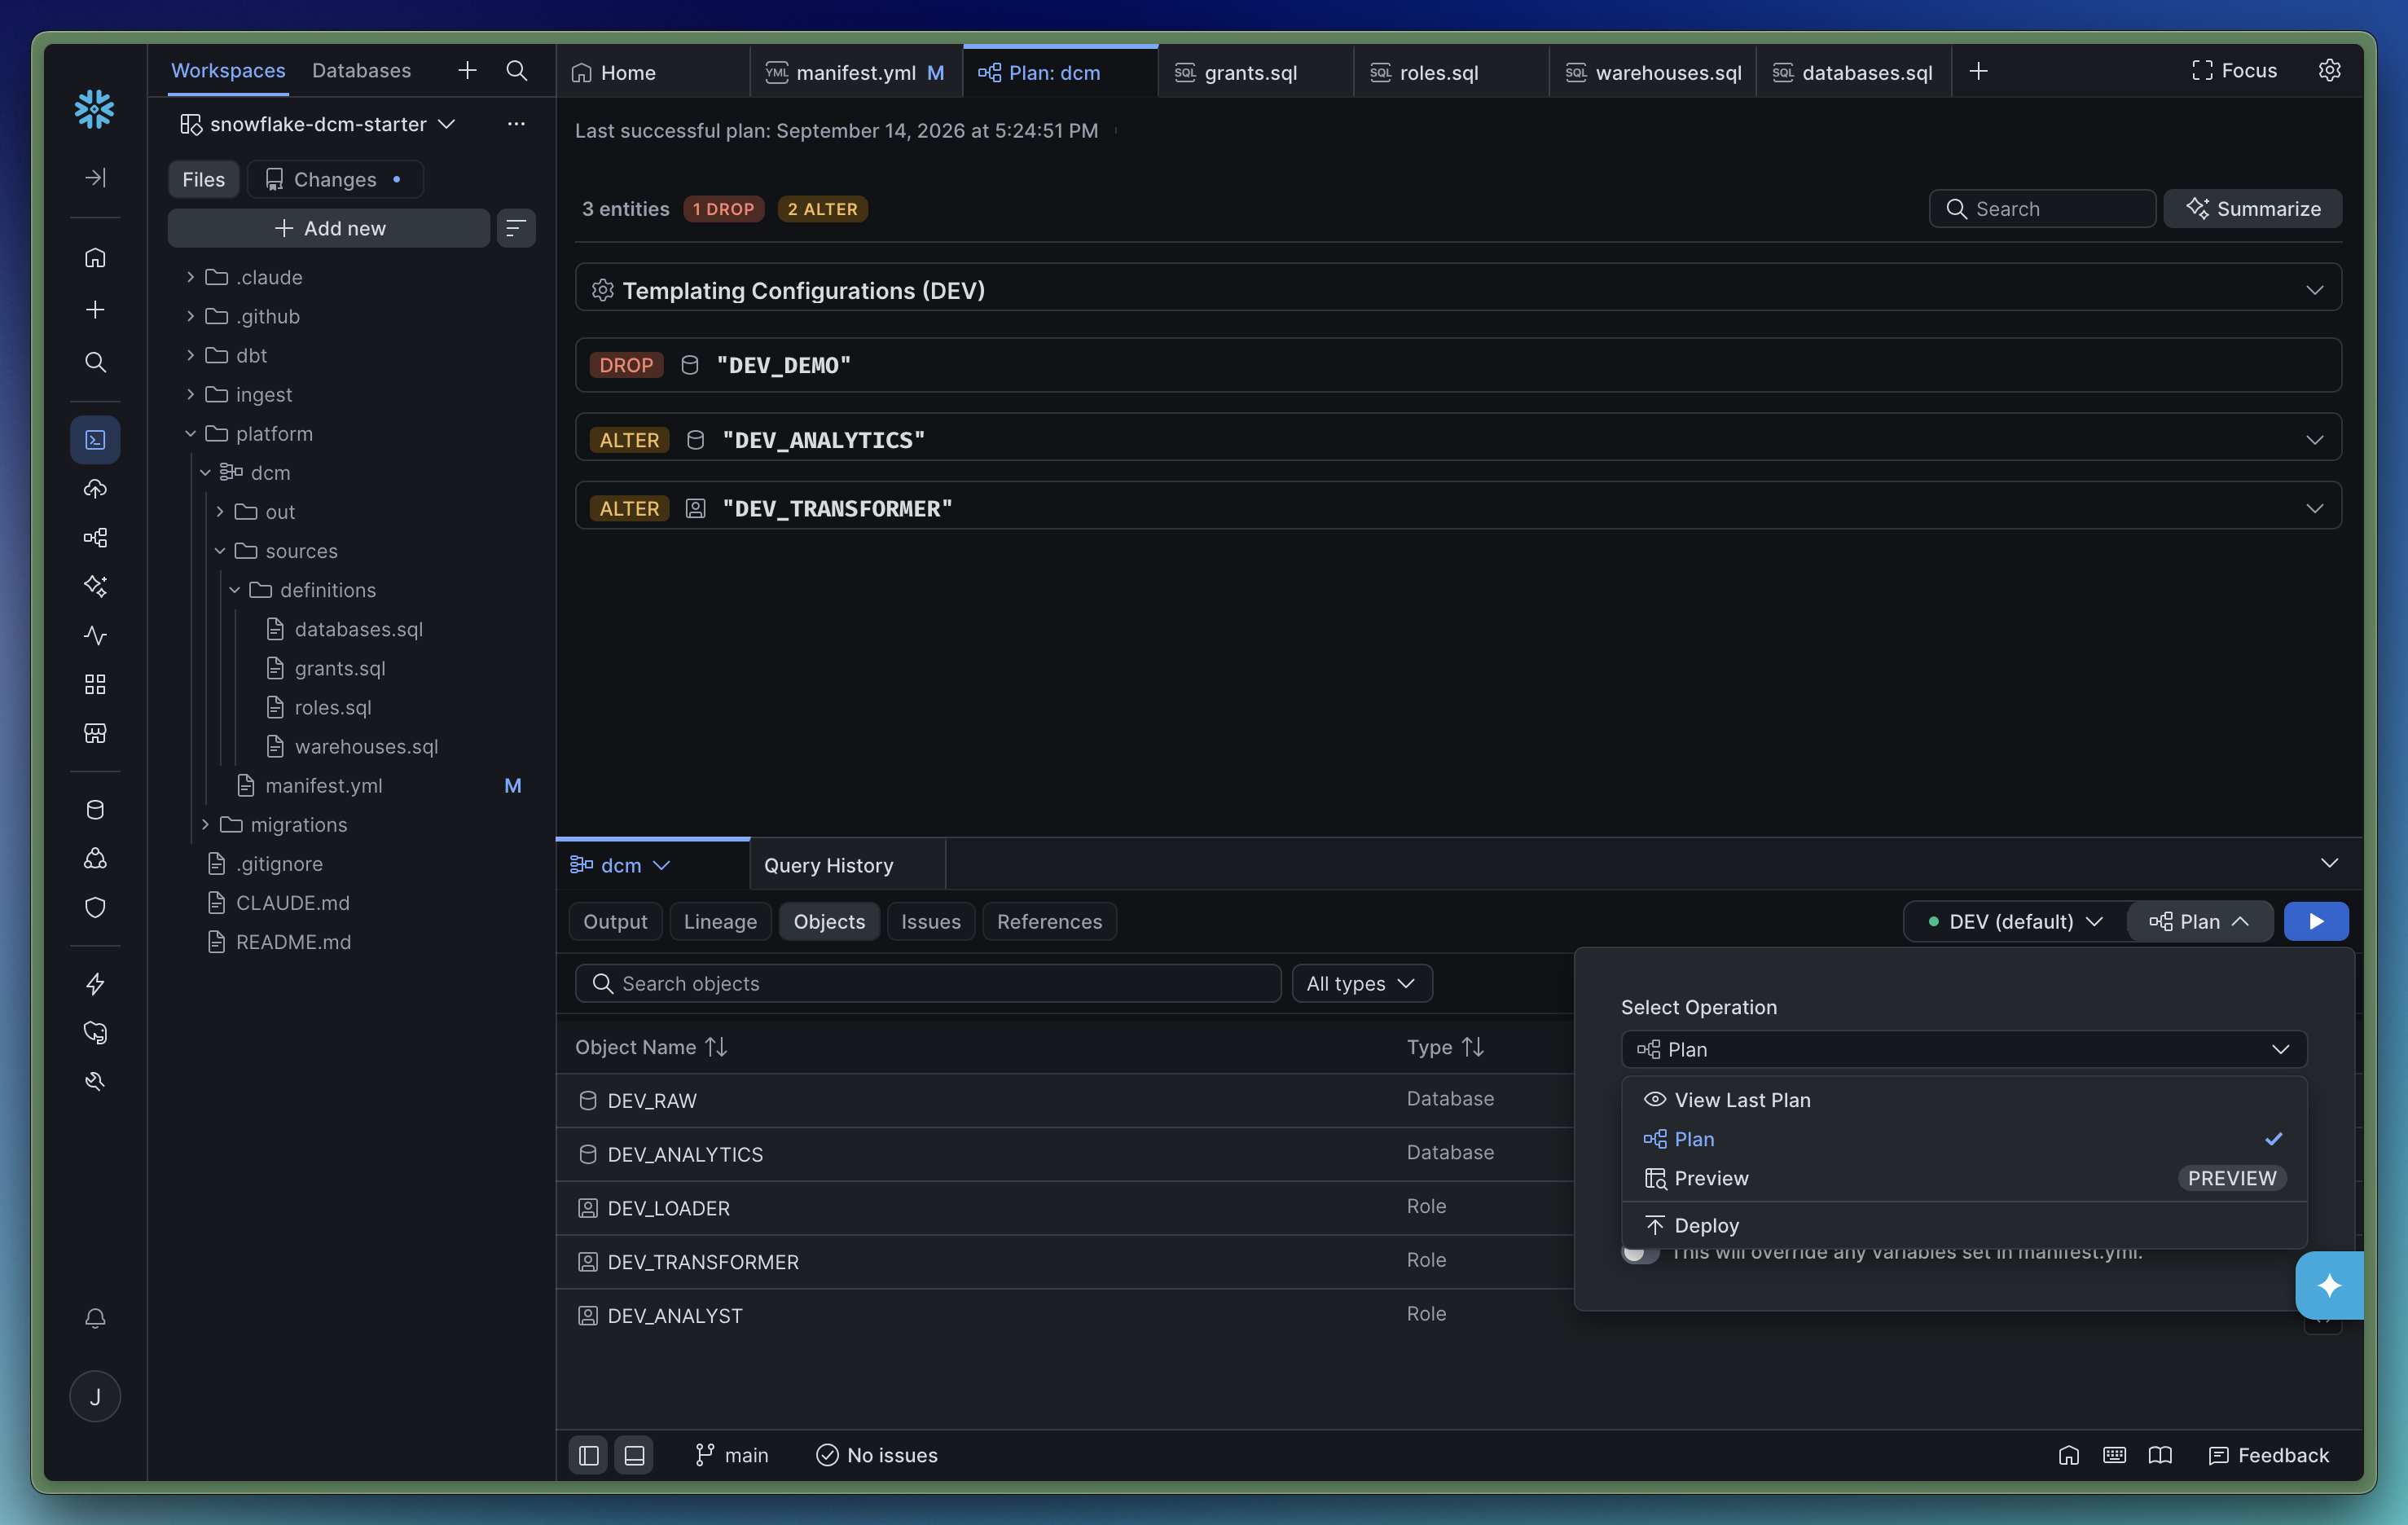
Quand vous êtes prêt à déployer, cliquez simplement sur le menu déroulant Plan et sélectionnez deploy :
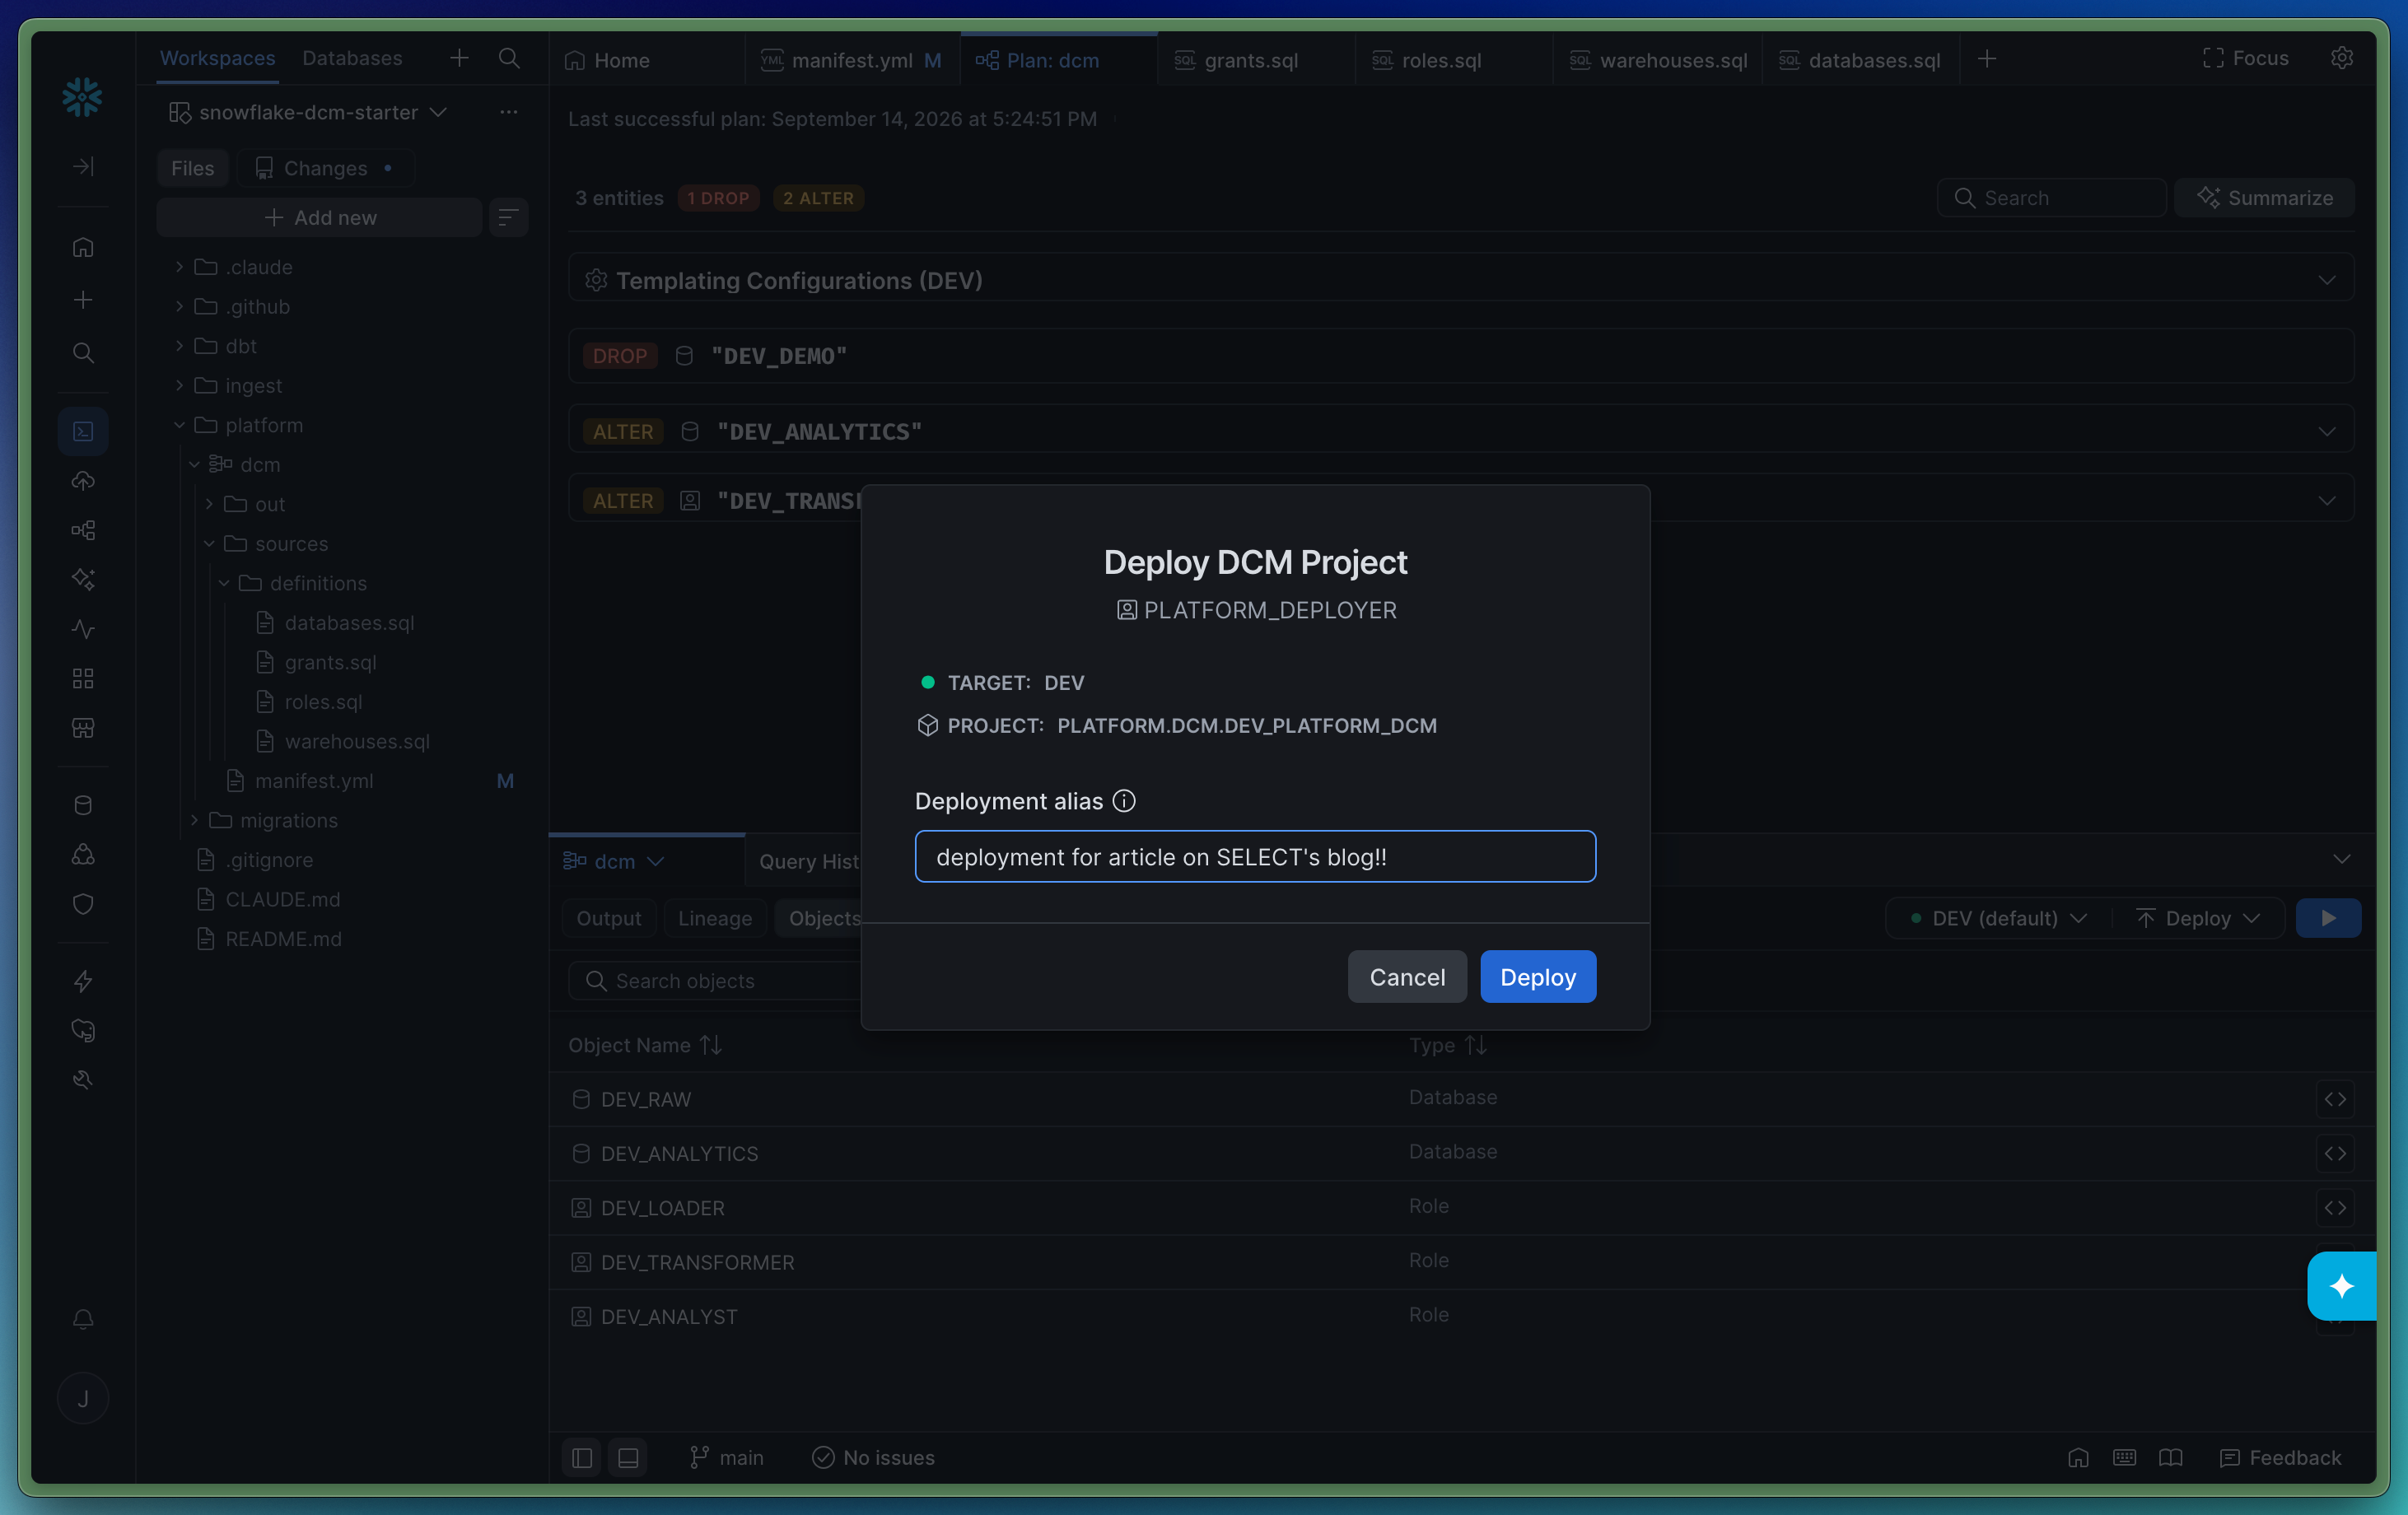
Une fois l'opération terminée, une notification apparaît en haut au centre de l'écran pour vous indiquer que le déploiement est effectué.
L'onglet Output affiche la sortie CLI de toutes vos exécutions :

Si nous avions un DAG de Dynamic Tables ou de Tasks, il apparaîtrait dans l'onglet lineage, mais ce projet n'en contient pas.
Exécuter DCM en local avec la CLI
Personnellement, je fais tout mon travail dans Visual Studio Code. Voici un aperçu rapide de ce à quoi ressemble un déploiement dans VS Code. dcm est une sous-commande de la commande CLI snow. Donc tant que la CLI snow est installée, vous avez déjà DCM ! Ici, je montre snow dcm plan et snow dcm deploy dans une seule capture d'écran.
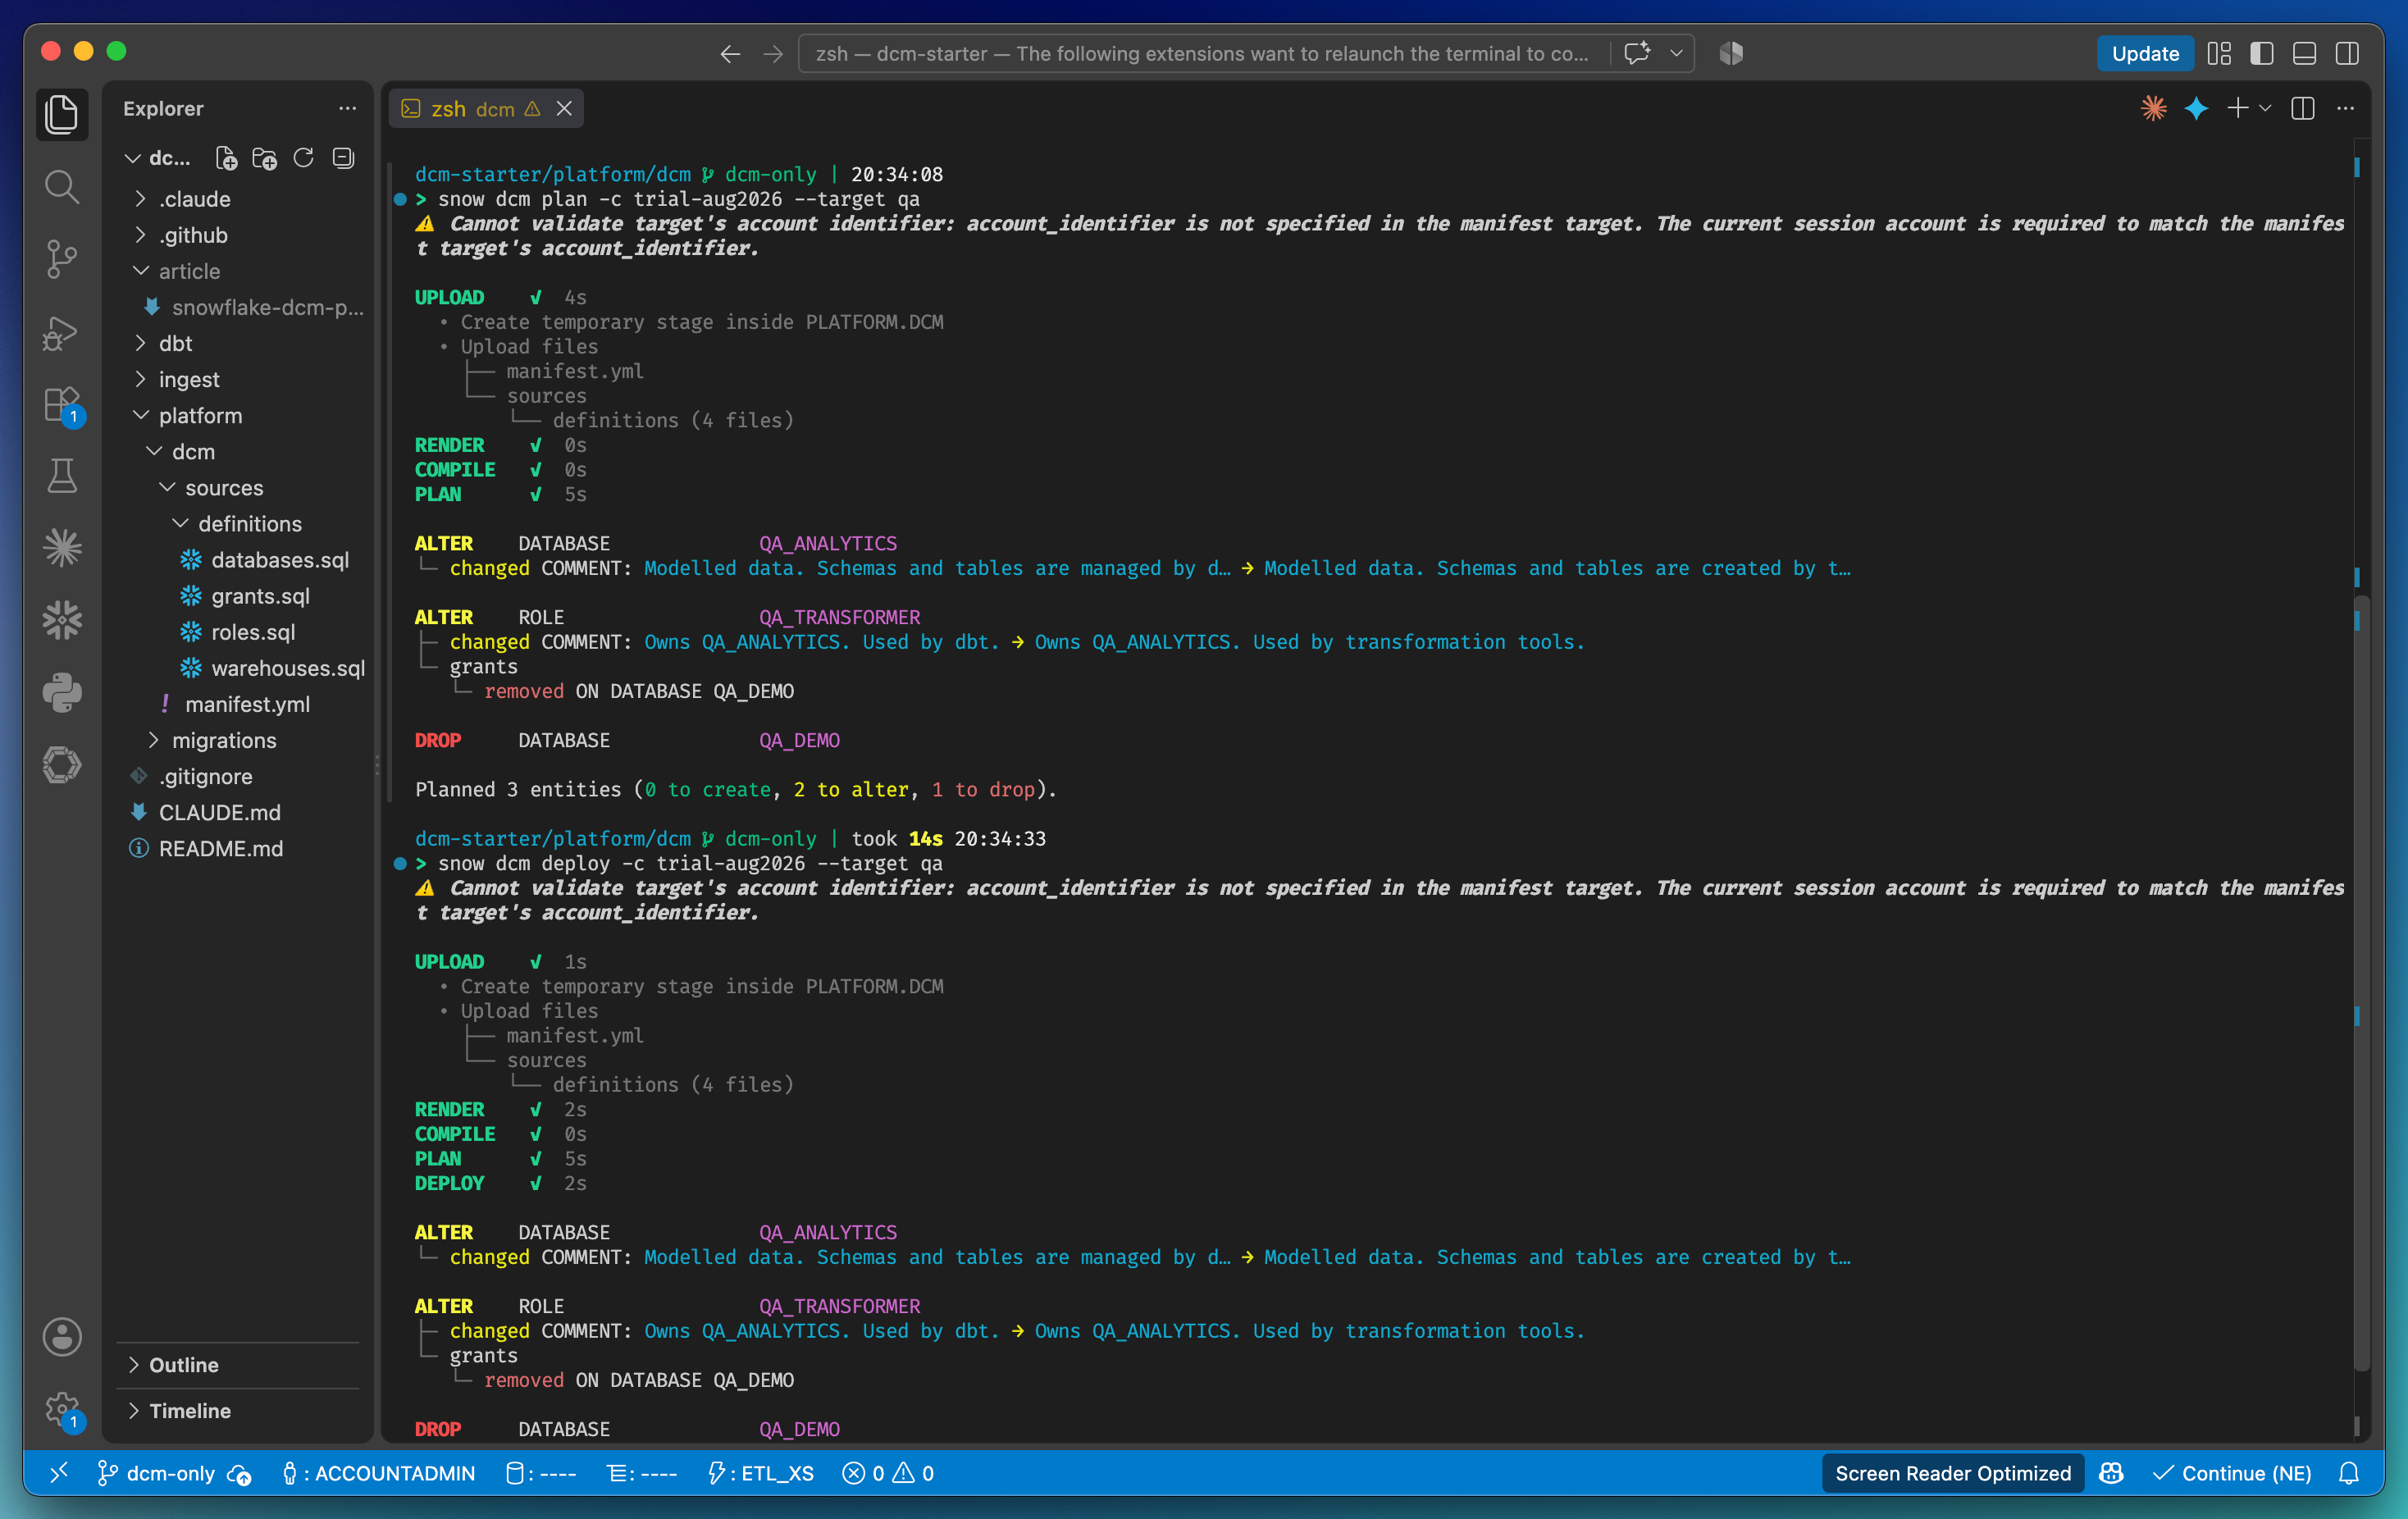
Je peux désormais itérer sur les fichiers en local, déployer dans mon environnement de dev, ouvrir une PR qui planifiera et déploiera QA, puis exécutera le plan sur la prod. Un workflow très agréable pour les développeurs !
DCM face aux alternatives
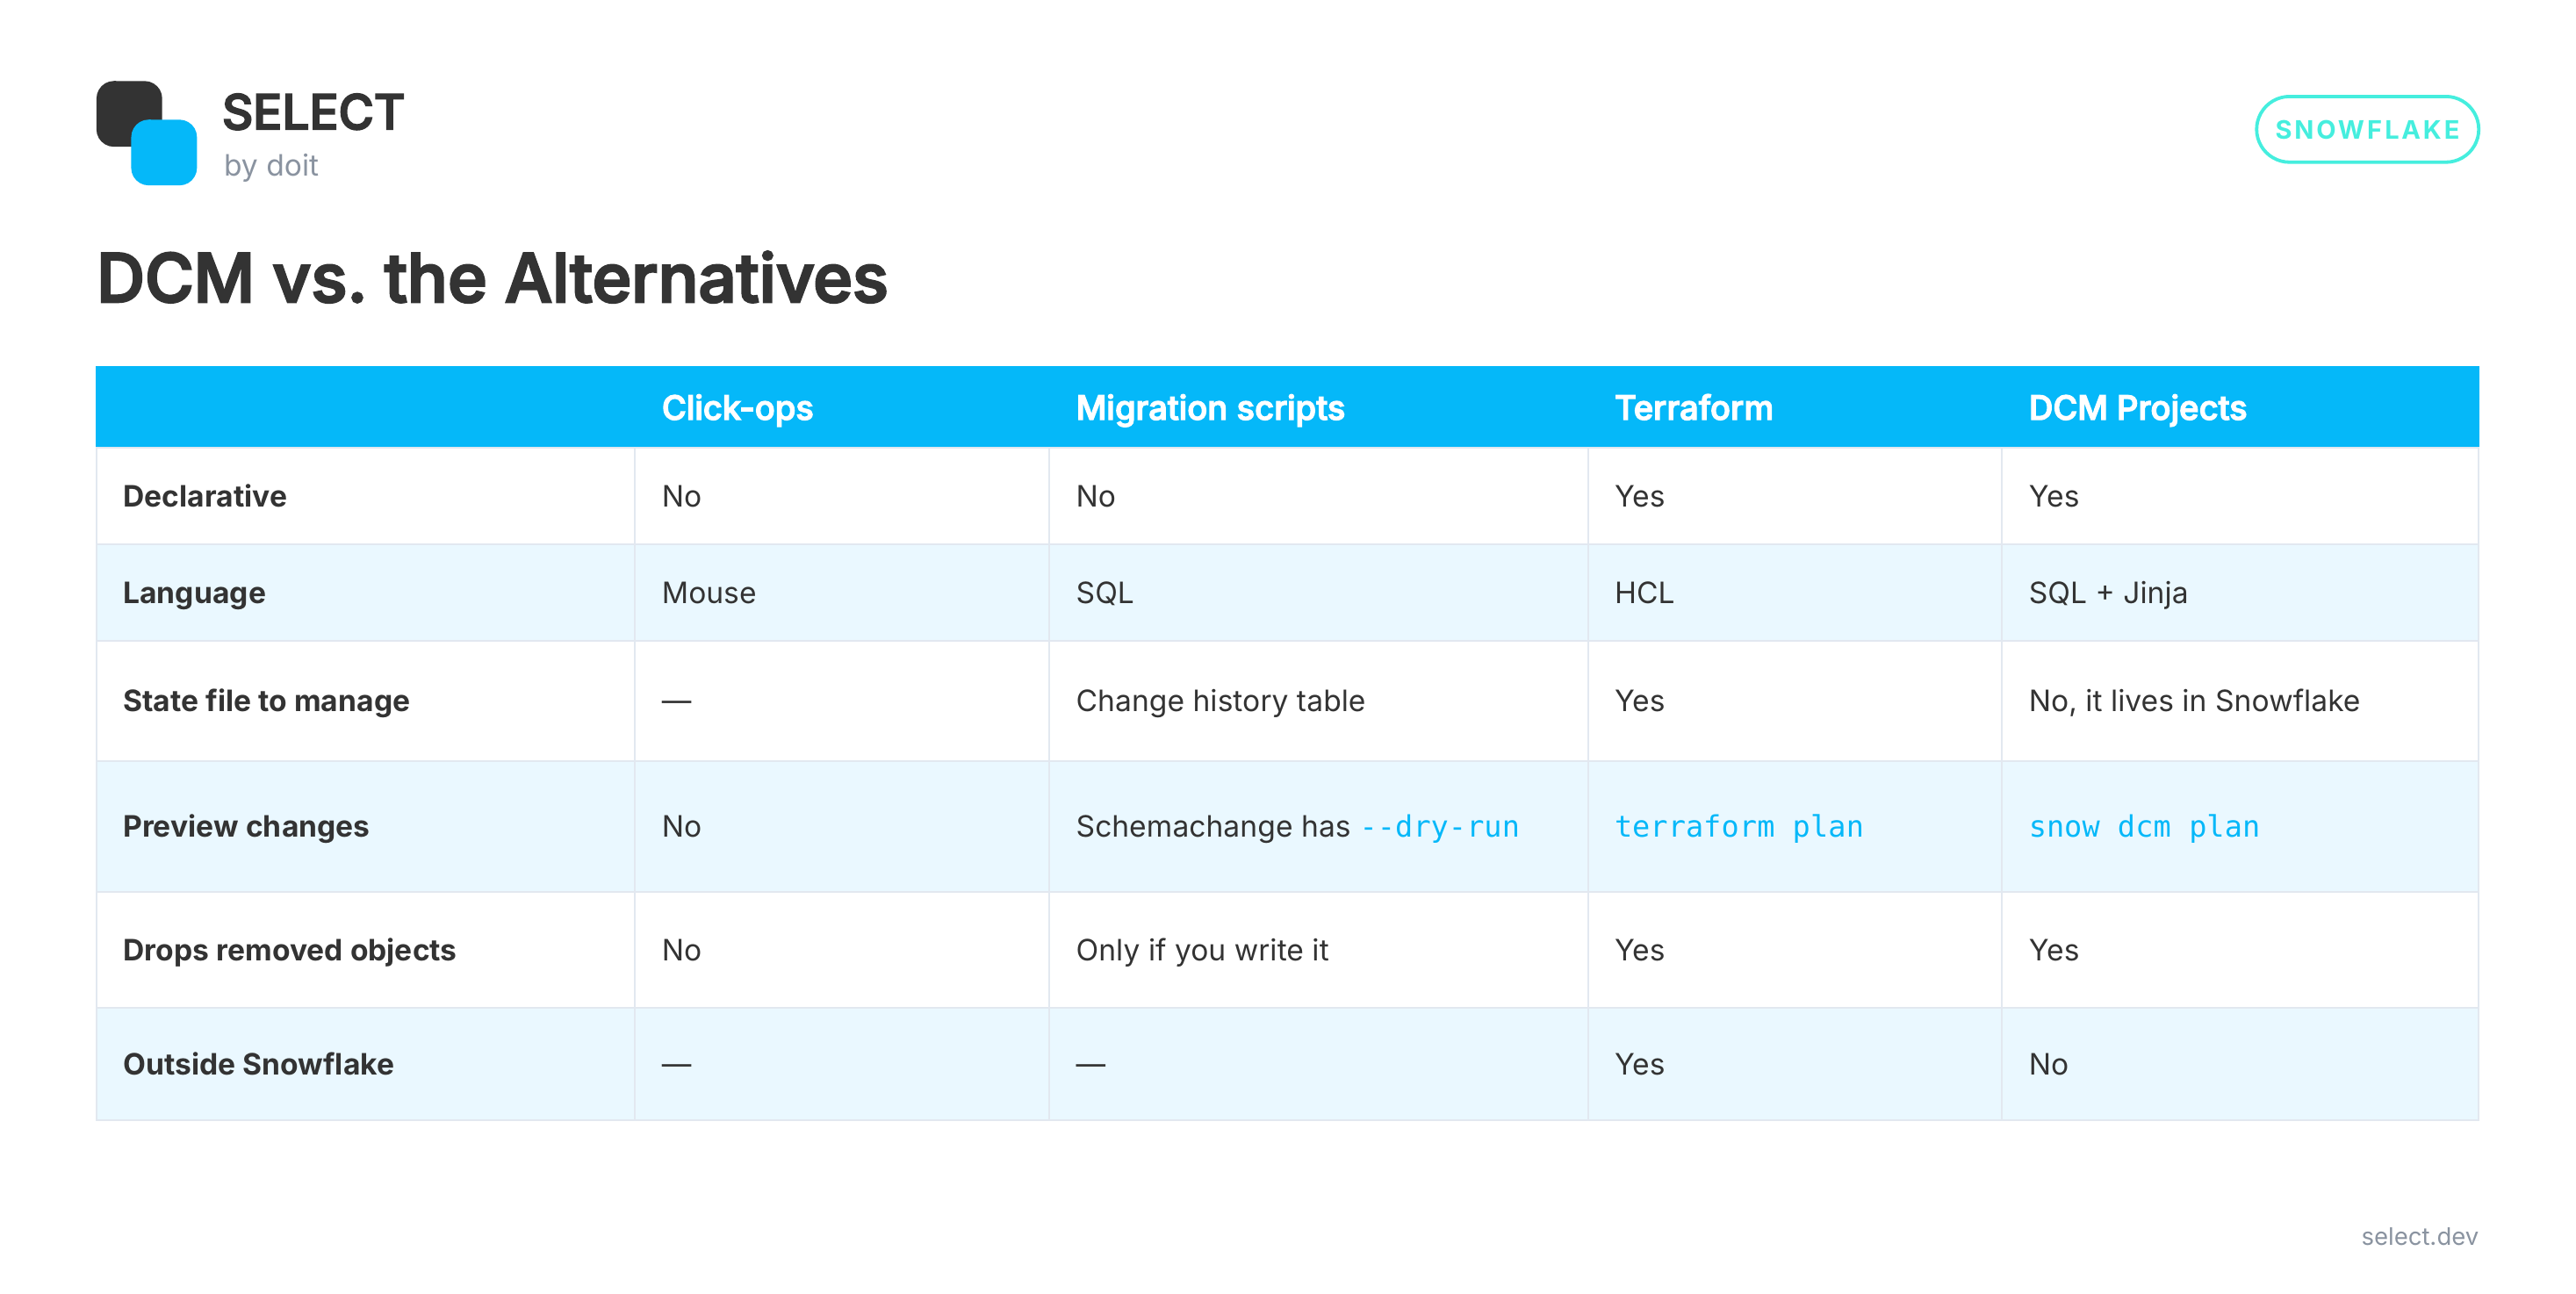
Si vous gérez AWS, Snowflake et votre DNS dans un seul repo Terraform, Terraform reste pertinent. Si l'infrastructure de votre équipe se résume essentiellement à Snowflake et que votre équipe parle déjà SQL, DCM est la voie la moins contraignante que j'aie trouvée.
Essayez par vous-même
J'ai rassemblé tout cela dans un repo de démarrage : https://github.com/jeff-skoldberg-gmds/snowflake-dcm-starter.
Il contient les définitions, les migrations de bootstrap, les deux workflows GitHub Actions et des skills Claude Code. Lancez /project-setup et il vous guide à travers le compte, le manifest, le bootstrap, le premier déploiement et la CI, une étape validée à la fois.
Il contient aussi des dossiers ingest/ et dbt/ vides, parce que DCM n'est que la fondation. Construisez un mono-repo pour votre plateforme Snowflake qui inclut le chargement et la transformation des données. Les rôles et les bases de données n'attendent plus que vos pipelines.
Maintenant, essayez, et dites-moi si l'infrastructure as code sur Snowflake vous semble toujours une corvée !x`