
TLDR
- Los DCM Projects son la forma nativa y declarativa de Snowflake de gestionar objetos como código. Escribes
DEFINE <object>en lugar deCREATE <object>(por ejemplo,DEFINE DATABASE), y Snowflake se encarga de determinar qué debe cambiar. - El ciclo es: editar definiciones, hacer plan y luego deploy. El plan es un diff de solo lectura. El deploy lo aplica.
- DCM elimina lo que dejas de definir. Borra una línea y pierdes una base de datos. Lee el plan.
- Con un
manifest.ymlmás Jinja obtienesDEV,QAyPRODa partir de un único conjunto de archivos. - DCM puede gestionar tablas y vistas, pero no creo que deba hacerlo si ya usas dbt. Deja que DCM sea dueño de la plataforma (roles, bases de datos, warehouses, grants) y que dbt sea dueño de lo que hay dentro de las bases de datos.
- El diseño de roles y bases de datos viene de la guía de configuración de Snowflake de dbt Labs, que cientos de proyectos de dbt han seguido. El repo le hace algunas mejoras y lo convierte en código.
- Aquí está el repo de GitHub en el que se basa este artículo, con CI/CD mediante GitHub Actions que nunca toca
ACCOUNTADMIN.
Cómo llegamos hasta aquí
Si llevas un tiempo en Snowflake, probablemente has gestionado la infraestructura de tu cuenta de una de estas tres maneras:
- Click-ops. Alguien con
ACCOUNTADMINcrea un objeto en Snowsight un martes. Nadie recuerda por qué. Tres años después, nadie se atreve a eliminarlo. - Scripts de migración:
V1__create_roles.sql,V2__grant_things.sql,V47__fix_the_grant_from_V2.sql. Herramientas como schemachange los ejecutan en orden. Funciona, pero el "estado actual" de tu cuenta es la suma de 47 archivos, y buena suerte tratando de leer eso. - Terraform. Declarativo y potente. También trae consigo HCL, un provider que hay que mantener al día y un archivo de estado que debes almacenar, bloquear y, de vez en cuando, operar a corazón abierto. Para muchos equipos de datos, eso es toda una disciplina nueva solo para crear un warehouse.
Los DCM Projects son la respuesta de Snowflake a todo eso. Obtienes el modelo declarativo de Terraform, pero el lenguaje es SQL y el estado vive en Snowflake.
El modelo de referencia: las sentencias GRANT que todos copiaron
Antes de entrar en DCM, hay que dar crédito a quien corresponde. Si alguna vez configuraste Snowflake para dbt, es muy probable que hayas leído Setting up Snowflake — the exact grant statements we run de Claire Carroll en el Discourse de dbt. Cientos de proyectos de dbt se configuraron siguiendo ese esquema. Yo mismo lo he seguido más veces de las que puedo contar.
El diseño es simple, y por eso funciona:
- Una base de datos
rawpara los datos entrantes y una base de datosanalyticspara los datos modelados. - Un rol
loaderque escribe enraw, un roltransformerque leerawy construyeanalytics, y un rolreporterque leeanalyticsy nada más. - Future grants, para que los nuevos schemas y tablas se puedan leer sin que nadie mueva un dedo.
El problema nunca fue el diseño. El problema es que se trata de una lista de sentencias que pegas una sola vez en una worksheet. Seis meses después, nadie puede decir si la cuenta todavía coincide con ella, y la extensión del "entorno de dev" al final del post queda como ejercicio para el lector.
Así que el repo inicial conserva la estructura de Claire y cambia algunas cosas:
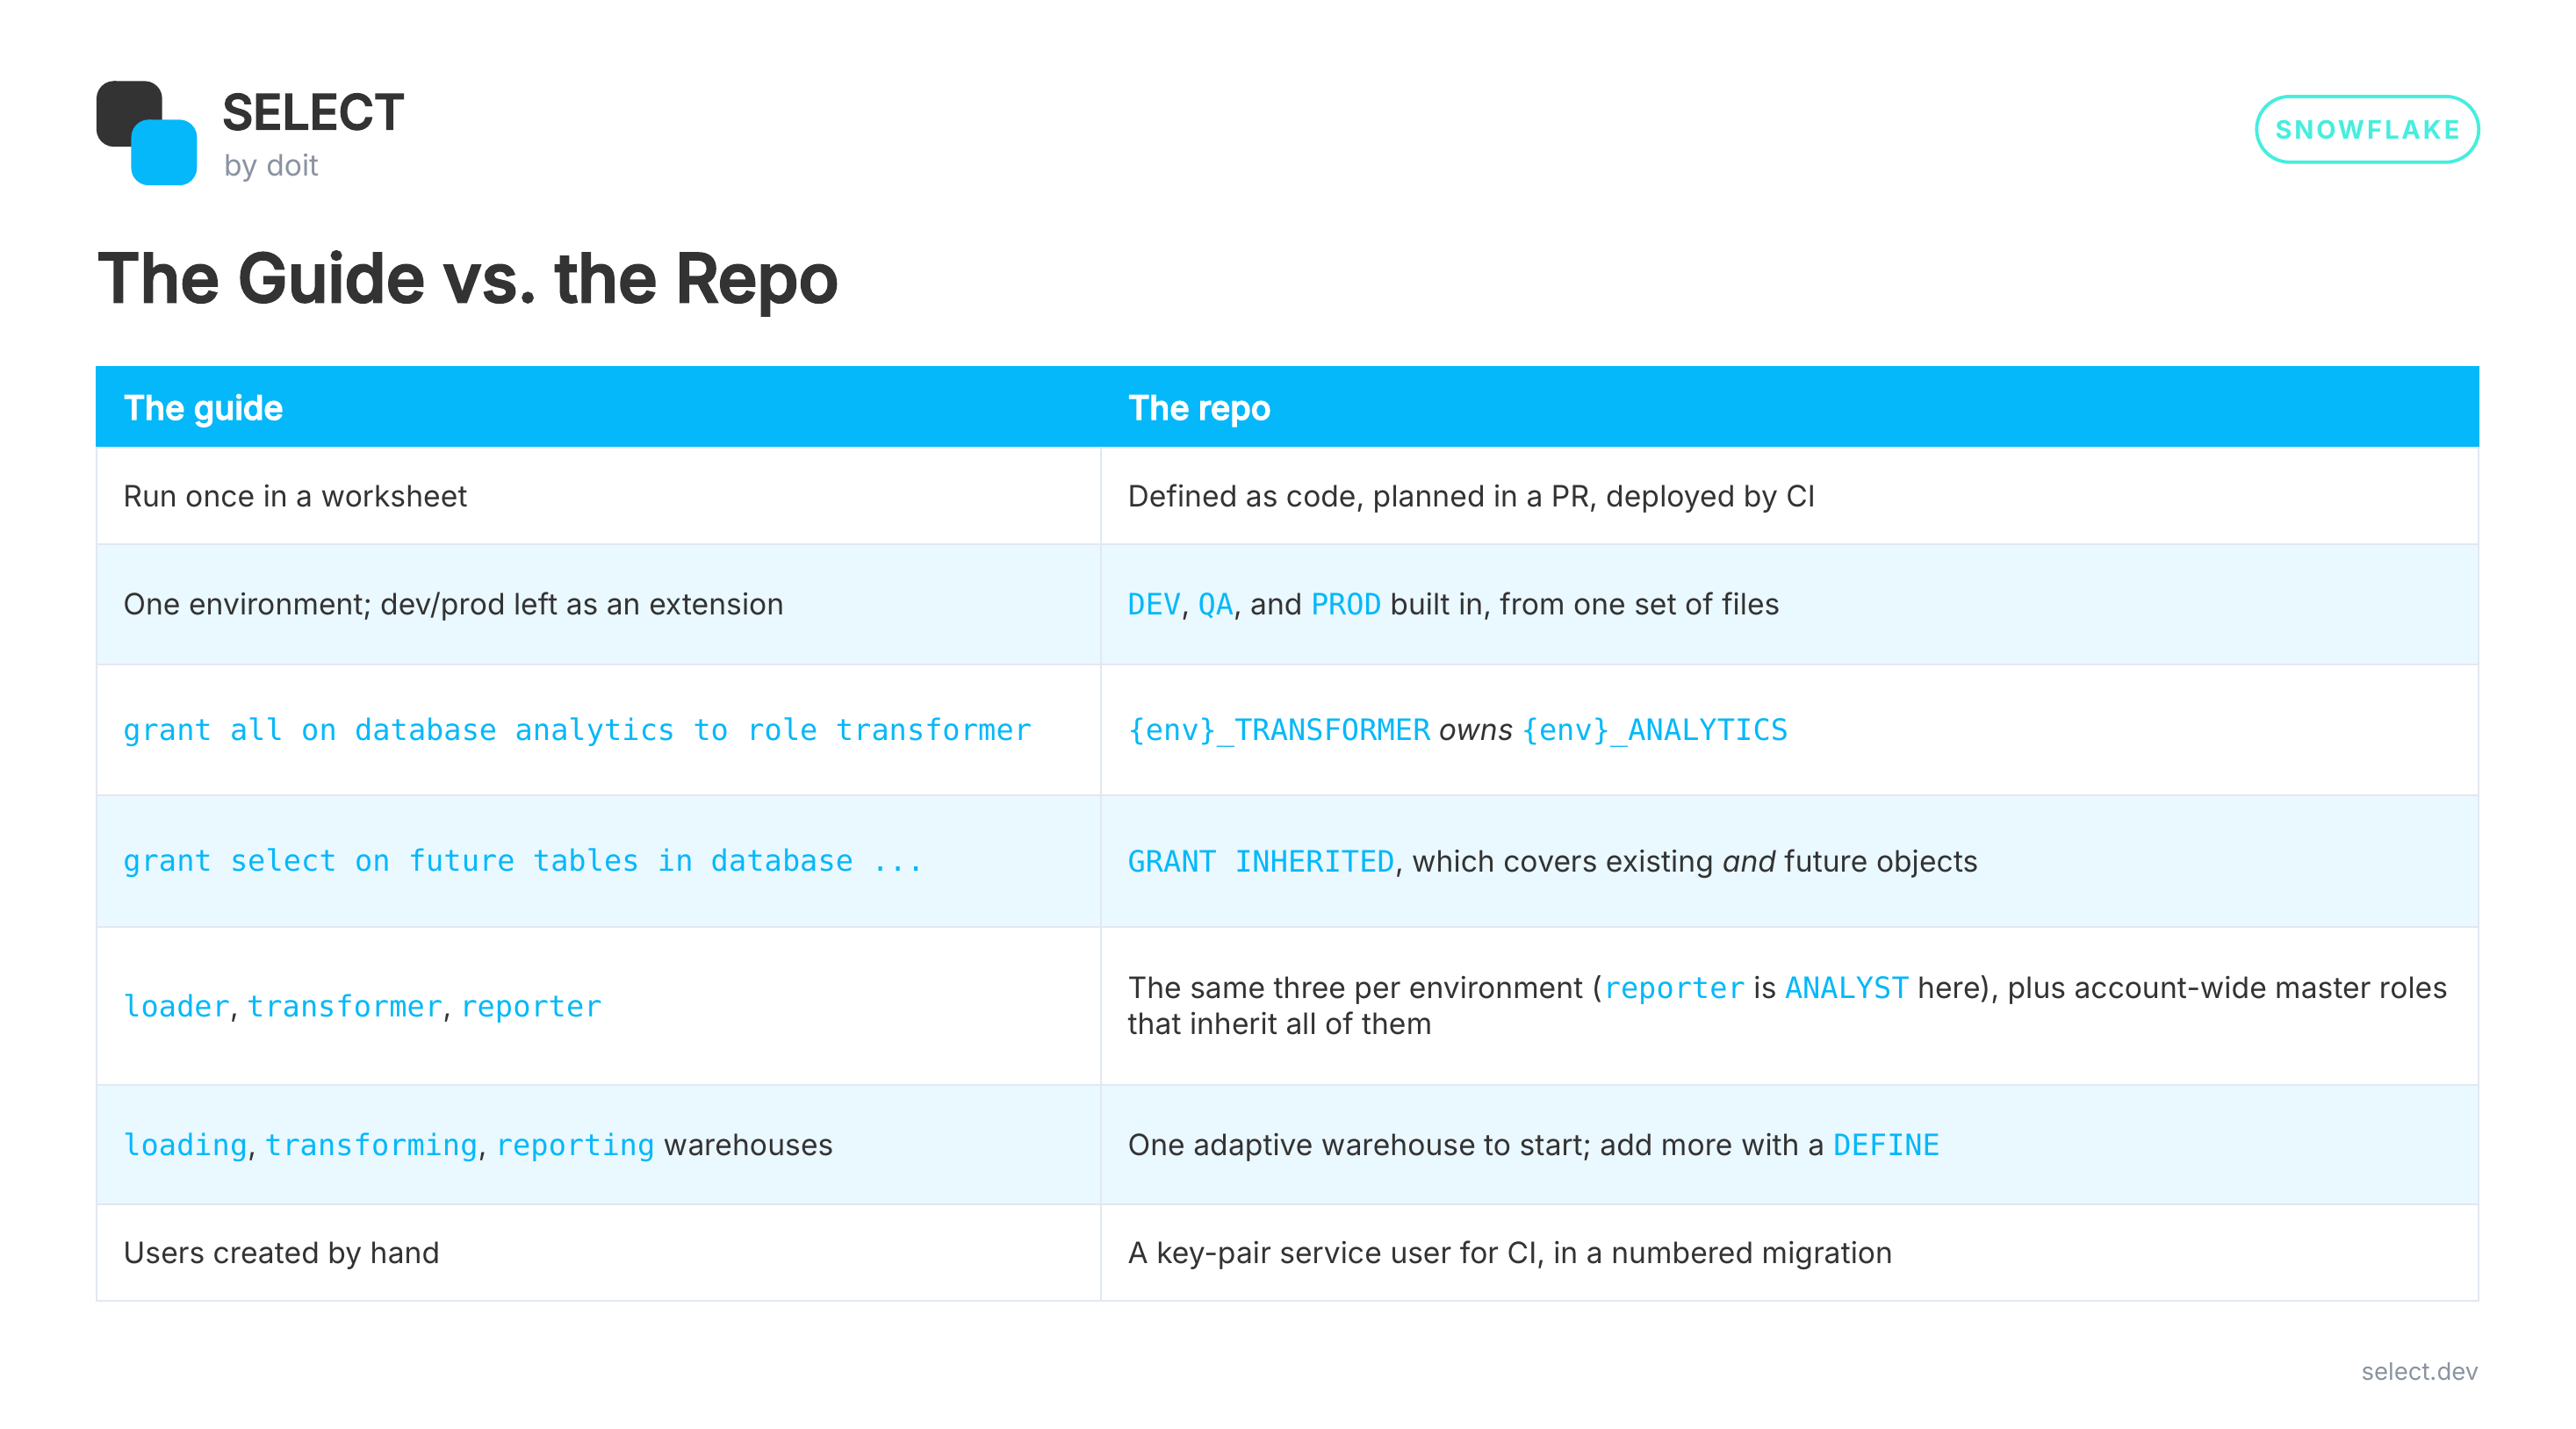
Por qué los inherited grants reemplazan a los future grants
Esa fila de grants es el cambio que más importa, así que profundicemos.
¡Los future grants fueron la herramienta correcta durante mucho tiempo! Son lo que hace que la configuración de Claire requiera tan poco mantenimiento. Pero tienen tres problemas, y cualquiera que haya administrado Snowflake durante algunos años se ha topado con al menos uno:
- Solo cubren el futuro. Un future grant no hace nada por las tablas que ya existen, así que toda configuración lo acompaña con una sentencia
grant select on all tables. Son dos sentencias por privilegio, y dos cosas que recordar. - Los future grants a nivel de schema anulan los de nivel de base de datos. Si alguien agrega un future grant en un schema, Snowflake ignora los future grants a nivel de base de datos para ese schema. Tu rol
reporterdeja de recibir las tablas nuevas ahí sin hacer ruido, y nada arroja error. - Son una copia única, no una regla. Un future grant se aplica a cada objeto en el momento en que este se crea. Si más tarde revocas o cambias el future grant, cada objeto que ya tocó conserva el privilegio anterior. El grant que puedes ver ya no describe el acceso que la gente realmente tiene.
Un inherited grant es una sola sentencia sobre un contenedor (la cuenta, una base de datos o un schema), y se aplica a todos los objetos que coinciden dentro de él, tanto existentes como futuros:
GRANT INHERITED SELECT ON ALL TABLES IN DATABASE {{ env }}_ANALYTICS TO ROLE {{ env }}_ANALYST;Eso reemplaza por completo al future grant, al grant on all y a la versión por schema de cada uno. Cuando quieras saber por qué alguien puede leer una tabla, SHOW GRANTS tiene las columnas IS_INHERITED e INHERITED_FROM, que apuntan al grant responsable.
También encaja de forma natural con DCM. Una herramienta declarativa quiere una sola línea que exprese la regla. "Los analistas pueden leer todo en ANALYTICS" ahora es una línea, no seis.
Algunos trade-offs que conviene conocer:
- Sin excepciones. No puedes revocar el privilegio en una tabla para excluirla. La documentación de Snowflake advierte que el revoke parece funcionar mientras el rol conserva el acceso a través del inherited grant. Si una tabla necesita un acceso distinto, su lugar está en otro schema u otra base de datos.
- Mover o clonar un objeto dentro de un contenedor cambia quién puede verlo, sin ninguna sentencia
GRANTde por medio. Esa es justamente la idea, pero clona con intención. OWNERSHIPno se puede heredar. La propiedad sigue siendo un grant normal.- Requiere un flag de cuenta,
FEATURE_RBAC_INHERITED_GRANTS, que soloACCOUNTADMINpuede configurar. Más sobre esto en el bootstrap de abajo.
¿Qué es un DCM Project en Snowflake?
Dos cosas:
- Una carpeta de archivos. Un
manifest.ymly algunos archivos.sqlllenos de sentenciasDEFINE. - Un objeto DCM project en Snowflake. Vive en un schema como cualquier otro objeto y guarda el historial de deployments.
Esta es la estructura de mi repo inicial:
platform/ dcm/ manifest.yml sources/definitions/ roles.sql databases.sql warehouses.sql grants.sql migrations/ 000_bootstrap.sql 001_ci_deployer.sqlUn archivo por tipo de objeto es mi convención, no una regla de DCM. Snowflake lee todo lo que hay bajo sources/, así que organízalo como mejor funcione para tu cabeza.
DEFINE, no CREATE
Aquí está todo el cambio de mentalidad. Con un script de migración escribes instrucciones:
CREATE ROLE IF NOT EXISTS DEV_LOADER;ALTER ROLE DEV_LOADER SET COMMENT = 'Owns DEV_RAW';Con DCM escribes el estado final:
DEFINE ROLE DEV_LOADER COMMENT = 'Owns DEV_RAW. Used by ingestion tools.';Si el rol no existe, DCM lo crea. Si existe con un comentario diferente, DCM lo modifica. Si ya coincide, DCM no hace nada. Nunca más vuelves a escribir IF NOT EXISTS, ni un ALTER para corregir algo que escribiste la semana pasada.
Los grants funcionan igual. No haces DEFINE de un grant, simplemente lo declaras:
DEFINE DATABASE DEV_RAW  COMMENT = 'Landing zone. Schemas and tables are created by ingestion tools.';
GRANT OWNERSHIP ON DATABASE DEV_RAW TO ROLE DEV_LOADER;
Plan y luego deploy
Cada cambio pasa por dos pasos. Con la CLI de Snowflake:
snow dcm plan --from platform/dcm --target DEV \ --connection my_account --role PLATFORM_DEPLOYEREl plan compara tus archivos con lo que hay en la cuenta y te dice exactamente qué crearía, modificaría y eliminaría. No cambia nada.
[screenshot: plan output for adding a database]
¿Conforme con el resultado? Haz el deploy:
snow dcm deploy --from platform/dcm --target DEV --alias add_marketing_db \ --connection my_account --role PLATFORM_DEPLOYEREse --alias es opcional, pero por favor úsalo. Sin uno, tu historial de deployments es una lista de nombres autogenerados que nadie puede leer. Con uno, snow dcm list-deployments se lee como un changelog: add_marketing_db, analyst_read_on_analytics, drop_legacy_loader.
También puedes hacer todo esto en SQL (EXECUTE DCM PROJECT ... PLAN), y Snowsight Workspaces tiene una UI para ello. Yo vivo en la terminal, así que aquí verás la CLI.
DCM elimina lo que dejas de definir
Esta es la parte que te puede jugar una mala pasada.
Si quitas un DEFINE que ya se había desplegado, el siguiente deploy elimina ese objeto.
Es el comportamiento correcto para una herramienta declarativa. Los archivos son la cuenta. Pero implica dos hábitos no negociables:
- Siempre ejecuta el plan antes del deploy. Un
DROPinesperado en el plan significa que falta una definición, no que DCM te esté haciendo un favor. - Lee el plan en tu PR. Más abajo cuento cómo lo automatizo.
Una cosa más: la documentación de Snowflake es clara en que un deploy fallido puede dejarte con una ejecución parcial. No es una gran transacción única. Corrige la definición y vuelve a ejecutar plan → deploy, en lugar de parchear las cosas a mano.
DEV, QA y PROD a partir de un único conjunto de archivos
Nadie quiere tres copias de roles.sql. El manifest.yml define targets, y cada target apunta a su propio objeto de proyecto y pasa sus propias variables de templating:
manifest_version: 2type: DCM_PROJECTdefault_target: DEV
targets:  DEV:    account_identifier: ABCDEFG-XY12345    project_name: PLATFORM.DCM.DEV_PLATFORM_DCM    project_owner: PLATFORM_DEPLOYER    templating_config: DEV  # QA and PROD look the same
templating:  configurations:    DEV:
Expandir código
Luego, cada definición usa {{ env }} como prefijo:
DEFINE DATABASE {{ env }}_RAW  COMMENT = 'Landing zone. Schemas and tables are created by ingestion tools.';
DEFINE DATABASE {{ env }}_ANALYTICS  COMMENT = 'Modelled data. Schemas and tables are created by transformation tools.';
GRANT OWNERSHIP ON DATABASE {{ env }}_RAW TO ROLE {{ env }}_LOADER;GRANT OWNERSHIP ON DATABASE {{ env }}_ANALYTICS TO ROLE {{ env }}_TRANSFORMER;
Haz deploy con --target DEV y obtienes DEV_RAW. Haz deploy con --target PROD y obtienes PROD_RAW. Los mismos archivos.
La parte complicada: los objetos a nivel de cuenta
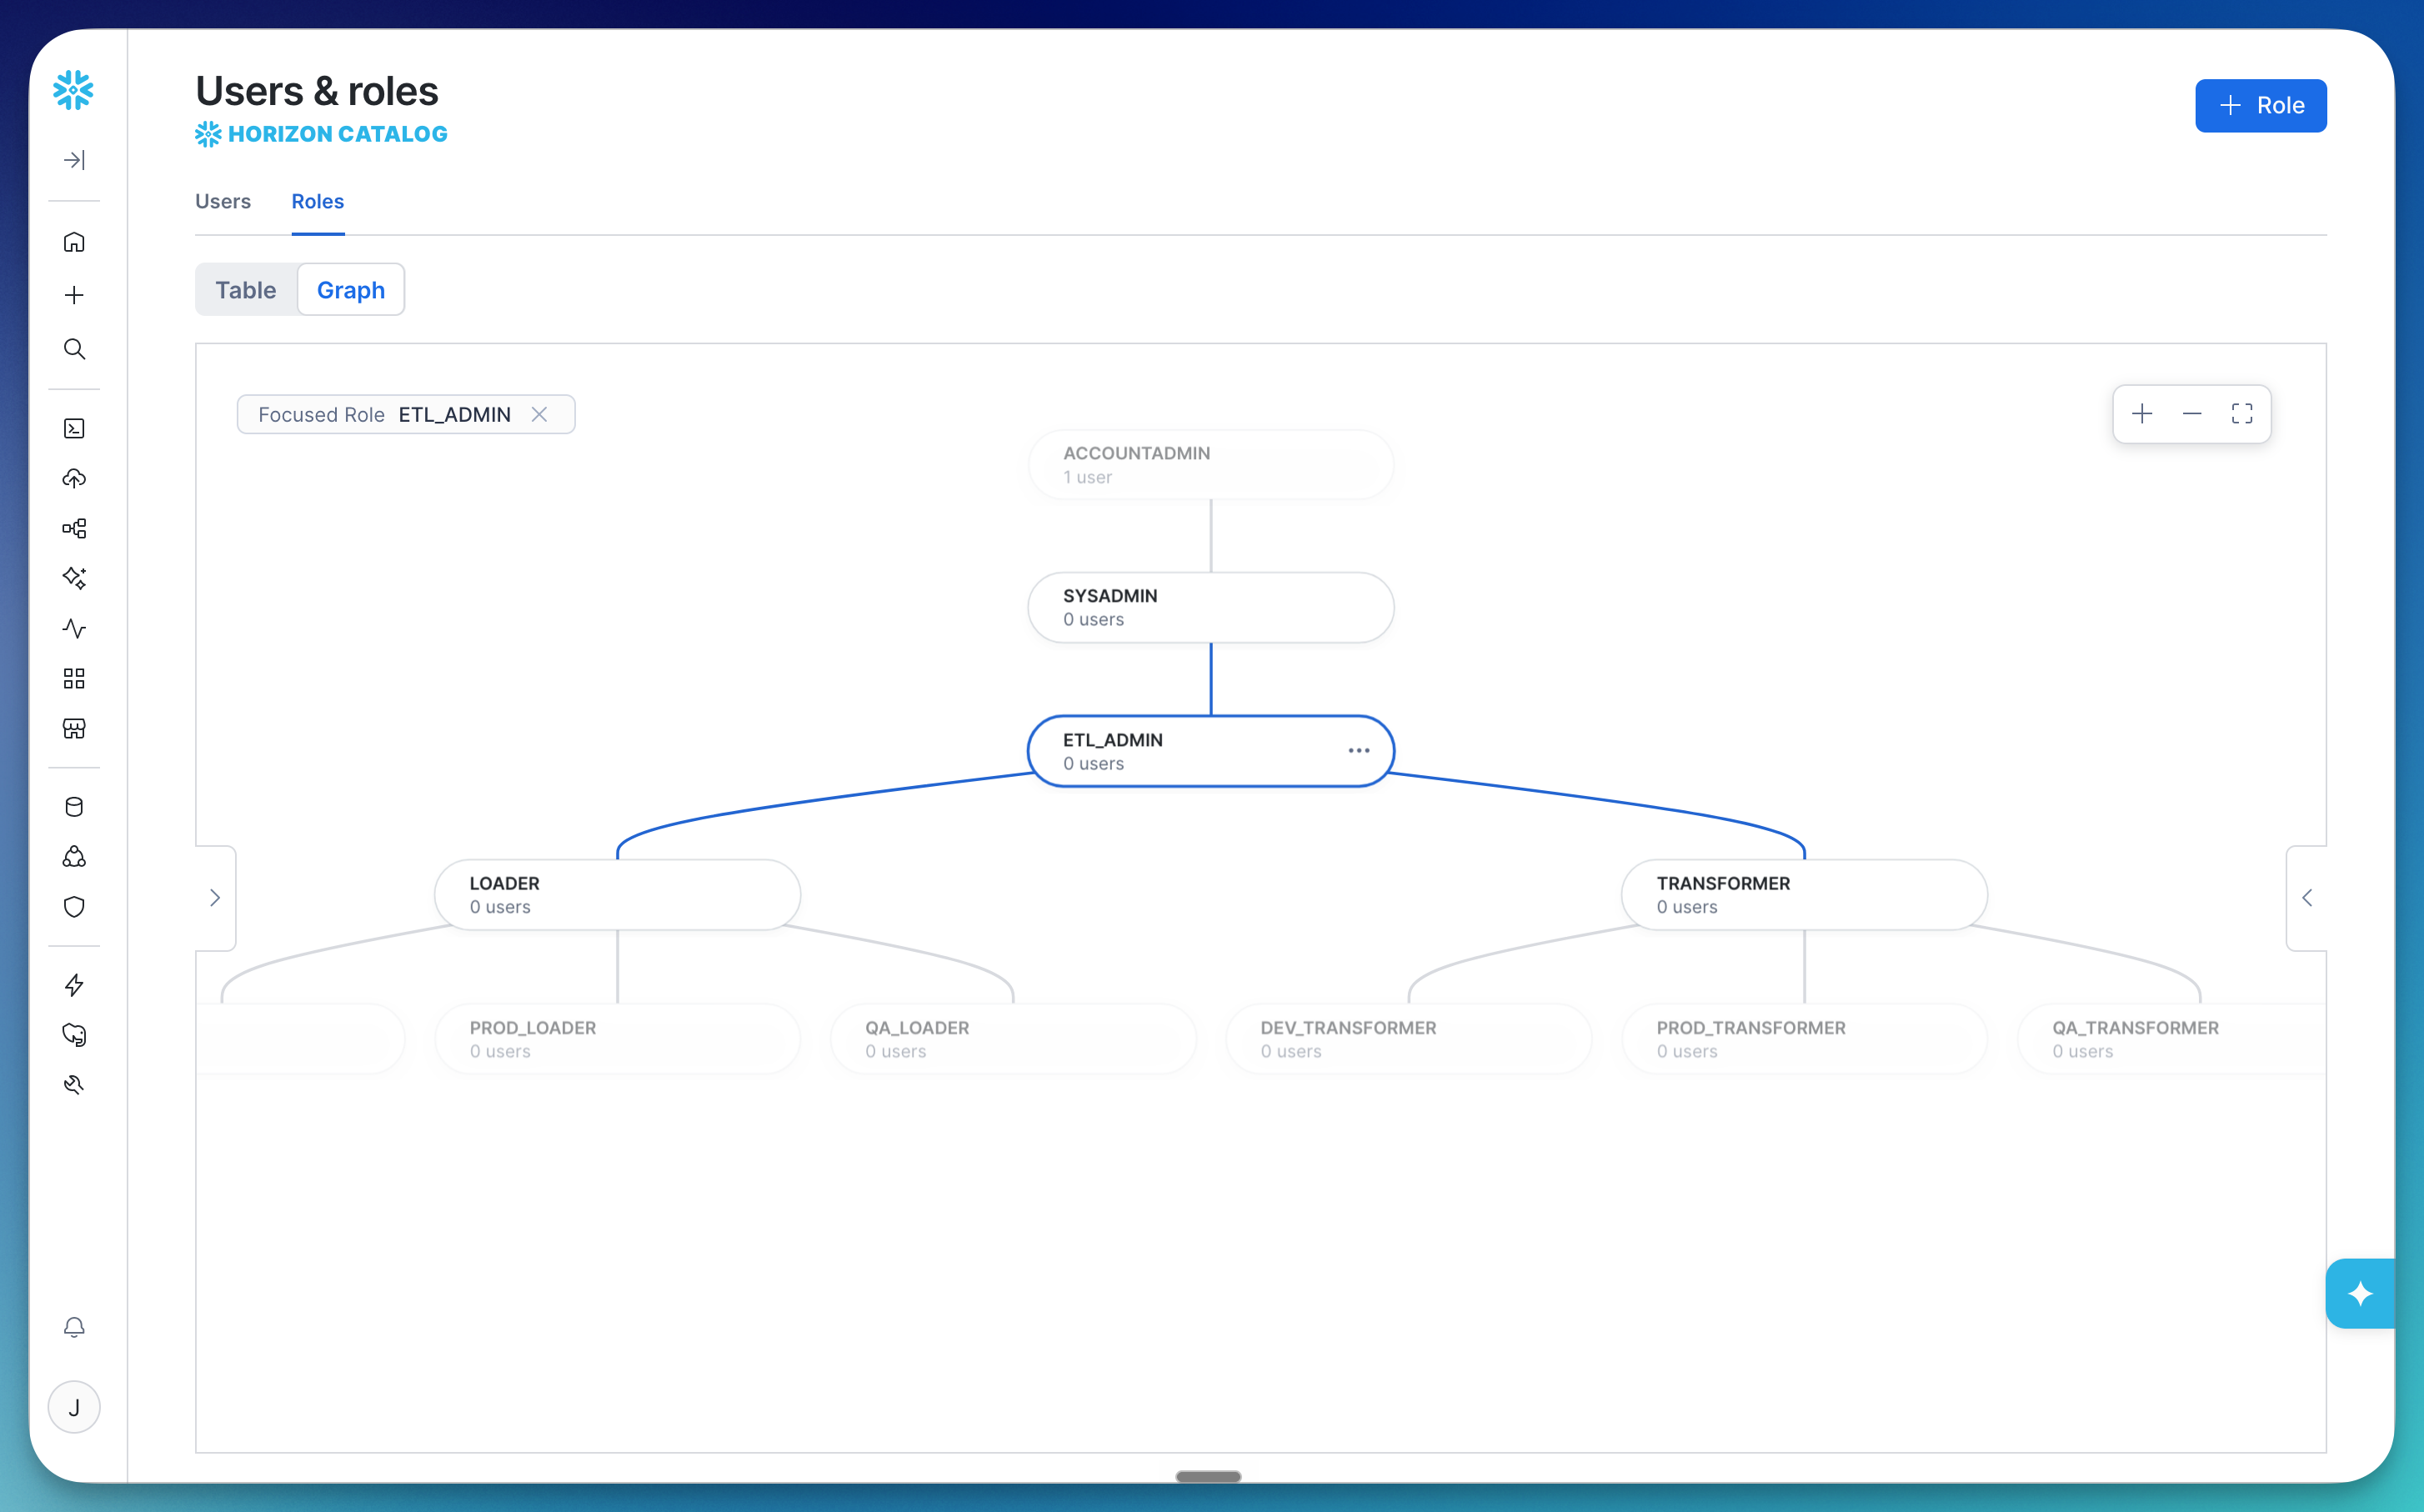
Algunos objetos no pertenecen a un entorno. En mi plantilla, los tres entornos comparten una cuenta, un warehouse y un conjunto de roles "maestros" como LOADER, que heredan DEV_LOADER, QA_LOADER y PROD_LOADER.
Si definiera COMPUTE_XS sin condición, los tres targets lo reclamarían, y el deploy de cada target pelearía por él. Así que los objetos a nivel de cuenta se definen en exactamente un target, con un if de Jinja y un bucle:
{% if env == 'PROD' %}{% set envs = ['DEV', 'QA', 'PROD'] %}
DEFINE WAREHOUSE COMPUTE_XS  WAREHOUSE_TYPE = 'ADAPTIVE'  MAX_QUERY_PERFORMANCE_LEVEL = XSMALL  QUERY_THROUGHPUT_MULTIPLIER = 2  COMMENT = 'Sole compute warehouse for loads and transforms.';
{% for e in envs %}GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_LOADER;GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_TRANSFORMER;GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_ANALYST;{% endfor %}{% endif %}
El detalle: ese bloque de PROD otorga grants a DEV_LOADER y QA_LOADER, así que DEV y QA tienen que desplegarse antes que PROD. El orden de los deploys pasa a formar parte de tu proceso, y de tu CI.
Si pones cada entorno en su propia cuenta, esto desaparece, pero entonces cada cuenta necesita su propia copia de los objetos a nivel de cuenta. Elige tu trade-off.
Este es el modelo de roles con el que termina la plantilla:
Además, el rol Deployer recibe directamente los roles específicos de cada entorno:
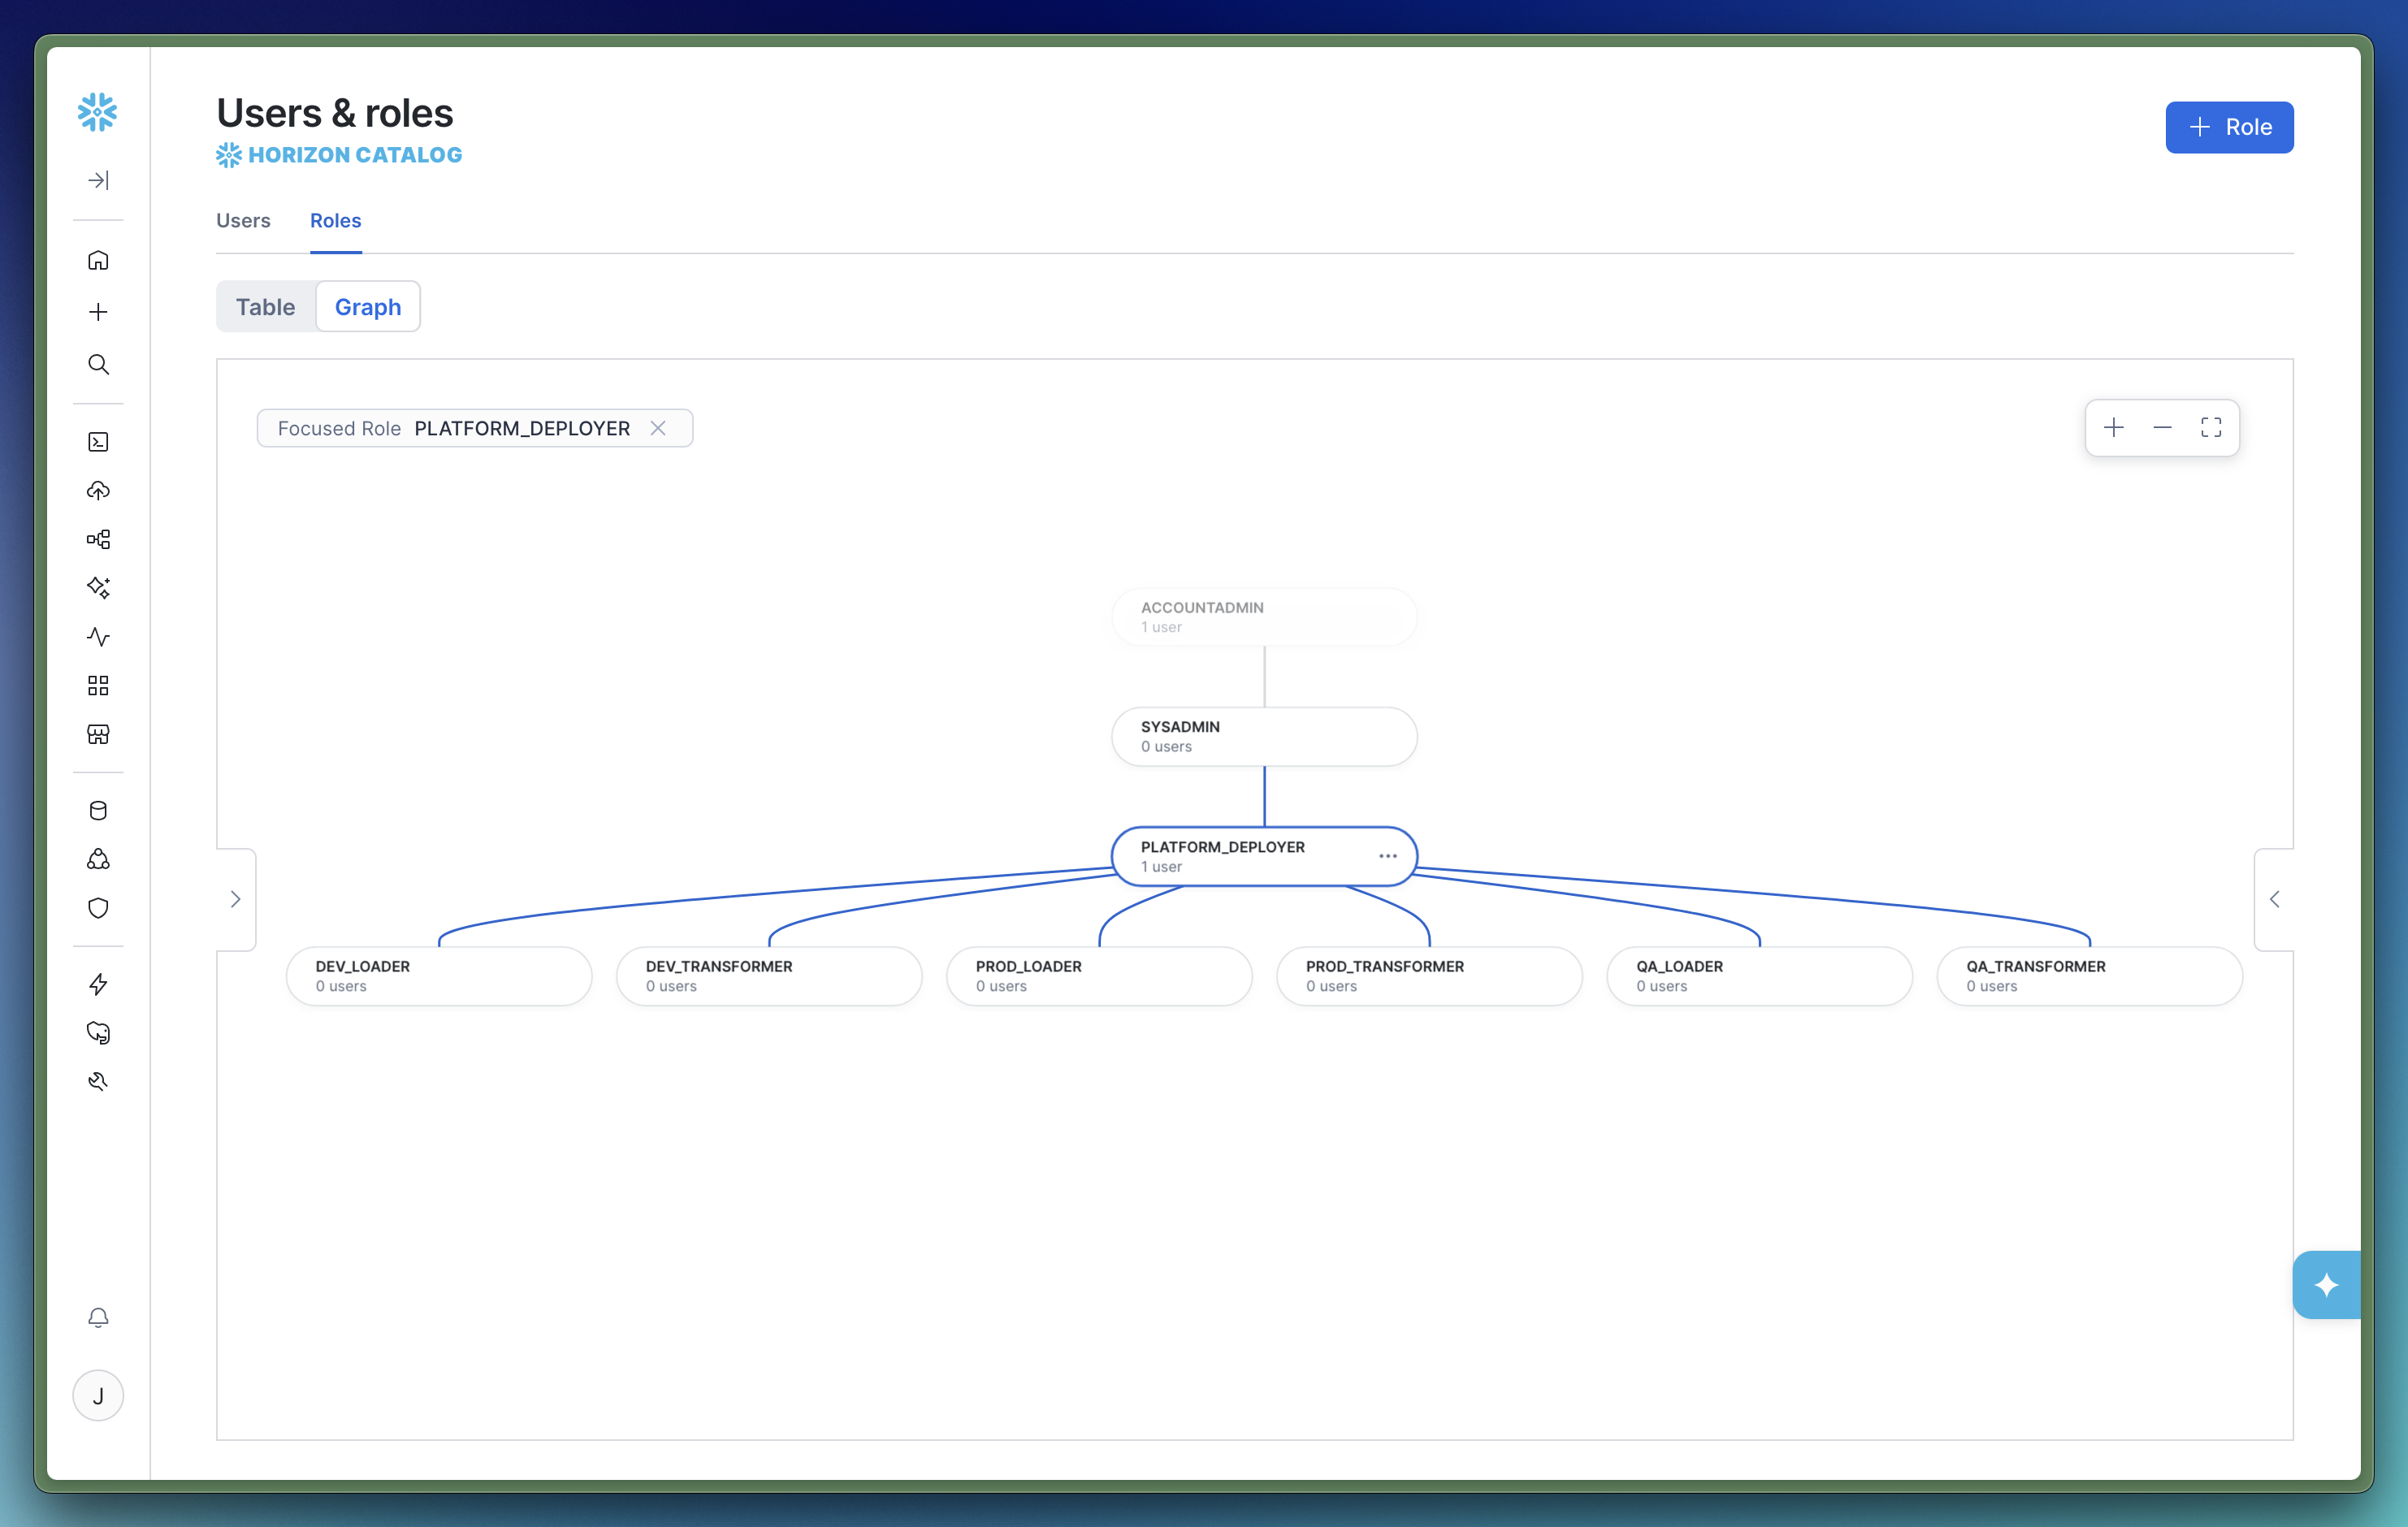
Tu herramienta de ingesta se conecta como {env}_LOADER. dbt se conecta como {env}_TRANSFORMER. Los analistas reciben {env}_ANALYST, que puede leer ANALYTICS y no puede ver RAW en absoluto.
Si usas dbt, deja que sea el dueño de las tablas y schemas en la base de datos Analytics
DCM admite una larga lista de tipos de objetos: bases de datos, schemas, tablas, vistas, dynamic tables, tasks, stages, funciones, procedimientos, masking policies, tags y más.
Entonces, ¿por qué mi plantilla solo lo usa para roles, bases de datos, warehouses y grants?
Porque si usas dbt, dbt ya gestiona tus tablas y vistas, con linaje, tests y documentación. Pon la misma tabla en una definición de DCM y ahora tienes dos herramientas que creen ser dueñas de ella. Tarde o temprano, una eliminará lo que la otra construyó.
Así que trazo una línea muy clara:
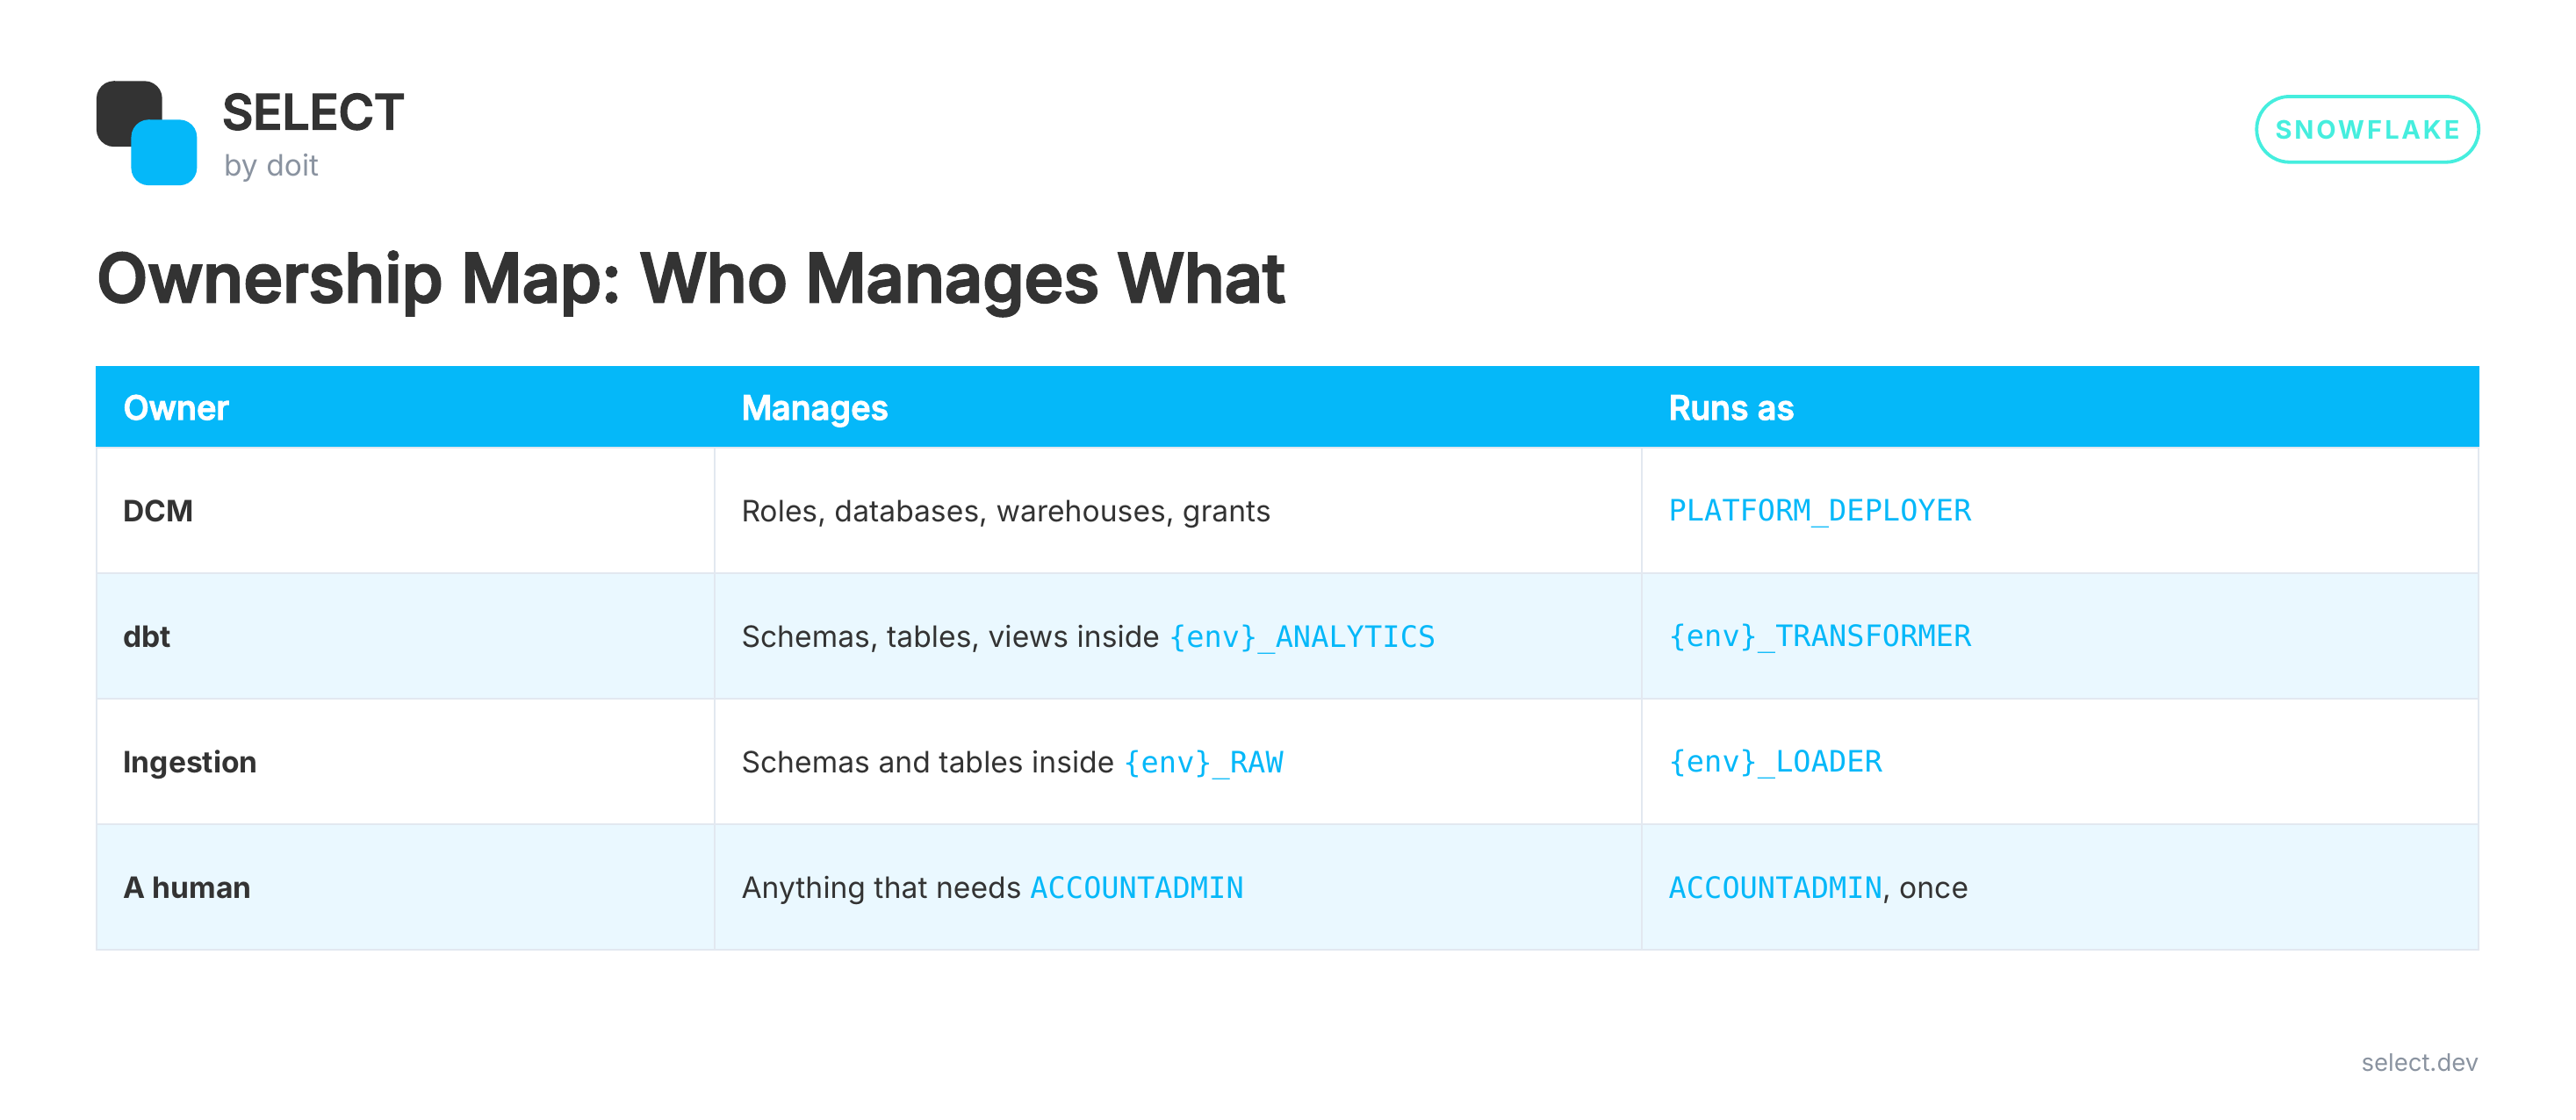
Ningún objeto tiene dos dueños. Si no usas dbt, o tienes objetos que ninguna herramienta de transformación gestiona (stages, file formats, network rules), DCM es el lugar ideal para ellos. La regla es "un dueño por objeto", no "DCM solo se encarga de los roles".
El huevo y la gallina: el bootstrap
DCM necesita un rol con el cual desplegar y un objeto de proyecto donde desplegar. Algo tiene que crearlos, y ese algo necesita ACCOUNTADMIN.
Mi regla para todo el repo:
CI/CD nunca debe necesitar
ACCOUNTADMIN.
Así que todo lo que sí lo necesita va a un archivo SQL numerado que un humano ejecuta exactamente una vez:
USE ROLE ACCOUNTADMIN;
ALTER ACCOUNT SET FEATURE_RBAC_INHERITED_GRANTS = 'ENABLED';
CREATE ROLE IF NOT EXISTS PLATFORM_DEPLOYER  COMMENT = 'CI/CD deployment role for DCM.';
GRANT CREATE ROLE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT CREATE DATABASE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT CREATE WAREHOUSE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT MANAGE GRANTS ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT ROLE PLATFORM_DEPLOYER TO ROLE SYSADMIN;
CREATE DATABASE IF NOT EXISTS PLATFORM;CREATE SCHEMA IF NOT EXISTS PLATFORM.DCM;
Expandir código
(Está un poco recortado. El archivo completo está en el repo).
Después de eso, PLATFORM_DEPLOYER hace todo. Y aquí va un hábito que me encanta: pasa --role PLATFORM_DEPLOYER también de forma local. Si un cambio necesita más privilegios de los que aparenta, falla en tu laptop y no en el CI un viernes por la tarde.
Tropiezos con los que ya me topé para que tú no tengas que hacerlo
Los inherited grants en DCM están marcados como preview. La lista de objetos compatibles con DCM de Snowflake señala los inherited grants y el MANAGE GRANTS a nivel de contenedor como funciones en preview. A mí me han funcionado bien, pero revisa la documentación antes de confiarles el acceso a producción.
No bloquees el acceso del deployer. Cuando DCM transfiere la propiedad de DEV_RAW a DEV_LOADER, PLATFORM_DEPLOYER deja de ser su dueño. En el siguiente deploy, DCM no puede gestionar lo que no está a su alcance. La solución es una línea por rol:
GRANT ROLE {{ env }}_LOADER TO ROLE PLATFORM_DEPLOYER;GRANT ROLE {{ env }}_TRANSFORMER TO ROLE PLATFORM_DEPLOYER;account_identifier en el manifest no expande variables de entorno. Escribe el identificador directamente. Es lo que permite que DCM te advierta cuando estás a punto de desplegar en la cuenta equivocada, lo cual, si eres consultor haciendo malabares con cuentas de clientes, es una función que quieres tener.
No uses templating para secretos. Snowflake lo dice sin rodeos: las variables de templating no están pensadas para credenciales.
CI/CD con GitHub Actions
Aquí es donde todo encaja. Dos workflows:
En un pull request:
- Plan y deploy en
QA. - Plan de
PRODy publicación del plan como comentario en el PR.
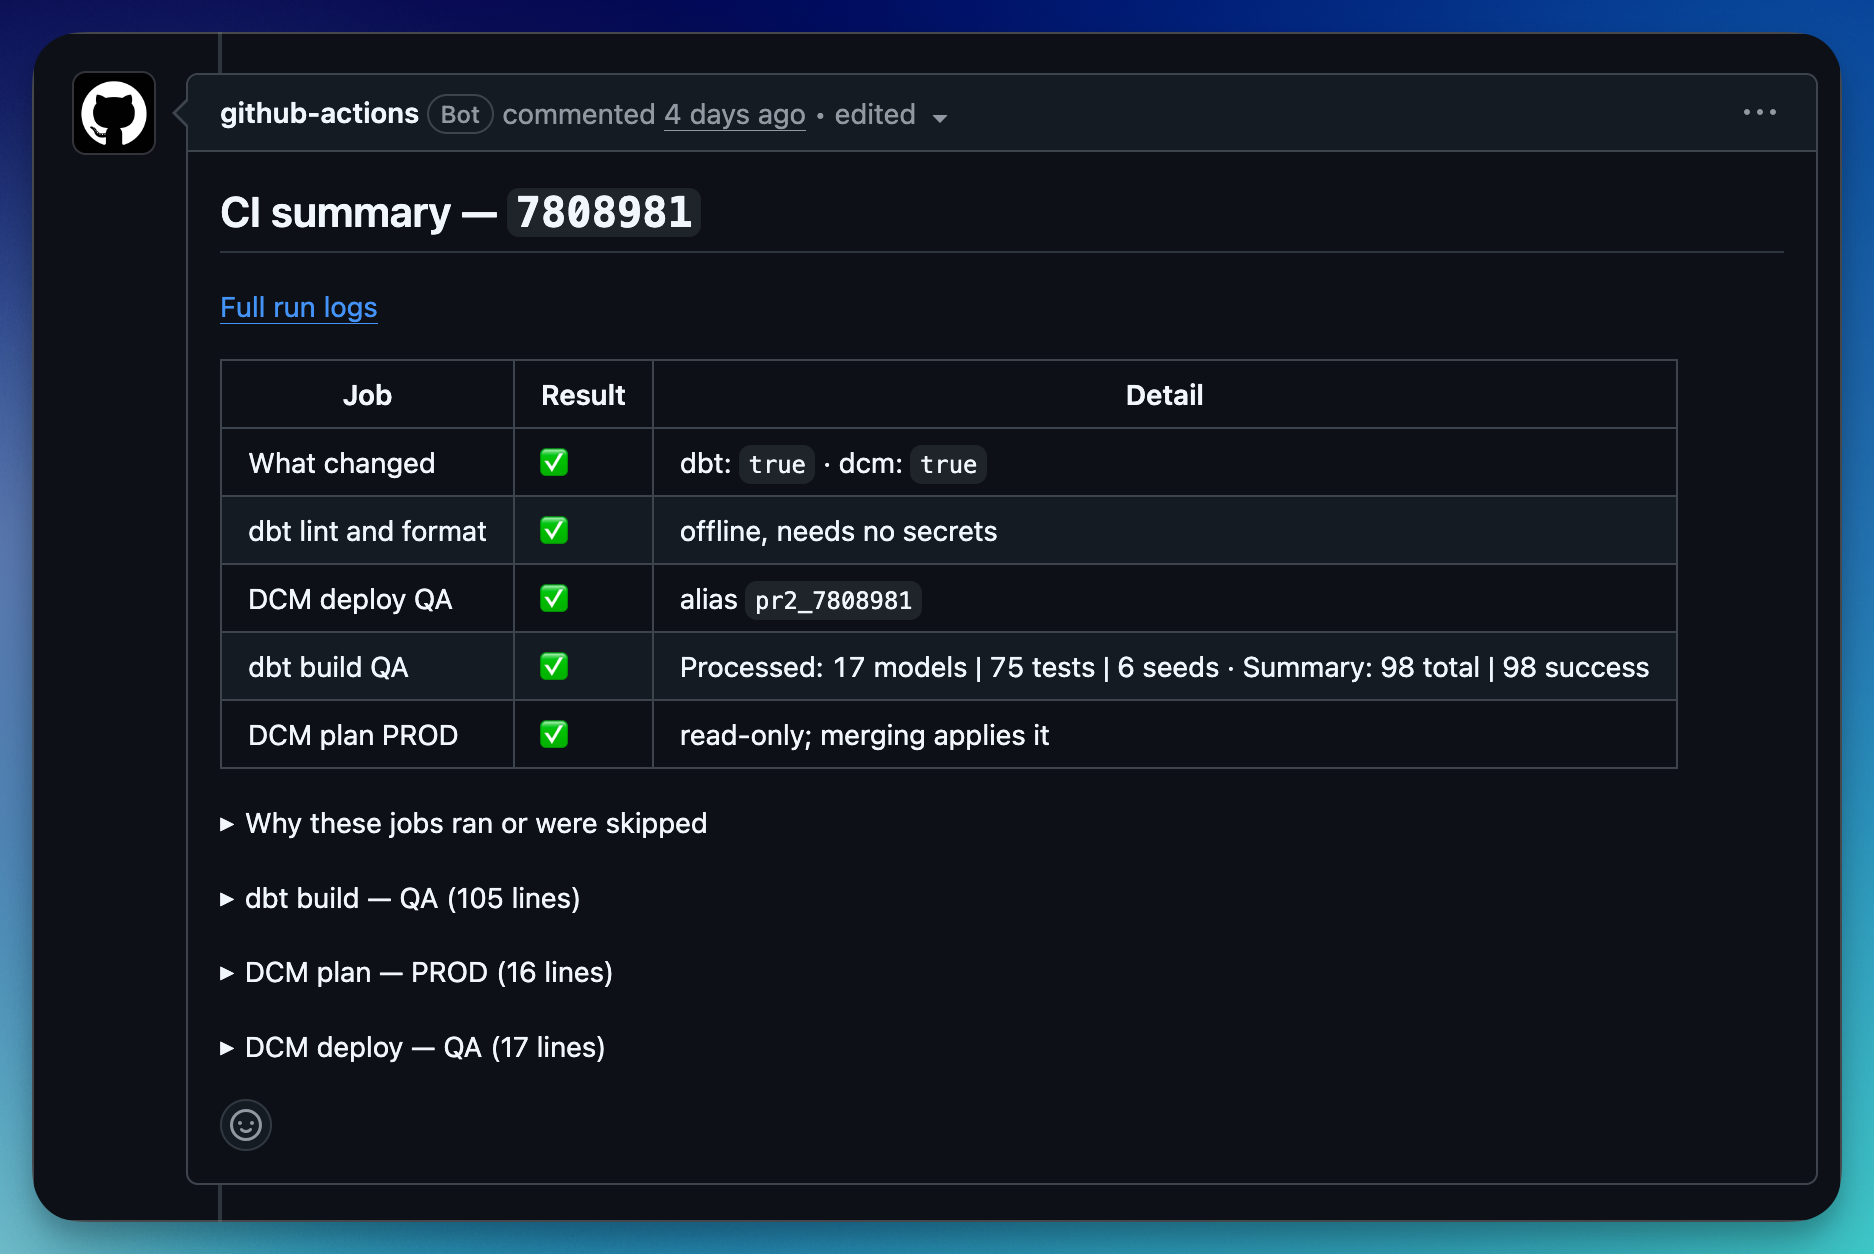
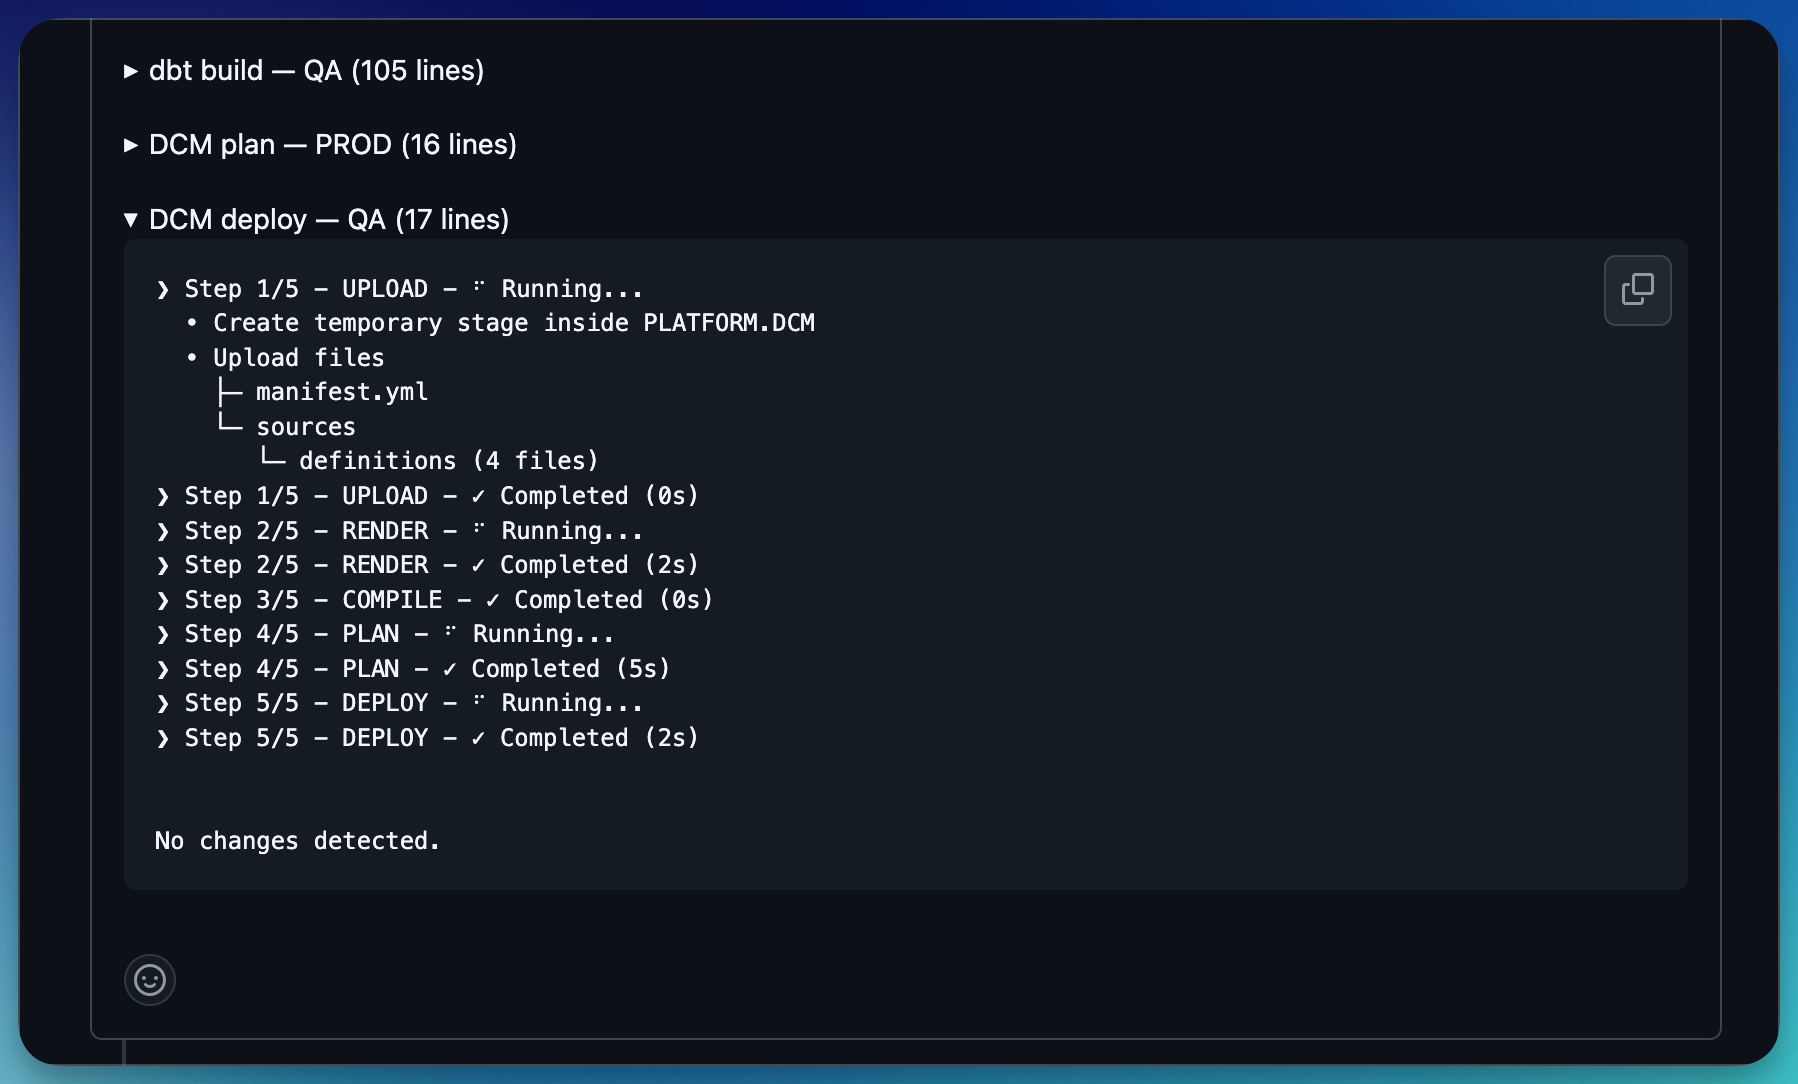
Al hacer merge a main:
- Plan y deploy de
DEV, luegoQAy luegoPROD, en ese orden.
El comentario en el PR es mi parte favorita. Los revisores no tienen que confiar en que un cambio es seguro. Ven exactamente qué le va a pasar a producción, incluido cualquier DROP, antes de hacer clic en merge. Y el job edita su comentario anterior en lugar de agregar uno nuevo, así que un PR con diez pushes sigue teniendo un solo comentario con el plan.
[screenshot: PROD plan posted as a PR comment]
El CI se autentica como un usuario TYPE = SERVICE con autenticación por par de claves. Ese usuario tiene PLATFORM_DEPLOYER y nada más. Cada deploy lleva como alias el commit (main_9fd3c1a), así que cualquier deployment en Snowflake se puede rastrear directamente hasta un merge.
DCM Projects en Snowsight
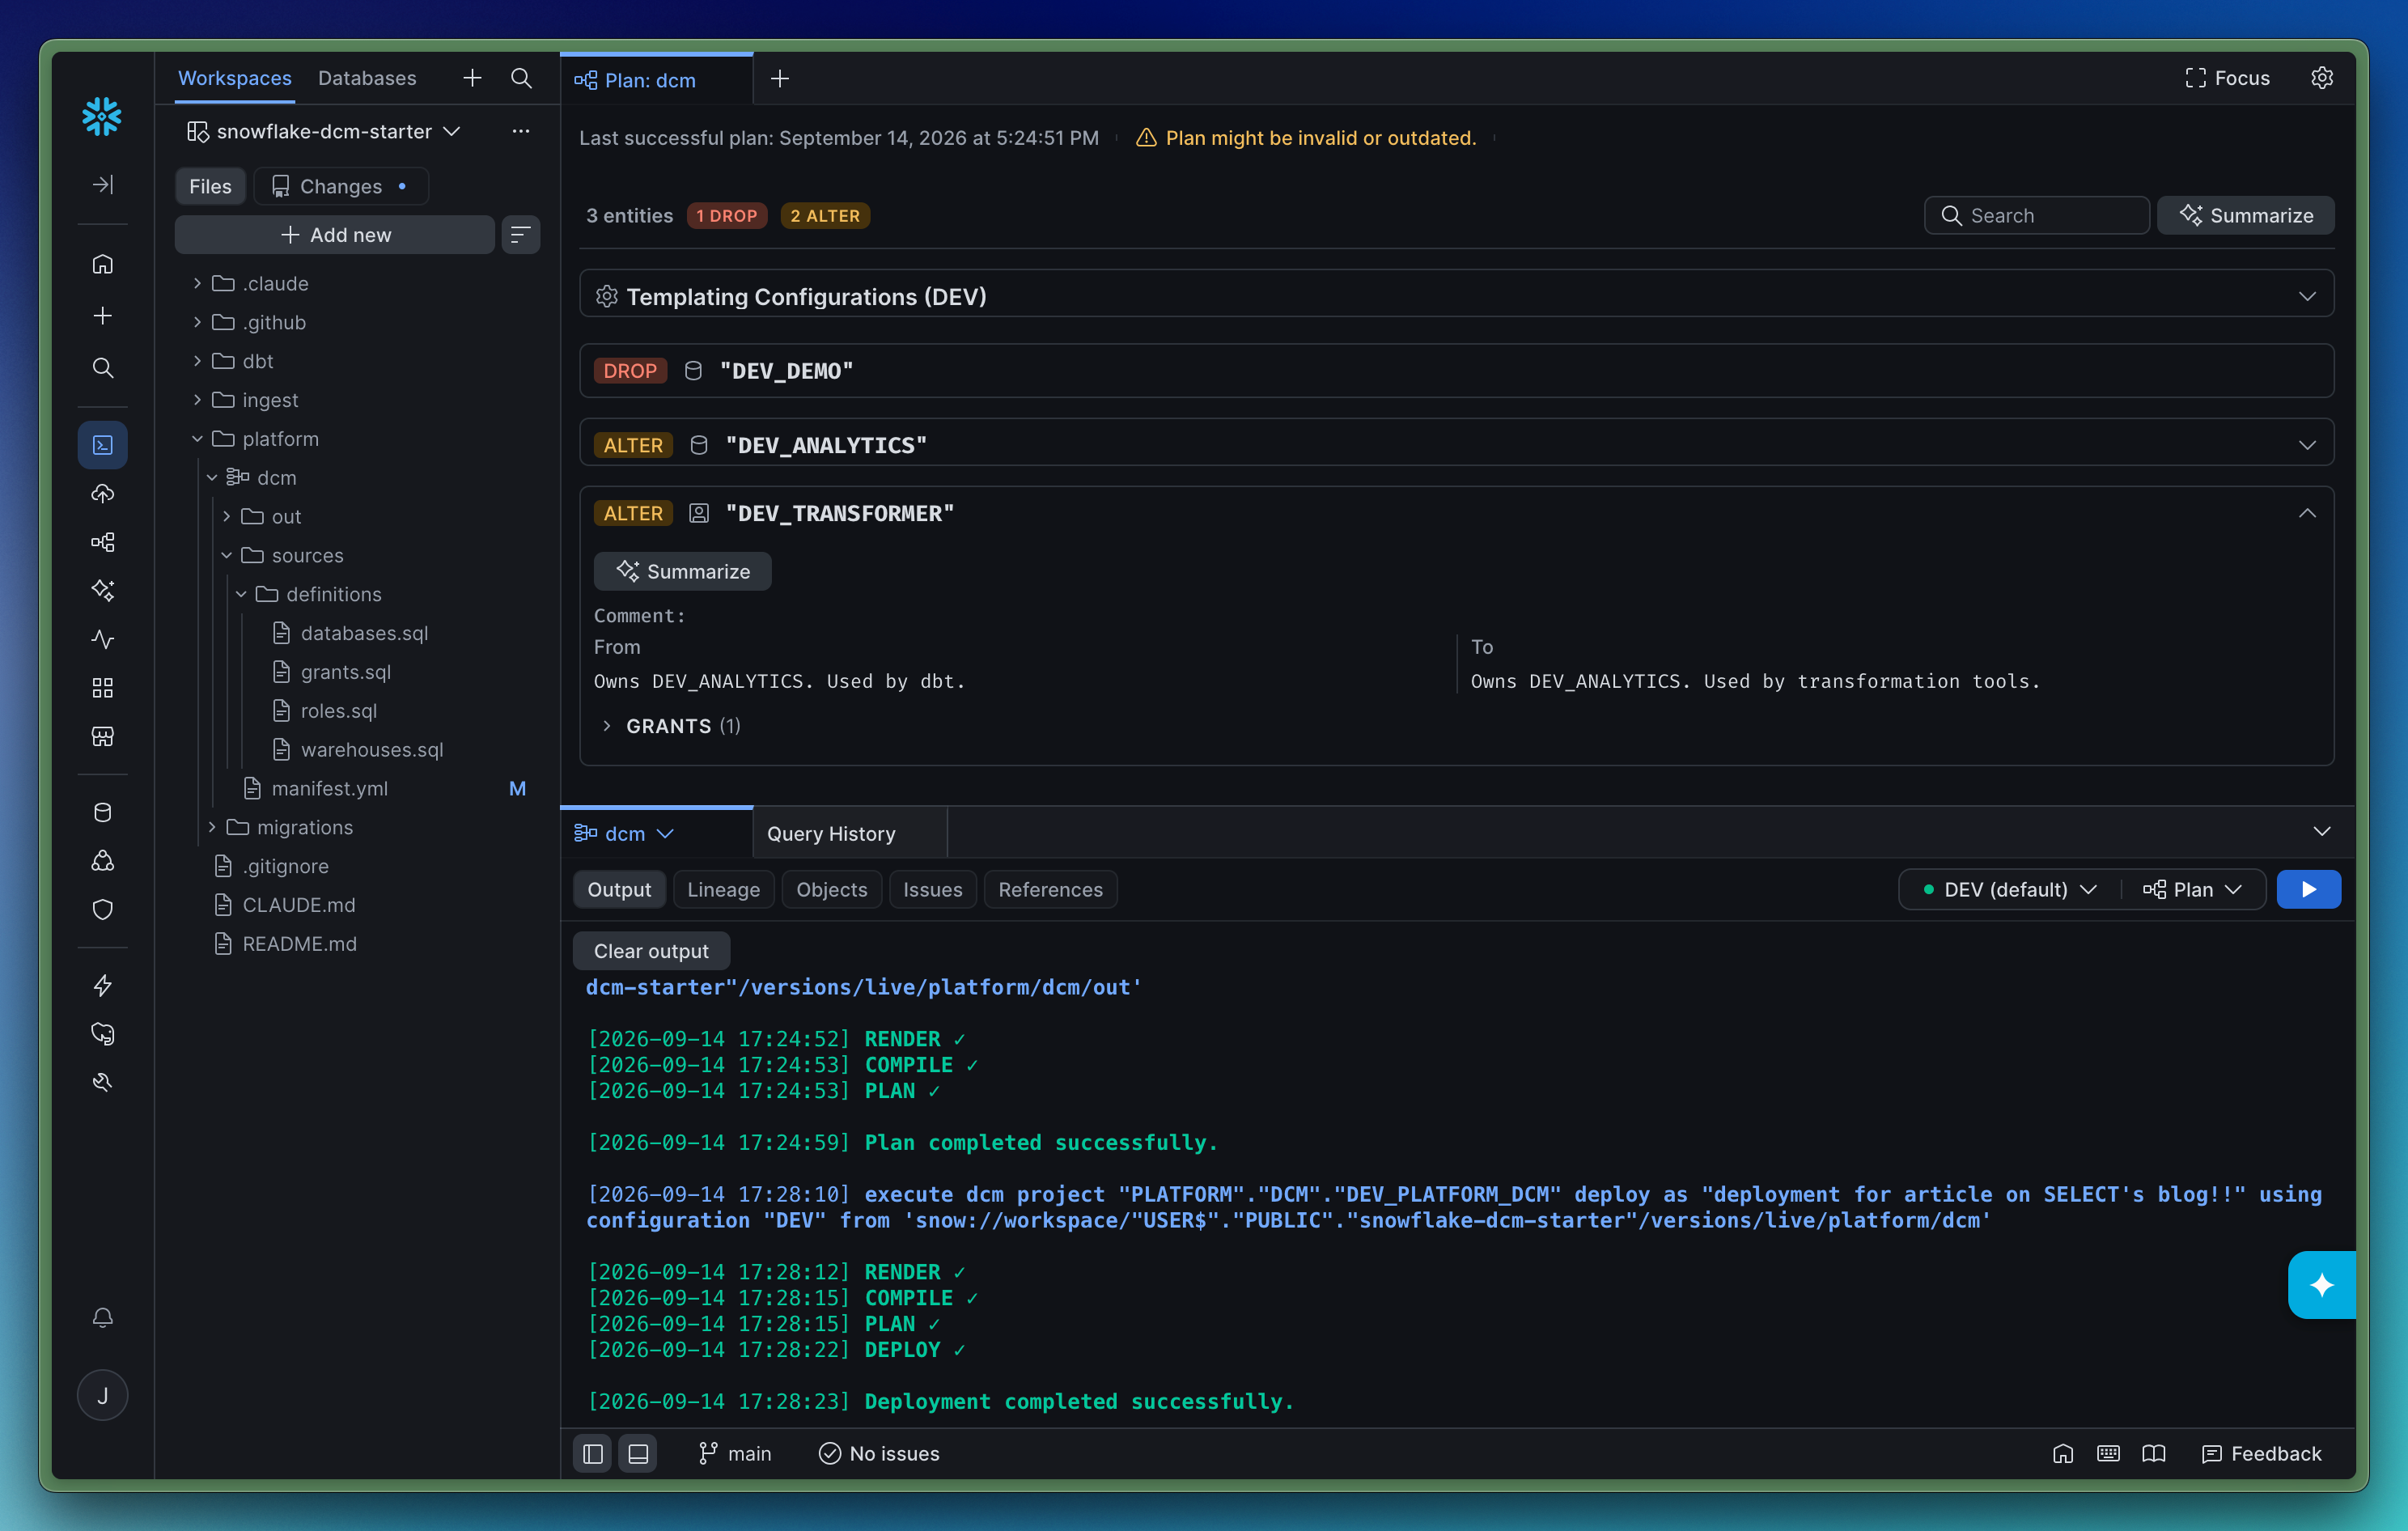
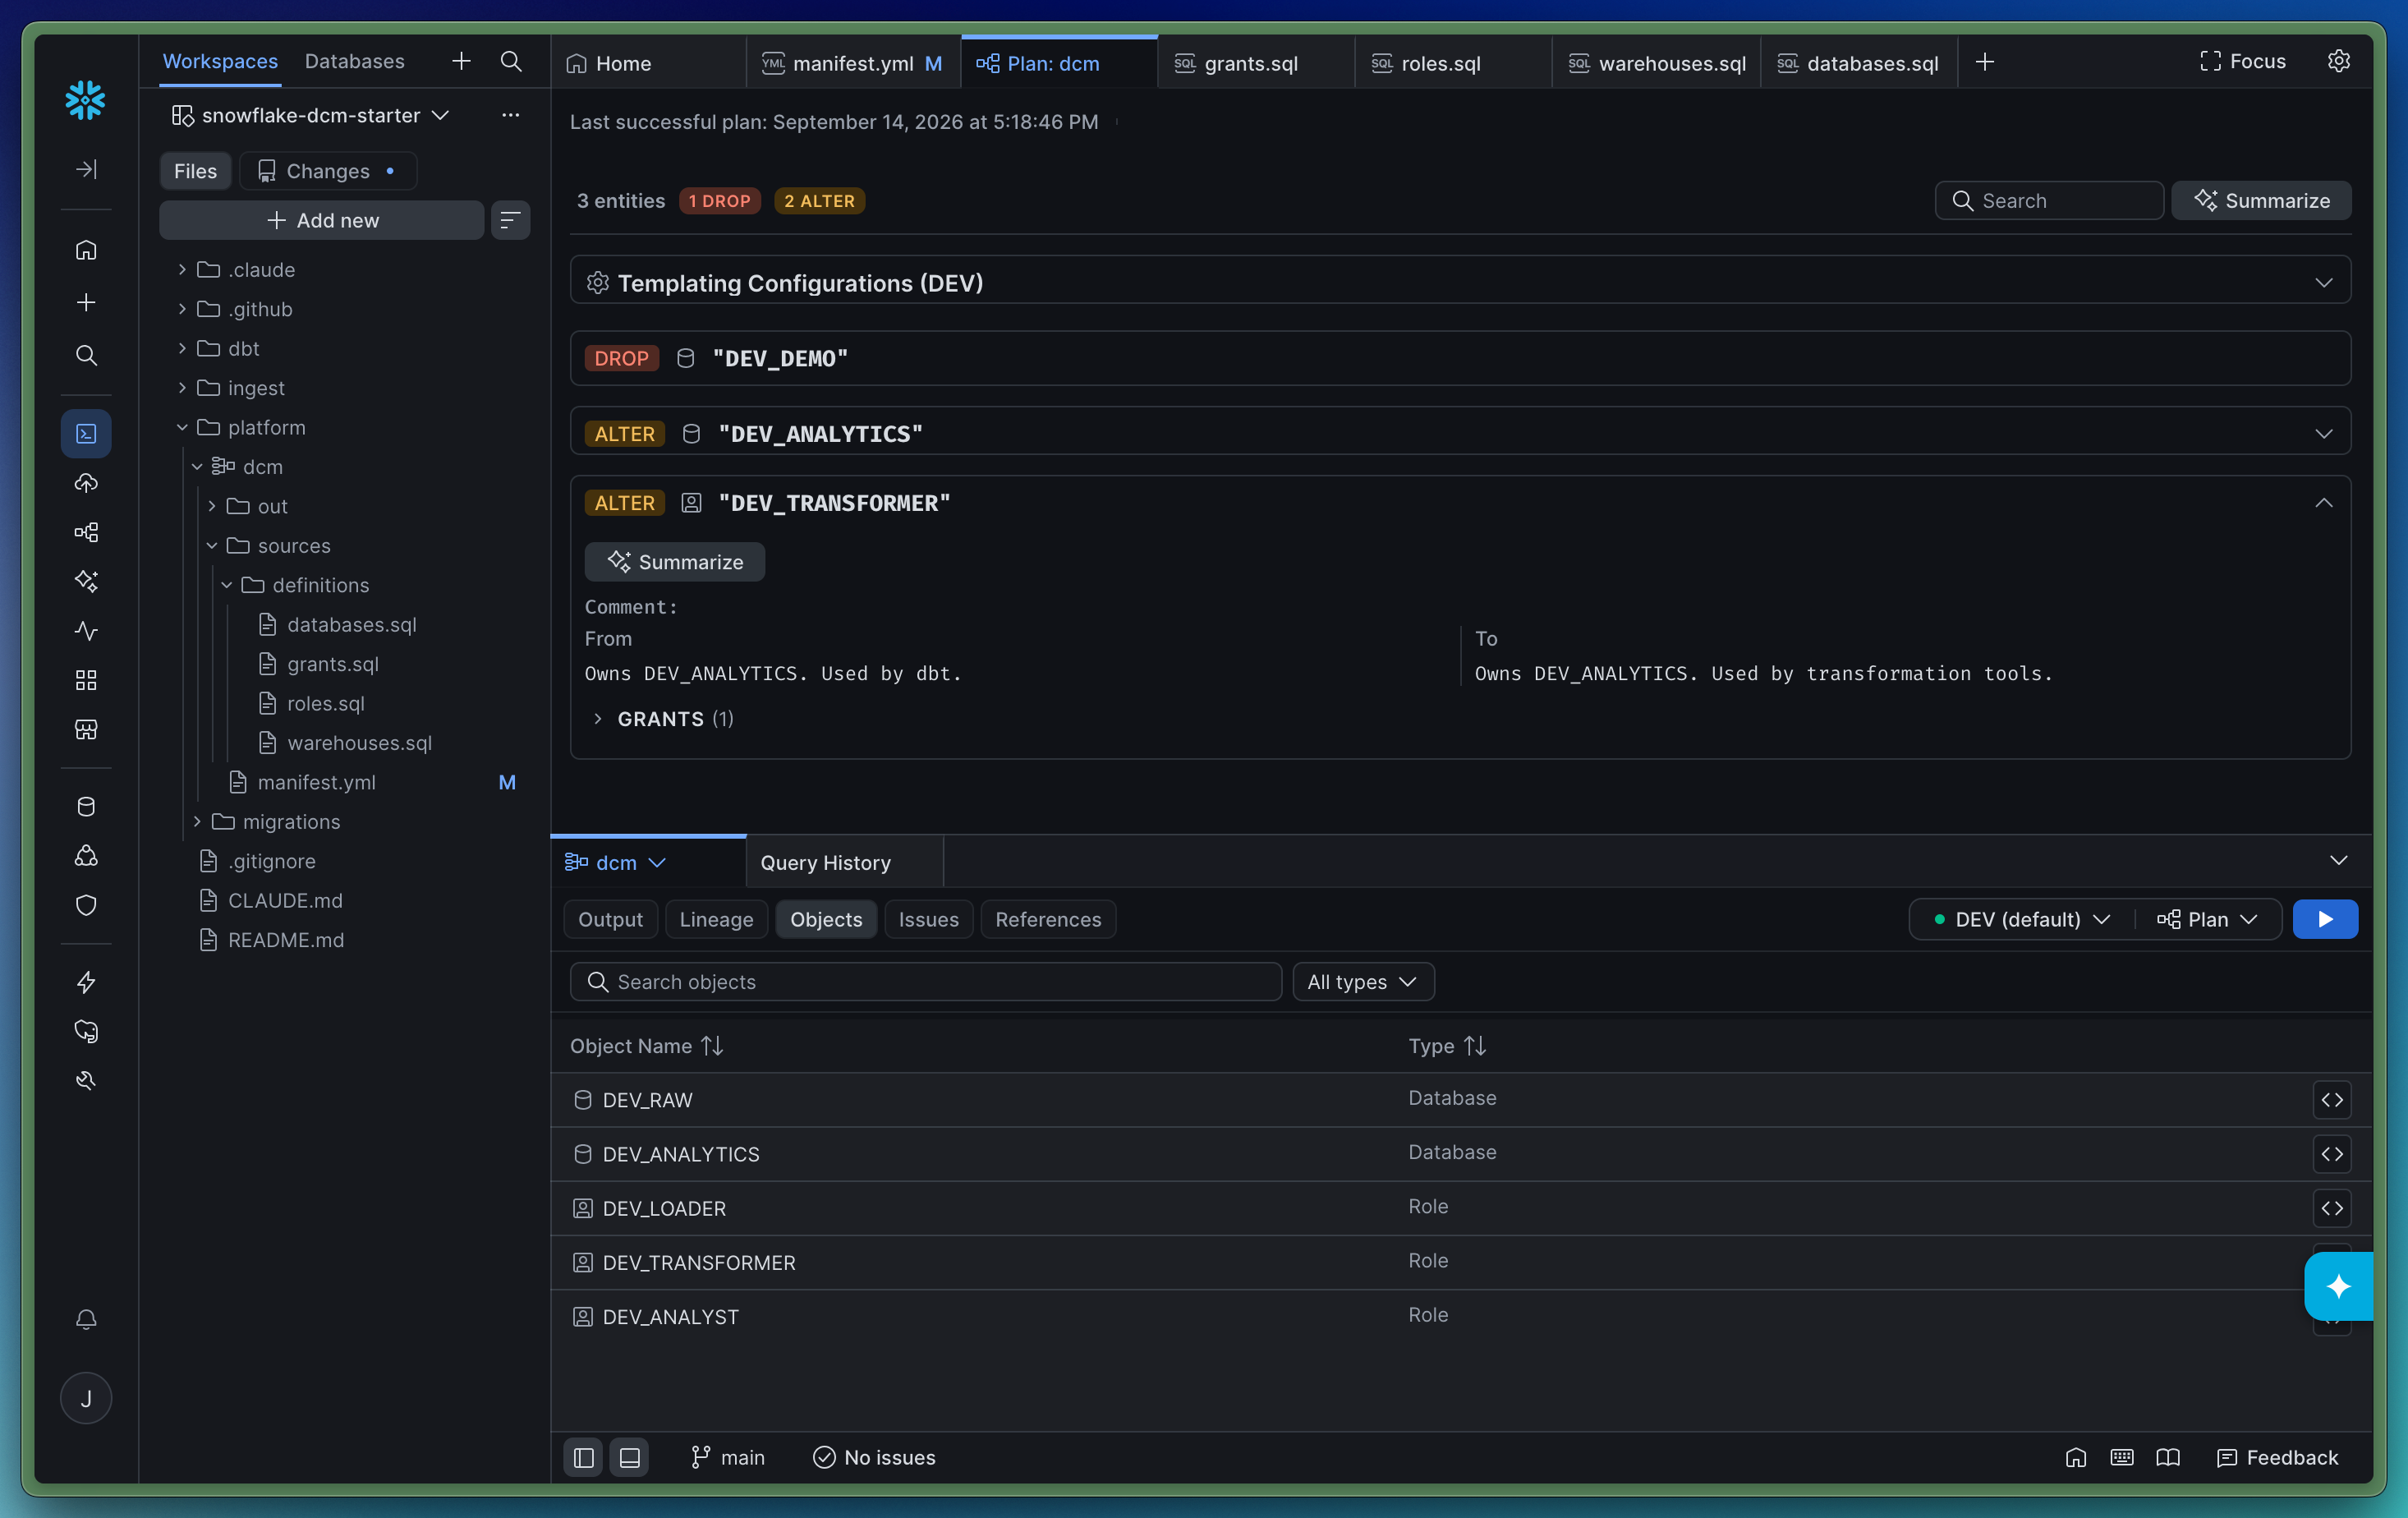
Snowflake Workspaces ofrece una UI muy buena para gestionar, planificar y desplegar proyectos DCM. Sin entrar en demasiados detalles, repasemos algunas capturas de pantalla.
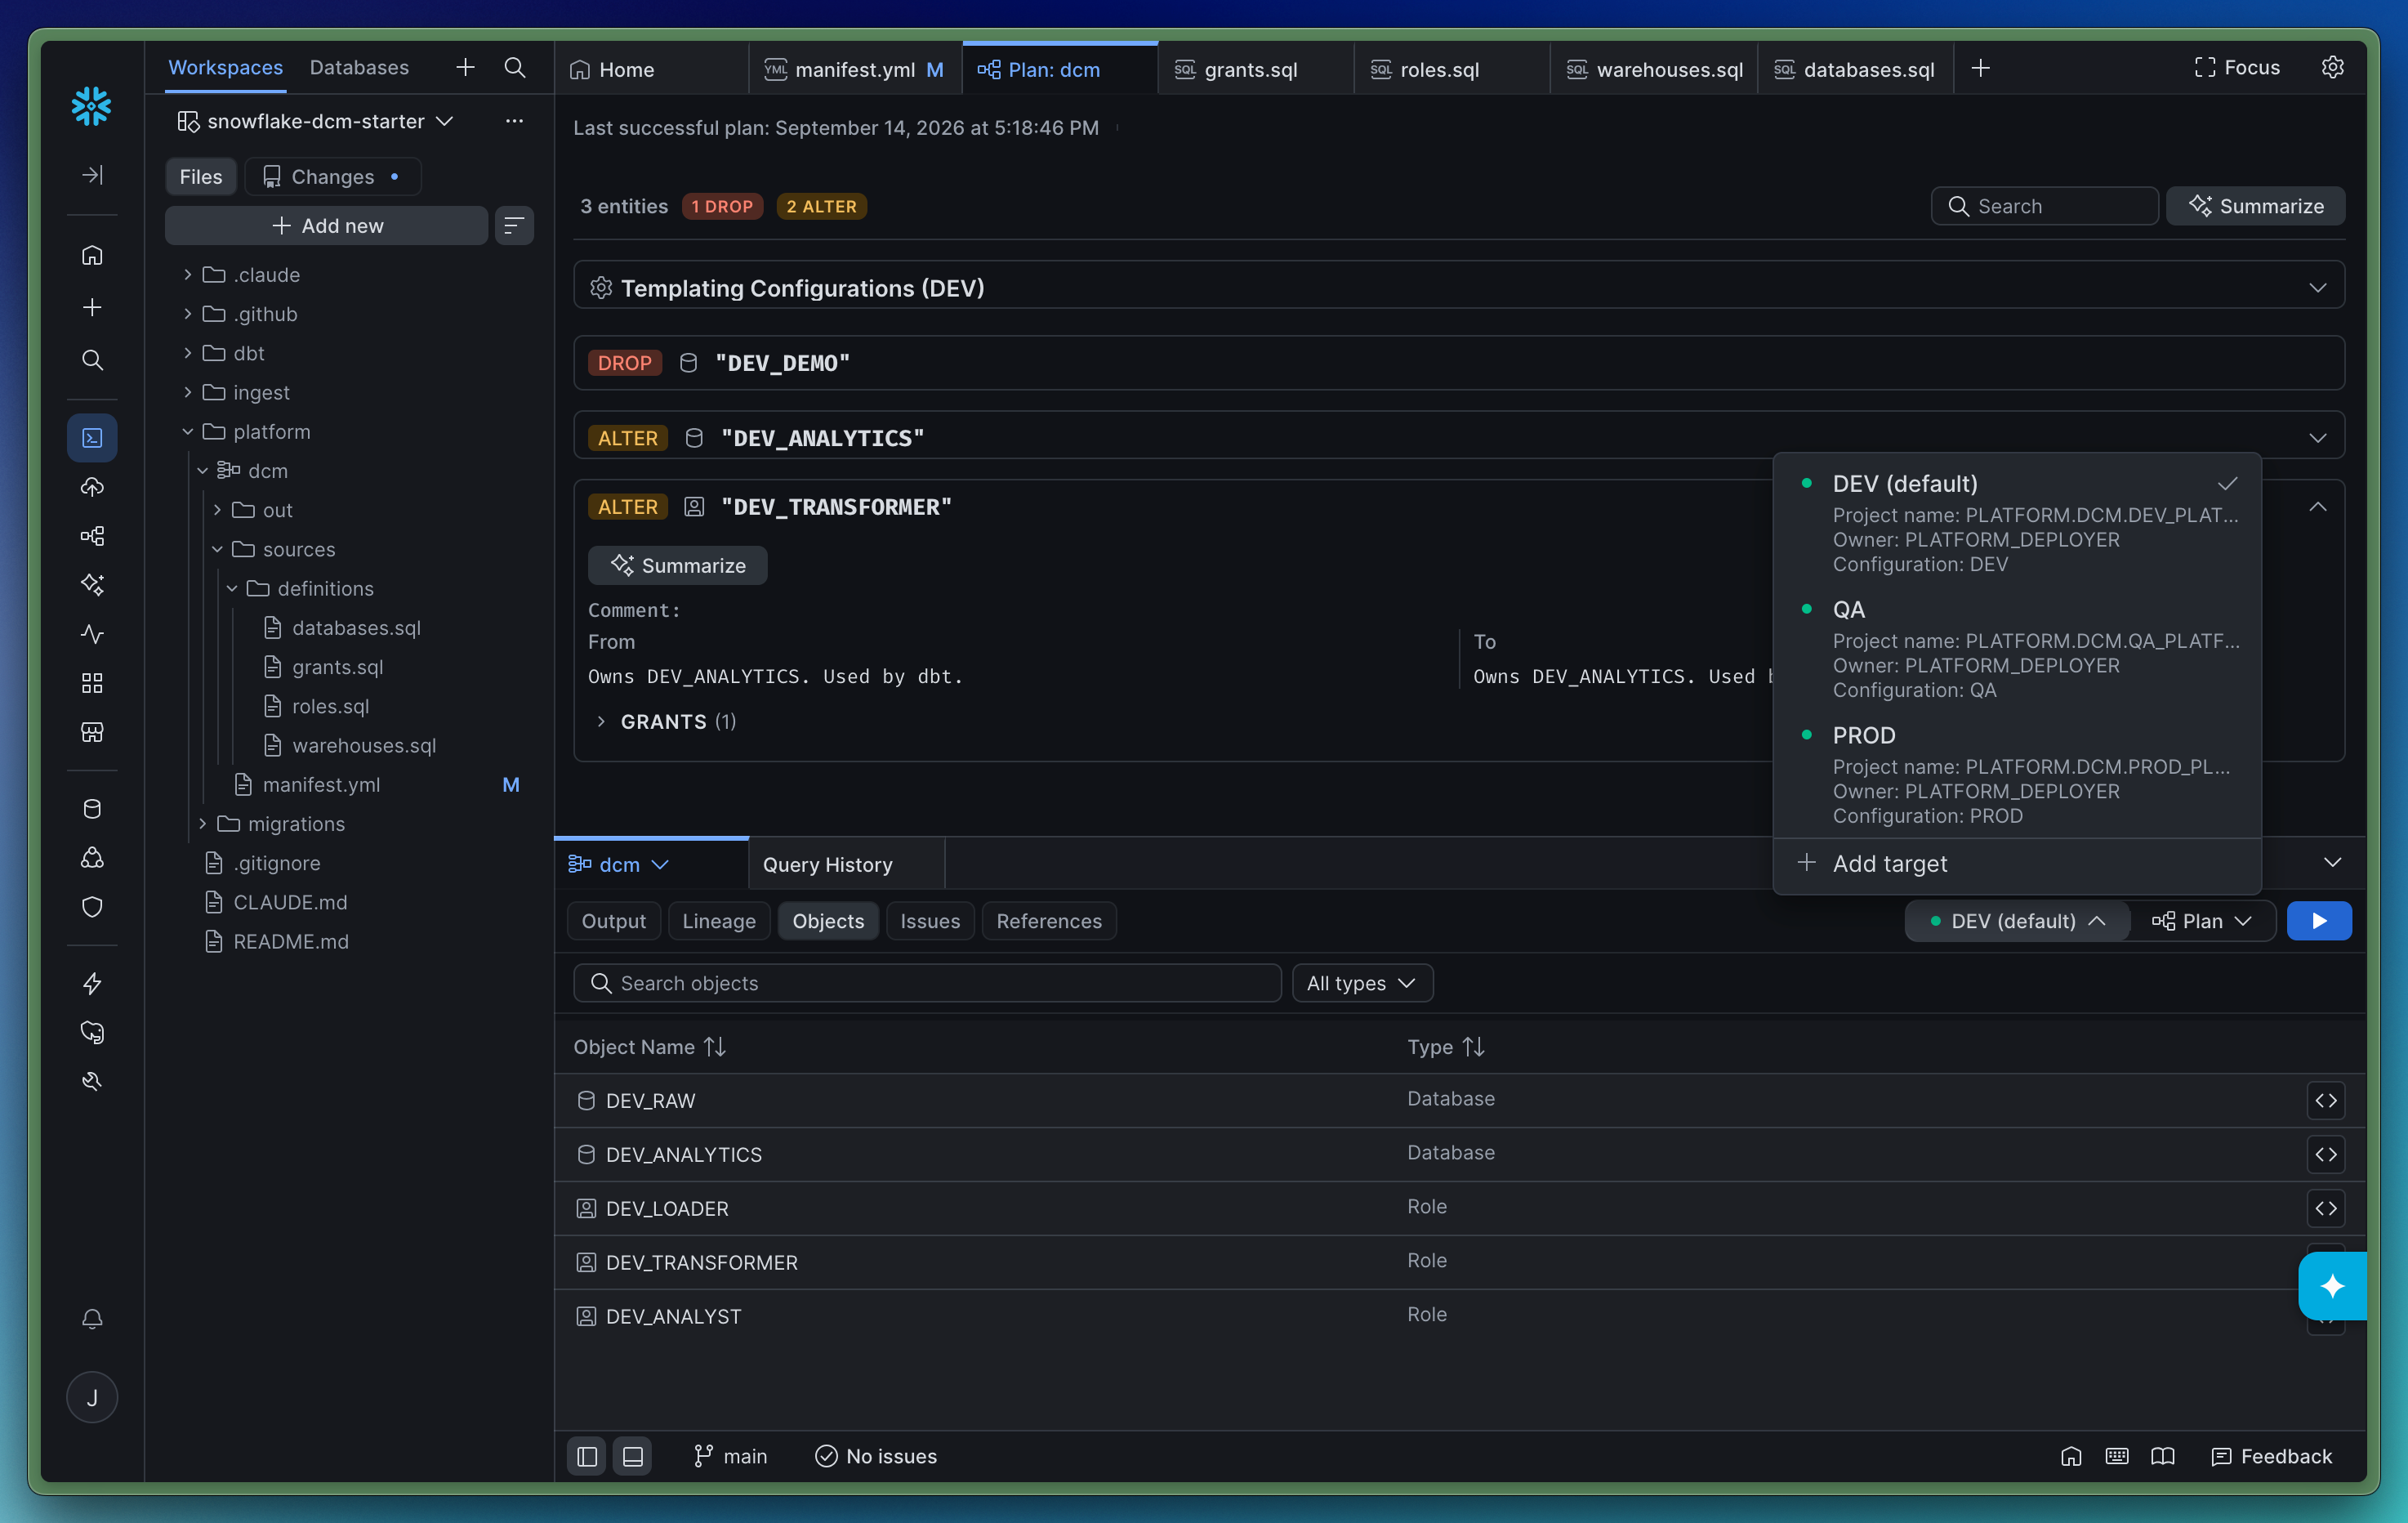
Al ejecutar un plan, se abre una pestaña que lo explica:
Puedes cambiar de entorno con el selector:
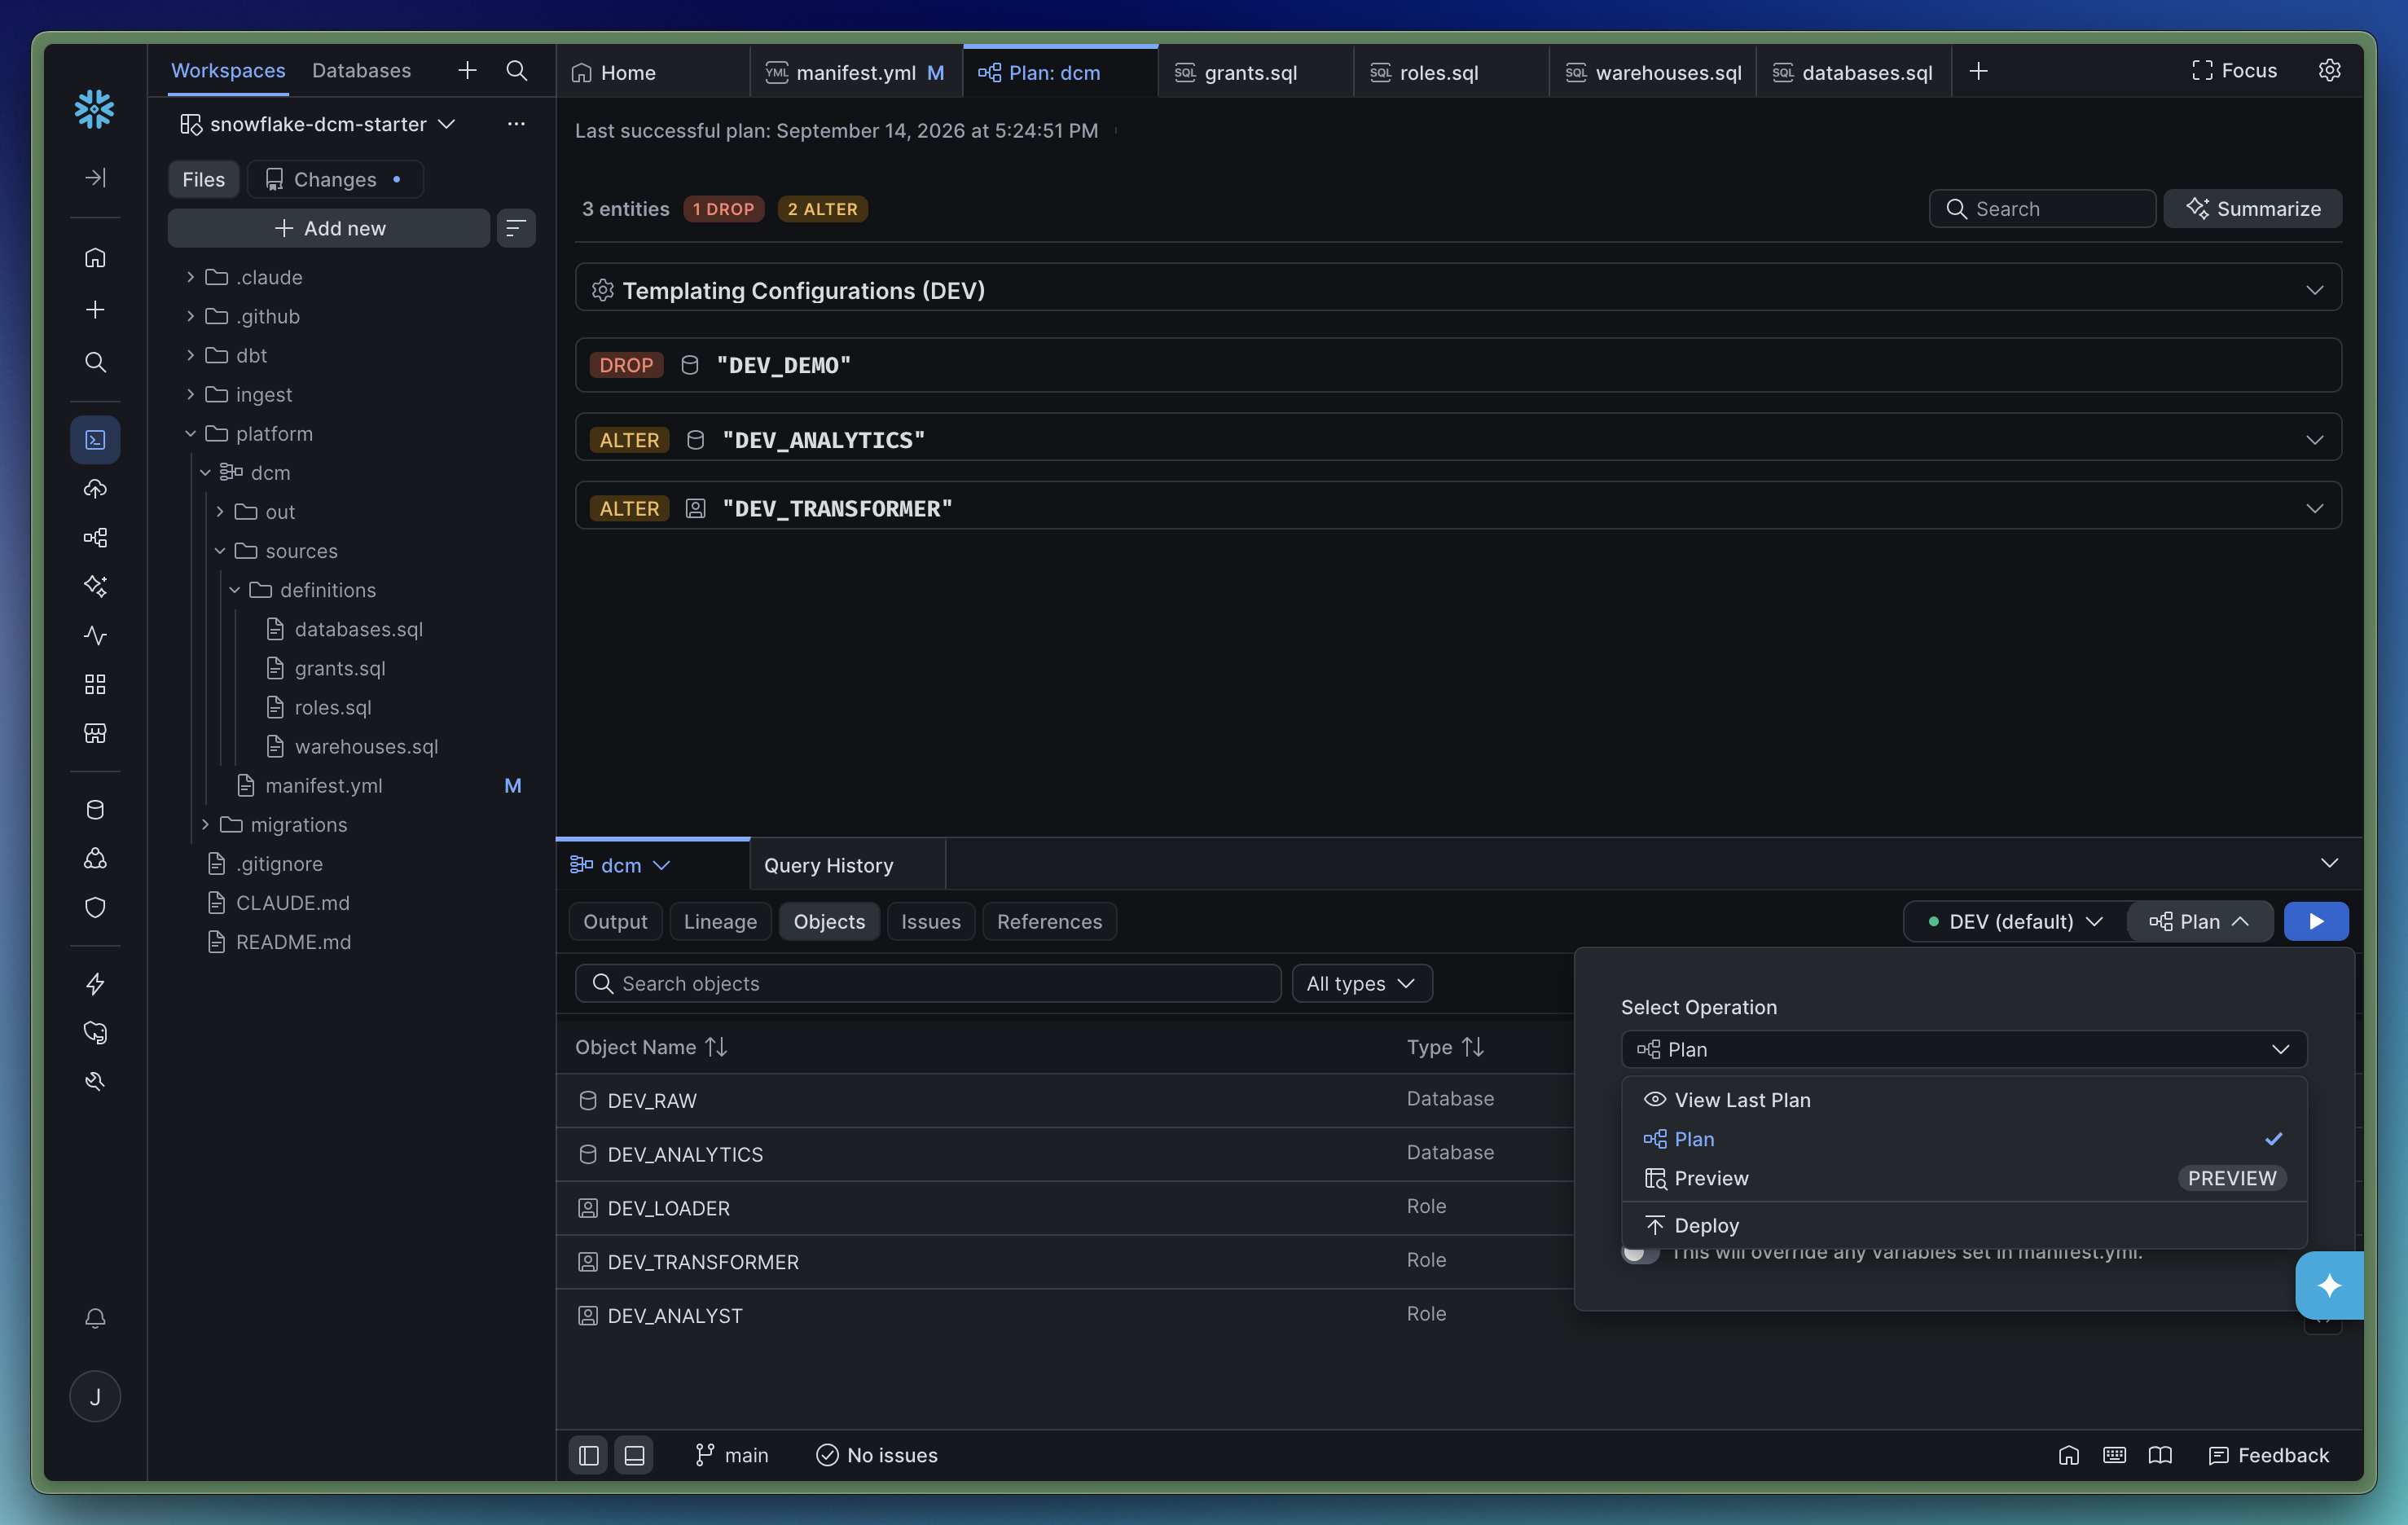
Cuando estés listo para el deploy, solo haz clic en el menú desplegable de Plan y selecciona deploy:
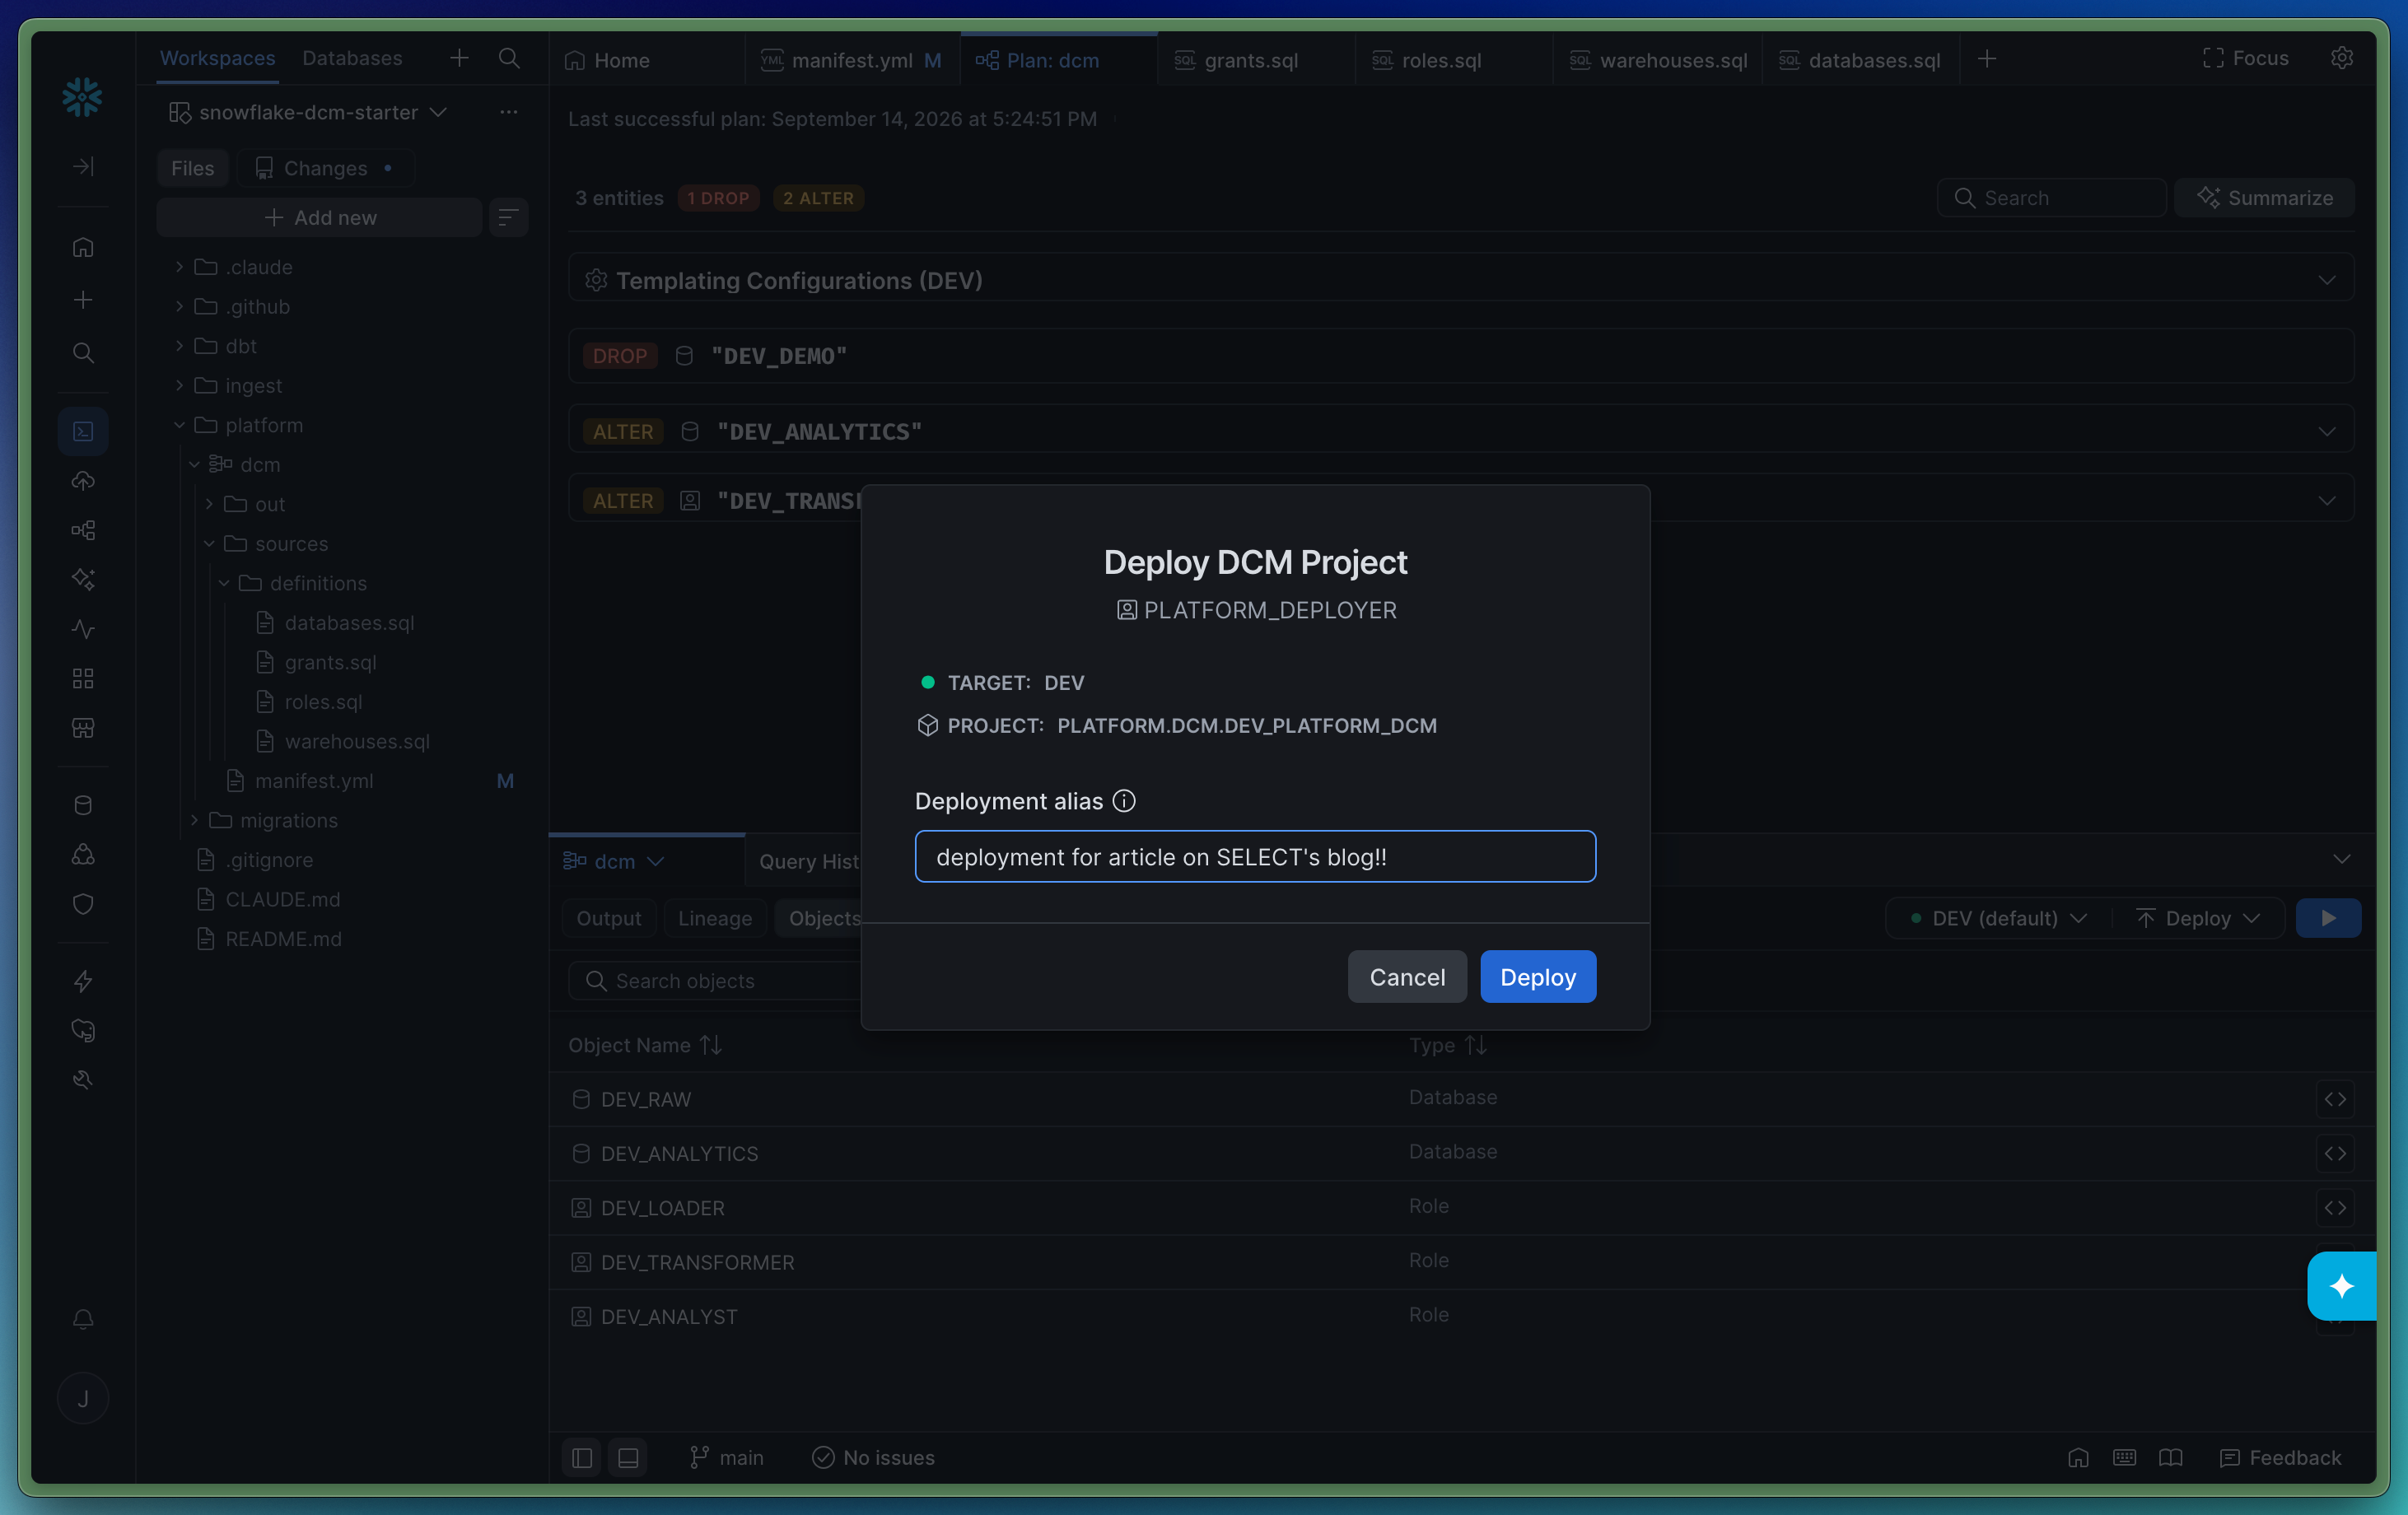
Cuando termina, aparece una notificación en la parte superior central de la pantalla avisándote de que ya se desplegó.
La pestaña Output te muestra la salida de la CLI de todas tus ejecuciones:

Si tuviéramos un DAG de Dynamic Tables o Tasks, aparecerían en la pestaña de linaje, pero este proyecto no contiene ninguno.
Ejecutar DCM de forma local con la CLI
Personalmente, hago todo mi trabajo en Visual Studio Code. Aquí va un repaso rápido de cómo se ve un deployment en VS Code. dcm es un subcomando del comando snow de la CLI. Así que, mientras tengas instalada la CLI de snow, ¡ya tienes DCM! Aquí muestro snow dcm plan y snow dcm deploy en una sola captura.
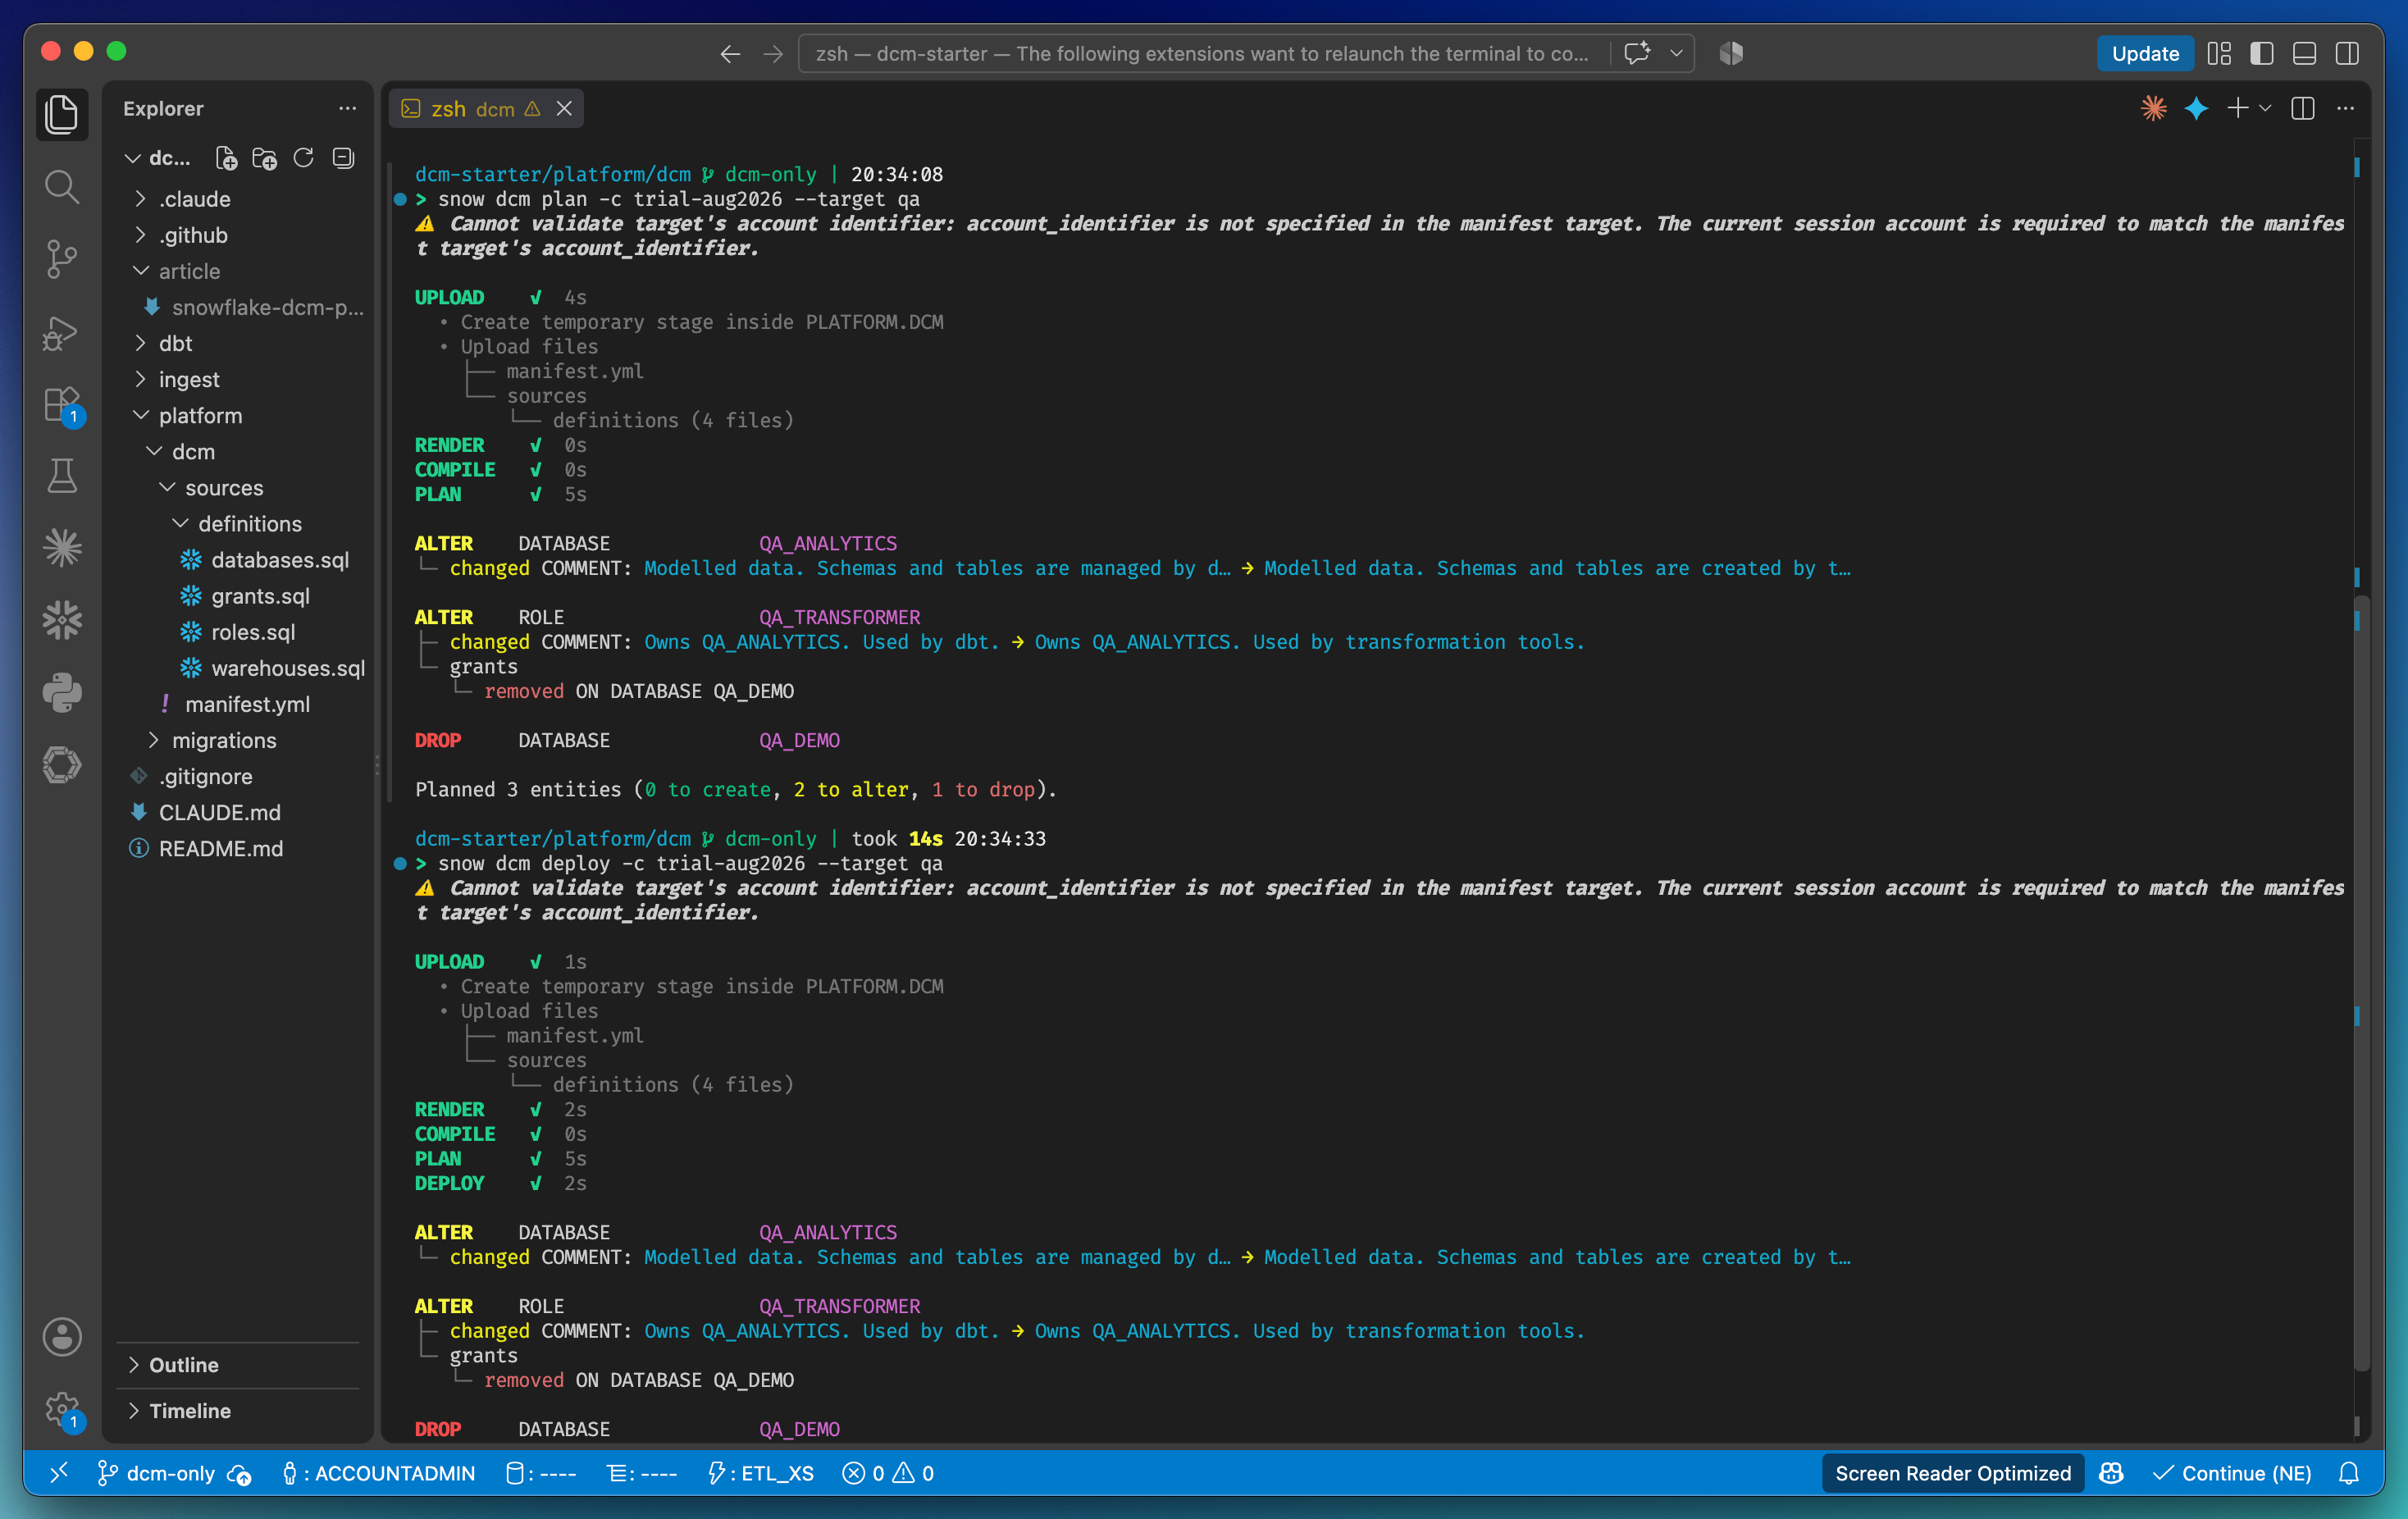
Ahora puedo iterar sobre los archivos de forma local, desplegar en mi entorno de dev y abrir un PR que hará el plan y el deploy de QA y ejecutará el plan contra prod. ¡Un flujo de trabajo muy cómodo para desarrolladores!
DCM vs. las alternativas
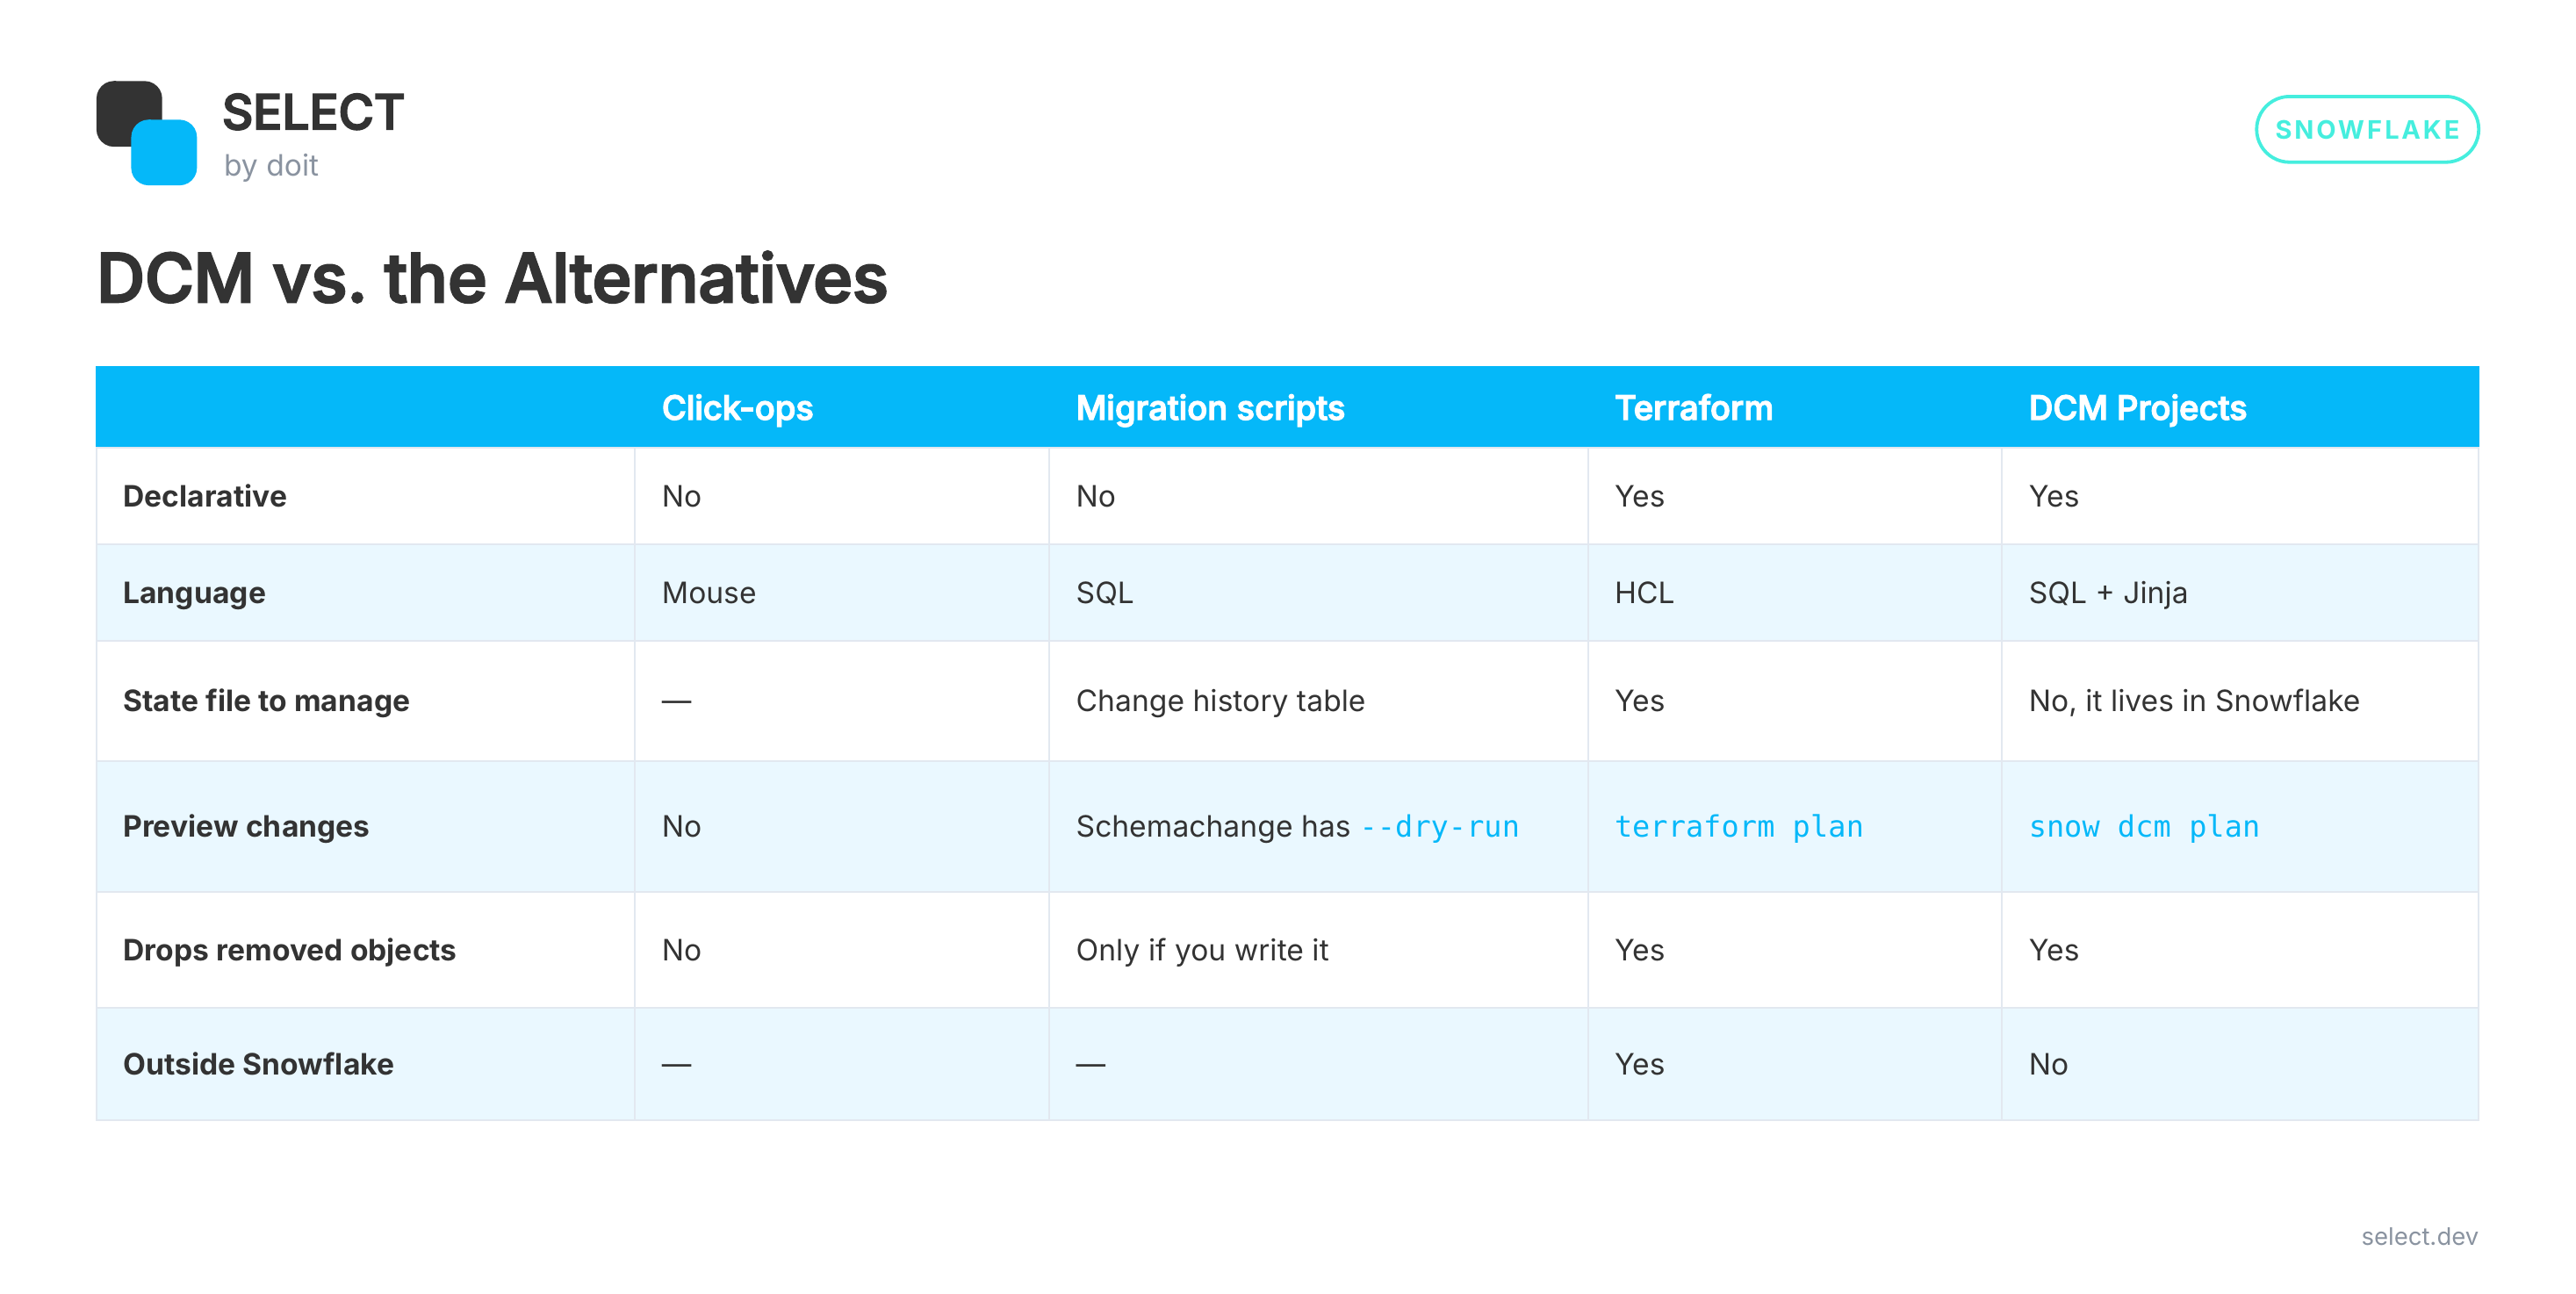
Si gestionas AWS, Snowflake y tu DNS en un solo repo de Terraform, Terraform sigue teniendo sentido. Si la infraestructura de tu equipo es básicamente Snowflake y tu equipo ya habla SQL, DCM es el camino con menos fricción que he encontrado.
Pruébalo tú mismo
Puse todo esto en un repo inicial: https://github.com/jeff-skoldberg-gmds/snowflake-dcm-starter.
Incluye las definiciones, las migraciones de bootstrap, ambos workflows de GitHub Actions y skills de Claude Code. Ejecuta /project-setup y te guía por la cuenta, el manifest, el bootstrap, el primer deploy y el CI, un paso verificado a la vez.
También tiene carpetas ingest/ y dbt/ vacías, porque DCM es solo la base. Deberías construir un monorepo para tu plataforma de Snowflake que incluya la carga y la transformación de datos. Los roles y las bases de datos están esperando tus pipelines.
¡Ahora ve a probarlo y cuéntame si la infraestructura como código en Snowflake todavía se siente como una tarea tediosa!x`