
TLDR
- I DCM Projects sono il modo nativo e dichiarativo di Snowflake per gestire gli oggetti come codice. Scrivi
DEFINE <object>invece diCREATE <object>(ad esempioDEFINE DATABASE) e Snowflake capisce da solo cosa deve cambiare. - Il ciclo è: modifichi le definizioni, plan, poi deploy. Il plan è un diff in sola lettura. Il deploy lo applica.
- DCM elimina ciò che smetti di definire. Cancelli una riga, perdi un database. Leggi il plan.
- Un
manifest.ymlpiù Jinja ti dannoDEV,QAePRODda un unico set di file. - DCM può gestire tabelle e viste, ma secondo me non dovrebbe se usi già dbt. Lascia che DCM si occupi della piattaforma (ruoli, database, warehouse, grant) e che dbt si occupi di ciò che sta dentro i database.
- Il design di ruoli e database viene dalla guida di setup di Snowflake di dbt Labs, seguita da centinaia di progetti dbt. Il repo introduce qualche miglioramento e la trasforma in codice.
- Ecco il repo GitHub su cui si basa questo articolo, con CI/CD via GitHub Actions che non tocca mai
ACCOUNTADMIN.
Come siamo arrivati fin qui
Se usi Snowflake da un po', probabilmente hai gestito l'infrastruttura del tuo account in uno di questi tre modi:
- Click-ops. Qualcuno con
ACCOUNTADMINcrea un oggetto in Snowsight un martedì qualsiasi. Nessuno ricorda perché. Tre anni dopo nessuno osa eliminarlo. - Script di migrazione:
V1__create_roles.sql,V2__grant_things.sql,V47__fix_the_grant_from_V2.sql. Strumenti come schemachange li eseguono in ordine. Funziona, ma lo "stato attuale" del tuo account è la somma di 47 file, e buona fortuna a leggerla. - Terraform. Dichiarativo e potente. Ma porta con sé HCL, un provider da tenere aggiornato e uno state file da archiviare, bloccare e su cui, ogni tanto, fare interventi chirurgici. Per molti team dati è una disciplina tutta nuova solo per creare un warehouse.
I DCM Projects sono la risposta di Snowflake a tutto questo. Ottieni il modello dichiarativo di Terraform, ma il linguaggio è SQL e lo stato vive in Snowflake.
Il blueprint: le istruzioni di grant che tutti hanno copiato
Prima di entrare nel vivo di DCM, un doveroso riconoscimento. Se hai configurato Snowflake per dbt, è molto probabile che tu abbia letto Setting up Snowflake — the exact grant statements we run di Claire Carroll sul Discourse di dbt. Centinaia di progetti dbt sono stati configurati seguendo quello schema. Io stesso l'ho seguito più volte di quante riesca a contare.
Il design è semplice, ed è per questo che funziona:
- Un database
rawper i dati in ingresso e un databaseanalyticsper i dati modellati. - Un ruolo
loaderche scrive inraw, un ruolotransformerche leggerawe costruisceanalytics, e un ruoloreporterche leggeanalyticse nient'altro. - Future grants, così i nuovi schemi e le nuove tabelle sono leggibili senza che nessuno muova un dito.
Il problema non è mai stato il design. Il problema è che si tratta di una lista di istruzioni che incolli in un worksheet una sola volta. Sei mesi dopo nessuno sa dire se l'account le rispecchia ancora, e l'estensione per l'"ambiente dev" in fondo al post è lasciata come esercizio al lettore.
Il repo starter mantiene quindi l'impostazione di Claire e cambia alcune cose:
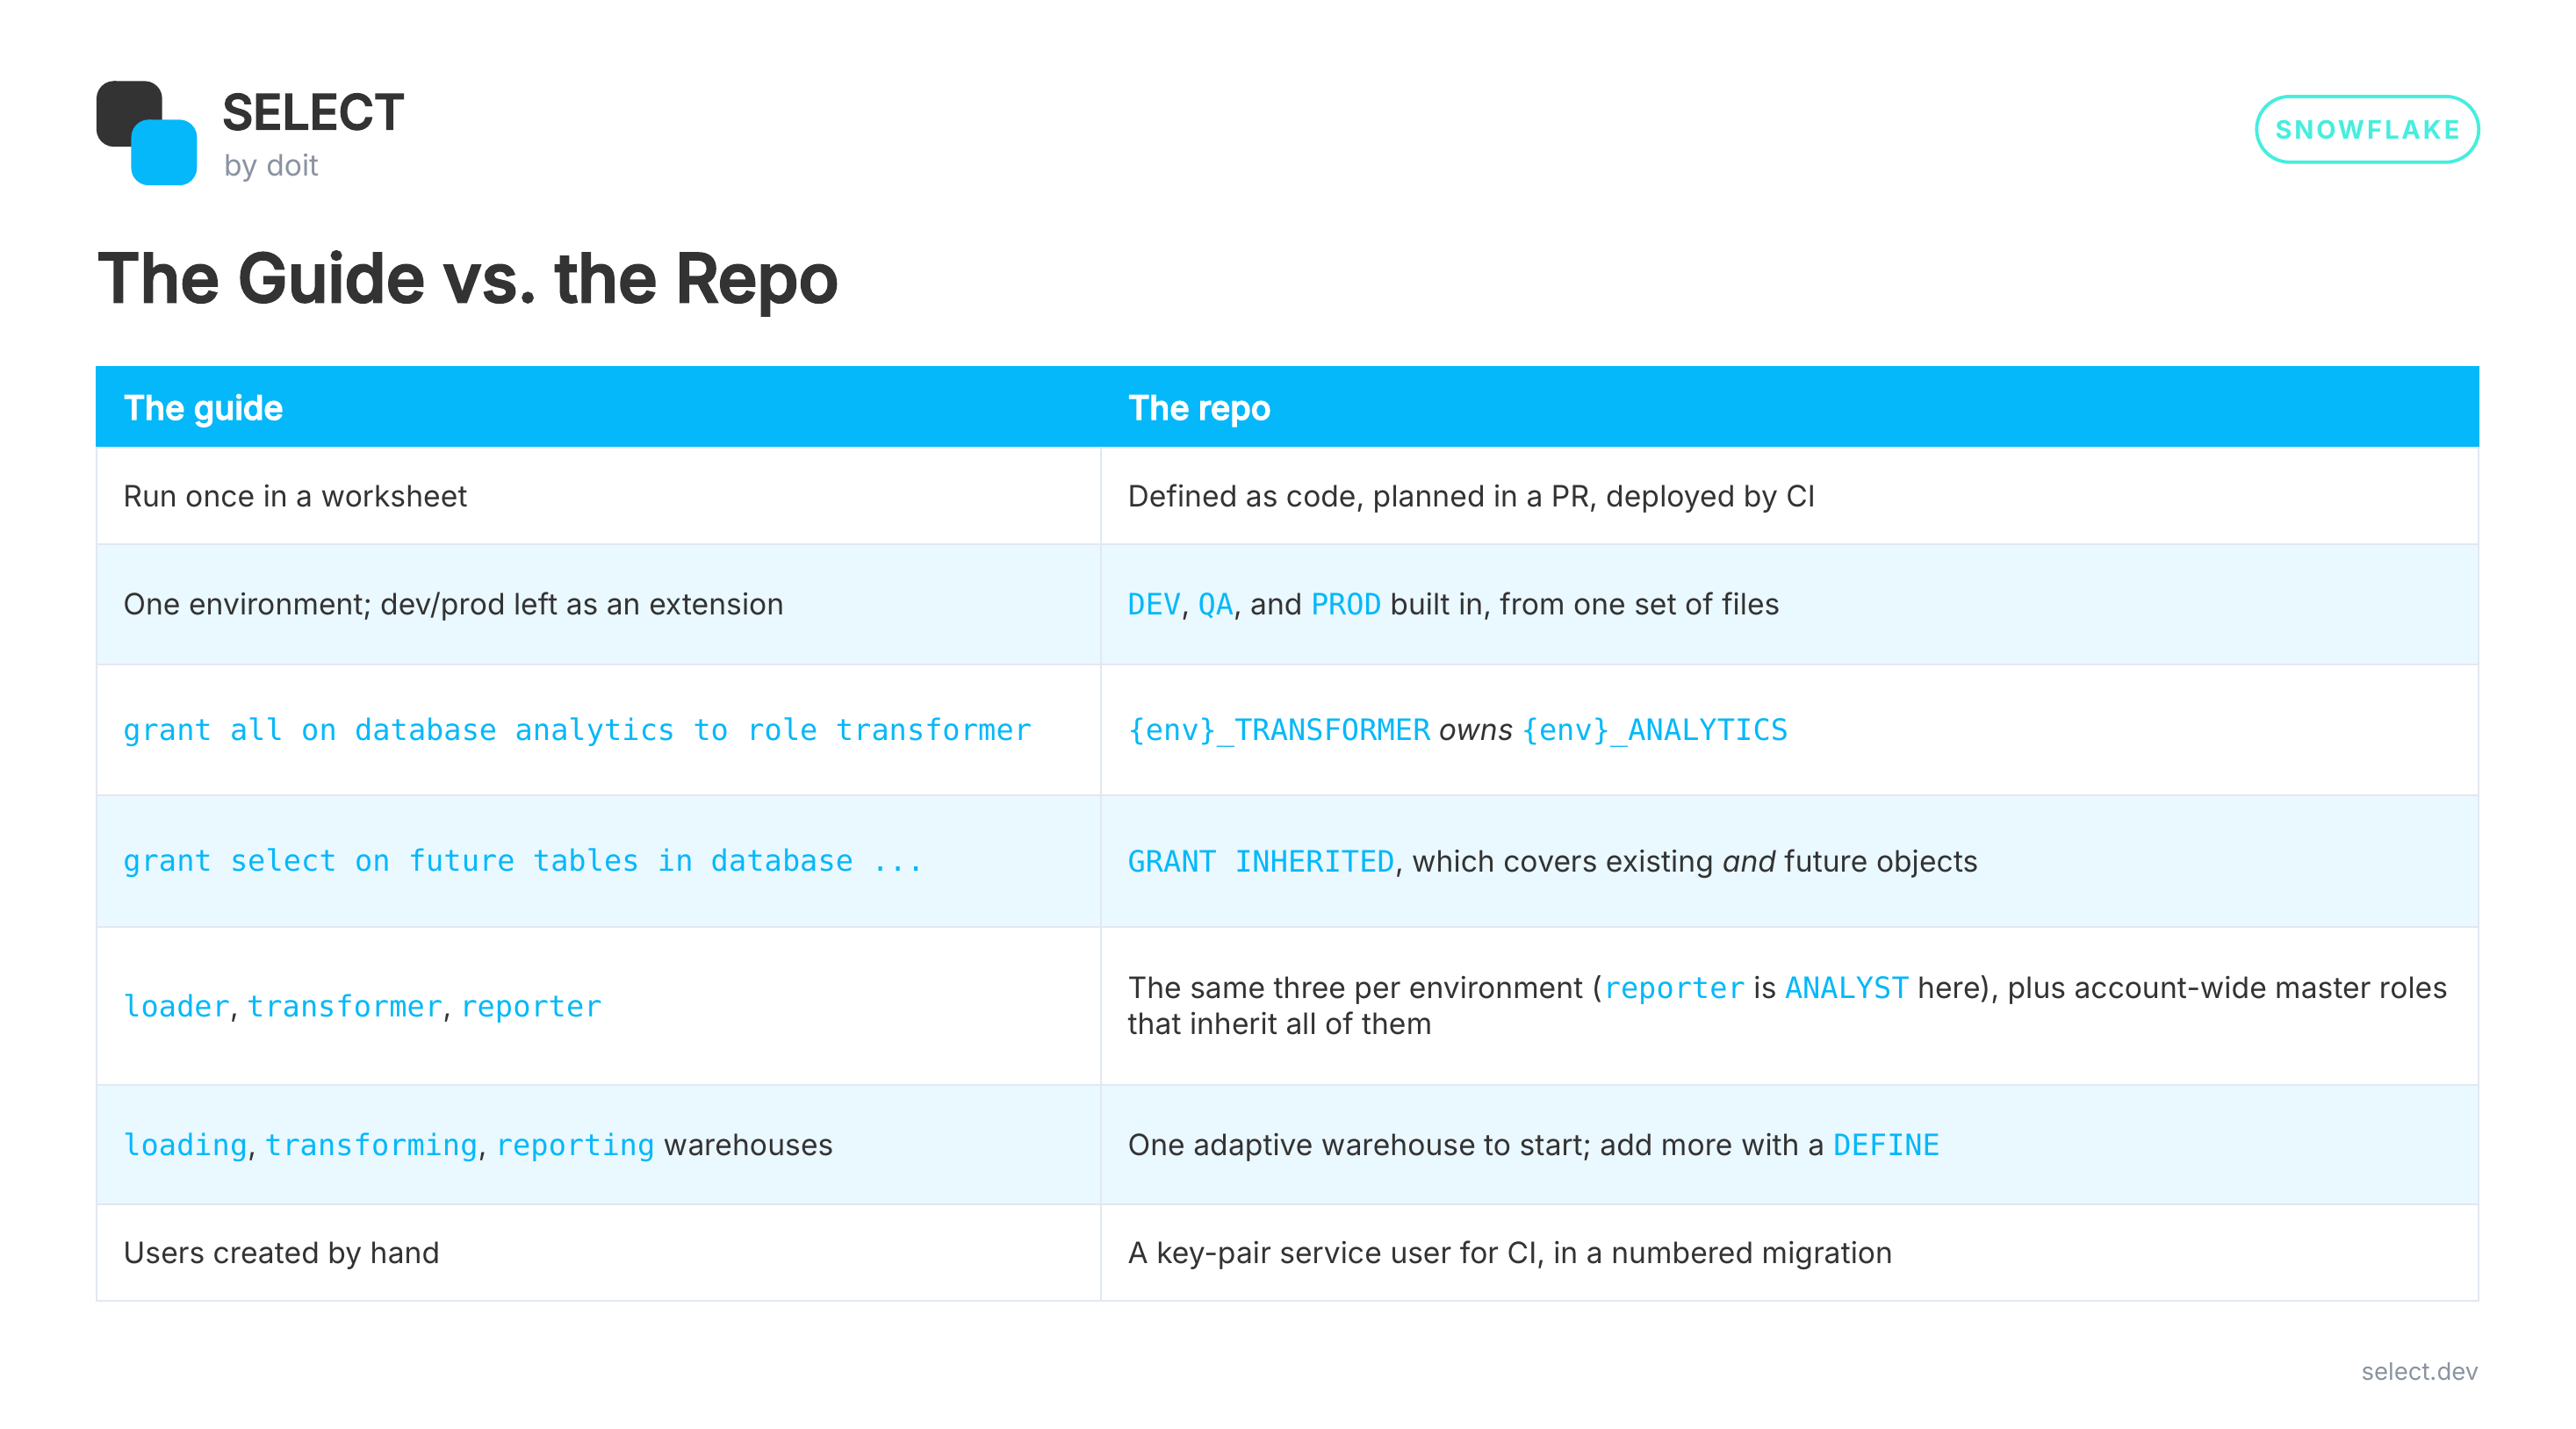
Perché gli inherited grants sostituiscono i future grants
La riga sui grant è il cambiamento più importante, quindi approfondiamo.
I future grants sono stati lo strumento giusto per molto tempo! Sono ciò che rende il setup di Claire a bassa manutenzione. Ma hanno tre problemi, e chiunque abbia gestito Snowflake per qualche anno ne ha incontrato almeno uno:
- Coprono solo il futuro. Un future grant non fa nulla per le tabelle che esistono già, quindi ogni setup lo abbina a un'istruzione
grant select on all tables. Sono due istruzioni per privilegio, e due cose da ricordare. - I future grants a livello di schema sovrascrivono quelli a livello di database. Se qualcuno aggiunge un future grant su uno schema, Snowflake ignora i future grants a livello di database per quello schema. Il tuo ruolo
reportersmette silenziosamente di ricevere le nuove tabelle lì, e non viene segnalato alcun errore. - Sono una copia una tantum, non una regola. Un future grant viene applicato a ciascun oggetto al momento della creazione. Se poi revochi o modifichi il future grant, tutti gli oggetti già toccati mantengono il vecchio privilegio. Il grant che vedi non descrive più l'accesso che le persone hanno davvero.
Un inherited grant è un'unica istruzione su un contenitore (l'account, un database o uno schema) e si applica a ogni oggetto corrispondente al suo interno, esistente e futuro:
GRANT INHERITED SELECT ON ALL TABLES IN DATABASE {{ env }}_ANALYTICS TO ROLE {{ env }}_ANALYST;Questa riga sostituisce in blocco il future grant, il grant on all e la versione per singolo schema di entrambi. Quando vuoi sapere perché qualcuno può leggere una tabella, SHOW GRANTS ha le colonne IS_INHERITED e INHERITED_FROM che puntano al grant responsabile.
È anche una scelta naturale per DCM. Uno strumento dichiarativo vuole una sola riga che enuncia la regola. "Gli analisti possono leggere tutto in ANALYTICS" ora è una riga, non sei.
Alcuni compromessi da conoscere:
- Niente eccezioni. Non puoi revocare il privilegio su una singola tabella per escluderla. La documentazione di Snowflake avverte che la revoca sembra riuscire, mentre il ruolo mantiene l'accesso tramite l'inherited grant. Se una tabella richiede un accesso diverso, deve stare in uno schema o in un database diverso.
- Spostare o clonare un oggetto in un contenitore cambia chi può vederlo, senza alcuna istruzione
GRANTda nessuna parte. È proprio questo il punto, ma presta attenzione ai cloni. OWNERSHIPnon può essere ereditato. L'ownership resta un grant normale.- Richiede un flag a livello di account,
FEATURE_RBAC_INHERITED_GRANTS, che soloACCOUNTADMINpuò impostare. Ne parliamo nel bootstrap qui sotto.
Che cos'è un DCM Project in Snowflake?
Due cose:
- Una cartella di file. Un
manifest.ymle alcuni file.sqlpieni di istruzioniDEFINE. - Un oggetto DCM project in Snowflake. Vive in uno schema come qualsiasi altro oggetto e conserva la cronologia dei deployment.
Ecco la struttura dal mio repo starter:
platform/ dcm/ manifest.yml sources/definitions/ roles.sql databases.sql warehouses.sql grants.sql migrations/ 000_bootstrap.sql 001_ci_deployer.sqlUn file per tipo di oggetto è una mia convenzione, non una regola di DCM. Snowflake legge tutto ciò che sta sotto sources/, quindi organizzalo come preferisci.
DEFINE, non CREATE
Il cambio di mentalità sta tutto qui. Con uno script di migrazione scrivi istruzioni:
CREATE ROLE IF NOT EXISTS DEV_LOADER;ALTER ROLE DEV_LOADER SET COMMENT = 'Owns DEV_RAW';Con DCM scrivi lo stato finale:
DEFINE ROLE DEV_LOADER COMMENT = 'Owns DEV_RAW. Used by ingestion tools.';Se il ruolo non esiste, DCM lo crea. Se esiste con un commento diverso, DCM lo modifica. Se corrisponde già, DCM non fa nulla. Non scriverai mai più IF NOT EXISTS, e non scriverai mai un ALTER per correggere qualcosa che hai scritto la settimana scorsa.
I grant funzionano allo stesso modo. Un grant non lo DEFINE, lo dichiari e basta:
DEFINE DATABASE DEV_RAW  COMMENT = 'Landing zone. Schemas and tables are created by ingestion tools.';
GRANT OWNERSHIP ON DATABASE DEV_RAW TO ROLE DEV_LOADER;
Plan, poi deploy
Ogni modifica passa per due fasi. Con la Snowflake CLI:
snow dcm plan --from platform/dcm --target DEV \ --connection my_account --role PLATFORM_DEPLOYERIl plan confronta i tuoi file con ciò che c'è nell'account e ti dice esattamente cosa creerebbe, modificherebbe ed eliminerebbe. Non cambia nulla.
[screenshot: output del plan per l'aggiunta di un database]
Soddisfatto? Fai il deploy:
snow dcm deploy --from platform/dcm --target DEV --alias add_marketing_db \ --connection my_account --role PLATFORM_DEPLOYERQuel --alias è facoltativo, ma usalo, per favore. Senza, la cronologia dei deployment è una lista di nomi generati automaticamente che nessuno riesce a leggere. Con l'alias, snow dcm list-deployments si legge come un changelog: add_marketing_db, analyst_read_on_analytics, drop_legacy_loader.
Puoi fare tutto questo anche in SQL (EXECUTE DCM PROJECT ... PLAN), e Snowsight Workspaces offre una UI dedicata. Io vivo nel terminale, quindi qui vedrai la CLI.
DCM elimina ciò che smetti di definire
Questa è la parte che può farti male.
Se rimuovi un DEFINE già deployato in precedenza, il deploy successivo elimina quell'oggetto.
È il comportamento corretto per uno strumento dichiarativo. I file sono l'account. Ma significa che due abitudini non sono negoziabili:
- Esegui sempre il plan prima del deploy. Un
DROPinaspettato nel plan significa che una definizione è sparita, non che DCM ti sta facendo un favore. - Leggi il plan nella tua PR. Più avanti spiego come lo automatizzo.
Un'altra cosa: la documentazione di Snowflake è esplicita sul fatto che un deploy fallito può lasciarti con un'esecuzione parziale. Non è un'unica grande transazione. Correggi la definizione ed esegui di nuovo plan → deploy, invece di sistemare le cose a mano.
DEV, QA e PROD da un unico set di file
Nessuno vuole tre copie di roles.sql. Il manifest.yml definisce i target, e ogni target punta al proprio oggetto project e passa le proprie variabili di templating:
manifest_version: 2type: DCM_PROJECTdefault_target: DEV
targets:  DEV:    account_identifier: ABCDEFG-XY12345    project_name: PLATFORM.DCM.DEV_PLATFORM_DCM    project_owner: PLATFORM_DEPLOYER    templating_config: DEV  # QA and PROD look the same
templating:  configurations:    DEV:
Espandi codice
Poi ogni definizione usa {{ env }} come prefisso:
DEFINE DATABASE {{ env }}_RAW  COMMENT = 'Landing zone. Schemas and tables are created by ingestion tools.';
DEFINE DATABASE {{ env }}_ANALYTICS  COMMENT = 'Modelled data. Schemas and tables are created by transformation tools.';
GRANT OWNERSHIP ON DATABASE {{ env }}_RAW TO ROLE {{ env }}_LOADER;GRANT OWNERSHIP ON DATABASE {{ env }}_ANALYTICS TO ROLE {{ env }}_TRANSFORMER;
Fai il deploy con --target DEV e ottieni DEV_RAW. Fai il deploy con --target PROD e ottieni PROD_RAW. Stessi file.
La parte complicata: gli oggetti a livello di account
Alcuni oggetti non appartengono a un ambiente. Nel mio template, tutti e tre gli ambienti condividono un solo account, un solo warehouse e un set di ruoli "master" come LOADER che ereditano DEV_LOADER, QA_LOADER e PROD_LOADER.
Se definissi COMPUTE_XS senza condizioni, tutti e tre i target lo rivendicherebbero, e i deploy dei vari target se lo contenderebbero. Quindi gli oggetti a livello di account vengono definiti in un solo target, con un if Jinja e un ciclo:
{% if env == 'PROD' %}{% set envs = ['DEV', 'QA', 'PROD'] %}
DEFINE WAREHOUSE COMPUTE_XS  WAREHOUSE_TYPE = 'ADAPTIVE'  MAX_QUERY_PERFORMANCE_LEVEL = XSMALL  QUERY_THROUGHPUT_MULTIPLIER = 2  COMMENT = 'Sole compute warehouse for loads and transforms.';
{% for e in envs %}GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_LOADER;GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_TRANSFORMER;GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_ANALYST;{% endfor %}{% endif %}
L'inghippo: quel blocco PROD concede grant a DEV_LOADER e QA_LOADER, quindi DEV e QA devono essere deployati prima di PROD. L'ordine di deploy diventa parte del tuo processo, e della tua CI.
Se metti ogni ambiente nel proprio account, il problema scompare, ma allora ogni account ha bisogno della propria copia degli oggetti a livello di account. A te la scelta del compromesso.
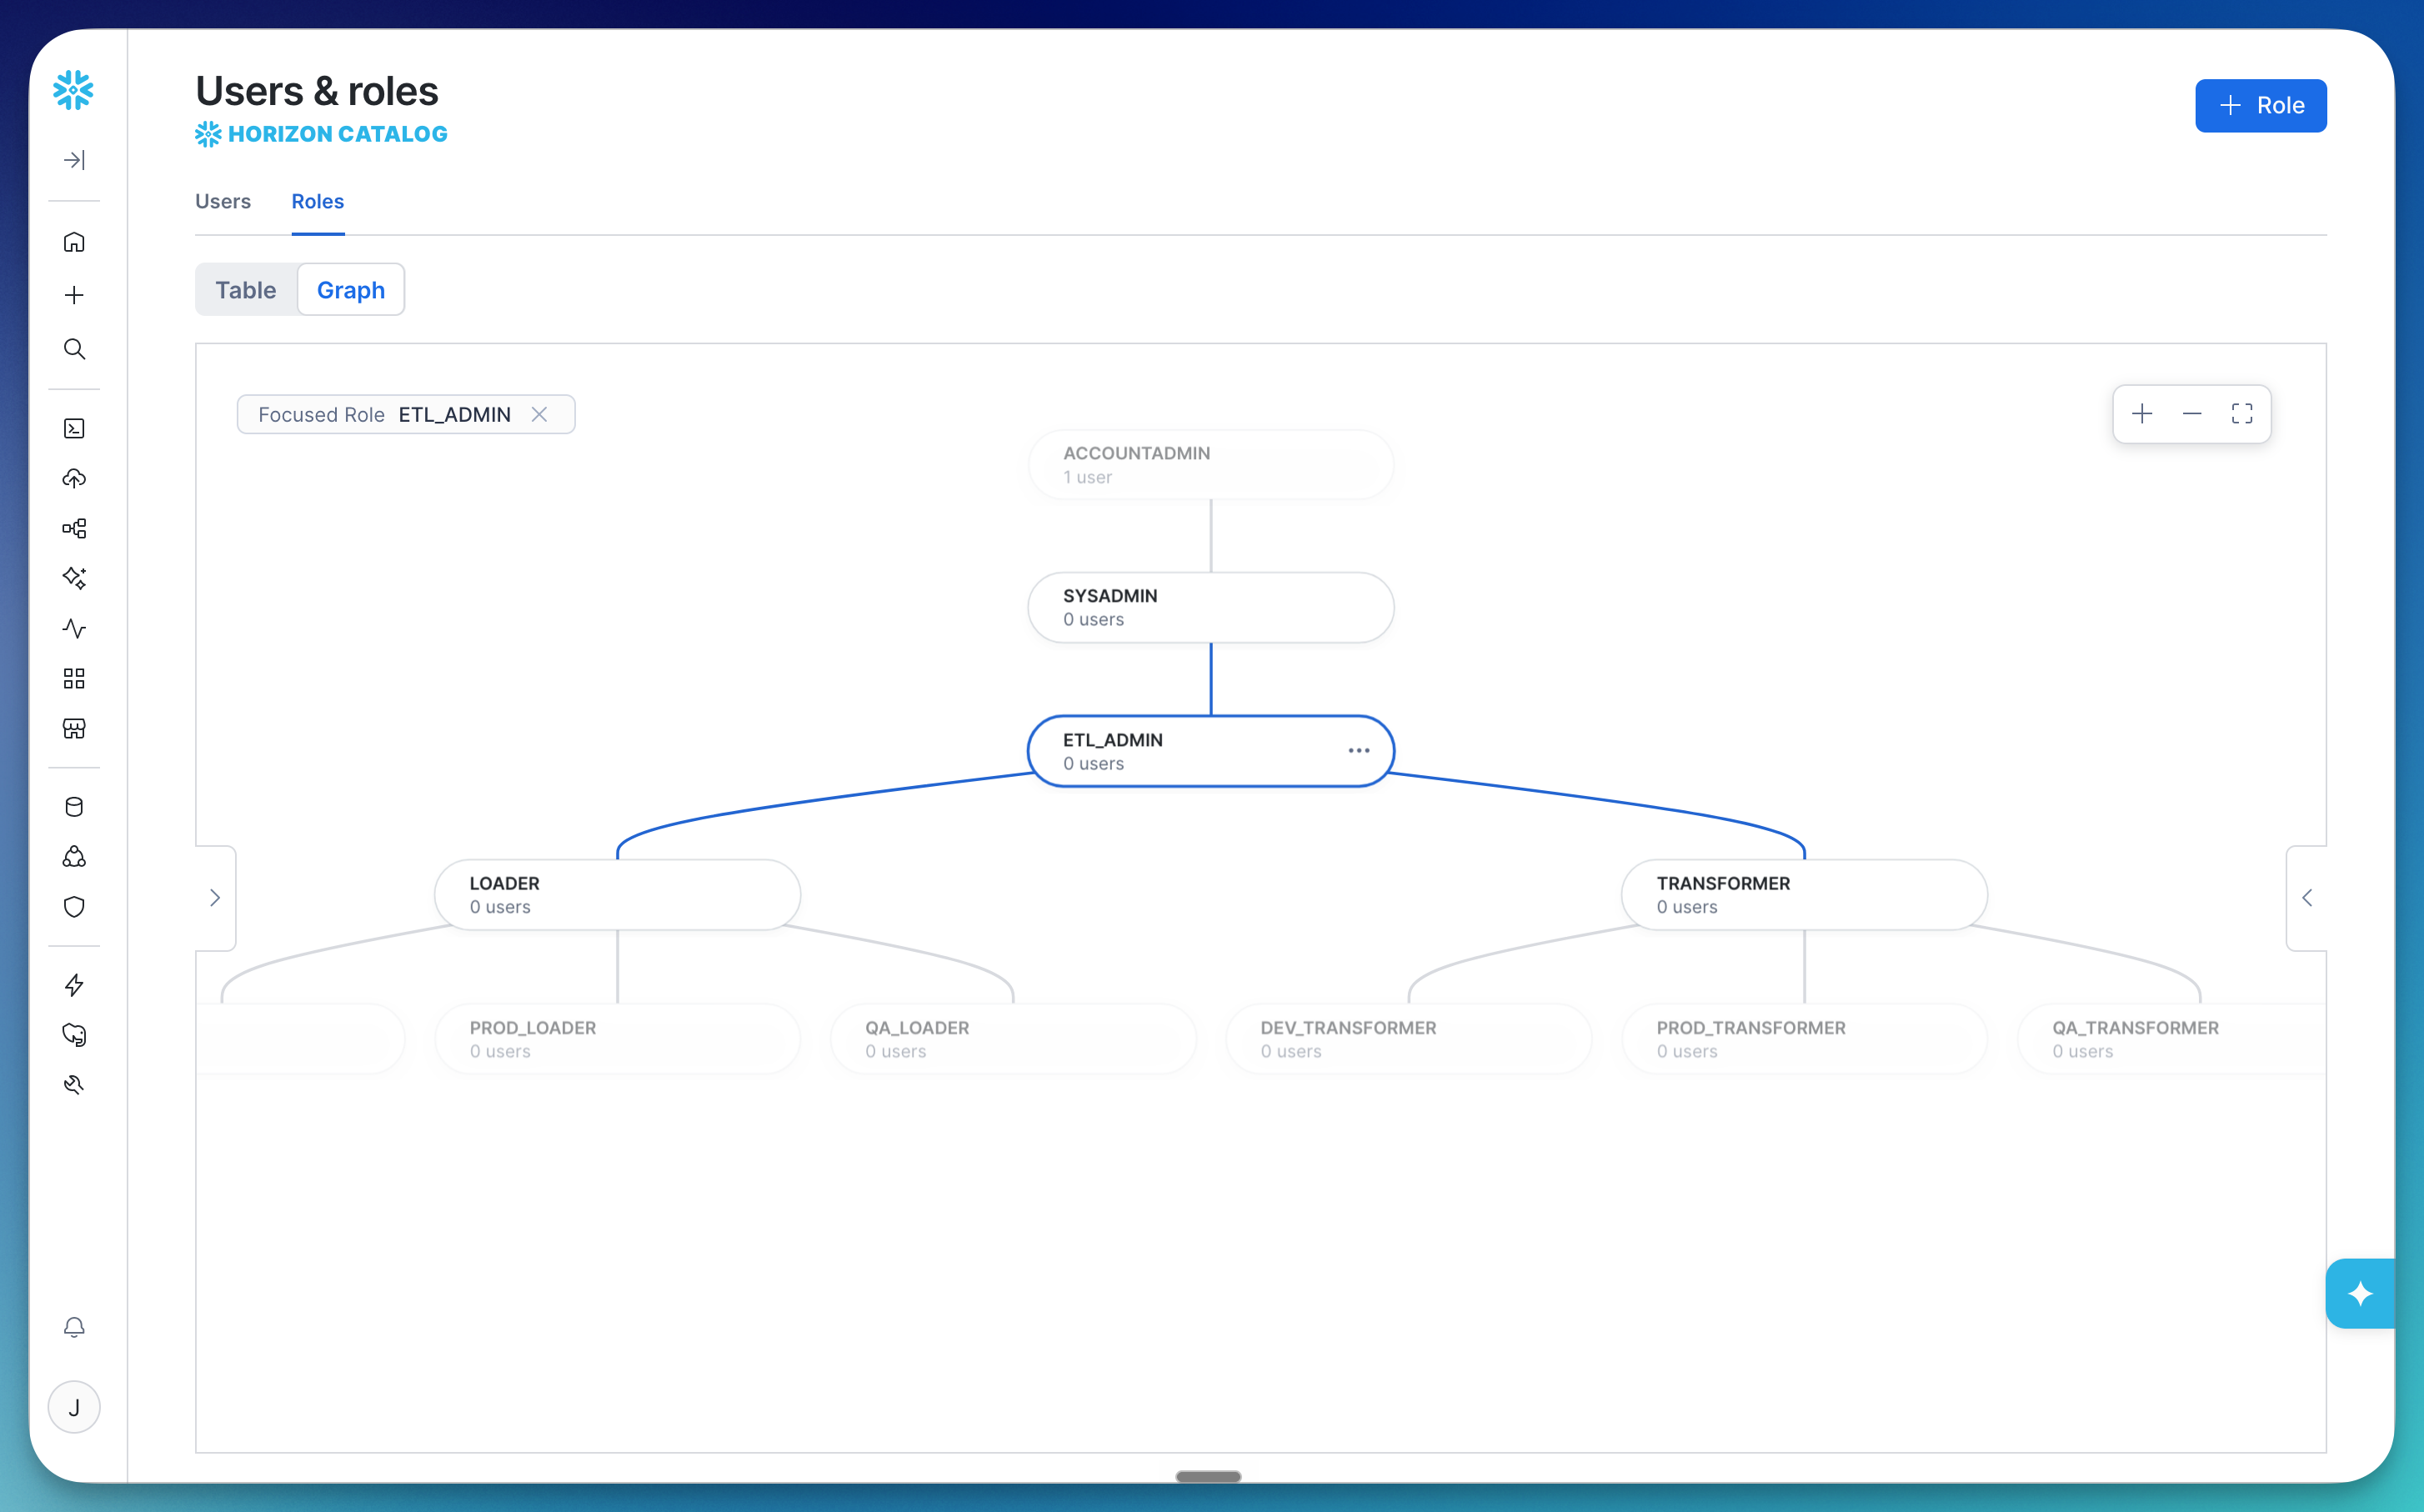
Ecco il modello di ruoli a cui arriva il template:
Inoltre, il ruolo Deployer riceve direttamente i ruoli specifici per ambiente:
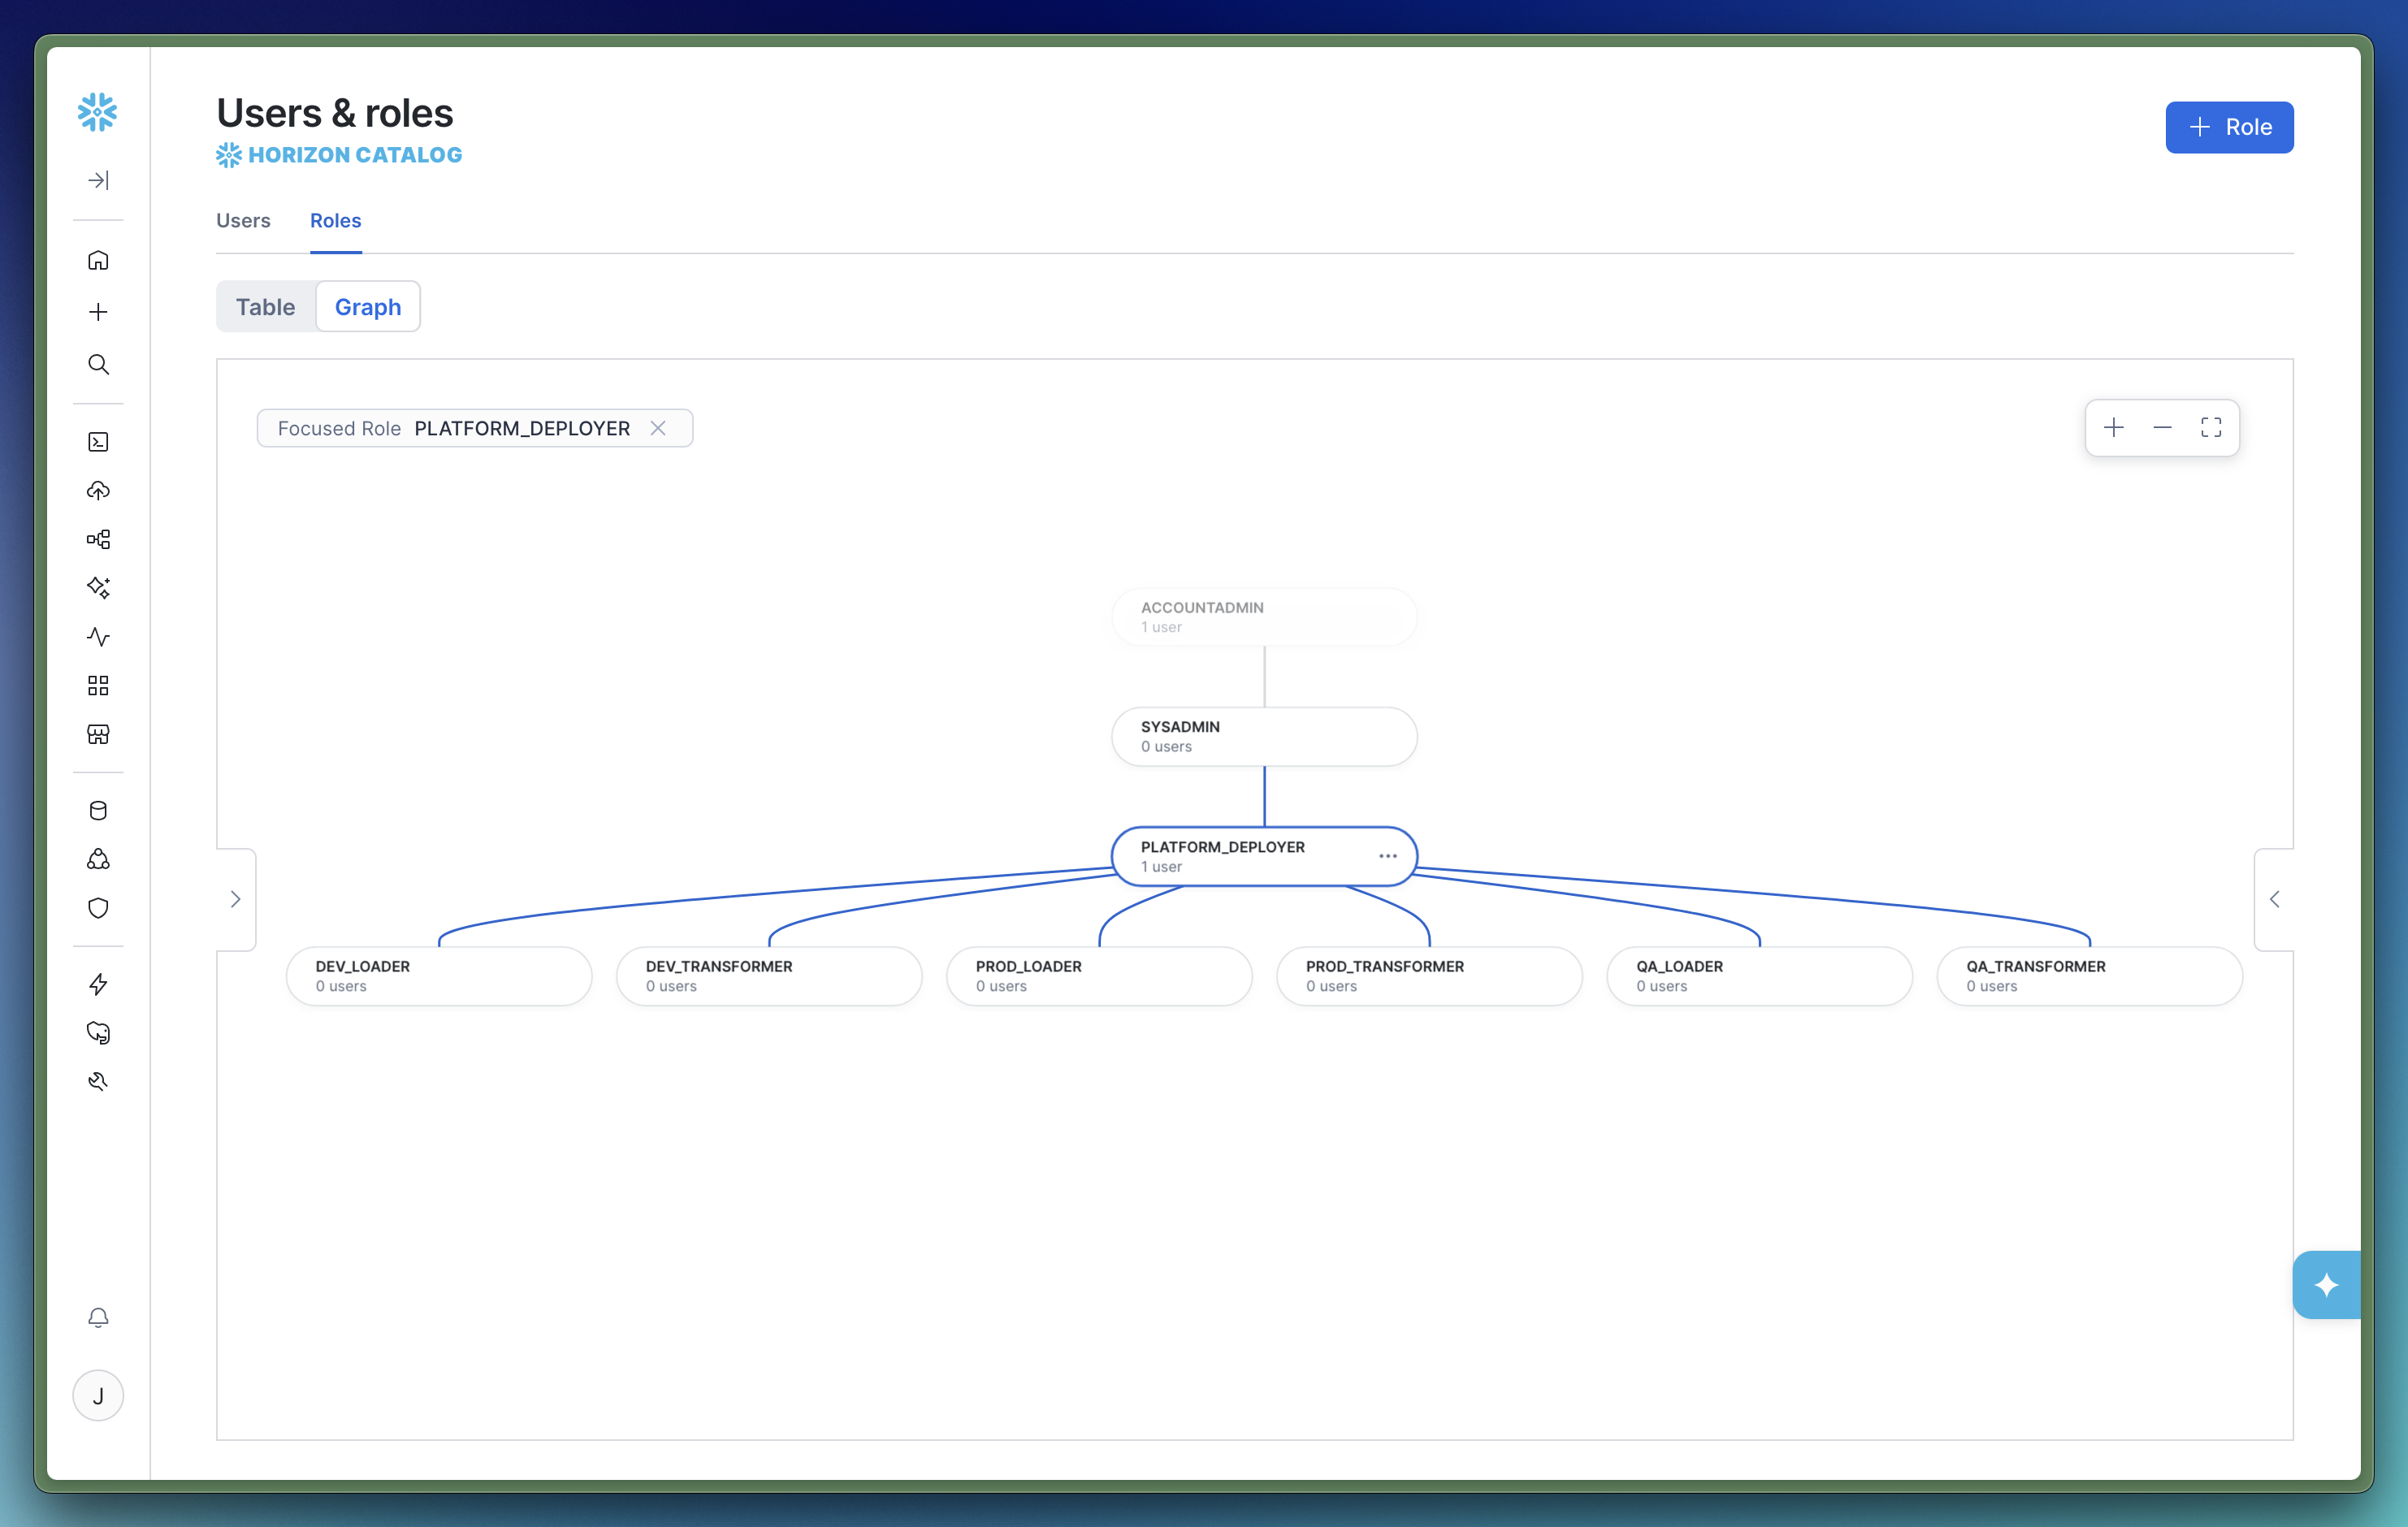
Il tuo strumento di ingestion si connette come {env}_LOADER. dbt si connette come {env}_TRANSFORMER. Gli analisti ricevono {env}_ANALYST, che può leggere ANALYTICS e non vede affatto RAW.
Se usi dbt, lascia che sia lui a gestire tabelle e schemi nel database Analytics
DCM supporta una lunga lista di tipi di oggetti: database, schemi, tabelle, viste, dynamic tables, task, stage, funzioni, procedure, masking policy, tag e altro ancora.
Allora perché il mio template lo usa solo per ruoli, database, warehouse e grant?
Perché se usi dbt, dbt gestisce già le tue tabelle e viste, con lineage, test e documentazione. Metti la stessa tabella in una definizione DCM e ti ritrovi con due strumenti convinti entrambi di esserne i proprietari. Prima o poi uno dei due eliminerà ciò che l'altro ha costruito.
Quindi traccio una linea netta:
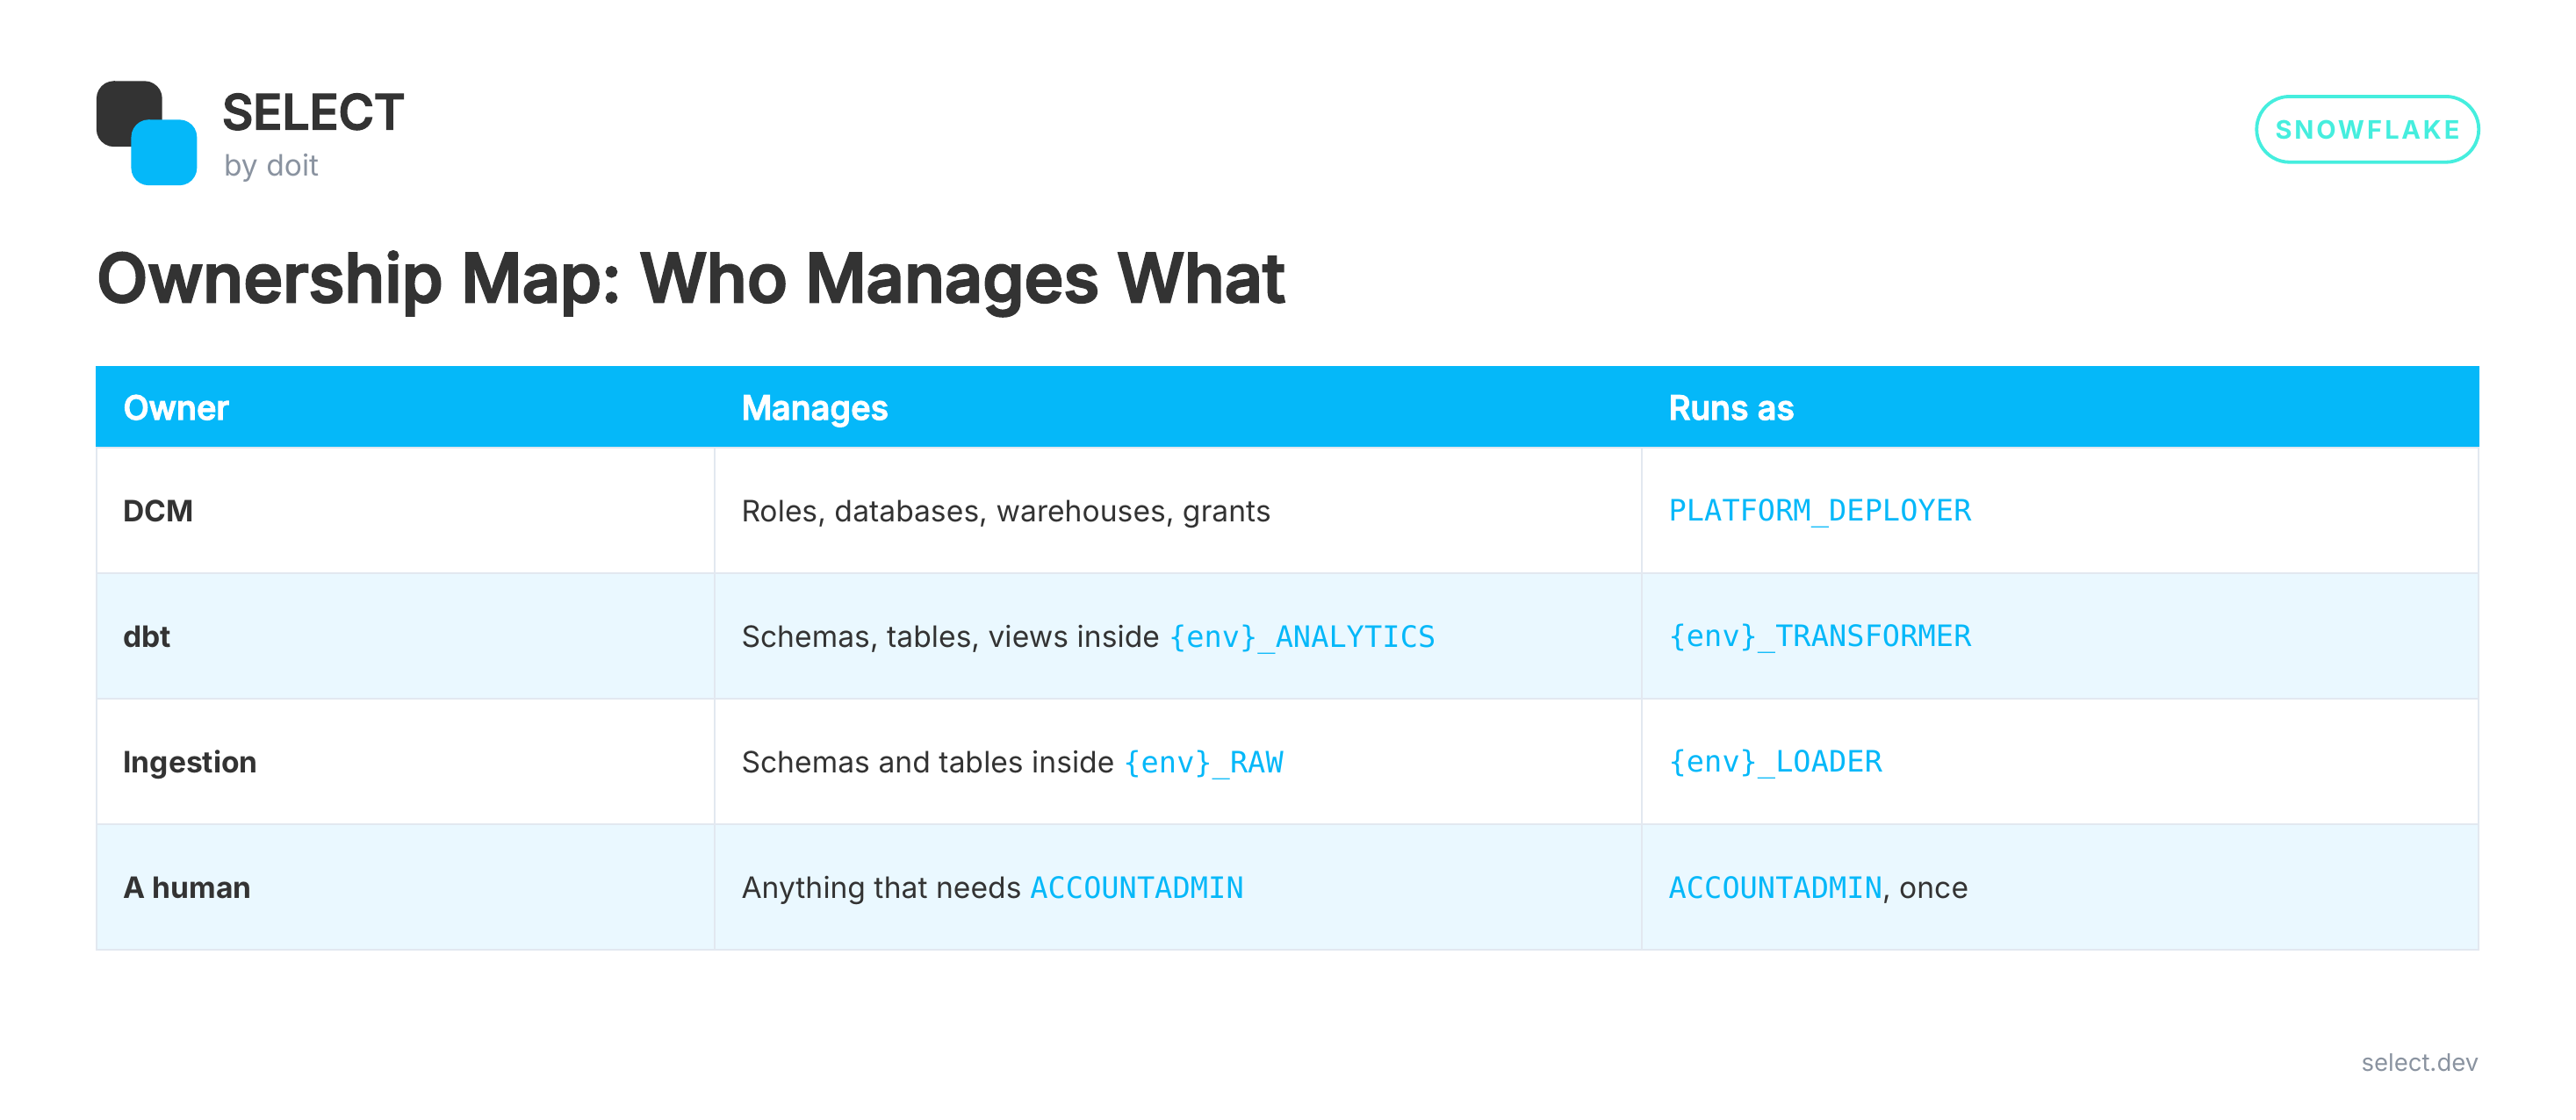
Nessun oggetto ha due proprietari. Se non usi dbt, o hai oggetti che nessuno strumento di trasformazione gestisce (stage, file format, network rule), DCM è il posto ideale per gestirli. La regola è "un solo proprietario per oggetto", non "DCM fa solo i ruoli".
Il problema dell'uovo e della gallina: il bootstrap
DCM ha bisogno di un ruolo con cui fare il deploy e di un oggetto project in cui farlo. Qualcosa deve crearli, e quel qualcosa ha bisogno di ACCOUNTADMIN.
La mia regola per l'intero repo:
La CI/CD non deve mai aver bisogno di
ACCOUNTADMIN.
Quindi tutto ciò che ne ha bisogno finisce in un file SQL numerato che un essere umano esegue esattamente una volta:
USE ROLE ACCOUNTADMIN;
ALTER ACCOUNT SET FEATURE_RBAC_INHERITED_GRANTS = 'ENABLED';
CREATE ROLE IF NOT EXISTS PLATFORM_DEPLOYER  COMMENT = 'CI/CD deployment role for DCM.';
GRANT CREATE ROLE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT CREATE DATABASE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT CREATE WAREHOUSE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT MANAGE GRANTS ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT ROLE PLATFORM_DEPLOYER TO ROLE SYSADMIN;
CREATE DATABASE IF NOT EXISTS PLATFORM;CREATE SCHEMA IF NOT EXISTS PLATFORM.DCM;
Espandi codice
(Leggermente abbreviato. Il file completo è nel repo.)
Dopo di che, PLATFORM_DEPLOYER fa tutto. Ed ecco un'abitudine che adoro: passa --role PLATFORM_DEPLOYER anche in locale. Se una modifica ha segretamente bisogno di più privilegi, fallisce sul tuo laptop invece che in CI un venerdì pomeriggio.
Gli ostacoli in cui sono inciampato io, così li eviti tu
Gli inherited grants in DCM sono contrassegnati come preview. L'elenco di Snowflake degli oggetti DCM supportati segnala gli inherited grants e il MANAGE GRANTS a livello di contenitore come funzionalità in preview. A me hanno funzionato bene, ma controlla la documentazione prima di affidare loro gli accessi di produzione.
Non chiudere fuori il deployer. Quando DCM passa l'ownership di DEV_RAW a DEV_LOADER, PLATFORM_DEPLOYER non ne è più proprietario. Al deploy successivo, DCM non può gestire ciò che non raggiunge. La soluzione è una riga per ruolo:
GRANT ROLE {{ env }}_LOADER TO ROLE PLATFORM_DEPLOYER;GRANT ROLE {{ env }}_TRANSFORMER TO ROLE PLATFORM_DEPLOYER;account_identifier nel manifest non espande le variabili d'ambiente. Scrivi l'identificatore per esteso. È ciò che permette a DCM di avvisarti quando stai per fare il deploy sull'account sbagliato, cosa che, se sei un consulente che si destreggia tra account di clienti diversi, è una funzionalità che vuoi assolutamente.
Non mettere segreti nei template. Snowflake lo dice chiaramente: le variabili di templating non sono pensate per le credenziali.
CI/CD con GitHub Actions
Ed ecco dove tutto si ricompone. Due workflow:
Su una pull request:
- Plan e deploy su
QA. - Plan su
PRODe pubblicazione del plan come commento alla PR.
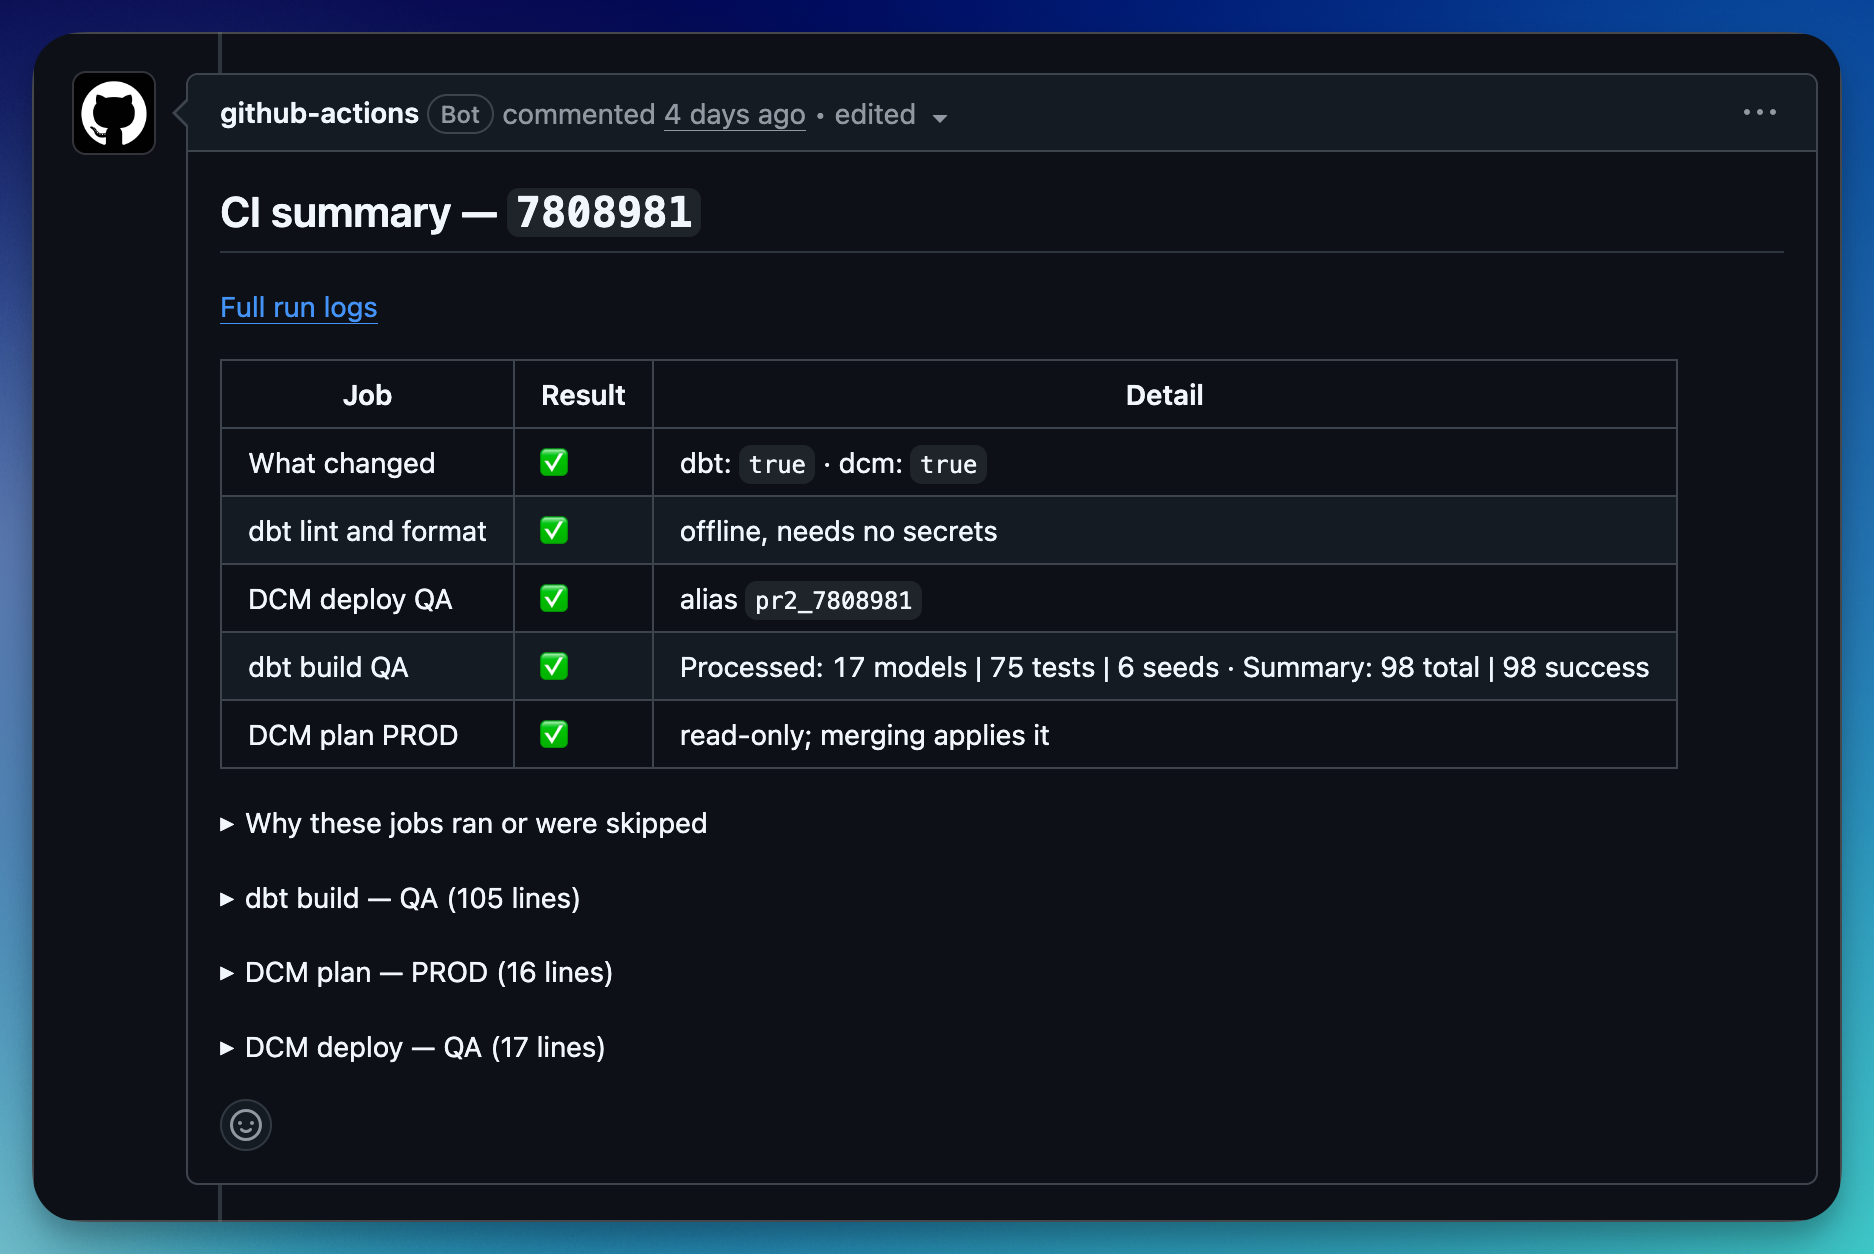
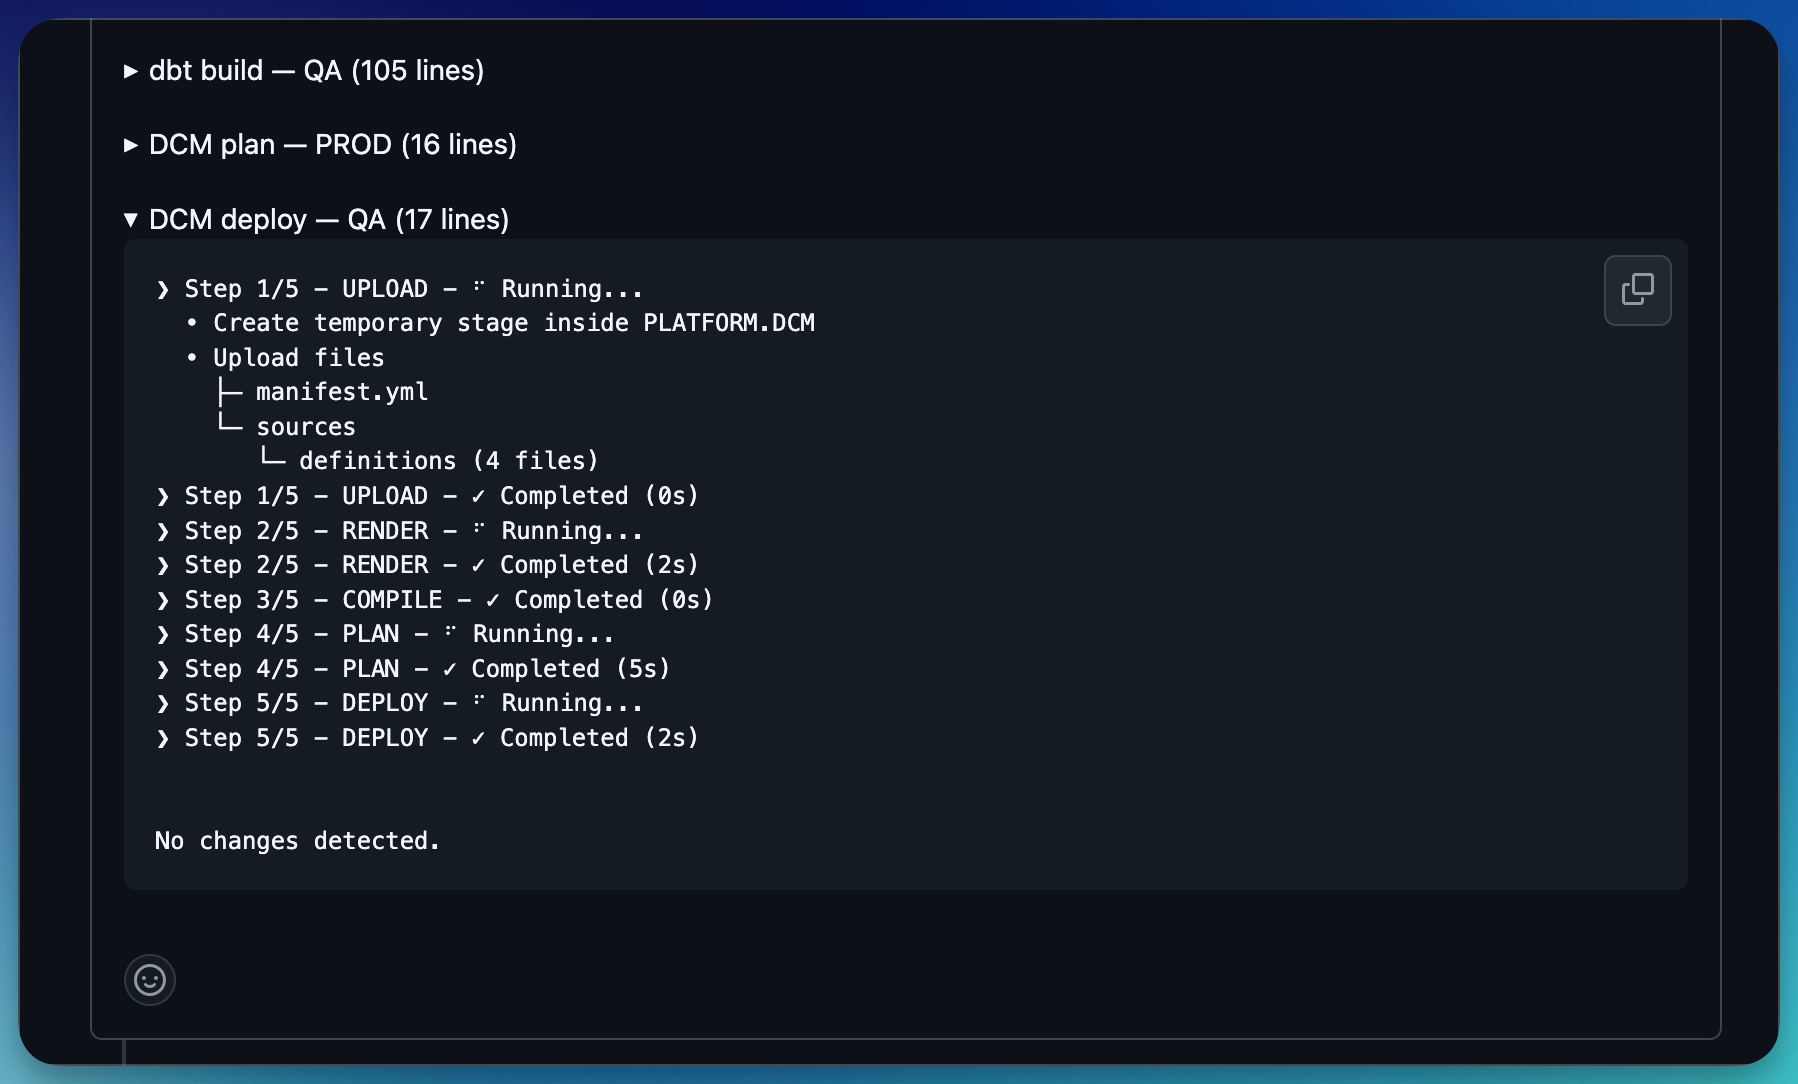
Al merge su main:
- Plan e deploy di
DEV, poiQA, poiPROD, in quest'ordine.
Il commento sulla PR è la mia parte preferita. I reviewer non devono fidarsi sulla parola che una modifica sia sicura. Vedono esattamente cosa succederà in produzione, inclusi eventuali DROP, prima di cliccare su merge. E il job modifica il suo commento precedente invece di aggiungerne uno nuovo, così una PR con dieci push ha comunque un solo commento con il plan.
[screenshot: plan di PROD pubblicato come commento alla PR]
La CI si autentica come utente TYPE = SERVICE con autenticazione key-pair. Quell'utente ha PLATFORM_DEPLOYER e nient'altro. Ogni deploy riceve un alias con il commit (main_9fd3c1a), così qualsiasi deployment in Snowflake è riconducibile direttamente a un merge.
I DCM Projects in Snowsight
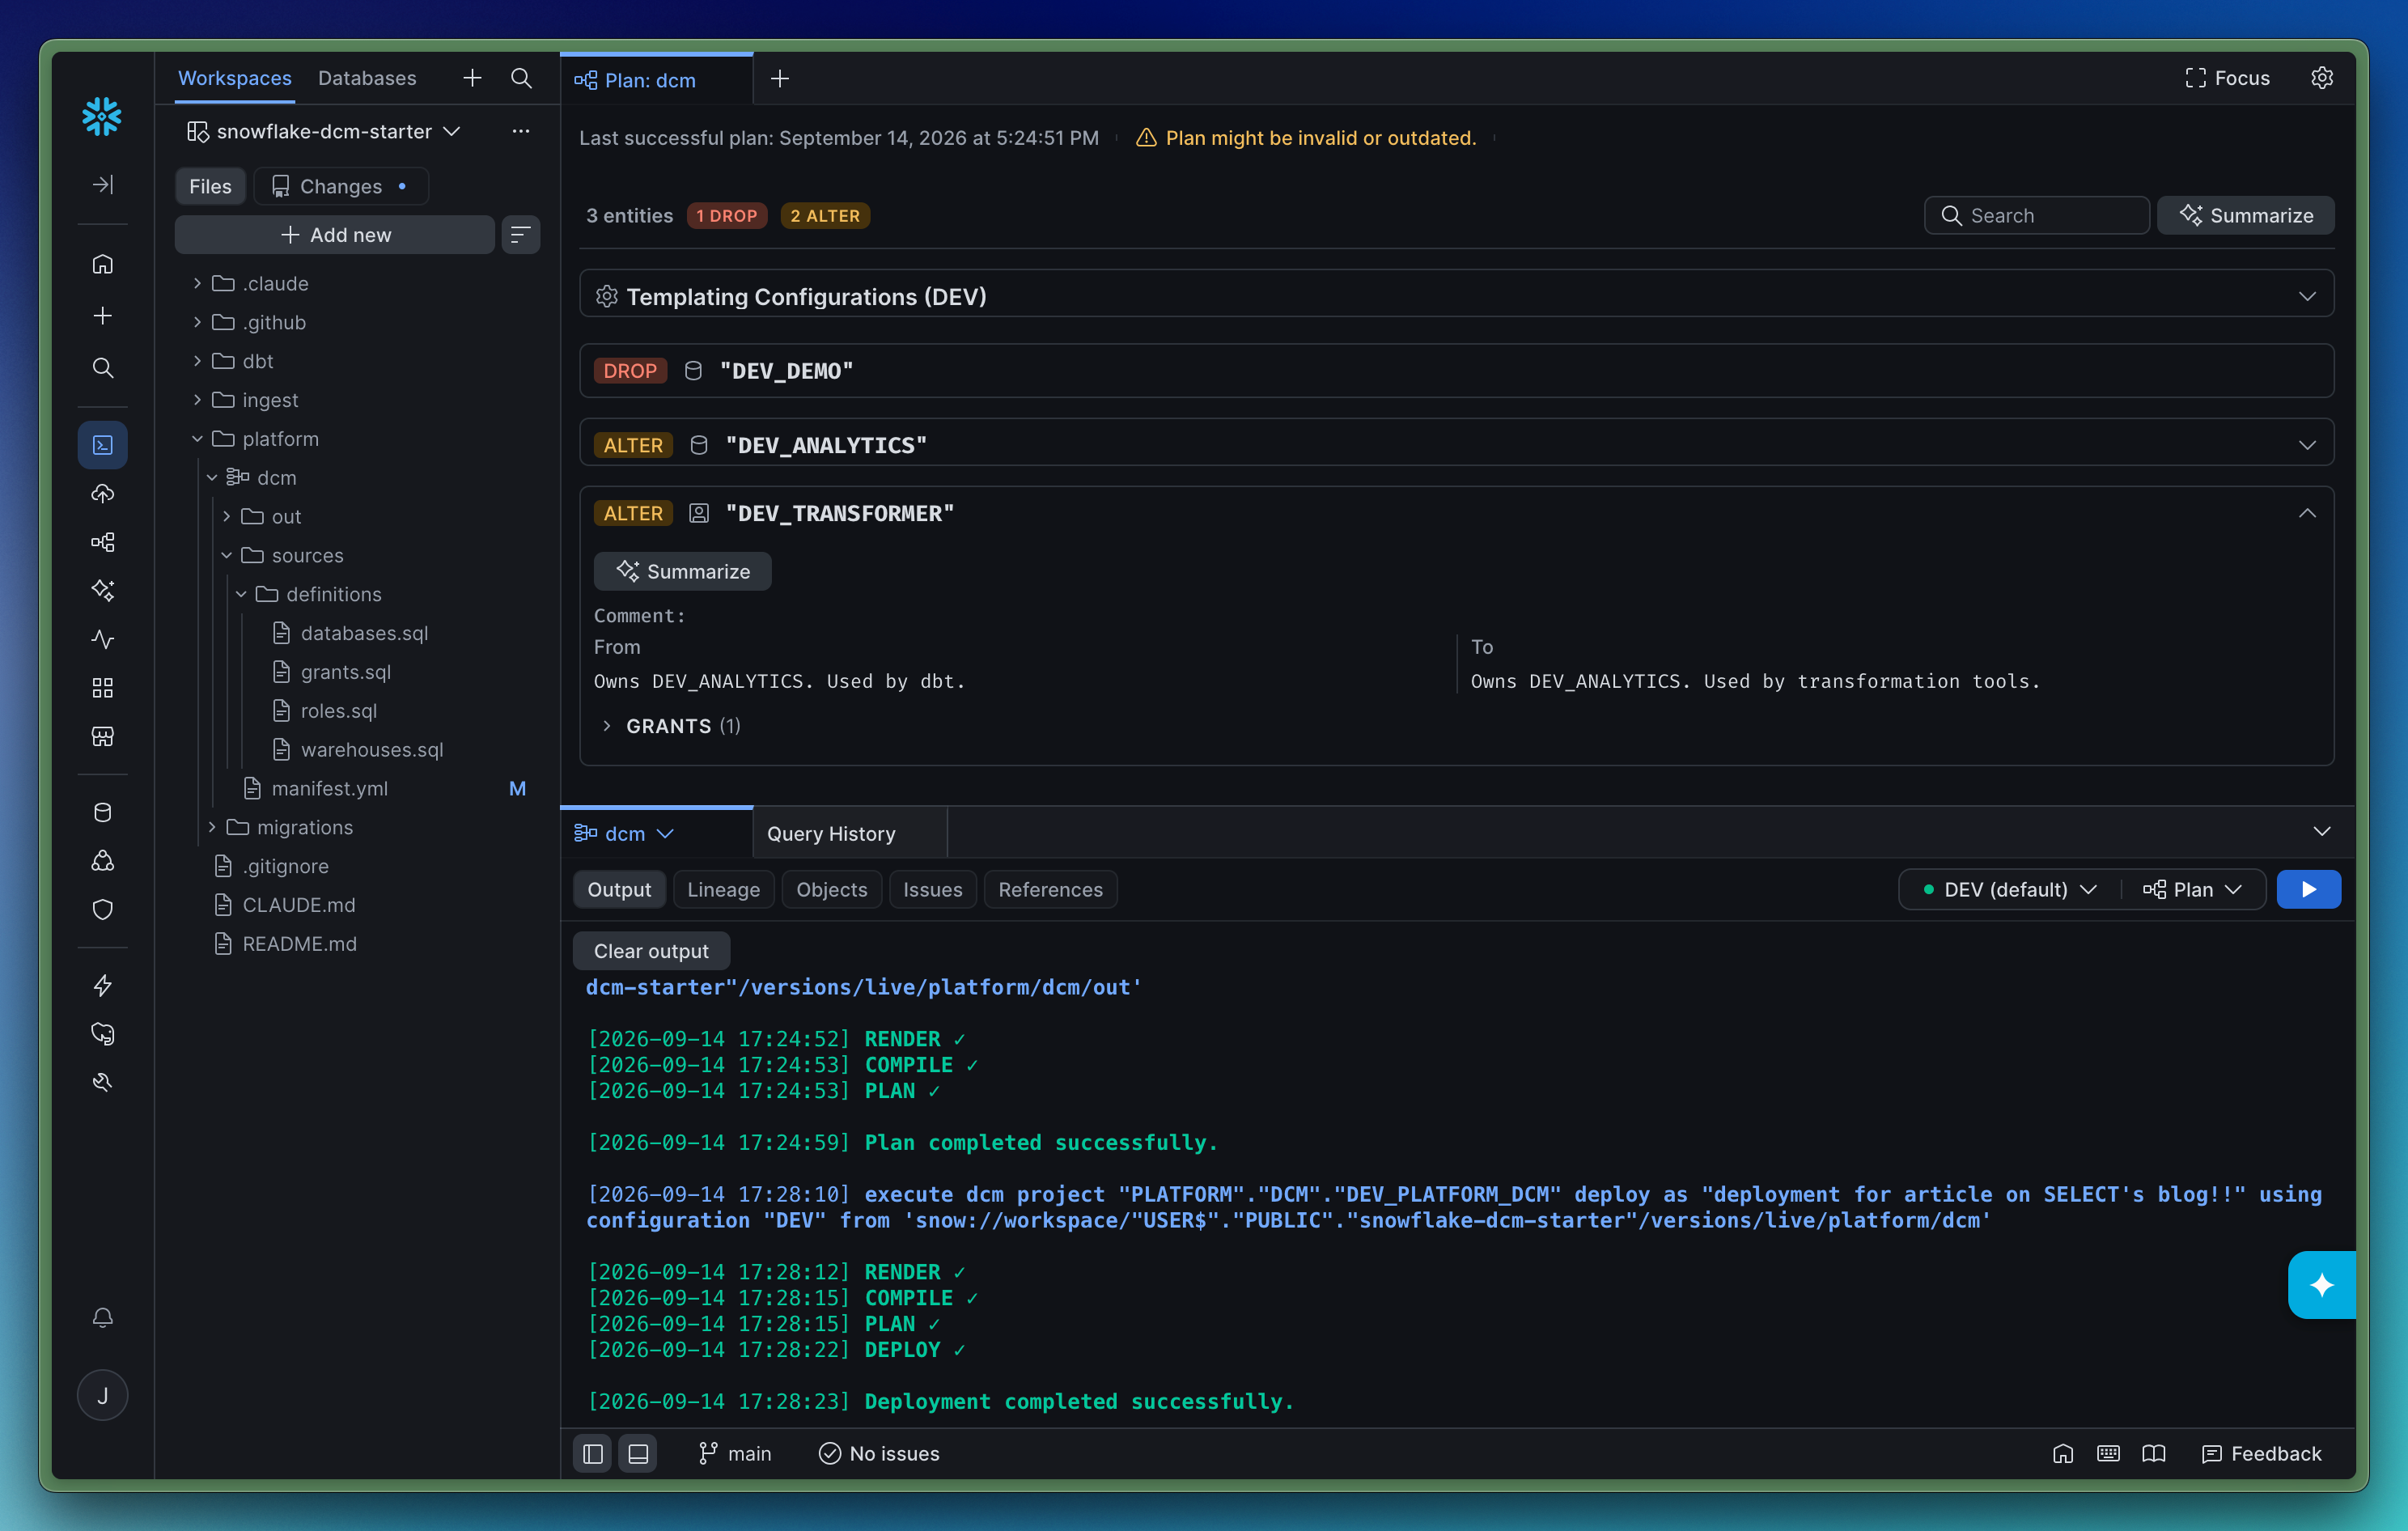
Snowflake Workspaces offre una UI davvero ben fatta per gestire, pianificare e deployare i DCM project. Senza addentrarci troppo nei dettagli, diamo un'occhiata ad alcuni screenshot.
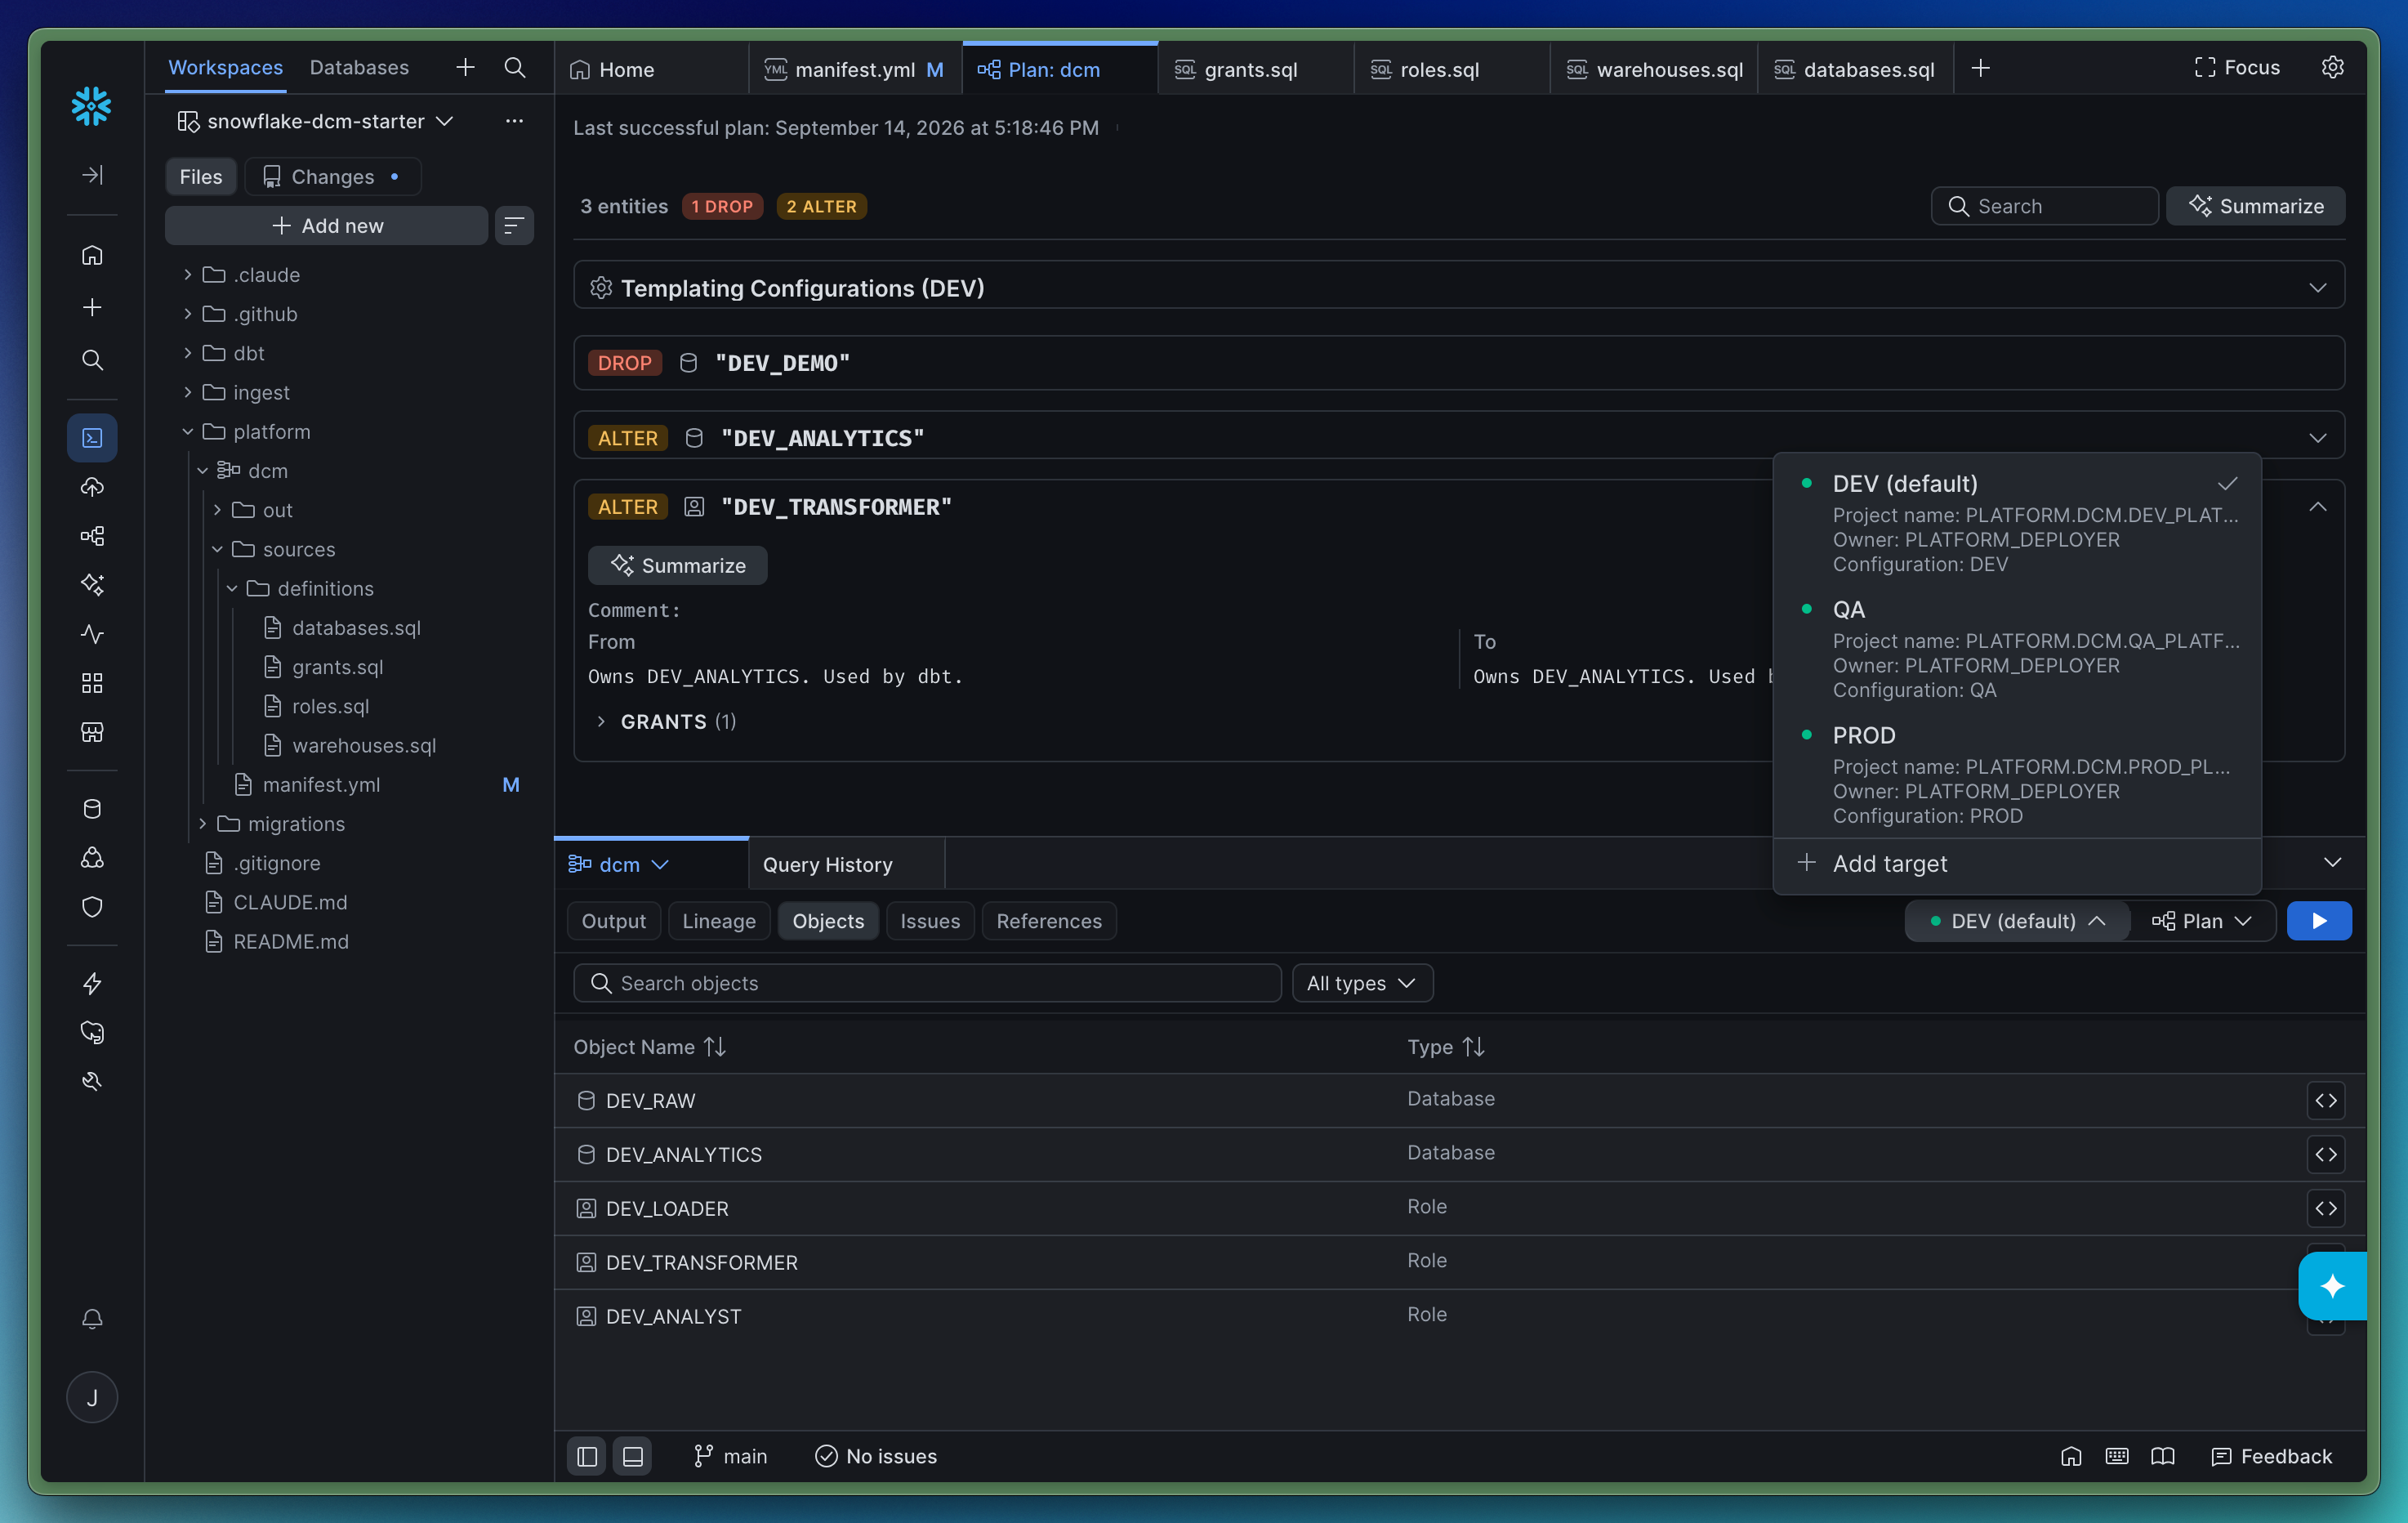
L'esecuzione di un plan apre una scheda che spiega il plan:
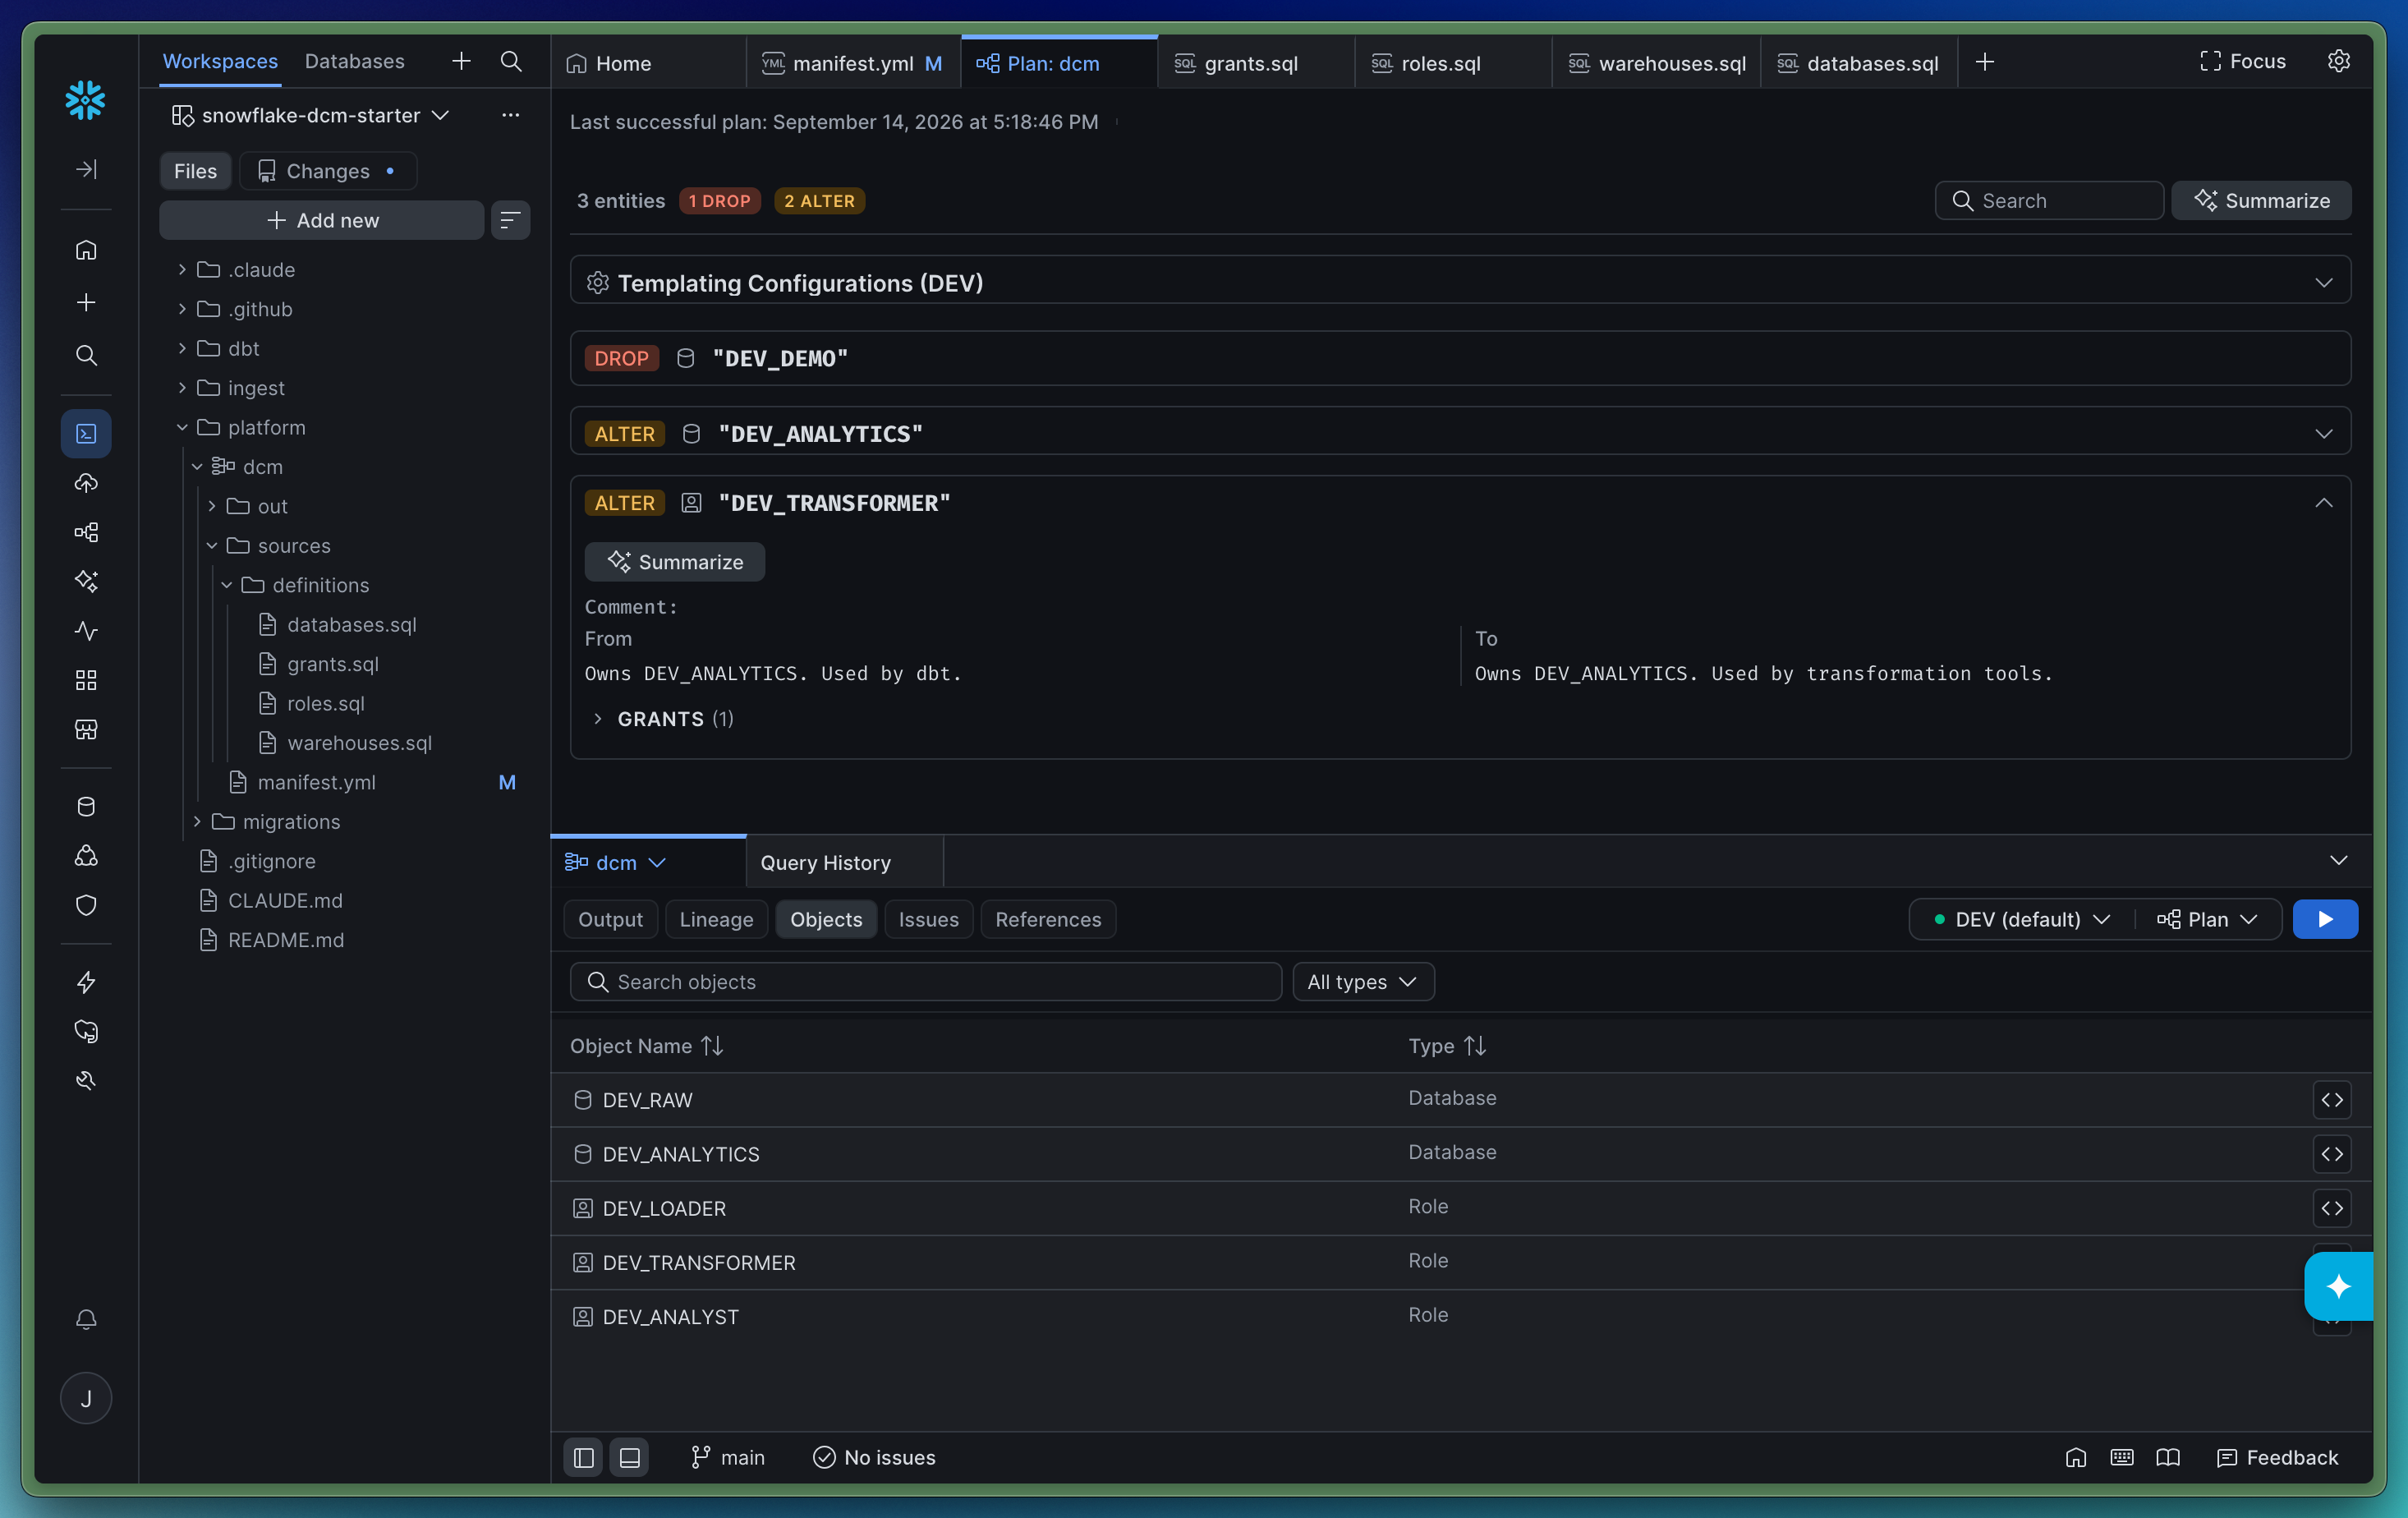
Puoi cambiare ambiente con il selettore:
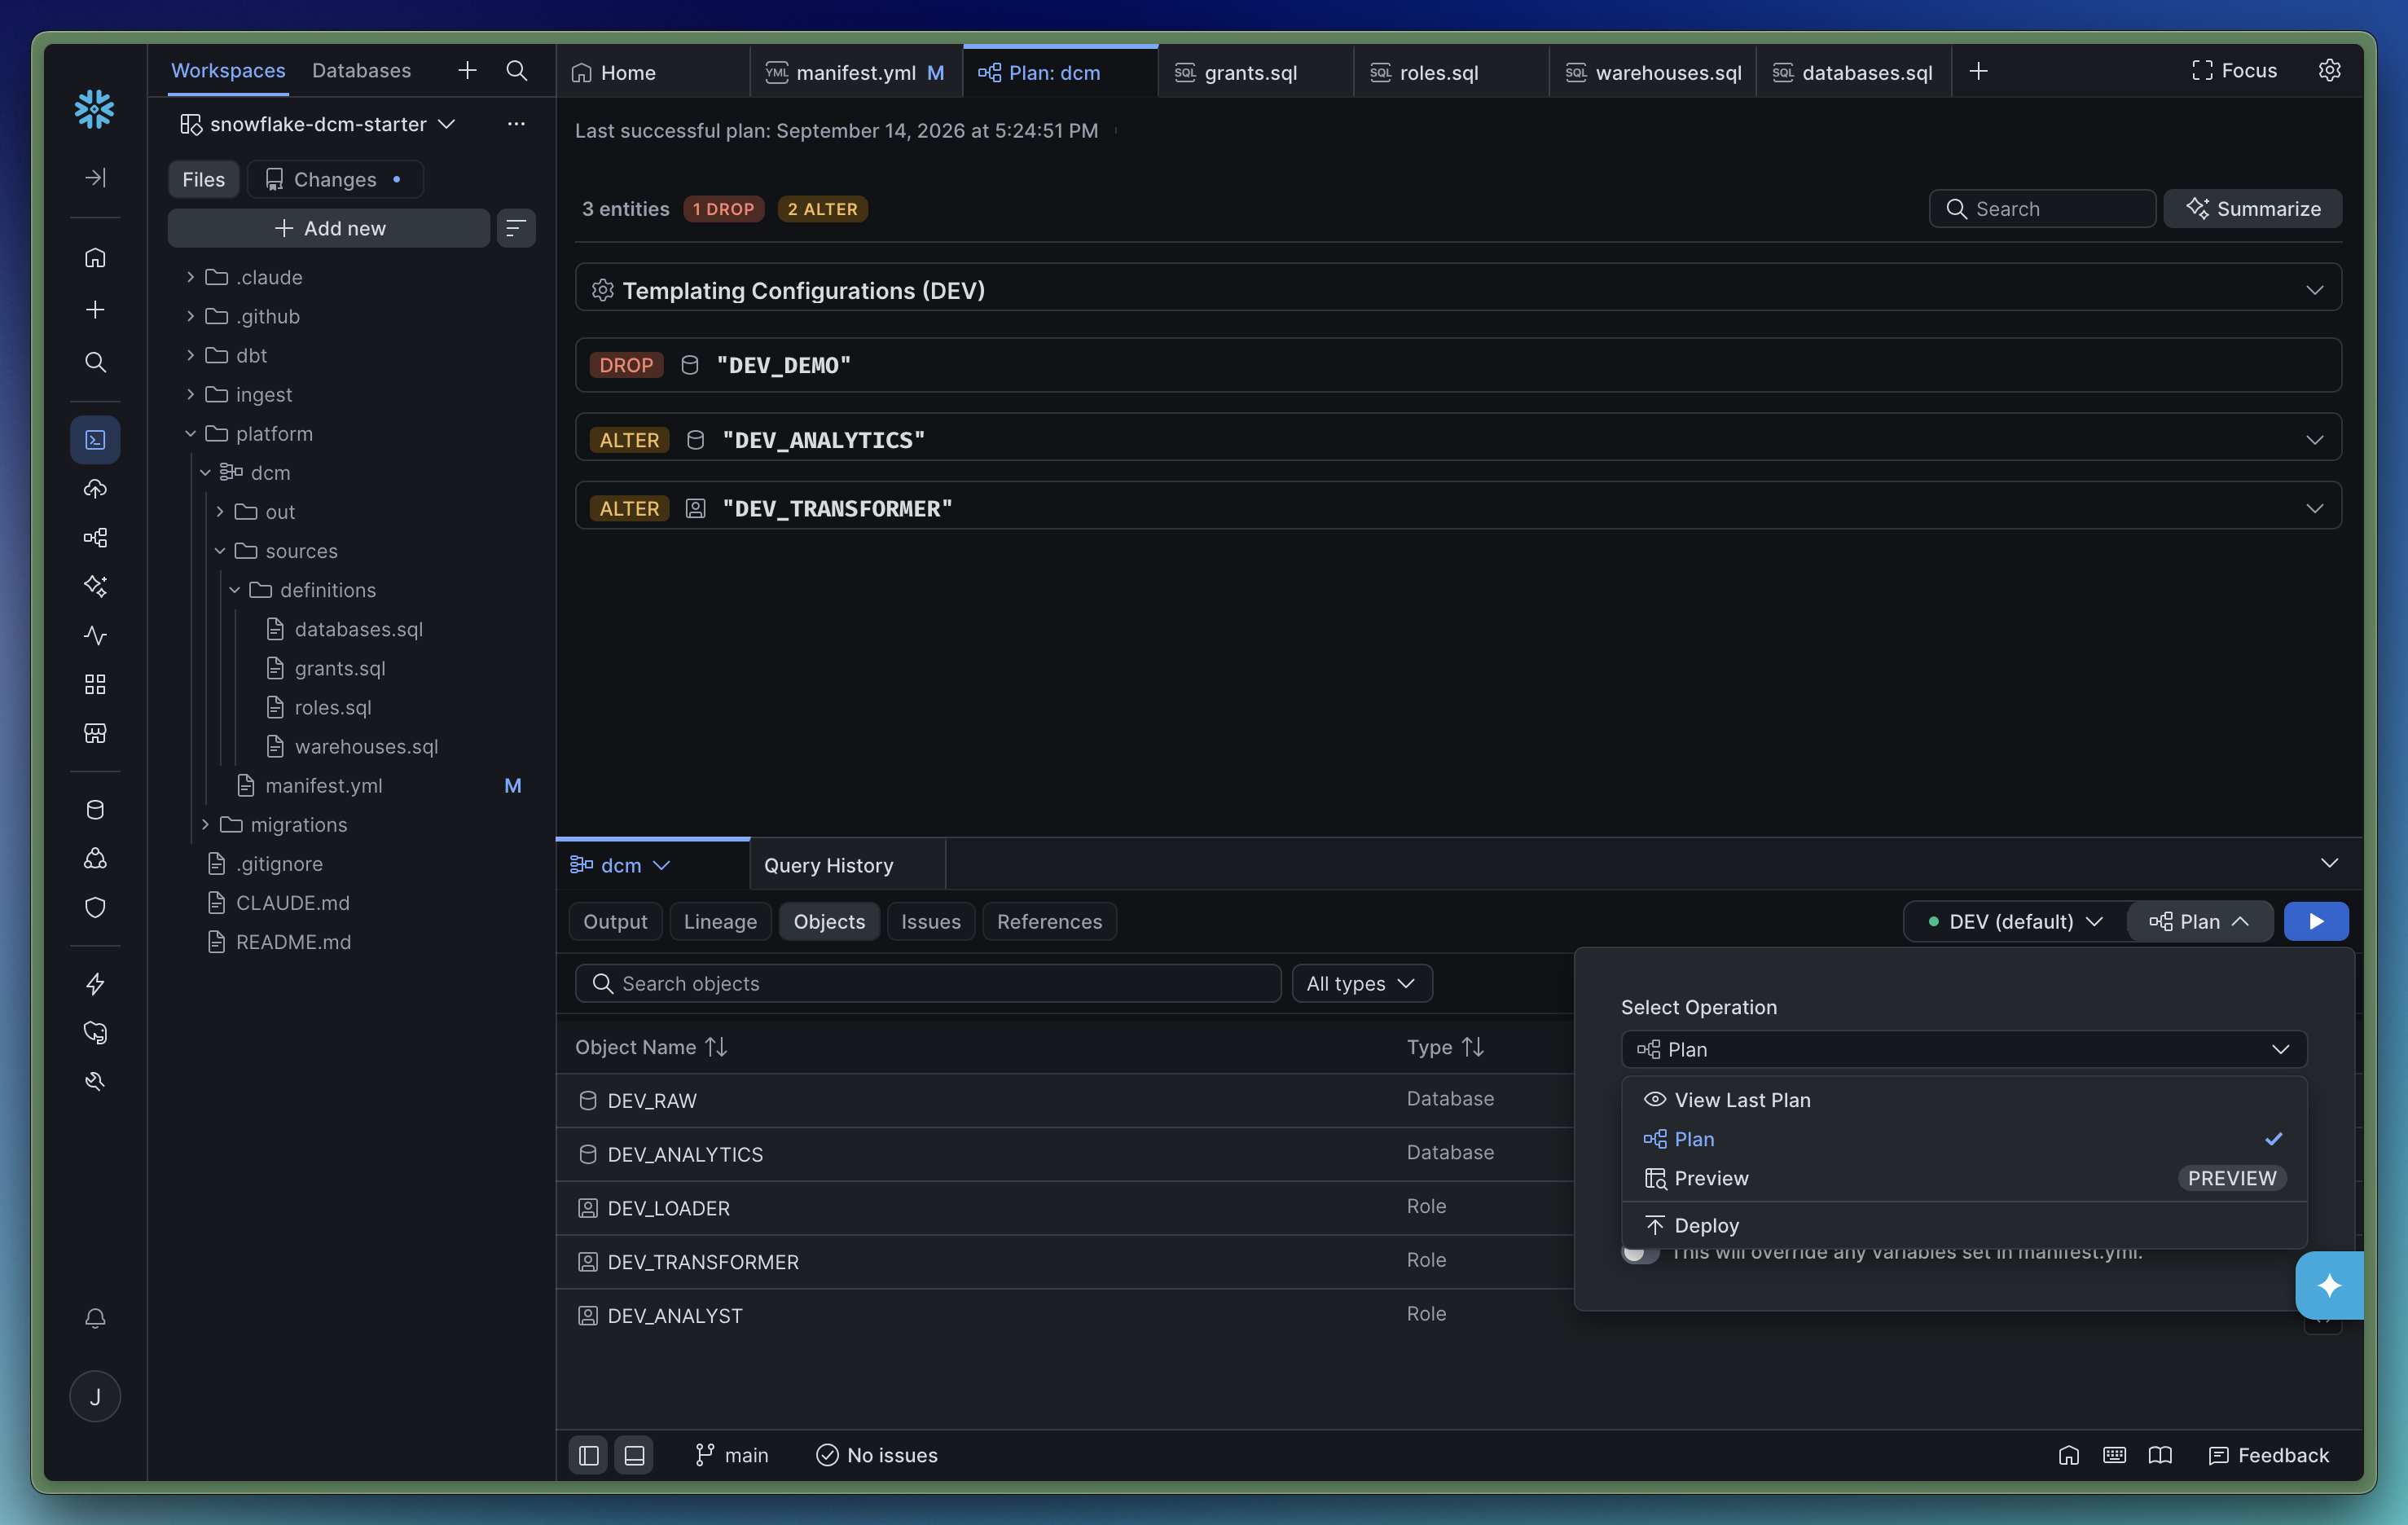
Quando sei pronto per il deploy, basta cliccare sul menu a tendina Plan e selezionare deploy:
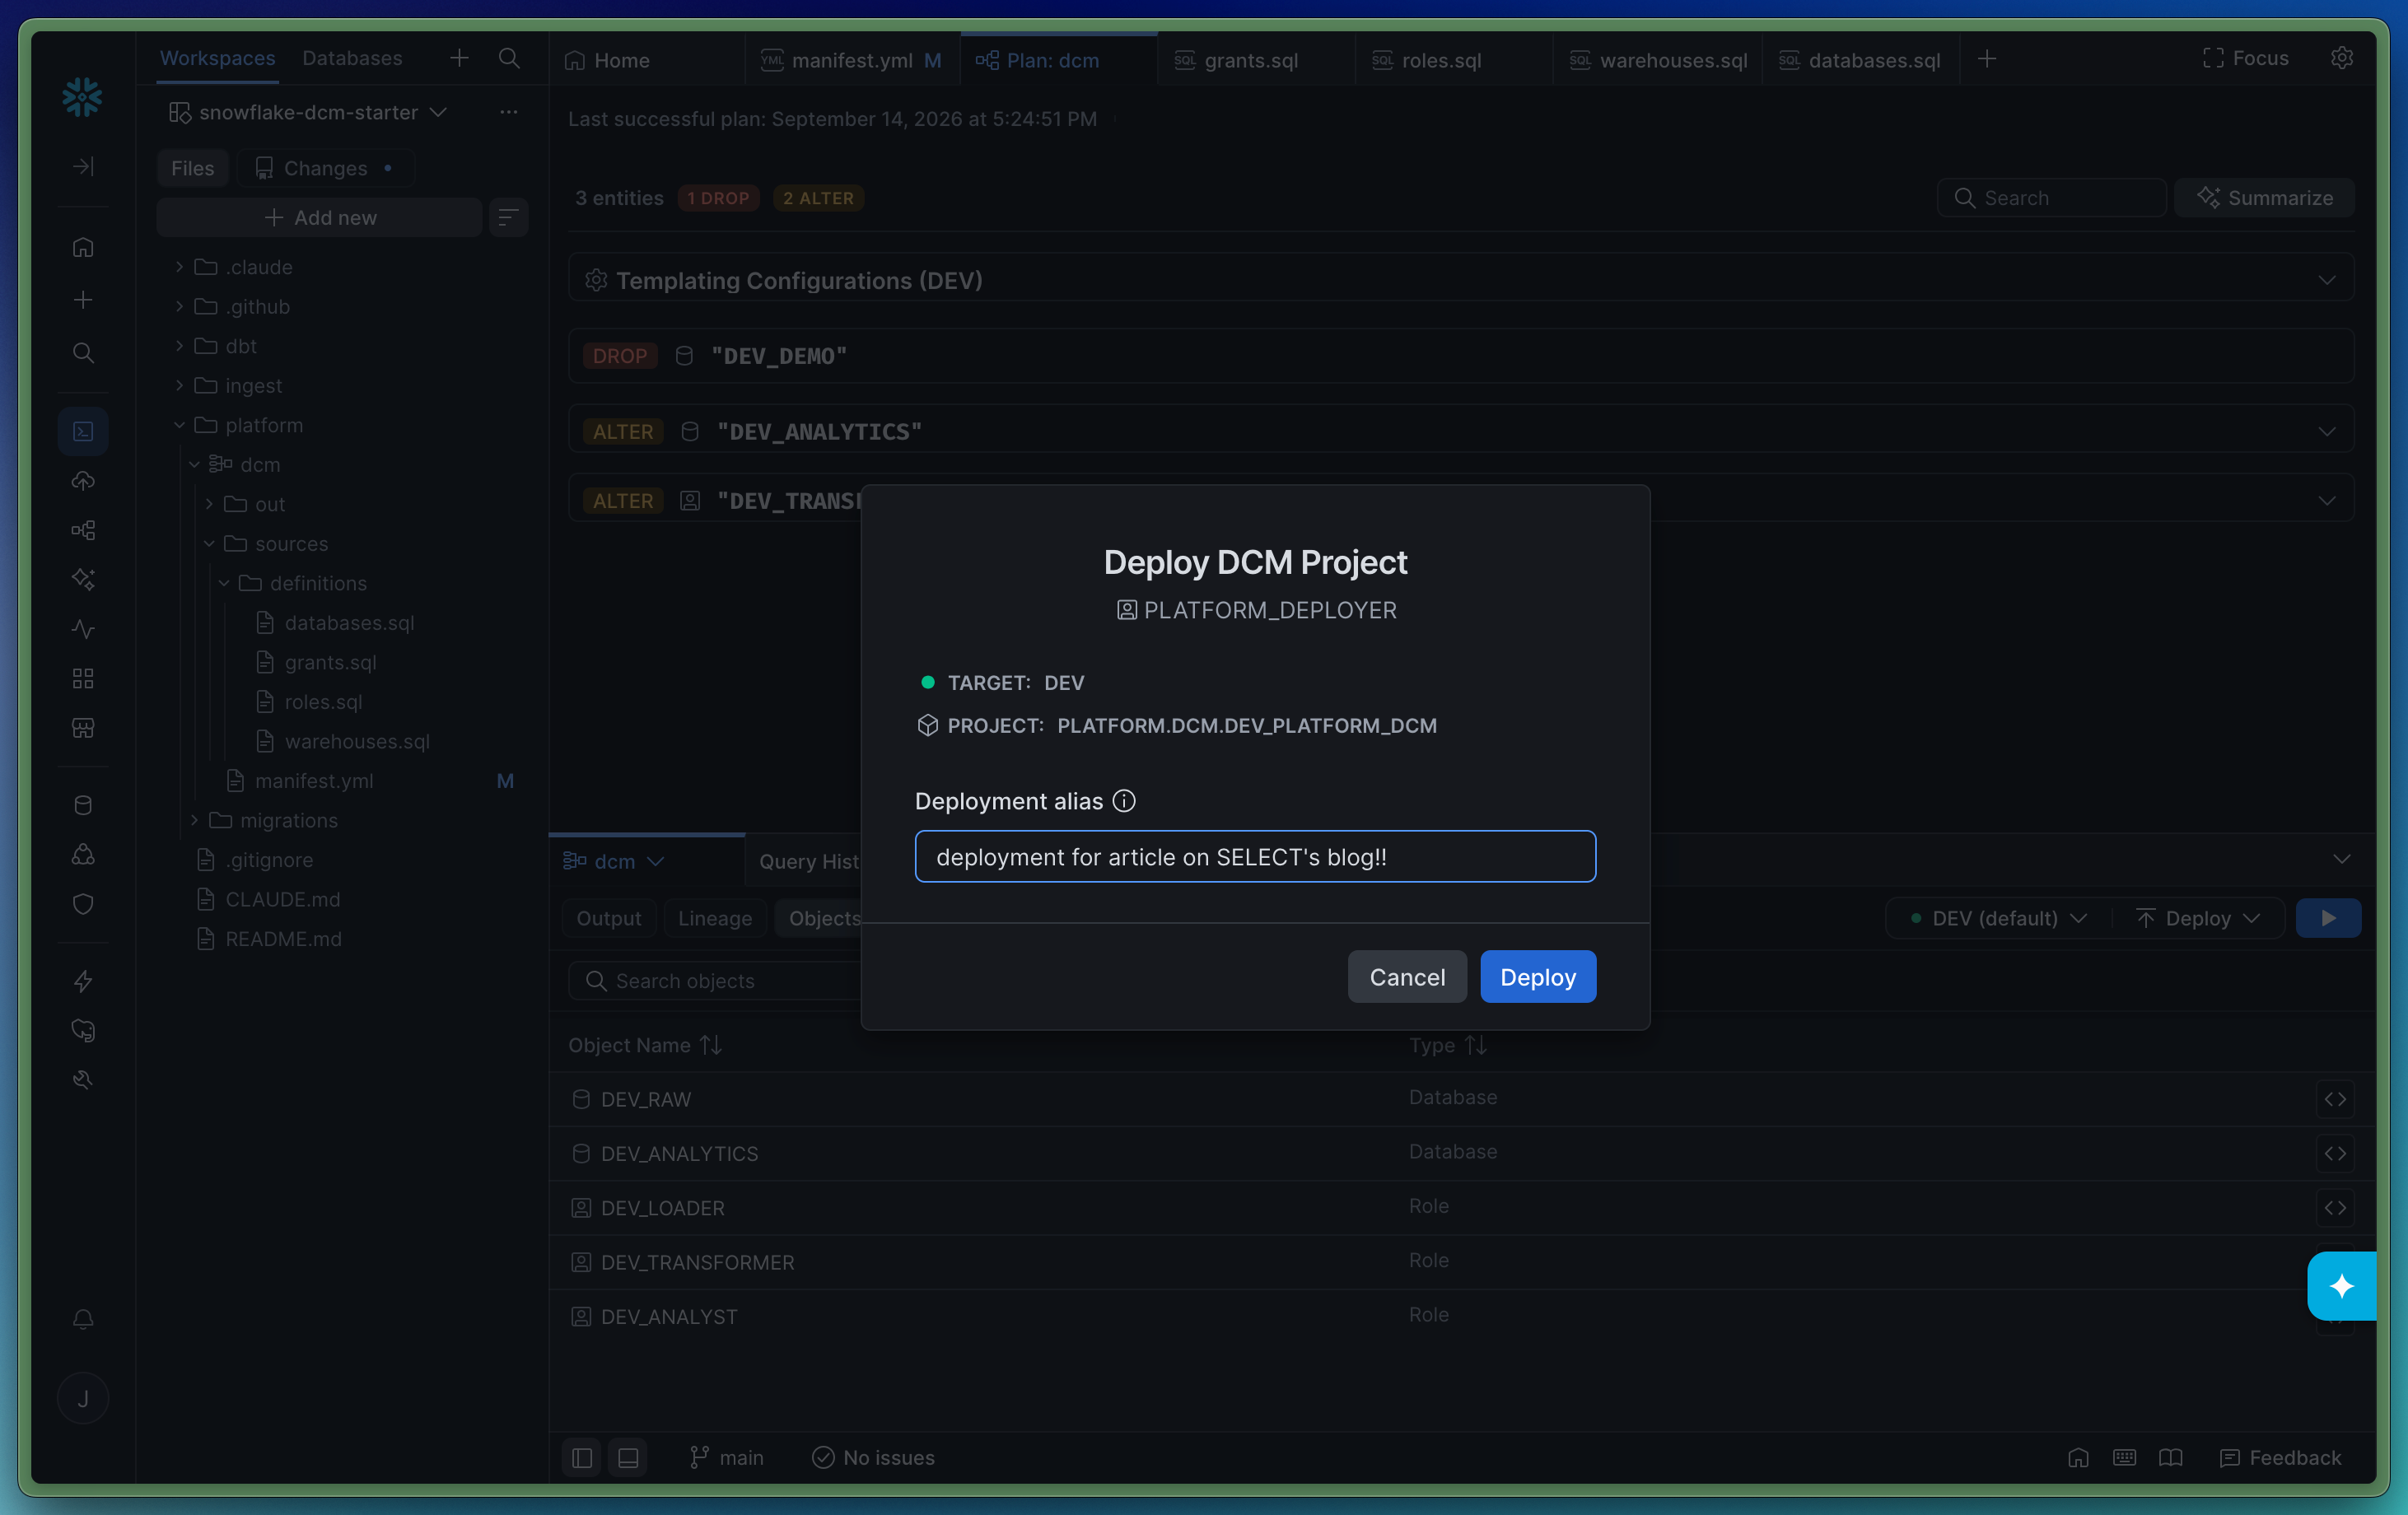
Al termine, una notifica compare in alto al centro dello schermo per avvisarti che il deploy è completato.
La scheda Output mostra l'output CLI di tutte le tue esecuzioni:

Se avessimo un DAG di Dynamic Tables o Task, comparirebbe nella scheda lineage, ma questo progetto non ne contiene.
Eseguire DCM in locale con la CLI
Personalmente faccio tutto il mio lavoro in Visual Studio Code. Ecco una rapida panoramica di come si presenta un deployment in VS Code. dcm è un sotto-comando del comando CLI snow. Quindi, se hai installato la CLI snow, hai già DCM! Qui mostro snow dcm plan e snow dcm deploy in un unico screenshot.
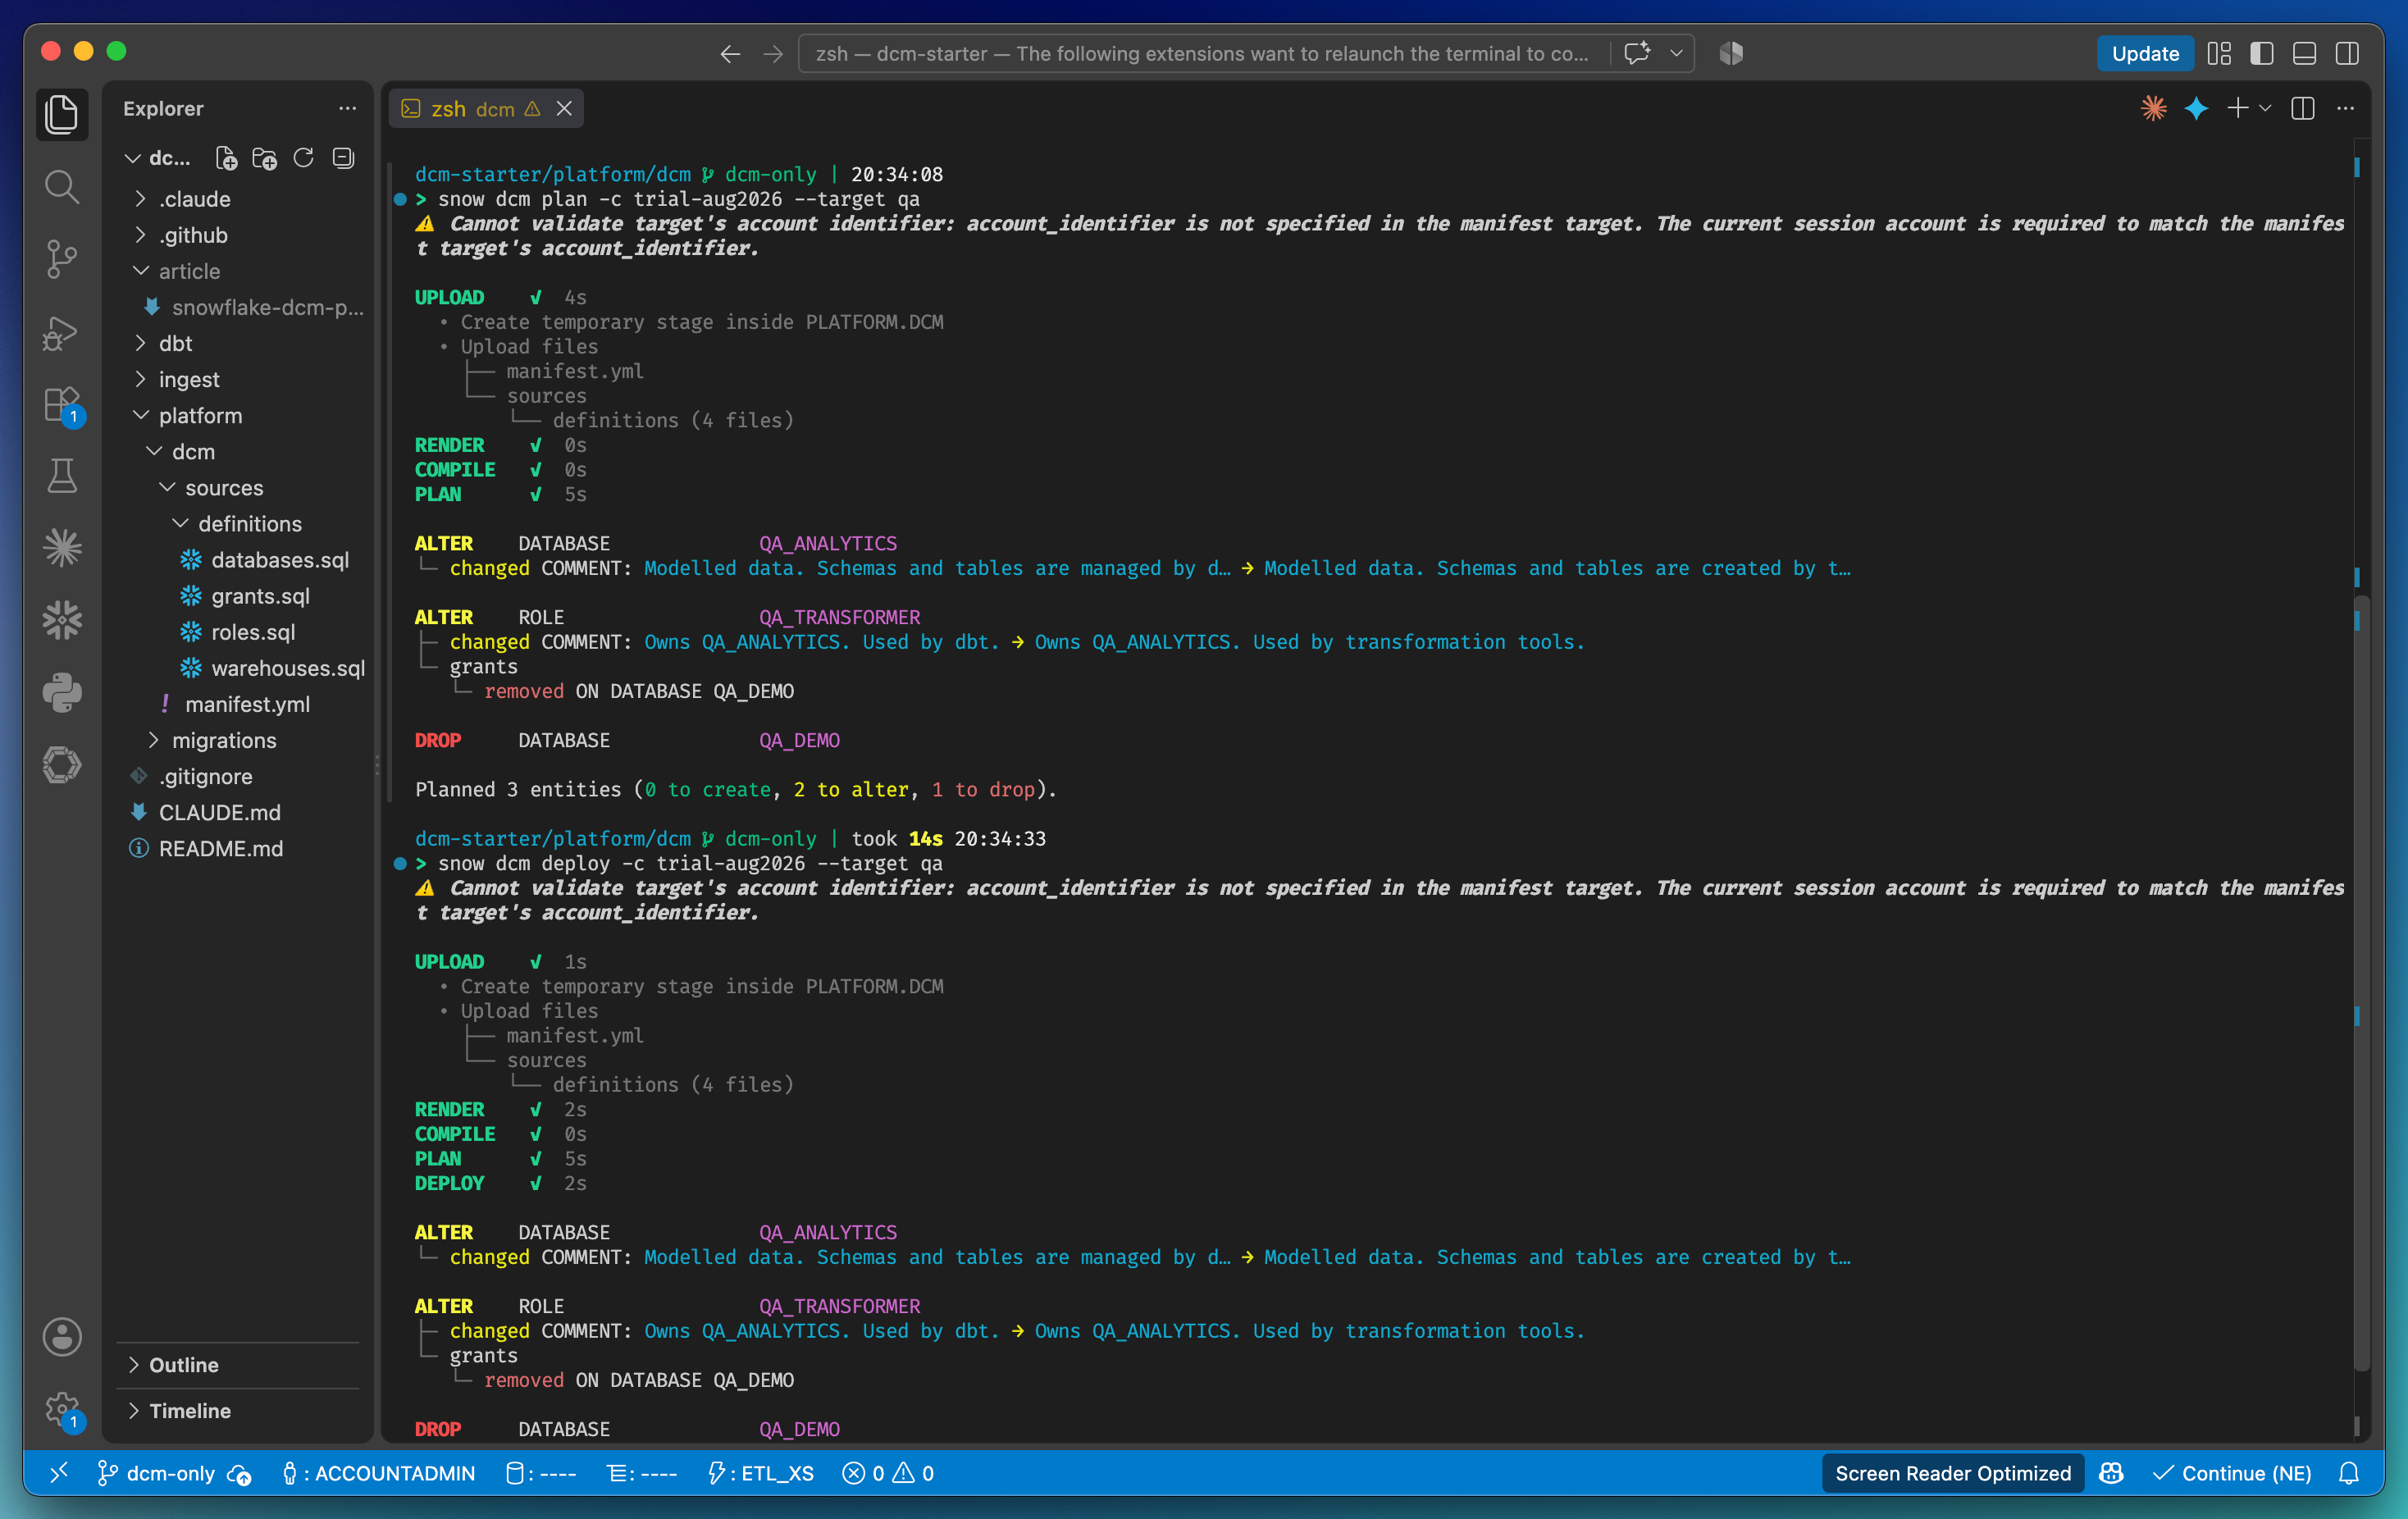
Ora posso iterare sui file in locale, fare il deploy nel mio ambiente dev, aprire una PR che fa plan e deploy su QA ed esegue il plan su prod. Un workflow davvero a misura di sviluppatore!
DCM e le alternative a confronto
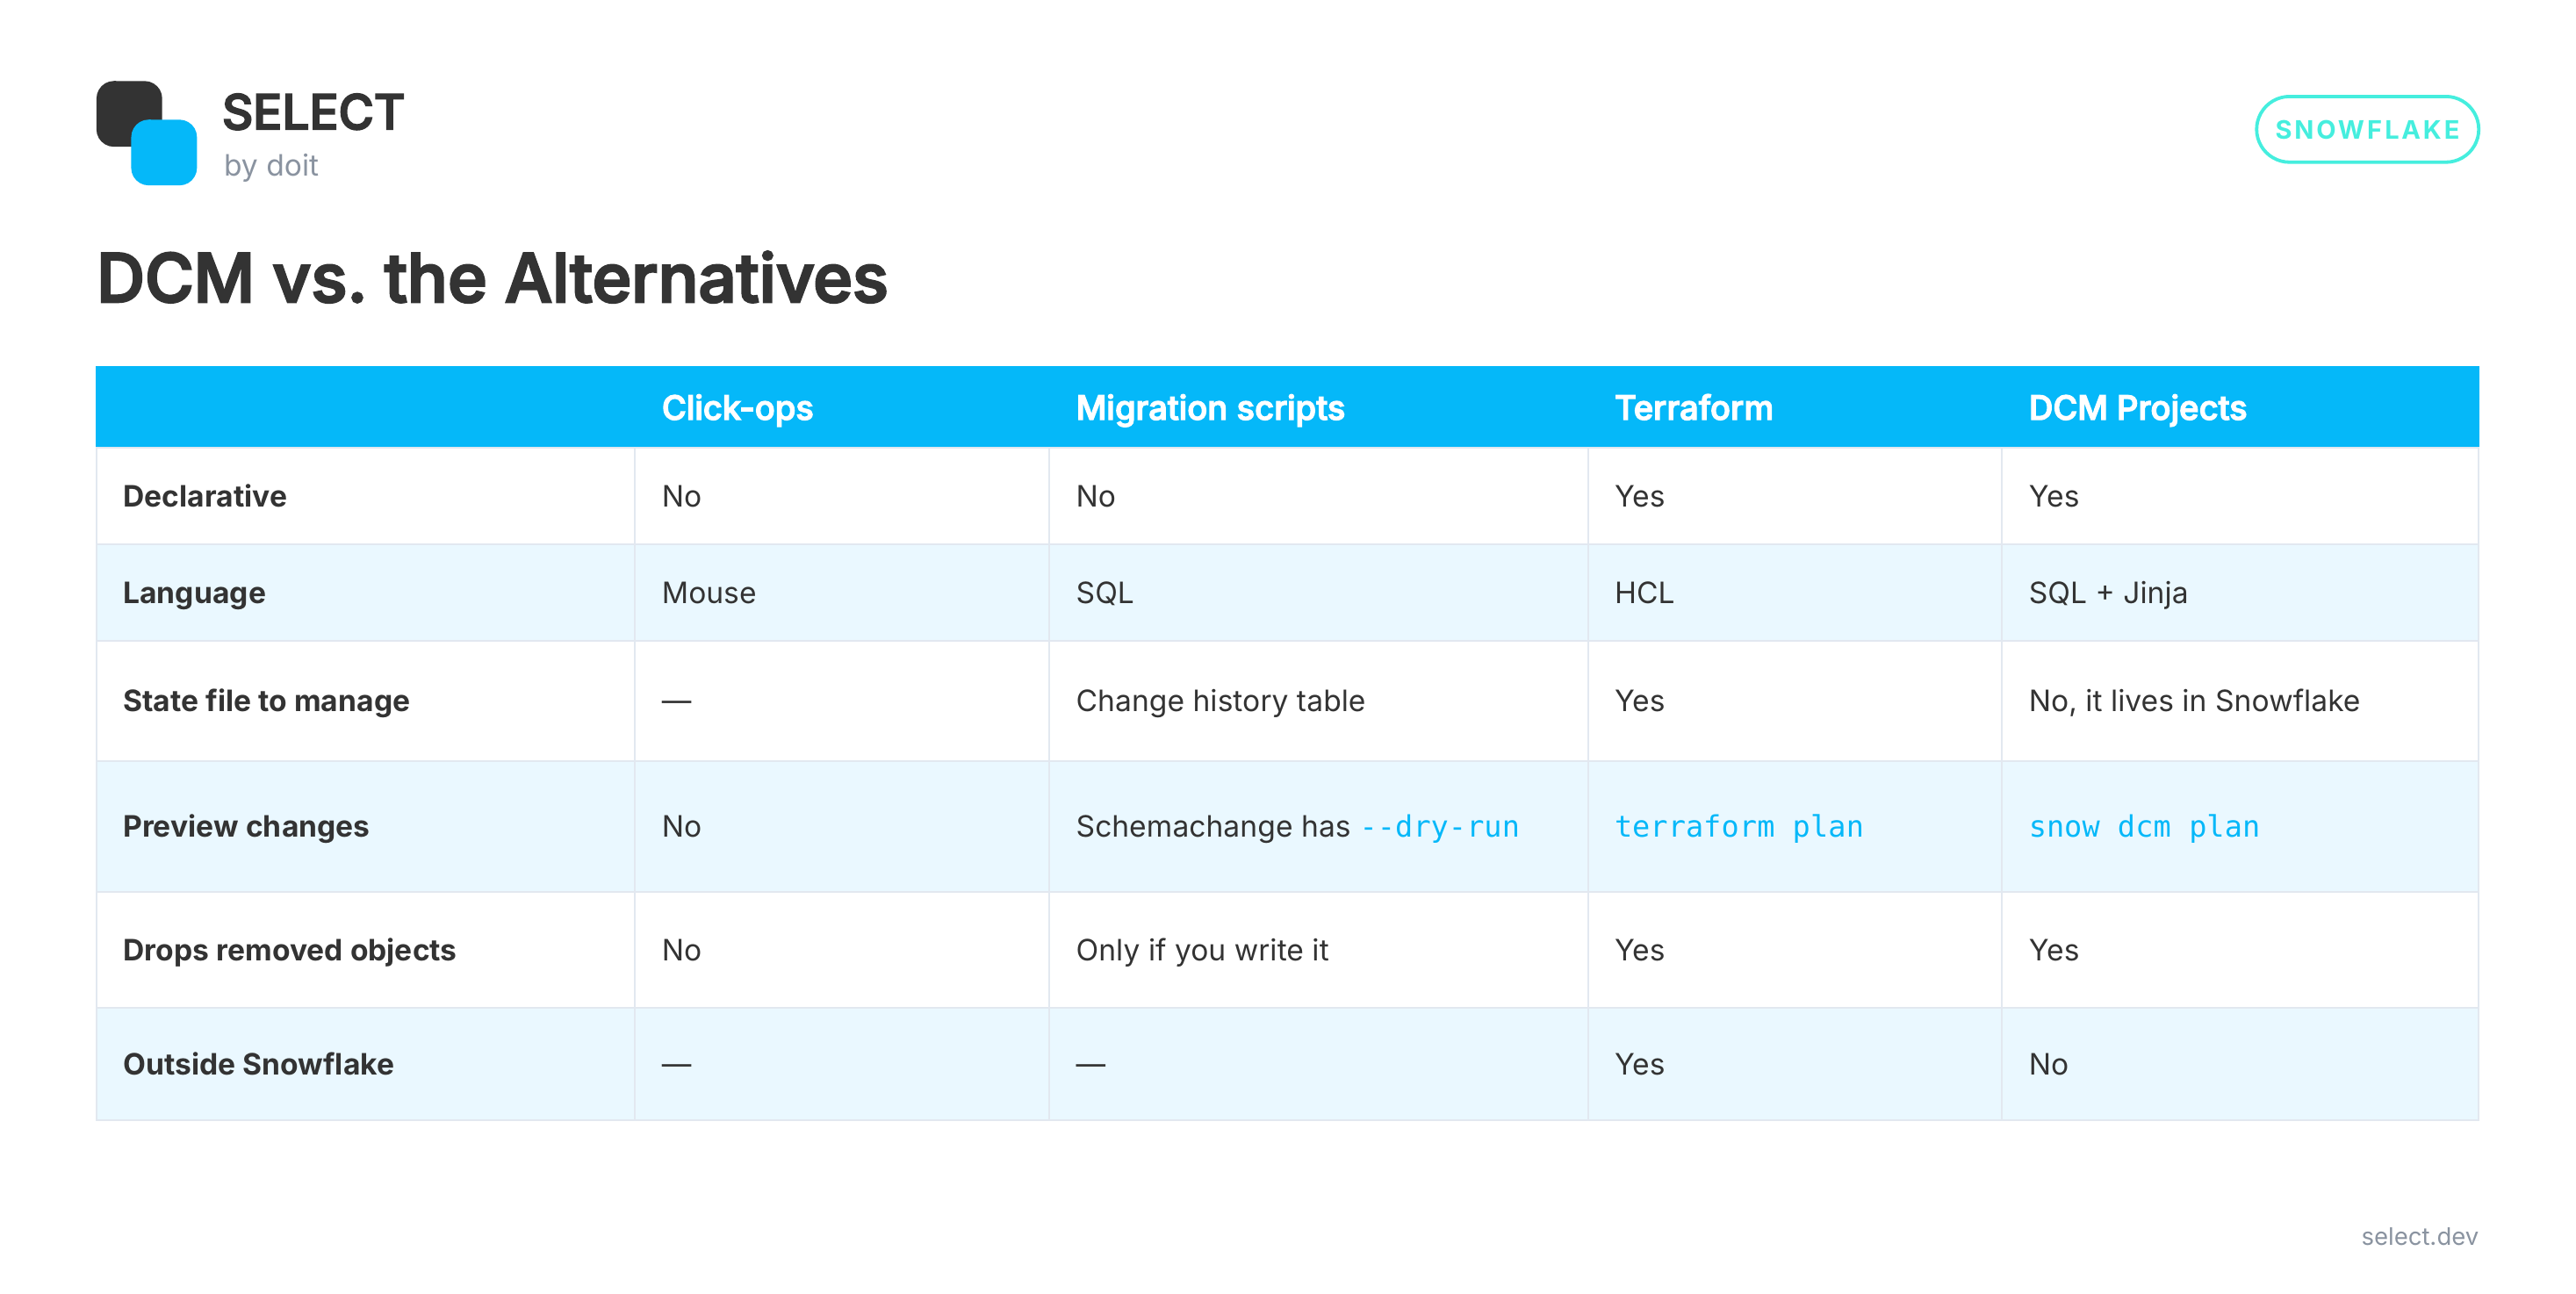
Se gestisci AWS, Snowflake e il tuo DNS in un unico repo Terraform, Terraform ha ancora senso. Se l'infrastruttura del tuo team è fondamentalmente Snowflake e il tuo team parla già SQL, DCM è il percorso con meno attriti che io abbia trovato.
Provalo tu stesso
Ho messo tutto questo in un repo starter: https://github.com/jeff-skoldberg-gmds/snowflake-dcm-starter.
Include le definizioni, le migrazioni di bootstrap, entrambi i workflow di GitHub Actions e le skill per Claude Code. Esegui /project-setup e ti guida attraverso l'account, il manifest, il bootstrap, il primo deploy e la CI, un passaggio verificato alla volta.
Contiene anche cartelle ingest/ e dbt/ vuote, perché DCM è solo la base. Dovresti costruire un mono-repo per la tua piattaforma Snowflake che includa il caricamento e la trasformazione dei dati. I ruoli e i database aspettano solo le tue pipeline.
Ora provalo, e fammi sapere se l'infrastructure as code su Snowflake ti sembra ancora una seccatura!