
TLDR
- Os DCM Projects são a forma nativa e declarativa do Snowflake de gerenciar objetos como código. Você escreve
DEFINE <objeto>em vez deCREATE <objeto>(por exemplo,DEFINE DATABASE), e o Snowflake descobre o que precisa mudar. - O ciclo é: editar as definições, planejar e depois fazer o deploy. O plano é um diff somente leitura. O deploy aplica as mudanças.
- O DCM remove o que você deixa de definir. Apague uma linha e perca um banco de dados. Leia o plano.
- Um
manifest.ymlmais Jinja te dáDEV,QAePRODa partir de um único conjunto de arquivos. - O DCM pode gerenciar tabelas e views, mas, na minha opinião, não deveria quando você já usa dbt. Deixe o DCM cuidar da plataforma (roles, bancos de dados, warehouses, grants) e deixe o dbt cuidar do que está dentro dos bancos de dados.
- O design de roles e bancos de dados vem do guia de configuração de Snowflake da dbt Labs, que centenas de projetos dbt já seguiram. O repositório traz algumas melhorias e transforma tudo em código.
- Aqui está o repositório no GitHub em que este artigo se baseia, com CI/CD via GitHub Actions que nunca toca no
ACCOUNTADMIN.
Como chegamos até aqui
Se você usa Snowflake há algum tempo, provavelmente já gerenciou a infraestrutura da sua conta de uma destas três formas:
- Click-ops. Alguém com
ACCOUNTADMINcria um objeto no Snowsight numa terça-feira. Ninguém lembra por quê. Três anos depois, ninguém tem coragem de removê-lo. - Scripts de migração:
V1__create_roles.sql,V2__grant_things.sql,V47__fix_the_grant_from_V2.sql. Ferramentas como o schemachange executam tudo em ordem. Funciona, mas o "estado atual" da sua conta é a soma de 47 arquivos — e boa sorte para ler isso. - Terraform. Declarativo e poderoso. Mas também traz HCL, um provider para manter atualizado e um arquivo de estado que você precisa armazenar, travar e, de vez em quando, submeter a uma cirurgia. Para muitos times de dados, isso é uma disciplina inteiramente nova só para criar um warehouse.
Os DCM Projects são a resposta do Snowflake para isso. Você tem o modelo declarativo do Terraform, mas a linguagem é SQL e o estado vive no Snowflake.
O blueprint: os grant statements que todo mundo copiou
Antes de entrarmos no DCM, crédito a quem merece. Se você já configurou o Snowflake para dbt, há uma boa chance de ter lido o post da Claire Carroll, Setting up Snowflake — the exact grant statements we run, no Discourse do dbt. Centenas de projetos dbt foram configurados seguindo aquele roteiro. Eu mesmo já segui mais vezes do que consigo contar.
O design é simples, e é por isso que funciona:
- Um banco de dados
rawpara os dados que chegam e um bancoanalyticspara os dados modelados. - Uma role
loaderque escreve emraw, uma roletransformerque lêrawe constróianalytics, e uma rolereporterque lêanalyticse nada mais. - Future grants, para que novos schemas e tabelas fiquem legíveis sem ninguém precisar mexer um dedo.
O problema nunca foi o design. O problema é que é uma lista de statements que você cola em uma worksheet uma única vez. Seis meses depois, ninguém sabe dizer se a conta ainda corresponde a ela, e a extensão de "ambiente de dev" no fim do post fica como exercício para o leitor.
Então o repositório inicial mantém o formato da Claire e muda algumas coisas:
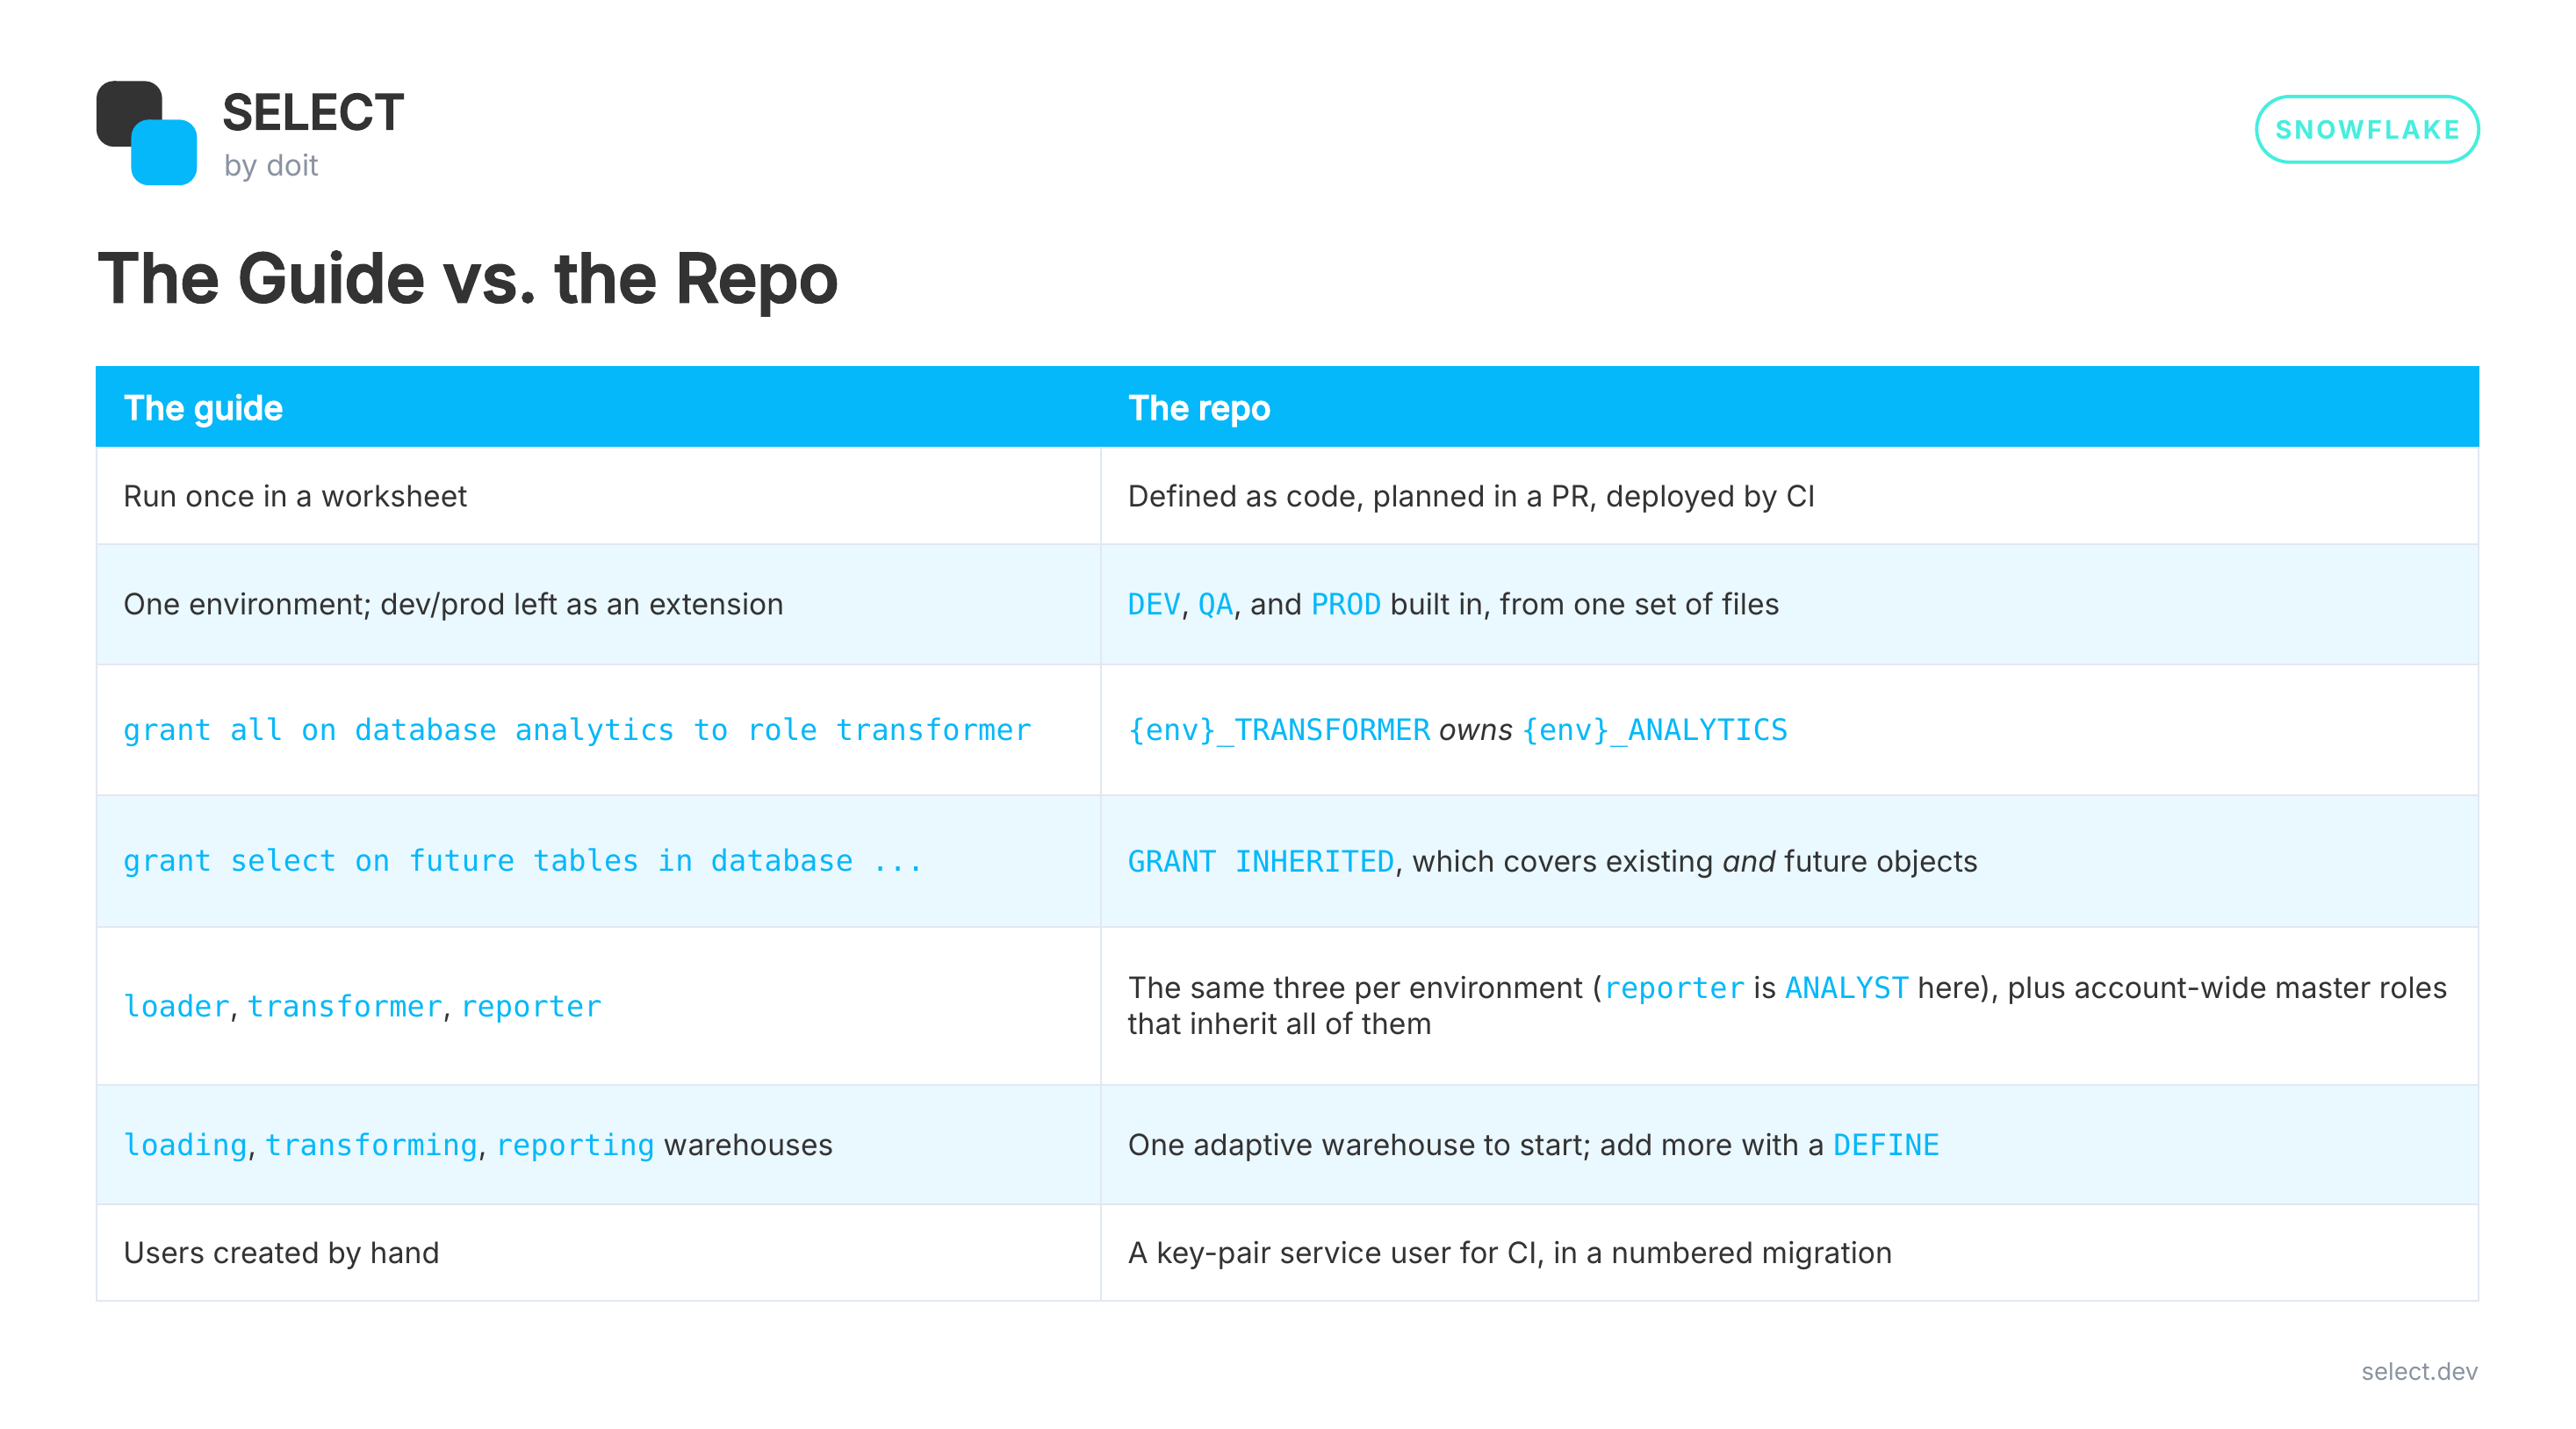
Por que inherited grants substituem future grants
Essa linha dos grants é a mudança que mais importa, então vamos nos aprofundar.
Future grants foram a ferramenta certa por muito tempo! São eles que tornam a configuração da Claire de baixa manutenção. Mas eles têm três problemas, e quem roda Snowflake há alguns anos já esbarrou em pelo menos um:
- Eles só cobrem o futuro. Um future grant não faz nada por tabelas que já existem, então toda configuração o combina com um statement
grant select on all tables. São dois statements por privilégio e duas coisas para lembrar. - Future grants no nível do schema sobrepõem os do nível do banco de dados. Se alguém adicionar um future grant em um schema, o Snowflake ignora os future grants no nível do banco para aquele schema. Sua role
reportersilenciosamente deixa de receber novas tabelas ali, e nada dá erro. - Eles são uma cópia pontual, não uma regra. Um future grant é aplicado a cada objeto no momento em que o objeto é criado. Revogue ou altere o future grant depois, e todo objeto que ele já tocou mantém o privilégio antigo. O grant que você enxerga não descreve mais o acesso que as pessoas realmente têm.
Um inherited grant é um único statement em um contêiner (a conta, um banco de dados ou um schema) e se aplica a todo objeto correspondente dentro dele, existente ou futuro:
GRANT INHERITED SELECT ON ALL TABLES IN DATABASE {{ env }}_ANALYTICS TO ROLE {{ env }}_ANALYST;Isso substitui, de uma vez, o future grant, o grant on all e a versão por schema de cada um. Quando você quiser saber por que alguém consegue ler uma tabela, o SHOW GRANTS tem as colunas IS_INHERITED e INHERITED_FROM, que apontam para o grant responsável.
Também é um encaixe natural para o DCM. Uma ferramenta declarativa quer uma única linha que declare a regra. "Analistas podem ler tudo em ANALYTICS" agora é uma linha, não seis.
Alguns trade-offs para conhecer:
- Sem exceções. Você não pode revogar o privilégio em uma tabela específica para abrir uma exceção. A documentação do Snowflake avisa que o revoke parece ter sucesso enquanto a role mantém o acesso por meio do inherited grant. Se uma tabela precisa de acesso diferente, ela pertence a outro schema ou banco de dados.
- Mover ou clonar um objeto para dentro de um contêiner muda quem pode vê-lo, sem nenhum statement de
GRANTem lugar algum. Esse é justamente o objetivo, mas seja intencional com os clones. OWNERSHIPnão pode ser herdado. A propriedade continua sendo um grant comum.- É preciso uma flag na conta,
FEATURE_RBAC_INHERITED_GRANTS, que só oACCOUNTADMINpode definir. Falo mais sobre isso no bootstrap abaixo.
O que é um DCM Project no Snowflake?
Duas coisas:
- Uma pasta de arquivos. Um
manifest.ymle alguns arquivos.sqlcheios de statementsDEFINE. - Um objeto DCM project no Snowflake. Ele vive em um schema como qualquer outro objeto e guarda o histórico de deployments.
Aqui está a estrutura do meu repositório inicial:
platform/ dcm/ manifest.yml sources/definitions/ roles.sql databases.sql warehouses.sql grants.sql migrations/ 000_bootstrap.sql 001_ci_deployer.sqlUm arquivo por tipo de objeto é uma convenção minha, não uma regra do DCM. O Snowflake lê tudo dentro de sources/, então organize do jeito que fizer sentido para você.
DEFINE, não CREATE
Essa é toda a mudança de mentalidade. Com um script de migração, você escreve instruções:
CREATE ROLE IF NOT EXISTS DEV_LOADER;ALTER ROLE DEV_LOADER SET COMMENT = 'Owns DEV_RAW';Com o DCM, você escreve o estado final:
DEFINE ROLE DEV_LOADER COMMENT = 'Owns DEV_RAW. Used by ingestion tools.';Se a role não existe, o DCM a cria. Se ela existe com um comentário diferente, o DCM a altera. Se já estiver igual, o DCM não faz nada. Você nunca mais escreve IF NOT EXISTS, e nunca mais escreve um ALTER para corrigir algo que você mesmo escreveu na semana passada.
Grants funcionam do mesmo jeito. Você não faz DEFINE de um grant, apenas o declara:
DEFINE DATABASE DEV_RAW  COMMENT = 'Landing zone. Schemas and tables are created by ingestion tools.';
GRANT OWNERSHIP ON DATABASE DEV_RAW TO ROLE DEV_LOADER;
Planeje, depois faça o deploy
Toda mudança passa por duas etapas. Com o Snowflake CLI:
snow dcm plan --from platform/dcm --target DEV \ --connection my_account --role PLATFORM_DEPLOYERO plano compara seus arquivos com o que está na conta e diz exatamente o que seria criado, alterado e removido. Ele não muda nada.
[screenshot: plan output for adding a database]
Gostou do resultado? Faça o deploy:
snow dcm deploy --from platform/dcm --target DEV --alias add_marketing_db \ --connection my_account --role PLATFORM_DEPLOYERO --alias é opcional, mas use, por favor. Sem ele, seu histórico de deployments vira uma lista de nomes gerados automaticamente que ninguém consegue ler. Com ele, o snow dcm list-deployments fica parecendo um changelog: add_marketing_db, analyst_read_on_analytics, drop_legacy_loader.
Você também pode fazer tudo isso em SQL (EXECUTE DCM PROJECT ... PLAN), e o Snowsight Workspaces tem uma interface para isso. Eu vivo no terminal, então o CLI é o que você vai ver aqui.
O DCM remove o que você deixa de definir
Essa é a parte que pode te pegar de surpresa.
Se você remover um DEFINE que já foi implantado, o próximo deploy remove aquele objeto.
Esse é o comportamento correto para uma ferramenta declarativa. Os arquivos são a conta. Mas isso significa que dois hábitos são inegociáveis:
- Sempre planeje antes do deploy. Um
DROPinesperado no plano significa que uma definição sumiu, não que o DCM está sendo prestativo. - Leia o plano no seu PR. Falo mais sobre como automatizo isso abaixo.
Mais um detalhe: a documentação do Snowflake é transparente ao dizer que um deploy com falha pode deixar uma execução parcial. Não é uma grande transação única. Corrija a definição e rode plan → deploy de novo, em vez de consertar as coisas na mão.
DEV, QA e PROD a partir de um único conjunto de arquivos
Ninguém quer três cópias do roles.sql. O manifest.yml define targets, e cada target aponta para seu próprio objeto de projeto e passa suas próprias variáveis de template:
manifest_version: 2type: DCM_PROJECTdefault_target: DEV
targets:  DEV:    account_identifier: ABCDEFG-XY12345    project_name: PLATFORM.DCM.DEV_PLATFORM_DCM    project_owner: PLATFORM_DEPLOYER    templating_config: DEV  # QA and PROD look the same
templating:  configurations:    DEV:
Expandir código
Depois, cada definição usa {{ env }} como prefixo:
DEFINE DATABASE {{ env }}_RAW  COMMENT = 'Landing zone. Schemas and tables are created by ingestion tools.';
DEFINE DATABASE {{ env }}_ANALYTICS  COMMENT = 'Modelled data. Schemas and tables are created by transformation tools.';
GRANT OWNERSHIP ON DATABASE {{ env }}_RAW TO ROLE {{ env }}_LOADER;GRANT OWNERSHIP ON DATABASE {{ env }}_ANALYTICS TO ROLE {{ env }}_TRANSFORMER;
Faça o deploy com --target DEV e você obtém DEV_RAW. Faça o deploy com --target PROD e você obtém PROD_RAW. Os mesmos arquivos.
A parte complicada: objetos de nível de conta
Alguns objetos não pertencem a um ambiente específico. No meu template, os três ambientes compartilham uma conta, um warehouse e um conjunto de roles "master" como LOADER, que herdam DEV_LOADER, QA_LOADER e PROD_LOADER.
Se eu definisse COMPUTE_XS sem nenhuma condição, os três targets reivindicariam o objeto, e o deploy de cada target brigaria por ele. Então os objetos de nível de conta são definidos em exatamente um target, com um if do Jinja e um loop:
{% if env == 'PROD' %}{% set envs = ['DEV', 'QA', 'PROD'] %}
DEFINE WAREHOUSE COMPUTE_XS  WAREHOUSE_TYPE = 'ADAPTIVE'  MAX_QUERY_PERFORMANCE_LEVEL = XSMALL  QUERY_THROUGHPUT_MULTIPLIER = 2  COMMENT = 'Sole compute warehouse for loads and transforms.';
{% for e in envs %}GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_LOADER;GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_TRANSFORMER;GRANT USAGE ON WAREHOUSE COMPUTE_XS TO ROLE {{ e }}_ANALYST;{% endfor %}{% endif %}
O detalhe: aquele bloco de PROD concede grants para DEV_LOADER e QA_LOADER, então DEV e QA precisam fazer deploy antes de PROD. A ordem de deploy passa a fazer parte do seu processo — e do seu CI.
Se você colocar cada ambiente em sua própria conta, isso desaparece, mas aí cada conta precisa da sua própria cópia dos objetos de nível de conta. Escolha o seu trade-off.
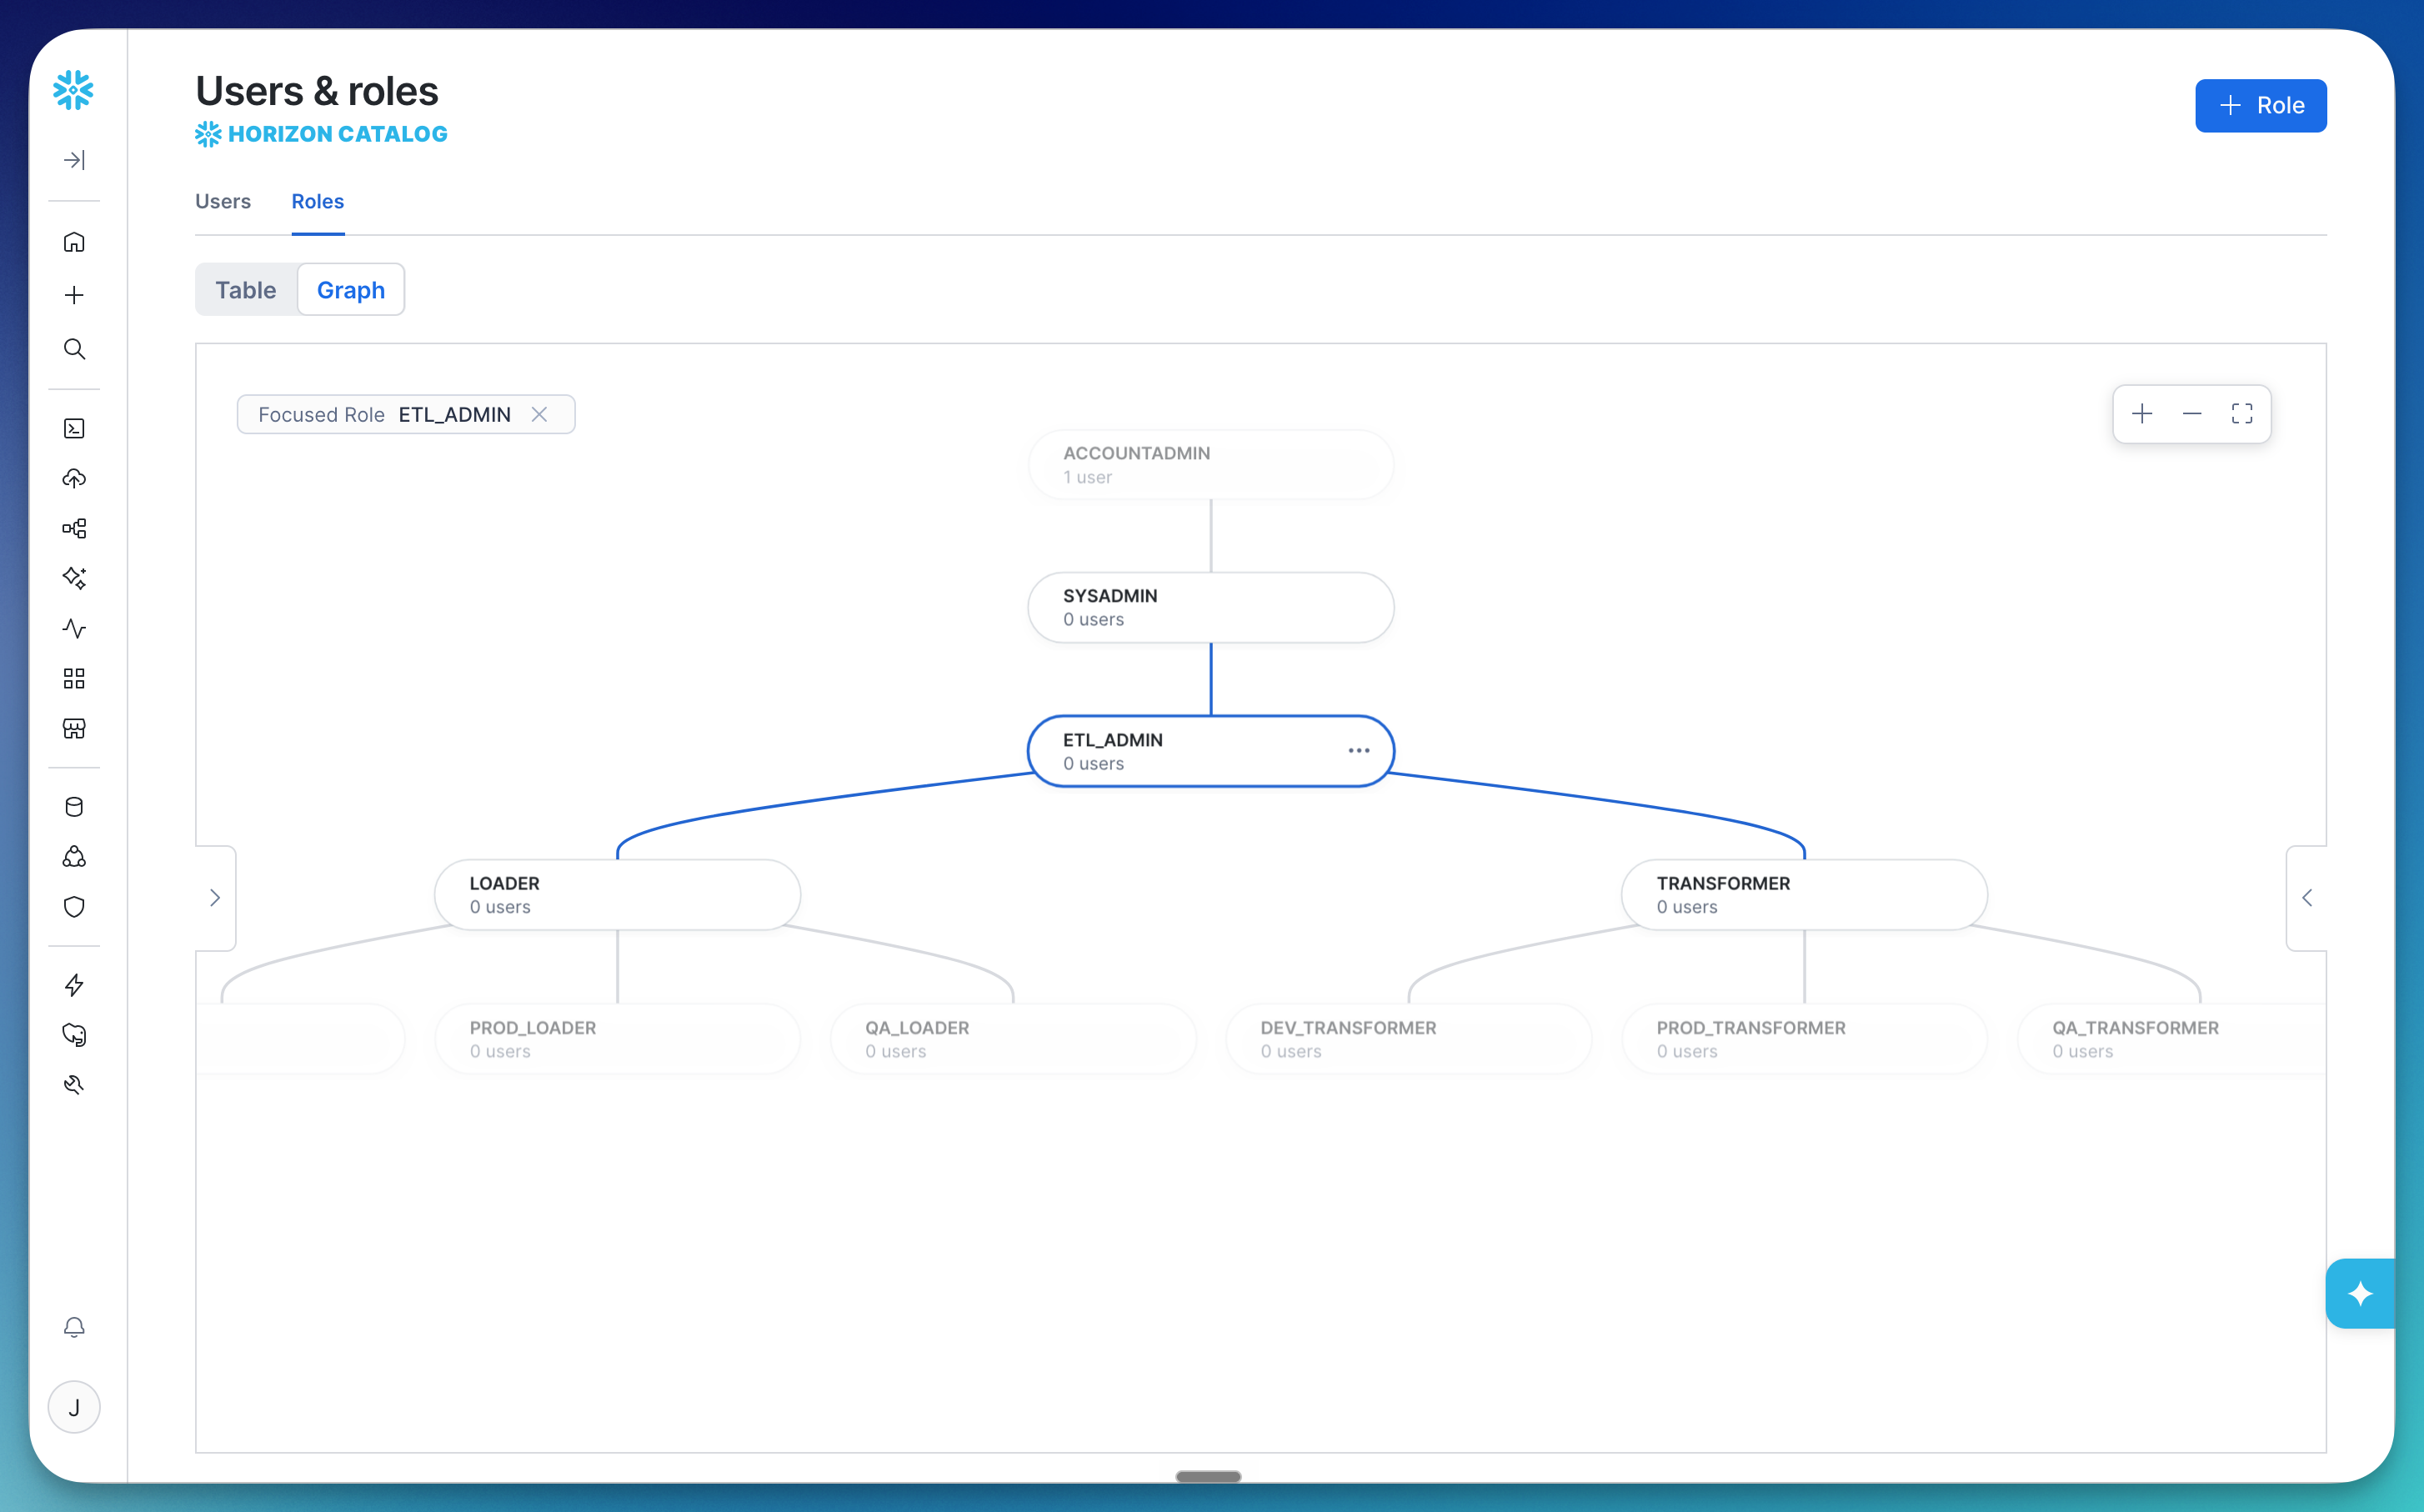
Este é o modelo de roles que o template entrega no final:
Além disso, a role de Deployer recebe diretamente as roles específicas de cada ambiente:
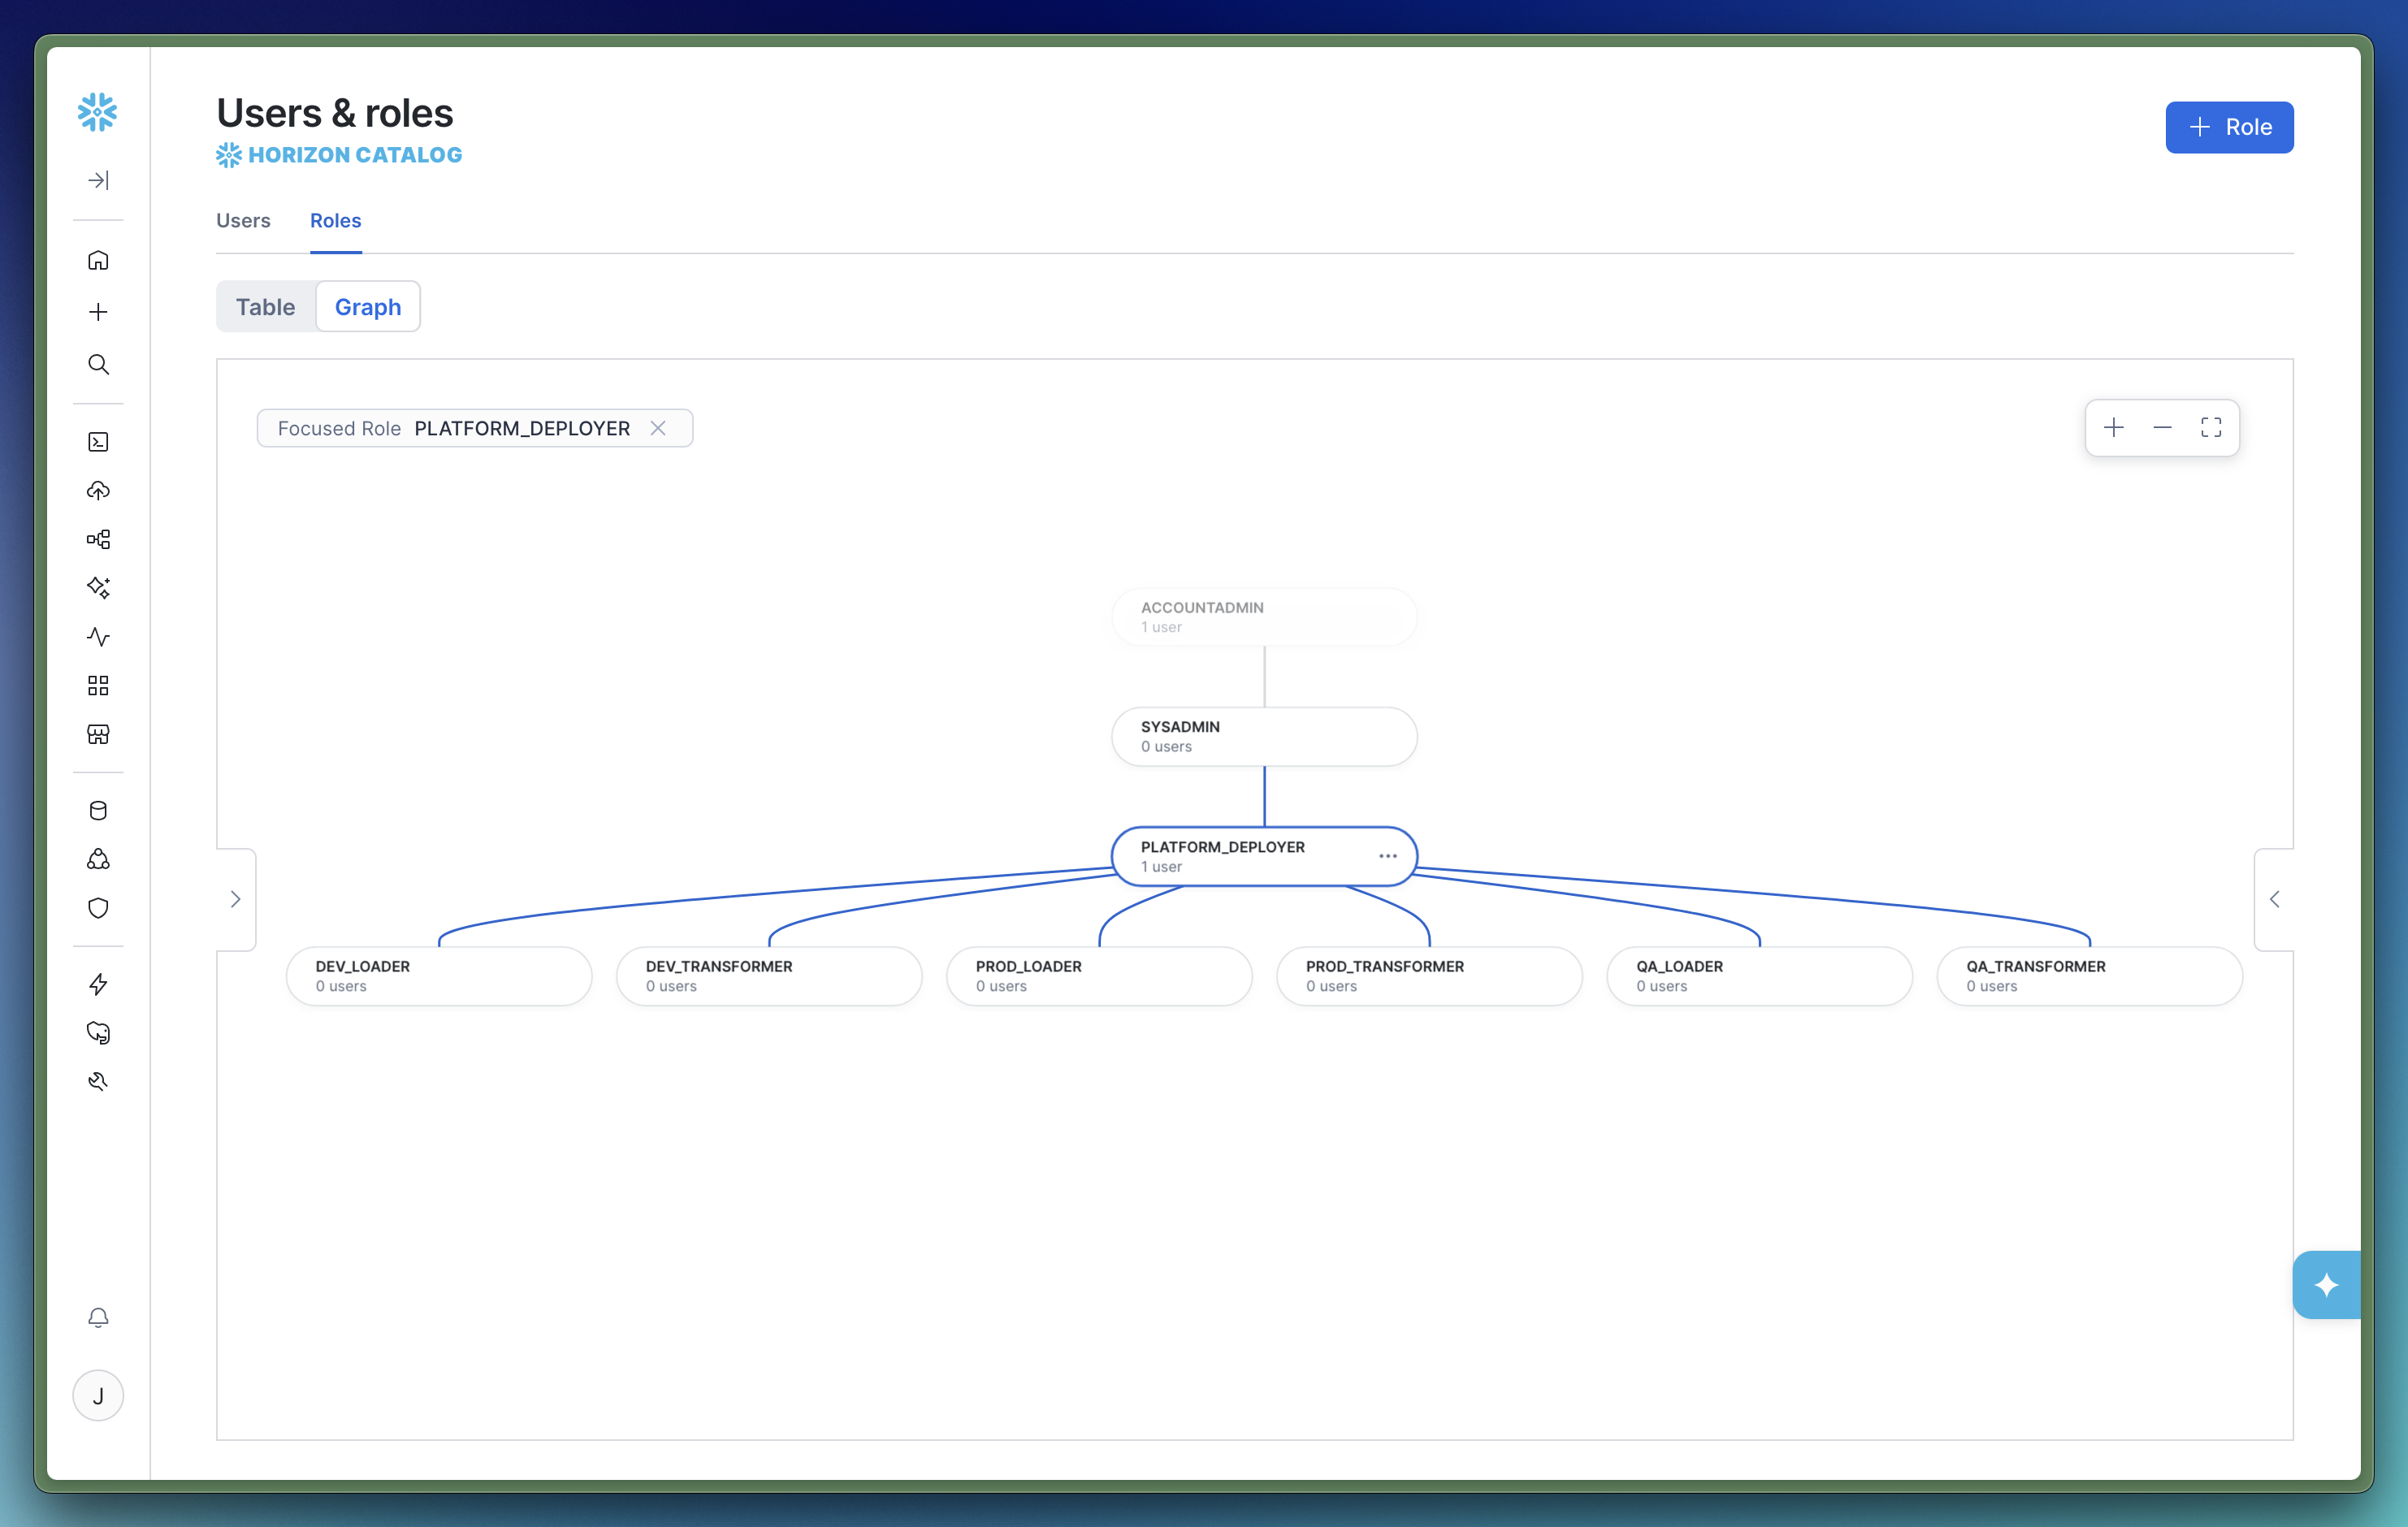
Sua ferramenta de ingestão se conecta como {env}_LOADER. O dbt se conecta como {env}_TRANSFORMER. Os analistas recebem {env}_ANALYST, que pode ler ANALYTICS e não enxerga RAW de forma alguma.
Se você usa dbt, deixe o dbt ser o dono das tabelas e schemas no banco Analytics
O DCM suporta uma longa lista de tipos de objeto: bancos de dados, schemas, tabelas, views, dynamic tables, tasks, stages, functions, procedures, masking policies, tags e mais.
Então por que o meu template só o usa para roles, bancos de dados, warehouses e grants?
Porque, se você roda dbt, o dbt já gerencia suas tabelas e views, com linhagem, testes e documentação. Coloque a mesma tabela em uma definição do DCM e agora você tem duas ferramentas que acham que são donas dela. Uma delas vai acabar derrubando o que a outra construiu.
Por isso, eu traço uma linha bem clara:
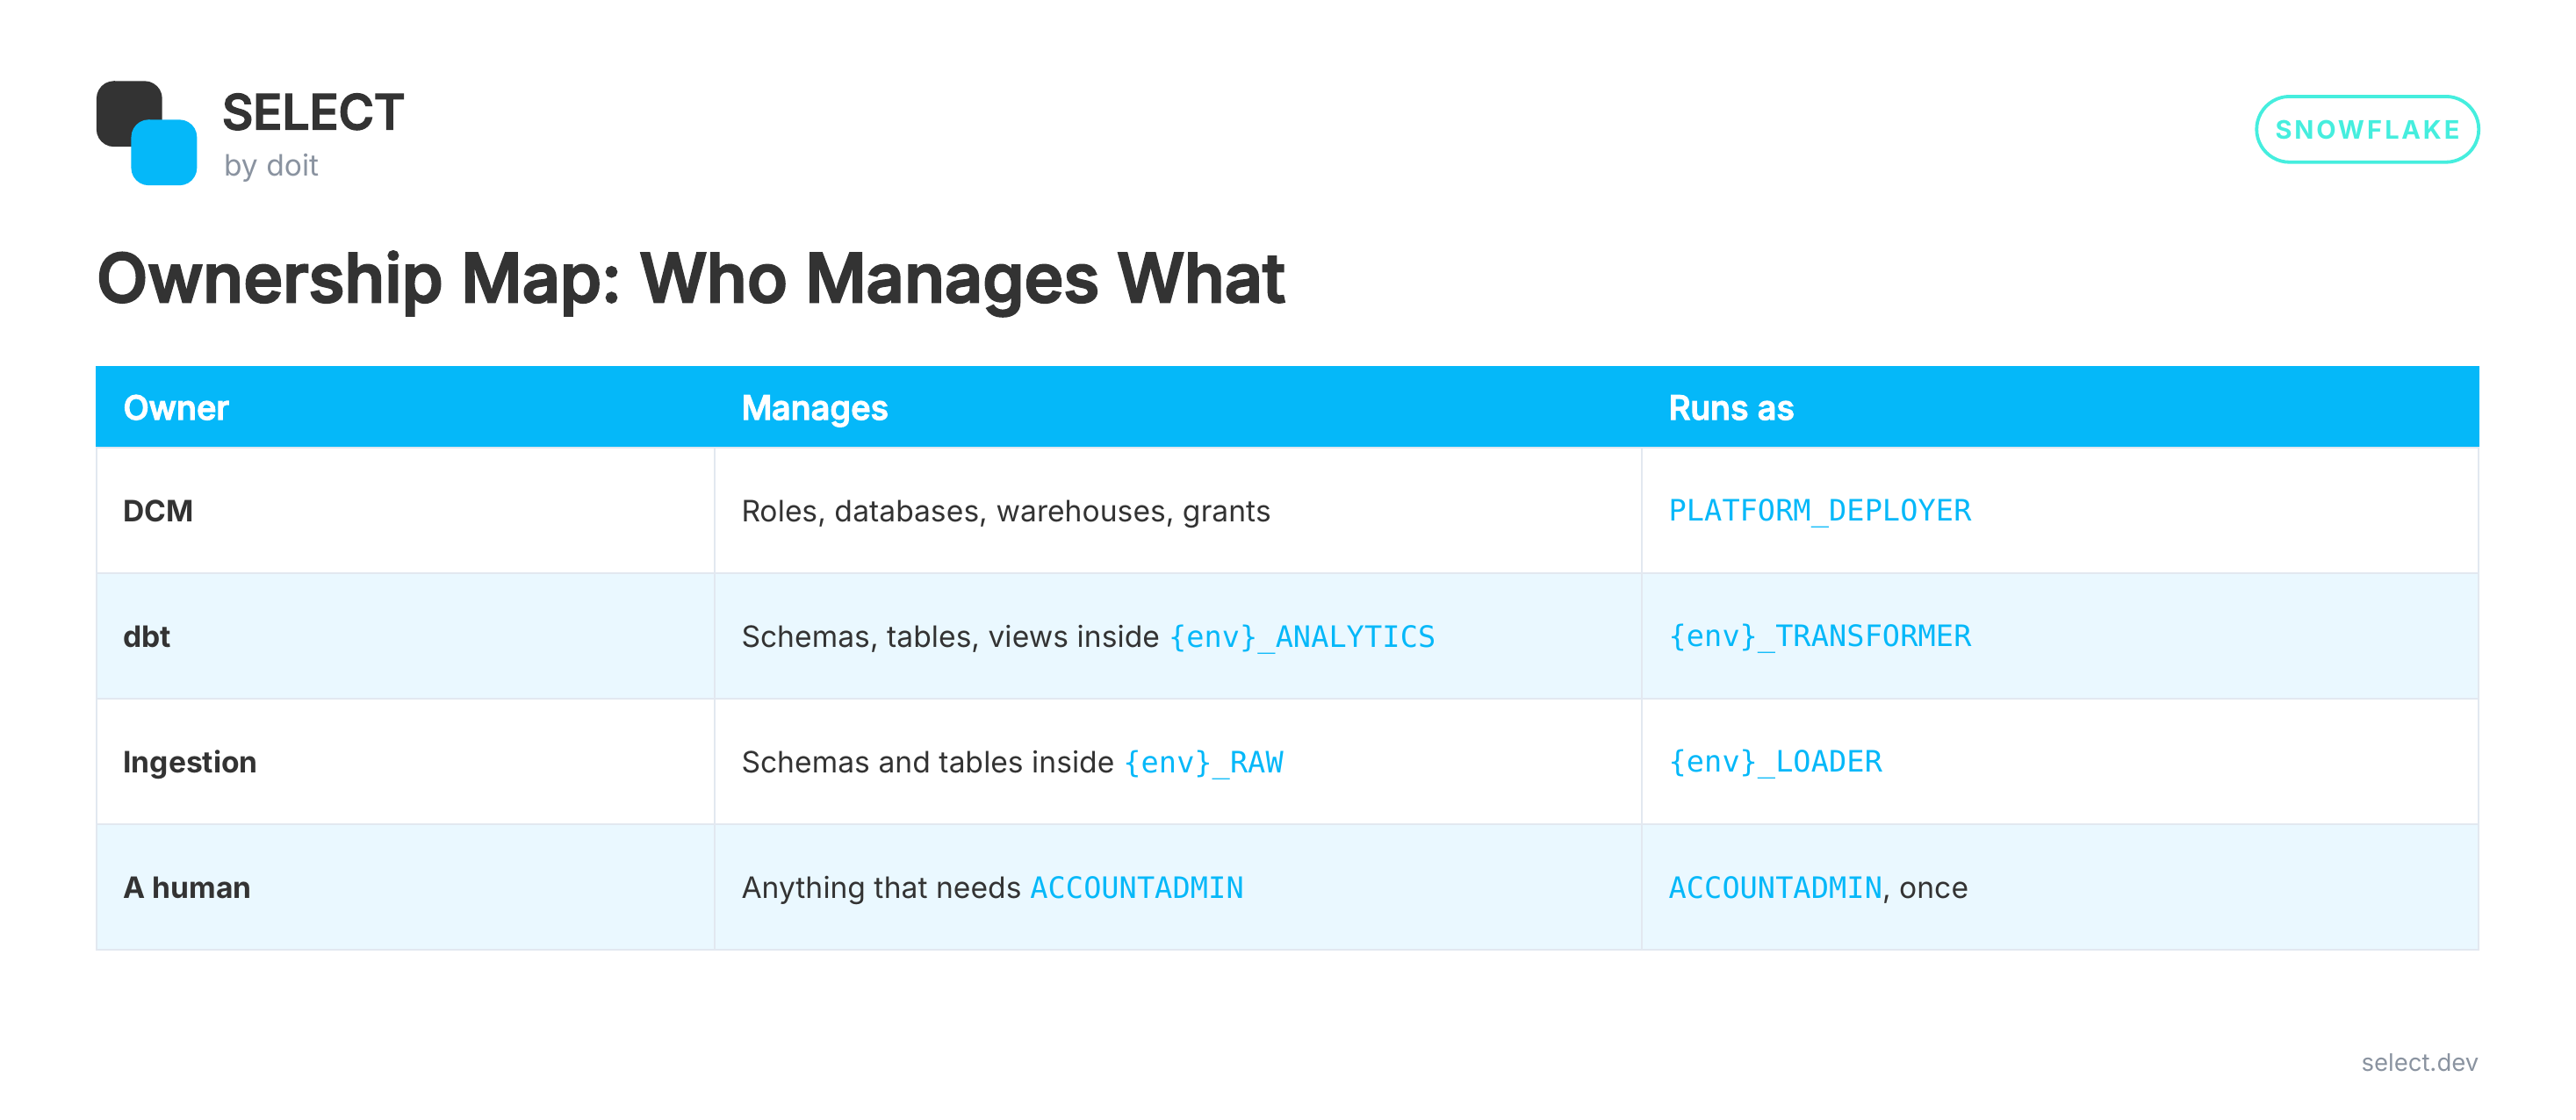
Nenhum objeto tem dois donos. Se você não usa dbt, ou se tem objetos que nenhuma ferramenta de transformação gerencia (stages, file formats, network rules), o DCM é um ótimo lugar para eles. A regra é "um dono por objeto", não "o DCM só cuida de roles".
O ovo e a galinha: bootstrap
O DCM precisa de uma role para fazer o deploy e de um objeto de projeto onde fazer o deploy. Algo tem que criar essas coisas, e esse algo precisa de ACCOUNTADMIN.
Minha regra para o repositório inteiro:
O CI/CD nunca deve precisar de
ACCOUNTADMIN.
Então tudo que realmente precisa dele vai para um arquivo SQL numerado que uma pessoa executa exatamente uma vez:
USE ROLE ACCOUNTADMIN;
ALTER ACCOUNT SET FEATURE_RBAC_INHERITED_GRANTS = 'ENABLED';
CREATE ROLE IF NOT EXISTS PLATFORM_DEPLOYER  COMMENT = 'CI/CD deployment role for DCM.';
GRANT CREATE ROLE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT CREATE DATABASE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT CREATE WAREHOUSE ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT MANAGE GRANTS ON ACCOUNT TO ROLE PLATFORM_DEPLOYER;GRANT ROLE PLATFORM_DEPLOYER TO ROLE SYSADMIN;
CREATE DATABASE IF NOT EXISTS PLATFORM;CREATE SCHEMA IF NOT EXISTS PLATFORM.DCM;
Expandir código
(Levemente resumido. O arquivo completo está no repositório.)
Depois disso, o PLATFORM_DEPLOYER faz tudo. E aqui vai um hábito que eu adoro: passe --role PLATFORM_DEPLOYER localmente também. Se uma mudança secretamente precisar de mais privilégios, ela falha no seu laptop, e não no CI numa sexta-feira à tarde.
Armadilhas em que eu caí para você não precisar cair
Inherited grants no DCM estão marcados como preview. A lista de objetos suportados pelo DCM do Snowflake sinaliza inherited grants e MANAGE GRANTS em nível de contêiner como recursos em preview. Funcionaram bem para mim, mas confira a documentação antes de apostar o acesso de produção neles.
Não deixe o deployer trancado do lado de fora. Quando o DCM entrega a propriedade de DEV_RAW para DEV_LOADER, o PLATFORM_DEPLOYER deixa de ser o dono. No próximo deploy, o DCM não consegue gerenciar o que não alcança. A correção é uma linha por role:
GRANT ROLE {{ env }}_LOADER TO ROLE PLATFORM_DEPLOYER;GRANT ROLE {{ env }}_TRANSFORMER TO ROLE PLATFORM_DEPLOYER;O account_identifier no manifest não expande variáveis de ambiente. Escreva o identificador diretamente. É isso que permite ao DCM te avisar quando você está prestes a fazer deploy na conta errada — o que, se você é consultor fazendo malabarismo com contas de vários clientes, é um recurso que você quer ter.
Não use templates para secrets. O Snowflake diz com todas as letras: variáveis de template não foram feitas para credenciais.
CI/CD com GitHub Actions
Aqui é onde tudo se encaixa. Dois workflows:
Em um pull request:
- Plan e deploy em
QA. - Plan de
PRODe publicação do plano como comentário no PR.
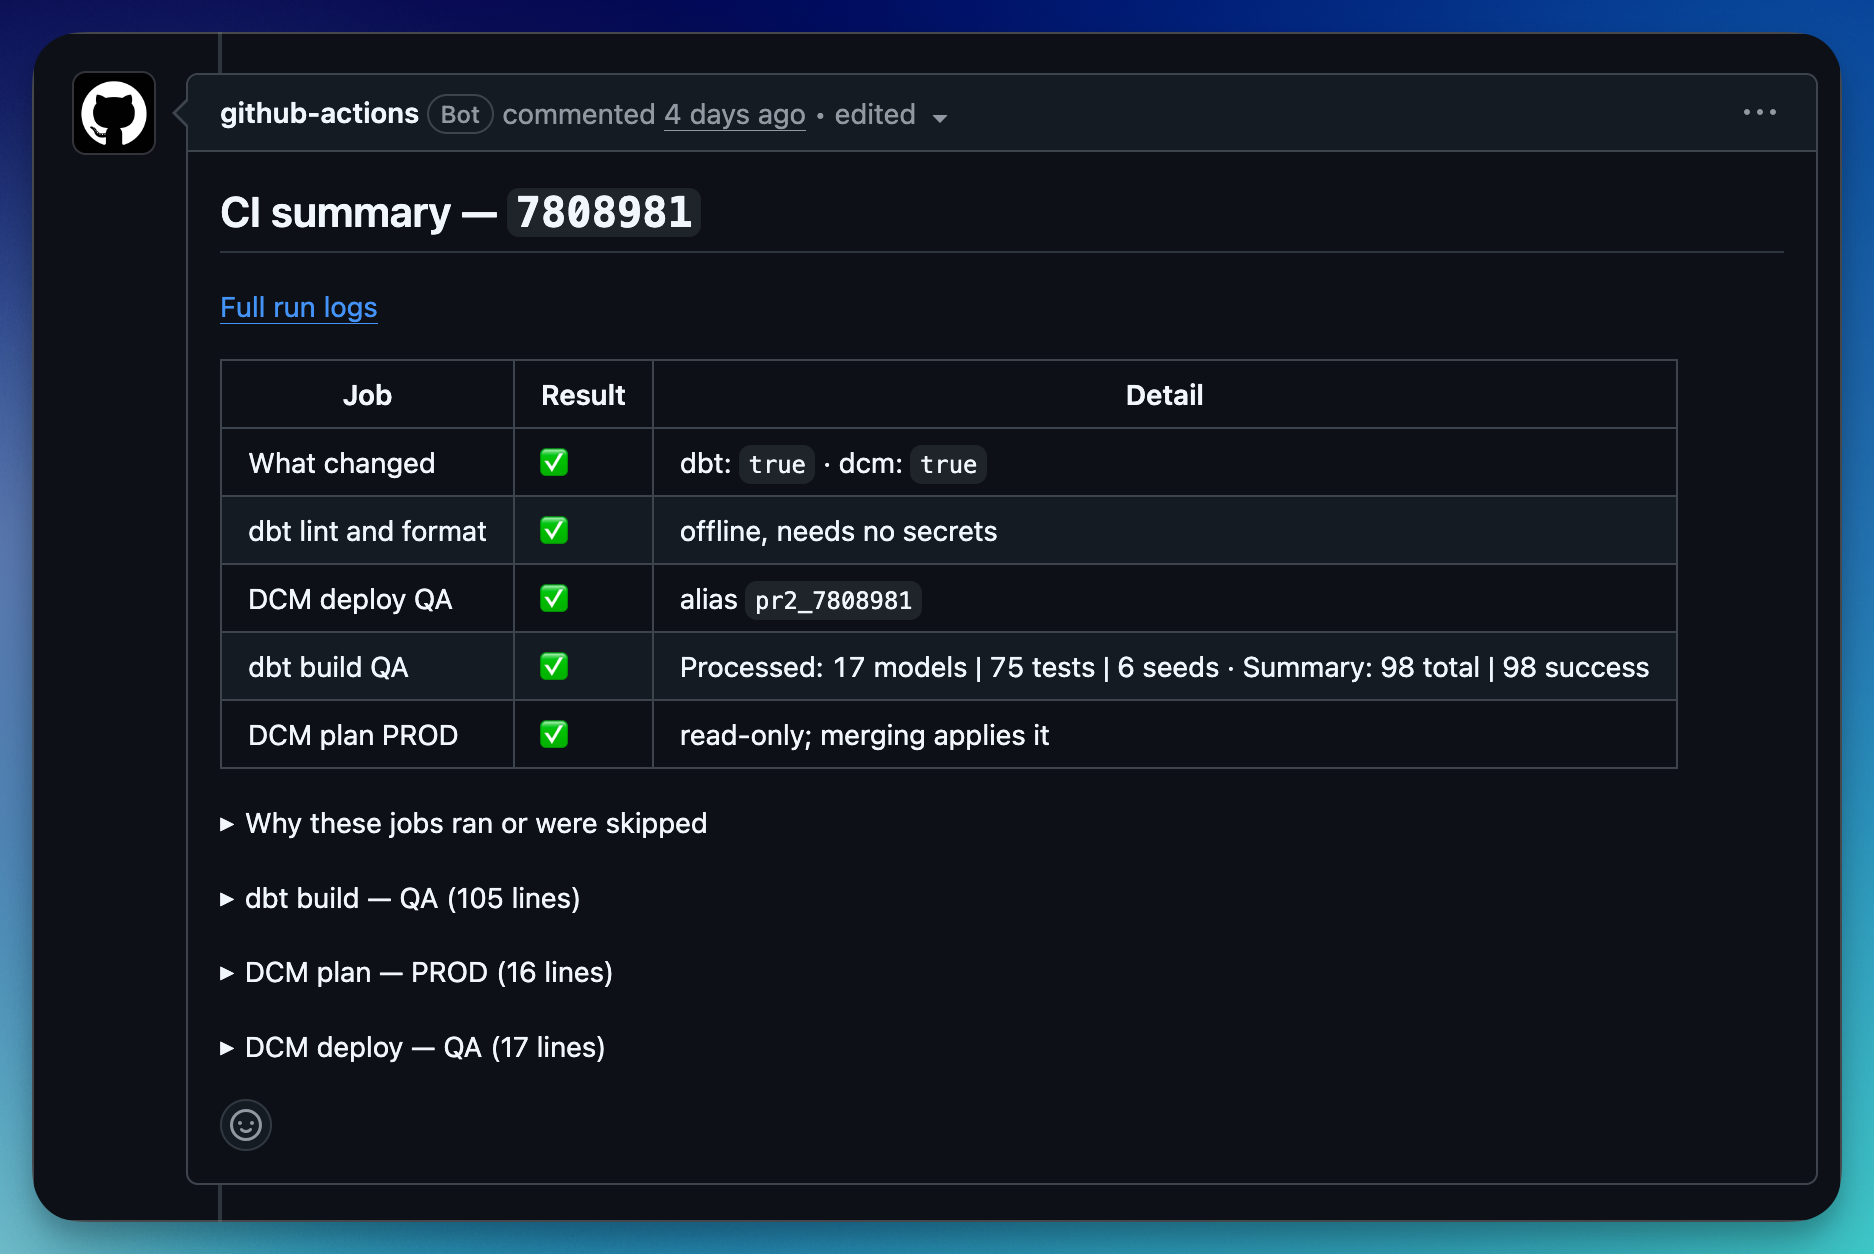
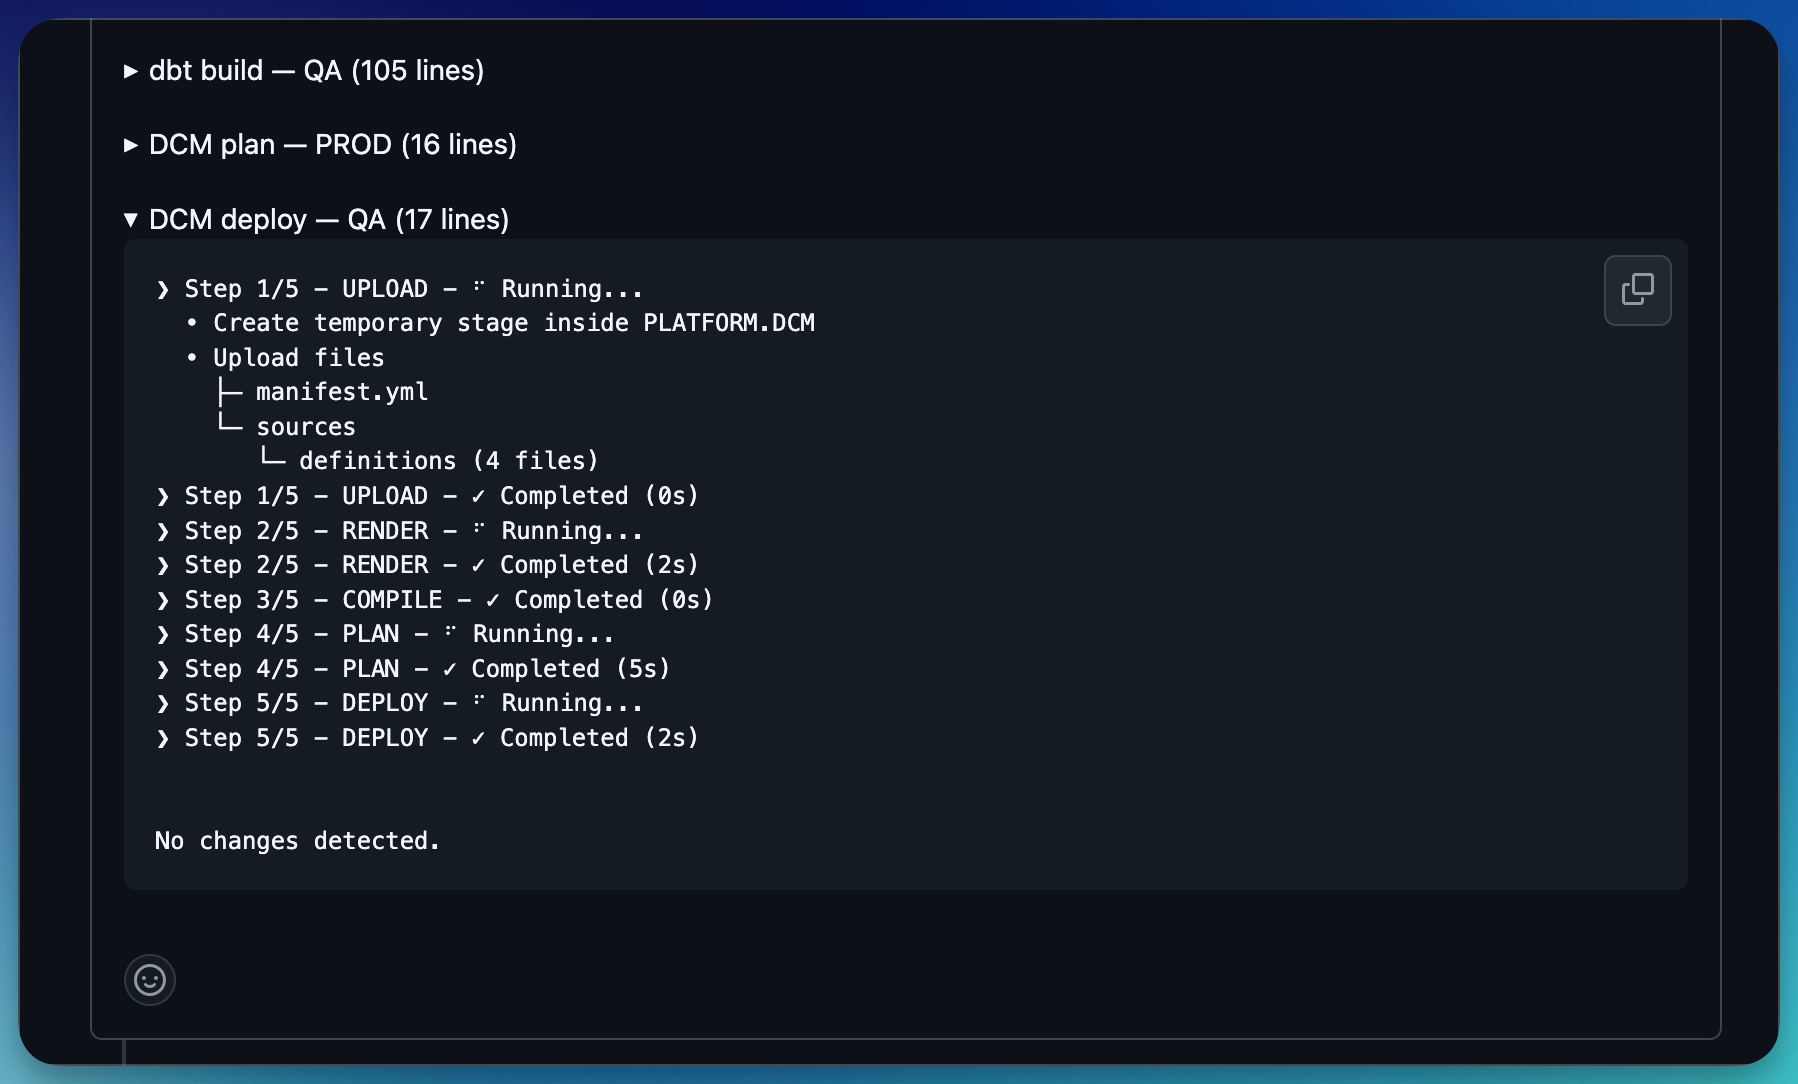
No merge para main:
- Plan e deploy de
DEV, depoisQA, depoisPROD, nessa ordem.
O comentário no PR é a minha parte favorita. Os revisores não precisam confiar que uma mudança é segura. Eles veem exatamente o que vai acontecer em produção, incluindo qualquer DROP, antes de clicar em merge. E o job edita o comentário anterior em vez de adicionar um novo, então um PR com dez pushes continua com um único comentário de plano.
[screenshot: PROD plan posted as a PR comment]
O CI se autentica como um usuário TYPE = SERVICE com autenticação por par de chaves. Esse usuário tem a role PLATFORM_DEPLOYER e nada mais. Todo deploy recebe um alias com o commit (main_9fd3c1a), então qualquer deployment no Snowflake pode ser rastreado direto até um merge.
DCM Projects no Snowsight
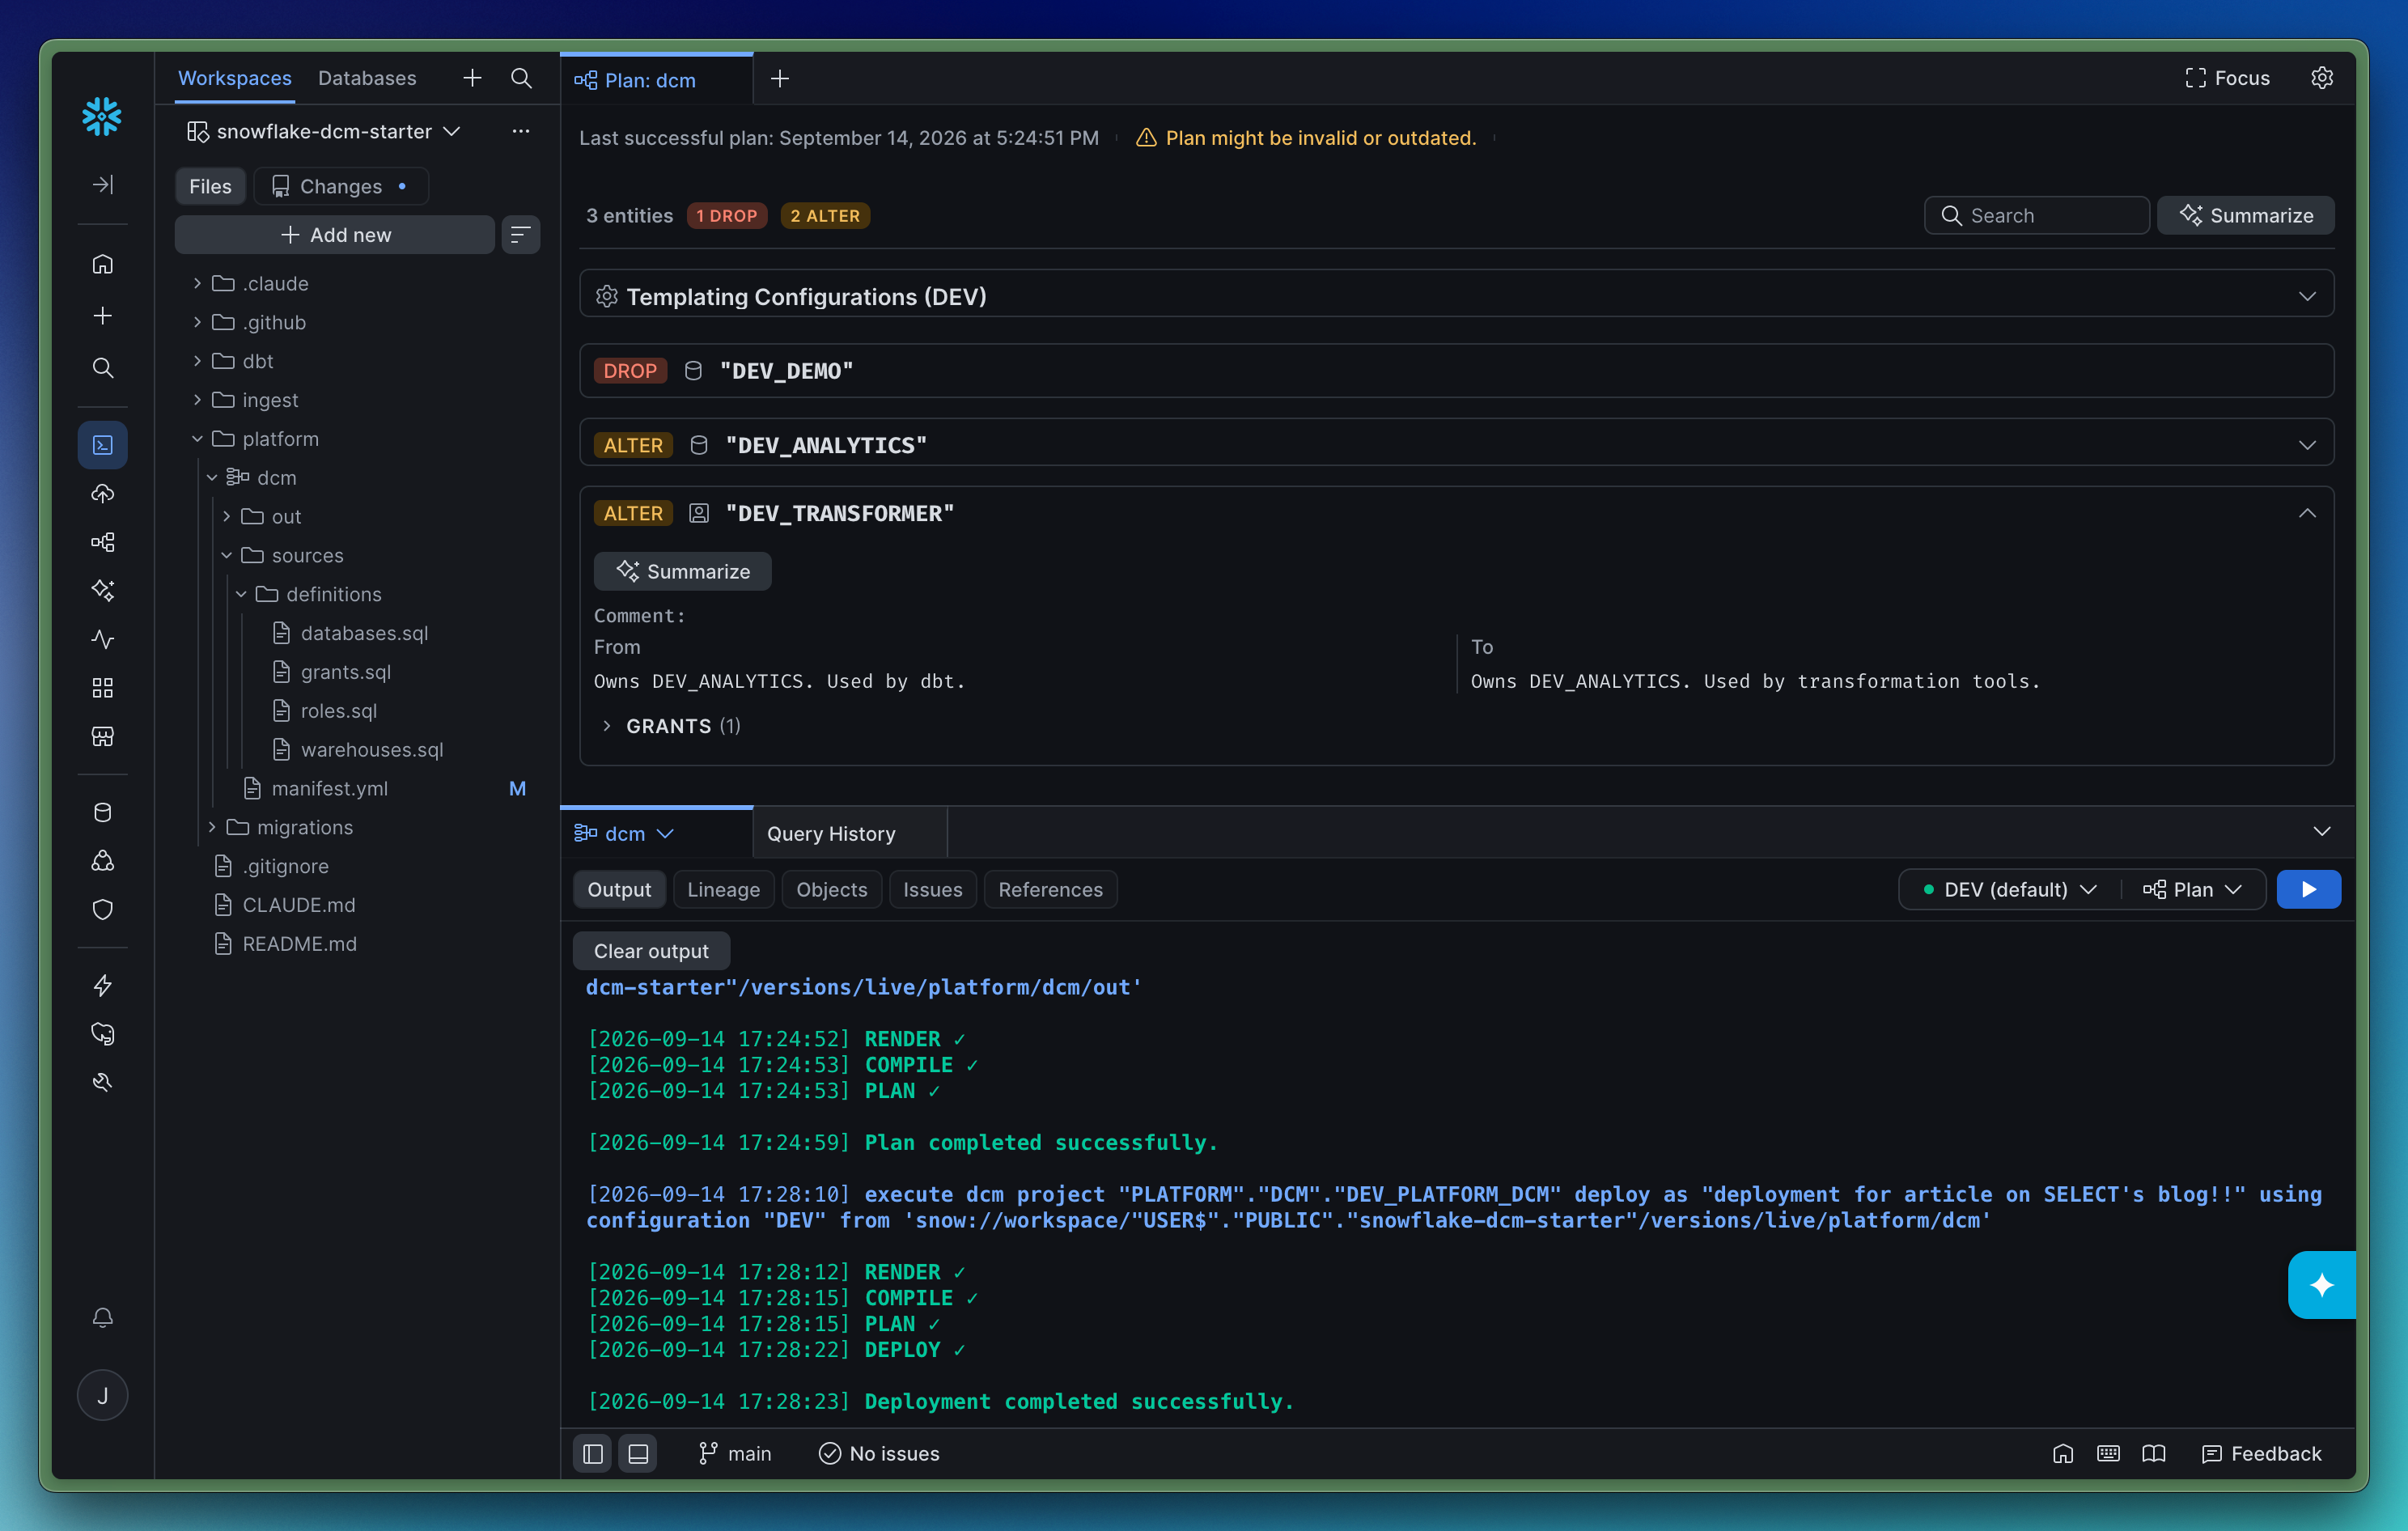
O Snowflake Workspaces oferece uma interface muito legal para gerenciar, planejar e fazer deploy de DCM Projects. Sem entrar em muitos detalhes, vamos só dar uma olhada em algumas capturas de tela.
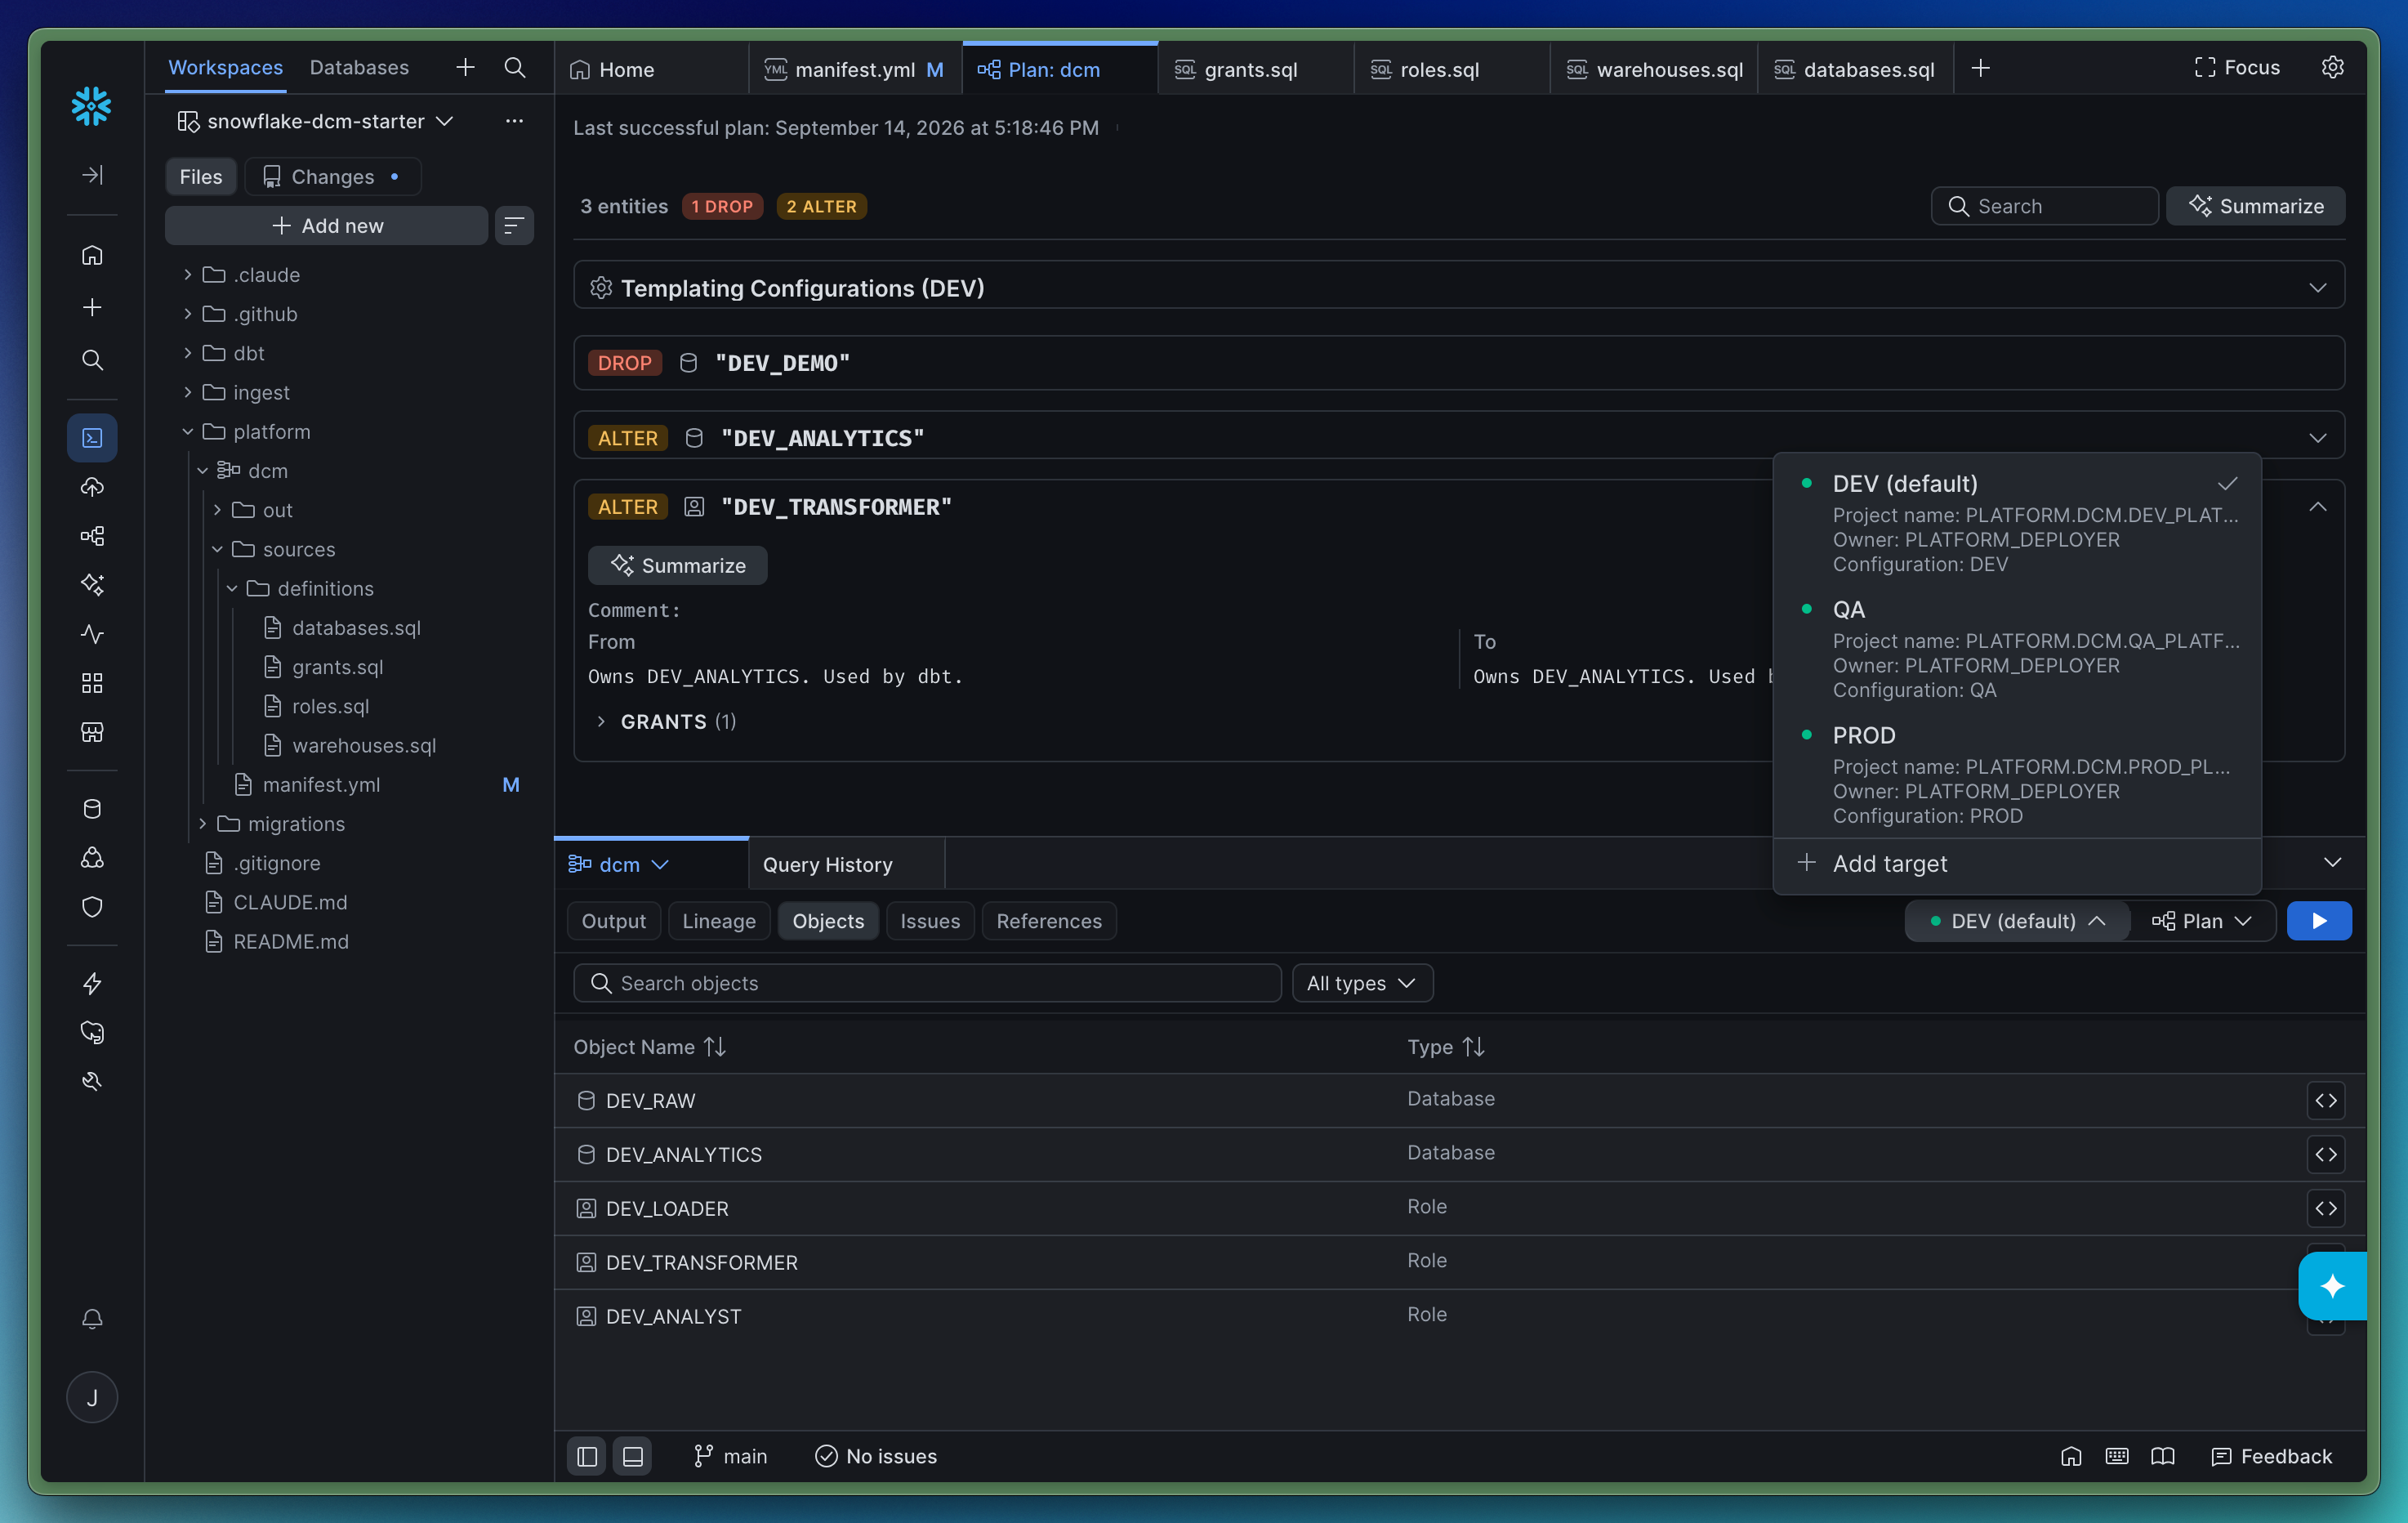
Ao executar um plan, uma aba se abre explicando o plano:
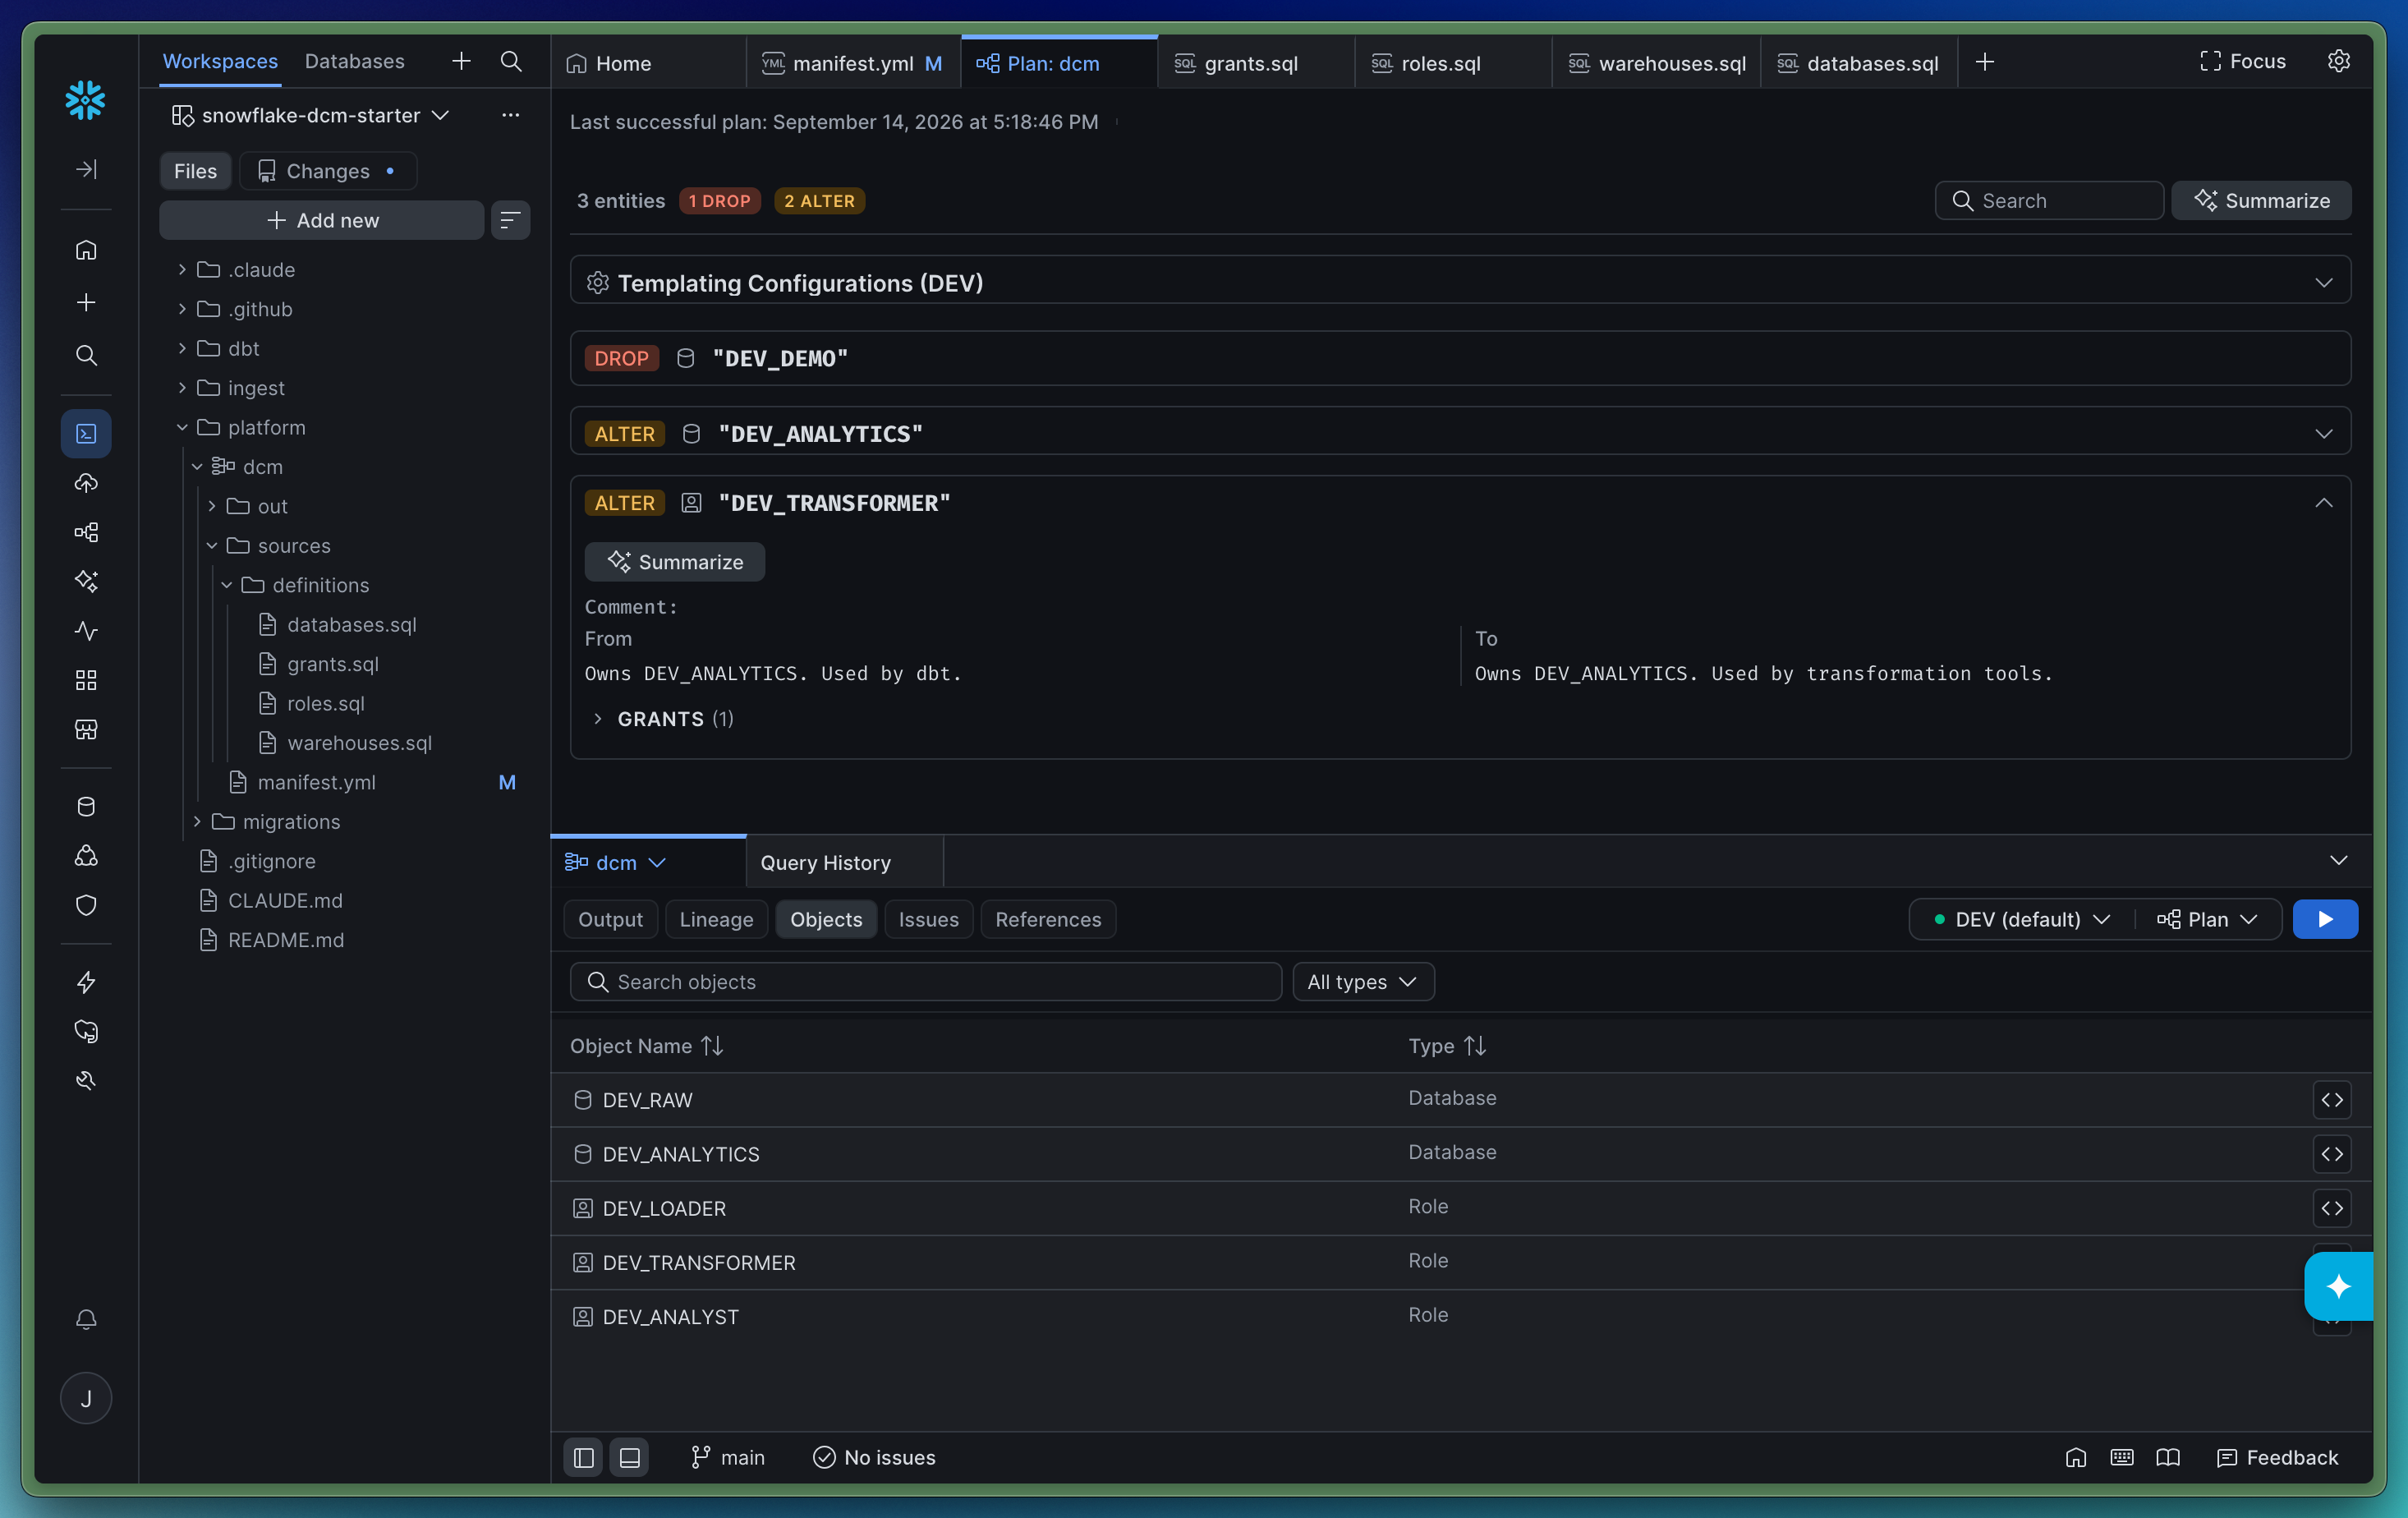
Você pode trocar de ambiente usando o seletor:
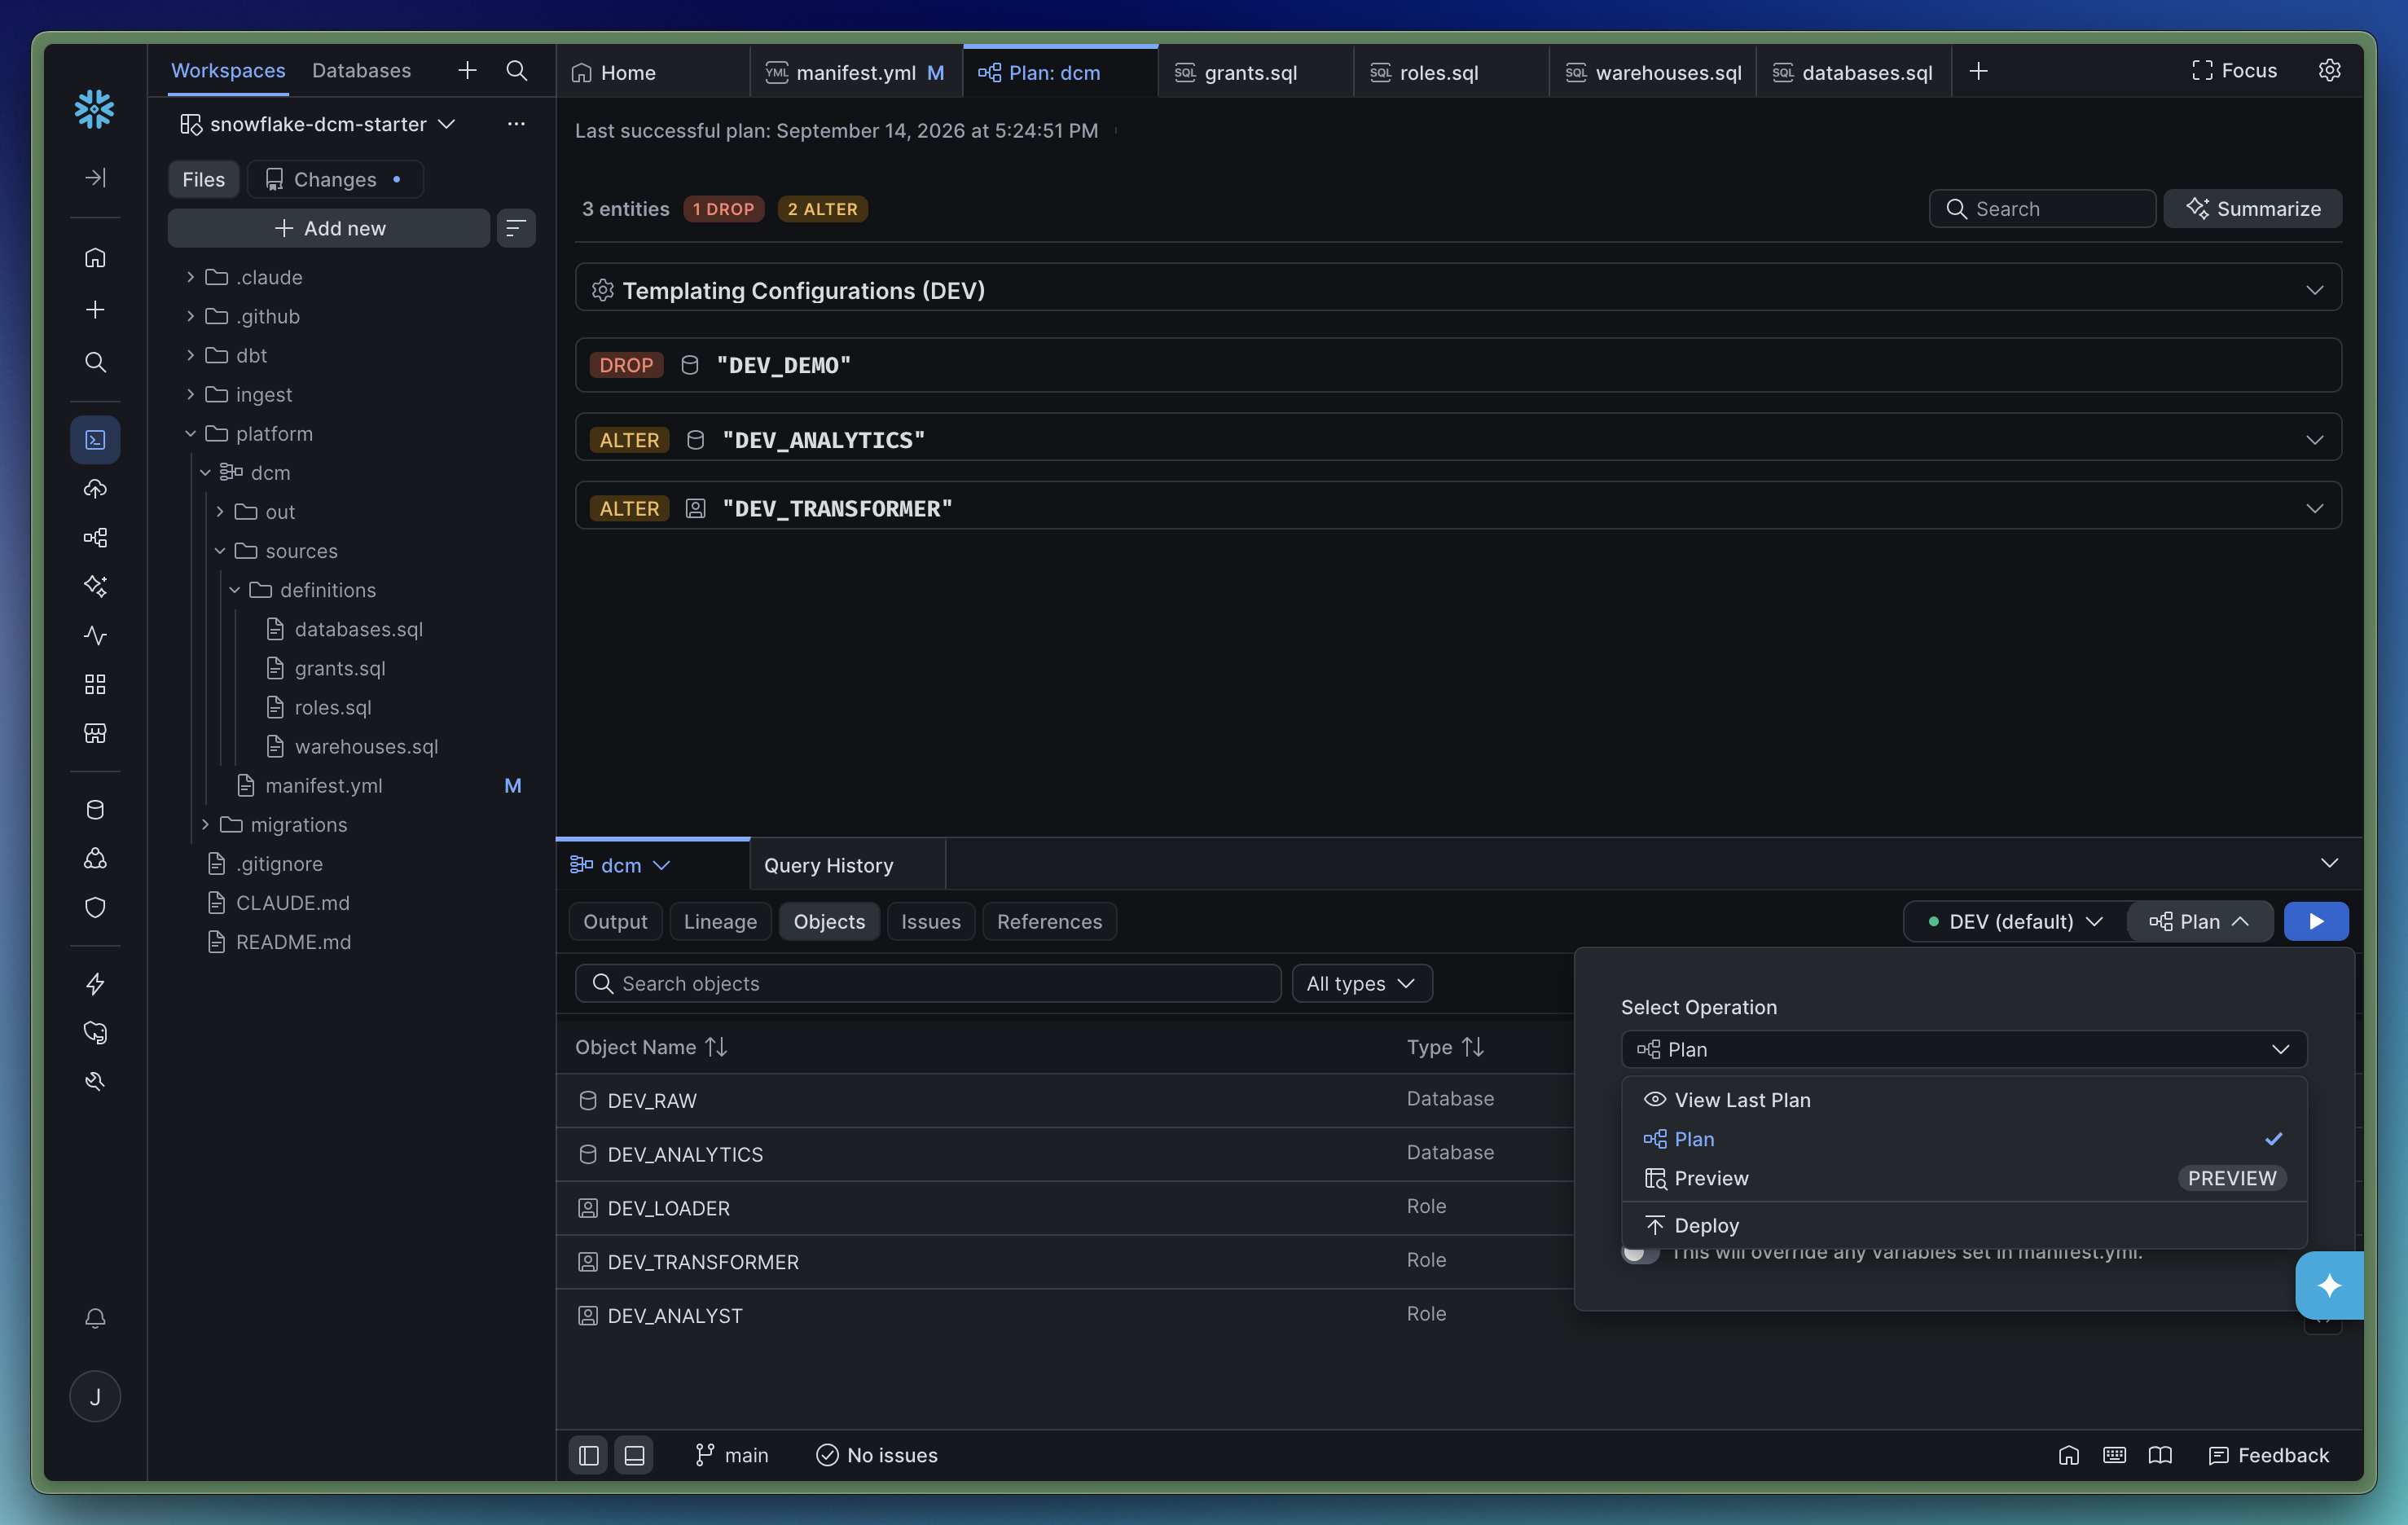
Quando estiver pronto para o deploy, basta clicar no menu suspenso de Plan e selecionar deploy:
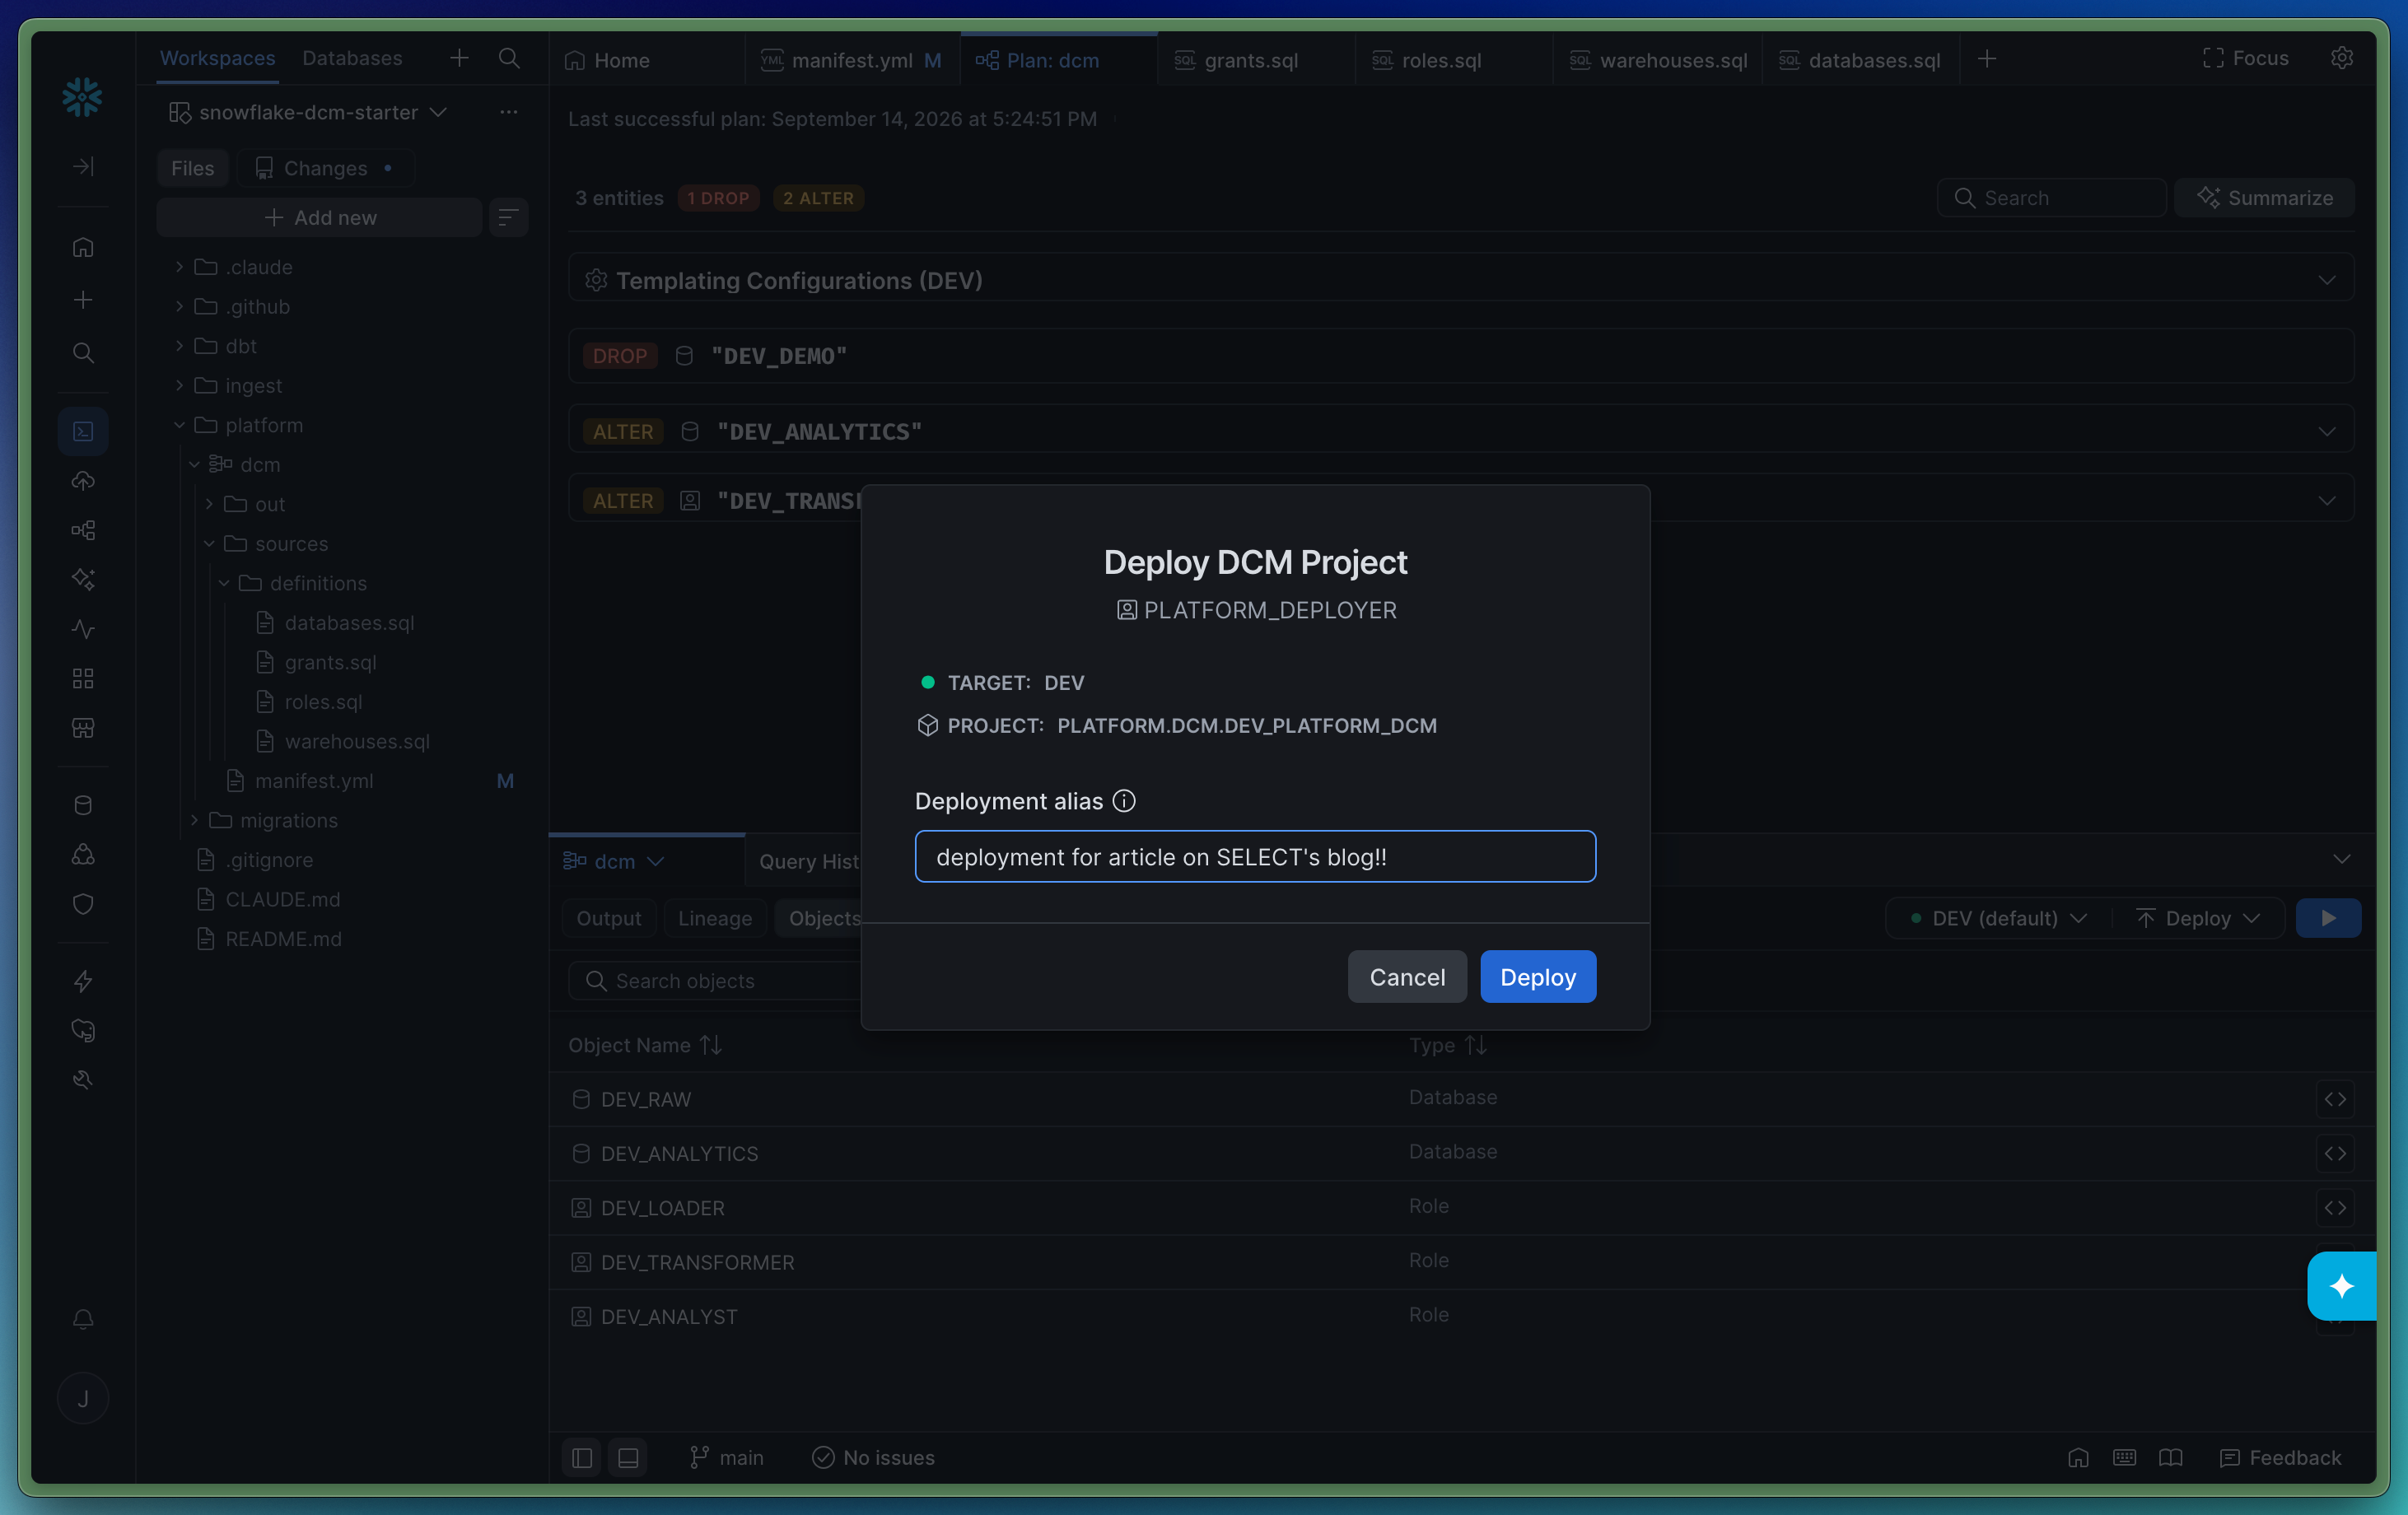
Quando terminar, uma notificação aparece na parte superior central da tela avisando que o deploy foi concluído.
A aba Output mostra a saída do CLI de todas as suas execuções:

Se tivéssemos um DAG de Dynamic Tables ou Tasks, eles apareceriam na aba de linhagem, mas este projeto não contém nenhum.
Executando o DCM localmente com o CLI
Pessoalmente, eu faço todo o meu trabalho no Visual Studio Code. Aqui vai um resumo rápido de como é o deployment no VS Code. dcm é um subcomando do comando snow do CLI. Então, se você tem o CLI snow instalado, já tem o DCM! Aqui estou mostrando snow dcm plan e snow dcm deploy em uma única captura de tela.
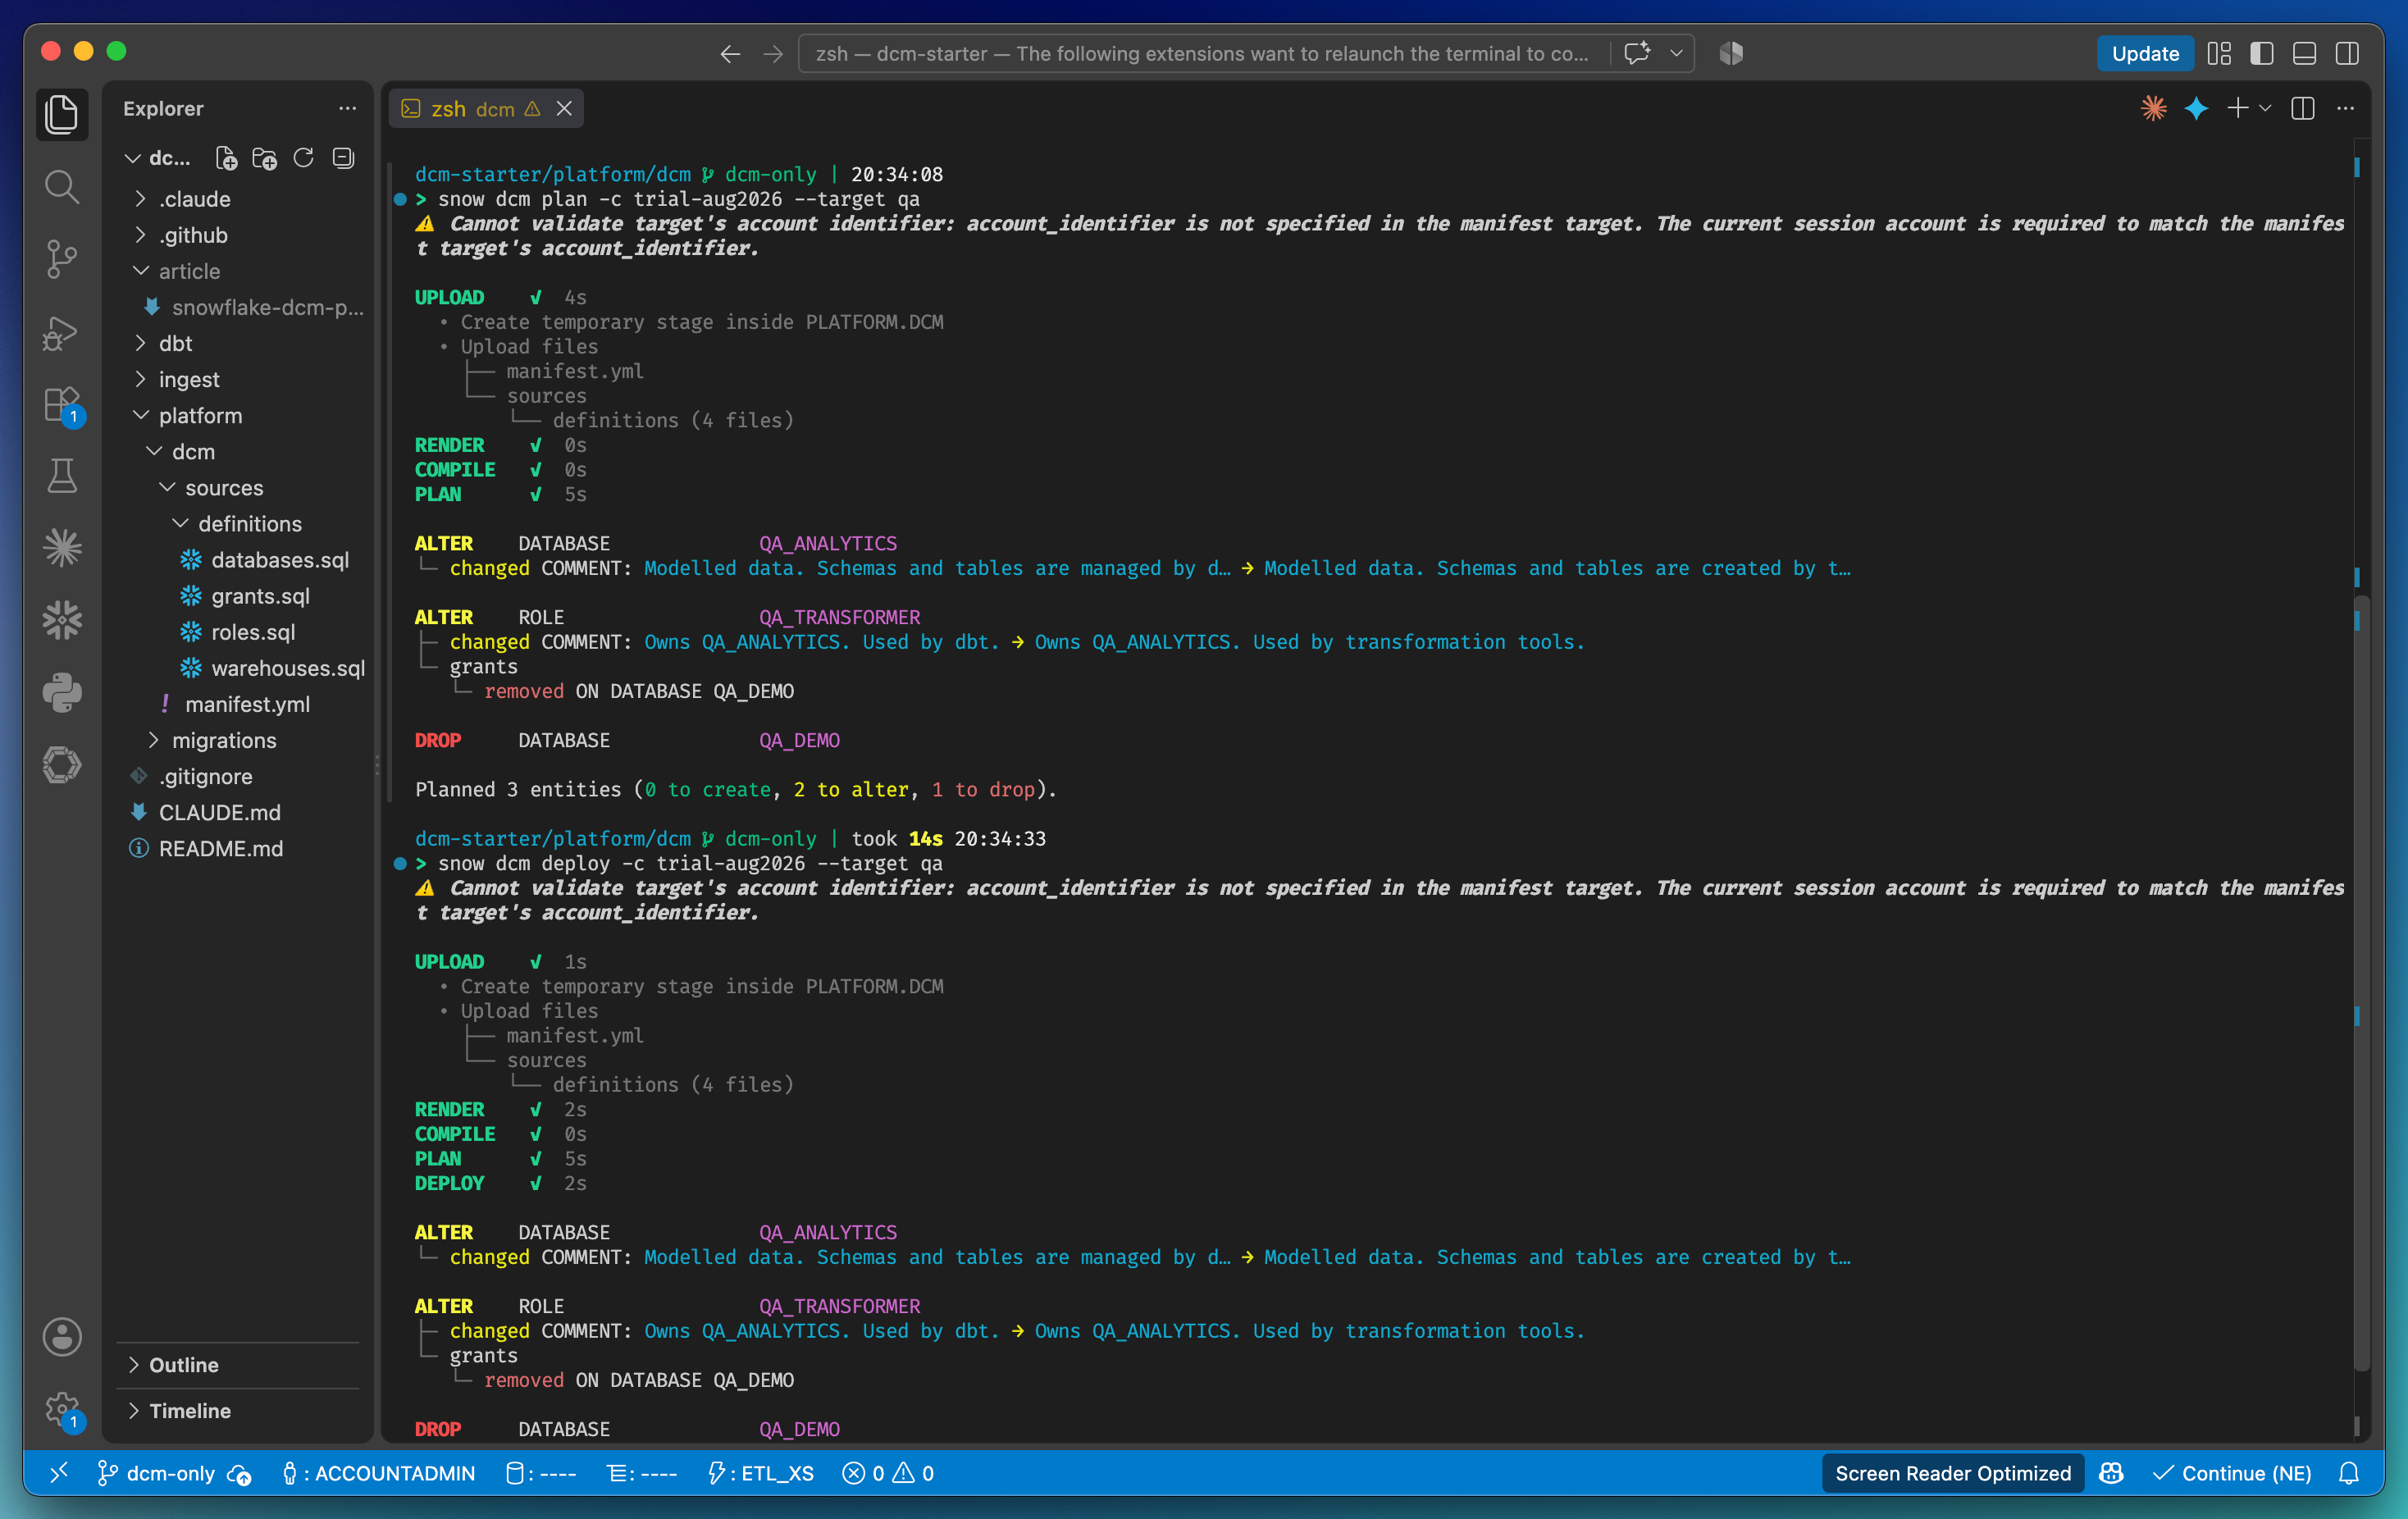
Agora posso iterar nos arquivos localmente, fazer deploy no meu ambiente de dev, abrir um PR que vai planejar e fazer deploy em QA e rodar o plano contra prod. Um workflow muito amigável para quem desenvolve!
DCM vs. as alternativas
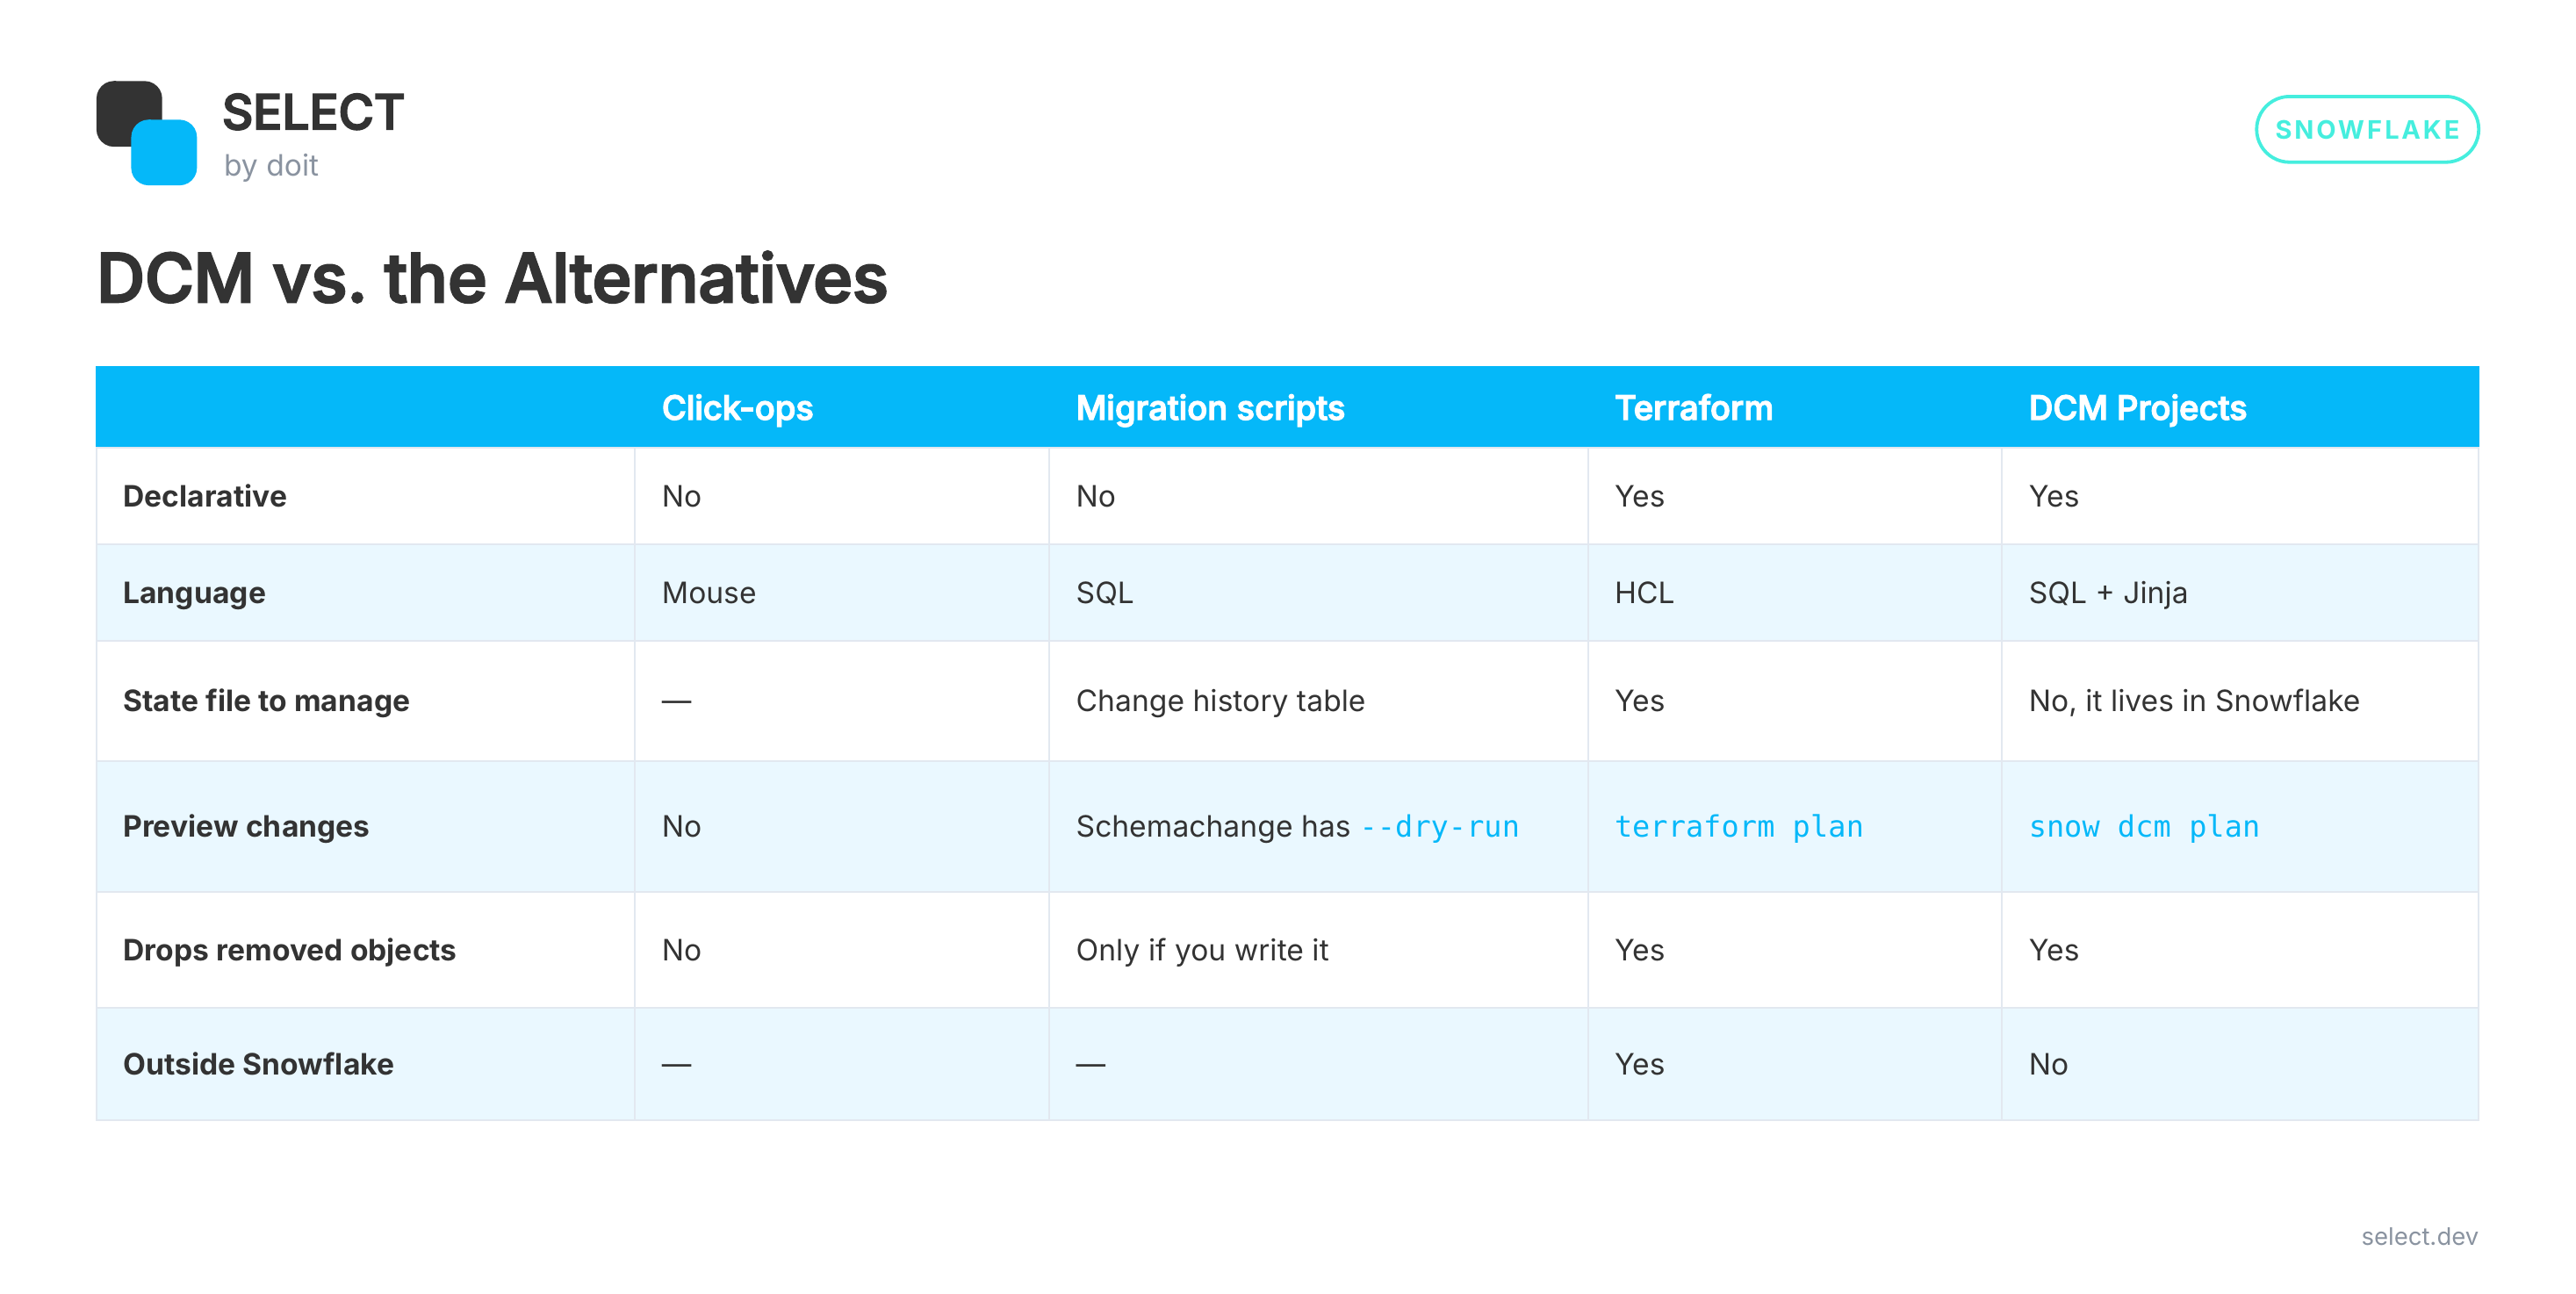
Se você gerencia AWS, Snowflake e seu DNS em um único repositório Terraform, o Terraform ainda faz sentido. Se a infraestrutura do seu time é basicamente Snowflake e o time já fala SQL, o DCM é o caminho de menor atrito que encontrei.
Experimente você mesmo
Coloquei tudo isso em um repositório inicial: https://github.com/jeff-skoldberg-gmds/snowflake-dcm-starter.
Ele inclui as definições, as migrações de bootstrap, os dois workflows de GitHub Actions e skills do Claude Code. Rode /project-setup e ele te guia pela conta, pelo manifest, pelo bootstrap, pelo primeiro deploy e pelo CI, um passo verificado de cada vez.
Ele também tem pastas ingest/ e dbt/ vazias, porque o DCM é só a base. Você deve construir um monorepo para a sua plataforma Snowflake que inclua a carga e a transformação dos dados. As roles e os bancos de dados estão esperando pelos seus pipelines.
Agora vá testar e me conte se infraestrutura como código no Snowflake ainda parece uma tarefa chata!