
TL;DR
Databricks te factura dos veces: una por DBUs (Databricks Units) y otra por la infraestructura en la nube, y las dos facturas no se concilian automáticamente. El precio por DBU varía hasta 3.5x según el tipo de cómputo, y funciones más recientes como los monitores de calidad siguen modelos de facturación completamente distintos. Tres controles evitan la mayoría de las sorpresas: terminación automática en cada clúster y warehouse, Job Compute para todos los flujos programados y un etiquetado consistente antes de escalar. Ninguno es complicado. Aun así, la mayoría de los equipos los omite.
¿Cómo funciona realmente la facturación de Databricks?
Databricks te cobra en dos lugares distintos, y esas dos facturas no se comunican entre sí.
La primera factura viene de Databricks. Se expresa en Databricks Units (DBUs), una medida abstracta de la capacidad de cómputo consumida por segundo. El precio por DBU varía según el tipo de trabajo que ejecutas, el proveedor de nube que usas y la edición de Databricks que contrataste.
La segunda factura viene de tu proveedor de nube (AWS, Azure o GCP). Ahí es donde aparecen las máquinas virtuales subyacentes, el almacenamiento y la salida de red.
Esa estructura doble confunde a muchos equipos desde el principio. Las tablas de sistema de Databricks te dan un desglose claro de costos por workload y SKU, pero esa vista solo cubre el lado de los DBUs. Los cargos de infraestructura en la nube viven en una exportación de facturación aparte, y conciliar ambos es genuinamente complejo. Se complica aún más cuando tu entorno mezcla cómputo clásico y serverless: los clústeres clásicos tienen costos de VM asociados en tu factura de nube, mientras que serverless incluye la infraestructura en el precio del DBU. Dos estructuras de costos distintas, un mismo workspace. La mayoría de los equipos no contabiliza por completo el lado de la nube hasta su primera factura incómoda.
Entender el costo total de operación es un reto tan grande que Databricks publicó una utilidad de código abierto para facilitar el ejercicio: https://www.databricks.com/blog/getting-full-picture-unifying-databricks-and-cloud-infrastructure-costs
¿Qué es un DBU y por qué varía tanto su precio?
Un DBU es una unidad normalizada de capacidad de procesamiento. Piénsalo como un crédito que se consume mientras el cómputo está en ejecución. El detalle es que el valor en dólares de un DBU no es fijo. Depende de tres cosas:
1. Tipo de cómputoEs el multiplicador más grande. Ejecutar un trabajo batch programado con Job Compute cuesta aproximadamente $0.15/DBU en Azure. Ejecutar el mismo código de forma interactiva en un clúster All-Purpose cuesta $0.55/DBU. No es una diferencia menor: es 3.5x. Los equipos que dejan sus pipelines de producción en clústeres All-Purpose porque "ya estaba ahí" pagan ese sobreprecio en cada ejecución.
Aquí tienes una tabla de referencia para Azure (región de EE. UU., precios de lista):
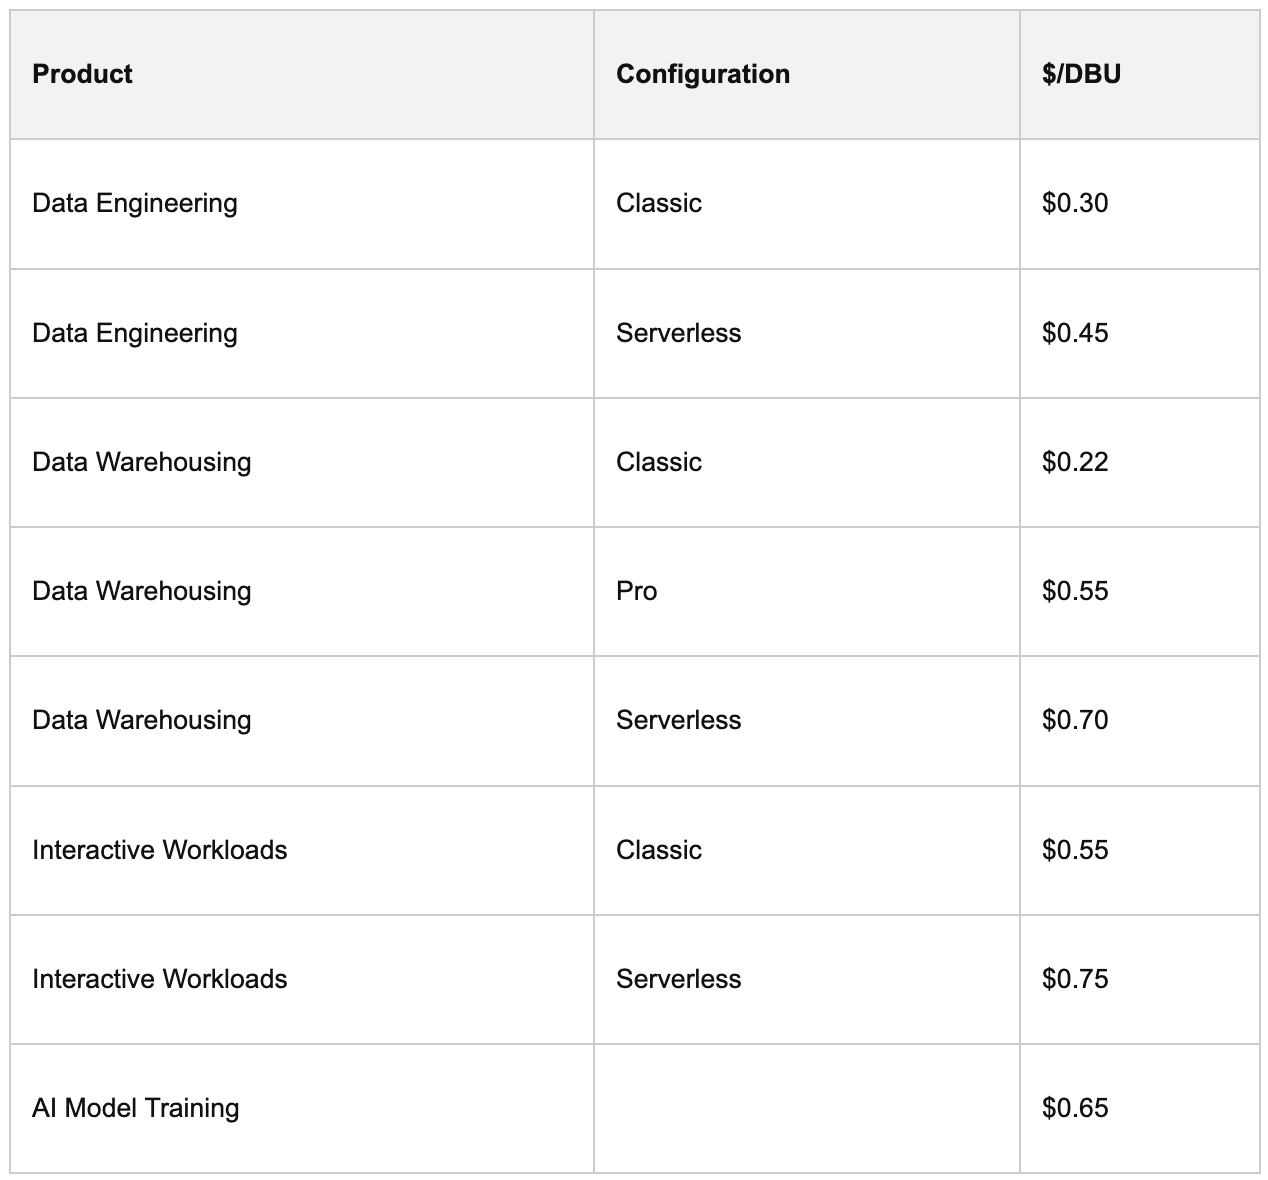
Precios completos en databricks.com/product/pricing.
2. Serverless vs. clásicoEl cómputo serverless tiene un precio por DBU más alto porque incluye la gestión de la infraestructura, sin cargos de VM del lado de la nube. El cómputo clásico tiene un precio por DBU más bajo, pero pagas las VMs subyacentes por separado. Ninguno es universalmente más barato; depende por completo de tu workload.
3. No todo se cobra por DBULas capacidades más recientes de Databricks, como la ingesta de datos, la búsqueda vectorial, los agentes de IA, los monitores de calidad y las bases de datos operacionales, suelen seguir modelos completamente distintos: por token, por GB almacenado, por hora de capacidad. Es una de las fuentes de sorpresas en la factura que más se pasa por alto. Más sobre esto a continuación.
¿Qué costos ocultos sorprendieron a un cliente con los monitores de calidad?
Hablando de costos que no se miden en DBUs: los monitores de calidad son una de las fuentes de costos más silenciosas que he visto en la práctica.
Para tablas pequeñas, una actualización de un monitor de calidad es barata: por lo general ronda los $0.10 por ejecución. Pero en tablas grandes e históricas sin Change Data Feed (CDF) habilitado, el monitor tiene que escanear la tabla completa en cada ejecución. En algunas tablas grandes, eso significa $20 por actualización.
Un cliente mío había desplegado monitores de calidad en cientos de tablas. Cerca del 95% se ejecutaba a bajo costo, sin problema. Pero unas cuantas tablas grandes sin CDF costaban $20 por ejecución, programadas a diario. Solo eso generaba una parte sustancial de su factura mensual, y nadie lo sabía hasta que lo encontramos en nuestro dashboard de monitoreo de costos. El panel de monitores de calidad no lo muestra de forma destacada. Hay que ir a buscarlo.
La solución es simple: habilitar CDF y usar monitores de calidad de series de tiempo en lugar de snapshots. Pero hay que saber lo que se hace.
Este también es un buen ejemplo de por qué el "costo en DBUs" por sí solo no cuenta toda la historia. Los monitores de calidad tienen su propia dimensión de facturación, separada del consumo de tus clústeres o warehouses.
¿Conviene usar cómputo serverless o clásico para ahorrar?
El cómputo serverless cuesta entre 1.5 y 2x más por DBU que su equivalente clásico. Dicho así, parece la opción equivocada para los equipos que cuidan su presupuesto. Normalmente no lo es, pero hay un matiz que vale la pena entender.
El argumento para empezar con serverless es sencillo: elimina toda una clase de problemas de configuración. Sin decisiones de dimensionamiento de clústeres, sin ajustes de autoescalado, sin terminación automática que olvidar, sin clústeres inactivos toda la noche. La carga operativa desaparece y, para la mayoría de los workloads, ese tiempo de ingeniería cuesta más que el sobreprecio del DBU.
El matiz es este: serverless escala con tanta eficiencia que los aumentos de costo pueden ser más difíciles de detectar. Con cómputo clásico, si un trabajo tarda consistentemente una hora, tienes una expectativa razonable de lo que cuesta. Con serverless, dos ejecuciones pueden durar exactamente lo mismo pero tener costos muy distintos, porque serverless escaló rápidamente en respuesta a un workload más pesado y consumiste el doble de DBUs. La duración se mantiene igual. La factura se duplica.
Esto no significa que serverless sea una mala elección. Significa que necesitas un monitoreo de costos adecuado, no solo un seguimiento de duraciones. Vigila el consumo de DBUs, no solo el tiempo de ejecución.
Mi recomendación: empieza con serverless en todo. Usa tu sistema de monitoreo de costos para identificar los trabajos de alto costo y alta frecuencia que se ejecutan con la previsibilidad suficiente como para justificar el esfuerzo de configurar bien el cómputo clásico. Optimiza los casos atípicos. No intentes ajustar todo a mano.
¿Cuáles son los 3 controles de costos que debes implementar antes de necesitarlos?
Entender el modelo de precios es útil. Hacer algo al respecto es lo que de verdad marca la diferencia. Estos son los tres controles que generan el mayor impacto con el menor esfuerzo de ingeniería.
1. Terminación automática en cada clúster y warehouse
Es el control de mayor impacto, y el que más se omite.
Sin terminación automática, un clúster que termina su trabajo simplemente se queda ahí, consumiendo DBUs al precio completo hasta que alguien lo detiene manualmente. El daño no suele venir de un solo clúster grande; es la acumulación de muchos clústeres, cada uno con unas horas extra de ejecución, en todo un equipo, todos los días.
Lo he visto salir mal dos veces, de formas memorables.
La primera: un pasante estaba entrenando modelos de ML y configuró un clúster grande con una ventana de terminación automática de cinco días, pensando que era un límite razonable para un entrenamiento. El trabajo terminó en horas. El clúster siguió corriendo. Nadie lo notó durante más de un mes. Ese único clúster representó el 15-20% de la factura total de Databricks de ese periodo.
La segunda: un pipeline que leía archivos JSON muy anidados funcionaba a la perfección en el entorno de pruebas. Se desplegó a producción. Los archivos de producción tenían una estructura distinta. El pipeline no falló; simplemente siguió ejecutándose. Durante diez horas. Todos los días. Nadie lo estaba vigilando. Hubo que detenerlo manualmente y corregirlo. Un timeout de trabajo lo habría detectado en la primera ejecución.
Cómo configurarlo:
- Clústeres interactivos: configura la terminación automática en 30 minutos
- SQL warehouses: configura el auto-stop en 10 minutos (los warehouses serverless arrancan en segundos, así que el costo de un reinicio es bajo)
- Cada trabajo programado: define un timeout de 2x la duración promedio de ejecución
Una salvedad importante: los notebooks no tienen un mecanismo de timeout nativo. Un notebook en ejecución activa mantendrá el clúster vivo de forma indefinida, porque la terminación automática nunca se activa mientras el clúster no esté inactivo. Una consulta de streaming mostrada en un notebook basta para mantener un clúster corriendo para siempre. La única protección aquí es monitorear el tiempo de actividad de los clústeres a través de las tablas de sistema y configurar alertas para todo lo que se ejecute más tiempo del esperado.
2. Usa Job Compute (no All-Purpose) para los flujos programados
Es la reducción de costos más fácil que la mayoría de los equipos todavía no ha aplicado.
Cuando defines un flujo de trabajo en Databricks, la tentación es asociarlo a un clúster interactivo existente. Ya está ahí, ya está configurado, funciona. El problema es que el cómputo interactivo (All-Purpose) cuesta aproximadamente $0.55/DBU, mientras que Job Compute cuesta $0.15/DBU en clásico y $0.35/DBU en serverless. Para un pipeline de producción que se ejecuta varias veces al día, esa diferencia se acumula rápido.
El enfoque correcto es tratar el cómputo como una decisión por tarea. Un flujo con una transformación en Python seguida de una agregación en SQL puede y debe usar Job Compute serverless para la primera tarea y un SQL warehouse para la segunda. No estás atado a un solo tipo de cómputo para todo el flujo. Elige la opción más barata que sea adecuada para cada tarea.
Regla general: si está programado, no debería ejecutarse en cómputo All-Purpose.
3. Etiqueta todo antes de escalar
Las etiquetas parecen una tarea de mantenimiento. En realidad son un requisito previo para gestionar los costos.
Las tablas de sistema de Databricks te dan datos crudos de consumo de DBUs. Las etiquetas son lo que te permite responder la pregunta que de verdad importa: ¿qué equipo, proyecto o pipeline está generando este costo?
Sin etiquetas, terminas ahogándote entre nombres de clústeres que cambian con el tiempo (etl_dev, etl_staging, prod_churn_v2) y registros de uso imposibles de agrupar de forma significativa. Con etiquetas, puedes segmentar los costos por unidad de negocio, entorno y flujo de trabajo con una consulta simple.
Buenas etiquetas para empezar:
- Unidad de negocio: qué equipo es dueño de este workload
- Entorno: producción, staging, desarrollo
- Proyecto: a qué iniciativa sirve
- Nombre del flujo: un nombre lógico estable que sobreviva a los cambios de nombre
En AWS y Azure, las etiquetas también se propagan a los datos de facturación de tu proveedor de nube, que es la única forma confiable de conciliar los costos de DBUs de Databricks con los cargos de VMs de la otra factura.
El consejo práctico: define tu taxonomía de etiquetado antes de tener docenas de pipelines. Aplicar etiquetas de forma retroactiva en un entorno maduro es doloroso. Un puñado de etiquetas bien elegidas y aplicadas de forma consistente desde el primer día vale más que un esquema elaborado que nadie sigue.
Para el cómputo serverless en particular hay un paso adicional: como serverless no tiene un clúster persistente que etiquetar, necesitas configurar políticas de presupuesto serverless para asociar etiquetas al uso serverless. Sin esto, el consumo serverless queda registrado en tus tablas de sistema sin contexto de atribución.
¿Quieres recortar tu factura de Databricks en un 30%? Nuestro ebook gratuito cubre la terminación automática, Job Compute, las políticas de presupuesto y 17 ajustes más que puedes aplicar hoy mismo. Sin relleno: solo las configuraciones que de verdad marcan la diferencia. Descarga tu copia gratis →
¿Por dónde empezar si ahora mismo tienes una factura de Databricks confusa?
Si tus costos de Databricks ya son más altos de lo esperado, el diagnóstico más rápido es consultar tus tablas de sistema:
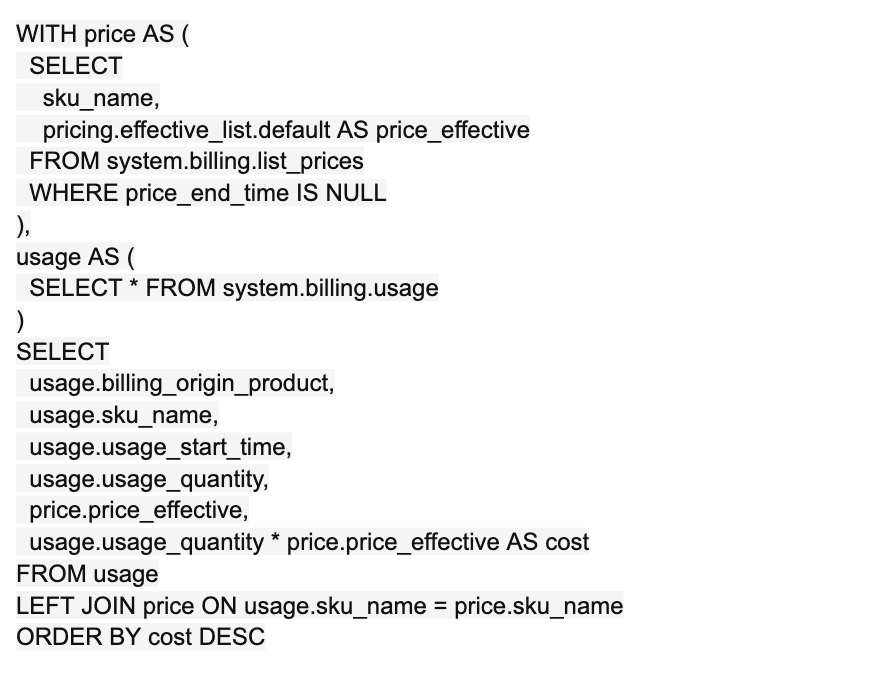
Esto te da un desglose de costos por producto y SKU. Para conectarlo con los workloads reales, haz un join con system.lakeflow.job_run_timeline para ver qué trabajos están generando la factura.
Qué buscar en particular:
- Cualquier uso del SKU de Interactive Workloads que debería ser Job Compute
- Cualquier línea de monitores de calidad, especialmente en tablas grandes
- Clústeres o warehouses con tiempos de ejecución largos en relación con el trabajo que realizan
Recuerda que esta vista solo cubre el lado de Databricks. Los costos de VMs en la nube están en una exportación aparte de tu proveedor. Si tienes un entorno mixto clásico/serverless, esas dos vistas deben conciliarse por separado.
¿Cómo mantener los costos de Databricks bajo control a medida que escalas?
Los tres controles anteriores cubrirán las fuentes más comunes de pérdida. Mantenerlos vigentes mientras tu equipo y tus workloads crecen requiere una capa de gobernanza:
- Despliega los clústeres como infraestructura como código en lugar de dejar que cada Engineer aprovisione los suyos. Cuando la configuración vive en YAML y pasa por CI/CD, la terminación automática y el etiquetado siempre quedan bien configurados, porque se aplican desde la definición y no se dejan al criterio individual.
- Usa políticas de clúster para los equipos que realmente necesitan crear su propio cómputo. Las políticas acotan el espacio de configuración: pueden exigir la terminación automática, limitar el tamaño del clúster y restringir los tipos de instancia, sin dejar de dar a los Engineers una flexibilidad real.
- Configura alertas de costos en la consola de cuenta de Databricks, o construye alertas personalizadas sobre las tablas de sistema. Medir la desviación estándar de los costos diarios por workload es una señal temprana más sensible que un umbral fijo. Detecta las desviaciones antes de que se conviertan en un problema.
La optimización de costos en Databricks no es un proyecto puntual. La plataforma evoluciona, los equipos suman workloads, los volúmenes de datos crecen. Los equipos que se mantienen un paso adelante de los costos tratan el monitoreo y la atribución como una práctica continua, no como un ejercicio de limpieza después de que algo salió mal.
Preguntas frecuentes
¿Por qué mi factura de Databricks es más alta de lo esperado? La razón más común es un desajuste en el tipo de cómputo: pipelines de producción ejecutándose en clústeres interactivos All-Purpose en lugar de Job Compute. El cómputo All-Purpose cuesta hasta 3.5x más por DBU que Job Compute. La segunda razón más común son los clústeres inactivos sin terminación automática configurada. Consulta system.billing.usage con un join a system.billing.list_prices y ordena por costo descendente: el culpable suele estar en las primeras cinco filas.
¿Cuál es la diferencia entre los costos de DBUs de Databricks y los costos de infraestructura en la nube? Los costos de DBUs aparecen en tu factura de Databricks y cubren la capacidad de cómputo consumida. Los costos de infraestructura en la nube aparecen en tu factura de AWS, Azure o GCP y cubren las VMs subyacentes, el almacenamiento y la salida de red. Para los clústeres clásicos, aplican ambos. Para serverless, la infraestructura está incluida en el precio del DBU y no hay un cargo separado de VMs en la nube. La mayoría de los equipos solo ve el lado de los DBUs hasta la primera factura en la que el lado de la nube los sorprende.
¿El cómputo serverless es más caro o más barato que el clásico en Databricks? Depende del workload, pero en la práctica serverless suele costar menos a pesar de tener un precio por DBU más alto. Ese precio mayor se compensa al no pagar por las VMs en la nube ni por el tiempo inactivo: serverless se apaga de inmediato cuando el trabajo termina. El riesgo con serverless es que los aumentos de costo son más difíciles de detectar: dos ejecuciones pueden durar lo mismo pero consumir cantidades de DBUs muy distintas si un workload fue más pesado. Monitorea el consumo de DBUs, no solo la duración de la ejecución.