
TL;DR
Databricks vous facture deux fois : une fois pour les DBU (Databricks Units) et une fois pour l'infrastructure cloud, et les deux factures ne se rapprochent pas automatiquement. Les tarifs DBU varient jusqu'à 3,5x selon le type de compute, et des fonctionnalités plus récentes comme les quality monitors suivent des modèles de facturation totalement distincts. Trois contrôles permettent d'éviter la plupart des mauvaises surprises : l'auto-termination sur chaque cluster et warehouse, le Job Compute pour tous les workflows planifiés, et un tagging cohérent avant de passer à l'échelle. Rien de compliqué. Et pourtant, la plupart des équipes font l'impasse.
Comment fonctionne réellement la facturation Databricks ?
Databricks vous facture à deux endroits distincts, et les deux factures ne communiquent pas entre elles.
La première facture vient de Databricks lui-même. Elle est libellée en Databricks Units (DBU), une mesure abstraite de la capacité de calcul consommée par seconde. Le prix par DBU varie selon le type de travail exécuté, votre fournisseur cloud et l'édition Databricks que vous avez souscrite.
La seconde facture vient de votre fournisseur cloud (AWS, Azure ou GCP). C'est là qu'apparaissent les machines virtuelles sous-jacentes, le stockage et le trafic réseau sortant.
Cette double structure piège beaucoup d'équipes au départ. Les tables système de Databricks offrent une ventilation claire des coûts par workload et par SKU, mais cette vue ne couvre que la partie DBU. Les frais d'infrastructure cloud se trouvent dans un export de facturation séparé, et rapprocher les deux n'a rien de trivial. C'est encore plus difficile quand votre environnement mélange compute classique et serverless : les clusters classiques génèrent des coûts de VM sur votre facture cloud, tandis que le serverless intègre l'infrastructure dans le prix du DBU. Deux structures de coûts différentes, un seul workspace. La plupart des équipes ne prennent pleinement conscience de la partie cloud qu'à la première facture douloureuse.
Comprendre vos coûts totaux d'exploitation est un tel défi que Databricks a publié un utilitaire open source pour faciliter l'exercice : https://www.databricks.com/blog/getting-full-picture-unifying-databricks-and-cloud-infrastructure-costs
Qu'est-ce qu'un DBU, et pourquoi le tarif varie-t-il autant ?
Un DBU est une unité normalisée de capacité de traitement. Voyez-le comme un crédit consommé dès qu'un compute est en cours d'exécution. Le hic, c'est que la valeur en dollars d'un DBU n'est pas fixe. Elle dépend de trois facteurs :
1. Le type de computeC'est le multiplicateur le plus important. Exécuter un job batch planifié avec du Job Compute coûte environ 0,15 $/DBU sur Azure. Exécuter le même code en mode interactif sur un cluster All-Purpose coûte 0,55 $/DBU. Ce n'est pas une petite différence : c'est 3,5x. Les équipes qui laissent tourner leurs pipelines de production sur des clusters All-Purpose parce que c'était déjà là paient ce surcoût à chaque exécution.
Voici un tableau de référence pour Azure (région US, prix catalogue) :
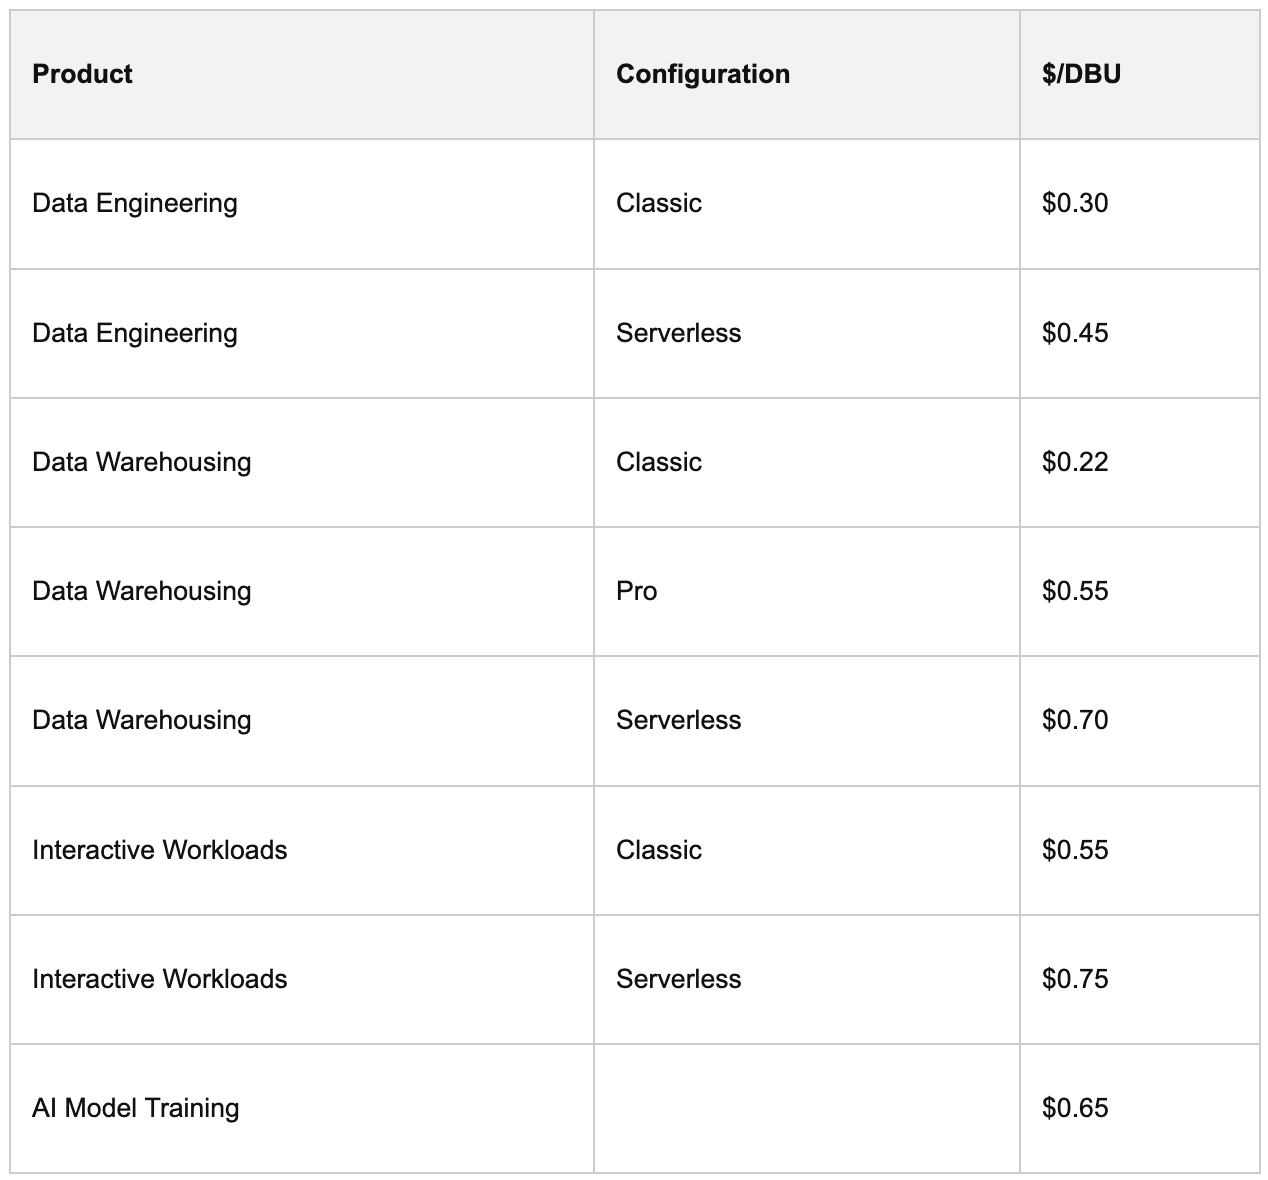
Tarifs complets sur databricks.com/product/pricing.
2. Serverless ou classiqueLe compute serverless affiche un tarif par DBU plus élevé car il intègre la gestion de l'infrastructure dans le prix, sans frais de VM côté cloud. Le compute classique a un tarif par DBU plus bas, mais vous payez séparément les VM sous-jacentes. Aucun des deux n'est systématiquement moins cher : tout dépend de votre workload.
3. Tout n'est pas facturé en DBULes fonctionnalités plus récentes de Databricks — ingestion de données, recherche vectorielle, agents IA, quality monitors, bases de données opérationnelles — suivent souvent des modèles totalement différents : au token, au Go stocké, à l'heure de capacité. C'est l'une des sources de surprises les plus négligées sur la facture. On y revient plus bas.
Quels coûts cachés liés aux quality monitors ont surpris un client ?
À propos des coûts hors DBU : les quality monitors sont l'un des facteurs de coût les plus sournois que j'aie rencontrés en pratique.
Pour les petites tables, une mise à jour de quality monitor coûte peu, généralement autour de 0,10 $ par exécution. Mais pour les grandes tables historiques sans Change Data Feed (CDF) activé, le monitor doit scanner la table entière à chaque exécution. Pour certaines grandes tables, cela représente 20 $ par mise à jour.
Un de mes clients avait déployé des quality monitors sur des centaines de tables. Environ 95 % d'entre eux tournaient à moindre coût, aucun problème. Mais une poignée de grandes tables sans CDF coûtaient 20 $ par exécution, avec une planification quotidienne. À elles seules, elles généraient une part substantielle de la facture mensuelle, et personne ne le savait avant que nous ne creusions dans notre Costs Monitoring Dashboard. Le panneau des quality monitors ne met pas cette information en évidence. Il faut aller la chercher.
La solution est simple : activez le CDF et utilisez des quality monitors en time-series plutôt qu'en snapshots. Mais encore faut-il savoir ce que l'on fait.
C'est aussi un bon exemple de la raison pour laquelle le coût DBU seul ne dit pas tout. Les quality monitors ont leur propre dimension de facturation, distincte de la consommation de vos clusters ou warehouses.
Faut-il choisir le serverless ou le compute classique pour réduire les coûts ?
Le compute serverless coûte 1,5 à 2 fois plus cher par DBU que son équivalent classique. On pourrait croire qu'il s'agit du mauvais choix pour les équipes soucieuses de leurs coûts. Ce n'est généralement pas le cas, mais une nuance mérite d'être comprise.
L'argument en faveur du serverless est simple : il élimine toute une catégorie de problèmes de configuration. Pas de dimensionnement de cluster, pas de réglage d'autoscaling, pas d'auto-termination à oublier, pas de clusters inactifs qui tournent toute la nuit. La charge opérationnelle disparaît, et pour la plupart des workloads, ce temps d'ingénierie coûte plus cher que le surcoût en DBU.
La nuance est la suivante : le serverless monte en charge si efficacement que les hausses de coûts peuvent être plus difficiles à repérer. Avec le compute classique, si un job prend systématiquement une heure, vous avez une idée raisonnable de ce qu'il coûte. Avec le serverless, deux exécutions peuvent avoir la même durée mais des coûts très différents, parce que le serverless a rapidement monté en charge pour absorber un workload plus lourd et que vous avez consommé deux fois plus de DBU. La durée reste la même. La facture double.
Cela ne veut pas dire que le serverless est un mauvais choix. Cela veut dire qu'il vous faut un vrai suivi des coûts, pas seulement un suivi des durées. Surveillez la consommation de DBU, pas uniquement le temps d'exécution.
Ma recommandation : commencez en serverless partout. Utilisez votre système de suivi des coûts pour identifier les jobs coûteux et fréquents, suffisamment prévisibles pour justifier l'effort de configurer correctement du compute classique. Optimisez les cas atypiques. N'essayez pas de tout régler à la main.
Quels sont les 3 contrôles à mettre en place avant d'en avoir besoin ?
Comprendre le modèle de tarification est utile. Mais c'est en passant à l'action que vous ferez vraiment la différence. Voici les trois contrôles qui offrent le plus d'impact avec le moins d'effort d'ingénierie.
1. L'auto-termination sur chaque cluster et chaque warehouse
C'est le contrôle qui a le plus d'impact, et celui qu'on néglige le plus souvent.
Sans auto-termination, un cluster qui a terminé son travail reste simplement là, à consommer des DBU à plein tarif jusqu'à ce que quelqu'un l'arrête manuellement. Le problème ne vient généralement pas d'un seul gros cluster, mais de l'accumulation de nombreux clusters, chacun laissé en marche quelques heures de trop, à l'échelle d'une équipe entière, chaque jour.
J'ai vu la situation mal tourner deux fois de façon mémorable.
La première : un stagiaire entraînait un modèle de ML et avait configuré un gros cluster avec une fenêtre d'auto-termination de cinq jours, pensant que c'était un plafond raisonnable pour un entraînement. Le job s'est terminé en quelques heures. Le cluster a continué de tourner. Personne ne l'a remarqué pendant plus d'un mois. Ce seul cluster représentait 15 à 20 % de la facture Databricks totale sur la période.
La seconde : un pipeline lisant des fichiers JSON très imbriqués fonctionnait parfaitement en environnement de test. Il a été déployé en production. Les fichiers de production avaient une structure différente. Le pipeline n'a pas échoué ; il a juste tourné. Pendant dix heures. Tous les jours. Personne ne surveillait. Il a fallu l'arrêter manuellement et le corriger. Un timeout de job l'aurait détecté dès la première exécution.
Comment configurer :
- Clusters interactifs : auto-termination à 30 minutes
- SQL warehouses : auto-stop à 10 minutes (les warehouses serverless démarrent en quelques secondes, le coût d'un redémarrage est donc faible)
- Chaque job planifié : un timeout à 2x la durée moyenne d'exécution
Une mise en garde importante : les notebooks n'ont aucun mécanisme de timeout natif. Un notebook en cours d'exécution maintient le cluster actif indéfiniment, car l'auto-termination ne se déclenche jamais tant que le cluster n'est pas inactif. Une requête de streaming affichée dans un notebook suffit à faire tourner un cluster indéfiniment. La seule protection consiste à surveiller la durée de fonctionnement des clusters via les tables système et à configurer des alertes pour tout ce qui tourne plus longtemps que prévu.
2. Utilisez le Job Compute (et non l'All-Purpose) pour les workflows planifiés
C'est la réduction de coûts la plus simple que la plupart des équipes n'ont pas encore appliquée.
Quand vous définissez un workflow Databricks, on est tenté de l'associer à un cluster interactif existant. Il est déjà là, déjà configuré, et il fonctionne. Le problème, c'est que le compute interactif (All-Purpose) tourne à environ 0,55 $/DBU, contre 0,15 $/DBU pour le Job Compute classique et 0,35 $/DBU en serverless. Pour un pipeline de production exécuté plusieurs fois par jour, l'écart s'accumule vite.
La bonne approche consiste à choisir le compute tâche par tâche. Un workflow comprenant une transformation Python suivie d'une agrégation SQL peut — et devrait — utiliser du Job Compute serverless pour la première tâche et un SQL warehouse pour la seconde. Vous n'êtes pas enfermé dans un seul type de compute pour tout le workflow. Choisissez l'option adaptée la moins coûteuse pour chaque tâche.
Règle simple : si c'est planifié, ça ne devrait pas tourner sur du compute All-Purpose.
3. Taguez tout avant de passer à l'échelle
Les tags ressemblent à une simple corvée administrative. En réalité, ils sont un prérequis de la gestion des coûts.
Les tables système de Databricks vous donnent les données brutes de consommation de DBU. Les tags sont ce qui vous permet de répondre à la question qui compte vraiment : quelle équipe, quel projet ou quel pipeline génère ce coût ?
Sans tags, vous finissez noyé sous des noms de clusters qui changent avec le temps (etl_dev, etl_staging, prod_churn_v2) et des enregistrements d'utilisation impossibles à regrouper de façon pertinente. Avec des tags, vous pouvez ventiler les coûts par unité métier, environnement et workflow avec une simple requête.
De bons tags pour commencer :
- Unité métier : l'équipe propriétaire de ce workload
- Environnement : production, staging, développement
- Projet : l'initiative concernée
- Nom du workflow : un nom logique stable qui survit aux renommages
Sur AWS et Azure, les tags se propagent également aux données de facturation de votre fournisseur cloud, ce qui est le seul moyen fiable de rapprocher vos coûts DBU Databricks des frais de VM cloud figurant sur l'autre facture.
Le conseil pratique : définissez votre taxonomie de tagging avant d'avoir des dizaines de pipelines. Ajouter des tags a posteriori sur un environnement mature est pénible. Une poignée de tags bien choisis, appliqués de façon cohérente dès le premier jour, vaut plus qu'un schéma élaboré que personne ne suit.
Pour le compute serverless en particulier, une étape supplémentaire s'impose : comme le serverless n'a pas de cluster persistant à taguer, vous devez configurer des serverless budget policies pour attacher des tags à l'utilisation serverless. Sans cela, la consommation serverless atterrit dans vos tables système sans aucun contexte d'attribution.
Envie de réduire votre facture Databricks de 30 % ? Notre ebook gratuit couvre l'auto-termination, le Job Compute, les budget policies et 17 autres correctifs applicables dès aujourd'hui. Sans blabla — juste les configurations qui font vraiment la différence. Téléchargez votre exemplaire gratuit →
Par où commencer face à une facture Databricks difficile à déchiffrer ?
Si vos coûts Databricks sont déjà plus élevés que prévu, le diagnostic le plus rapide consiste à interroger vos tables système :
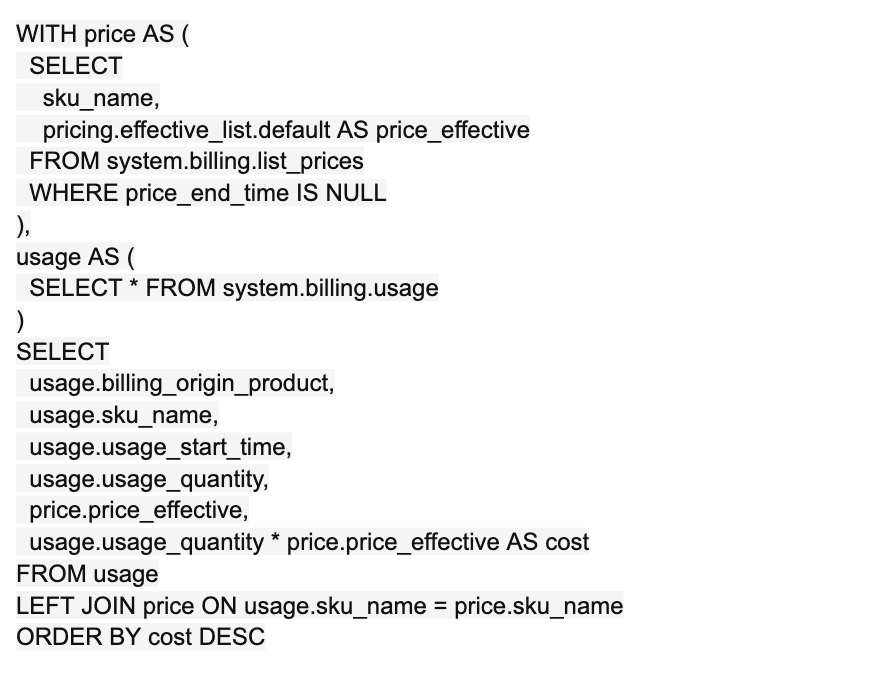
Vous obtenez ainsi une ventilation des coûts par produit et par SKU. Pour la relier aux workloads réels, joignez system.lakeflow.job_run_timeline afin d'identifier les jobs qui alourdissent la facture.
Quelques points à vérifier en particulier :
- Toute utilisation du SKU Interactive Workloads qui devrait relever du Job Compute
- Toute ligne quality monitor, surtout sur les grandes tables
- Des clusters ou warehouses qui tournent longtemps par rapport au travail réellement effectué
Gardez en tête que cette vue ne couvre que le côté Databricks. Les coûts de VM cloud se trouvent dans un export séparé de votre fournisseur cloud. Si votre environnement mélange classique et serverless, ces deux vues doivent être rapprochées séparément.
Comment garder le contrôle des coûts Databricks à mesure que vous grandissez ?
Les trois contrôles ci-dessus traiteront les sources de gaspillage les plus courantes. Les maintenir en place à mesure que votre équipe et vos workloads grandissent exige une couche de gouvernance :
- Déployez vos clusters en infrastructure as code plutôt que de laisser les ingénieurs provisionner les leurs. Quand la configuration est en YAML et passe par la CI/CD, l'auto-termination et le tagging sont toujours correctement définis, car ils sont imposés dans la définition et non laissés à la discrétion de chacun.
- Utilisez des cluster policies pour les équipes qui ont réellement besoin de créer leur propre compute. Les policies contraignent l'espace de configuration : elles peuvent imposer l'auto-termination, plafonner la taille des clusters et restreindre les types d'instances, tout en laissant aux ingénieurs une réelle flexibilité.
- Configurez des alertes de coûts dans la console de compte Databricks, ou construisez des alertes personnalisées à partir des tables système. Mesurer l'écart-type des coûts quotidiens par workload est un signal précoce plus sensible qu'un seuil fixe. Cela détecte la dérive avant qu'elle ne devienne un problème.
L'optimisation des coûts dans Databricks n'est pas un projet ponctuel. La plateforme évolue, les équipes ajoutent des workloads, les volumes de données croissent. Les équipes qui gardent une longueur d'avance sur leurs coûts traitent le suivi et l'attribution comme une pratique continue, et non comme un exercice de nettoyage après coup.
FAQ
Pourquoi ma facture Databricks est-elle plus élevée que prévu ? La raison la plus fréquente est une inadéquation du type de compute : des pipelines de production tournant sur des clusters interactifs All-Purpose au lieu du Job Compute. Le compute All-Purpose coûte jusqu'à 3,5x plus par DBU que le Job Compute. La deuxième raison la plus fréquente : des clusters inactifs sans auto-termination configurée. Interrogez system.billing.usage jointe à system.billing.list_prices et triez par coût décroissant — le coupable figure généralement dans les cinq premières lignes.
Quelle est la différence entre les coûts DBU Databricks et les coûts d'infrastructure cloud ? Les coûts DBU apparaissent sur votre facture Databricks et couvrent la capacité de calcul consommée. Les coûts d'infrastructure cloud apparaissent sur votre facture AWS, Azure ou GCP et couvrent les VM sous-jacentes, le stockage et le trafic réseau sortant. Pour les clusters classiques, les deux s'appliquent. Pour le serverless, l'infrastructure est intégrée au tarif DBU et il n'y a pas de frais de VM cloud distincts. La plupart des équipes ne voient que la partie DBU jusqu'à la première facture où la partie cloud les surprend.
Le compute serverless est-il plus ou moins cher que le classique dans Databricks ? Cela dépend du workload, mais en pratique le serverless coûte généralement moins cher malgré un tarif par DBU plus élevé. Ce tarif plus élevé est compensé par l'absence de frais de VM cloud et de temps d'inactivité facturé — le serverless s'arrête immédiatement une fois le travail terminé. Le risque avec le serverless : les hausses de coûts sont plus difficiles à repérer. Deux exécutions peuvent avoir la même durée mais consommer des quantités de DBU très différentes si l'un des workloads était plus lourd. Surveillez la consommation de DBU, pas seulement la durée d'exécution.