
TL;DR
Databricksの請求は2回発生します。1つはDBU(Databricks Unit)、もう1つはクラウドインフラの料金で、この2つの請求は自動的には突合されません。DBU単価はコンピュートの種類によって最大3.5倍の差があり、品質モニターなどの新しい機能はまったく別の課金モデルに従います。想定外のコストの大半は、3つの管理策で防げます。すべてのクラスターとウェアハウスへの自動終了の設定、スケジュール実行するワークフローすべてへのJob Computeの使用、そしてスケールする前の一貫したタグ付けです。どれも難しいものではありません。それでも、多くのチームが後回しにしています。
Databricksの課金は実際どのように機能するのか?
Databricksの請求は2つの別々の場所で発生し、しかもこの2つの請求書は互いに連携していません。
1つ目の請求はDatabricks自体からのものです。これは**Databricks Unit(DBU)**という、1秒ごとに消費されるコンピュート容量を表す抽象的な単位で計算されます。DBUあたりの価格は、実行する処理の種類、利用しているクラウドプロバイダー、購入したDatabricksのエディションによって変動します。
2つ目の請求はクラウドプロバイダー(AWS、Azure、GCP)からのものです。基盤となる仮想マシン、ストレージ、ネットワーク送信(egress)の料金がここに計上されます。
この二重構造で、導入初期に多くのチームがつまずきます。DatabricksのシステムテーブルではワークロードやSKUごとのコスト内訳をきれいに確認できますが、そこで見えるのはDBU側だけです。クラウドインフラの料金は別の請求エクスポートに存在し、両者の突合は決して簡単ではありません。クラシックコンピュートとサーバーレスコンピュートが混在する環境では、さらに難しくなります。クラシッククラスターではVMのコストがクラウド側の請求に計上される一方、サーバーレスではインフラ費用がDBU価格に含まれるためです。1つのワークスペースに、2つの異なるコスト構造が存在するのです。ほとんどのチームは、想定外に高額な請求書が初めて届くまで、クラウド側のコストを十分に把握していません。
総運用コストの把握は非常に難しい課題であるため、Databricksはこの作業を支援するオープンソースのユーティリティを公開しています: https://www.databricks.com/blog/getting-full-picture-unifying-databricks-and-cloud-infrastructure-costs
DBUとは何か、なぜ単価がこれほど変動するのか?
DBUは正規化された処理能力の単位です。コンピュートが稼働している間、消費され続けるクレジットと考えてください。問題は、1 DBUの金額が固定ではないことです。以下の3つの要素によって決まります。
1. コンピュートの種類これが最大の変動要因です。Job Computeを使ってスケジュールされたバッチジョブを実行した場合、Azureではおよそ$0.15/DBUです。同じコードをAll-Purposeクラスターでインタラクティブに実行すると$0.55/DBUになります。これは小さな差ではなく、3.5倍です。「すでにそこにあったから」という理由で本番パイプラインをAll-Purposeクラスターで動かしているチームは、実行のたびにこの割増料金を支払っています。
以下はAzure(米国リージョン、定価)の参考表です:
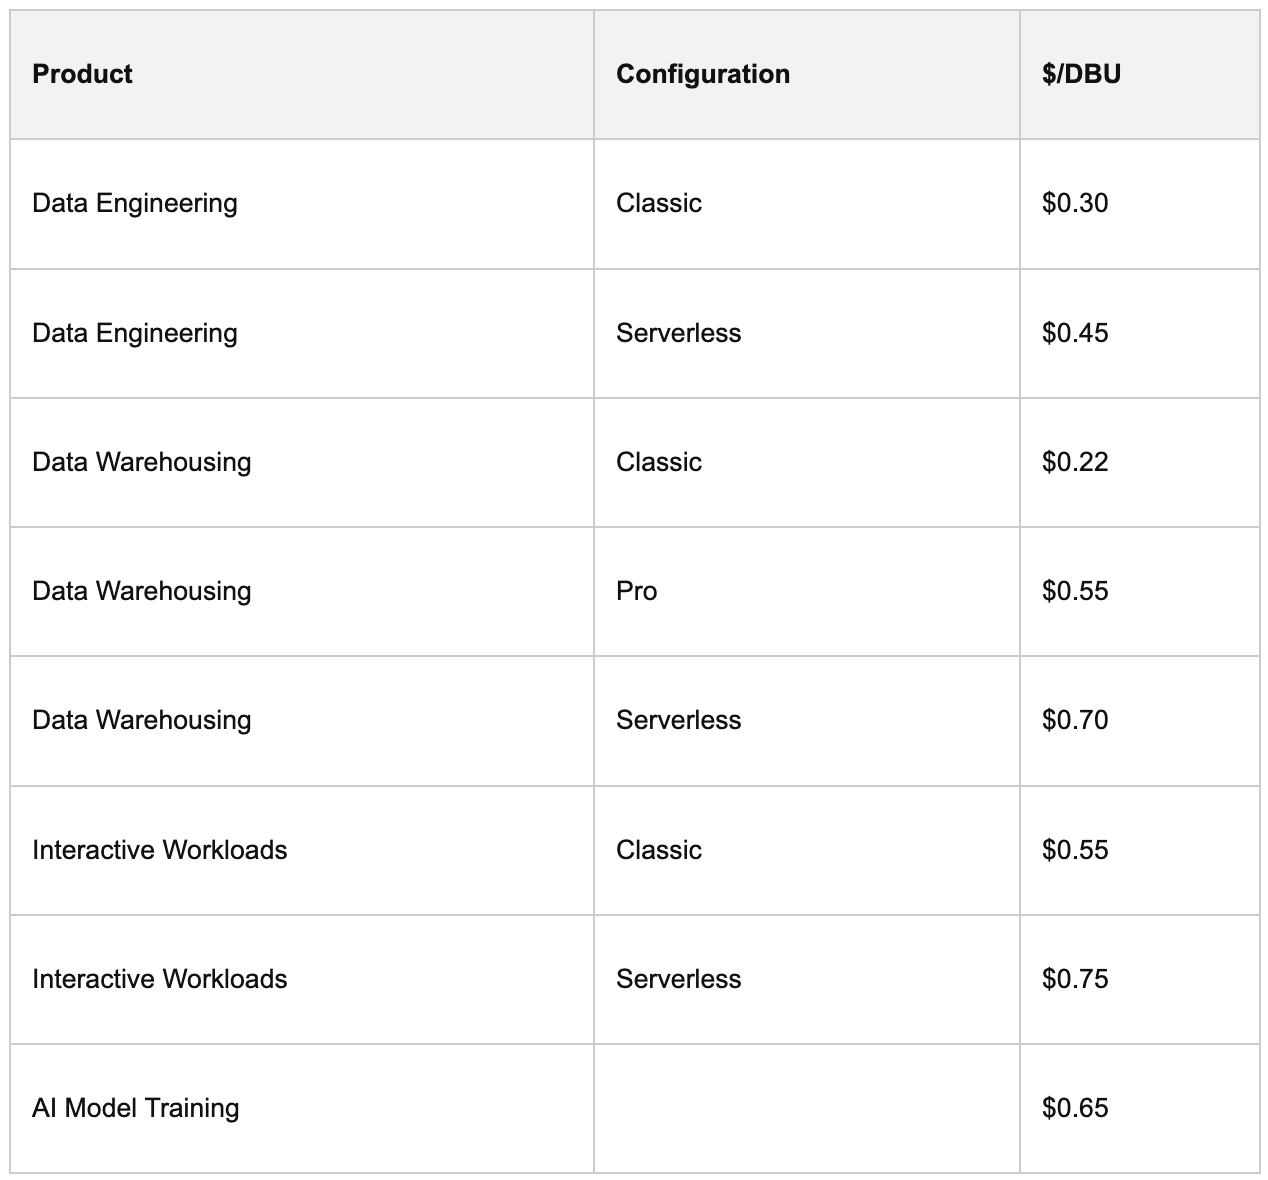
料金の詳細はdatabricks.com/product/pricingをご覧ください。
2. サーバーレスとクラシックサーバーレスコンピュートはインフラ管理を価格に含むため、DBUあたりの単価は高くなりますが、クラウド側のVM料金は発生しません。クラシックコンピュートはDBU単価が低い代わりに、基盤となるVMの料金を別途支払います。どちらが常に安いというわけではなく、完全にワークロード次第です。
3. すべてがDBU課金ではないデータ取り込み、ベクトル検索、AIエージェント、品質モニター、オペレーショナルデータベースといった新しいDatabricksの機能は、トークン単位、保存GB単位、容量の時間単位など、まったく異なる課金モデルに従うことがよくあります。これは、想定外の請求を生む要因の中でも、特に見落とされがちなものの1つです。詳しくは後述します。
品質モニターで顧客が直面した想定外のコストとは?
DBU以外のコストと言えば、品質モニターは私が実際に見た中で最も気づきにくいコスト要因の1つです。
小さなテーブルであれば、品質モニターの更新は安価で、通常は1回あたり約$0.10です。しかし、Change Data Feed(CDF)が有効化されていない大規模な履歴テーブルの場合、モニターは実行のたびにテーブル全体をスキャンしなければなりません。大きなテーブルでは、1回の更新で$20かかることもあります。
ある顧客は、数百のテーブルに品質モニターを導入していました。そのうち約95%は低コストで問題なく動いていました。しかし、CDFのない一部の大規模テーブルでは、1回あたり$20のコストが毎日のスケジュールで発生していました。これだけで月額請求のかなりの部分を占めていたのですが、私たちがコスト監視ダッシュボードを掘り下げるまで、誰も気づいていませんでした。品質モニターのパネルでは、この情報は目立つ形で表示されません。自分から探しに行く必要があるのです。
対策はシンプルです。CDFを有効化し、スナップショットではなく時系列(time-series)の品質モニターを使うこと。ただし、何をしているのかを理解した上で行う必要があります。
これは、「DBUコスト」だけでは全体像が見えない理由を示す好例でもあります。品質モニターには、クラスターやウェアハウスの消費とは別の、独自の課金軸があるのです。
コスト削減にはサーバーレスとクラシックのどちらを使うべきか?
サーバーレスコンピュートのDBU単価は、クラシックの同等構成より1.5〜2倍高くなります。これだけ聞くと、コストに敏感なチームには不向きに思えるかもしれません。実際にはたいていそうではないのですが、理解しておくべき注意点が1つあります。
まずサーバーレスから始めるべき理由は明快です。設定にまつわる一連の問題がまるごと不要になるからです。クラスターのサイジング判断も、オートスケーリングの調整も、自動終了の設定忘れも、夜間に放置されるアイドルクラスターもありません。運用負荷が消え、ほとんどのワークロードでは、そのエンジニアリング時間のほうがDBUの割増分より高くつきます。
注意点とはこうです。**サーバーレスは非常に効率的にスケールするため、コストの増加に気づきにくいのです。**クラシックコンピュートなら、あるジョブが常に1時間かかるのであれば、そのコストはおおよそ予測できます。サーバーレスでは、2回の実行が同じ実時間でもコストが大きく異なることがあります。より重いワークロードに応じてサーバーレスが素早くスケールアップし、2倍のDBUを消費したからです。所要時間は同じ。請求は2倍です。
これはサーバーレスが間違いだという意味ではありません。実行時間の追跡だけでなく、適切なコスト監視が必要だという意味です。実行時間ではなく、DBU消費量を監視してください。
私の推奨は、まず全面的にサーバーレスで始めることです。その上でコスト監視システムを使い、クラシックコンピュートを丁寧に設定する手間に見合うほど予測可能に実行される、高コスト・高頻度のジョブを特定します。最適化するのは外れ値だけで十分です。すべてを手作業でチューニングしようとしないでください。
問題が起きる前に導入すべき3つのコスト管理策とは?
料金モデルの理解は有益です。しかし実際に成果を生むのは、行動に移す部分です。最小のエンジニアリング工数で最大の効果をもたらす3つの管理策を紹介します。
1. すべてのクラスターとウェアハウスに自動終了を設定する
これは最もインパクトの大きい管理策であり、最も見送られがちなものでもあります。
自動終了がなければ、処理を終えたクラスターはそのまま放置され、誰かが手動で停止するまでフルレートでDBUを消費し続けます。損失は通常、1つの巨大なクラスターではなく、チーム全体で毎日、数時間ずつ余分に稼働し続ける多数のクラスターの積み重ねから生まれます。
私はこれが手痛い結果につながった印象的な事例を2つ見てきました。
1つ目:MLモデルの学習を行っていたインターンが、学習実行の上限として妥当だと考え、大規模クラスターに5日間の自動終了ウィンドウを設定しました。ジョブは数時間で終了。クラスターは稼働し続けました。1か月以上、誰も気づきませんでした。そのクラスター1つで、当該期間のDatabricks請求総額の**15〜20%**を占めていたのです。
2つ目:深くネストされたJSONファイルを読み込むパイプラインが、テスト環境では完璧に動作していました。それが本番環境にデプロイされました。本番のファイルは構造が異なっていました。パイプラインは失敗せず、ただ走り続けました。毎日、10時間。誰も見ていませんでした。手動で停止して修正する必要がありました。ジョブのタイムアウトを設定していれば、初回の実行で検知できたはずです。
設定方法:
- インタラクティブクラスター:自動終了を30分に設定
- SQL Warehouse:自動停止を10分に設定(サーバーレスのウェアハウスは数秒で起動するため、再起動のコストは低い)
- すべてのスケジュールジョブ:平均実行時間の2倍でタイムアウトを設定
重要な注意点が1つあります。**ノートブックにはネイティブのタイムアウト機構がありません。**実行中のノートブックはクラスターを無期限に稼働させ続けます。クラスターがアイドル状態でない限り、自動終了は発動しないからです。ノートブックに表示されたストリーミングクエリ1つで、クラスターは永遠に動き続けます。ここでの唯一の防御策は、システムテーブルでクラスターの稼働時間を監視し、想定より長く稼働しているものにアラートを設定することです。
2. スケジュール実行のワークフローにはJob Computeを使う(All-Purposeではなく)
これは、多くのチームがまだ実施していない、最も手軽なコスト削減策です。
Databricksのワークフローを定義するとき、既存のインタラクティブクラスターにアタッチしたくなるものです。すでに存在し、設定済みで、動くからです。問題は、インタラクティブ(All-Purpose)コンピュートがおよそ$0.55/DBUであるのに対し、Job Computeはクラシックで$0.15/DBU、サーバーレスで$0.35/DBUという点です。1日に何度も実行される本番パイプラインでは、この差は急速に積み上がります。
正しいアプローチは、コンピュートをタスク単位の判断として扱うことです。Python変換の後にSQL集計を行うワークフローなら、最初のタスクにはサーバーレスのJob Computeを、2つ目にはSQL Warehouseを使うことができますし、そうすべきです。ワークフロー全体で1つのコンピュートタイプに縛られる必要はありません。各タスクに対して、最も安価で適切な選択肢を選んでください。
経験則:スケジュール実行されるものは、All-Purposeコンピュートで動かすべきではありません。
3. スケールする前にすべてにタグを付ける
タグ付けは雑務のように感じられます。しかし実際には、コスト管理の前提条件です。
Databricksのシステムテーブルは、DBU消費の生データを提供します。タグがあって初めて、本当に重要な問い——どのチーム、プロジェクト、パイプラインがこのコストを生んでいるのか?——に答えられるようになります。
タグがなければ、時間とともに変わるクラスター名(etl_dev、etl_staging、prod_churn_v2)と、意味のあるグルーピングが不可能な利用レコードの山に埋もれることになります。タグがあれば、シンプルなクエリ1つで、事業部門、環境、ワークフロー別にコストを切り分けられます。
まず始めるとよいタグ:
- 事業部門: このワークロードを所有するチーム
- 環境: 本番、ステージング、開発
- プロジェクト: どの取り組みのためのものか
- ワークフロー名: 名前変更にも耐える安定した論理名
AWSとAzureでは、タグはクラウドプロバイダーの請求データにも伝播します。これは、DatabricksのDBUコストと、もう一方の請求書にあるクラウドVM料金を突合する唯一の確実な方法です。
実践的なアドバイス:パイプラインが数十本になる前に、タグの分類体系を定義しておきましょう。成熟した環境に後からタグを付け直すのは骨の折れる作業です。初日から一貫して適用される少数の厳選されたタグは、誰も守らない精緻なスキーマよりずっと価値があります。
サーバーレスコンピュートについては、追加の手順が1つあります。サーバーレスにはタグを付ける永続的なクラスターが存在しないため、サーバーレスの利用にタグを付与するにはサーバーレス予算ポリシーを設定する必要があります。これを行わないと、サーバーレスの消費は帰属情報のないままシステムテーブルに記録されてしまいます。
Databricksの請求を30%削減しませんか? 無料のeBookでは、自動終了、Job Compute、予算ポリシーに加え、今日から適用できる17の改善策を解説しています。余計な話は抜きで、本当に効果のある設定だけをまとめました。無料でダウンロードする →
今まさに分かりにくいDatabricksの請求書を前にしているなら、どこから始めるべきか?
Databricksのコストがすでに想定を超えているなら、最速の診断方法はシステムテーブルへのクエリです:
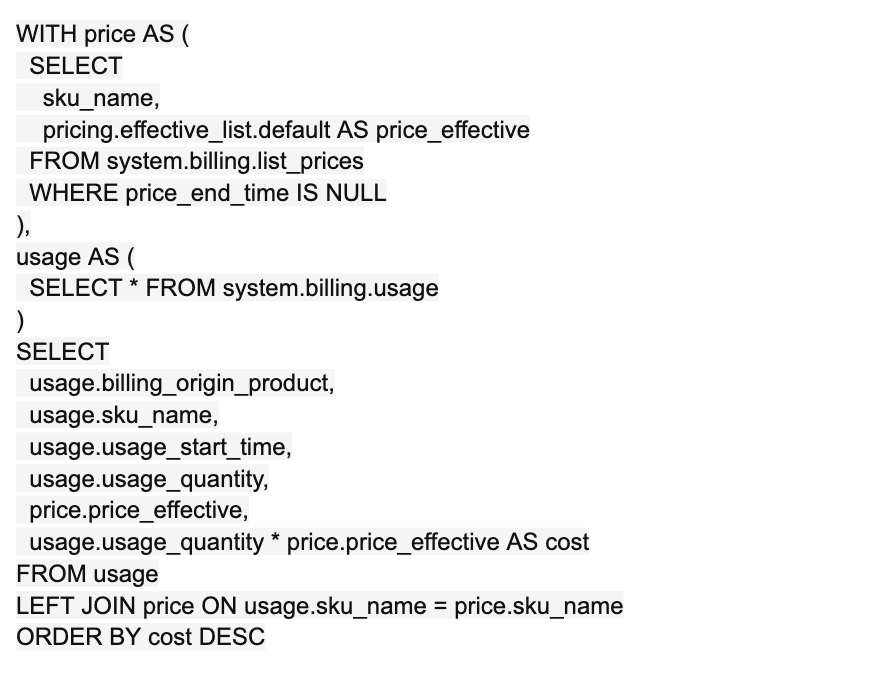
これで製品別・SKU別のコスト内訳が得られます。実際のワークロードと結び付けるには、system.lakeflow.job_run_timelineを結合して、どのジョブが請求を押し上げているかを確認します。
特に注目すべきポイント:
- Job ComputeであるべきInteractive Workloads SKUの利用
- 品質モニターの明細、特に大規模テーブルのもの
- 実行している処理に対して長時間稼働しているクラスターやウェアハウス
このビューがカバーするのはDatabricks側だけであることを忘れないでください。クラウドVMのコストは、クラウドプロバイダーからの別のエクスポートにあります。クラシックとサーバーレスが混在する環境であれば、この2つのビューは個別に突合する必要があります。
スケールしながらDatabricksのコストを管理し続けるには?
上記の3つの管理策で、最も一般的な無駄の発生源には対処できます。チームとワークロードが成長しても管理策を維持するには、ガバナンスのレイヤーが必要です:
- エンジニアが各自でプロビジョニングするのではなく、クラスターをInfrastructure as Codeとしてデプロイすること。設定がYAMLに記述されCI/CDを通過すれば、自動終了とタグ付けは定義の中で強制されるため、個人の裁量に委ねられることなく常に正しく設定されます。
- 本当に独自のコンピュートを作成する必要があるチームには、クラスターポリシーを使うこと。ポリシーは設定の自由度を制約します。自動終了の強制、クラスターサイズの上限設定、インスタンスタイプの制限を行いながら、エンジニアに十分な柔軟性を残せます。
- Databricksのアカウントコンソールでコストアラートを設定するか、システムテーブルを基盤にカスタムアラートを構築すること。ワークロードごとの日次コストの標準偏差を測定するほうが、固定しきい値よりも感度の高い早期シグナルになります。問題になる前にドリフトを捉えられます。
Databricksのコスト最適化は、一度きりのプロジェクトではありません。プラットフォームは進化し、チームはワークロードを追加し、データ量は増え続けます。コストを先回りして管理できているチームは、監視とコスト帰属を、何かが起きた後の後始末ではなく、継続的な実践として扱っています。
よくある質問
Databricksの請求が想定より高いのはなぜですか? 最も多い原因はコンピュートタイプの不一致です。本番パイプラインがJob ComputeではなくAll-Purposeのインタラクティブクラスターで実行されているケースです。All-PurposeコンピュートのDBU単価は、Job Computeの最大3.5倍です。2番目に多い原因は、自動終了が設定されていないアイドルクラスターです。system.billing.usageをsystem.billing.list_pricesと結合し、コストの降順でソートしてください。原因はたいてい上位5行の中にあります。
DatabricksのDBUコストとクラウドインフラコストの違いは何ですか? DBUコストはDatabricksの請求書に計上され、消費したコンピュート容量に対する料金です。クラウドインフラコストはAWS、Azure、GCPの請求書に計上され、基盤となるVM、ストレージ、ネットワーク送信に対する料金です。クラシッククラスターでは両方が発生します。サーバーレスではインフラがDBU単価に含まれており、クラウドVMの料金は別途発生しません。多くのチームはDBU側しか見ておらず、最初の請求書でクラウド側に驚かされることになります。
Databricksではサーバーレスとクラシックのどちらが高くつきますか? ワークロードによりますが、DBU単価が高いにもかかわらず、実際にはサーバーレスのほうが安く済むことがほとんどです。クラウドVMの料金が不要で、アイドル時間に対する支払いも発生しない(サーバーレスは処理完了後すぐに停止する)ことで、高い単価は相殺されます。サーバーレスのリスクは、コストの増加に気づきにくいことです。一方のワークロードが重かった場合、2回の実行が同じ実時間でも、消費するDBU量は大きく異なることがあります。実行時間だけでなく、DBU消費量を監視してください。