
Resumo (TL;DR)
O Databricks cobra você duas vezes: uma por DBUs (Databricks Units) e outra pela infraestrutura de nuvem — e as duas faturas não se reconciliam automaticamente. As taxas de DBU variam até 3,5x dependendo do tipo de compute, e recursos mais novos, como os quality monitors, seguem modelos de cobrança totalmente separados. Três controles evitam a maioria das surpresas de custo: auto-termination em todo cluster e warehouse, Job Compute para todos os workflows agendados e tagging consistente antes de escalar. Nenhum deles é complicado. Mesmo assim, a maioria das equipes pula essa etapa.
Como funciona, na prática, a cobrança do Databricks?
O Databricks cobra você em dois lugares distintos, e as duas faturas não conversam entre si.
A primeira fatura vem do próprio Databricks. Ela é denominada em Databricks Units (DBUs), uma medida abstrata de capacidade de computação consumida por segundo. O preço por DBU varia conforme o tipo de trabalho que você está executando, o provedor de nuvem que você usa e a edição do Databricks que você contratou.
A segunda fatura vem do seu provedor de nuvem (AWS, Azure ou GCP). É nela que aparecem as máquinas virtuais subjacentes, o armazenamento e a saída de rede.
Essa estrutura dupla pega muitas equipes de surpresa logo no início. As tabelas de sistema do Databricks oferecem um detalhamento claro de custos por workload e SKU, mas essa visão cobre apenas o lado dos DBUs. Os custos de infraestrutura de nuvem ficam em um export de faturamento separado, e reconciliar os dois é genuinamente trabalhoso. Fica ainda mais difícil quando seu ambiente mistura compute clássico e serverless: clusters clássicos têm custos de VM associados na fatura da nuvem, enquanto o serverless embute a infraestrutura no preço do DBU. Duas estruturas de custo diferentes, um único workspace. A maioria das equipes só contabiliza totalmente o lado da nuvem depois da primeira fatura desconfortável.
Entender o custo total de operação é um desafio tão grande que o Databricks lançou um utilitário open source para facilitar esse exercício: https://www.databricks.com/blog/getting-full-picture-unifying-databricks-and-cloud-infrastructure-costs
O que é um DBU e por que a taxa varia tanto?
Um DBU é uma unidade normalizada de capacidade de processamento. Pense nele como um crédito que é consumido sempre que há compute em execução. O detalhe é que o valor em dólares de um DBU não é fixo. Ele depende de três fatores:
1. Tipo de computeEsse é o maior multiplicador. Executar um job em lote agendado usando Job Compute custa cerca de US$ 0,15/DBU no Azure. Executar o mesmo código de forma interativa em um cluster All-Purpose custa US$ 0,55/DBU. Não é uma diferença pequena: são 3,5x. Equipes que deixam pipelines de produção rodando em clusters All-Purpose porque "ele já estava lá" pagam esse ágio em cada execução.
Aqui está uma tabela de referência para o Azure (região dos EUA, preços de lista):
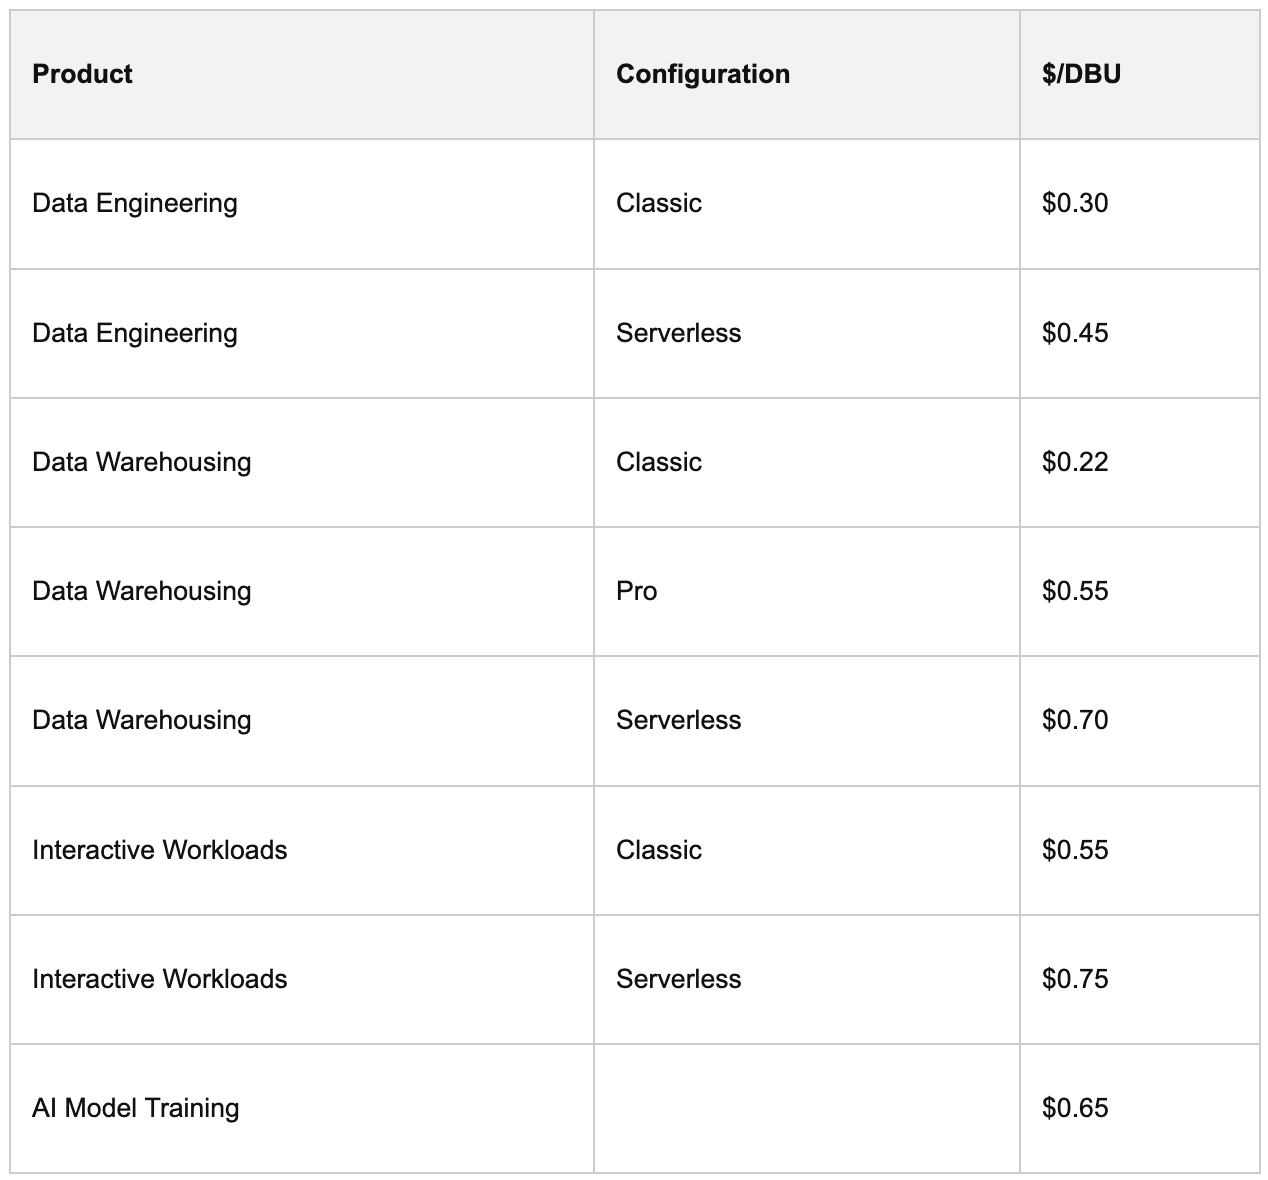
Preços completos em databricks.com/product/pricing.
2. Serverless vs. clássicoO compute serverless tem uma taxa por DBU mais alta porque embute o gerenciamento da infraestrutura no preço, sem cobranças de VM no lado da nuvem. O compute clássico tem uma taxa por DBU mais baixa, mas você paga pelas VMs subjacentes separadamente. Nenhum dos dois é universalmente mais barato; depende inteiramente do seu workload.
3. Nem tudo é precificado em DBURecursos mais novos do Databricks, incluindo ingestão de dados, busca vetorial, agentes de IA, quality monitors e bancos de dados operacionais, costumam seguir modelos totalmente diferentes: por token, por GB armazenado, por hora de capacidade. Essa é uma das fontes de surpresas na fatura mais negligenciadas. Falamos mais sobre isso a seguir.
Que custos ocultos pegaram um cliente de surpresa com quality monitors?
Falando em custos fora do DBU: os quality monitors são um dos geradores de custo mais traiçoeiros que já vi na prática.
Para tabelas pequenas, uma atualização de quality monitor é barata, geralmente em torno de US$ 0,10 por execução. Mas, para tabelas grandes e históricas sem o Change Data Feed (CDF) habilitado, o monitor precisa varrer a tabela inteira em cada execução. Para algumas tabelas grandes, isso significa US$ 20 por atualização.
Um cliente meu havia implantado quality monitors em centenas de tabelas. Cerca de 95% delas rodavam a baixo custo, sem problema. Mas um punhado de tabelas grandes sem CDF custava US$ 20 por execução, com agendamento diário. Só isso já gerava uma parcela substancial da fatura mensal, e ninguém sabia até investigarmos nosso dashboard de monitoramento de custos. O painel de quality monitors não destaca isso com clareza. Você precisa procurar.
A correção é simples: habilitar o CDF e usar quality monitors de séries temporais em vez de snapshots. Mas é preciso saber o que você está fazendo.
Esse também é um bom exemplo de por que o "custo de DBU" sozinho não conta a história completa. Os quality monitors têm sua própria dimensão de cobrança, separada do consumo do seu cluster ou warehouse.
Vale a pena usar compute serverless ou clássico para economizar?
O compute serverless custa de 1,5 a 2x mais por DBU do que seu equivalente clássico. Isso faz parecer a escolha errada para equipes preocupadas com custo. Normalmente não é, mas há uma nuance que vale entender.
O argumento para começar com serverless é direto: ele elimina uma classe inteira de problemas de configuração. Nada de decisões de dimensionamento de cluster, nada de ajuste de autoscaling, nenhum auto-termination para esquecer, nenhum cluster ocioso passando a noite ligado. O overhead operacional desaparece e, para a maioria dos workloads, esse tempo de engenharia custa mais do que o ágio no DBU.
A nuance é a seguinte: o serverless escala com tanta eficiência que aumentos de custo podem ser mais difíceis de perceber. Com compute clássico, se um job leva consistentemente uma hora, você tem uma expectativa razoável de quanto ele custa. Com serverless, duas execuções podem levar o mesmo tempo corrido, mas ter custos muito diferentes, porque o serverless escalou rapidamente em resposta a um workload mais pesado e você consumiu o dobro de DBUs. A duração permanece a mesma. A fatura dobra.
Isso não significa que o serverless seja errado. Significa que você precisa de um monitoramento de custos adequado, não apenas de acompanhamento de duração. Observe o consumo de DBUs, não só o tempo de execução.
Minha recomendação: comece com serverless em tudo. Use seu sistema de monitoramento de custos para identificar os jobs de alto custo e alta frequência que rodam de forma previsível o suficiente para justificar o esforço de configurar o compute clássico corretamente. Otimize os pontos fora da curva. Não tente ajustar tudo manualmente.
Quais são os 3 controles de custo para implementar antes de precisar deles?
Entender o modelo de preços é útil. Agir de fato é o que faz a diferença. Aqui estão os três controles que entregam o maior impacto com o menor esforço de engenharia.
1. Auto-Termination em todo cluster e warehouse
Esse é o controle de maior impacto isolado — e o mais frequentemente ignorado.
Sem auto-termination, um cluster que termina seu trabalho simplesmente fica lá, consumindo DBUs na tarifa cheia até alguém pará-lo manualmente. O prejuízo normalmente não vem de um único cluster grande; vem do acúmulo de muitos clusters, cada um deixado rodando algumas horas a mais, por toda uma equipe, todos os dias.
Já vi isso dar errado duas vezes de formas memoráveis.
A primeira: um estagiário estava treinando modelos de ML e configurou um cluster grande com uma janela de auto-termination de cinco dias, achando que era um teto razoável para um treinamento. O job terminou em horas. O cluster continuou rodando. Ninguém percebeu por mais de um mês. Aquele único cluster representou 15–20% da fatura total do Databricks naquele período.
A segunda: um pipeline que lia arquivos JSON altamente aninhados funcionava perfeitamente no ambiente de teste. Foi implantado em produção. Os arquivos de produção tinham uma estrutura diferente. O pipeline não falhou; apenas rodou. Por dez horas. Todos os dias. Ninguém estava olhando. Ele teve que ser parado manualmente e corrigido. Um timeout de job teria detectado o problema na primeira execução.
Como configurar:
- Clusters interativos: defina o auto-termination para 30 minutos
- SQL warehouses: defina o auto-stop para 10 minutos (warehouses serverless iniciam em segundos, então o custo de uma reinicialização é baixo)
- Todo job agendado: defina um timeout de 2x a duração média de execução
Uma ressalva importante: notebooks não têm mecanismo nativo de timeout. Um notebook em execução ativa mantém o cluster vivo indefinidamente, porque o auto-termination nunca dispara quando o cluster não está ocioso. Uma query de streaming exibida em um notebook é suficiente para manter um cluster rodando para sempre. A única proteção aqui é monitorar o uptime dos clusters pelas tabelas de sistema e configurar alertas para qualquer coisa rodando por mais tempo que o esperado.
2. Use Job Compute (não All-Purpose) para workflows agendados
Essa é a redução de custo mais fácil que a maioria das equipes ainda não fez.
Ao definir um workflow no Databricks, a tentação é anexá-lo a um cluster interativo existente. Ele já está lá, já está configurado, funciona. O problema é que o compute interativo (All-Purpose) custa cerca de US$ 0,55/DBU, enquanto o Job Compute custa US$ 0,15/DBU no clássico e US$ 0,35/DBU no serverless. Para um pipeline de produção que roda várias vezes por dia, essa diferença se acumula rápido.
A abordagem certa é tratar o compute como uma decisão por tarefa. Um workflow com uma transformação em Python seguida de uma agregação em SQL pode — e deve — usar Job Compute serverless para a primeira tarefa e um SQL warehouse para a segunda. Você não está preso a um único tipo de compute para o workflow inteiro. Escolha a opção adequada mais barata para cada tarefa.
Regra prática: se é agendado, não deveria estar rodando em compute All-Purpose.
3. Aplique tags em tudo antes de escalar
Tags parecem uma tarefa de organização. Na verdade, são um pré-requisito de gestão de custos.
As tabelas de sistema do Databricks fornecem dados brutos de consumo de DBUs. As tags são o que permite responder à pergunta que realmente importa: qual equipe, projeto ou pipeline está gerando esse custo?
Sem tags, você acaba se afogando em nomes de cluster que mudam ao longo do tempo (etl_dev, etl_staging, prod_churn_v2) e registros de uso impossíveis de agrupar de forma significativa. Com tags, você consegue fatiar os custos por unidade de negócio, ambiente e workflow com uma query simples.
Boas tags para começar:
- Unidade de negócio: qual equipe é dona deste workload
- Ambiente: produção, staging, desenvolvimento
- Projeto: a qual iniciativa ele atende
- Nome do workflow: um nome lógico estável que sobreviva a renomeações
Na AWS e no Azure, as tags também se propagam para os dados de faturamento do seu provedor de nuvem, o que é a única forma confiável de reconciliar os custos de DBU do Databricks com as cobranças de VM da nuvem na outra fatura.
O conselho prático: defina sua taxonomia de tagging antes de ter dezenas de pipelines. Aplicar tags retroativamente em um ambiente maduro é doloroso. Um punhado de tags bem escolhidas e aplicadas com consistência desde o primeiro dia vale mais do que um esquema elaborado que ninguém segue.
Especificamente para compute serverless, há um passo adicional: como o serverless não tem um cluster persistente para receber tags, você precisa configurar serverless budget policies para anexar tags ao uso serverless. Sem isso, o consumo serverless aparece nas suas tabelas de sistema sem nenhum contexto de atribuição.
Quer cortar sua fatura do Databricks em 30%? Nosso ebook gratuito cobre auto-termination, Job Compute, budget policies e mais 17 correções que você pode aplicar hoje. Sem enrolação — só as configurações que realmente fazem a diferença. Baixe seu exemplar gratuito →
Por onde começar se você está diante de uma fatura confusa do Databricks neste momento?
Se os custos do Databricks já estão acima do esperado, o diagnóstico mais rápido é consultar suas tabelas de sistema:
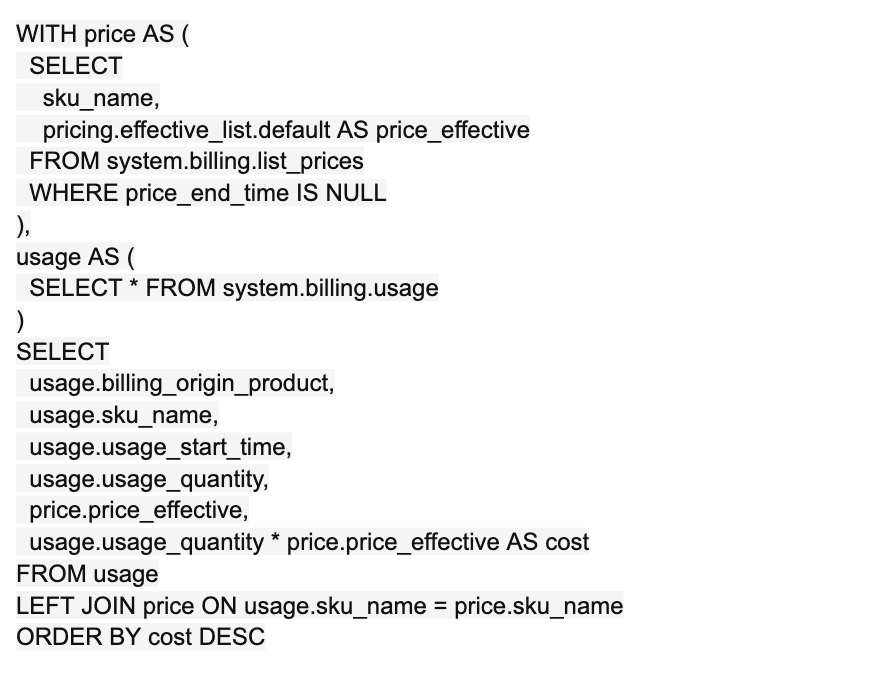
Isso fornece um detalhamento de custos por produto e SKU. Para conectar aos workloads reais, faça um join com system.lakeflow.job_run_timeline para ver quais jobs estão pesando na fatura.
Alguns pontos específicos para procurar:
- Qualquer uso do SKU de Interactive Workloads que deveria ser Job Compute
- Qualquer lançamento de quality monitor, especialmente em tabelas grandes
- Clusters ou warehouses rodando por muito tempo em relação ao trabalho que executam
Lembre-se de que essa visão cobre apenas o lado do Databricks. Os custos de VM da nuvem estão em um export separado do seu provedor de nuvem. Se você está em um ambiente misto clássico/serverless, essas duas visões precisam ser reconciliadas separadamente.
Como manter os custos do Databricks sob controle à medida que você escala?
Os três controles acima resolvem as fontes mais comuns de desperdício. Mantê-los funcionando enquanto sua equipe e seus workloads crescem exige uma camada de governança:
- Implante clusters como infraestrutura como código em vez de deixar que os Engineers provisionem por conta própria. Quando a configuração está em YAML e passa por CI/CD, o auto-termination e o tagging estão sempre configurados corretamente, porque são impostos na definição, e não deixados ao critério individual.
- Use cluster policies para equipes que realmente precisam criar seu próprio compute. As policies restringem o espaço de configuração: podem impor auto-termination, limitar o tamanho dos clusters e restringir tipos de instância, sem tirar dos Engineers uma flexibilidade significativa.
- Configure alertas de custo no console de conta do Databricks, ou crie alertas personalizados sobre as tabelas de sistema. Medir o desvio padrão dos custos diários por workload é um sinal precoce mais sensível do que um limite fixo. Ele detecta desvios antes que virem problema.
Otimização de custos no Databricks não é um projeto pontual. A plataforma evolui, as equipes adicionam workloads, os volumes de dados crescem. As equipes que se mantêm à frente dos custos tratam monitoramento e atribuição como uma prática contínua, não como uma faxina depois que algo deu errado.
Perguntas frequentes
Por que minha fatura do Databricks está mais alta que o esperado? O motivo mais comum é o uso do tipo errado de compute: pipelines de produção rodando em clusters interativos All-Purpose em vez de Job Compute. O compute All-Purpose custa até 3,5x mais por DBU do que o Job Compute. O segundo motivo mais comum são clusters ociosos sem auto-termination configurado. Consulte system.billing.usage com join em system.billing.list_prices e ordene por custo decrescente — o culpado geralmente está nas cinco primeiras linhas.
Qual é a diferença entre os custos de DBU do Databricks e os custos de infraestrutura de nuvem? Os custos de DBU aparecem na fatura do Databricks e cobrem a capacidade de computação consumida. Os custos de infraestrutura de nuvem aparecem na fatura da AWS, do Azure ou do GCP e cobrem as VMs subjacentes, o armazenamento e a saída de rede. Para clusters clássicos, os dois se aplicam. Para serverless, a infraestrutura está embutida na taxa de DBU e não há cobrança separada de VM na nuvem. A maioria das equipes só enxerga o lado dos DBUs até a primeira fatura em que o lado da nuvem as surpreende.
O compute serverless é mais caro ou mais barato que o clássico no Databricks? Depende do workload, mas o serverless geralmente custa menos na prática, apesar da taxa por DBU mais alta. A taxa maior é compensada por não pagar pelas VMs da nuvem e por não pagar por tempo ocioso — o serverless desliga imediatamente quando o trabalho termina. O risco do serverless é que aumentos de custo são mais difíceis de perceber: duas execuções podem levar o mesmo tempo corrido, mas consumir quantidades muito diferentes de DBUs se um dos workloads foi mais pesado. Monitore o consumo de DBUs, não apenas a duração da execução.