
TL;DR
Databricks emette due fatture: una per le DBU (Databricks Units) e una per l'infrastruttura cloud, e le due fatture non si riconciliano automaticamente. Le tariffe DBU variano fino a 3,5x a seconda del tipo di compute, e le funzionalità più recenti come i quality monitor seguono modelli di fatturazione completamente separati. Tre controlli prevengono la maggior parte delle sorprese sui costi: auto-termination su ogni cluster e warehouse, Job Compute per tutti i workflow pianificati e un tagging coerente prima di scalare. Nessuno di questi è complicato. Eppure la maggior parte dei team li salta.
Come funziona davvero la fatturazione di Databricks?
Databricks addebita i costi in due punti distinti, e le due fatture non comunicano tra loro.
La prima fattura arriva direttamente da Databricks. È espressa in Databricks Units (DBU), una misura astratta della capacità di calcolo consumata al secondo. Il prezzo per DBU varia a seconda del tipo di lavoro in esecuzione, del cloud provider utilizzato e dell'edizione di Databricks acquistata.
La seconda fattura arriva dal cloud provider (AWS, Azure o GCP). È qui che compaiono le macchine virtuali sottostanti, lo storage e l'egress di rete.
Questa doppia struttura mette in difficoltà molti team fin dall'inizio. Le system tables di Databricks offrono una ripartizione pulita dei costi per workload e SKU, ma quella vista copre solo il lato DBU. Gli addebiti per l'infrastruttura cloud si trovano in un export di fatturazione separato, e riconciliare le due fonti è tutt'altro che banale. Diventa ancora più difficile quando l'ambiente mescola compute classico e serverless: i cluster classici hanno costi VM associati nella fattura cloud, mentre il serverless include l'infrastruttura nel prezzo della DBU. Due strutture di costo diverse, un unico workspace. La maggior parte dei team non tiene pienamente conto del lato cloud fino alla prima fattura spiacevole.
Capire i costi operativi totali è una sfida tale che Databricks ha rilasciato una utility open source per semplificare il compito: https://www.databricks.com/blog/getting-full-picture-unifying-databricks-and-cloud-infrastructure-costs
Che cos'è una DBU e perché la tariffa varia così tanto?
Una DBU è un'unità normalizzata di capacità di elaborazione. La si può immaginare come un credito che viene consumato ogni volta che il compute è in esecuzione. Il punto è che il valore in dollari di una DBU non è fisso. Dipende da tre fattori:
1. Tipo di computeÈ il moltiplicatore più importante. Eseguire un job batch pianificato con Job Compute costa circa 0,15 $/DBU su Azure. Eseguire lo stesso codice in modo interattivo su un cluster All-Purpose costa 0,55 $/DBU. Non è una differenza da poco: è 3,5x. I team che lasciano girare le pipeline di produzione su cluster All-Purpose perché "era già lì" pagano quel sovrapprezzo a ogni esecuzione.
Ecco una tabella di riferimento per Azure (regione US, prezzi di listino):
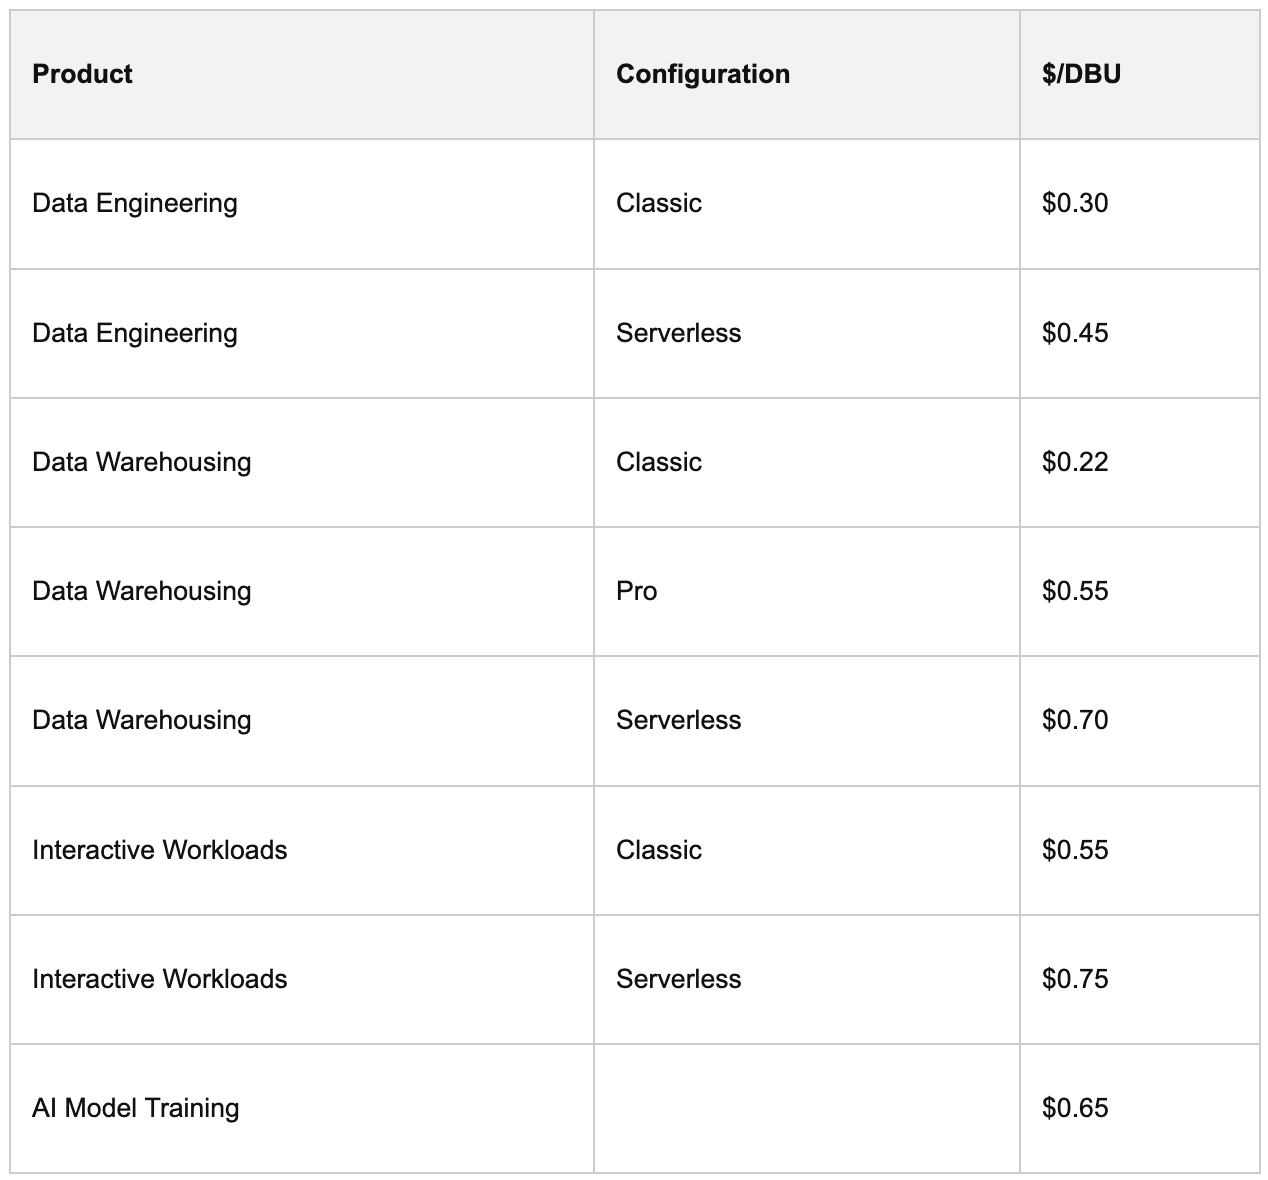
Prezzi completi su databricks.com/product/pricing.
2. Serverless vs. classicoIl compute serverless ha una tariffa per DBU più alta perché include la gestione dell'infrastruttura nel prezzo, senza addebiti VM sul lato cloud. Il compute classico ha una tariffa per DBU più bassa, ma le VM sottostanti si pagano a parte. Nessuno dei due è universalmente più economico: dipende interamente dal workload.
3. Non tutto si paga in DBULe funzionalità più recenti di Databricks, tra cui data ingestion, vector search, agenti AI, quality monitor e database operativi, seguono spesso modelli completamente diversi: per token, per GB archiviato, per ora di capacità. È una delle fonti di sorprese in fattura più trascurate. Ne parliamo più avanti.
Quali costi nascosti hanno colto di sorpresa un cliente con i quality monitor?
A proposito di costi non-DBU: i quality monitor sono uno dei driver di costo più subdoli che abbia visto nella pratica.
Per le tabelle piccole, un aggiornamento del quality monitor è economico, in genere circa 0,10 $ per esecuzione. Ma per le tabelle grandi e storiche senza Change Data Feed (CDF) abilitato, il monitor deve scansionare l'intera tabella a ogni esecuzione. Per alcune tabelle di grandi dimensioni, si parla di 20 $ per aggiornamento.
Un mio cliente aveva implementato quality monitor su centinaia di tabelle. Circa il 95% girava a costi contenuti, nessun problema. Ma una manciata di tabelle grandi senza CDF costava 20 $ a esecuzione, con pianificazione giornaliera. Da sola, quella voce generava una quota sostanziale della fattura mensile, e nessuno lo sapeva finché non abbiamo scavato nella nostra Costs Monitoring Dashboard. Il pannello dei quality monitor non lo mette in evidenza. Bisogna andarselo a cercare.
La soluzione è semplice: abilitare il CDF e usare quality monitor time-series anziché snapshot. Ma bisogna sapere cosa si sta facendo.
È anche un buon esempio del perché il solo "costo DBU" non dà il quadro completo. I quality monitor hanno una dimensione di fatturazione propria, separata dal consumo dei cluster o dei warehouse.
Conviene usare il compute serverless o classico per risparmiare?
Il compute serverless costa da 1,5 a 2 volte di più per DBU rispetto all'equivalente classico. Detta così, sembra la scelta sbagliata per i team attenti ai costi. Di solito non lo è, ma c'è una sfumatura che vale la pena capire.
L'argomento a favore di partire con il serverless è semplice: elimina un'intera classe di problemi di configurazione. Niente decisioni sul dimensionamento dei cluster, niente tuning dell'autoscaling, nessuna auto-termination da dimenticare, nessun cluster inattivo che resta acceso tutta la notte. L'overhead operativo scompare e, per la maggior parte dei workloads, quel tempo di engineering costa più del sovrapprezzo sulle DBU.
La sfumatura è questa: il serverless scala con una tale efficienza che gli aumenti di costo possono essere più difficili da individuare. Con il compute classico, se un job impiega regolarmente un'ora, si ha un'aspettativa ragionevole di quanto costa. Con il serverless, due esecuzioni possono avere la stessa durata effettiva ma costi molto diversi, perché il serverless è scalato rapidamente in risposta a un workload più pesante e si sono consumate il doppio delle DBU. La durata resta la stessa. La fattura raddoppia.
Questo non significa che il serverless sia sbagliato. Significa che serve un monitoraggio dei costi adeguato, non solo il tracciamento delle durate. Va monitorato il consumo di DBU, non solo il tempo di esecuzione.
Il mio consiglio: partire con il serverless su tutta la linea. Usare il sistema di monitoraggio dei costi per identificare i job ad alto costo e alta frequenza che girano in modo abbastanza prevedibile da giustificare lo sforzo di configurare correttamente il compute classico. Ottimizzare i casi anomali. Non cercare di mettere a punto tutto a mano.
Quali sono i 3 controlli di costo da mettere in atto prima che servano?
Capire il modello di pricing è utile. Agire di conseguenza è la parte che fa la differenza. Ecco i tre controlli che offrono il massimo impatto con il minimo sforzo di engineering.
1. Auto-termination su ogni cluster e warehouse
È il controllo più incisivo in assoluto, e anche quello più spesso trascurato.
Senza auto-termination, un cluster che ha finito il proprio lavoro resta semplicemente lì, consumando DBU a tariffa piena finché qualcuno non lo ferma manualmente. Il danno di solito non viene da un unico grande cluster, ma dall'accumulo di tanti cluster, ciascuno lasciato acceso qualche ora di troppo, nell'intero team, ogni giorno.
L'ho visto finire male due volte, in modi memorabili.
La prima: uno stagista stava addestrando un modello di ML e aveva configurato un cluster di grandi dimensioni con una finestra di auto-termination di cinque giorni, pensando che fosse un tetto ragionevole per un run di training. Il job si è concluso in poche ore. Il cluster ha continuato a girare. Nessuno se n'è accorto per oltre un mese. Quel singolo cluster rappresentava il 15-20% della fattura Databricks totale di quel periodo.
La seconda: una pipeline che leggeva file JSON molto annidati funzionava perfettamente nell'ambiente di test. È stata portata in produzione. I file di produzione avevano una struttura diversa. La pipeline non falliva: girava e basta. Per dieci ore. Ogni giorno. Nessuno la stava guardando. È stato necessario fermarla manualmente e correggerla. Un timeout sul job l'avrebbe intercettata alla prima esecuzione.
Come configurare:
- Cluster interattivi: impostare l'auto-termination a 30 minuti
- SQL warehouse: impostare l'auto-stop a 10 minuti (i warehouse serverless si avviano in pochi secondi, quindi il costo di un riavvio è basso)
- Ogni job pianificato: impostare un timeout pari a 2 volte la durata media di esecuzione
Un avvertimento importante: i notebook non hanno un meccanismo di timeout nativo. Un notebook in esecuzione attiva mantiene vivo il cluster a tempo indeterminato, perché l'auto-termination non scatta mai quando il cluster non è inattivo. Una query di streaming visualizzata in un notebook basta a tenere un cluster acceso per sempre. L'unica protezione, in questo caso, è monitorare l'uptime dei cluster tramite le system tables e impostare alert per tutto ciò che gira più a lungo del previsto.
2. Usare Job Compute (non All-Purpose) per i workflow pianificati
È la riduzione di costo più facile che la maggior parte dei team non ha ancora messo in pratica.
Quando si definisce un workflow Databricks, la tentazione è agganciarlo a un cluster interattivo esistente. È già lì, è già configurato, funziona. Il problema è che il compute interattivo (All-Purpose) costa circa 0,55 $/DBU, mentre Job Compute costa 0,15 $/DBU in versione classica e 0,35 $/DBU in versione serverless. Per una pipeline di produzione eseguita più volte al giorno, quella differenza si fa sentire rapidamente.
L'approccio corretto è trattare il compute come una decisione per singolo task. Un workflow con una trasformazione Python seguita da un'aggregazione SQL può e dovrebbe usare Job Compute serverless per il primo task e un SQL warehouse per il secondo. Non si è vincolati a un unico tipo di compute per l'intero workflow. Scegliere l'opzione più economica adatta a ciascun task.
Regola pratica: se è pianificato, non dovrebbe girare su compute All-Purpose.
3. Taggare tutto prima di scalare
I tag sembrano pura manutenzione ordinaria. In realtà sono un prerequisito della gestione dei costi.
Le system tables di Databricks forniscono i dati grezzi di consumo delle DBU. Sono i tag a permettere di rispondere alla domanda che conta davvero: quale team, progetto o pipeline sta generando questo costo?
Senza tag, si finisce per annegare in nomi di cluster che cambiano nel tempo (etl_dev, etl_staging, prod_churn_v2) e in record di utilizzo impossibili da raggruppare in modo sensato. Con i tag, è possibile scomporre i costi per business unit, ambiente e workflow con una semplice query.
Tag da cui partire:
- Business unit: quale team è responsabile di questo workload
- Ambiente: produzione, staging, sviluppo
- Progetto: quale iniziativa serve
- Nome del workflow: un nome logico stabile che sopravvive alle ridenominazioni
Su AWS e Azure, i tag si propagano anche ai dati di fatturazione del cloud provider, ed è l'unico modo affidabile per riconciliare i costi DBU di Databricks con gli addebiti per le VM cloud sull'altra fattura.
Il consiglio pratico: definire la tassonomia di tagging prima di avere decine di pipeline. Applicare i tag a posteriori su un ambiente maturo è doloroso. Una manciata di tag ben scelti e applicati con coerenza fin dal primo giorno vale più di uno schema elaborato che nessuno segue.
Per il compute serverless, in particolare, c'è un passaggio aggiuntivo: dato che il serverless non ha un cluster persistente da taggare, bisogna configurare le serverless budget policies per associare i tag all'utilizzo serverless. Senza di queste, il consumo serverless finisce nelle system tables senza alcun contesto di attribuzione.
Vuole ridurre la fattura Databricks del 30%? Il nostro ebook gratuito copre auto-termination, Job Compute, budget policies e altre 17 correzioni applicabili da subito. Niente fronzoli: solo le configurazioni che fanno davvero la differenza. Scarichi la copia gratuita →
Da dove iniziare se si trova davanti a una fattura Databricks che non torna?
Se i costi Databricks sono già più alti del previsto, la diagnosi più rapida è interrogare le system tables:
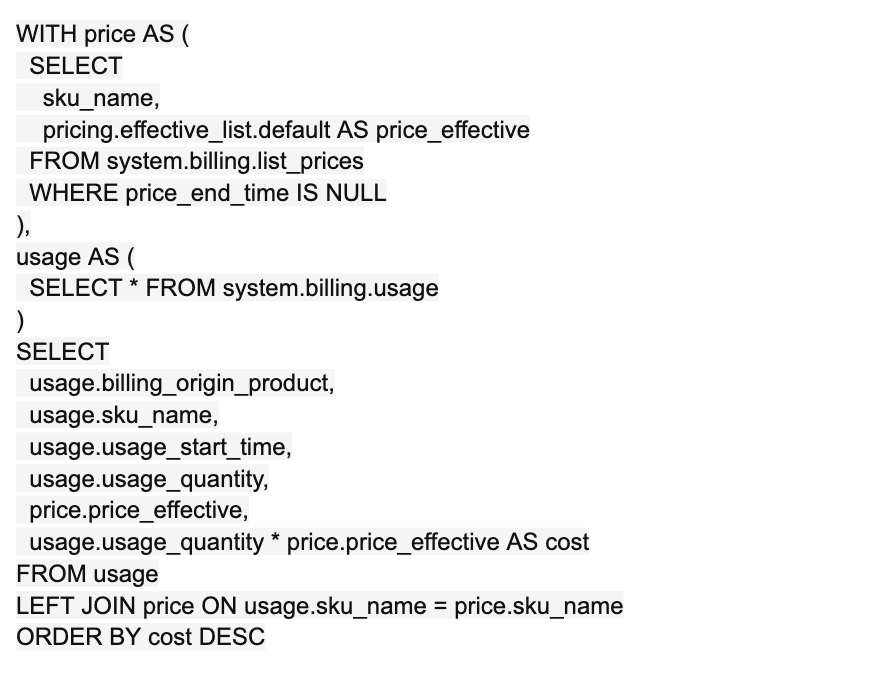
Questo fornisce una ripartizione dei costi per prodotto e SKU. Per collegarla ai workloads effettivi, si esegua una join con system.lakeflow.job_run_timeline per vedere quali job pesano di più sulla fattura.
Alcune cose da cercare in particolare:
- Qualsiasi utilizzo dello SKU Interactive Workloads che dovrebbe essere Job Compute
- Qualsiasi voce relativa ai quality monitor, specialmente su tabelle grandi
- Cluster o warehouse in esecuzione a lungo rispetto al lavoro che svolgono
Va ricordato che questa vista copre solo il lato Databricks. I costi delle VM cloud sono in un export separato del cloud provider. In un ambiente misto classico/serverless, le due viste vanno riconciliate separatamente.
Come tenere sotto controllo i costi Databricks man mano che si scala?
I tre controlli descritti sopra gestiscono le fonti di spreco più comuni. Mantenerli in piedi mentre il team e i workloads crescono richiede un livello di governance:
- Fare il deploy dei cluster come infrastructure as code invece di lasciare che gli Engineers li creino in autonomia. Quando la configurazione è in YAML e passa attraverso la CI/CD, auto-termination e tagging sono sempre impostati correttamente, perché vengono imposti nella definizione e non lasciati alla discrezione del singolo.
- Usare le cluster policies per i team che hanno davvero bisogno di creare il proprio compute. Le policy vincolano lo spazio di configurazione: possono imporre l'auto-termination, limitare la dimensione dei cluster e restringere i tipi di istanza, lasciando comunque agli Engineers una flessibilità concreta.
- Impostare alert sui costi nella console account di Databricks, o costruire alert personalizzati sopra le system tables. Misurare la deviazione standard dei costi giornalieri per workload è un segnale precoce più sensibile di una soglia fissa: intercetta la deriva prima che diventi un problema.
L'ottimizzazione dei costi in Databricks non è un progetto una tantum. La piattaforma evolve, i team aggiungono workloads, i volumi di dati crescono. I team che restano un passo avanti sui costi trattano monitoraggio e attribuzione come una pratica continua, non come un'operazione di pulizia dopo che qualcosa è andato storto.
FAQ
Perché la mia fattura Databricks è più alta del previsto? Il motivo più comune è un disallineamento del tipo di compute: pipeline di produzione eseguite su cluster interattivi All-Purpose invece che su Job Compute. Il compute All-Purpose costa fino a 3,5 volte di più per DBU rispetto a Job Compute. Il secondo motivo più comune sono i cluster inattivi senza auto-termination impostata. Interrogando system.billing.usage in join con system.billing.list_prices e ordinando per costo decrescente, il colpevole si trova di solito nelle prime cinque righe.
Qual è la differenza tra i costi DBU di Databricks e i costi dell'infrastruttura cloud? I costi DBU compaiono sulla fattura Databricks e coprono la capacità di calcolo consumata. I costi dell'infrastruttura cloud compaiono sulla fattura AWS, Azure o GCP e coprono le VM sottostanti, lo storage e l'egress di rete. Per i cluster classici si applicano entrambi. Per il serverless, l'infrastruttura è inclusa nella tariffa DBU e non c'è un addebito separato per le VM cloud. La maggior parte dei team vede solo il lato DBU fino alla prima fattura in cui il lato cloud li coglie di sorpresa.
Il compute serverless è più o meno costoso del classico in Databricks? Dipende dal workload, ma nella pratica il serverless costa di solito meno, nonostante una tariffa per DBU più alta. La tariffa maggiore è compensata dal fatto di non pagare le VM cloud né i tempi di inattività: il serverless si spegne immediatamente quando il lavoro è concluso. Il rischio con il serverless è che gli aumenti di costo sono più difficili da individuare: due esecuzioni possono avere la stessa durata effettiva ma consumare quantità di DBU molto diverse se un workload era più pesante. Va monitorato il consumo di DBU, non solo la durata di esecuzione.