
Databricks hat jahrelang daran gearbeitet, der Ort zu werden, an dem Teams Daten verarbeiten, verwalten und analysieren. Kompliziert wird es, sobald diese Daten eine Anwendung antreiben sollen.
Ein SQL Warehouse ist großartig darin, Millionen von Zeilen zu scannen. Es ist aber nicht der Ort, an dem eine Anwendung Tausende kleiner Inserts, Updates und Point Lookups ausführen sollte. Also verfallen Teams in ein vertrautes Muster: Analytics bleibt in Databricks, irgendwo anders läuft Postgres, beides wird per CDC oder Reverse ETL verbunden – und anschließend betreibt man diese zweite Datenbank samt Synchronisationsschicht so lange, wie die Anwendung existiert.
Lakebase ist der Versuch von Databricks, diese Trennung zu beseitigen. Die Idee ist überzeugend, weil Postgres damit direkt neben dem Rest der Plattform steht, Anwendungen eine operative Datenbank erhalten und Daten zwischen transaktionalen und analytischen Systemen fließen, ohne dass Teams die nötige Infrastruktur selbst bauen müssen.
Aber Lakebase ist nicht einfach "Postgres in Databricks". Die Integration bringt Kompromisse mit sich: Der Sync hat zwei unterschiedliche Richtungen und Mechanismen, und Scale-to-Zero verändert, was mit dem Session State passiert. Außerdem bedeutet Postgres-Kompatibilität nicht, dass jede Annahme aus selbst verwalteten Postgres-Umgebungen weiterhin gilt – und die Kostenstruktur entspricht nicht dem DBU-Modell, das die meisten Databricks-Teams bereits kennen.
Ein sinnvoller Ansatz zur Bewertung von Lakebase: Prüfen Sie, ob die Kompromisse zu der Anwendung passen, die Sie tatsächlich betreiben müssen.
TL;DR
- Nutzen Sie Lakebase, wenn Ihre Anwendung transaktionales Postgres braucht und Ihre Daten bereits in Databricks liegen. Die Integration erspart Ihnen die CDC-Pipeline, die Sie sonst bauen und pflegen müssten
- Nutzen Sie es nicht als universellen Ersatz für Managed Postgres. Wenn Ihre Anwendung keinerlei Abhängigkeit von Databricks-Analytics, -Governance oder -AI-Workflows hat, ist eine eigenständige Managed-Postgres-Lösung einfacher
- Prüfen Sie Extension-Support und das Verhalten des Session State, bevor Sie etwas von RDS oder Cloud SQL migrieren
Das Problem, das Lakebase beseitigen soll
Analytische und transaktionale Workloads stellen sehr unterschiedliche Anforderungen an eine Datenbank – genau dort beginnt die architektonische Trennung.
Ihr SQL Warehouse ist für Online Analytical Processing (OLAP) gebaut: große Scans, Joins, Aggregationen und Queries, die Millionen oder Milliarden von Zeilen berühren können. Ein Anwendungs-Backend lebt in der Welt des Online Transaction Processing (OLTP), in der kurze Transaktionen, vorhersehbare Nebenläufigkeit, Point Lookups und Inserts oder Updates im Millisekundenbereich zählen.
Der Versuch, das eine System wie das andere zu betreiben, geht meistens schief.
Vor Lakebase lautete die praktische Antwort: Postgres dazunehmen. Die analytische Seite bleibt auf der Databricks-Plattform, für die Anwendung läuft eine PostgreSQL-Instanz oder ein gehosteter Dienst – verbunden über Change Data Capture, Reverse ETL oder eigene Jobs.
Das funktioniert. Es beschert Ihnen aber auch ein weiteres Produktionssystem, das Sie verantworten müssen.
Nun verwalten Sie PostgreSQL-Zugangsdaten, Schemaänderungen, Failure Recovery, Netzwerkkonfiguration, Synchronisationsverzögerungen – und alles, was kaputtgeht, wenn sich das transaktionale Schema ändert, bevor die analytische Pipeline nachzieht. Die Datenbank selbst ist selten der schmerzhafte Teil. Zwei Systeme synchron zu halten dagegen schon.
Genau dieses Problem will Lakebase beseitigen.
Die Nachfrage ist eindeutig da. Laut Databricks ist die Verbreitung seit Juni 2025 mehr als doppelt so schnell gewachsen wie beim eigenen Warehousing-Produkt, und das Unternehmen berichtet von Tausenden Firmen, die produktive Workloads auf operativen Daten betreiben.
Diese Zahl ist interessant, aber kein Grund, das Produkt zu wählen. Die eigentliche Frage ist, ob eine transaktionale Datenbank innerhalb derselben Plattform genug operativen Aufwand einspart, um die neuen Einschränkungen zu rechtfertigen, die damit einhergehen.
Was ist Databricks Lakebase?
Lakebase Postgres ist ein vollständig verwalteter Postgres-Dienst in der Databricks-Plattform. Lakebase trennt Compute vollständig vom Storage, sodass sich die Compute-Schicht an die Nachfrage anpassen kann, während der Storage dauerhaft bestehen bleibt.
Diese Trennung macht Features wie Autoscaling und Scale-to-Zero erst möglich. Ist die Datenbank inaktiv, kann Compute herunterfahren, statt untätig auf Traffic zu warten. Kehrt Aktivität zurück, geht es weiter, ohne die gespeicherte Datenbank neu aufbauen zu müssen.
Für die Entwicklung sind Instant Branches und Zero-Copy Clones mindestens genauso spannend. Statt jedes Mal eine komplette Produktionsdatenbank zu kopieren, wenn jemand eine isolierte Umgebung braucht, kann ein Team einen Branch der Datenbank anlegen und mit dieser Kopie arbeiten, ohne den gesamten zugrunde liegenden Storage zu duplizieren.
Die Technologie stammt von Neon. Databricks kündigte am 14. Mai 2025 – kurz vor dem Launch von Lakebase – die Vereinbarung zur Übernahme des Serverless-Postgres-Unternehmens an.
Doch die Datenbanktechnologie ist nur die halbe Geschichte. Der Grund, Lakebase statt eines anderen Managed-Postgres-Anbieters zu evaluieren, ist die Integration drumherum.
Dieses integrierte Databricks-Design verbindet die Datenbank mit Plattformfunktionen wie Unity Catalog, Synced Tables und dem Rückweg der Änderungen in Delta-Tabellen. Wenn Ihre Anwendung bereits neben Databricks Apps, AI-Systemen, Feature-Pipelines oder analytischen Workflows lebt, kann diese Nähe erstaunlich viel Infrastrukturarbeit einsparen.
Spielen diese Integrationen für Ihre Anwendung keine Rolle, fällt das Argument deutlich schwächer aus. Dann vergleichen Sie im Wesentlichen eine Managed-Postgres-Implementierung mit einer anderen.
Lakebase erreichte am 3. Februar 2026 die General Availability auf AWS, gefolgt von Azure am 3. März 2026.
So funktioniert der bidirektionale Sync
Hier wird die Architektur interessanter.
"Bidirektionaler Sync" kann so klingen, als würde eine Replikations-Engine dieselben Tabellen kontinuierlich in beide Richtungen spiegeln. Das ist hier nicht das Modell. Lakebase hat zwei gerichtete Pfade, die zwei unterschiedliche Probleme lösen:
- Synced Tables bringen unter Governance stehende Quelltabellen nach Lakebase, wenn eine Anwendung Zugriff mit niedriger Latenz auf analytische oder unter Governance stehende Daten benötigt.
- Lakehouse Sync überträgt Änderungen aus der operativen Datenbank in verwaltete Delta-Tabellen – für Analytics, Audits und nachgelagerte Verarbeitung.
Die Richtung ist entscheidend, denn Mechanismen, Ownership-Modell und operative Einschränkungen unterscheiden sich auf beiden Seiten.
Lakehouse zu Lakebase – Synced Tables
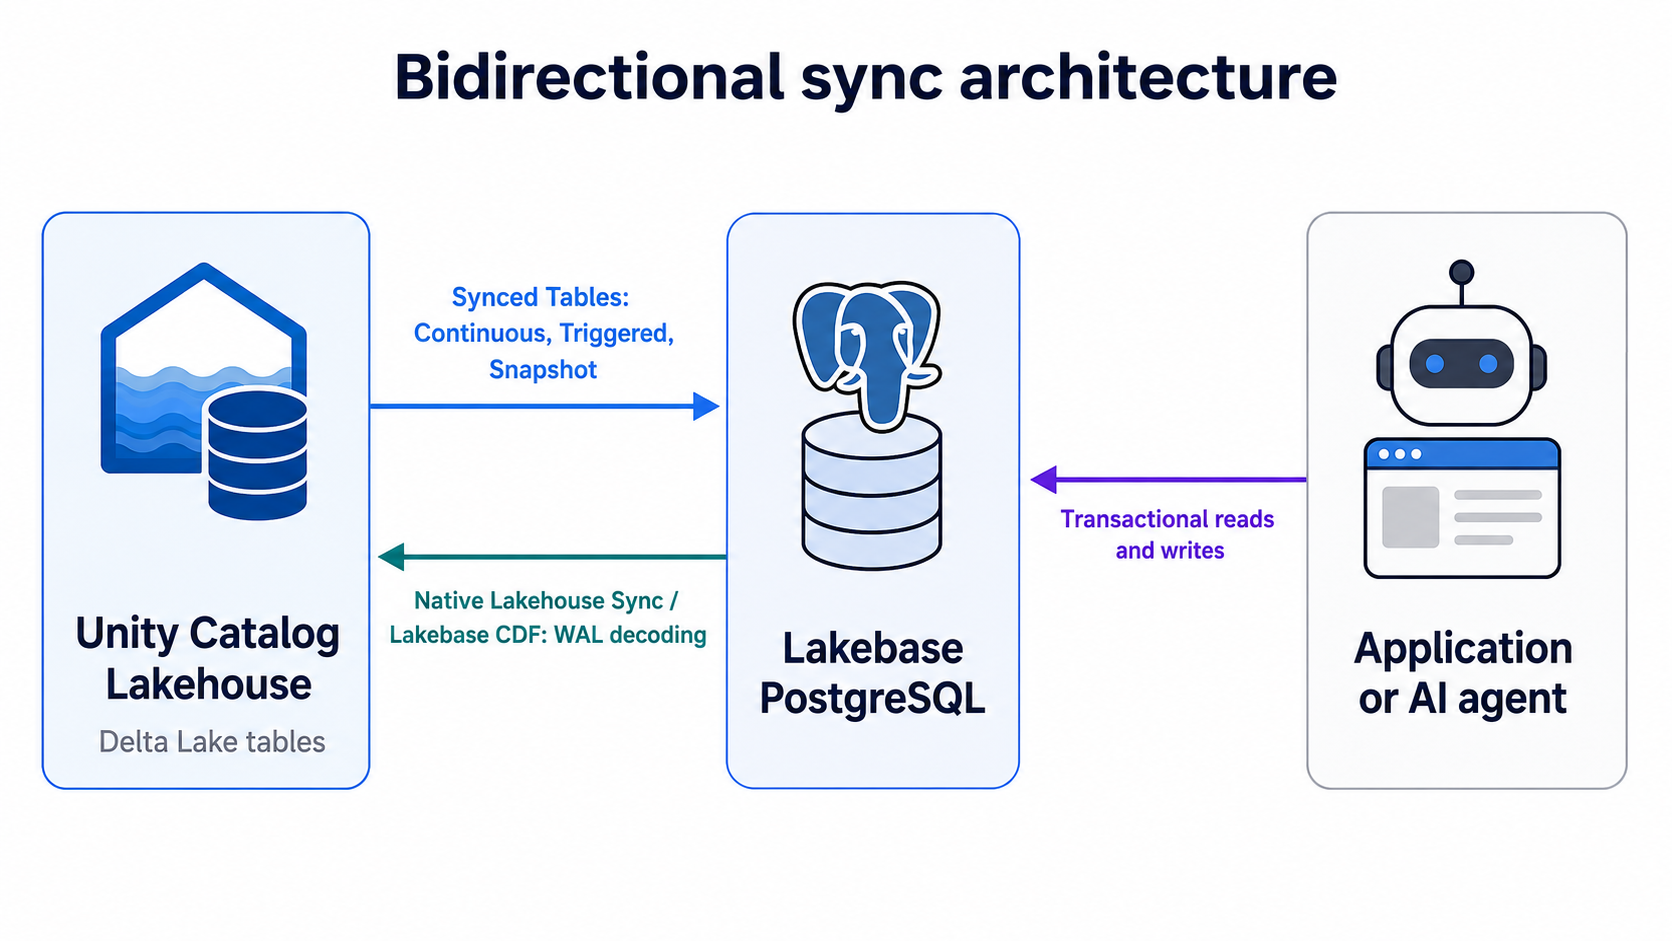
Synced Tables sind für den Fall gedacht, dass die Source of Truth bereits in unter Governance stehenden analytischen Tabellen existiert, eine Anwendung diese Informationen aber mit datenbanktypischer Latenz lesen muss.
Statt die Anwendung direkt gegen analytische Tabellen laufen zu lassen, publiziert der Sync-Prozess die relevante Quelle nach Lakebase. Anwendungen greifen dann über die PostgreSQL-Schnittstelle mit Standardtreibern auf die synchronisierte Kopie zu.
Dieses Ownership-Modell ist wichtig. Behandeln Sie eine Synced Table als etwas, das die Synchronisations-Pipeline kontrolliert – nicht als weitere anwendungseigene Tabelle, die zufällig repliziert wird. Rein lesender Zugriff für die Anwendung ist der sicherere Standard.
Es gibt drei Synchronisationsmodi:
- Snapshot erstellt eine einmalige Kopie. Das ist die naheliegende Wahl für Bulk-Publishing, Quellen ohne Delta Change Data Feed oder Fälle, in denen sich zwischen den Refreshes ein großer Teil der Tabelle ändert.
- Triggered führt inkrementelle Updates aus – bei Bedarf oder nach Zeitplan. Das passt meist besser, wenn Aktualitätsanforderungen in Minuten oder Stunden statt in Sekunden gemessen werden.
- Continuous hält Änderungen mit Latenz im Sekundenbereich im Fluss. Sie erhalten die geringste Verzögerung, halten aber auch die Synchronisationsmaschinerie dauerhaft aktiv.
Wählen Sie Continuous, wenn die Anwendung eine messbare Aktualitätsanforderung hat, die Snapshot oder Triggered nicht erfüllen können. Echtzeitsynchronisation verursacht Kosten und operativen Aufwand – der Sync-Modus sollte sich daher aus der benötigten Aktualität ergeben.
Außerdem gibt es Größenlimits, die Sie einplanen sollten.
Continuous- und Triggered-Writes liegen bei geschätzt rund 150 Zeilen pro Sekunde pro Capacity Unit, während Snapshot-Writes bis zu 2.000 Zeilen pro Sekunde pro CU erreichen können.
Betrachten Sie diese Werte als praktische Richtgrößen für die Kapazitätsplanung – der tatsächliche Durchsatz variiert je nach Tabellenstruktur, Indexierung und Änderungsmustern.
Die aggregierte logische Größe über alle Synced Tables ist auf 16 TB begrenzt. Für einzelne Tabellen gibt es kein separates hartes Limit, aber Databricks empfiehlt, Tabellen mit Refresh-Bedarf bei maximal 1 TB zu halten.
Das Refresh-Verhalten wird leicht übersehen. Während eines vollständigen Refreshs bleibt die alte synchronisierte Version verfügbar, während die neue aufgebaut wird. Beide Versionen belegen vorübergehend Storage, der auf das logische Datenbankkontingent angerechnet wird.
Wenn Sie bereits nah am Limit sind, kann ein Refresh genau das sein, was Sie über die Grenze bringt. Planen Sie die Kapazität für den Refresh, nicht nur für den Normalbetrieb.
Autoscaling vs. Provisioned: Was sich im März 2026 geändert hat
Ältere Lakebase-Materialien verwischen mitunter den Wechsel von Provisioned zu Autoscaling – für aktuelle Designs ist die Unterscheidung jedoch weitgehend historisch.
Provisioned und Autoscaling waren unterschiedliche Betriebsmodelle. Diese Unterscheidung ist inzwischen weitgehend Geschichte.
Neue Instanzen laufen seit dem 12. März 2026 standardmäßig mit Autoscaling. Bestehende Provisioned-Instanzen wurden bis Juli 2026 umgestellt, und die alte UI bleibt nur als vorübergehende Übergangsoberfläche bis zum 1. September 2026 bestehen.
Das Sizing-Modell hat sich deutlich verändert. Autoscaling nutzt Capacity Units mit 2 GB RAM pro CU. Das ältere Provisioned-Modell arbeitete mit einer Provisioned Capacity Unit mit 16 GB RAM pro Einheit.
Das ist nicht nur eine kleinere Einheit. Autoscaling kann sich innerhalb eines konfigurierten CU-Bereichs mit der Nachfrage bewegen. Provisioned bedeutete, eine feste Kapazität zu wählen und damit zu leben, bis man die Konfiguration änderte.
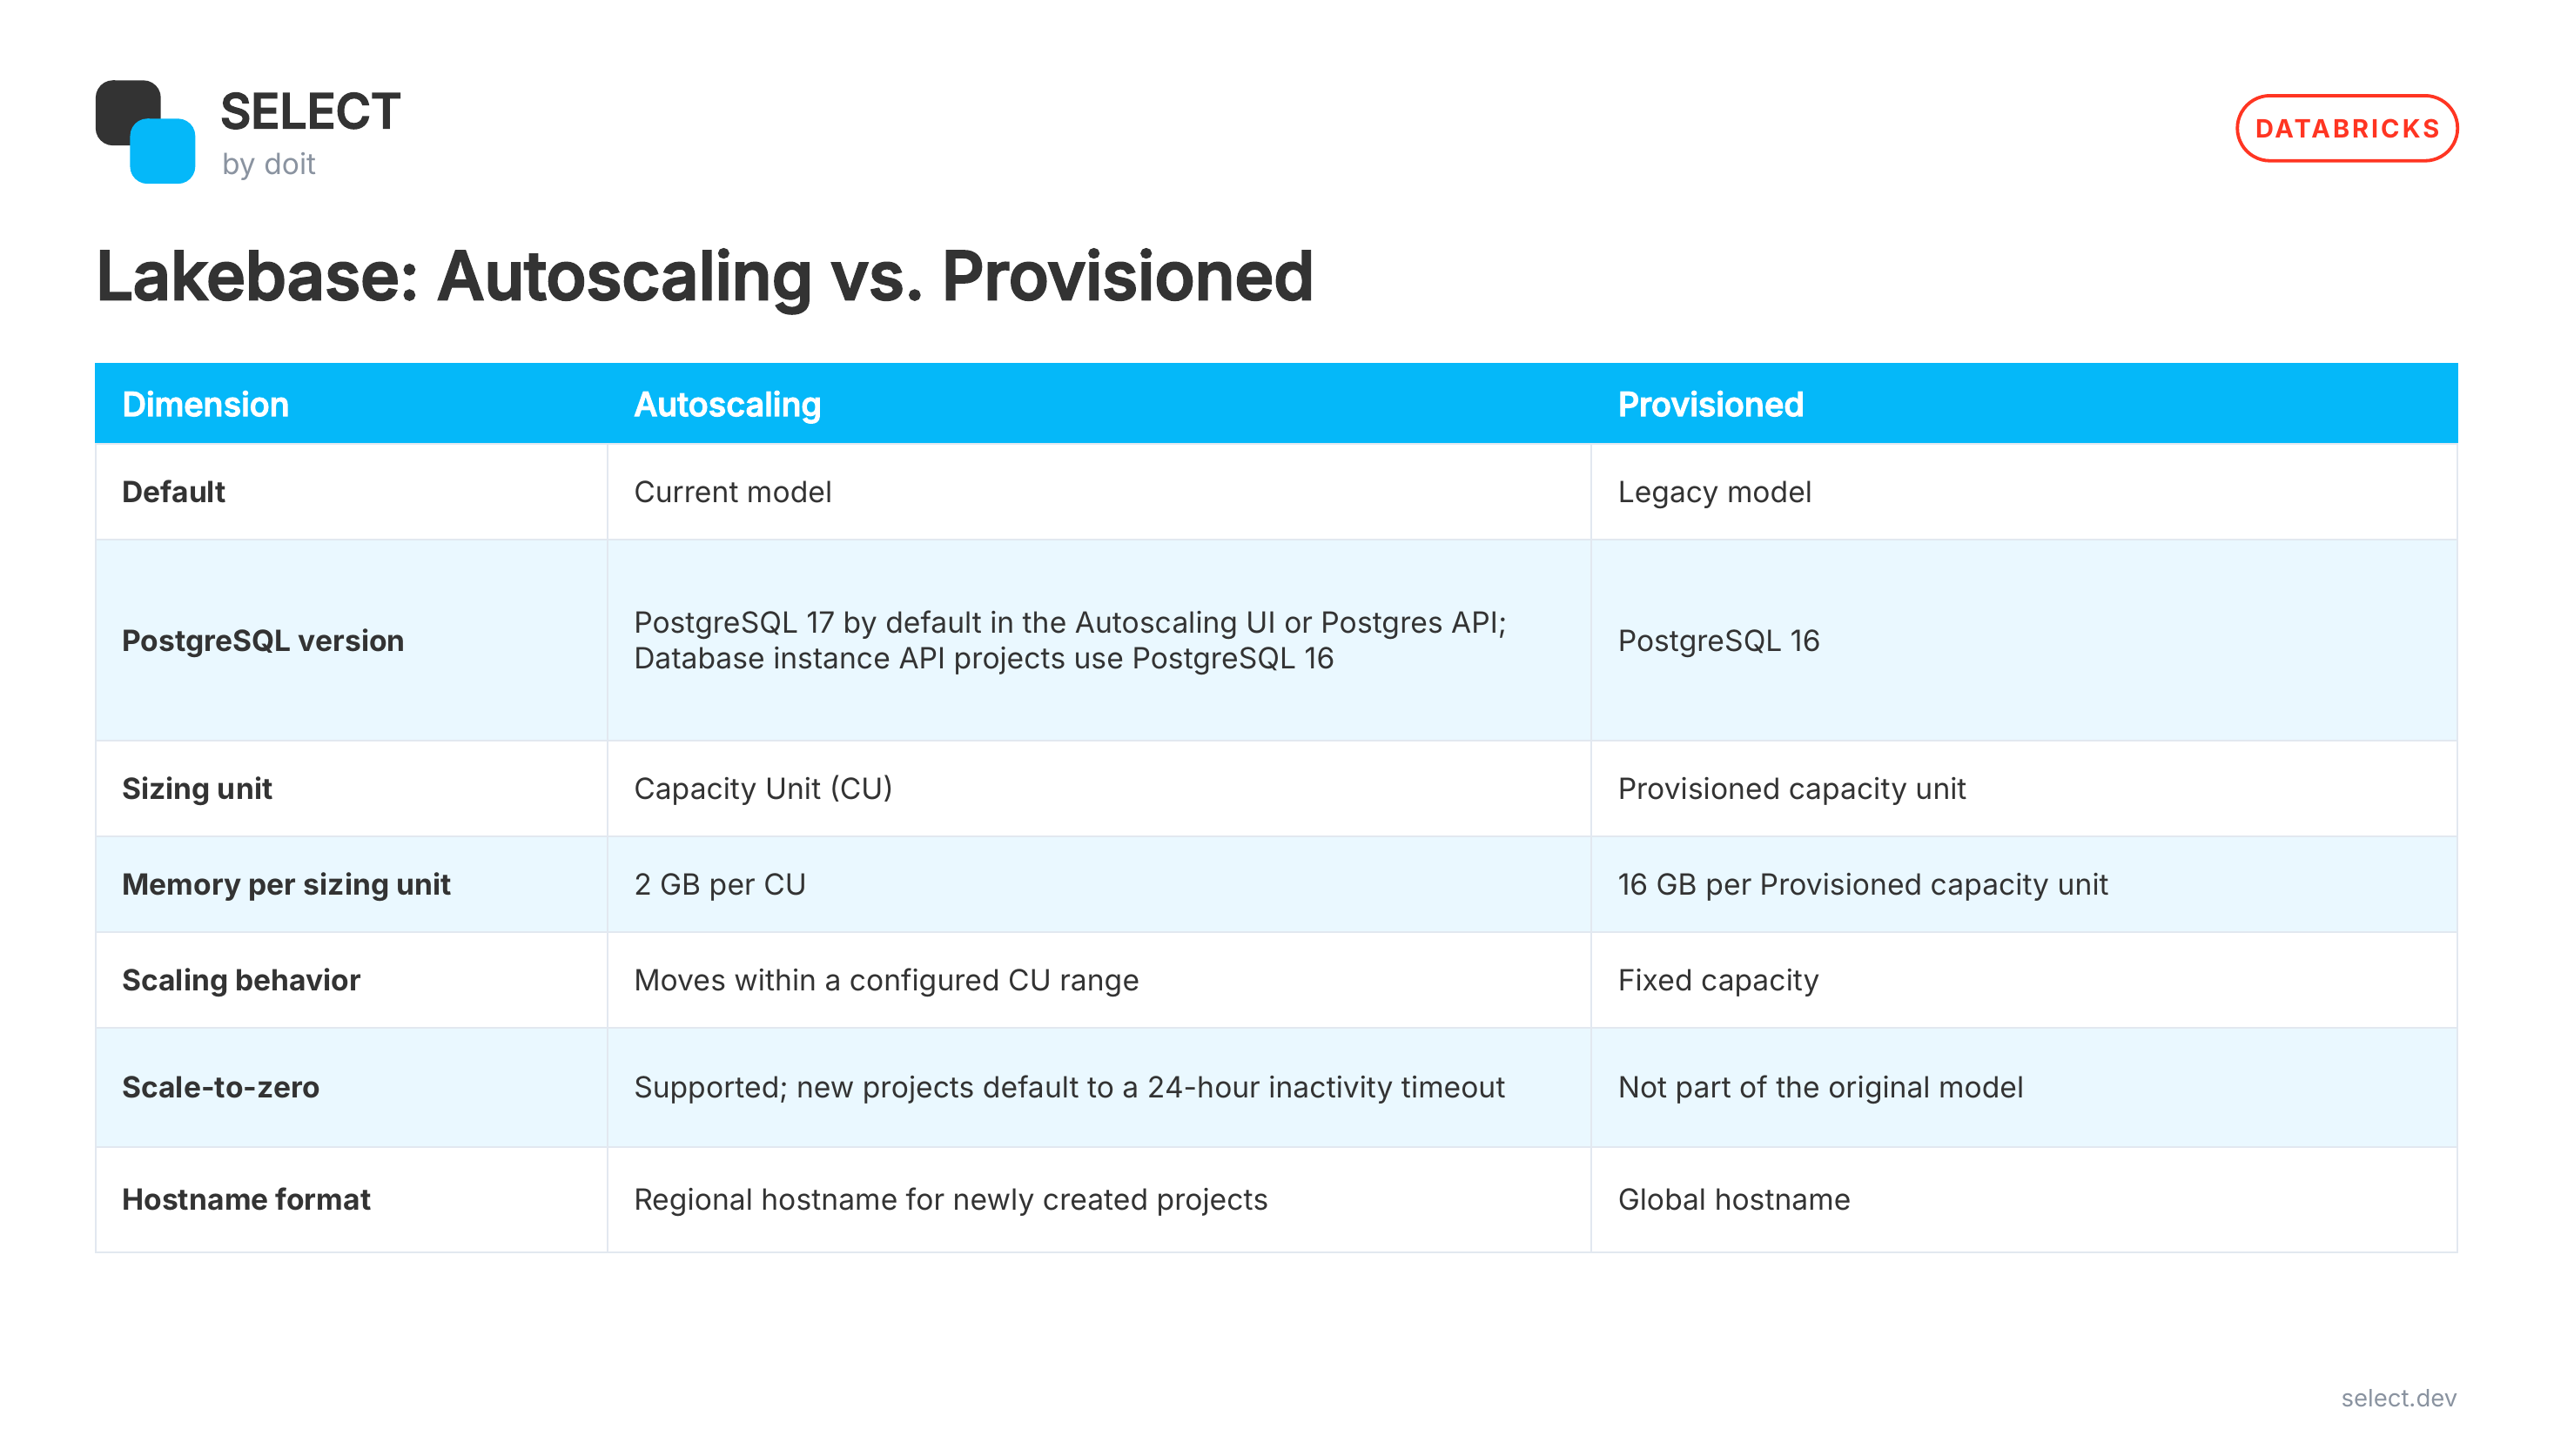
Für die meisten neuen Designs gibt es keine Entscheidung mehr zwischen Provisioned und Autoscaling. Die sinnvolle Frage ist, wie breit der CU-Bereich sein sollte und ob Scale-to-Zero für die Anwendung Sinn ergibt.
Diese beiden Entscheidungen beeinflussen sowohl Kosten als auch Verhalten. Wenn Sie das größere Betriebsmodell evaluieren, behandelt Databricks-Kostenoptimierung die übergreifenden Kostentreiber über Compute, Infrastruktur und Workload-Design hinweg.
Eine Datenbank mit unvorhersehbaren Lastspitzen profitiert von Spielraum zum Skalieren. Eine ruhige Entwicklungsumgebung profitiert von Scale-to-Zero. Eine Produktionsanwendung, die auf persistente Sessions angewiesen ist, sollte womöglich weder eine aggressive Untergrenze noch ein Inaktivitäts-Timeout haben.
Genau diesen Kompromiss sollten Sie durchrechnen.
Was Lakebase im Vergleich zu Standard-Postgres nicht bietet
PostgreSQL-Kompatibilität bedeutet nicht, dass sich jedes Postgres-Deployment gleich verhält.
Wenn Sie von RDS, Cloud SQL oder einem selbst verwalteten Cluster migrieren, testen Sie die Annahmen, die Ihre Anwendung über die Datenbank trifft – nicht nur, ob die SQL-Syntax funktioniert.
Beginnen Sie bei der Administration. Der Zugriff ist an die Account- und Workspace-Verwaltung gekoppelt, Benutzer werden über Plattform-APIs verwaltet. Gehen Sie nicht davon aus, dass Automatisierung, die die Superuser-Semantik von selbst verwaltetem PostgreSQL erwartet, unverändert weiterläuft.
Es gibt weitere Lücken, die Sie vor einer Migration prüfen sollten. Tablespaces werden nicht unterstützt. Native logische Replikation von PostgreSQL ist derzeit nicht verfügbar. Der Extension-Support ist kuratiert statt uneingeschränkt.
Keine dieser Einschränkungen macht Lakebase automatisch zur schlechten Wahl. Zum Problem werden sie, wenn Ihr bestehendes System darauf angewiesen ist.
Die größere operative Stolperfalle ist Scale-to-Zero.
Wenn Compute nach der Inaktivitätsphase herunterfährt, verschwindet auch die Verbindung. Temporäre Tabellen verschwinden. Prepared Statements verschwinden. Advisory Locks verschwinden. Der Zustand von LISTEN und NOTIFY verschwindet. Alles, was nur innerhalb dieser Datenbank-Session existierte, ist weg.
Ein sauber implementierter Connection Pool sollte sich problemlos neu verbinden. Doch viele Produktionssysteme hängen stillschweigend an Sticky Connections oder langlebigem Session State – und niemand merkt es, bis die Verbindung verschwindet.
Wenn Ihre Anwendung das tut: Beheben Sie die Abhängigkeit oder deaktivieren Sie Scale-to-Zero. Entdecken Sie es nicht erst in der Produktion.
Eine gute Migrationsregel: Validieren Sie, wie sich die Anwendung verhält – nicht nur, ob das Schema kompatibel ist.
Lakebase-Anwendungsfälle
Die stärksten Lakebase-Anwendungsfälle sind jene, bei denen die Nähe der transaktionalen Datenbank zum Rest der Plattform eine echte Systemgrenze beseitigt.
Die drei stärksten Anwendungsfälle sind Agent State, Online Feature Serving und Anwendungs-Backends.
AI Agent Memory
AI-Agenten brauchen einen Ort, um ihren Zustand zwischen den Interaktionen zu speichern.
Dazu gehören Nutzerkontext, Tool-Ausgaben, Workflow-Fortschritt, Task-Status oder anwendungsspezifische Informationen, die der Agent später wieder benötigt. Sobald dieser Zustand über Requests hinweg relevant ist, braucht er einen dauerhaften Speicher statt eines weiteren In-Memory-Objekts im Serving-Prozess.
Ein PostgreSQL-Speicher funktioniert gut, wenn die Anwendung direkten SQL-Zugriff und Kontrolle über das eigene Schema benötigt. In diesem Modell gehört der Zustand der Anwendung und bleibt nah am Rest der Databricks-Umgebung.
Es gibt weitere State-Optionen mit Governance, daher würde ich Lakebase nicht allein deshalb wählen, weil der Workload einen Agenten enthält. Wählen Sie es, wenn der Agent anwendungsgesteuerten relationalen Zustand braucht.
Online Feature Store in Lakebase
Feature Serving passt ebenfalls sauber ins Bild, weil Offline- und Online-Seite völlig unterschiedliche Zugriffsmuster verlangen.
Features werden vielleicht aus großen, unter Governance stehenden Tabellen berechnet, aber der Model-Endpoint möchte nicht jedes Mal eine Warehouse-Query ausführen, wenn er customer_risk_score oder days_since_last_purchase braucht.
Publizieren Sie stattdessen die Feature-Werte per Snapshot-, Triggered- oder Continuous-Synchronisation in einen PostgreSQL-basierten Online Store. Der Serving-Endpoint kann dann Lookups mit niedriger Latenz gegen die operative Kopie ausführen.
Die interessante Frage ist nicht, ob sich das Feature synchronisieren lässt. Sondern wie aktuell es wirklich sein muss.
Ändert sich der Wert einmal am Tag, ist Continuous Verschwendung. Hängt die Modellentscheidung von etwas ab, das sich vor 20 Sekunden geändert hat, reicht Snapshot nicht aus.
Diese Aktualitätsanforderung sollte den Sync-Modus bestimmen.
Und der Online Store macht das Design der vorgelagerten Tabellen nicht irrelevant. [Wie Ihre Delta-Tabellen aufgebaut sind, beeinflusst die Serving-Latenz, denn die Quell-Pipeline muss frische Feature-Werte weiterhin effizient erzeugen und synchronisieren.
Anwendungs-Backend
Das ist der naheliegendste Anwendungsfall.
Eine Anwendung braucht Inserts, Updates, Deletes, Indizes, kurze Reads und vorhersehbare Nebenläufigkeit. Sie kann die Datenbank für diese transaktionalen Operationen nutzen, während Analytics auf der Plattform bleibt.
Das schließt Databricks Apps ein, muss aber nicht darauf beschränkt sein.
Der interessantere Teil kommt danach. Sobald die Anwendung operative Daten erzeugt, kann der umgekehrte Sync-Pfad diese Änderungen in verwalteten Delta-Tabellen verfügbar machen. Analytics, Audit-Jobs und nachgelagerte Pipelines können sie konsumieren, ohne dass Sie eine separate externe CDC-Plattform aufbauen müssen.
Hier zahlt sich die Lakebase-Architektur wirklich aus.
Sie nutzen sie nicht, weil Postgres neu wäre. Sie nutzen sie, weil sich die operative und die analytische Seite nicht mehr wie zwei fremde Systeme anfühlen, die Sie selbst zusammenkleben müssen.
Lakebase-Kosten und was SELECT sichtbar macht
Die Lakebase-Preisgestaltung muss getrennt vom DBU-Denkmodell betrachtet werden, das die meisten Databricks-Teams bereits nutzen.
Die aktuelle Preisstruktur umfasst Always-On-Pricing für Serverless Autoscaling mit einem um 25 % niedrigeren Basistarif und ohne langfristige Bindung. Ziel ist es, die Elastizität von Serverless zu erhalten, ohne dass eine dauerhaft laufende Produktionsdatenbank dieselben Basiskonditionen zahlen muss wie ein Workload, der regelmäßig herunterskaliert.
Das ist nützlich, bedeutet aber auch, dass Ihre gesamte Databricks-Rechnung nun mehr als ein Preismodell umfasst.
Klassische Jobs können DBU-Kosten plus Cloud-Infrastruktur verursachen. Serverless bündelt Infrastruktur anders. Model Serving hat eine eigene Kostenstruktur. Operative Datenbanken fügen eine weitere Kostendimension hinzu.
Deshalb verrät ein einzelnes Preisblatt selten, was ein Workload tatsächlich kostet.
Der SELECT Databricks Cost Optimization Guide nutzt system.billing.usage und system.billing.list_prices als Ausgangspunkte, um zu verstehen, wo Ausgaben entstehen. Das funktioniert gut für DBU-basierte Workloads, aber Lakebase sollte dennoch im Kontext der restlichen Umgebung bewertet werden – nicht als isolierter Posten auf der Rechnung.
Für die Verarbeitungsseite: wie Photon die Kosten pro Job beeinflusst [LINK PENDING].
SELECT kombiniert die DBU-Nutzung mit den zugrunde liegenden Cloud-Infrastrukturkosten, damit Teams Ausgaben Jobs, Queries, Nutzern, Workspaces und anderen Dimensionen zuordnen können. Laut DoiT nutzt die Anbindung einen rein lesenden Service Principal und ist in rund 20 Minuten eingerichtet.
SELECT hilft Ihnen, Lakebase im Kontext Ihrer gesamten Plattformrechnung zu bewerten. Es zeigt, ob die zusätzliche operative Schicht die Gesamtkosten und -komplexität Ihrer Architektur senkt oder die Ausgaben lediglich in eine andere Kategorie verschiebt.
Genau dieser Vergleich lohnt sich.
Wenn Sie diesen umfassenderen Kostenblick brauchen: Teams können mit SELECT in rund 20 Minuten starten. Buchen Sie eine Demo, um zu sehen, wie sich der Rest Ihrer Databricks-Ausgaben neben der Datenbank aufschlüsselt.
Häufige Fragen zu Lakebase
Ist Databricks Lakebase nur Managed Postgres?
Nein.
Die Datenbank ist PostgreSQL, aber ihr Wert entsteht durch die umgebende Plattformintegration – darunter Serverless-Betrieb, Branching, Synced Tables und der Pfad, über den operative Änderungen in verwaltete analytische Tabellen gelangen.
Wenn diese Integrationen Infrastruktur ersetzen, die Sie sonst selbst betreiben müssten, spricht viel für Lakebase. Brauchen Sie nur eine universelle Postgres-Datenbank, vergleichen Sie sie mit anderen Managed-Postgres-Angeboten.
Worin unterscheiden sich Synced Tables und Lakehouse Sync?
Sie decken entgegengesetzte Richtungen ab.
Synced Tables publizieren unter Governance stehende Quelltabellen nach Lakebase, wenn eine Anwendung Zugriff mit niedriger Latenz darauf benötigt.
Lakehouse Sync deckt die umgekehrte Richtung ab. Databricks nennt die WAL-basierte Implementierung Change Data Feed. Sie erfasst Inserts, Updates und Deletes aus PostgreSQL und stellt diese Änderungen in verwalteten Delta-Tabellen bereit.
Denken Sie bei Synced Tables an "analytische Quelle zur Anwendung" und beim umgekehrten Pfad an "Anwendungsänderungen zurück in die Analytics".
Unterstützt Lakebase jede Postgres-Extension?
Nein.
Der Extension-Support ist kuratiert und kann je nach PostgreSQL-Version variieren. Prüfen Sie vor der Migration die aktuelle Liste unterstützter Extensions, wenn Ihr bestehendes RDS-, Cloud-SQL- oder selbst verwaltetes PostgreSQL-Deployment von einer bestimmten Extension abhängt.
Diese Prüfung gehört an den Anfang einer Migrationsbewertung, nicht an deren Ende.
Was ist aus Lakebase Provisioned geworden?
Provisioned ist das Legacy-Modell.
Die Neuanlage endete im März 2026, bestehende Instanzen wurden bis Juli 2026 auf Autoscaling umgestellt. Die Provisioned-UI bleibt während der Übergangsphase vorübergehend verfügbar.
Konzentrieren Sie sich bei neuen Designs auf die Autoscaling-Einstellungen, die das Produktionsverhalten beeinflussen: den CU-Bereich, das Inaktivitäts-Timeout, die PostgreSQL-Version und die Verbindungsdetails des aktuellen Projektmodells.
Wann sollte ich Lakebase für AI State nutzen?
Nutzen Sie Lakebase, wenn eine AI-Anwendung anwendungsgesteuerten relationalen Zustand benötigt.
Das umfasst in der Regel direkten SQL-Zugriff, ein eigenes Schema, transaktionale Writes oder dauerhaften Kontext, den auch andere Anwendungskomponenten abfragen müssen.
Braucht der Agent nur Memory, vergleichen Sie Lakebase mit höher abstrahierten Managed-Memory-Optionen. Die richtige Wahl hängt davon ab, ob die Anwendung direkte Kontrolle über das State-Modell benötigt.