
Databricks a passé des années à s'imposer comme la plateforme où les équipes traitent, gouvernent et analysent leurs données. Les choses se compliquent lorsque ces données doivent alimenter une application.
Un SQL Warehouse excelle à scanner des millions de lignes. En revanche, ce n'est pas l'endroit où faire tourner une application qui effectue des milliers de petits inserts, de mises à jour et de recherches ponctuelles. Les équipes retombent alors dans un schéma bien connu : conserver l'analytique dans Databricks, déployer Postgres ailleurs, relier les deux avec du CDC ou du reverse ETL, puis gérer cette seconde base de données et cette couche de synchronisation aussi longtemps que l'application existe.
Lakebase est la réponse de Databricks pour supprimer cette fracture. L'idée est séduisante : placer Postgres aux côtés du reste de la plateforme, offrir aux applications une base de données opérationnelle et faire circuler l'information entre systèmes transactionnels et analytiques sans obliger les équipes à construire la tuyauterie elles-mêmes.
Mais Lakebase n'est pas simplement Postgres dans Databricks. L'intégration s'accompagne de compromis : la synchronisation repose sur deux directions et deux mécanismes distincts, et le scale-to-zero change ce qu'il advient de l'état de session. De plus, la compatibilité Postgres ne signifie pas que toutes les hypothèses valables pour un Postgres autogéré restent vraies, et le modèle économique ne ressemble pas au modèle DBU que la plupart des équipes Databricks connaissent déjà.
Pour évaluer Lakebase, le plus utile est de se demander si ses compromis correspondent à l'application que vous devez réellement faire tourner.
En bref
- Utilisez Lakebase si votre application a besoin d'un Postgres transactionnel et que vos données vivent déjà dans Databricks. L'intégration élimine le pipeline CDC que vous devriez sinon construire et maintenir
- Ne l'utilisez pas comme substitut généraliste à un Postgres managé. Si votre application ne dépend ni de l'analytique, ni de la gouvernance, ni des workflows IA de Databricks, un Postgres managé autonome est plus simple
- Vérifiez la prise en charge des extensions et le comportement de l'état de session avant de migrer quoi que ce soit depuis RDS ou Cloud SQL
Le problème que Lakebase est conçu pour éliminer
Les workloads analytiques et transactionnels imposent des exigences très différentes à une base de données, et c'est là que commence la fracture architecturale.
Votre SQL Warehouse est conçu pour l'OLAP (Online Analytical Processing) : scans massifs, jointures, agrégations et requêtes qui peuvent toucher des millions, voire des milliards de lignes. Un backend applicatif évolue dans le monde de l'OLTP (Online Transaction Processing), où comptent davantage les transactions courtes, les accès concurrents prévisibles, les recherches ponctuelles et les inserts ou mises à jour en quelques millisecondes.
Vouloir qu'un système se comporte comme l'autre finit généralement mal.
Avant Lakebase, la réponse pragmatique consistait à ajouter Postgres. Garder la partie analytique sur la plateforme Databricks, exécuter une instance PostgreSQL ou un service hébergé pour l'application, puis les connecter avec du Change Data Capture, du reverse ETL ou des jobs maison.
Cela fonctionne. Mais cela vous donne aussi un système de production supplémentaire à gérer.
Vous voilà à administrer les identifiants PostgreSQL, les évolutions de schéma, la reprise après incident, le réseau, le décalage de synchronisation, et tout ce qui casse lorsque le schéma transactionnel change avant que le pipeline analytique ne rattrape son retard. La base de données elle-même est rarement la partie douloureuse. Maintenir deux systèmes alignés, si.
C'est ce problème que Lakebase cherche à éliminer.
La demande est bien réelle. Databricks indique que l'adoption depuis juin 2025 progresse plus de deux fois plus vite que celle de son produit de warehousing, et fait état de milliers d'entreprises exécutant des workloads de production sur des données opérationnelles.
Le chiffre d'adoption est intéressant, mais ce n'est pas la raison de choisir le produit. La vraie question est de savoir si garder votre base transactionnelle au sein de la même plateforme supprime suffisamment de travail opérationnel pour justifier les nouvelles contraintes qui l'accompagnent.
Qu'est-ce que Databricks Lakebase ?
Lakebase Postgres est un service Postgres entièrement managé au sein de la plateforme Databricks. Lakebase sépare totalement le calcul du stockage : la couche de calcul peut s'ajuster à la demande tandis que le stockage reste durable.
C'est cette séparation qui rend possibles des fonctionnalités comme l'autoscaling et le scale-to-zero. Quand la base est inactive, le calcul peut s'arrêter au lieu d'attendre le trafic. Quand l'activité reprend, il redémarre sans reconstruire la base stockée.
Pour le développement, les branches instantanées et les clones zero-copy sont tout aussi intéressants. Plutôt que de copier une base de production entière chaque fois que quelqu'un a besoin d'un environnement isolé, une équipe peut créer une branche de la base et travailler sur cette copie sans dupliquer tout le stockage sous-jacent.
La technologie vient de Neon. Databricks a annoncé le 14 mai 2025 un accord pour racheter ce spécialiste du Postgres serverless, peu avant le lancement de Lakebase.
Mais la technologie de base de données n'est que la moitié de l'histoire. Ce qui justifie d'évaluer Lakebase plutôt qu'un autre fournisseur de Postgres managé, c'est l'intégration qui l'entoure.
Cette conception intégrée à Databricks connecte la base à des capacités de la plateforme telles que Unity Catalog, les Synced Tables et le chemin de retour des changements vers les tables Delta. Si votre application vit déjà aux côtés de Databricks Apps, de systèmes d'IA, de pipelines de features ou de workflows analytiques, cette proximité peut éliminer une quantité surprenante de tuyauterie.
Si aucune de ces intégrations ne concerne votre application, l'argument est beaucoup moins évident. Dans ce cas, vous comparez surtout une implémentation de Postgres managé à une autre.
Lakebase a atteint la disponibilité générale sur AWS le 3 février 2026, puis sur Azure le 3 mars 2026.
Comment fonctionne la synchronisation bidirectionnelle
C'est ici que l'architecture devient plus intéressante.
Synchronisation bidirectionnelle peut laisser penser qu'un seul moteur de réplication reflète en continu les mêmes tables dans les deux sens. Ce n'est pas le modèle retenu. Lakebase comprend deux chemins directionnels qui résolvent deux problèmes différents :
- Les Synced Tables amènent des tables sources gouvernées dans Lakebase lorsqu'une application a besoin d'accéder à faible latence à des données analytiques ou gouvernées.
- Lakehouse Sync déplace les changements de la base opérationnelle vers des tables Delta managées pour l'analytique, l'audit et les traitements en aval.
La direction compte, car les mécanismes, le modèle de responsabilité et les contraintes opérationnelles diffèrent de chaque côté.
Du Lakehouse vers Lakebase : les Synced Tables
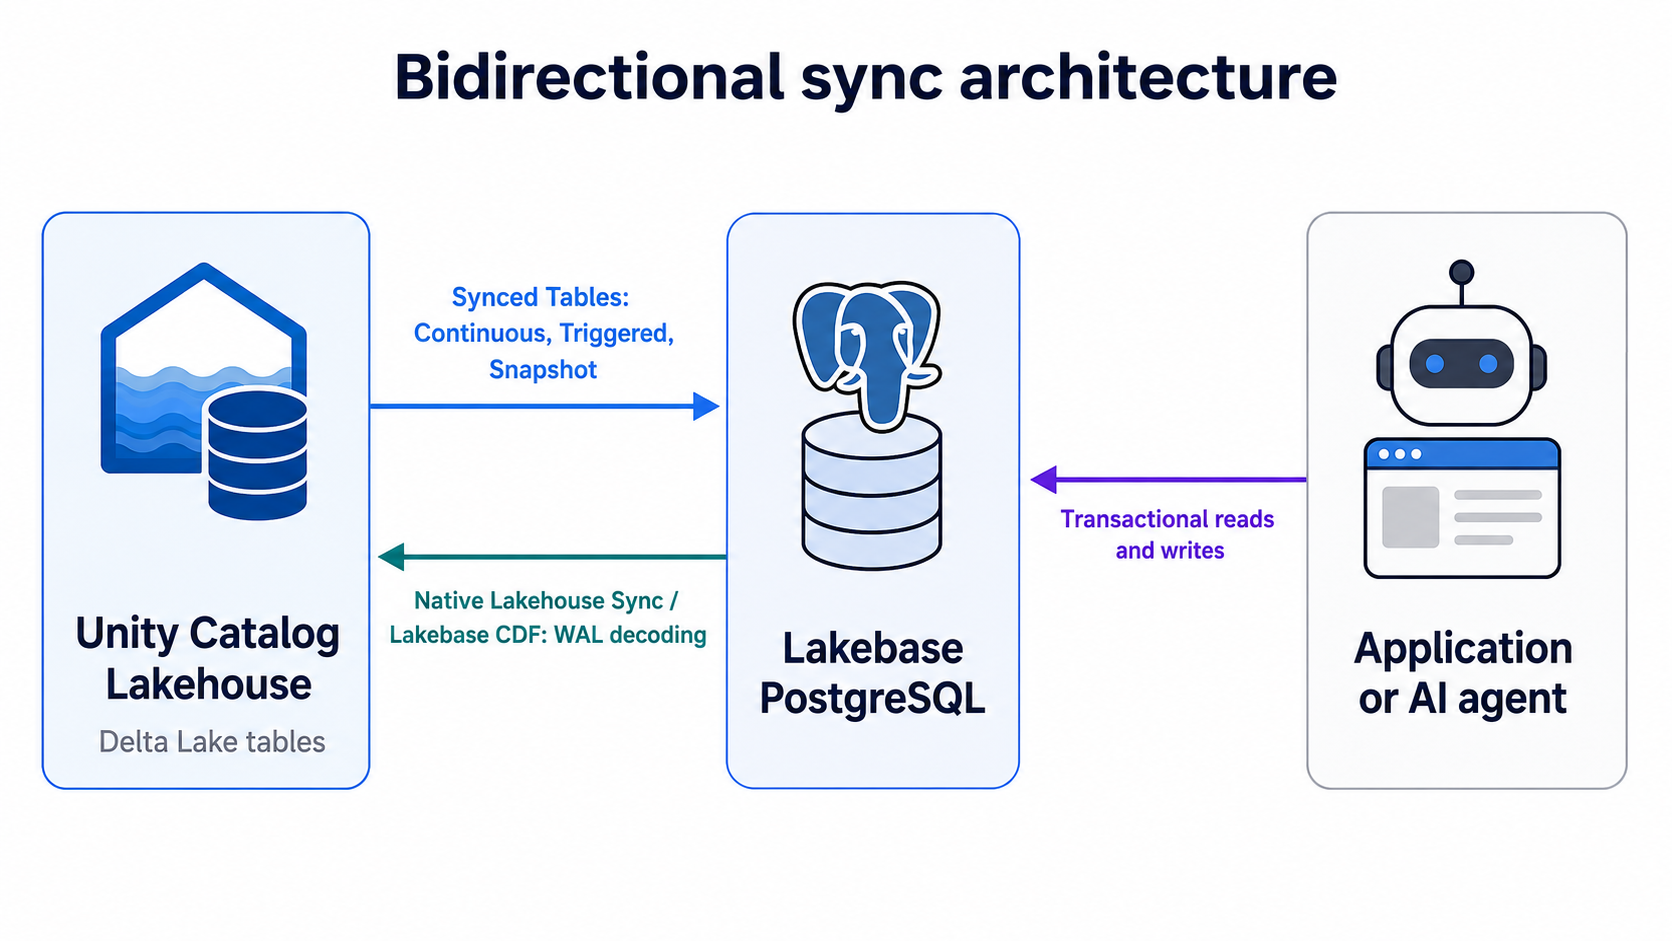
Les Synced Tables répondent au cas où la source de vérité existe déjà dans des tables analytiques gouvernées, mais où une application doit lire ces informations avec une latence digne d'une base de données.
Au lieu de faire interroger directement les tables analytiques par l'application, le processus de synchronisation publie la source concernée dans Lakebase. Les applications accèdent ensuite à la copie synchronisée via l'interface PostgreSQL, avec des drivers standards.
Ce modèle de responsabilité est important. Considérez une synced table comme un objet contrôlé par le pipeline de synchronisation, pas comme une énième table applicative que vous répliquez au passage. Un accès applicatif en lecture seule est le réglage par défaut le plus sûr.
Trois modes de synchronisation sont proposés :
- Snapshot effectue une copie unique. C'est le choix évident pour la publication en masse, les sources sans Delta Change Data Feed, ou les cas où une grande partie de la table change entre deux rafraîchissements.
- Triggered applique des mises à jour incrémentales à la demande ou selon un planning. C'est généralement le meilleur choix quand la fraîcheur se mesure en minutes ou en heures plutôt qu'en secondes.
- Continuous fait circuler les changements avec une latence de l'ordre de la seconde. Vous obtenez le décalage le plus faible, mais la machinerie de synchronisation reste active en permanence.
Choisissez Continuous lorsque l'application a une exigence de fraîcheur mesurée que Snapshot ou Triggered ne peuvent pas satisfaire. La synchronisation en temps réel a un coût et une charge opérationnelle : c'est la fraîcheur requise qui doit dicter le mode de synchronisation.
Il existe aussi des limites de dimensionnement à anticiper.
Les écritures Continuous et Triggered sont estimées à environ 150 lignes par seconde et par Capacity Unit, tandis que les écritures Snapshot peuvent atteindre 2 000 lignes par seconde et par CU.
Considérez ces chiffres comme des repères pratiques pour la planification de capacité : le débit réel variera selon la structure des tables, l'indexation et les schémas de changement.
La taille logique agrégée des synced tables est plafonnée à 16 To. Il n'existe pas de quota strict par table, mais Databricks recommande de maintenir les tables nécessitant des rafraîchissements à 1 To ou moins.
Le comportement de rafraîchissement passe facilement inaperçu. Pendant un rafraîchissement complet, l'ancienne version synchronisée reste disponible pendant que la nouvelle est construite. Les deux versions consomment temporairement du stockage sur le quota logique de la base.
Si vous êtes déjà proche de la limite, un rafraîchissement peut être ce qui vous la fait dépasser. Planifiez la capacité pour le rafraîchissement, pas seulement pour le régime de croisière.
Autoscaling ou Provisioned : ce qui a changé en mars 2026
Les contenus plus anciens sur Lakebase peuvent brouiller le passage de Provisioned à Autoscaling, mais pour les architectures actuelles, la distinction est aujourd'hui surtout historique.
Provisioned et Autoscaling étaient deux modèles d'exploitation différents. Cette distinction appartient désormais largement au passé.
Les nouvelles instances sont passées à l'Autoscaling par défaut le 12 mars 2026. Les instances Provisioned existantes ont été migrées jusqu'en juillet 2026, et l'ancienne interface ne subsiste que comme interface de transition temporaire jusqu'au 1er septembre 2026.
Le modèle de dimensionnement a profondément changé. L'Autoscaling utilise des Capacity Units, avec 2 Go de RAM par CU. L'ancien modèle Provisioned reposait sur une unité de capacité provisionnée avec 16 Go de RAM par unité.
Il ne s'agit pas seulement d'une unité plus petite. L'Autoscaling peut évoluer au sein d'une plage de CU configurée, au gré de la demande. Avec Provisioned, vous choisissiez une capacité fixe et la conserviez jusqu'au prochain changement de configuration.
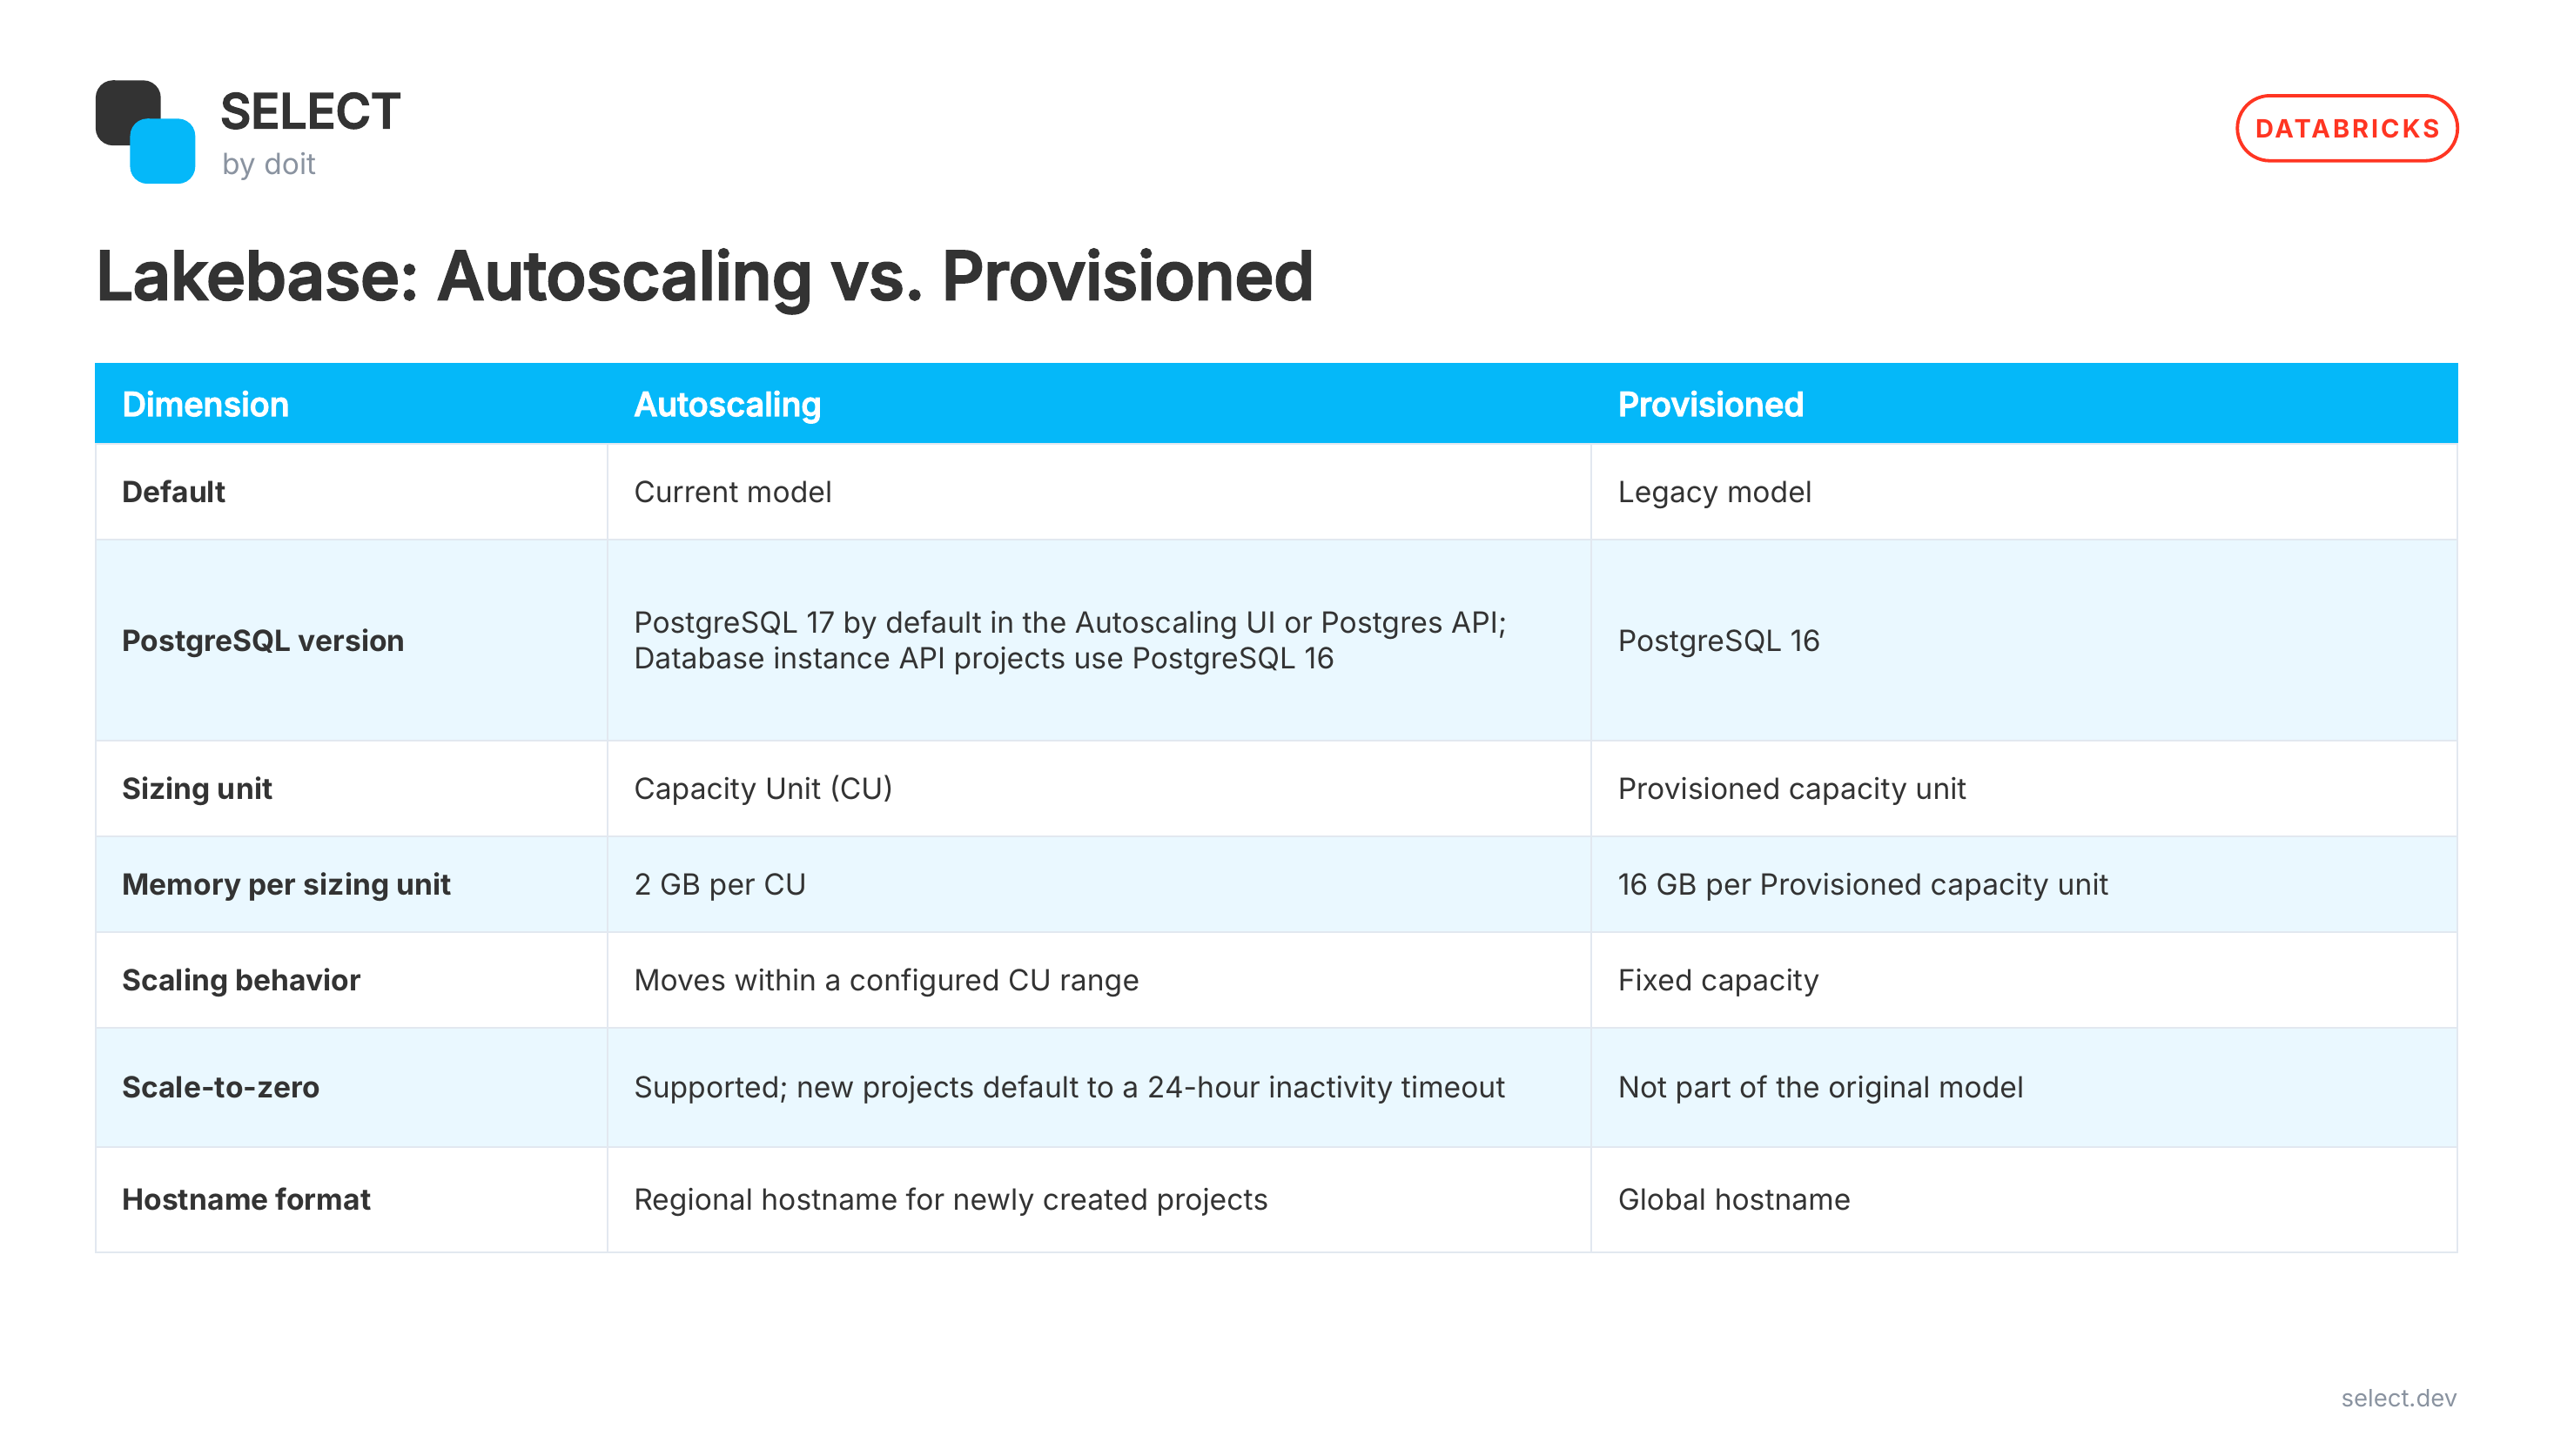
Pour la plupart des nouvelles architectures, il n'y a plus de décision à prendre entre Provisioned et Autoscaling. La question utile est de savoir quelle plage de CU définir et si le scale-to-zero a du sens pour l'application.
Ces deux choix influent à la fois sur le coût et sur le comportement. Si vous évaluez le modèle d'exploitation dans son ensemble, l'optimisation des coûts Databricks couvre les principaux facteurs de coût entre calcul, infrastructure et conception des workloads.
Une base soumise à des pics imprévisibles bénéficie d'une marge pour monter en charge. Un environnement de développement peu sollicité bénéficie du scale-to-zero. Une application de production qui dépend de sessions persistantes ne voudra sans doute ni d'une borne basse agressive ni d'un délai d'inactivité.
C'est ce compromis qu'il faut modéliser.
Ce que Lakebase ne reprend pas d'un Postgres standard
La compatibilité PostgreSQL ne signifie pas que tous les déploiements Postgres se comportent de la même façon.
Si vous migrez depuis RDS, Cloud SQL ou un cluster autogéré, testez les hypothèses que votre application fait sur la base de données, pas seulement la validité de la syntaxe SQL.
Commencez par l'administration. L'accès est lié à la gestion du compte et du workspace, les utilisateurs étant gérés via les API de la plateforme. Ne partez pas du principe que des automatisations qui attendent une sémantique superuser de PostgreSQL autogéré fonctionneront à l'identique.
D'autres écarts méritent vérification avant migration. Les tablespaces ne sont pas pris en charge. La réplication logique native de PostgreSQL n'est pas disponible pour le moment. La prise en charge des extensions est sélective plutôt qu'illimitée.
Aucune de ces limites ne disqualifie Lakebase en soi. Elles deviennent des problèmes quand votre système existant en dépend.
Le piège opérationnel le plus sérieux, c'est le scale-to-zero.
Quand le calcul s'arrête après la période d'inactivité, la connexion disparaît avec lui. Les tables temporaires disparaissent. Les prepared statements disparaissent. Les advisory locks disparaissent. L'état LISTEN et NOTIFY disparaît. Tout ce qui n'existait qu'au sein de cette session de base de données est perdu.
Un pool applicatif bien conçu devrait se reconnecter proprement. Mais nombre de systèmes de production dépendent discrètement de connexions persistantes ou d'un état de session de longue durée, sans que personne ne s'en rende compte avant que la connexion ne disparaisse.
Si c'est le cas de votre application, corrigez la dépendance ou désactivez le scale-to-zero. Ne le découvrez pas en production.
Une bonne règle de migration : validez le comportement de l'application, pas seulement la compatibilité du schéma.
Les cas d'usage de Lakebase
Les cas d'usage les plus solides de Lakebase sont ceux où rapprocher la base transactionnelle du reste de la plateforme supprime une véritable frontière entre systèmes.
Les trois plus convaincants : l'état des agents, le serving de features en ligne et les backends applicatifs.
Mémoire des agents IA
Les agents IA ont besoin d'un endroit où conserver leur état entre deux tours de conversation.
Cela peut inclure le contexte utilisateur, les sorties d'outils, l'avancement du workflow, le statut des tâches ou des informations propres à l'application dont l'agent aura besoin plus tard. Dès que cet état compte d'une requête à l'autre, il lui faut un stockage durable plutôt qu'un énième objet en mémoire dans le processus de serving.
Un stockage PostgreSQL convient bien lorsque l'application a besoin d'un accès SQL direct et du contrôle de son propre schéma. Dans ce modèle, l'application possède l'état et le garde à proximité du reste de l'environnement Databricks.
Il existe d'autres options d'état gouverné, donc je ne choisirais pas Lakebase simplement parce que le workload contient un agent. Choisissez-le quand l'agent a besoin d'un état relationnel contrôlé par l'application.
Un feature store en ligne dans Lakebase
Le serving de features est un autre cas d'école, car les volets offline et online appellent des schémas d'accès radicalement différents.
Vous calculez peut-être les features à partir de grandes tables gouvernées, mais l'endpoint du modèle ne veut pas exécuter une requête de warehouse chaque fois qu'il a besoin de customer_risk_score ou de days_since_last_purchase.
Publiez plutôt les valeurs de features dans un store en ligne adossé à PostgreSQL, via une synchronisation Snapshot, Triggered ou Continuous. L'endpoint de serving peut ensuite effectuer des lookups à faible latence sur la copie opérationnelle.
Le choix intéressant n'est pas de savoir si la feature peut être synchronisée, mais à quel point elle doit vraiment être fraîche.
Si la valeur change une fois par jour, Continuous est du gaspillage. Si la décision du modèle dépend d'un changement survenu il y a 20 secondes, Snapshot ne suffit pas.
C'est cette exigence de fraîcheur qui doit dicter le mode de synchronisation.
Et le store en ligne ne rend pas la conception des tables en amont superflue. [La façon dont vos tables Delta sont organisées influe sur la latence de serving, car le pipeline source doit toujours produire et synchroniser efficacement des valeurs de features fraîches.
Backend applicatif
C'est le cas d'usage le plus évident.
Une application a besoin d'inserts, de mises à jour, de suppressions, d'index, de lectures courtes et d'accès concurrents prévisibles. Elle peut utiliser la base pour ces opérations transactionnelles pendant que l'analytique reste sur la plateforme.
Cela inclut Databricks Apps, sans s'y limiter.
La suite est encore plus intéressante. Une fois que l'application commence à générer des données opérationnelles, le chemin de synchronisation inverse peut rendre ces changements disponibles dans des tables Delta managées. L'analytique, les jobs d'audit et les pipelines en aval peuvent les consommer sans que vous ayez à déployer une plateforme CDC externe distincte.
C'est là que l'architecture de Lakebase prouve sa valeur.
Vous ne l'utilisez pas parce que Postgres est une nouveauté. Vous l'utilisez parce que les volets opérationnel et analytique cessent de ressembler à deux systèmes sans rapport qu'il faut assembler vous-même.
Les coûts de Lakebase et ce que SELECT met en lumière
La tarification de Lakebase doit être considérée indépendamment du modèle mental DBU que la plupart des équipes Databricks utilisent déjà.
La tarification actuelle inclut une offre Always-On pour l'autoscaling serverless, avec un tarif de base inférieur de 25 % et sans engagement de longue durée. L'objectif : conserver l'élasticité du serverless sans imposer à une base de production toujours active les mêmes conditions économiques de base qu'à un workload qui redescend régulièrement en charge.
C'est utile, mais cela signifie aussi que votre facture Databricks globale couvre désormais plusieurs modèles de tarification.
Les jobs classiques peuvent cumuler frais de DBU et infrastructure cloud. Le serverless intègre l'infrastructure différemment. Le model serving a sa propre logique économique. Les bases opérationnelles ajoutent un poste de coûts supplémentaire.
Voilà pourquoi une simple grille tarifaire révèle rarement ce que coûte réellement un workload.
Le guide d'optimisation des coûts Databricks de SELECT s'appuie sur system.billing.usage et system.billing.list_prices comme points de départ pour comprendre l'origine des dépenses. Cela fonctionne bien pour les workloads facturés en DBU, mais Lakebase doit être évalué dans le contexte du reste de l'environnement plutôt que comme une ligne de facturation isolée.
Côté traitement, comment Photon influe sur le coût par job [LINK PENDING].
SELECT combine la consommation de DBU avec les coûts d'infrastructure cloud sous-jacents afin que les équipes puissent attribuer les dépenses aux jobs, requêtes, utilisateurs, workspaces et autres dimensions. DoiT indique que la connexion repose sur un service principal en lecture seule et se configure en 20 minutes environ.
SELECT vous aide à évaluer Lakebase aux côtés du reste de votre facture plateforme. L'outil montre si l'ajout de la couche opérationnelle réduit le coût et la complexité de l'architecture dans son ensemble, ou s'il déplace simplement les dépenses vers une autre catégorie.
C'est cette comparaison qui mérite d'être faite.
Si vous avez besoin de cette vision élargie des coûts, vous pouvez démarrer avec SELECT en 20 minutes environ. Réservez une démo pour voir comment se décompose le reste de vos dépenses Databricks aux côtés de la base de données.
Questions fréquentes sur Lakebase
Databricks Lakebase est-il simplement un Postgres managé ?
Non.
La base est bien PostgreSQL, mais sa valeur vient de l'intégration à la plateforme qui l'entoure : fonctionnement serverless, branching, Synced Tables et chemin de transfert des changements opérationnels vers des tables analytiques managées.
Si ces intégrations remplacent une infrastructure que vous devriez sinon exploiter vous-même, Lakebase a de solides arguments. Si vous avez seulement besoin d'une base Postgres généraliste, comparez-la aux autres offres de Postgres managé.
Quelle est la différence entre Synced Tables et Lakehouse Sync ?
Ils couvrent deux directions opposées.
Les Synced Tables publient des tables sources gouvernées dans Lakebase lorsqu'une application a besoin d'y accéder à faible latence.
Lakehouse Sync couvre la direction inverse. Databricks appelle Change Data Feed l'implémentation basée sur le WAL, qui capture les inserts, mises à jour et suppressions dans PostgreSQL et rend ces changements disponibles dans des tables Delta managées.
Retenez de la source analytique vers l'application pour les Synced Tables, et des changements applicatifs vers l'analytique pour le chemin inverse.
Lakebase prend-il en charge toutes les extensions Postgres ?
Non.
La prise en charge des extensions est sélective et peut varier selon la version de PostgreSQL. Consultez la liste des extensions prises en charge avant toute migration si votre déploiement RDS, Cloud SQL ou PostgreSQL autogéré dépend d'une extension particulière.
Cette vérification a sa place au début d'une évaluation de migration, pas à la fin.
Qu'est devenu Lakebase Provisioned ?
Provisioned est le modèle historique.
La création de nouvelles instances a pris fin en mars 2026, et les instances existantes ont migré vers l'Autoscaling jusqu'en juillet 2026. L'interface Provisioned reste temporairement disponible pendant la transition.
Pour les nouvelles architectures, concentrez-vous sur les réglages Autoscaling qui influent sur le comportement en production : plage de CU, délai d'inactivité, version de PostgreSQL et détails de connexion du modèle de projet actuel.
Quand utiliser Lakebase pour l'état des applications IA ?
Utilisez Lakebase lorsqu'une application IA a besoin d'un état relationnel contrôlé par l'application.
Cela inclut généralement un accès SQL direct, un schéma personnalisé, des écritures transactionnelles ou un contexte durable que d'autres composants de l'application doivent aussi interroger.
Si l'agent a seulement besoin de mémoire, comparez Lakebase aux options de mémoire managée de plus haut niveau. Le bon choix dépend du besoin de contrôle direct de l'application sur le modèle d'état.