
Databricksは長年にわたり、チームがデータを処理・管理・分析する場としての地位を築いてきました。厄介なのは、そのデータでアプリケーションを動かす必要が出てきたときです。
SQL Warehouseは数百万行のスキャンには優れています。しかし、アプリケーションが何千もの小さなINSERT、UPDATE、ポイントルックアップを実行する場所としては適していません。そのため多くのチームは、分析はDatabricksに残し、別の場所でPostgresを立ち上げ、CDCやリバースETLで両者をつなぎ、アプリケーションが存在する限りその2つ目のデータベースと同期レイヤーを管理し続けるという、おなじみのパターンに陥ります。
Lakebaseは、この分断を解消しようとするDatabricksの試みです。Postgresをプラットフォームの他の部分と並べて配置し、アプリケーションに運用データベースを提供し、データ連携の仕組みを自前で構築することなくトランザクション系と分析系の間で情報を移動できるという点で、この構想には説得力があります。
しかし、Lakebaseは単なる「Databricks内のPostgres」ではありません。同期には2つの異なる方向と仕組みがあり、スケールトゥゼロはセッション状態の扱いを変えるなど、統合にはトレードオフが伴います。また、Postgres互換であっても、セルフマネージドPostgresの前提がすべてそのまま通用するわけではなく、コスト構造も多くのDatabricksチームが慣れ親しんだDBUモデルとは異なります。
Lakebaseを評価する際は、そのトレードオフが実際に運用したいアプリケーションに合うかどうかに注目するのが有効です。
要点まとめ
- アプリケーションがトランザクショナルなPostgresを必要とし、データがすでにDatabricksにあるならLakebaseを使いましょう。この統合により、本来構築・保守が必要だったCDCパイプラインが不要になります
- 汎用のマネージドPostgresの代替としては使わないでください。アプリケーションがDatabricksの分析、ガバナンス、AIワークフローに依存していないなら、スタンドアロンのマネージドPostgresのほうがシンプルです
- RDSやCloud SQLから移行する前に、拡張機能のサポートとセッション状態の挙動を確認してください
Lakebaseが解消しようとしている課題
分析系ワークロードとトランザクション系ワークロードがデータベースに求めるものは大きく異なります。アーキテクチャの分断はここから始まります。
SQL Warehouseはオンライン分析処理(OLAP)向けに設計されており、大規模なスキャン、結合、集計、そして数百万〜数十億行に及ぶクエリを処理します。一方、アプリケーションのバックエンドはオンライントランザクション処理(OLTP)の世界で動いており、短いトランザクション、予測可能な同時実行性、ポイントルックアップ、ミリ秒単位のINSERTやUPDATEが重要になります。
一方のシステムをもう一方のように振る舞わせようとすると、たいてい悪い結果に終わります。
Lakebase登場以前の現実的な答えは、Postgresを追加することでした。分析側はDatabricksプラットフォームに残し、アプリケーション用にPostgreSQLインスタンスやホスティングサービスを運用し、Change Data Capture、リバースETL、カスタムジョブで両者を接続する、というものです。
これは機能します。ただし、運用責任を負う本番システムがもう1つ増えます。
PostgreSQLの認証情報、スキーマ変更、障害復旧、ネットワーク、同期の遅延、そしてトランザクション側のスキーマが分析パイプラインより先に変わったときに壊れるあれこれを管理することになります。データベースそのものが悩みの種になることはまれです。大変なのは、2つのシステムの整合性を保ち続けることです。
それこそがLakebaseが取り除こうとしている課題です。
需要があることは明らかです。Databricksによれば、2025年6月以降の導入は同社のウェアハウジング製品の2倍以上のペースで拡大しており、数千社が運用レコードを扱う本番ワークロードを稼働させていると報告されています。
導入数は興味深いものの、それ自体が製品を選ぶ理由にはなりません。本当に問うべきは、トランザクショナルデータベースを同じプラットフォーム内に置くことで、新たに生じる制約を正当化できるだけの運用作業を削減できるかどうかです。
Databricks Lakebaseとは?
Lakebase Postgresは、Databricksプラットフォーム上のフルマネージドPostgresサービスです。Lakebaseはコンピュートとストレージを完全に分離しているため、ストレージの耐久性を保ちながら、コンピュートレイヤーを需要に応じて調整できます。
この分離こそが、オートスケーリングやスケールトゥゼロといった機能を可能にしています。データベースがアイドル状態のとき、コンピュートはトラフィックを待ち続ける代わりにシャットダウンできます。アクティビティが戻れば、保存されたデータベースを再構築することなく復帰できます。
開発面では、インスタントブランチとゼロコピークローンも同じくらい注目に値します。隔離された環境が必要になるたびに本番データベース全体をコピーする代わりに、データベースをブランチして、基盤ストレージを複製することなくそのコピーに対して作業できます。
この技術はNeonに由来します。Databricksは、Lakebaseのローンチ直前にあたる2025年5月14日に、このサーバーレスPostgres企業を買収する契約を発表しました。
しかし、データベース技術は話の半分にすぎません。他のマネージドPostgresプロバイダーではなくLakebaseを評価する理由は、その周囲の統合にあります。
Databricksに統合されたこの設計により、データベースはUnity Catalog、Synced Tables、Deltaテーブルへの逆方向の変更パスといったプラットフォーム機能と連携します。アプリケーションがすでにDatabricks Apps、AIシステム、特徴量パイプライン、分析ワークフローの隣にあるなら、この近さによって驚くほど多くの連携作業を省けます。
これらの統合がアプリケーションにとって意味を持たないのであれば、採用する根拠はずっと弱くなります。その場合は、あるマネージドPostgres実装と別の実装を比較しているにすぎないからです。
Lakebaseは2026年2月3日にAWSで一般提供となり、2026年3月3日にAzureが続きました。
双方向同期の仕組み
ここからアーキテクチャの話が面白くなります。
「双方向同期」と聞くと、1つのレプリケーションエンジンが同じテーブルを両方向に継続的にミラーリングしているように思えるかもしれません。ここでのモデルはそうではありません。Lakebaseには、異なる2つの課題を解決する、方向の異なる2つのパスがあります。
- Synced Tablesは、アプリケーションが分析系またはガバナンス対象のレコードに低レイテンシでアクセスする必要がある場合に、ガバナンスされたソーステーブルをLakebaseに取り込みます。
- Lakehouse Syncは、運用データベースの変更をマネージドDeltaテーブルに移動し、分析、監査、下流処理に利用できるようにします。
方向が重要なのは、それぞれの側で仕組み、所有モデル、運用上の制約が異なるからです。
LakehouseからLakebaseへ - Synced Tables
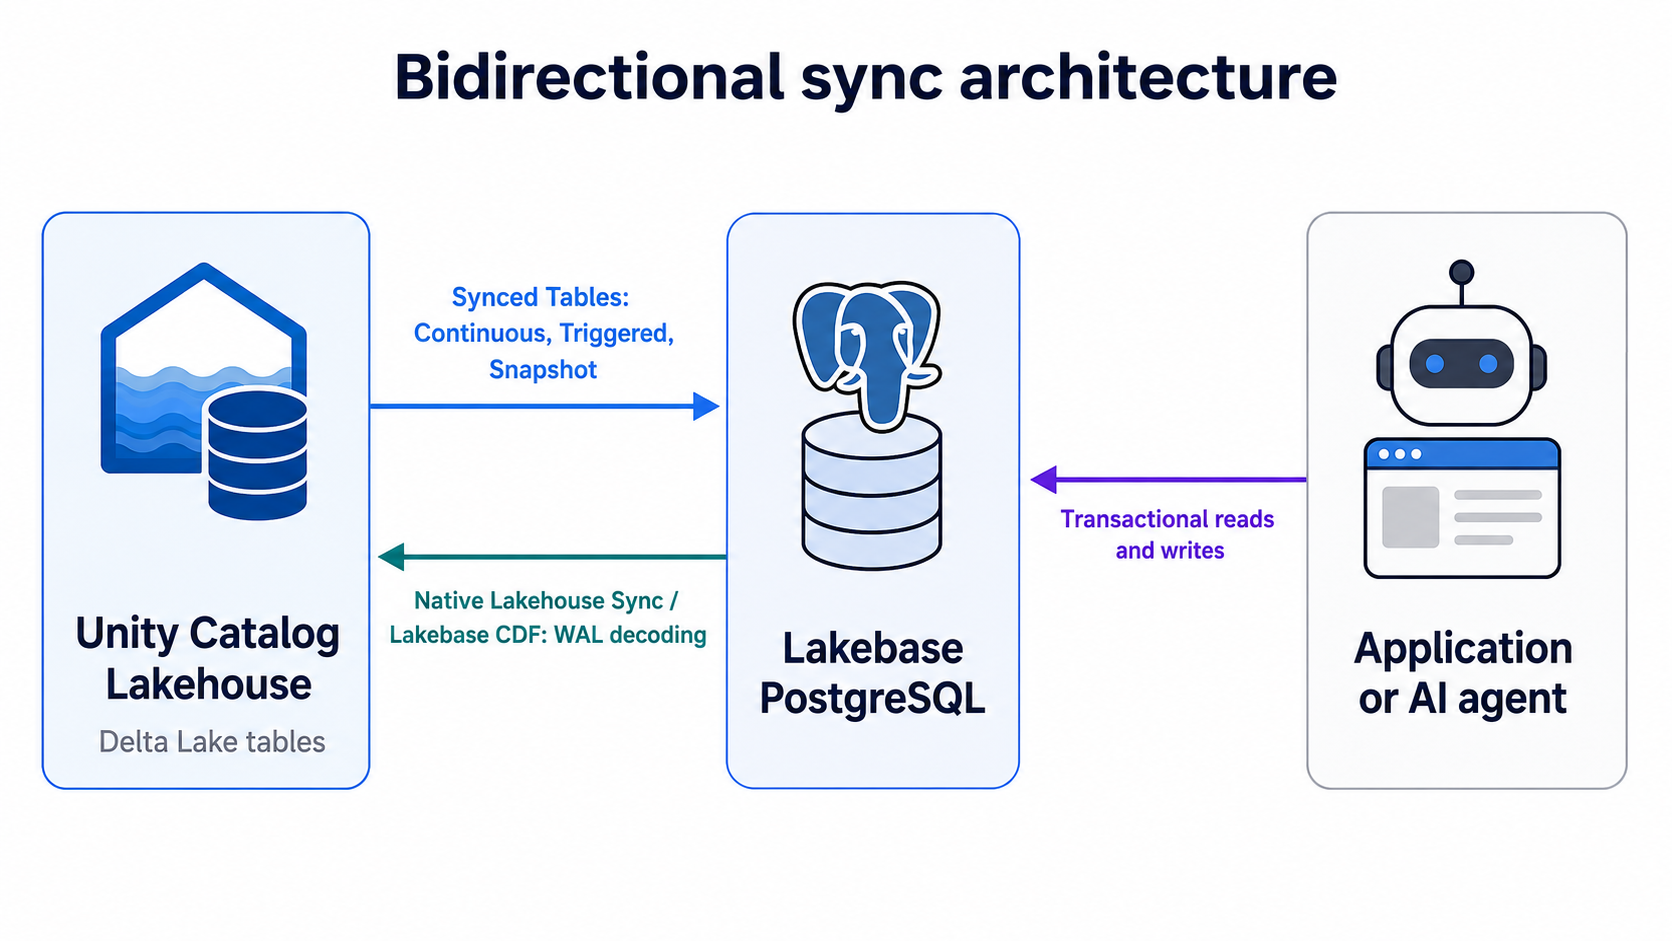
Synced Tablesは、信頼できる情報源がすでにガバナンスされた分析テーブルに存在するものの、アプリケーションがその情報をデータベース並みのレイテンシで読み取る必要がある場合のためのものです。
アプリケーションに分析テーブルを直接クエリさせるのではなく、同期プロセスが該当ソースをLakebaseに公開します。アプリケーションは標準ドライバーを使い、PostgreSQLインターフェース経由で同期されたコピーにアクセスします。
この所有モデルは重要です。同期されたテーブルは、たまたまレプリケーションしているアプリケーション所有のテーブルではなく、同期パイプラインが管理するものとして扱ってください。アプリケーションからは読み取り専用でアクセスするのが安全なデフォルトです。
同期モードは3つあります。
- Snapshotは一度きりのコピーを作成します。一括公開、Delta Change Data Feedのないソース、リフレッシュ間でテーブルの大部分が変化するケースに向いた、素直な選択肢です。
- Triggeredは、実行時またはスケジュールに従って増分更新を行います。鮮度要件が秒単位ではなく分単位・時間単位の場合は、たいていこちらが適しています。
- Continuousは、秒単位のレイテンシで変更を流し続けます。遅延は最小になりますが、同期の仕組みを常時稼働させ続けることにもなります。
Continuousを選ぶのは、SnapshotやTriggeredでは満たせない、明確に数値化された鮮度要件がアプリケーションにある場合です。リアルタイム同期にはコストと運用負荷の両方が伴うため、必要な鮮度が同期モードを決めるべきです。
サイジングの上限も計画に織り込んでおく価値があります。
ContinuousおよびTriggeredの書き込みはCapacity Unitあたり毎秒およそ150行、Snapshotの書き込みはCUあたり毎秒最大2,000行と見積もられています。
実際のスループットはテーブルの形状、インデックス、変更パターンによって変動するため、これらの数値は実務的なキャパシティプランニングの目安として扱ってください。
同期テーブル全体の論理サイズの合計は16 TBが上限です。個々のテーブルに対する個別のハードクォータはありませんが、Databricksはリフレッシュが必要なテーブルを1 TB以下に保つことを推奨しています。
リフレッシュの挙動は見落としがちです。フルリフレッシュ中は、新しいバージョンの構築が完了するまで、古い同期済みバージョンが利用可能なまま残ります。この間、両バージョンが一時的に、論理データベースのクォータに対してストレージを消費します。
すでに上限に近い場合、リフレッシュが上限超過の引き金になり得ます。定常状態だけでなく、リフレッシュも見込んでキャパシティを計画してください。
AutoscalingとProvisioned:2026年3月に何が変わったか
Lakebaseの古い資料ではProvisionedからAutoscalingへの移行が分かりにくいことがありますが、現在の設計においてこの区別はほぼ過去のものです。
ProvisionedとAutoscalingは異なる運用モデルでした。その区別は現在、ほぼ歴史的なものになっています。
新規インスタンスは2026年3月12日からデフォルトでAutoscalingに移行しました。既存のProvisionedインスタンスは2026年7月までにアップグレードされ、旧UIは2026年9月1日までの一時的な移行用画面としてのみ残ります。
サイジングモデルは大きく変わりました。AutoscalingはCapacity Unitを使用し、1 CUあたり2 GBのRAMです。旧Provisionedモデルは、1ユニットあたり16 GBのRAMを持つProvisioned capacity unitを使用していました。
これは単にユニットサイズが小さくなっただけではありません。Autoscalingは需要の変化に応じて、設定されたCU範囲内で変動できます。Provisionedでは固定容量を選び、設定を変更するまでそれで運用する必要がありました。
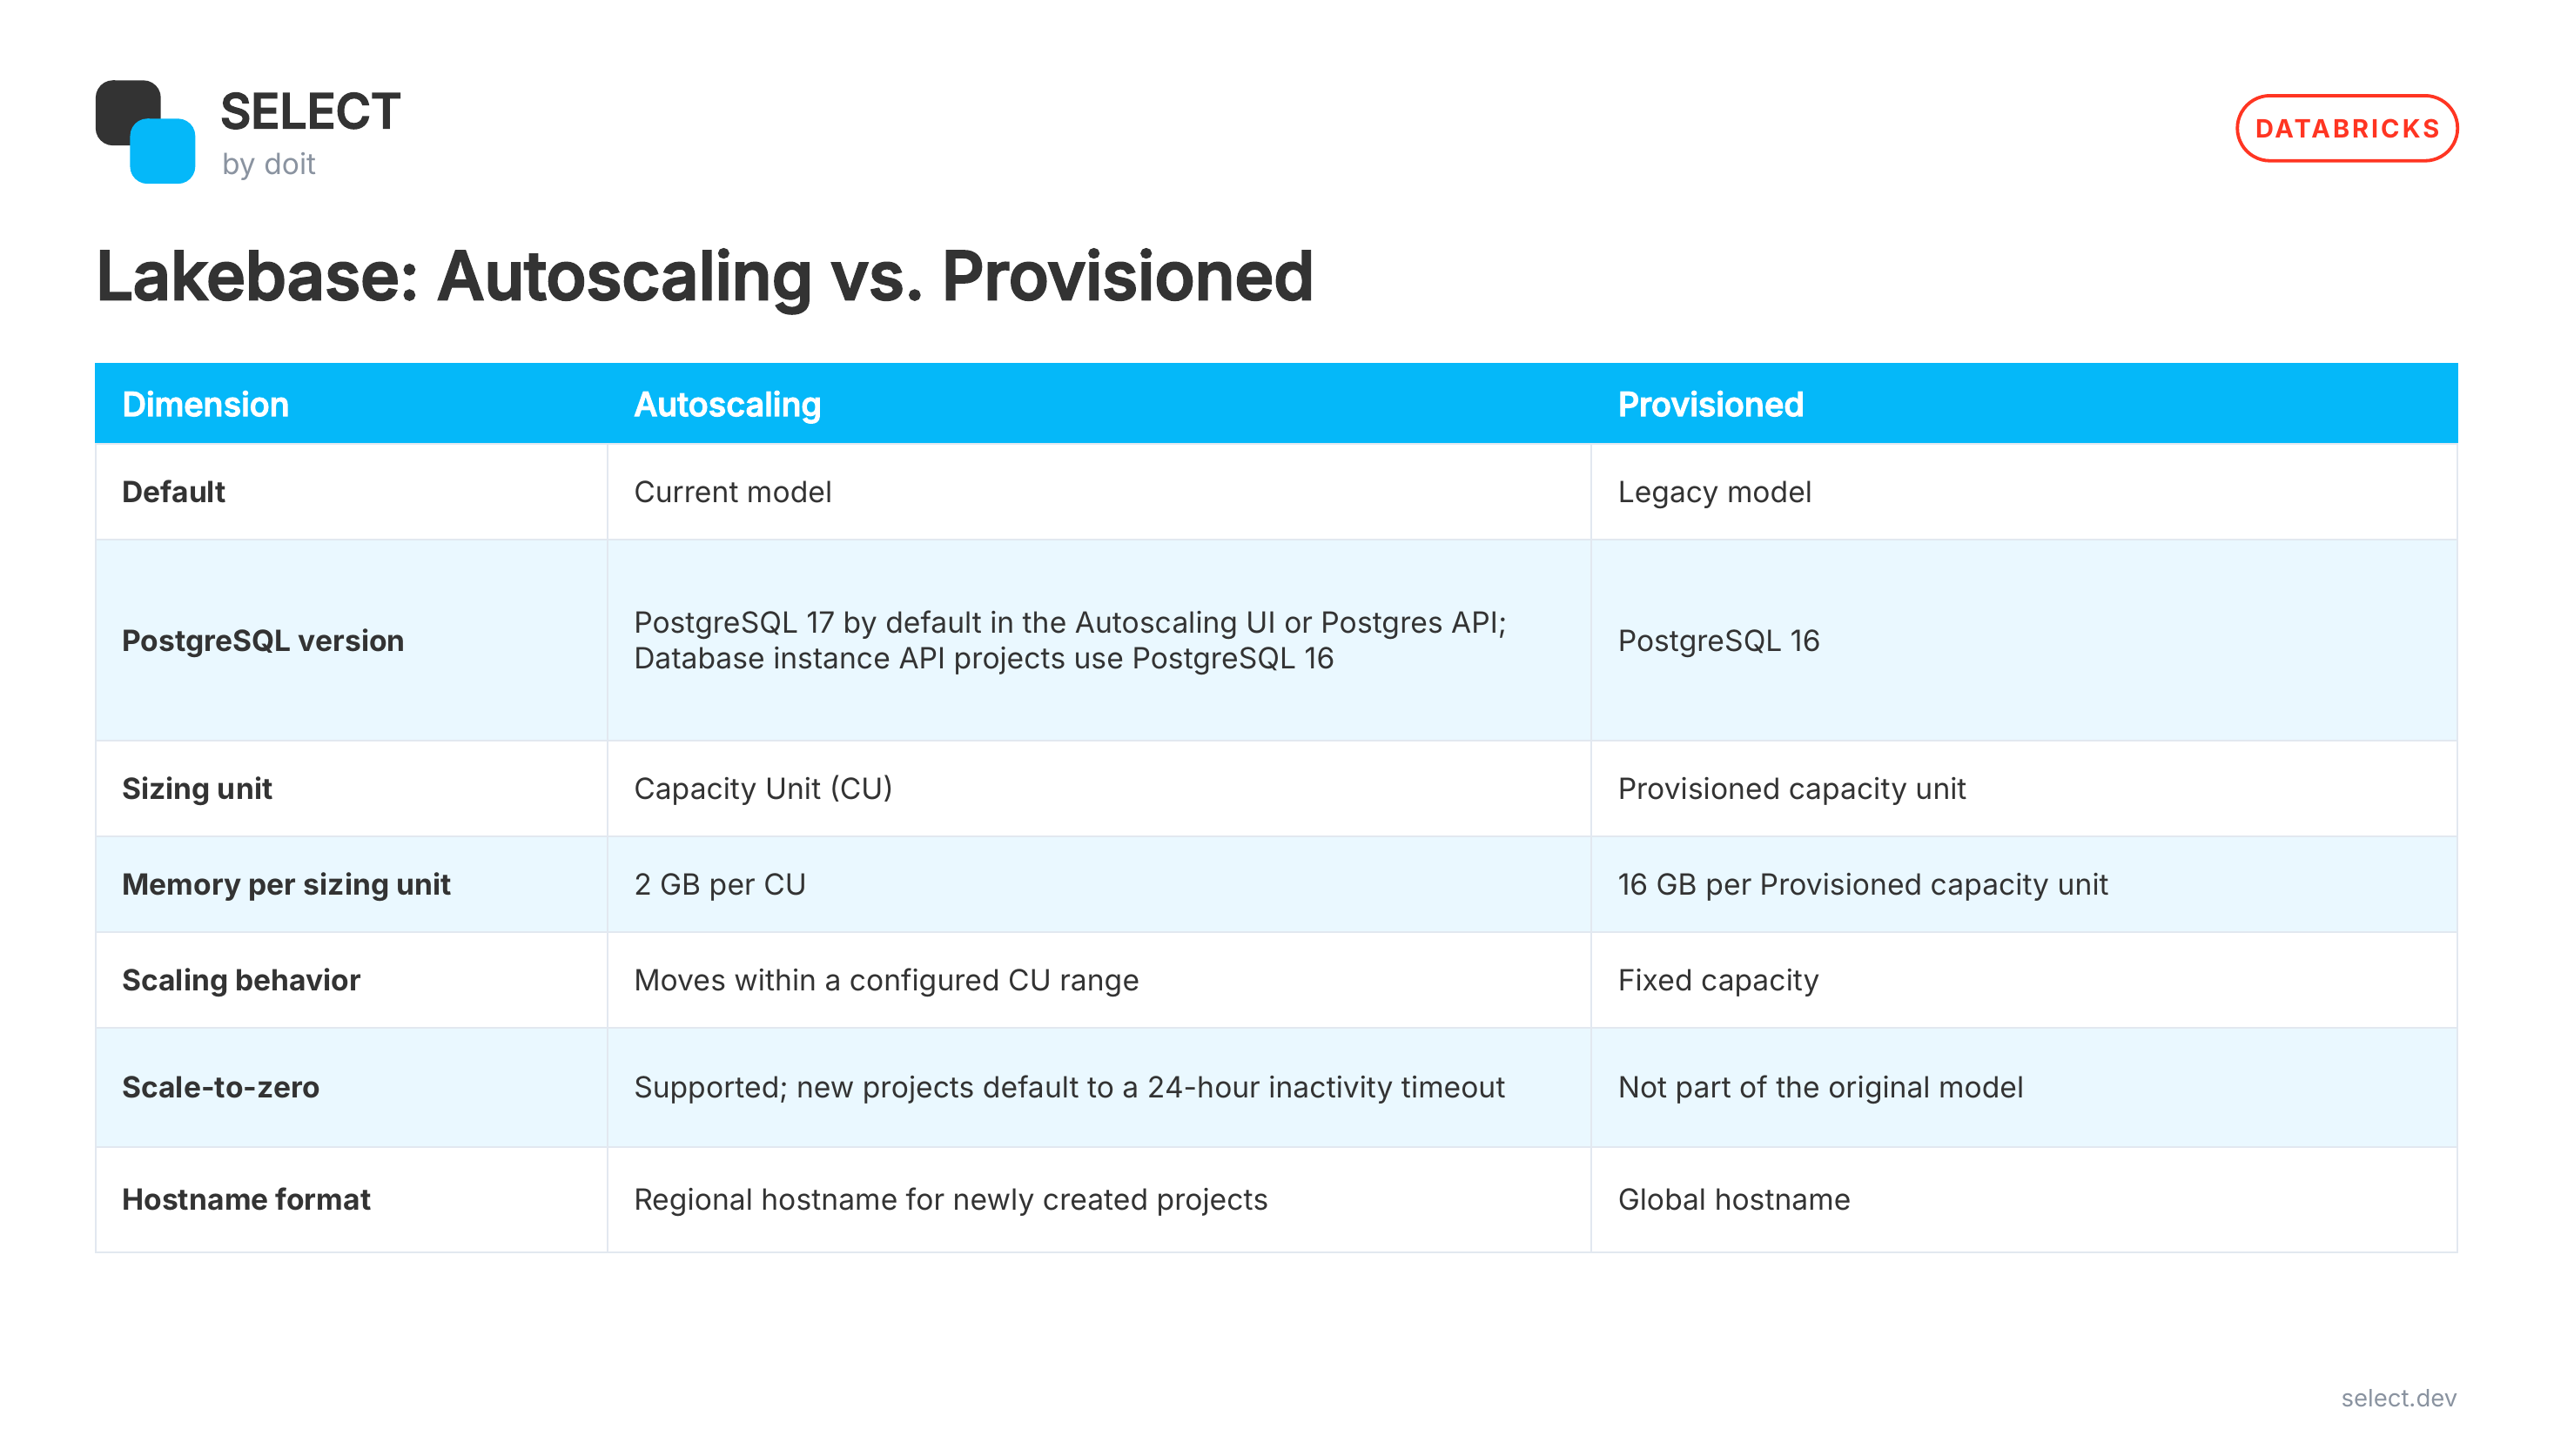
ほとんどの新規設計では、もはやProvisionedかAutoscalingかを選ぶ必要はありません。問うべきは、どれくらいの幅のCU範囲を設定すべきか、そしてスケールトゥゼロがそのアプリケーションに適しているかです。
この2つの選択はコストと挙動の両方に影響します。より広い運用モデルを評価しているなら、Databricksのコスト最適化で、コンピュート、インフラ、ワークロード設計にまたがる主要なコスト要因を解説しています。
予測不能なバーストを受けるデータベースには、スケールの余地が有効です。利用の少ない開発環境には、スケールトゥゼロが有効です。永続的なセッションに依存する本番アプリケーションでは、下限を攻めた設定も非アクティブタイムアウトも望ましくないかもしれません。
それがモデル化すべきトレードオフです。
標準のPostgresにあってLakebaseにないもの
PostgreSQL互換であることは、「すべてのPostgresデプロイメントが同じように振る舞う」こととは別です。
RDS、Cloud SQL、セルフマネージドクラスタから移行する場合は、SQL構文が動くかどうかだけでなく、アプリケーションがデータベースに対して置いている前提をテストしてください。
まずは管理面から確認しましょう。アクセスはアカウントとワークスペースの管理に紐づいており、ユーザーはプラットフォームAPIで管理されます。セルフマネージドPostgreSQLのスーパーユーザーのセマンティクスを前提とする自動化が、そのまま通用するとは考えないでください。
移行前に確認すべきギャップは他にもあります。テーブルスペースはサポートされていません。PostgreSQLネイティブの論理レプリケーションは現時点では利用できません。拡張機能のサポートは無制限ではなく、厳選されたものです。
これらの制限があるからといって、Lakebaseが自動的に不向きになるわけではありません。既存システムがそれらに依存している場合に問題になります。
運用面でより大きな落とし穴は、スケールトゥゼロです。
非アクティブ期間の経過後にコンピュートがシャットダウンすると、接続も一緒に消えます。一時テーブルが消えます。プリペアドステートメントが消えます。アドバイザリロックが消えます。LISTENとNOTIFYの状態が消えます。そのデータベースセッションの中にしか存在しなかったものは、すべて失われます。
適切に実装されたコネクションプールであれば、きれいに再接続するはずです。しかし、本番システムの多くは、接続が切れて初めて気づくような形で、スティッキーな接続や長寿命のセッション状態に暗黙的に依存しています。
アプリケーションがそうなっているなら、その依存を解消するか、スケールトゥゼロを無効にしてください。本番環境で初めて気づく、という事態は避けましょう。
移行時の良い指針は、スキーマの互換性だけでなく、アプリケーションの振る舞いを検証することです。
Lakebaseのユースケース
Lakebaseが最も力を発揮するのは、トランザクショナルデータベースをプラットフォームの他の部分の近くに置くことで、実際のシステム境界が取り除かれるケースです。
最も有力な3つのユースケースは、エージェントの状態管理、オンライン特徴量サービング、アプリケーションバックエンドです。
AIエージェントのメモリ
AIエージェントには、ターン間で状態を保持する場所が必要です。
これには、ユーザーコンテキスト、ツールの出力、ワークフローの進捗、タスクのステータス、エージェントが後で再び必要とするアプリケーション固有の情報などが含まれます。その状態がリクエストをまたいで重要になった時点で、サービングプロセス内のインメモリオブジェクトではなく、永続ストアが必要になります。
アプリケーションが直接のSQLアクセスと独自スキーマの制御を必要とする場合には、PostgreSQLストアがうまく機能します。このモデルでは、アプリケーションが状態を所有し、Databricks環境の他の部分の近くに保持します。
ガバナンスされた状態管理の選択肢は他にもあるため、ワークロードにエージェントが含まれているというだけでLakebaseを選ぶことはおすすめしません。エージェントがアプリケーション制御のリレーショナルな状態を必要とするときに選んでください。
Lakebaseでのオンライン特徴量ストア
特徴量サービングも相性の良いユースケースです。オフライン側とオンライン側では、まったく異なるアクセスパターンが求められるからです。
特徴量は大規模なガバナンス対象テーブルから計算するとしても、モデルのエンドポイントは、customer_risk_scoreやdays_since_last_purchaseが必要になるたびにウェアハウスクエリを実行したくはありません。
代わりに、Snapshot、Triggered、またはContinuousの同期を使って、特徴量の値をPostgreSQLベースのオンラインストアに公開します。サービングエンドポイントは、その運用コピーに対して低レイテンシのルックアップを実行できます。
本当に重要な選択は、特徴量を同期できるかどうかではありません。実際にどこまでの鮮度が必要か、です。
値が1日に1回しか変わらないなら、Continuousは無駄です。20秒前に変わった何かにモデルの判断が依存するなら、Snapshotでは不十分です。
その鮮度要件が同期モードを決めるべきです。
また、オンラインストアがあっても、上流のテーブル設計が無関係になるわけではありません。[Deltaテーブルのレイアウトはサービングのレイテンシに影響します。ソースパイプラインは依然として、新鮮な特徴量の値を効率的に生成・同期しなければならないからです。
アプリケーションバックエンド
これは最もわかりやすいユースケースです。
アプリケーションには、INSERT、UPDATE、DELETE、インデックス、短い読み取り、予測可能な同時実行性が必要です。そうしたトランザクション操作にはこのデータベースを使い、分析はプラットフォーム側に残せます。
Databricks Appsも含まれますが、それに限定される必要はありません。
より興味深いのはその後です。アプリケーションが運用レコードを生成し始めると、逆方向の同期パスによって、その変更をマネージドDeltaテーブルで利用できるようになります。別途外部のCDCプラットフォームを立ち上げることなく、分析、監査ジョブ、下流パイプラインがそれらを消費できます。
Lakebaseのアーキテクチャが真価を発揮するのはここです。
Postgresが目新しいから使うのではありません。運用側と分析側が、自分でつなぎ合わせなければならない無関係な2つのシステムに感じられなくなるから使うのです。
LakebaseのコストとSELECTが可視化するもの
Lakebaseの料金は、多くのDatabricksチームがすでに使っているDBUのメンタルモデルとは切り離して考える必要があります。
現在の料金体系には、サーバーレスオートスケーリング向けのAlways-On料金が含まれており、ベースラインレートが25%低く、長期契約も不要です。狙いは、定期的にスケールダウンするワークロードと同じベースラインの経済性を常時稼働の本番データベースに強いることなく、サーバーレスの弾力性を保つことにあります。
これは有用ですが、同時に、Databricksの請求全体が複数の料金モデルにまたがることも意味します。
クラシックジョブには、DBU料金に加えてクラウドインフラの費用がかかることがあります。サーバーレスはインフラの扱いが異なります。モデルサービングには独自の経済性があります。運用データベースは、さらに別のコスト領域を追加します。
だからこそ、単一の料金表を見るだけでは、ワークロードの実際のコストはほとんどわからないのです。
SELECTのDatabricksコスト最適化ガイドでは、支出の発生源を把握する出発点としてsystem.billing.usageとsystem.billing.list_pricesを使っています。これはDBU課金のワークロードにはよく機能しますが、Lakebaseは独立したデータベースの費目としてではなく、環境全体の文脈の中で評価すべきです。
処理側については、Photonがジョブあたりのコストにどう影響するか [LINK PENDING]。
SELECTはDBU使用量と基盤となるクラウドインフラのコストを組み合わせ、支出をジョブ、クエリ、ユーザー、ワークスペースなどのディメンションに帰属させられるようにします。DoiTによれば、接続には読み取り専用のサービスプリンシパルを使用し、セットアップには約20分かかります。
SELECTを使えば、プラットフォームの請求全体と並べてLakebaseを評価できます。運用レイヤーの追加がアーキテクチャ全体のコストと複雑さを削減するのか、それとも単に支出を別のカテゴリに移しているだけなのかがわかります。
それこそが、行う価値のある比較です。
より広いコストの視点が必要なら、SELECTは約20分で使い始められます。デモを予約して、データベースと並べてDatabricksの残りの支出の内訳をご確認ください。
Lakebaseに関するよくある質問
Databricks Lakebaseは単なるマネージドPostgresですか?
いいえ。
データベースはPostgreSQLですが、その価値は、サーバーレス運用、ブランチング、Synced Tables、運用上の変更をマネージドな分析テーブルに移すパスなど、周囲のプラットフォーム統合から生まれます。
これらの統合が、本来自前で運用しなければならないインフラの代わりになるなら、Lakebaseには強い根拠があります。汎用のPostgresデータベースだけが必要なら、他のマネージドPostgresの選択肢と比較してください。
Synced TablesとLakehouse Syncの違いは何ですか?
両者は逆方向の課題を解決します。
Synced Tablesは、アプリケーションが低レイテンシでアクセスする必要がある場合に、ガバナンスされたソーステーブルをLakebaseに公開します。
Lakehouse Syncは逆方向をカバーします。DatabricksはWALベースの実装をChange Data Feedと呼んでおり、PostgreSQLからINSERT、UPDATE、DELETEをキャプチャし、その変更をマネージドDeltaテーブルで利用できるようにします。
Synced Tablesは「分析ソースからアプリケーションへ」、逆方向のパスは「アプリケーションの変更を分析へ戻す」と考えてください。
LakebaseはすべてのPostgres拡張機能をサポートしていますか?
いいえ。
拡張機能のサポートは厳選されており、PostgreSQLのバージョンによって異なる場合があります。既存のRDS、Cloud SQL、セルフマネージドPostgreSQLのデプロイメントが特定の拡張機能に依存している場合は、移行前に現在のサポート対象拡張機能リストを確認してください。
この確認は、移行アセスメントの最後ではなく、最初の段階で行うべきものです。
Lakebase Provisionedはどうなりましたか?
Provisionedはレガシーモデルです。
新規作成は2026年3月に終了し、既存インスタンスは2026年7月までにAutoscalingへ移行しました。Provisioned UIは、移行期間中は一時的に利用可能なままです。
新規設計では、CU範囲、非アクティブタイムアウト、PostgreSQLバージョン、現行のプロジェクトモデルの接続情報など、本番の挙動に影響するAutoscalingの設定に注力してください。
AIの状態管理にLakebaseを使うべきなのはどんなときですか?
AIアプリケーションがアプリケーション制御のリレーショナルな状態を必要とするときに、Lakebaseを使ってください。
これには通常、直接のSQLアクセス、カスタムスキーマ、トランザクショナルな書き込み、あるいは他のアプリケーションコンポーネントもクエリする必要がある永続コンテキストが含まれます。
エージェントに必要なのがメモリだけであれば、Lakebaseをより高レベルのマネージドメモリの選択肢と比較してください。正しい選択は、アプリケーションが状態モデルを直接制御する必要があるかどうかで決まります。