
Databricks lleva años consolidándose como el lugar donde los equipos procesan, gobiernan y analizan datos. La parte incómoda empieza cuando esos datos tienen que alimentar una aplicación.
Un SQL Warehouse es excelente para escanear millones de filas. Sin embargo, no es donde quieres que una aplicación haga miles de pequeños inserts, updates y consultas puntuales. Así que los equipos caen en un patrón conocido: mantener la analítica en Databricks, levantar Postgres en otro lado, conectar ambos con CDC o reverse ETL, y luego administrar esa segunda base de datos y la capa de sincronización mientras exista la aplicación.
Lakebase es el intento de Databricks por eliminar esa división. La idea es atractiva porque pone Postgres junto al resto de la plataforma, les da a las aplicaciones una base de datos operacional y mueve la información entre los sistemas transaccionales y analíticos sin obligar a los equipos a construir la plomería por su cuenta.
Pero Lakebase no es simplemente "Postgres dentro de Databricks". La integración implica ciertas concesiones: la sincronización tiene dos direcciones y mecanismos distintos, y el scale-to-zero cambia lo que ocurre con el estado de la sesión. Además, la compatibilidad con Postgres no significa que todas las suposiciones de un Postgres autogestionado se mantengan, y la estructura de costos no se parece al modelo de DBU que la mayoría de los equipos de Databricks ya conoce.
Una forma útil de evaluar Lakebase es concentrarse en si esas concesiones encajan con la aplicación que realmente necesitas ejecutar.
TL;DR
- Usa Lakebase si tu aplicación necesita un Postgres transaccional y tus datos ya viven en Databricks. La integración elimina el pipeline de CDC que de otra forma tendrías que construir y mantener
- No lo uses como reemplazo de un Postgres administrado de propósito general. Si tu aplicación no depende de la analítica, la gobernanza o los flujos de IA de Databricks, un Postgres administrado independiente es más simple
- Verifica el soporte de extensiones y el comportamiento del estado de sesión antes de migrar cualquier cosa desde RDS o Cloud SQL
El problema que Lakebase busca eliminar
Los workloads analíticos y transaccionales le exigen cosas muy distintas a una base de datos, y ahí es donde empieza la división arquitectónica.
Tu SQL Warehouse está diseñado para el procesamiento analítico en línea (OLAP): escaneos grandes, joins, agregaciones y consultas que pueden tocar millones o miles de millones de filas. El backend de una aplicación opera en el mundo del procesamiento transaccional en línea (OLTP), donde importan más las transacciones cortas, la concurrencia predecible, las consultas puntuales y los inserts o updates en milisegundos.
Intentar que un sistema se comporte como el otro suele terminar mal.
Antes de Lakebase, la respuesta práctica era agregar Postgres. Mantener el lado analítico en la plataforma de Databricks, correr una instancia de PostgreSQL o un servicio administrado para la aplicación, y luego conectarlos con Change Data Capture, reverse ETL o jobs personalizados.
Funciona. Pero también te deja otro sistema productivo que administrar.
Ahora gestionas credenciales de PostgreSQL, cambios de esquema, recuperación ante fallos, la configuración de red, el retraso de sincronización y todo lo que se rompe cuando el esquema transaccional cambia antes de que el pipeline analítico se ponga al día. La base de datos en sí rara vez es la parte dolorosa. Mantener dos sistemas alineados sí lo es.
Ese es el problema que Lakebase intenta eliminar.
Está claro que hay demanda. Databricks afirma que, desde junio de 2025, la adopción ha crecido a más del doble del ritmo de su producto de warehousing, y reporta miles de empresas corriendo workloads de producción sobre registros operacionales.
La cifra de adopción es interesante, pero no es la razón para elegir el producto. La verdadera pregunta es si mantener tu base de datos transaccional dentro de la misma plataforma elimina suficiente trabajo operativo como para justificar las nuevas restricciones que trae consigo.
¿Qué es Databricks Lakebase?
Lakebase Postgres es un servicio de Postgres totalmente administrado dentro de la plataforma de Databricks. Lakebase separa por completo el cómputo del almacenamiento, de modo que la capa de cómputo puede ajustarse a la demanda mientras el almacenamiento se mantiene persistente.
Esa separación es lo que hace posibles funciones como el autoscaling y el scale-to-zero. Cuando la base de datos está inactiva, el cómputo puede apagarse en lugar de quedarse esperando tráfico. Cuando vuelve la actividad, puede reactivarse sin reconstruir la base de datos almacenada.
Para el desarrollo, los branches instantáneos y los clones zero-copy son igual de interesantes. En lugar de copiar toda una base de datos de producción cada vez que alguien necesita un entorno aislado, un equipo puede crear un branch de la base de datos y trabajar sobre esa copia sin duplicar todo el almacenamiento subyacente.
La tecnología proviene de Neon. Databricks anunció el acuerdo para adquirir la empresa de Postgres serverless el 14 de mayo de 2025, poco antes de lanzar Lakebase.
Pero la tecnología de base de datos es solo la mitad de la historia. La razón para evaluar Lakebase en lugar de otro proveedor de Postgres administrado es la integración que lo rodea.
Este diseño integrado de Databricks conecta la base de datos con capacidades de la plataforma como Unity Catalog, Synced Tables y la ruta inversa de cambios hacia las tablas Delta. Si tu aplicación ya vive junto a Databricks Apps, sistemas de IA, pipelines de features o flujos analíticos, esa cercanía puede ahorrarte una cantidad sorprendente de plomería.
Si ninguna de esas integraciones le importa a tu aplicación, el caso es mucho menos obvio. En esa situación, básicamente estás comparando una implementación de Postgres administrado con otra.
Lakebase alcanzó la disponibilidad general en AWS el 3 de febrero de 2026, seguida de Azure el 3 de marzo de 2026.
Cómo funciona la sincronización bidireccional
Aquí es donde la arquitectura se pone más interesante.
"Sincronización bidireccional" puede sonar como si un solo motor de replicación reflejara continuamente las mismas tablas en ambas direcciones. Ese no es el modelo aquí. Lakebase tiene dos rutas direccionales que resuelven dos problemas distintos:
- Synced Tables llevan tablas de origen gobernadas a Lakebase cuando una aplicación necesita acceso de baja latencia a registros analíticos o gobernados.
- Lakehouse Sync mueve los cambios de la base de datos operacional hacia tablas Delta administradas para analítica, auditoría y procesamiento posterior.
La dirección importa porque los mecanismos, el modelo de propiedad y las restricciones operativas son distintos en cada lado.
De Lakehouse a Lakebase: Synced Tables
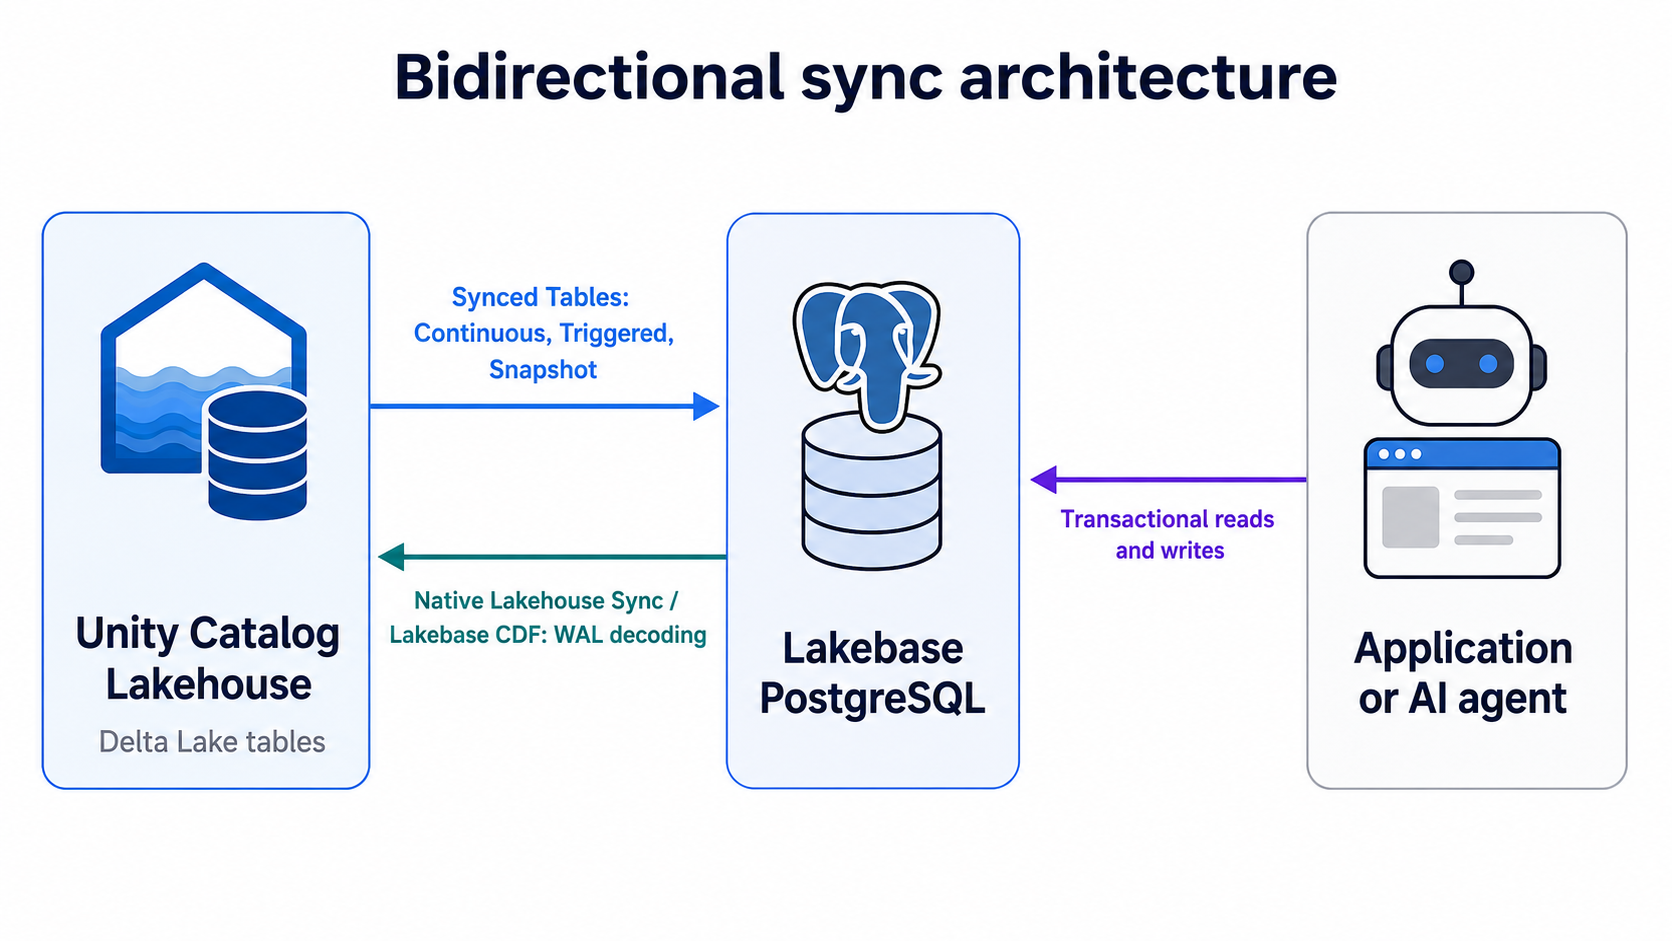
Las Synced Tables son para el caso en que la fuente de verdad ya existe en tablas analíticas gobernadas, pero una aplicación necesita leer esa información con latencia de base de datos.
En lugar de hacer que la aplicación consulte directamente las tablas analíticas, el proceso de sincronización publica la fuente relevante en Lakebase. Las aplicaciones acceden luego a la copia sincronizada a través de la interfaz de PostgreSQL con drivers estándar.
Ese modelo de propiedad es importante. Trata una synced table como algo que controla el pipeline de sincronización, no como otra tabla propiedad de la aplicación que casualmente estás replicando. El acceso de solo lectura desde la aplicación es el valor predeterminado más seguro.
Tienes tres modos de sincronización:
- Snapshot hace una copia única. Es la opción directa para publicaciones masivas, fuentes sin Delta Change Data Feed o casos en los que un gran porcentaje de la tabla cambia entre actualizaciones.
- Triggered realiza actualizaciones incrementales cuando lo ejecutas o según un calendario. Suele ser la mejor opción cuando los requisitos de frescura se miden en minutos u horas, no en segundos.
- Continuous mantiene el flujo de cambios con una latencia de segundos. Obtienes el menor retraso, pero también mantienes la maquinaria de sincronización activa de forma continua.
Elige Continuous cuando la aplicación tenga un requisito de frescura medido que Snapshot o Triggered no puedan cumplir. La sincronización en tiempo real implica costos y sobrecarga operativa, así que el modo de sincronización debe definirse según la frescura requerida.
También hay límites de dimensionamiento que conviene tener en cuenta al planificar.
Las escrituras Continuous y Triggered se estiman en unas 150 filas por segundo por Capacity Unit, mientras que las escrituras Snapshot pueden alcanzar hasta 2,000 filas por segundo por CU.
Toma esas cifras como referencias prácticas para la planificación de capacidad, ya que el rendimiento real variará según la estructura de la tabla, los índices y los patrones de cambio.
El tamaño lógico agregado de las synced tables tiene un tope de 16 TB. No existe una cuota estricta por tabla individual, pero Databricks recomienda mantener las tablas que requieren refresh en 1 TB o menos.
El comportamiento del refresh es fácil de pasar por alto. Durante un refresh completo, la versión sincronizada anterior sigue disponible mientras se construye el reemplazo. Ambas versiones consumen temporalmente almacenamiento contra la cuota lógica de la base de datos.
Si ya estás cerca del límite, un refresh puede ser justo lo que te haga superarlo. Planifica la capacidad para el refresh, no solo para el estado estable.
Autoscaling vs Provisioned: qué cambió en marzo de 2026
El material más antiguo sobre Lakebase puede confundir el cambio de Provisioned a Autoscaling, pero para los diseños actuales la distinción es mayormente histórica.
Provisioned y Autoscaling eran modelos operativos distintos. Esa distinción es hoy mayormente histórica.
Las nuevas instancias pasaron a Autoscaling de forma predeterminada el 12 de marzo de 2026. Las instancias Provisioned existentes se actualizaron hasta julio de 2026, y la interfaz antigua se mantiene solo como un recurso temporal durante la transición, hasta el 1 de septiembre de 2026.
El modelo de dimensionamiento cambió sustancialmente. Autoscaling usa Capacity Units, con 2 GB de RAM por CU. El modelo Provisioned anterior usaba una unidad de capacidad Provisioned con 16 GB de RAM por unidad.
No se trata solo de una unidad más pequeña. Autoscaling puede moverse dentro de un rango de CU configurado a medida que cambia la demanda. Provisioned significaba elegir una cantidad fija de capacidad y vivir con ella hasta cambiar la configuración.
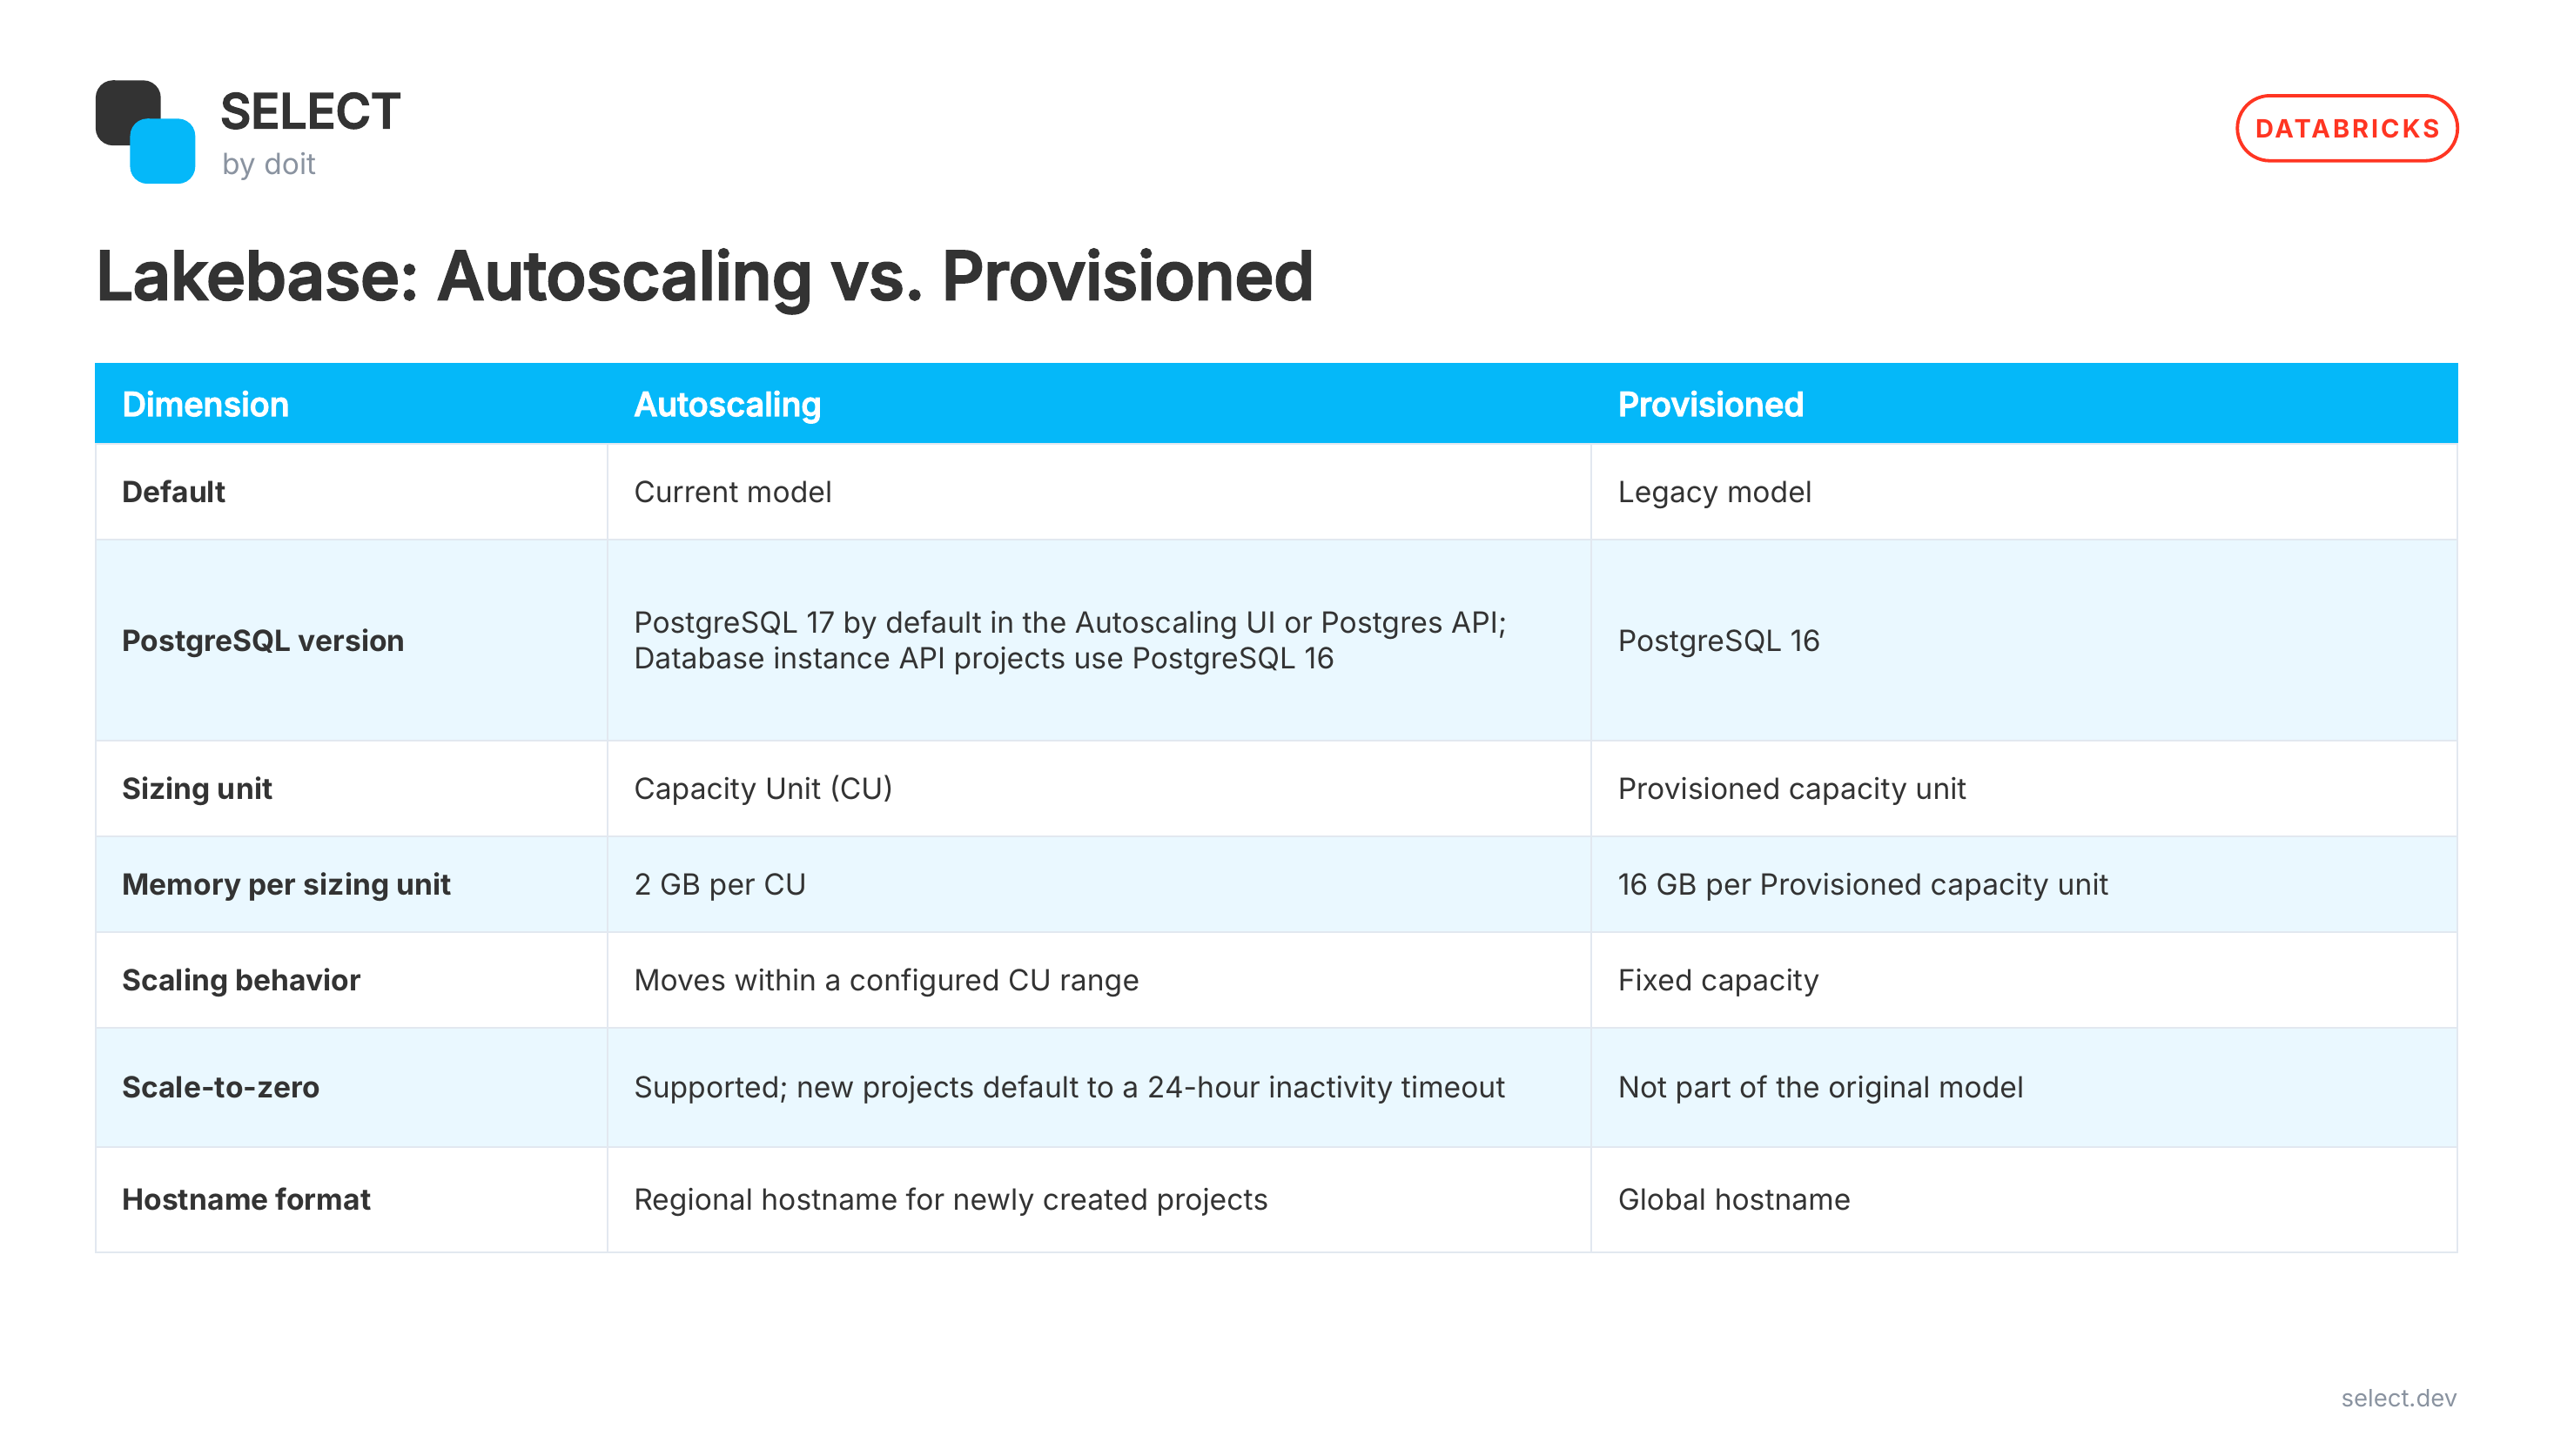
Para la mayoría de los diseños nuevos, ya no hay una decisión que tomar entre Provisioned y Autoscaling. La pregunta útil es qué tan amplio debería ser el rango de CU y si el scale-to-zero tiene sentido para la aplicación.
Esas dos decisiones afectan tanto el costo como el comportamiento. Si estás evaluando el modelo operativo más amplio, la optimización de costos de Databricks cubre los factores de costo generales en cómputo, infraestructura y diseño de workloads.
Una base de datos que recibe ráfagas impredecibles se beneficia de tener margen para escalar. Un entorno de desarrollo con poca actividad se beneficia del scale-to-zero. Una aplicación de producción que depende de sesiones persistentes quizás no quiera ni un límite inferior agresivo ni un timeout por inactividad.
Esa es la disyuntiva que hay que modelar.
Lo que Lakebase no te da frente a un Postgres estándar
La compatibilidad con PostgreSQL no equivale a que "todos los despliegues de Postgres se comporten igual".
Si migras desde RDS, Cloud SQL o un clúster autogestionado, prueba las suposiciones que tu aplicación hace sobre la base de datos, no solo si funciona la sintaxis SQL.
Empieza por la administración. El acceso está ligado a la gestión de la cuenta y el workspace, con usuarios administrados mediante las APIs de la plataforma. No asumas que la automatización que espera semántica de superusuario de un PostgreSQL autogestionado funcionará sin cambios.
Hay otras limitaciones que conviene revisar antes de migrar. Los tablespaces no están soportados. La replicación lógica nativa de PostgreSQL no está disponible por ahora. El soporte de extensiones es una lista curada, no irrestricta.
Ninguna de esas limitaciones hace que Lakebase sea automáticamente una mala opción. Se convierten en problemas cuando tu sistema actual depende de ellas.
El mayor riesgo operativo es el scale-to-zero.
Cuando el cómputo se apaga tras el período de inactividad, la conexión se va con él. Las tablas temporales desaparecen. Los prepared statements desaparecen. Los advisory locks desaparecen. El estado de LISTEN y NOTIFY desaparece. Todo lo que solo existía dentro de esa sesión de base de datos se pierde.
Un pool de aplicación bien implementado debería reconectarse sin problemas. Pero muchos sistemas de producción dependen, sin que nadie lo advierta, de conexiones persistentes o de estado de sesión de larga duración, hasta que la conexión desaparece.
Si tu aplicación hace eso, corrige la dependencia o desactiva el scale-to-zero. No lo descubras en producción.
Una buena regla de migración es validar cómo se comporta la aplicación, no solo si el esquema es compatible.
Casos de uso de Lakebase
Los casos de uso más sólidos de Lakebase son aquellos en los que mantener la base de datos transaccional cerca del resto de la plataforma elimina una frontera real entre sistemas.
Los tres casos más fuertes son el estado de agentes, el serving de features en línea y los backends de aplicaciones.
Memoria de agentes de IA
Los agentes de IA necesitan un lugar donde guardar el estado entre turnos.
Eso puede incluir contexto del usuario, salidas de herramientas, avance del flujo de trabajo, estado de tareas o información específica de la aplicación que el agente volverá a necesitar más adelante. Una vez que ese estado importa entre solicitudes, requiere un almacenamiento persistente y no otro objeto en memoria dentro del proceso de serving.
Un almacén PostgreSQL funciona bien cuando la aplicación necesita acceso SQL directo y control sobre su propio esquema. En este modelo, la aplicación es dueña del estado y lo mantiene cerca del resto del entorno de Databricks.
Existen otras opciones de estado gobernado, así que no elegiría Lakebase solo porque el workload incluye un agente. Elígelo cuando el agente necesite estado relacional controlado por la aplicación.
Online Feature Store en Lakebase
El serving de features es otro caso que encaja de forma natural, porque los lados offline y online requieren patrones de acceso completamente distintos.
Puedes calcular features a partir de grandes tablas gobernadas, pero el endpoint del modelo no quiere ejecutar una consulta de warehouse cada vez que necesita customer_risk_score o days_since_last_purchase.
En su lugar, publica los valores de las features en un store online respaldado por PostgreSQL usando sincronización Snapshot, Triggered o Continuous. El endpoint de serving puede entonces hacer lookups de baja latencia contra la copia operacional.
La decisión interesante no es si la feature se puede sincronizar, sino qué tan fresca necesita ser realmente.
Si el valor cambia una vez al día, Continuous es un desperdicio. Si la decisión del modelo depende de algo que cambió hace 20 segundos, Snapshot no basta.
Ese requisito de frescura debe definir el modo de sincronización.
Y el store online no vuelve irrelevante el diseño de las tablas de origen. [La forma en que están organizadas tus tablas Delta afecta la latencia de serving, porque el pipeline de origen todavía tiene que producir y sincronizar valores frescos de features de manera eficiente.
Backend de aplicaciones
Este es el caso de uso más directo.
Una aplicación necesita inserts, updates, deletes, índices, lecturas cortas y concurrencia predecible. Puede usar la base de datos para esas operaciones transaccionales mientras la analítica se queda en la plataforma.
Eso incluye Databricks Apps, pero no tiene por qué limitarse a ellas.
La parte más interesante viene después. Una vez que la aplicación empieza a generar registros operacionales, la ruta de sincronización inversa puede poner esos cambios a disposición de las tablas Delta administradas. La analítica, los jobs de auditoría y los pipelines posteriores pueden consumirlos sin que tengas que montar una plataforma de CDC externa aparte.
Aquí es donde la arquitectura de Lakebase se gana su lugar.
No la usas porque Postgres sea una novedad. La usas porque el lado operacional y el analítico dejan de sentirse como dos sistemas sin relación que tienes que pegar por tu cuenta.
Costos de Lakebase y lo que SELECT muestra
Los precios de Lakebase deben considerarse por separado del modelo mental de DBU que la mayoría de los equipos de Databricks ya usa.
Los precios actuales incluyen la modalidad Always-On para autoscaling serverless, con un precio base un 25% más bajo y sin compromiso a largo plazo. El objetivo es conservar la elasticidad serverless sin obligar a una base de datos de producción siempre activa a pagar los mismos costos base que un workload que se reduce con regularidad.
Eso es útil, pero también significa que tu factura total de Databricks ahora abarca más de un modelo de precios.
Los jobs clásicos pueden tener cargos por DBU más infraestructura de nube. Serverless empaqueta la infraestructura de otra manera. El model serving tiene su propia lógica de costos. Las bases de datos operacionales agregan otro frente de costos.
Por eso, mirar una sola tabla de precios rara vez te dice cuánto cuesta realmente un workload.
La guía de optimización de costos de Databricks de SELECT usa system.billing.usage y system.billing.list_prices como puntos de partida para entender de dónde proviene el gasto. Eso funciona bien para workloads con precio por DBU, pero Lakebase debe evaluarse en el contexto del resto del entorno y no como una línea de base de datos aislada.
Para el lado de procesamiento, cómo afecta Photon el costo por job [LINK PENDING].
SELECT combina el uso de DBU con los costos de la infraestructura de nube subyacente para que los equipos puedan atribuir el gasto a jobs, consultas, usuarios, workspaces y otras dimensiones. DoiT indica que la conexión usa un service principal de solo lectura y toma unos 20 minutos de configuración.
SELECT te ayuda a evaluar Lakebase junto con el resto de tu factura de la plataforma. Muestra si agregar la capa operacional reduce el costo y la complejidad generales de la arquitectura o si solo traslada el gasto a otra categoría.
Esa es la comparación que vale la pena hacer.
Si necesitas esa visión de costos más amplia, los equipos pueden empezar con SELECT en aproximadamente 20 minutos. Agenda una demo para ver cómo se desglosa el resto de tu gasto en Databricks junto con la base de datos.
Preguntas frecuentes sobre Lakebase
¿Databricks Lakebase es solo un Postgres administrado?
No.
La base de datos es PostgreSQL, pero su valor proviene de la integración con la plataforma que la rodea, incluida la operación serverless, el branching, las Synced Tables y la ruta para mover cambios operacionales hacia tablas analíticas administradas.
Si esas integraciones reemplazan infraestructura que de otra forma tendrías que operar, Lakebase tiene un caso sólido. Si solo necesitas una base de datos Postgres de propósito general, compárala con otras opciones de Postgres administrado.
¿En qué se diferencian Synced Tables y Lakehouse Sync?
Resuelven direcciones opuestas.
Las Synced Tables publican tablas de origen gobernadas en Lakebase cuando una aplicación necesita acceso de baja latencia a ellas.
Lakehouse Sync cubre la dirección inversa. Databricks llama Change Data Feed a la implementación basada en WAL, que captura inserts, updates y deletes de PostgreSQL y pone esos cambios a disposición en tablas Delta administradas.
Piensa en "de la fuente analítica a la aplicación" para las Synced Tables y en "los cambios de la aplicación de vuelta a la analítica" para la ruta inversa.
¿Lakebase soporta todas las extensiones de Postgres?
No.
El soporte de extensiones es curado y puede variar según la versión de PostgreSQL. Revisa la lista actual de extensiones soportadas antes de migrar si tu despliegue existente de RDS, Cloud SQL o PostgreSQL autogestionado depende de alguna extensión en particular.
Esa verificación corresponde al inicio de una evaluación de migración, no al final.
¿Qué pasó con Lakebase Provisioned?
Provisioned es el modelo heredado.
La creación de nuevas instancias terminó en marzo de 2026, y las existentes pasaron a Autoscaling hasta julio de 2026. La interfaz de Provisioned sigue disponible temporalmente durante la transición.
Para diseños nuevos, concéntrate en los ajustes de Autoscaling que afectan el comportamiento en producción, incluidos el rango de CU, el timeout por inactividad, la versión de PostgreSQL y los detalles de conexión del modelo de proyecto actual.
¿Cuándo debería usar Lakebase para el estado de IA?
Usa Lakebase cuando una aplicación de IA necesite estado relacional controlado por la aplicación.
Eso suele incluir acceso SQL directo, un esquema personalizado, escrituras transaccionales o contexto persistente que otros componentes de la aplicación también necesitan consultar.
Si el agente solo necesita memoria, compara Lakebase con opciones de memoria administrada de más alto nivel. La elección correcta depende de si la aplicación necesita control directo sobre el modelo de estado.