
Databricks ha passato anni a diventare il luogo in cui i team elaborano, governano e analizzano i dati. Le complicazioni iniziano quando quei dati devono alimentare un'applicazione.
Un SQL Warehouse è eccellente quando si tratta di scansionare milioni di righe. Ma non è il posto in cui vuoi che un'applicazione esegua migliaia di piccoli insert, update e point lookup. Così i team finiscono nel solito schema: tenere l'analytics in Databricks, avviare Postgres da qualche altra parte, collegare i due sistemi con CDC o reverse ETL, e poi gestire quel secondo database e il layer di sincronizzazione per tutta la vita dell'applicazione.
Lakebase è il tentativo di Databricks di eliminare questa separazione. L'idea è convincente perché mette Postgres accanto al resto della piattaforma, fornisce alle applicazioni un database operazionale e sposta le informazioni tra sistemi transazionali e analitici senza costringere i team a costruirsi da soli tutta l'infrastruttura di raccordo.
Ma Lakebase non è semplicemente "Postgres dentro Databricks". L'integrazione comporta dei compromessi: la sincronizzazione ha due direzioni e due meccanismi diversi, e lo scale-to-zero cambia cosa succede allo stato di sessione. Inoltre, la compatibilità con Postgres non significa che ogni assunzione valida per un Postgres self-managed resti valida, e l'economia del servizio non assomiglia al modello DBU che la maggior parte dei team Databricks già conosce.
Un buon modo per valutare Lakebase è chiedersi se i suoi compromessi si adattino all'applicazione che devi effettivamente far girare.
TL;DR
- Usa Lakebase se la tua applicazione ha bisogno di un Postgres transazionale e i tuoi dati vivono già in Databricks. L'integrazione elimina la pipeline CDC che altrimenti dovresti costruire e mantenere
- Non usarlo come sostituto generico di un Postgres gestito. Se la tua applicazione non dipende da analytics, governance o workflow AI di Databricks, un Postgres gestito standalone è più semplice
- Verifica il supporto delle estensioni e il comportamento dello stato di sessione prima di migrare qualsiasi cosa da RDS o Cloud SQL
Il problema che Lakebase è nato per eliminare
I workloads analitici e transazionali impongono esigenze molto diverse a un database, ed è da qui che nasce la separazione architetturale.
Il tuo SQL Warehouse è costruito per l'Online Analytical Processing (OLAP): gestisce grandi scansioni, join, aggregazioni e query che possono toccare milioni o miliardi di righe. Il backend di un'applicazione opera nel mondo dell'Online Transaction Processing (OLTP), dove contano di più transazioni brevi, concorrenza prevedibile, point lookup e insert o update in millisecondi.
Cercare di far comportare un sistema come l'altro di solito finisce male.
Prima di Lakebase, la risposta pratica era aggiungere Postgres. Tenere la parte analitica sulla piattaforma Databricks, eseguire un'istanza PostgreSQL o un servizio hosted per l'applicazione, poi collegarli con Change Data Capture, reverse ETL o job custom.
Funziona. Ma ti lascia anche un altro sistema di produzione da gestire.
Ora ti ritrovi a gestire credenziali PostgreSQL, modifiche allo schema, ripristino dai guasti, networking, lag di sincronizzazione e qualunque cosa si rompa quando lo schema transazionale cambia prima che la pipeline analitica si adegui. Il database in sé è raramente la parte dolorosa. Tenere allineati due sistemi lo è.
È questo il problema che Lakebase cerca di eliminare.
E la domanda, chiaramente, non manca. Databricks afferma che da giugno 2025 l'adozione è cresciuta a un ritmo più che doppio rispetto al suo prodotto di warehousing, e riporta migliaia di aziende che eseguono workloads di produzione su record operazionali.
Il dato sull'adozione è interessante, ma non è il motivo per scegliere il prodotto. La vera domanda è se tenere il database transazionale all'interno della stessa piattaforma elimini abbastanza lavoro operativo da giustificare i nuovi vincoli che ne derivano.
Cos'è Databricks Lakebase?
Lakebase Postgres è un servizio Postgres completamente gestito all'interno della piattaforma Databricks. Lakebase separa completamente il compute dallo storage, così il layer di compute può adattarsi alla domanda mentre lo storage rimane durevole.
È questa separazione a rendere possibili funzionalità come l'autoscaling e lo scale-to-zero. Quando il database è inattivo, il compute può spegnersi invece di restare lì in attesa di traffico. Quando l'attività riprende, può ripartire senza ricostruire il database archiviato.
Per lo sviluppo, i branch istantanei e i cloni zero-copy sono altrettanto interessanti. Invece di copiare un intero database di produzione ogni volta che qualcuno ha bisogno di un ambiente isolato, un team può creare un branch del database e lavorare su quella copia senza duplicare tutto lo storage sottostante.
La tecnologia arriva da Neon. Databricks ha annunciato l'accordo per acquisire l'azienda specializzata in Postgres serverless il 14 maggio 2025, poco prima di lanciare Lakebase.
Ma la tecnologia del database è solo metà della storia. Il motivo per valutare Lakebase invece di un altro provider di Postgres gestito è l'integrazione che lo circonda.
Questo design integrato di Databricks collega il database a funzionalità della piattaforma come Unity Catalog, le Synced Tables e il percorso inverso delle modifiche verso le tabelle Delta. Se la tua applicazione vive già accanto a Databricks Apps, sistemi AI, pipeline di feature o workflow analitici, questa vicinanza può eliminare una quantità sorprendente di lavoro di raccordo.
Se nessuna di queste integrazioni è rilevante per la tua applicazione, le ragioni per sceglierlo sono molto meno evidenti. In quella situazione, stai sostanzialmente confrontando un'implementazione di Postgres gestito con un'altra.
Lakebase ha raggiunto la general availability su AWS il 3 febbraio 2026, seguita da Azure il 3 marzo 2026.
Come funziona la sincronizzazione bidirezionale
È qui che l'architettura si fa più interessante.
"Sync bidirezionale" può far pensare a un unico motore di replica che rispecchia continuamente le stesse tabelle in entrambe le direzioni. Non è questo il modello. Lakebase ha due percorsi direzionali che risolvono due problemi diversi:
- Le Synced Tables portano tabelle sorgente governate dentro Lakebase quando un'applicazione ha bisogno di accesso a bassa latenza a record analitici o governati.
- Il Lakehouse Sync sposta le modifiche del database operazionale in tabelle Delta gestite per analytics, audit e processi a valle.
La direzione conta, perché meccanismi, modello di ownership e vincoli operativi sono diversi su ciascun lato.
Dal Lakehouse a Lakebase - Synced Tables
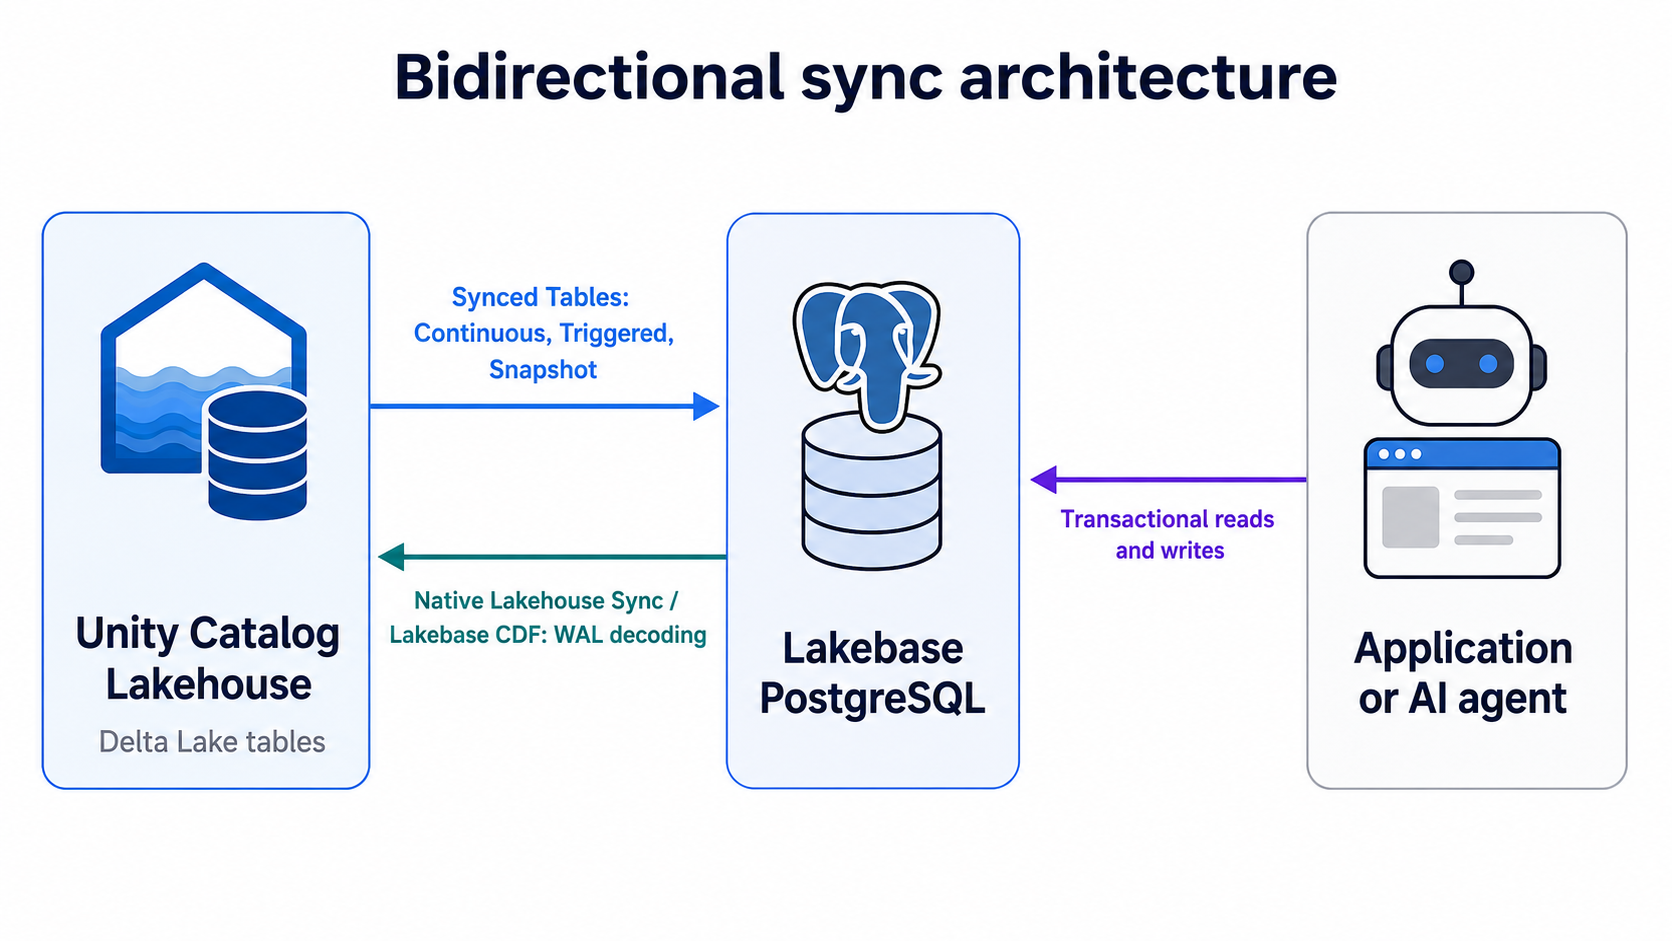
Le Synced Tables servono quando la source of truth esiste già in tabelle analitiche governate, ma un'applicazione deve leggere quelle informazioni con latenze da database.
Invece di far interrogare direttamente le tabelle analitiche all'applicazione, il processo di sincronizzazione pubblica la sorgente rilevante in Lakebase. Le applicazioni accedono poi alla copia sincronizzata attraverso l'interfaccia PostgreSQL con driver standard.
Questo modello di ownership è importante. Tratta una synced table come qualcosa che la pipeline di sincronizzazione controlla, non come un'altra tabella di proprietà dell'applicazione che ti capita di replicare. L'accesso in sola lettura da parte dell'applicazione è il default più sicuro.
Hai tre modalità di sincronizzazione:
- Snapshot crea una copia una tantum. È la scelta più diretta per pubblicazioni bulk, sorgenti senza Delta Change Data Feed o casi in cui una grande percentuale della tabella cambia tra un refresh e l'altro.
- Triggered esegue aggiornamenti incrementali quando lo avvii o su pianificazione. Di solito è la soluzione migliore quando i requisiti di freschezza dei dati si misurano in minuti o ore anziché in secondi.
- Continuous mantiene il flusso delle modifiche con latenze nell'ordine dei secondi. Ottieni il lag più basso, ma tieni anche il meccanismo di sincronizzazione attivo in modo continuo.
Scegli Continuous quando l'applicazione ha un requisito di freschezza misurato che Snapshot o Triggered non possono soddisfare. La sincronizzazione in tempo reale comporta costi e overhead operativo, quindi dovrebbe essere la freschezza richiesta a determinare la modalità di sync.
Ci sono anche limiti di dimensionamento da considerare in fase di pianificazione.
Le scritture Continuous e Triggered sono stimate in circa 150 righe al secondo per Capacity Unit, mentre le scritture Snapshot possono arrivare fino a 2.000 righe al secondo per CU.
Considera questi numeri come benchmark pratici per il capacity planning, poiché il throughput reale varierà in base alla struttura delle tabelle, all'indicizzazione e ai pattern di modifica.
La dimensione logica aggregata delle synced tables è limitata a 16 TB. Non esiste una quota rigida separata per la singola tabella, ma Databricks consiglia di mantenere le tabelle che richiedono refresh entro 1 TB.
Il comportamento del refresh è facile da trascurare. Durante un refresh completo, la vecchia versione sincronizzata resta disponibile mentre viene costruita quella sostitutiva. Entrambe le versioni consumano temporaneamente storage a valere sulla quota logica del database.
Se sei già vicino al limite, un refresh può essere proprio ciò che te lo fa superare. Pianifica la capacità per il refresh, non solo per lo stato a regime.
Autoscaling vs Provisioned: cosa è cambiato a marzo 2026
Il materiale meno recente su Lakebase può confondere le acque sul passaggio da Provisioned ad Autoscaling, ma per i design attuali la distinzione è ormai in gran parte storica.
Provisioned e Autoscaling erano modelli operativi diversi. Quella distinzione è ormai in gran parte storica.
Le nuove istanze sono passate ad Autoscaling di default il 12 marzo 2026. Le istanze Provisioned esistenti sono state aggiornate entro luglio 2026, e la vecchia UI resta disponibile solo come interfaccia di transizione temporanea fino al 1° settembre 2026.
Il modello di dimensionamento è cambiato in modo sostanziale. Autoscaling usa le Capacity Units, con 2 GB di RAM per CU. Il vecchio modello Provisioned usava una Provisioned capacity unit con 16 GB di RAM per unità.
Non si tratta solo di un'unità più piccola. Autoscaling può muoversi all'interno di un range di CU configurato al variare della domanda. Provisioned significava scegliere una quantità fissa di capacità e tenersela finché non cambiavi la configurazione.
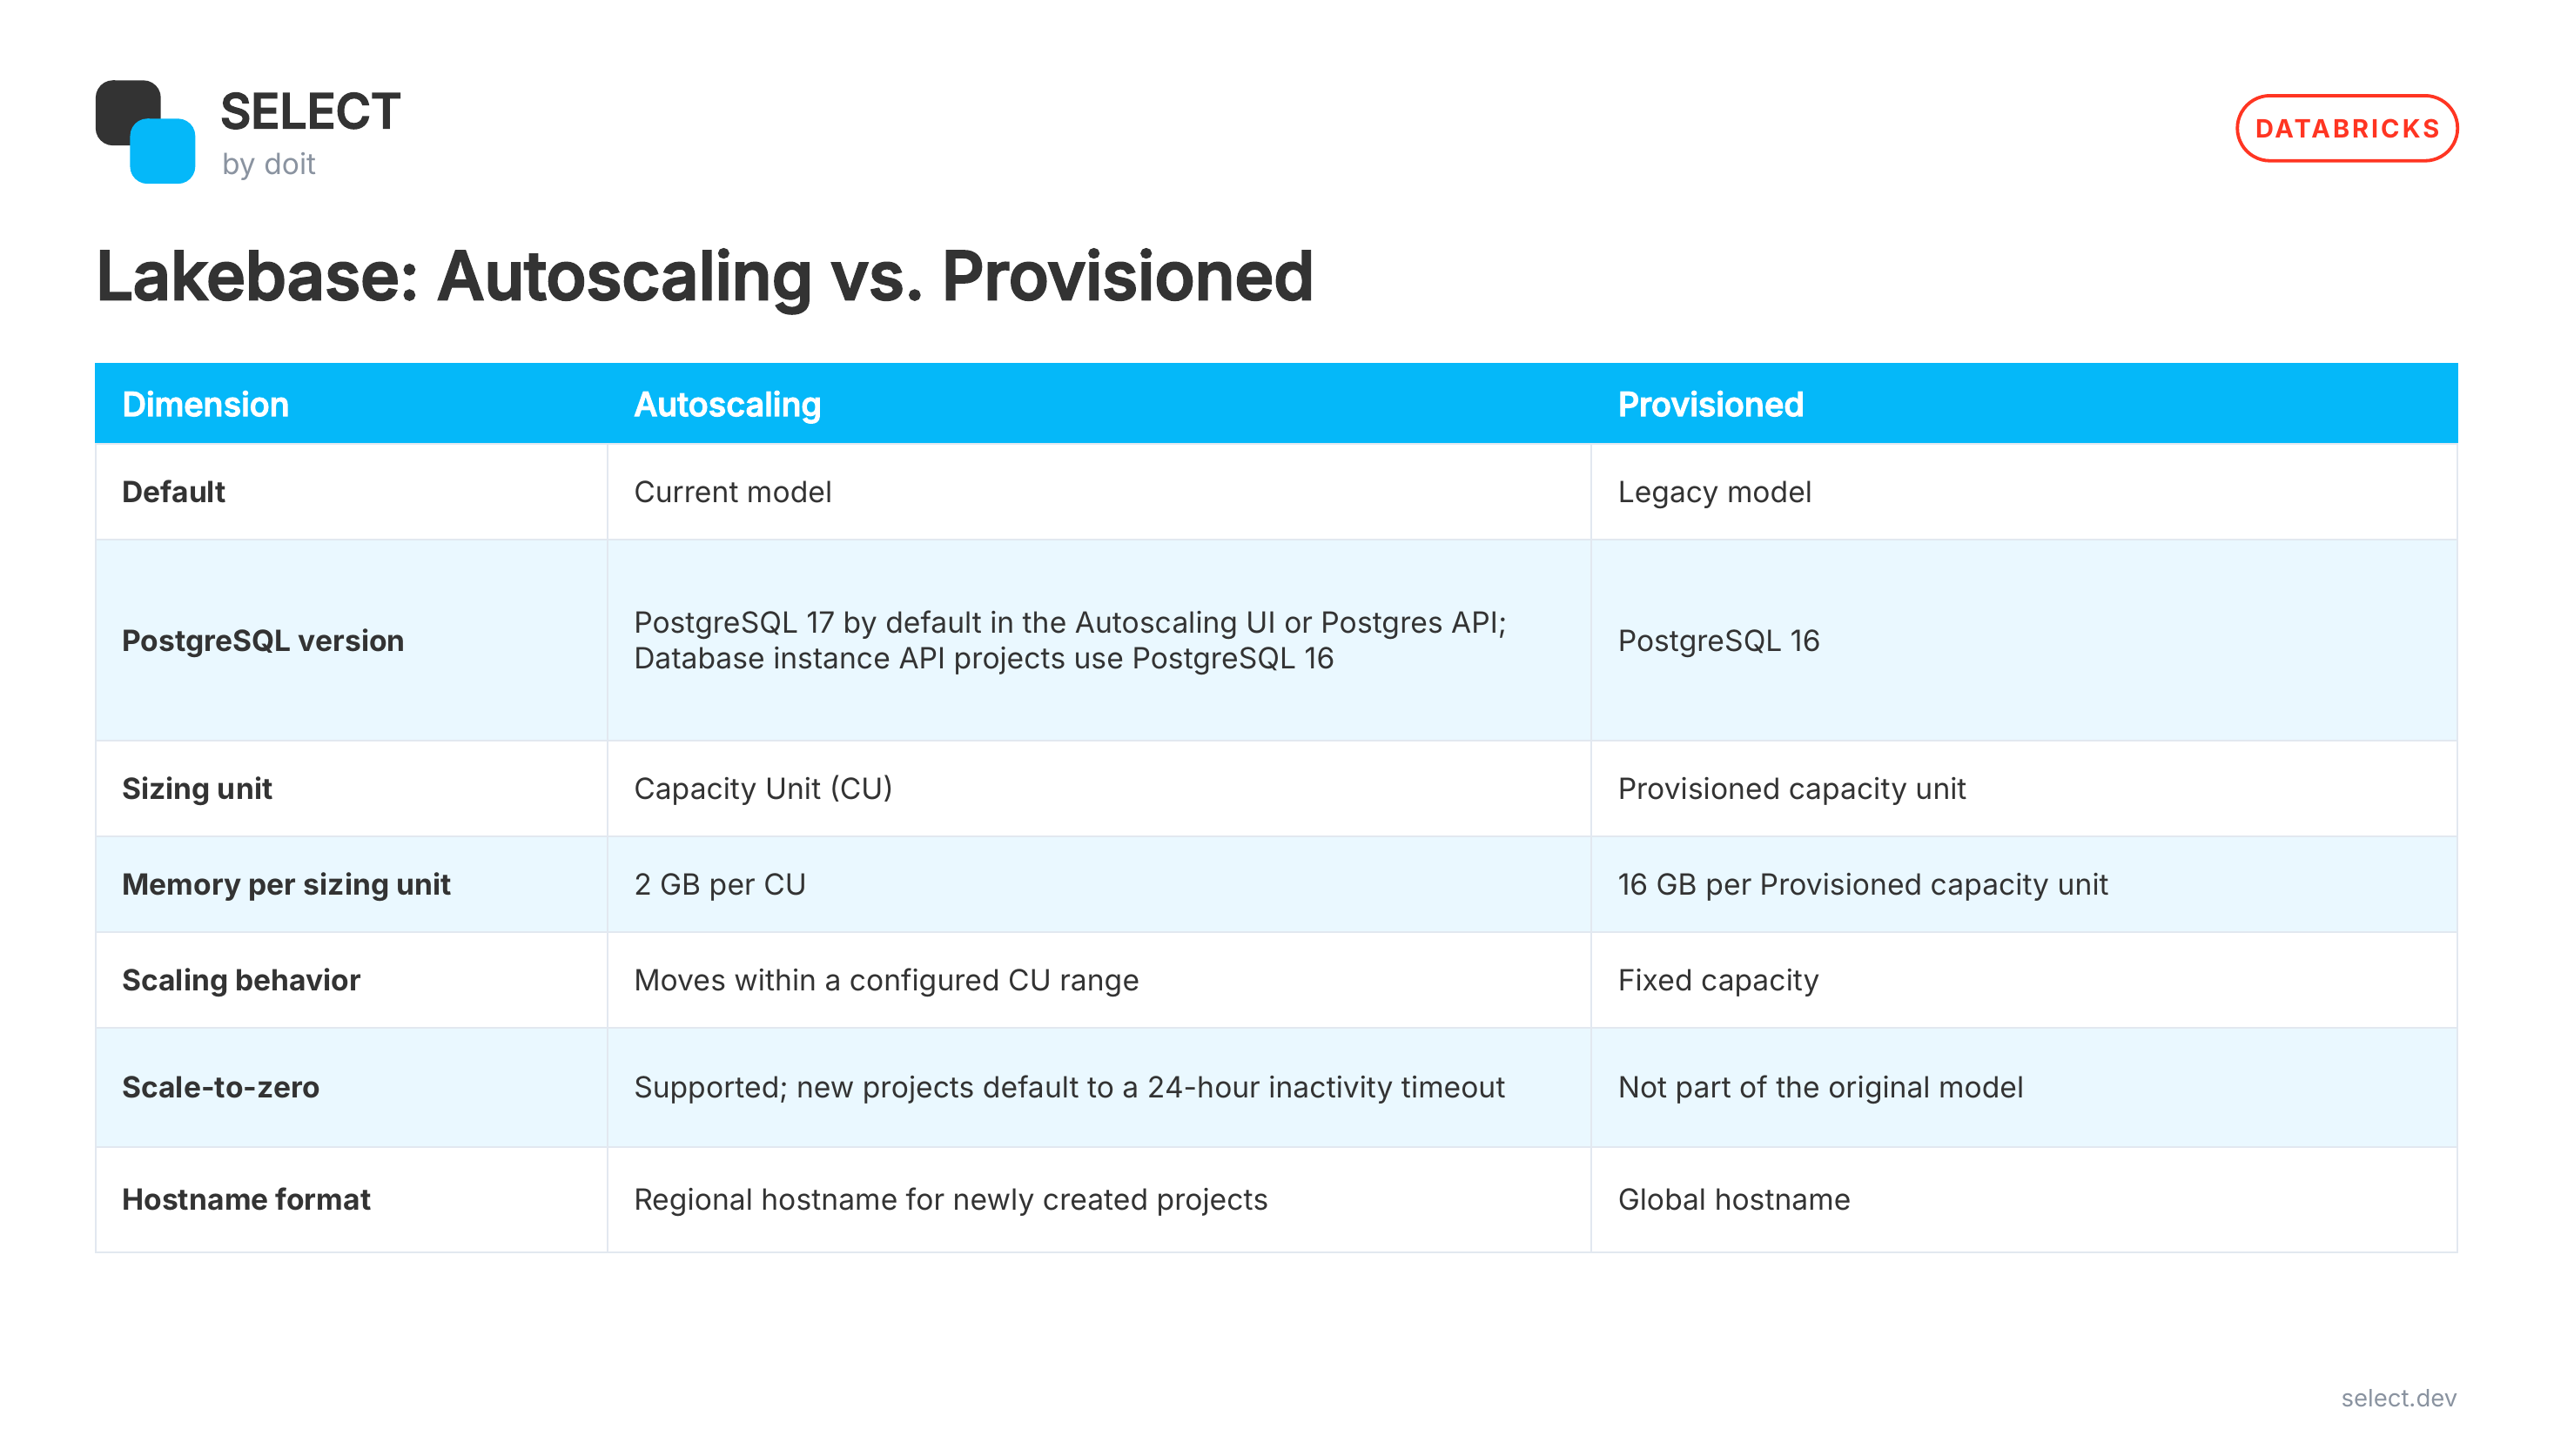
Per la maggior parte dei nuovi design, non c'è più alcuna decisione da prendere tra Provisioned e Autoscaling. La domanda utile è quanto ampio impostare il range di CU e se lo scale-to-zero abbia senso per l'applicazione.
Queste due scelte influenzano sia i costi che il comportamento. Se stai valutando il modello operativo nel suo complesso, l'ottimizzazione dei costi di Databricks copre i driver di costo più ampi tra compute, infrastruttura e design dei workloads.
Un database che riceve burst imprevedibili trae vantaggio dall'avere margine per scalare. Un ambiente di sviluppo poco attivo trae vantaggio dallo scale-to-zero. Un'applicazione di produzione che dipende da sessioni persistenti potrebbe non volere né un limite inferiore aggressivo né un timeout di inattività.
È questo il compromesso da modellare.
Cosa Lakebase non ti offre rispetto a un Postgres standard
La compatibilità con PostgreSQL non equivale a "ogni deployment Postgres si comporta allo stesso modo".
Se stai migrando da RDS, Cloud SQL o un cluster self-managed, testa le assunzioni che la tua applicazione fa sul database, non solo se la sintassi SQL funziona.
Parti dall'amministrazione. L'accesso è legato alla gestione di account e workspace, con utenti gestiti tramite le API della piattaforma. Non dare per scontato che l'automazione che si aspetta la semantica superuser di un PostgreSQL self-managed funzioni senza modifiche.
Ci sono altre lacune da verificare prima della migrazione. I tablespace non sono supportati. La logical replication nativa di PostgreSQL non è attualmente disponibile. Il supporto delle estensioni è selezionato, non illimitato.
Nessuna di queste limitazioni rende automaticamente Lakebase una scelta sbagliata. Diventano problemi quando il tuo sistema esistente dipende da esse.
L'insidia operativa più grande è lo scale-to-zero.
Quando il compute si spegne dopo il periodo di inattività, anche la connessione cade. Le tabelle temporanee spariscono. I prepared statement spariscono. Gli advisory lock spariscono. Lo stato di LISTEN e NOTIFY sparisce. Tutto ciò che esisteva solo all'interno di quella sessione del database è perso.
Un pool applicativo ben progettato dovrebbe riconnettersi senza problemi. Ma molti sistemi di produzione dipendono silenziosamente da connessioni sticky o da stato di sessione di lunga durata senza che nessuno se ne accorga, finché la connessione non sparisce.
Se la tua applicazione rientra in questo caso, correggi la dipendenza oppure disattiva lo scale-to-zero. Non scoprirlo in produzione.
Una buona regola di migrazione è validare come si comporta l'applicazione, non solo se lo schema è compatibile.
Casi d'uso di Lakebase
I casi d'uso più forti di Lakebase sono quelli in cui tenere il database transazionale vicino al resto della piattaforma elimina un vero confine di sistema.
I tre casi d'uso più forti sono lo stato degli agenti, il serving online delle feature e i backend applicativi.
Memoria per agenti AI
Gli agenti AI hanno bisogno di un posto dove conservare lo stato tra un turno e l'altro.
Può trattarsi di contesto utente, output dei tool, avanzamento dei workflow, stato dei task o informazioni specifiche dell'applicazione di cui l'agente avrà di nuovo bisogno in seguito. Quando quello stato conta tra una richiesta e l'altra, serve uno store durevole, non un altro oggetto in memoria dentro il processo di serving.
Uno store PostgreSQL funziona bene quando l'applicazione ha bisogno di accesso SQL diretto e di controllo sul proprio schema. In questo modello, l'applicazione possiede lo stato e lo tiene vicino al resto dell'ambiente Databricks.
Esistono altre opzioni di stato governato, quindi non sceglierei Lakebase solo perché il workload contiene un agente. Sceglilo quando l'agente ha bisogno di stato relazionale controllato dall'applicazione.
Online Feature Store in Lakebase
Il feature serving è un altro caso che calza a pennello, perché il lato offline e quello online vogliono pattern di accesso completamente diversi.
Puoi calcolare le feature da grandi tabelle governate, ma l'endpoint del modello non vuole eseguire una query sul warehouse ogni volta che gli serve customer_risk_score o days_since_last_purchase.
Pubblica invece i valori delle feature in uno store online basato su PostgreSQL usando la sincronizzazione Snapshot, Triggered o Continuous. L'endpoint di serving può poi eseguire lookup a bassa latenza sulla copia operazionale.
La scelta interessante non è se la feature possa essere sincronizzata, ma quanto fresca debba essere davvero.
Se il valore cambia una volta al giorno, Continuous è uno spreco. Se la decisione del modello dipende da qualcosa cambiato 20 secondi fa, Snapshot non basta.
Dovrebbe essere il requisito di freschezza a determinare la modalità di sync.
E lo store online non rende irrilevante il design delle tabelle a monte. [Il modo in cui sono strutturate le tue tabelle Delta influisce sulla latenza di serving, perché la pipeline sorgente deve comunque produrre e sincronizzare valori di feature aggiornati in modo efficiente.
Backend applicativo
Questo è il caso d'uso più lineare.
Un'applicazione ha bisogno di insert, update, delete, indici, letture brevi e concorrenza prevedibile. Può usare il database per queste operazioni transazionali mentre l'analytics resta sulla piattaforma.
Questo include le Databricks Apps, ma non deve necessariamente limitarsi a esse.
La parte più interessante viene dopo. Una volta che l'applicazione inizia a generare record operazionali, il percorso di sync inverso può rendere quelle modifiche disponibili alle tabelle Delta gestite. Analytics, job di audit e pipeline a valle possono consumarle senza che tu debba mettere in piedi una piattaforma CDC esterna separata.
È qui che l'architettura di Lakebase dimostra il proprio valore.
Non la usi perché Postgres è una novità. La usi perché il lato operazionale e quello analitico smettono di sembrare due sistemi scollegati che devi incollare insieme da solo.
I costi di Lakebase e cosa mostra SELECT
Il pricing di Lakebase va considerato separatamente dal modello mentale dei DBU che la maggior parte dei team Databricks già usa.
Il pricing attuale include la tariffazione Always-On per l'autoscaling serverless, con una tariffa base inferiore del 25% e nessun impegno a lungo termine. L'obiettivo è mantenere l'elasticità serverless senza costringere un database di produzione sempre attivo a sostenere la stessa economia di base di un workload che scala regolarmente verso il basso.
È utile, ma significa anche che la tua fattura Databricks complessiva ormai abbraccia più di un modello di pricing.
I job classici possono avere addebiti DBU più infrastruttura cloud. Il serverless include l'infrastruttura in modo diverso. Il model serving segue logiche economiche proprie. I database operazionali aggiungono un ulteriore fronte di costo.
Ecco perché guardare un singolo listino raramente ti dice quanto costa davvero un workload.
La Databricks Cost Optimization Guide di SELECT usa system.billing.usage e system.billing.list_prices come punti di partenza per capire da dove nasce la spesa. Funziona bene per i workloads prezzati in DBU, ma Lakebase va comunque valutato nel contesto del resto dell'ambiente, non come voce di database isolata.
Per il lato processing, come Photon influisce sul costo per job [LINK PENDING].
SELECT combina l'utilizzo di DBU con i costi dell'infrastruttura cloud sottostante, così i team possono attribuire la spesa a job, query, utenti, workspace e altre dimensioni. DoiT dichiara che la connessione usa un service principal in sola lettura e richiede circa 20 minuti di configurazione.
SELECT ti aiuta a valutare Lakebase insieme al resto della fattura della piattaforma. Mostra se aggiungere il layer operazionale riduce il costo e la complessità complessivi dell'architettura o se sposta semplicemente la spesa in un'altra categoria.
È questo il confronto che vale la pena fare.
Se ti serve questa visione più ampia dei costi, i team possono iniziare a usare SELECT in circa 20 minuti. Prenota una demo per vedere come si scompone il resto della tua spesa Databricks insieme al database.
Domande frequenti su Lakebase
Databricks Lakebase è solo un Postgres gestito?
No.
Il database è PostgreSQL, ma il suo valore deriva dall'integrazione con la piattaforma circostante: funzionamento serverless, branching, Synced Tables e il percorso per spostare le modifiche operazionali in tabelle analitiche gestite.
Se queste integrazioni sostituiscono infrastruttura che altrimenti dovresti gestire, le ragioni a favore di Lakebase sono solide. Se ti serve solo un database Postgres generico, confrontalo con altre opzioni di Postgres gestito.
Che differenza c'è tra Synced Tables e Lakehouse Sync?
Risolvono direzioni opposte.
Le Synced Tables pubblicano tabelle sorgente governate in Lakebase quando un'applicazione ha bisogno di accedervi a bassa latenza.
Il Lakehouse Sync copre la direzione inversa. Databricks chiama l'implementazione basata su WAL Change Data Feed: cattura insert, update e delete da PostgreSQL e rende quelle modifiche disponibili in tabelle Delta gestite.
Pensa a "dalla sorgente analitica all'applicazione" per le Synced Tables e a "dalle modifiche applicative di nuovo all'analytics" per il percorso inverso.
Lakebase supporta tutte le estensioni Postgres?
No.
Il supporto delle estensioni è selettivo e può variare in base alla versione di PostgreSQL. Verifica l'elenco aggiornato delle estensioni supportate prima della migrazione, se il tuo deployment esistente su RDS, Cloud SQL o PostgreSQL self-managed dipende da un'estensione specifica.
Questa verifica va fatta all'inizio di una valutazione di migrazione, non alla fine.
Che fine ha fatto Lakebase Provisioned?
Provisioned è il modello legacy.
La creazione di nuove istanze è terminata a marzo 2026 e le istanze esistenti sono passate ad Autoscaling entro luglio 2026. La UI di Provisioned resta temporaneamente disponibile durante la transizione.
Per i nuovi design, concentrati sulle impostazioni di Autoscaling che influenzano il comportamento in produzione: range di CU, timeout di inattività, versione di PostgreSQL e dettagli di connessione per il modello di progetto attuale.
Quando dovrei usare Lakebase per lo stato AI?
Usa Lakebase quando un'applicazione AI ha bisogno di stato relazionale controllato dall'applicazione.
Questo di solito include accesso SQL diretto, uno schema custom, scritture transazionali o contesto durevole che anche altri componenti dell'applicazione devono interrogare.
Se all'agente serve solo memoria, confronta Lakebase con opzioni di memoria gestita di più alto livello. La scelta giusta dipende dal fatto che l'applicazione abbia bisogno di controllo diretto sul modello di stato.