
A Databricks passou anos se consolidando como o lugar onde as equipes processam, governam e analisam dados. A parte complicada começa quando esses dados precisam alimentar uma aplicação.
Um SQL Warehouse é ótimo para varrer milhões de linhas. Mas não é onde você quer uma aplicação fazendo milhares de pequenos inserts, updates e consultas pontuais. Por isso, as equipes acabam caindo em um padrão conhecido: manter a parte analítica no Databricks, subir um Postgres em outro lugar, conectar os dois com CDC ou reverse ETL e, a partir daí, gerenciar esse segundo banco de dados e a camada de sincronização enquanto a aplicação existir.
O Lakebase é a tentativa da Databricks de eliminar essa divisão. A ideia é atraente porque coloca o Postgres ao lado do resto da plataforma, dá às aplicações um banco de dados operacional e move informações entre sistemas transacionais e analíticos sem obrigar as equipes a construir toda essa infraestrutura de integração por conta própria.
Mas o Lakebase não é simplesmente "Postgres dentro do Databricks". A integração vem com trade-offs: a sincronização tem duas direções e dois mecanismos diferentes, e o scale-to-zero muda o que acontece com o estado da sessão. Além disso, compatibilidade com Postgres não significa que todas as premissas de um Postgres autogerenciado continuam valendo — e a economia não se parece com o modelo de DBUs que a maioria das equipes Databricks já conhece.
Uma boa forma de avaliar o Lakebase é focar em saber se esses trade-offs combinam com a aplicação que você realmente precisa rodar.
TL;DR
- Use o Lakebase se sua aplicação precisa de Postgres transacional e seus dados já vivem no Databricks. A integração elimina o pipeline de CDC que você teria que construir e manter
- Não use como substituto genérico de Postgres gerenciado. Se sua aplicação não tem nenhuma dependência de analytics, governança ou workflows de IA do Databricks, um Postgres gerenciado independente é mais simples
- Verifique o suporte a extensões e o comportamento do estado de sessão antes de migrar qualquer coisa do RDS ou do Cloud SQL
O problema que o Lakebase nasceu para eliminar
Workloads analíticas e transacionais impõem demandas muito diferentes a um banco de dados, e é aí que começa a divisão arquitetural.
Seu SQL Warehouse foi construído para Online Analytical Processing (OLAP), lidando com grandes varreduras, joins, agregações e consultas que podem tocar milhões ou bilhões de linhas. Um backend de aplicação vive no mundo do Online Transaction Processing (OLTP), onde transações curtas, concorrência previsível, consultas pontuais e inserts ou updates em milissegundos importam mais.
Tentar fazer um sistema se comportar como o outro geralmente termina mal.
Antes do Lakebase, a resposta prática era adicionar um Postgres. Manter o lado analítico na plataforma Databricks, rodar uma instância ou serviço hospedado de PostgreSQL para a aplicação e conectar os dois com Change Data Capture, reverse ETL ou jobs customizados.
Funciona. Mas também te dá mais um sistema de produção para cuidar.
Agora você está gerenciando credenciais do PostgreSQL, mudanças de schema, recuperação de falhas, rede, atraso de sincronização e tudo o que quebra quando o schema transacional muda antes de o pipeline analítico acompanhar. O banco de dados em si raramente é a parte dolorosa. Manter dois sistemas alinhados é.
Esse é o problema que o Lakebase tenta eliminar.
E claramente existe demanda. A Databricks afirma que a adoção desde junho de 2025 cresceu a mais do que o dobro da taxa de seu produto de warehousing, e reporta milhares de empresas rodando workloads de produção sobre registros operacionais.
O dado de adoção é interessante, mas não é o motivo para escolher o produto. A pergunta real é se manter seu banco de dados transacional dentro da mesma plataforma elimina trabalho operacional suficiente para justificar as novas restrições que vêm junto.
O que é o Databricks Lakebase?
O Lakebase Postgres é um serviço Postgres totalmente gerenciado dentro da plataforma Databricks. O Lakebase separa completamente computação de armazenamento, de modo que a camada de computação pode se ajustar à demanda enquanto o armazenamento permanece durável.
Essa separação é o que torna possíveis recursos como autoscaling e scale-to-zero. Quando o banco de dados está ocioso, a computação pode ser desligada em vez de ficar parada esperando tráfego. Quando a atividade volta, ela retorna sem precisar reconstruir o banco armazenado.
Para desenvolvimento, branches instantâneos e clones zero-copy são igualmente interessantes. Em vez de copiar um banco de produção inteiro toda vez que alguém precisa de um ambiente isolado, a equipe pode criar um branch do banco e trabalhar nessa cópia sem duplicar todo o armazenamento subjacente.
A tecnologia vem da Neon. A Databricks anunciou o acordo para adquirir a empresa de Postgres serverless em 14 de maio de 2025, pouco antes de lançar o Lakebase.
Mas a tecnologia do banco de dados é só metade da história. O motivo para avaliar o Lakebase em vez de outro provedor de Postgres gerenciado é a integração ao redor dele.
Esse design integrado ao Databricks conecta o banco de dados a recursos da plataforma como o Unity Catalog, Synced Tables e o caminho reverso de mudanças de volta para tabelas Delta. Se sua aplicação já vive ao lado de Databricks Apps, sistemas de IA, pipelines de features ou workflows analíticos, essa proximidade pode eliminar uma quantidade surpreendente de trabalho de integração.
Se nenhuma dessas integrações importa para sua aplicação, a justificativa fica bem menos óbvia. Nessa situação, você está basicamente comparando uma implementação de Postgres gerenciado com outra.
O Lakebase atingiu disponibilidade geral na AWS em 3 de fevereiro de 2026, seguido pelo Azure em 3 de março de 2026.
Como funciona a sincronização bidirecional
É aqui que a arquitetura fica mais interessante.
"Sincronização bidirecional" pode dar a impressão de que um único mecanismo de replicação espelha continuamente as mesmas tabelas nas duas direções. Não é esse o modelo aqui. O Lakebase tem dois caminhos direcionais que resolvem dois problemas diferentes:
- Synced Tables trazem tabelas de origem governadas para dentro do Lakebase quando uma aplicação precisa de acesso de baixa latência a registros analíticos ou governados.
- Lakehouse Sync move mudanças do banco de dados operacional para tabelas Delta gerenciadas, para analytics, auditoria e processamento downstream.
A direção importa porque os mecanismos, o modelo de propriedade e as restrições operacionais são diferentes em cada lado.
Do Lakehouse para o Lakebase – Synced Tables
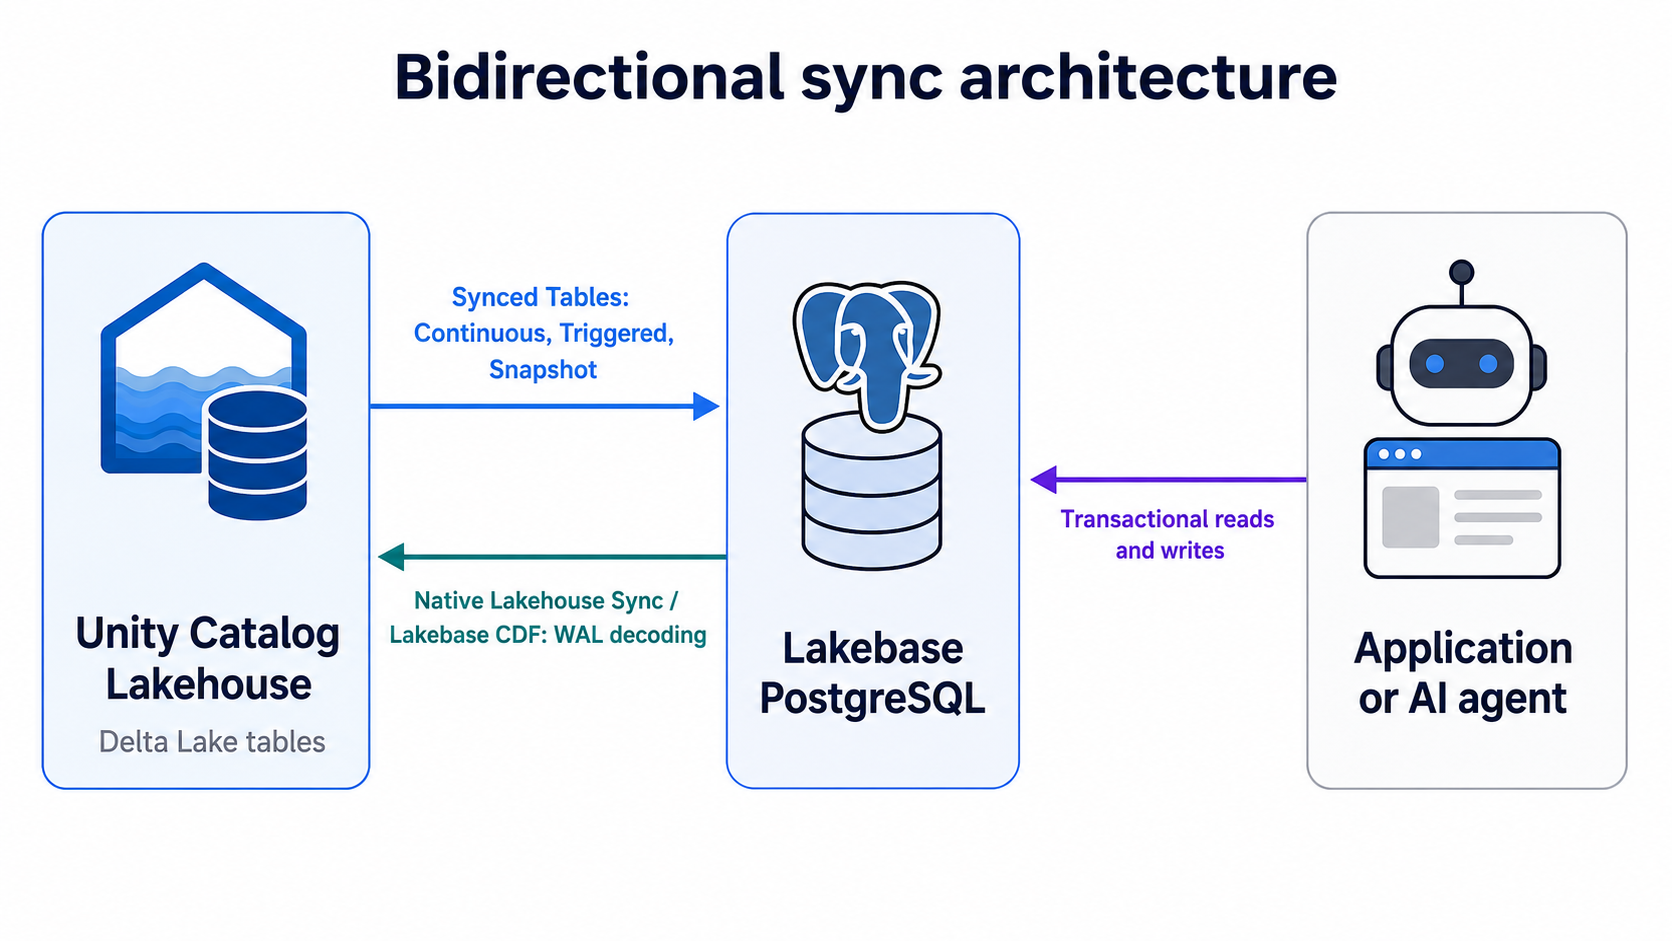
As Synced Tables servem para o caso em que a fonte da verdade já existe em tabelas analíticas governadas, mas uma aplicação precisa ler essas informações com latência de banco de dados.
Em vez de fazer a aplicação consultar tabelas analíticas diretamente, o processo de sincronização publica a origem relevante no Lakebase. As aplicações então acessam a cópia sincronizada pela interface do PostgreSQL usando drivers padrão.
Esse modelo de propriedade é importante. Trate uma synced table como algo controlado pelo pipeline de sincronização, e não como mais uma tabela da aplicação que você por acaso está replicando. Acesso somente leitura pela aplicação é o padrão mais seguro.
Você tem três modos de sincronização:
- Snapshot faz uma cópia única. É a escolha mais direta para publicação em massa, origens sem Delta Change Data Feed ou casos em que uma grande porcentagem da tabela muda entre atualizações.
- Triggered faz atualizações incrementais quando você o executa ou de forma agendada. Costuma ser a melhor opção quando os requisitos de atualidade são medidos em minutos ou horas, não em segundos.
- Continuous mantém as mudanças fluindo com latência de segundos. Você tem o menor atraso, mas também mantém a maquinaria de sincronização ativa o tempo todo.
Escolha Continuous quando a aplicação tiver um requisito de atualidade medido que Snapshot ou Triggered não conseguem atender. Sincronização em tempo real traz custo e overhead operacional, então o requisito de atualidade é o que deve determinar o modo de sincronização.
Também existem limites de dimensionamento que vale a pena considerar no planejamento.
Gravações Continuous e Triggered são estimadas em cerca de 150 linhas por segundo por Capacity Unit, enquanto gravações Snapshot podem chegar a 2.000 linhas por segundo por CU.
Trate esses números como referências práticas de planejamento de capacidade, já que o throughput real vai variar com o formato da tabela, a indexação e os padrões de mudança.
O tamanho lógico agregado entre as synced tables é limitado a 16 TB. Não há uma cota rígida separada para uma tabela individual, mas a Databricks recomenda manter tabelas que exigem refresh em até 1 TB.
É fácil deixar o comportamento do refresh passar despercebido. Durante um refresh completo, a versão sincronizada antiga continua disponível enquanto a substituta é construída. As duas versões consomem armazenamento temporariamente contra a cota lógica do banco de dados.
Se você já está perto do limite, um refresh pode ser justamente o que te faz ultrapassá-lo. Planeje capacidade para o refresh, não só para o estado estável.
Autoscaling vs Provisioned: o que mudou em março de 2026
Materiais mais antigos sobre o Lakebase podem confundir a transição de Provisioned para Autoscaling, mas para projetos atuais essa distinção é, em grande parte, histórica.
Provisioned e Autoscaling eram modelos de operação diferentes. Hoje, essa distinção é majoritariamente histórica.
Novas instâncias passaram para Autoscaling por padrão em 12 de março de 2026. As instâncias Provisioned existentes foram atualizadas ao longo de julho de 2026, e a UI antiga permanece disponível apenas como interface temporária de transição até 1º de setembro de 2026.
O modelo de dimensionamento mudou substancialmente. O Autoscaling usa Capacity Units, com 2 GB de RAM por CU. O modelo Provisioned mais antigo usava uma unidade de capacidade provisionada com 16 GB de RAM por unidade.
Não se trata apenas de uma unidade menor. O Autoscaling pode se mover dentro de uma faixa configurada de CUs conforme a demanda muda. Provisioned significava escolher uma quantidade fixa de capacidade e conviver com ela até você alterar a configuração.
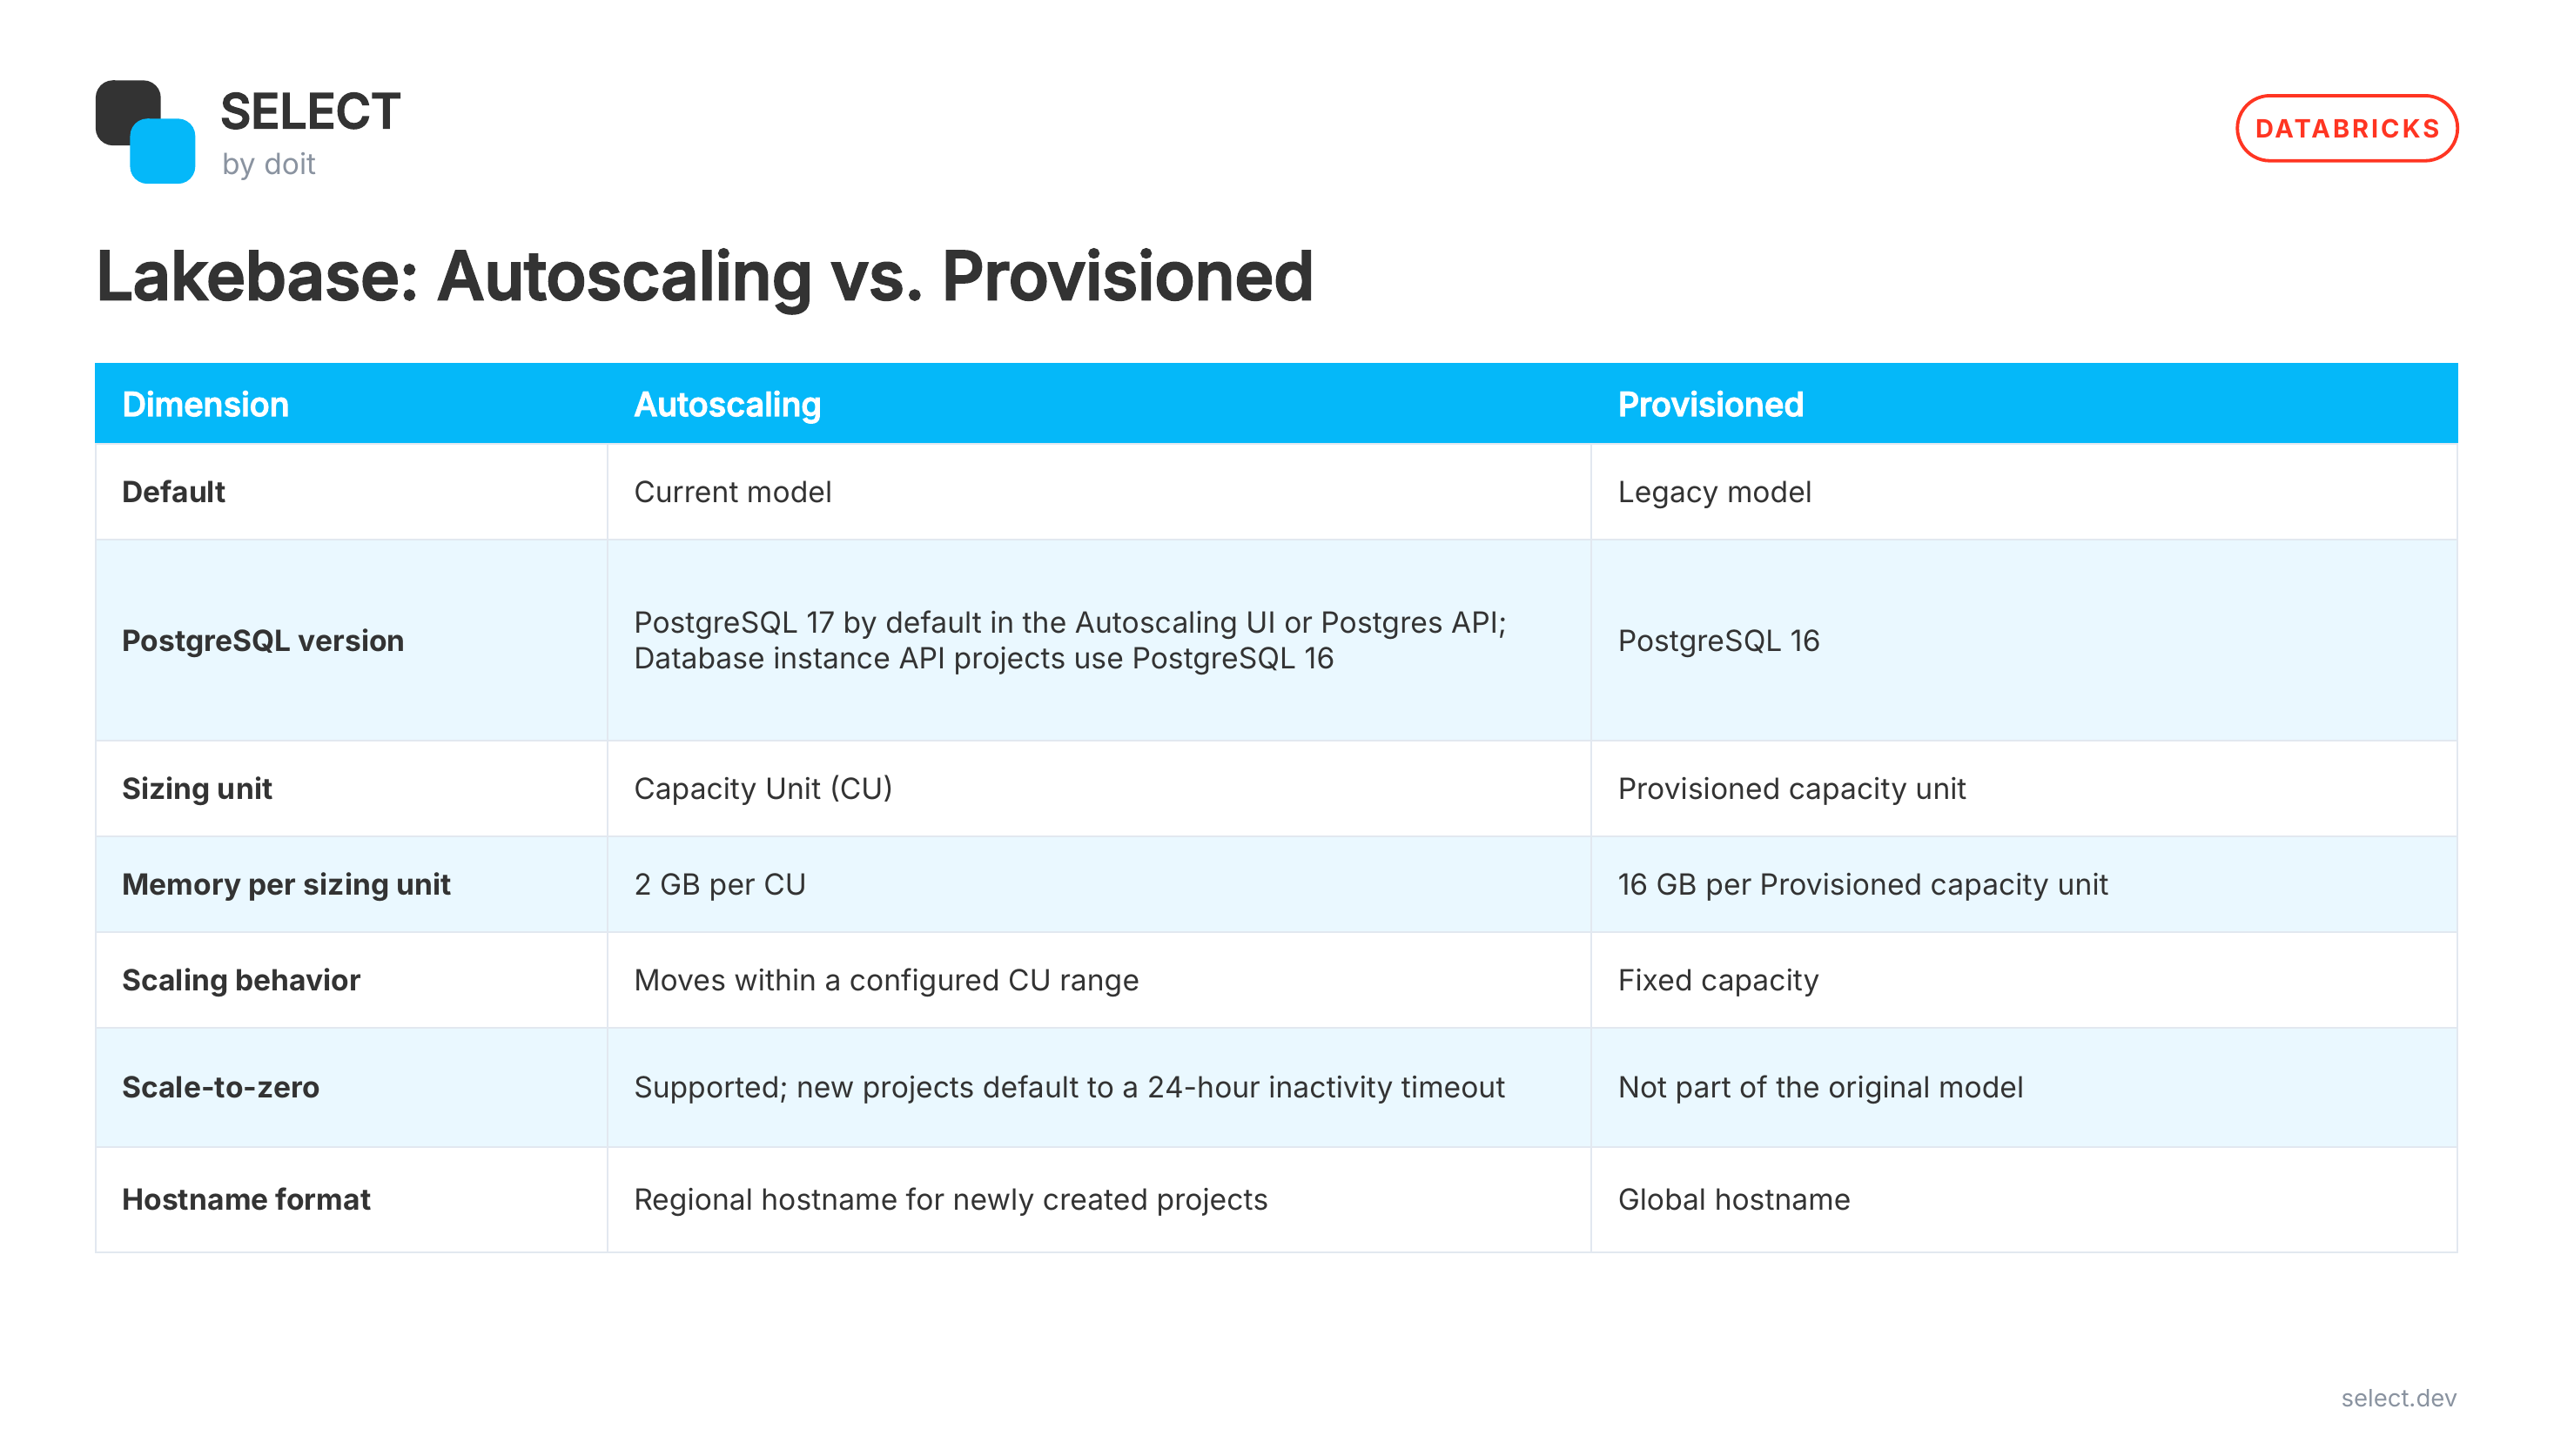
Para a maioria dos novos projetos, não há mais decisão a tomar entre Provisioned e Autoscaling. A pergunta útil é qual deve ser a largura da faixa de CUs e se o scale-to-zero faz sentido para a aplicação.
Essas duas escolhas afetam tanto o custo quanto o comportamento. Se você está avaliando o modelo de operação de forma mais ampla, otimização de custos do Databricks cobre os principais fatores de custo em computação, infraestrutura e design de workloads.
Um banco de dados que recebe picos imprevisíveis se beneficia de espaço para escalar. Um ambiente de desenvolvimento com pouco uso se beneficia do scale-to-zero. Uma aplicação de produção que depende de sessões persistentes talvez não queira nem um limite inferior agressivo nem um timeout de inatividade.
Esse é o trade-off a modelar.
O que o Lakebase não oferece em relação ao Postgres padrão
Compatibilidade com PostgreSQL não é a mesma coisa que "todo deployment de Postgres se comporta igual".
Se você está migrando do RDS, do Cloud SQL ou de um cluster autogerenciado, teste as premissas que sua aplicação faz sobre o banco de dados, não apenas se a sintaxe SQL funciona.
Comece pela administração. O acesso está vinculado à gestão da conta e do workspace, com usuários gerenciados por APIs da plataforma. Não assuma que automações que esperam semântica de superusuário de um PostgreSQL autogerenciado vão funcionar sem mudanças.
Há outras lacunas que vale a pena verificar antes da migração. Tablespaces não são suportados. A replicação lógica nativa do PostgreSQL não está disponível no momento. O suporte a extensões é curado, não irrestrito.
Nenhuma dessas limitações torna automaticamente o Lakebase uma má escolha. Elas viram problema quando seu sistema atual depende delas.
A maior pegadinha operacional é o scale-to-zero.
Quando a computação desliga após o período de inatividade, a conexão vai junto. Tabelas temporárias desaparecem. Prepared statements desaparecem. Advisory locks desaparecem. O estado de LISTEN e NOTIFY desaparece. Tudo o que só existia dentro daquela sessão do banco se vai.
Um pool de aplicação bem-comportado deve reconectar sem problemas. Mas muitos sistemas de produção dependem silenciosamente de conexões fixas ou de estado de sessão de longa duração sem que ninguém perceba — até a conexão desaparecer.
Se sua aplicação faz isso, corrija a dependência ou desligue o scale-to-zero. Não descubra isso em produção.
Uma boa regra de migração é validar como a aplicação se comporta, não apenas se o schema é compatível.
Casos de uso do Lakebase
Os casos de uso mais fortes do Lakebase são aqueles em que manter o banco de dados transacional perto do resto da plataforma elimina uma fronteira real entre sistemas.
Os três casos de uso mais fortes são estado de agentes, serving online de features e backends de aplicação.
Memória de agentes de IA
Agentes de IA precisam de algum lugar para manter estado entre interações.
Isso pode incluir contexto do usuário, saídas de ferramentas, progresso de workflows, status de tarefas ou informações específicas da aplicação que o agente vai precisar de novo mais tarde. Quando esse estado passa a importar entre requisições, ele precisa de um armazenamento durável, não de mais um objeto em memória dentro do processo de serving.
Um armazenamento PostgreSQL funciona bem quando a aplicação precisa de acesso SQL direto e de controle sobre o próprio schema. Nesse modelo, a aplicação é dona do estado e o mantém perto do resto do ambiente Databricks.
Existem outras opções governadas de estado, então eu não escolheria o Lakebase só porque a workload contém um agente. Escolha-o quando o agente precisa de estado relacional controlado pela aplicação.
Feature store online no Lakebase
O serving de features é outro encaixe natural, porque os lados offline e online querem padrões de acesso completamente diferentes.
Você pode calcular features a partir de grandes tabelas governadas, mas o endpoint do modelo não quer rodar uma consulta de warehouse toda vez que precisa de customer_risk_score ou days_since_last_purchase.
Em vez disso, publique os valores das features em um store online baseado em PostgreSQL usando sincronização Snapshot, Triggered ou Continuous. O endpoint de serving pode então fazer consultas de baixa latência contra a cópia operacional.
A escolha interessante não é se a feature pode ser sincronizada. É quão atualizada ela realmente precisa estar.
Se o valor muda uma vez por dia, Continuous é desperdício. Se a decisão do modelo depende de algo que mudou 20 segundos atrás, Snapshot não basta.
Esse requisito de atualidade é o que deve determinar o modo de sincronização.
E o store online não torna irrelevante o design das tabelas upstream. [A forma como suas tabelas Delta estão organizadas afeta a latência de serving, porque o pipeline de origem ainda precisa produzir e sincronizar valores de features atualizados com eficiência.
Backend de aplicação
Este é o caso de uso mais direto.
Uma aplicação precisa de inserts, updates, deletes, índices, leituras curtas e concorrência previsível. Ela pode usar o banco de dados para essas operações transacionais enquanto o analytics fica na plataforma.
Isso inclui Databricks Apps, mas não precisa se limitar a eles.
A parte mais interessante vem depois. Quando a aplicação começa a gerar registros operacionais, o caminho de sincronização reversa pode disponibilizar essas mudanças em tabelas Delta gerenciadas. Analytics, jobs de auditoria e pipelines downstream podem consumi-las sem que você precise montar uma plataforma externa de CDC separada.
É aqui que a arquitetura do Lakebase se paga.
Você não está usando porque Postgres é novidade. Você está usando porque os lados operacional e analítico deixam de parecer dois sistemas sem relação que você mesmo precisa costurar.
Custos do Lakebase e o que o SELECT mostra
O preço do Lakebase precisa ser analisado separadamente do modelo mental de DBUs que a maioria das equipes Databricks já usa.
O preço atual inclui o modelo Always-On para autoscaling serverless, com uma taxa base 25% menor e sem compromisso de longo prazo. O objetivo é manter a elasticidade do serverless sem forçar um banco de produção sempre ativo a pagar a mesma base de custo de uma workload que reduz escala regularmente.
Isso é útil, mas também significa que sua fatura total do Databricks agora abrange mais de um modelo de preço.
Jobs clássicos podem ter cobranças de DBU mais infraestrutura de nuvem. O serverless embute a infraestrutura de outra forma. O model serving tem sua própria economia. Bancos de dados operacionais adicionam mais uma frente de custo.
É por isso que olhar para uma única tabela de preços raramente diz quanto uma workload realmente custa.
O Guia de Otimização de Custos do Databricks do SELECT usa system.billing.usage e system.billing.list_prices como pontos de partida para entender de onde vêm os gastos. Isso funciona bem para workloads precificadas em DBU, mas o Lakebase ainda deve ser avaliado no contexto do restante do ambiente, e não como um item isolado de banco de dados.
Para o lado do processamento, veja como o Photon afeta o custo por job [LINK PENDING].
O SELECT combina o uso de DBUs com os custos subjacentes de infraestrutura de nuvem para que as equipes possam atribuir gastos a jobs, consultas, usuários, workspaces e outras dimensões. A DoiT afirma que a conexão usa um service principal somente leitura e leva cerca de 20 minutos para configurar.
O SELECT te ajuda a avaliar o Lakebase ao lado do resto da fatura da sua plataforma. Ele mostra se adicionar a camada operacional reduz o custo e a complexidade geral da arquitetura ou se apenas desloca o gasto para outra categoria.
Essa é a comparação que vale a pena fazer.
Se você precisa dessa visão mais ampla de custos, é possível começar com o SELECT em aproximadamente 20 minutos. Agende uma demo para ver como o restante do seu gasto com Databricks se distribui junto com o banco de dados.
Perguntas frequentes sobre o Lakebase
O Databricks Lakebase é só um Postgres gerenciado?
Não.
O banco de dados é PostgreSQL, mas o valor vem da integração com a plataforma ao redor, incluindo operação serverless, branching, Synced Tables e o caminho para mover mudanças operacionais para tabelas analíticas gerenciadas.
Se essas integrações substituem infraestrutura que você teria que operar, o Lakebase tem um argumento forte. Se você só precisa de um banco Postgres de uso geral, compare-o com outras opções de Postgres gerenciado.
Qual é a diferença entre Synced Tables e Lakehouse Sync?
Cada um resolve uma direção oposta.
As Synced Tables publicam tabelas de origem governadas no Lakebase quando uma aplicação precisa de acesso de baixa latência a elas.
O Lakehouse Sync cobre a direção inversa. A Databricks chama a implementação baseada em WAL de Change Data Feed, que captura inserts, updates e deletes do PostgreSQL e disponibiliza essas mudanças em tabelas Delta gerenciadas.
Pense em "origem analítica para a aplicação" para as Synced Tables e "mudanças da aplicação de volta para o analytics" para o caminho reverso.
O Lakebase suporta todas as extensões do Postgres?
Não.
O suporte a extensões é curado e pode variar conforme a versão do PostgreSQL. Verifique a lista atual de extensões suportadas antes da migração se seu deployment existente de RDS, Cloud SQL ou PostgreSQL autogerenciado depende de uma extensão específica.
Essa verificação deve acontecer no início da avaliação de migração, não no final.
O que aconteceu com o Lakebase Provisioned?
Provisioned é o modelo legado.
A criação de novas instâncias terminou em março de 2026, e as instâncias existentes migraram para Autoscaling ao longo de julho de 2026. A UI do Provisioned permanece temporariamente disponível durante a transição.
Para novos projetos, foque nas configurações de Autoscaling que afetam o comportamento em produção, incluindo a faixa de CUs, o timeout de inatividade, a versão do PostgreSQL e os detalhes de conexão do modelo de projeto atual.
Quando devo usar o Lakebase para estado de IA?
Use o Lakebase quando uma aplicação de IA precisa de estado relacional controlado pela aplicação.
Isso normalmente inclui acesso SQL direto, um schema customizado, gravações transacionais ou contexto durável que outros componentes da aplicação também precisam consultar.
Se o agente só precisa de memória, compare o Lakebase com opções gerenciadas de memória de nível mais alto. A escolha certa depende de a aplicação precisar ou não de controle direto sobre o modelo de estado.