
TL;DR
Databricks Unity Catalog ist die Governance-Schicht über Ihren Workspaces: ein Metastore pro Cloud-Region, ein dreistufiger Namespace und ein einheitlicher Satz an Grants, der überall dort gilt, wo dieser Metastore angebunden ist. Ob das Ganze für Sie funktioniert, entscheidet nicht die Feature-Liste, sondern die Frage, wie Sie Kataloge und Schemas organisieren. Diese Antwort ist spezifisch für Ihre Organisation – und sie ändert sich, wenn Sie wachsen.
Einleitung
Die meisten Erklärungen zu Databricks Unity Catalog enden bei der Definition. Sie erfahren, dass es eine einheitliche Governance-Schicht ist, dass der Namespace drei Ebenen statt zwei hat und dass Lineage gleich mitgeliefert wird. Alles richtig – und nichts davon beantwortet die Frage, die sich zwanzig Sekunden später stellt: Was soll ein Katalog repräsentieren? Gehören Bronze, Silver und Gold in getrennte Schemas? Und was macht das alles mit der Rechnung? Dieser Beitrag erklärt, was Unity Catalog ist und wie er funktioniert, und widmet dann die meiste Zeit dem Teil, über den niemand schreibt: wie man ihn organisiert – und warum diese Entscheidung Kostenfolgen hat, mit denen Sie nicht rechnen.
Was ist Databricks Unity Catalog und warum ist er wichtig?
Die Governance-Lücke, die Unity Catalog schließen soll
Vor Unity Catalog lag der Metastore im Workspace. Der Namespace hatte zwei Ebenen (schema.table), sodass sich Umgebung oder Ownership nirgends ausdrücken ließen außer im Namen selbst. Gruppen waren Workspace-lokal, der Zugriff eines Users musste also in jedem Workspace, den er nutzte, neu aufgebaut werden. Die Zugriffskontrolle hing am Compute statt am Datenobjekt – dieselbe Tabelle konnte lesbar sein oder nicht, je nachdem, von welchem Cluster aus man sie öffnete. Lineage und Audit existierten nicht.
Unity Catalog verlagert den Metastore auf Account-Ebene, mit Geltungsbereich einer Cloud-Region. Ein Metastore wird an viele Workspaces angebunden, ein einmal erteiltes Privileg gilt in allen, und der Grant liegt am Datenobjekt statt an dem Compute, der es gerade liest.
Was tatsächlich im dreistufigen Namespace liegt
Die dritte Ebene von catalog.schema.table enthält mehr als nur Tabellen: Views (inklusive materialisierter und Metric Views), Volumes und Functions – darunter UDFs, Stored Procedures und MLflow-Modelle. Eine weitere Gruppe von Securable Objects liegt direkt unter dem Metastore: Storage Credentials, External Locations, Connections, Shares und Clean Rooms.
Volumes lohnen einen zweiten Blick, denn sie erweitern dasselbe Grant-Modell auf Dateien im Cloud-Speicher. READ VOLUME verhält sich wie SELECT auf einer Tabelle: am Objekt verankert, nicht am lesenden Compute – genau das, was Mounts nie konnten.
Warum Unity Catalog nicht mehr optional ist
Entscheidend ist der Sog: Serverless Compute, Lakeflow, Genie, Model Serving, Vector Search und Lakebase setzen allesamt Unity Catalog voraus. System Tables ebenfalls. Beim Hive-Metastore zu bleiben bedeutet nicht nur schlechtere Governance, sondern den Ausschluss von fast allem, was Databricks in den letzten drei Jahren ausgeliefert hat. Der Druck von der anderen Seite ist geringer: Ab dem 30. September 2026 stellt Databricks neue Workspaces ohne Hive-Metastore bereit; bestehende Workspaces sind nicht betroffen.
Wie sollten Sie Ihre Kataloge und Schemas organisieren?
An dieser Stelle schweigt die Dokumentation. Databricks sagt, Kataloge würden "typischerweise" nach Organisationseinheit oder Lifecycle-Scope organisiert – und lässt Sie damit allein. Drei Dinge gehören vor jede Empfehlung:
Die richtige Antwort ist spezifisch für Ihre Organisation. Kein Layout lässt sich von einem fünfköpfigen Plattformteam auf eine föderierte Organisation mit Engineers in jeder Business Unit übertragen. Genau deshalb schreiben so wenige darüber.
Die richtige Antwort ändert sich. Zu glauben, die erste Implementierung überstehe unbegrenztes Wachstum, ist utopisch. Das Ziel ist keine Struktur, die sich nie ändert, sondern eine, deren Änderungen günstig sind.
Größe und Reifegrad Ihres Teams bestimmen den Startpunkt. Ein zentrales Team von sechs Personen braucht nicht, was eine verteilte Organisation mit sechzig Leuten braucht – und es zu früh einzuführen, kostet mehr, als es spart.
Was folgt, ist das, wobei ich bei Kunden aus Finanzwesen, Luft- und Raumfahrt und Energie immer wieder lande – samt Begründung, damit Sie die Begründung hinterfragen können statt nur die Schlussfolgerung.
Wie Vererbung funktioniert – und warum sie jede andere Entscheidung bestimmt
Zwei Regeln prägen das gesamte Layout.
Der Speicherort wird standardmäßig am Metastore gesetzt und kann auf Katalog- und Schema-Ebene überschrieben werden. Jedes Objekt erbt vom nächstgelegenen Elternobjekt.
Grants vererben sich von Katalogen und Schemas nach unten. SELECT auf einem Katalog erreicht jede aktuelle und künftige Tabelle, View und Volume darin. Es gibt kein DENY im Grant-Modell, ein geerbter Grant lässt sich also nicht für ein einzelnes Kindobjekt widerrufen. ABAC-Policies und Row Filter liefern etwas DENY-Ähnliches und sind durchaus nützlich, aber sie sind weniger offensichtlich und weniger robust als ein Grant: Der Grant sagt Ja, während eine Policy an anderer Stelle leise Nein sagt – und wer den Grant liest, sieht das nicht. Setzen Sie sie gezielt ein, nicht als Notlösung für ein Layout, das nicht passt.
Daraus folgt der Kern des ganzen Arguments: Die Ebene, auf der Sie Grants vergeben wollen, ist die Ebene, der Ihr Layout Bedeutung geben muss. Wenn Ihre Schemas nicht Gruppen von Personen entsprechen, die dieselben Daten sehen sollen, landen Sie bei Grants Tabelle für Tabelle.
Kataloge nach Umgebung – meistens
Für ein zentrales Datenteam richten Sie Kataloge an den Deployment-Umgebungen aus.
- Speicherort. Getrennter Speicher pro Umgebung ist gängige Praxis und oft regulatorische Pflicht. Einmal am Katalog gesetzt, erbt ihn jede Tabelle.
- CI/CD. Liegt die Umgebung auf der obersten Ebene, wird die Promotion zu einer Variablensubstitution statt zu einem Rewrite.
- Workspace-Ausrichtung. Die meisten Teams richten Workspaces ohnehin an Umgebungen aus, und Workspace-Catalog-Binding kann das erzwingen.
- Lineage. Jede andere Komponente auf Katalog-Ebene erzeugt katalogübergreifende Lineage-Graphen, die schwerer zu lesen sind.
Die Nuance ist die Team-Topologie. Hat jede Business Unit eigene Data Engineers, die eigene Pipelines bauen, passt ein Katalog pro Business Unit besser, weil die Katalog-Grenze dann der Ownership-Grenze entspricht. Die Empfehlung "ein Katalog pro Umgebung" gilt für ein zentrales Team und hört in dem Moment auf zu gelten, in dem sich die Produzenten vervielfachen.
Zwei Dinge machen diesen Übergang verkraftbar. Verwenden Sie von Anfang an Präfixe: Nennen Sie Ihren ersten Katalog nicht prd. Nennen Sie ihn edp_prd nach dem Plattformteam oder etwas Generisches wie analytics_prd. Das kostet am ersten Tag nichts – und wenn später finance_prd und hr_prd dazukommen, bleibt das Modell konsistent, statt dass ein Katalog ohne Präfix neben einer Familie von Business-Unit-Katalogen steht. Wählen Sie Namen, die eine Umstrukturierung überleben: Ein Katalog, der nach einer Abteilung benannt ist, die alle achtzehn Monate umbenannt wird, ist eine Umbenennung, die Sie nie vornehmen werden – und wird damit zur Lüge in Ihrem Namespace.
Schemas nach Datenproduzent und Datenprodukt
Der umstrittenste Teil. Mein Default ist ein Hybrid: Bronze- und Silver-Tabellen liegen in einem Schema, das nach dem Datenproduzenten benannt ist, Gold-Tabellen in einem Schema, das nach der Business Unit oder dem Datenprodukt benannt ist.
Der Instinkt ist, einen kompletten Flow unter ein Schema zu packen. In einfachen Fällen funktioniert das, in den meisten greift es zu kurz:
- Ownership-Trennung. Viele Teams teilen die Arbeit: Eine Kerngruppe baut Bronze und Silver mit Engineering-Disziplin, während Analysten und Fachexperten die Gold-Aggregationen bauen. Die Schema-Grenze entspricht der Ownership-Grenze.
- Zugriffskontrolle. Wer ein Quellsystem betreibt, sollte in der Regel die Daten sehen, die es produziert. Business-User sollten sehen, was ihre Einheit aggregiert. Beides sind hier Grants auf Schema-Ebene. In einem Flow-basierten Layout ist es keines von beiden.
- Datenqualität. Jedes Dataset für das Business wird aus bereinigten Produzentendaten gebaut statt aus Rohdaten.
Machen Sie die beiden Rollen im Namen explizit: source_<source_name> für Produzenten, bu_<bu_name> für Business Units und Produkte. Manchmal landen Sie bei source_hr und bu_hr gleichzeitig – das ist in Ordnung. Oft ist es genau das, was Sie wollen, weil es den rohen HR-Feed von den HR-eigenen Gold-Tabellen trennt, die darauf aufbauen.
Eine dritte Option sollten Sie kennen. Wenn Ihre Organisation tatsächlich unterschiedliche Zugriffslevel pro Medallion-Layer braucht, heben Sie den Layer ins Schema: brz_sap, slv_sap, gld_finance. Das ist die einzige Struktur, mit der Sie einem Analysten Silver gewähren können, ohne Bronze mitzugewähren – und das Mittel der Wahl, wenn Bronze rohe PII enthält. Für die meisten Organisationen ist das mehr Struktur, als das Problem rechtfertigt; Bronze und Silver zusammenzulassen und Spalten per ABAC zu schützen, ist der bessere Kompromiss.
Medallion-Layer als Tabellen-Präfixe
Sofern Sie den Layer nicht ins Schema gehoben haben, lebt er im Tabellennamen: brz_*, slv_*, gld_*. Der Speicherort ist inzwischen am Katalog gesetzt, die Zugriffskontrolle am Schema – eine neue Tabelle braucht also keines von beidem. Der einzige Grund, auf Tabellenebene etwas zu konfigurieren, sind Row-Level Security oder Column Masking.
Drei Startpunkte und zwei reale Layouts
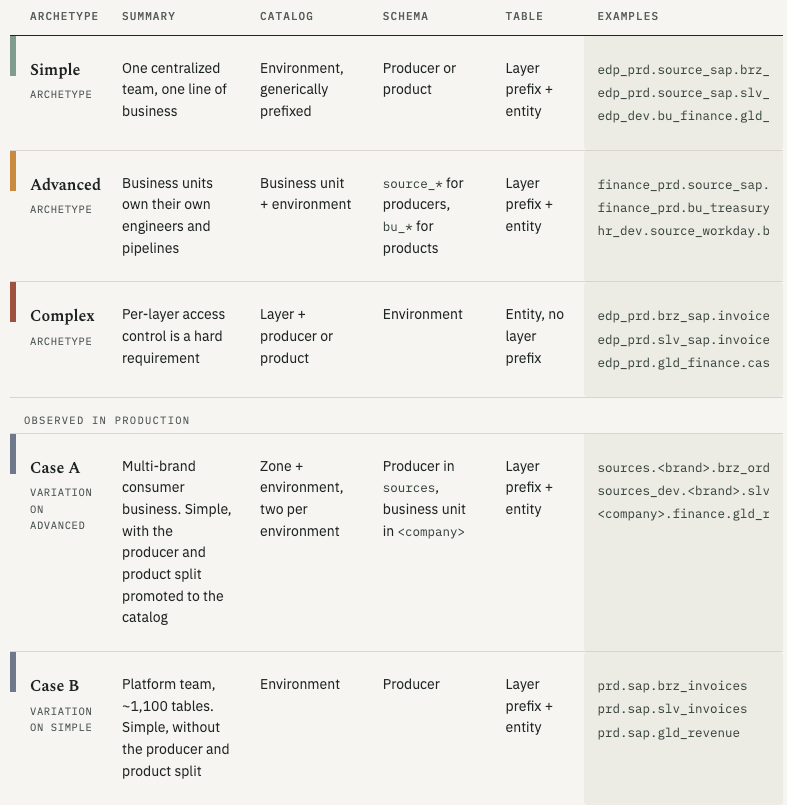
Die ersten drei Zeilen sind Archetypen. Die letzten beiden sind Strukturen, mit denen ich gearbeitet habe – ins selbe Raster gesetzt, damit Sie sehen, von welchem Archetyp jede eine Variante ist.
Was die beiden realen Layouts ihre Teams kosten
Fall A. Das Detail, über das es sich zu streiten lohnt, ist das fehlende _prd. Es wegzulassen macht den Katalog, in dem alle arbeiten, am kürzesten zu tippen – ein echter Gefallen für alle, die täglich darin navigieren. Es bedeutet aber auch, dass _ keine Vorlage mehr ist. Production wird in jedem Deployment zum Sonderfall, und jemand muss diese Sonderlogik für immer pflegen. Angenehm für die Nutzer, lästig für die Engineers – und kein Kompromiss, den ich eingehen würde.
Fall B. Sehen Sie sich die dritte Zeile der Beispiele an: Bronze, Silver und Gold in einem Schema. Nichts hat erzwungen, wo Gold hingehört, also enthalten manche Schemas alle drei. Das klingt kosmetisch. Ist es nicht. Einem Analysten, der nur Gold sehen soll, können Sie den Zugriff nicht auf Schema-Ebene gewähren, weil dasselbe Schema auch Bronze enthält. Der Grant, den Sie wollen, existiert nicht – also bauen Sie ihn Tabelle für Tabelle, für immer.
Außerdem kodieren sie den vorgesehenen Konsumenten im Tabellennamen: [], inzwischen 181 Objekte verteilt auf 27 Ziele. Das stammt aus einem Legacy-System, aus dem die Tabellen übernommen wurden, und damals war es die richtige Entscheidung. Trotzdem ist es der falsche Ansatz, denn die Klammer gewährt nichts und erzwingt nichts: Sie dokumentiert eine Absicht, auf die die Plattform nicht reagieren kann. Über den Ersatz wird dort noch diskutiert. Die vielversprechendste Variante sind Tags an den Tabellen plus ein geplanter Job, der sie ausliest und die Grants vergibt – das macht aus einer Namenskonvention etwas, das den Zugriff tatsächlich ändert.
Bereit zu sehen, wohin Ihre Unity-Catalog-Ausgaben tatsächlich fließen?
Wer billing_origin_product von Hand gruppiert, erfährt, dass Predictive Optimization letzten Monat etwas gekostet hat. Nicht aber, welche Tabelle, welcher User oder welche Strukturentscheidung vor drei Jahren dafür verantwortlich ist. SELECT liefert Datenplattform-Teams Attribution auf Query-Ebene über die gesamte Umgebung – inklusive der Posten, die überall sonst zu einer einzigen Zeile zusammenfallen. Sehen Sie, was es in Ihrem Workspace zutage fördert.
Was kostet Databricks Unity Catalog tatsächlich?
Die Governance-Schicht selbst ist kostenlos
Für Unity Catalog fällt keine separate Gebühr an. Kataloge, Schemas, Grants, Lineage, Audit-Logs und System Tables kosten nichts über Ihren Plan hinaus, und Databricks hat das Projekt im Juni 2024 unter der Linux Foundation als Open Source veröffentlicht.
System Tables verdienen eine Anmerkung: Sie existieren nur innerhalb eines Unity-Catalog-Metastores und lassen sich nur aus einem Workspace mit aktiviertem Unity Catalog abfragen – obwohl sie auch über Nicht-UC-Workspaces berichten. Jede Kostenabfrage in unserem E-Book zur Databricks-Kostenoptimierung und jeder Hebel in Databricks Pricing Explained läuft über sie. Damit ist Unity Catalog die Eintrittskarte, um Databricks-Kosten überhaupt managen zu können.
Geld kostet, was Unity Catalog ermöglicht – und diese Posten übersieht man leicht, weil sie nach nichts aussehen, das Sie selbst gestartet haben. Die Spalte billing_origin_product in system.billing.usage trennt sie heraus. Gruppieren Sie danach, und Zeilen wie PREDICTIVE_OPTIMIZATION und VECTOR_SEARCH tauchen neben dem Compute auf, den Sie wiedererkennen. Quality Monitoring erscheint doppelt, unter LAKEHOUSE_MONITORING und DATA_QUALITY_MONITORING – eine deutliche Warnung, dass diese Namen dem internen Aufbau von Databricks folgen und nicht den Produktnamen, unter denen Sie sie kennen.
Managed Tables und Predictive Optimization
Predictive Optimization ist der Posten, dem die meisten begegnen, ohne es zu merken. Es führt Kompaktierung, Bereinigung, Clustering und Statistikerfassung auf Managed Tables für Sie aus – und stellt das in Rechnung.
Meist ein guter Deal: Bleiben diese Operationen aus, entstehen aufgeblähter Speicher, schlechteres Data Skipping und langsamere Queries – die Sie ohnehin in Compute bezahlen, nur verteilt über jede Query statt einzeln ausgewiesen. Für Accounts, die seit November 2024 erstellt wurden, ist es standardmäßig aktiv; der Rollout auf bestehende Accounts wird um August 2026 erwartet. Steuern Sie es also gezielt auf Katalog- oder Schema-Ebene, statt den Account-Default überall zu akzeptieren.
Warum Ihr Layout eine Kostenentscheidung ist
Das meiste, was ein schlechtes Layout kostet, taucht nie auf einer Rechnung auf. Es ist die Person, die Grants auf einzelnen Tabellen pflegt, und das Quartals-Review, das sich nicht automatisieren lässt, weil das Modell nur in jemandes Kopf existiert. Diese Arbeit wächst mit der Lücke zwischen Ihrem Namespace und Ihrem Zugriffsmuster – und sie hört nie auf. Feingranulare Zugriffskontrolle muss außerdem irgendwo laufen: Jede Query gegen einen Row Filter oder eine Column Mask verursacht Compute, für den Sie sonst nicht zahlen würden. Mit einem Layout, das Grants auf Schema-Ebene erlaubt, entstehen beide Kosten gar nicht erst.
Wo sollten Sie also anfangen?
Wählen Sie das einfachste Layout, das heute zu Ihrem Team passt, versehen Sie Ihre Kataloge mit Präfixen, damit der nächste dazupasst, und akzeptieren Sie, dass Sie umstrukturieren werden. Was Sie nicht können: die Entscheidung aufschieben. Denn der Default ist nicht "keine Struktur", sondern das, was sich ansammelt, während Sie nicht hinsehen: einzelne Grants, Einmal-Views und Namenskonventionen, die für sich genommen alle vernünftig aussahen. Die Teams, die dem einen Schritt voraus bleiben, beobachten, was ihre Struktur sie kostet, solange noch Zeit ist, sie zu ändern. Genau dafür haben wir SELECT für Databricks gebaut. Buchen Sie eine Demo und sehen Sie, was es in Ihrer Umgebung findet.
FAQ
Kostet Unity Catalog extra?
Nein. Unity Catalog ist in Databricks-Plänen ab Premium enthalten; für Metastore, Kataloge, Schemas, Grants, Lineage, Audit-Logs und System Tables fällt keine Gebühr an. Geld kostet, was er ermöglicht: Predictive Optimization, Quality Monitors, Vector Search und feingranulare Zugriffskontrolle werden alle berechnet – und man übersieht sie leicht, sofern man system.billing.usage nicht nach billing_origin_product gruppiert, wo sie unter Namen erscheinen, die nicht zu den Produkten passen, unter denen Sie sie kennen.
Sollten Bronze-, Silver- und Gold-Tabellen in getrennten Schemas liegen?
Nur, wenn Sie zwischen Bronze und Silver unterschiedliche Zugriffslevel brauchen. Den Medallion-Layer in den Tabellennamen zu legen (brz_, slv_) und Schemas für Produzenten und Produkte zu nutzen, ist der bessere Default, weil Grants so an der Ownership ausgerichtet bleiben. Gold ist in diesem Layout bereits getrennt: Es liegt im Business-Unit- oder Produkt-Schema, nicht neben den Roh- und bereinigten Tabellen des Produzenten.
Die Konsequenz, die viele spät entdecken: Wer SELECT auf einem Produzenten-Schema hat, sieht Bronze genauso klar wie Silver. Enthält Bronze rohe PII, die bestimmte User nicht erreichen dürfen, ist das keine Berechtigungsänderung, die Sie später vornehmen können – es ist eine Umstrukturierung. Heben Sie den Layer in diesem Fall von Anfang an ins Schema (brz_sap, slv_sap, gld_finance).
Was ist der Unterschied zwischen Managed und External Tables in Unity Catalog?
Bei einer Managed Table bestimmt Unity Catalog den Speicherpfad. Die Daten liegen weiterhin in Ihrem Cloud-Account, aber Databricks steuert Layout und Lebenszyklus: Das Löschen der Tabelle entfernt die Dateien, und Predictive Optimization kann sie automatisch pflegen. Bei einer External Table geben Sie den Pfad an: Unity Catalog verwaltet Metadaten und Zugriff, aber Lebenszyklus und Optimierung bleiben bei Ihnen, und das Löschen der Tabelle lässt die Dateien zurück. Managed ist der Default und die bessere Wahl, sofern kein externes System die Dateien direkt lesen muss.