
TL;DR
Databricks Unity Catalog es la capa de gobernanza que está por encima de tus workspaces: un metastore por región de nube, un namespace de tres niveles y un solo conjunto de grants que aplica en todos los workspaces a los que ese metastore esté vinculado. Lo que determina si te va a funcionar no es la lista de funcionalidades, sino cómo organizas los catálogos y esquemas. Esa respuesta es específica de tu organización, y cambia a medida que creces.
Introducción
La mayoría de las explicaciones sobre Databricks Unity Catalog se quedan en la definición. Aprendes que es una capa de gobernanza unificada, que el namespace tiene tres niveles en lugar de dos y que el linaje viene incluido. Todo cierto, y nada de eso responde la pregunta que te haces veinte segundos después: ¿qué debería representar un catálogo? ¿Bronze, silver y gold van en esquemas separados? ¿Y qué efecto tiene todo esto en la factura? Este artículo cubre qué es Unity Catalog y cómo funciona, y luego dedica la mayor parte del tiempo a lo que nadie escribe: cómo organizarlo, y por qué esa decisión tiene consecuencias de costos que no verás venir.
¿Qué es Databricks Unity Catalog y por qué importa?
La brecha de gobernanza que Unity Catalog vino a resolver
Antes de Unity Catalog, el metastore vivía dentro del workspace. El namespace tenía dos niveles (schema.table), sin ningún lugar para expresar el entorno o la propiedad más allá del propio nombre. Los grupos eran locales a cada workspace, así que el acceso de un usuario debía reconstruirse en cada workspace que tocaba. El control de acceso se asociaba al cómputo y no al objeto de datos, de modo que una misma tabla podía ser legible o no según el clúster desde el que la abrieras. El linaje y la auditoría no existían.
Unity Catalog mueve el metastore al nivel de cuenta, con alcance de región de nube. Un metastore se vincula a muchos workspaces, un privilegio otorgado en uno es efectivo en todos ellos, y el grant vive en el objeto de datos, no en el cómputo que lo lee.
Qué vive realmente en el namespace de tres niveles
El tercer nivel de catalog.schema.table contiene más que tablas: vistas (incluidas las materializadas y las metric views), volúmenes y funciones, lo que abarca UDFs, procedimientos almacenados y modelos de MLflow. Otro conjunto de objetos asegurables cuelga directamente del metastore: credenciales de almacenamiento, ubicaciones externas, conexiones, shares y clean rooms.
Los volúmenes merecen una segunda mirada, porque extienden el mismo modelo de grants a los archivos en el almacenamiento en la nube. READ VOLUME se comporta como SELECT sobre una tabla: está asociado al objeto, no al cómputo que lo lee, que es precisamente lo que los mounts nunca pudieron hacer.
Por qué Unity Catalog ya no es opcional
Lo que de verdad pesa es el incentivo. El cómputo serverless, Lakeflow, Genie, el model serving, la búsqueda vectorial y Lakebase requieren Unity Catalog. También las system tables. Quedarse en el metastore de Hive no solo significa una peor gobernanza: significa quedar fuera de casi todo lo que Databricks ha lanzado en los últimos tres años. La presión en sentido contrario es menor: a partir del 30 de septiembre de 2026, Databricks aprovisionará los nuevos workspaces sin metastore de Hive, aunque los workspaces existentes no se verán afectados.
¿Cómo deberías organizar tus catálogos y esquemas?
Aquí la documentación guarda silencio. Databricks dice que los catálogos "normalmente" se organizan por unidad organizacional o por alcance de ciclo de vida, y ahí te deja. Vale la pena dejar claras tres cosas antes de cualquier recomendación:
La respuesta correcta es específica de tu organización. Ningún diseño sirve igual para un equipo de plataforma de cinco personas y para una organización federada con engineers en cada unidad de negocio. Por eso tan poca gente escribe sobre esto.
La respuesta correcta cambia. Creer que tu primera implementación sobrevivirá a un crecimiento indefinido es utópico. La meta no es una estructura que nunca cambie, sino una cuyos cambios salgan baratos.
El tamaño y la madurez de tu equipo definen tu punto de partida. Un equipo centralizado de seis personas no necesita lo mismo que una organización distribuida de sesenta, y adoptarlo antes de tiempo cuesta más de lo que ahorra.
Lo que sigue es el punto al que llego una y otra vez con clientes de finanzas, aeroespacial y energía, con el razonamiento incluido, para que puedas discutir el razonamiento y no la conclusión.
Cómo funciona la herencia, y por qué condiciona todas las demás decisiones
Dos reglas dan forma a todo el diseño.
La ubicación de almacenamiento se define por defecto en el metastore y puede sobrescribirse a nivel de catálogo y de esquema. Cada objeto hereda de su padre más cercano.
Los grants se heredan hacia abajo desde los catálogos y esquemas. Un SELECT sobre un catálogo alcanza cada tabla, vista y volumen presente y futuro dentro de él. No existe DENY en el modelo de grants, así que un grant heredado no puede revocarse en un solo objeto hijo. Las políticas ABAC y los filtros de fila te dan algo parecido a un DENY, y son genuinamente útiles, pero son menos evidentes y menos robustos que un grant: el grant dice que sí mientras una política dice que no en silencio en otro lugar, y nadie que lea el grant puede verlo. Úsalas de forma deliberada, no como parche sobre un diseño que no encaja.
La consecuencia es todo el argumento: el nivel en el que quieres otorgar permisos es el nivel al que tu diseño tiene que darle significado. Si tus esquemas no corresponden a grupos de personas que deberían ver los mismos datos, terminarás otorgando permisos tabla por tabla.
Catálogos por entorno, casi siempre
Para un equipo de datos centralizado, alinea los catálogos con los entornos de despliegue.
- Ubicación de almacenamiento. Separar el almacenamiento por entorno es una práctica común y, a menudo, un requisito regulatorio. Defínela una vez en el catálogo y cada tabla la hereda.
- CI/CD. Con el entorno en el nivel superior, la promoción se convierte en una sustitución de variables en lugar de una reescritura.
- Alineación con los workspaces. La mayoría de los equipos ya alinea los workspaces con los entornos, y el binding entre workspace y catálogo puede hacerlo cumplir.
- Linaje. Cualquier otro componente a nivel de catálogo produce grafos de linaje entre catálogos que son más difíciles de leer.
El matiz está en la topología del equipo. Si cada unidad de negocio tiene sus propios data engineers construyendo sus propios pipelines, un catálogo por unidad de negocio encaja mejor, porque entonces la frontera del catálogo coincide con la frontera de propiedad. La recomendación de un solo catálogo por entorno se sostiene para un equipo centralizado y deja de sostenerse en cuanto los productores se multiplican.
Dos cosas hacen que esa transición sea llevadera. Usa prefijos desde el principio: no llames prd a tu primer catálogo. Llámalo edp_prd por el equipo de plataforma, o algo genérico como analytics_prd. No cuesta nada el primer día, y significa que cuando más adelante lleguen finance_prd y hr_prd, el modelo se mantiene consistente en lugar de tener un catálogo de entorno a secas junto a una familia de catálogos de unidades de negocio. Elige nombres que sobrevivan a una reorganización: un catálogo con el nombre de un departamento que cambia de nombre cada dieciocho meses es un renombrado que nunca harás, así que se convierte en una mentira dentro de tu namespace.
Esquemas por productor de datos y por producto de datos
La parte más debatida. Mi opción por defecto es un híbrido: las tablas bronze y silver viven en un esquema con el nombre del productor de datos, y las tablas gold viven en un esquema con el nombre de la unidad de negocio o del producto de datos.
El instinto es poner un flujo completo bajo un solo esquema. Funciona en los casos simples y se queda corto en la mayoría:
- Segregación de propiedad. Muchos equipos dividen el trabajo: un grupo central construye bronze y silver con disciplina de ingeniería, mientras analistas y expertos de dominio construyen las agregaciones gold. La frontera del esquema coincide con la frontera de propiedad.
- Control de acceso. Quienes operan un sistema de origen deberían, en general, poder ver los datos que produce. Los usuarios de negocio deberían ver lo que agrega su unidad. Ambos son grants a nivel de esquema con este diseño. Ninguno lo es con un diseño basado en flujos.
- Calidad de datos. Cada dataset de cara al negocio se construye a partir de datos limpios del productor y no de los datos crudos.
Haz explícitos los dos roles en el nombre: source_<source_name> para los productores, bu_<bu_name> para las unidades de negocio y los productos. A veces terminarás con source_hr y bu_hr a la vez, y está bien. A menudo es exactamente lo que quieres, porque separa el feed crudo de HR de las tablas gold propiedad de HR construidas encima.
Vale la pena conocer una tercera opción. Si tu organización realmente requiere niveles de acceso distintos por capa medallion, promueve la capa al esquema: brz_sap, slv_sap, gld_finance. Es la única estructura que te permite otorgarle silver a un analista sin otorgarle bronze, y es la opción indicada cuando bronze contiene PII sin procesar. Para la mayoría de las organizaciones es más estructura de la que el problema justifica, y mantener bronze y silver juntos con protección a nivel de columna mediante ABAC es la opción más conveniente.
Las capas medallion como prefijos de tabla
A menos que hayas promovido la capa al esquema, vive en el nombre de la tabla: brz_*, slv_*, gld_*. A estas alturas, la ubicación de almacenamiento está definida en el catálogo y el control de acceso en el esquema, así que una tabla nueva no necesita ninguno de los dos. La única razón para configurar algo a nivel de tabla es la seguridad a nivel de fila o el enmascaramiento de columnas.
Tres puntos de partida y dos diseños reales
Las primeras tres filas son arquetipos. Las dos últimas son estructuras con las que he trabajado, colocadas en la misma cuadrícula para que veas de qué arquetipo es variación cada una.
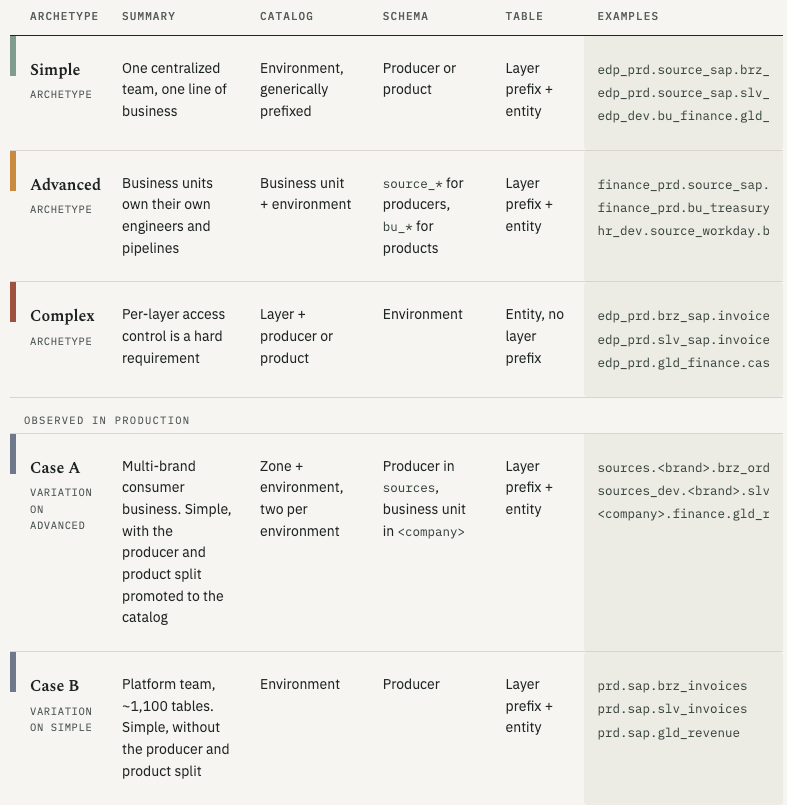
Lo que los dos diseños reales les cuestan a sus equipos
Caso A. El detalle que vale la pena discutir es el _prd que falta. Quitarlo hace que el catálogo en el que todos trabajan sea el más corto de escribir, lo cual es una verdadera cortesía para quienes lo navegan a diario. También significa que _ deja de ser una plantilla. Producción se convierte en un caso especial en cada despliegue, y alguien mantiene ese switch para siempre. Cómodo para los usuarios, un dolor de cabeza para los engineers, y no es una concesión que yo haría.
Caso B. Mira la tercera fila de sus ejemplos: bronze, silver y gold en un mismo esquema. Nada obligaba a que gold estuviera donde correspondía, así que algunos esquemas contienen las tres capas. Suena cosmético. No lo es. A un analista que solo debería ver gold no se le puede otorgar el acceso a nivel de esquema, porque el mismo esquema también contiene bronze. El grant que quieres no existe, así que lo construyes tabla por tabla, para siempre.
También codifican el consumidor previsto en el nombre de la tabla: [], que hoy suma 181 objetos repartidos en 27 destinos. Venía de un sistema legado del que se migraron las tablas, y en su momento fue la decisión correcta. Sigue siendo el enfoque equivocado, porque el corchete no otorga nada ni obliga a nada: registra una intención sobre la que la plataforma no puede actuar. El reemplazo todavía se debate allí. La versión más prometedora son tags en las tablas más un job programado que los lee y emite los grants, lo que convierte una convención de nombres en algo que realmente cambia el acceso.
¿Quieres ver a dónde se va realmente tu gasto en Unity Catalog?
Agrupar billing_origin_product a mano te dice que la optimización predictiva te costó algo el mes pasado. No te dice qué tabla, qué usuario o qué decisión estructural de hace tres años lo causó. SELECT les da a los equipos de plataforma de datos atribución a nivel de consulta en todo el entorno, incluidas las líneas de facturación que en cualquier otro lugar se colapsan en una sola fila. Mira lo que revela en tu workspace.
¿Cuánto cuesta realmente Databricks Unity Catalog?
La capa de gobernanza en sí es gratuita
Unity Catalog no tiene un cargo aparte. Los catálogos, los esquemas, los grants, el linaje, los logs de auditoría y las system tables no cuestan nada más allá del plan en el que estés, y Databricks liberó el proyecto como código abierto bajo la Linux Foundation en junio de 2024.
Las system tables merecen una nota aparte, porque solo existen dentro de un metastore de Unity Catalog y solo pueden consultarse desde un workspace habilitado con Unity Catalog, aunque también reportan sobre workspaces sin UC. Cada consulta de costos de nuestro ebook de optimización de costos de Databricks y cada control de Databricks Pricing Explained pasa por ellas, lo que hace de Unity Catalog el requisito de entrada para poder gestionar los costos de Databricks.
Lo que cuesta dinero es lo que Unity Catalog hace posible, y esos cargos son fáciles de pasar por alto porque no se parecen a nada que hayas lanzado tú. La columna billing_origin_product de system.billing.usage los separa. Agrupa por ella y aparecerán filas como PREDICTIVE_OPTIMIZATION y VECTOR_SEARCH junto al cómputo que sí reconoces. El monitoreo de calidad aparece dos veces, bajo LAKEHOUSE_MONITORING y DATA_QUALITY_MONITORING, lo cual es una buena advertencia de que estos nombres siguen la maquinaria interna de Databricks y no los nombres de producto con los que los conoces.
Tablas administradas y optimización predictiva
Predictive Optimization es la que la mayoría conoce sin darse cuenta. Ejecuta en tu nombre la compactación, la limpieza, el clustering y la recolección de estadísticas sobre las tablas administradas, y se factura.
Por lo general conviene: si no se ejecutan, esas operaciones producen almacenamiento inflado, peor data skipping y consultas más lentas, que de todos modos pagas en cómputo, repartidas entre todas las consultas en lugar de detalladas en la factura. Viene activada por defecto en las cuentas creadas desde noviembre de 2024, con un despliegue a las cuentas existentes previsto alrededor de agosto de 2026, así que defínela a nivel de catálogo o de esquema en lugar de aceptar el valor por defecto de la cuenta en todas partes.
Por qué tu diseño es una decisión de costos
La mayor parte de lo que cuesta un mal diseño nunca aparece en una factura. Es la persona que mantiene grants en tablas individuales, y la revisión trimestral que no se puede automatizar porque el modelo solo existe en la cabeza de alguien. Ese trabajo escala con la brecha entre tu namespace y tu patrón de acceso, y nunca se detiene. El control de acceso granular también tiene que ejecutarse en algún lado, así que cada consulta contra un filtro de fila o una máscara de columna consume cómputo que de otro modo no pagarías. Un diseño que te permite otorgar permisos a nivel de esquema es aquel en el que ninguno de esos dos costos existe.
Entonces, ¿por dónde empezar?
Elige el diseño más simple que encaje con tu equipo de hoy, ponles prefijos a tus catálogos para que el siguiente encaje, y acepta que vas a reestructurar. Lo que no puedes hacer es aplazar la decisión, porque la opción por defecto no es "sin estructura", sino lo que se va acumulando mientras no miras: grants individuales, vistas improvisadas y convenciones de nombres que, cada una por separado, parecían razonables. Los equipos que se mantienen un paso adelante observan lo que su estructura les cuesta mientras todavía hay tiempo de cambiarla. Por eso construimos SELECT para Databricks. Agenda una demo para ver qué encuentra en tu entorno.
FAQ
¿Unity Catalog tiene un costo adicional?
No. Unity Catalog está incluido en los planes Premium de Databricks y superiores, y no hay cargo por el metastore, los catálogos, los esquemas, los grants, el linaje, los logs de auditoría ni las system tables. Lo que cuesta dinero es lo que hace posible: Predictive Optimization, los monitores de calidad, la búsqueda vectorial y el control de acceso granular se facturan, y es fácil pasarlos por alto a menos que agrupes system.billing.usage por billing_origin_product, donde aparecen bajo nombres que no coinciden con los productos con los que los conoces.
¿Las tablas bronze, silver y gold deberían vivir en esquemas separados?
Solo si necesitas niveles de acceso distintos entre bronze y silver. Poner la capa medallion en el nombre de la tabla (brz_, slv_) y usar los esquemas para productores y productos es el mejor punto de partida, porque mantiene los grants alineados con la propiedad. Gold ya queda separado con ese diseño: vive en el esquema de la unidad de negocio o del producto, no junto a las tablas crudas y limpias del productor.
La consecuencia que la gente descubre tarde es que cualquiera con SELECT sobre un esquema de productor ve bronze con la misma claridad que silver. Si bronze contiene PII sin procesar al que ciertos usuarios no deben llegar, eso no es un cambio de permisos que puedas hacer después: es una reestructuración. En ese caso, promueve la capa al esquema (brz_sap, slv_sap, gld_finance) desde el inicio.
¿Cuál es la diferencia entre tablas administradas y externas en Unity Catalog?
En una tabla administrada, Unity Catalog determina la ruta de almacenamiento. Los datos siguen viviendo en tu cuenta de nube, pero Databricks controla el layout y el ciclo de vida, así que eliminar la tabla borra los archivos y Predictive Optimization puede mantenerla automáticamente. En una tabla externa, tú especificas la ruta: Unity Catalog gobierna los metadatos y el acceso, pero el ciclo de vida y la optimización siguen siendo tuyos, y al eliminar la tabla los archivos permanecen. La administrada es el valor por defecto y la mejor opción, salvo que un sistema externo necesite leer los archivos directamente.