
TL;DR
Databricks Unity Catalog è il livello di governance sopra i workspace: un metastore per regione cloud, un namespace a tre livelli e un unico set di grant valido ovunque quel metastore sia collegato. Ciò che determina se funzionerà nel Suo caso non è l'elenco delle funzionalità, ma il modo in cui organizza cataloghi e schemi. La risposta è specifica di ogni organizzazione, e cambia man mano che si cresce.
Introduzione
La maggior parte delle spiegazioni su Databricks Unity Catalog si ferma alla definizione. Si apprende che è un livello di governance unificato, che il namespace ha tre livelli invece di due e che la lineage è inclusa. Tutto vero, e niente di tutto questo risponde alla domanda che ci si pone venti secondi dopo: cosa dovrebbe rappresentare un catalogo? Bronze, silver e gold vanno in schemi separati? E che effetto ha tutto questo sulla fattura? Questo articolo spiega cos'è Unity Catalog e come funziona, per poi dedicare la maggior parte dello spazio alla parte di cui nessuno scrive: come organizzarlo, e perché quella decisione ha conseguenze sui costi che non vedrà arrivare.
Cos'è Databricks Unity Catalog e perché è importante?
Il vuoto di governance che Unity Catalog è nato per colmare
Prima di Unity Catalog, il metastore risiedeva all'interno del workspace. Il namespace aveva due livelli (schema.table), senza alcun modo di esprimere ambiente o ownership se non nel nome stesso. I gruppi erano locali al workspace, quindi gli accessi di un utente andavano ricostruiti in ogni workspace utilizzato. Il controllo degli accessi era legato al compute anziché all'oggetto dati, quindi la stessa tabella poteva essere leggibile o meno a seconda del cluster da cui la si apriva. Lineage e audit non esistevano.
Unity Catalog sposta il metastore a livello di account, con ambito limitato a una regione cloud. Un metastore si collega a molti workspace, un privilegio concesso in uno è valido in tutti, e il grant risiede sull'oggetto dati anziché sul compute che lo sta leggendo.
Cosa contiene davvero il namespace a tre livelli
Il terzo livello di catalog.schema.table contiene più che semplici tabelle: viste (incluse viste materializzate e metric view), volumi e funzioni, che comprendono UDF, stored procedure e modelli MLflow. Un ulteriore insieme di securable objects si trova direttamente sotto il metastore: storage credential, external location, connessioni, share e clean room.
I volumi meritano una seconda occhiata, perché estendono lo stesso modello di grant ai file nel cloud storage. READ VOLUME si comporta come SELECT su una tabella: è legato all'oggetto, non al compute che lo legge, esattamente ciò che i mount non hanno mai potuto fare.
Perché Unity Catalog non è più opzionale
È il fattore di attrazione a contare. Serverless compute, Lakeflow, Genie, model serving, vector search e Lakebase richiedono tutti Unity Catalog. Lo stesso vale per le system table. Restare sul metastore Hive non significa solo una governance peggiore: significa restare esclusi dalla maggior parte di ciò che Databricks ha rilasciato negli ultimi tre anni. La spinta, invece, è più debole: dal 30 settembre 2026 Databricks creerà i nuovi workspace senza metastore Hive, anche se i workspace esistenti non saranno interessati.
Come organizzare cataloghi e schemi?
Qui la documentazione tace. Databricks dice che i cataloghi sono "tipicamente" organizzati per unità organizzativa o per ambito di ciclo di vita, e lì si ferma. Tre cose vanno dette prima di qualsiasi raccomandazione:
La risposta giusta è specifica di ogni organizzazione. Nessun layout vale allo stesso modo per un team di piattaforma di cinque persone e per un'organizzazione federata con engineer in ogni business unit. Ecco perché così pochi ne scrivono.
La risposta giusta cambia. Credere che la prima implementazione sopravviva a una crescita indefinita è utopico. L'obiettivo non è una struttura che non cambia mai, ma una i cui cambiamenti costano poco.
Dimensione e maturità del team determinano il punto di partenza. Un team centralizzato di sei persone non ha bisogno di ciò che serve a un'organizzazione distribuita di sessanta, e adottarlo in anticipo costa più di quanto faccia risparmiare.
Quanto segue è la soluzione a cui continuo ad approdare con clienti nei settori finanziario, aerospaziale ed energetico, con il ragionamento allegato, così da poter discutere il ragionamento anziché la conclusione.
Come funziona l'ereditarietà, e perché guida ogni altra decisione
Due regole plasmano l'intero layout.
La posizione di storage è impostata di default a livello di metastore e può essere sovrascritta a livello di catalogo e di schema. Ogni oggetto eredita dal genitore più vicino.
I grant si ereditano verso il basso da cataloghi e schemi. SELECT su un catalogo raggiunge ogni tabella, vista e volume presenti e futuri al suo interno. Nel modello di grant non esiste DENY, quindi un grant ereditato non può essere revocato su un singolo oggetto figlio. Le policy ABAC e i row filter offrono qualcosa di simile a un DENY, e sono genuinamente utili, ma sono meno evidenti e meno robusti di un grant: il grant dice sì mentre una policy dice silenziosamente no da qualche altra parte, e chi legge il grant non può vederlo. Vanno usati deliberatamente, non come toppa su un layout inadeguato.
La conseguenza racchiude l'intero ragionamento: il livello a cui si vogliono concedere i grant è il livello che il layout deve rendere significativo. Se gli schemi non corrispondono a gruppi di persone che dovrebbero vedere gli stessi dati, si finirà per concedere grant tabella per tabella.
Cataloghi per ambiente, di solito
Per un team dati centralizzato, conviene allineare i cataloghi agli ambienti di deployment.
- Posizione di storage. Uno storage separato per ambiente è prassi comune e spesso un requisito normativo. Lo si imposta una volta a livello di catalogo e ogni tabella lo eredita.
- CI/CD. L'ambiente al livello più alto rende la promozione una sostituzione di variabile anziché una riscrittura.
- Allineamento dei workspace. La maggior parte dei team allinea già i workspace agli ambienti, e il binding workspace-catalogo può imporlo.
- Lineage. Qualsiasi altro componente a livello di catalogo produce grafi di lineage cross-catalogo più difficili da leggere.
La sfumatura sta nella topologia del team. Se ogni business unit ha i propri data engineer che costruiscono le proprie pipeline, un catalogo per business unit è la soluzione migliore, perché il confine del catalogo coincide allora con il confine di ownership. La raccomandazione di un catalogo per ambiente vale per un team centralizzato e smette di valere nel momento in cui i producer si moltiplicano.
Due accorgimenti rendono quella transizione sostenibile. Usare un prefisso fin dall'inizio: non chiamare il primo catalogo prd. Meglio edp_prd, dal nome del team di piattaforma, o qualcosa di generico come analytics_prd. Non costa nulla il primo giorno, e significa che quando più avanti arriveranno finance_prd e hr_prd il modello resterà coerente, anziché avere un catalogo d'ambiente spoglio accanto a una famiglia di cataloghi per business unit. Scegliere nomi che sopravvivano a una riorganizzazione: un catalogo intitolato a un reparto che viene rinominato ogni diciotto mesi è una ridenominazione che non verrà mai fatta, e diventa quindi una bugia nel namespace.
Schemi per data producer e data product
La parte più dibattuta. La mia impostazione predefinita è un ibrido: le tabelle bronze e silver vivono in uno schema intitolato al data producer, mentre le tabelle gold vivono in uno schema intitolato alla business unit o al data product.
L'istinto è mettere un intero flusso sotto un unico schema. Funziona nei casi semplici e si rivela insufficiente nella maggior parte dei casi:
- Segregazione dell'ownership. Molti team dividono il lavoro: un gruppo core costruisce bronze e silver con disciplina ingegneristica, mentre analisti ed esperti di dominio costruiscono le aggregazioni gold. Il confine dello schema coincide con il confine di ownership.
- Controllo degli accessi. Chi gestisce un sistema sorgente dovrebbe in genere vedere i dati che produce. Gli utenti business dovrebbero vedere ciò che la loro unità aggrega. In questo layout entrambi sono grant a livello di schema. In un layout basato sui flussi, nessuno dei due lo è.
- Qualità dei dati. Ogni dataset destinato al business viene costruito a partire dai dati puliti del producer anziché da quelli grezzi.
Conviene rendere espliciti i due ruoli nel nome: source_<source_name> per i producer, bu_<bu_name> per business unit e prodotti. A volte capiterà di avere sia source_hr sia bu_hr, e va bene così. Spesso è esattamente ciò che si vuole, perché separa il feed HR grezzo dalle tabelle gold di proprietà di HR costruite sopra di esso.
Vale la pena conoscere una terza opzione. Se l'organizzazione richiede davvero livelli di accesso diversi per ciascun layer medallion, si promuova il layer a schema: brz_sap, slv_sap, gld_finance. È l'unica struttura che consente di concedere a un analista il silver senza concedergli il bronze, ed è quella a cui ricorrere quando il bronze contiene PII grezze. Per la maggior parte delle organizzazioni è più struttura di quanta il problema ne giustifichi, e tenere bronze e silver insieme con una protezione a livello di colonna tramite ABAC è il compromesso migliore.
I layer medallion come prefissi delle tabelle
A meno che il layer non sia stato promosso a schema, vive nel nome della tabella: brz_*, slv_*, gld_*. A questo punto la posizione di storage è impostata a livello di catalogo e il controllo degli accessi a livello di schema, quindi una nuova tabella non ha bisogno né dell'una né dell'altro. L'unico motivo per configurare qualcosa a livello di tabella è la sicurezza a livello di riga o il mascheramento delle colonne.
Tre punti di partenza e due layout reali
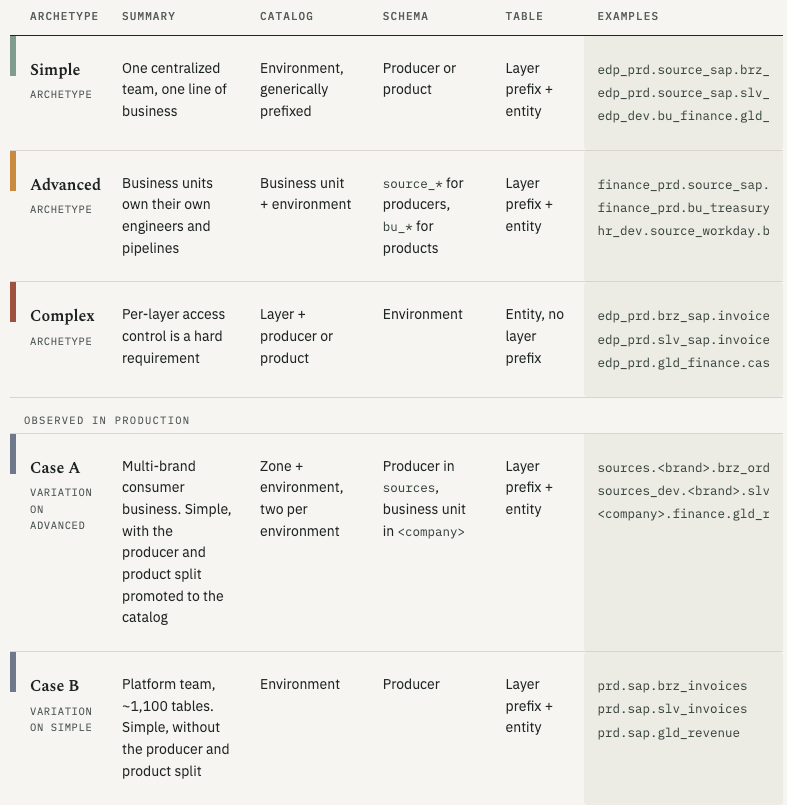
Le prime tre righe sono archetipi. Le ultime due sono strutture con cui ho lavorato, inserite nella stessa griglia così da vedere di quale archetipo ciascuna è una variante.
Quanto costano i due layout reali ai rispettivi team
Caso A. Il dettaglio su cui vale la pena discutere è il _prd mancante. Eliminarlo rende il catalogo in cui tutti lavorano il più breve da digitare, una vera cortesia per chi lo naviga ogni giorno. Significa però anche che _ non è più un template. La produzione diventa un caso speciale in ogni deployment, e qualcuno mantiene quell'eccezione per sempre. Comodo per gli utenti, un grattacapo per gli engineer, e non un compromesso che farei.
Caso B. Si guardi la terza riga dei suoi esempi: bronze, silver e gold in un unico schema. Nulla imponeva dove dovesse stare il gold, quindi alcuni schemi contengono tutti e tre i layer. Sembra una questione estetica. Non lo è. A un analista che dovrebbe vedere solo il gold non si può concedere l'accesso a livello di schema, perché lo stesso schema contiene anche il bronze. Il grant che si vorrebbe non esiste, quindi lo si costruisce tabella per tabella, per sempre.
Codificano inoltre il consumatore previsto nel nome della tabella: [], ormai 181 oggetti distribuiti su 27 target. Deriva da un sistema legacy da cui le tabelle sono state migrate, e all'epoca era la scelta giusta. Resta comunque la forma sbagliata, perché la parentesi non concede nulla e non impone nulla: registra un'intenzione su cui la piattaforma non può agire. La soluzione sostitutiva è lì ancora in discussione. La versione più promettente prevede tag sulle tabelle più un job pianificato che li legge e applica i grant, trasformando una convenzione di denominazione in qualcosa che modifica davvero gli accessi.
Vuole vedere dove finisce davvero la Sua spesa legata a Unity Catalog?
Raggruppare billing_origin_product a mano dice che la predictive optimization il mese scorso è costata qualcosa. Non dice quale tabella, quale utente o quale decisione strutturale di tre anni fa ne è all'origine. SELECT offre ai team di data platform un'attribuzione a livello di query sull'intero ambiente, incluse le voci che altrove collassano in un'unica riga. Scopra cosa fa emergere nel Suo workspace.
Quanto costa davvero Databricks Unity Catalog?
Il livello di governance in sé è gratuito
Unity Catalog non ha un costo separato. Cataloghi, schemi, grant, lineage, audit log e system table non costano nulla oltre al piano in uso, e nel giugno 2024 Databricks ha reso il progetto open source sotto la Linux Foundation.
Le system table meritano una nota, perché esistono solo all'interno di un metastore Unity Catalog e possono essere interrogate solo da un workspace abilitato a Unity Catalog, pur riportando dati anche sui workspace non UC. Ogni query sui costi nel nostro ebook sull'ottimizzazione dei costi di Databricks e ogni leva descritta in Databricks Pricing Explained passa da lì, il che rende Unity Catalog il requisito d'ingresso per gestire i costi di Databricks tout court.
A costare è ciò che Unity Catalog abilita, e quegli addebiti passano facilmente inosservati perché non assomigliano a nulla di avviato deliberatamente. La colonna billing_origin_product in system.billing.usage li separa. Raggruppando per questa colonna, righe come PREDICTIVE_OPTIMIZATION e VECTOR_SEARCH compaiono accanto alle voci di compute già note. Il quality monitoring compare due volte, sotto LAKEHOUSE_MONITORING e DATA_QUALITY_MONITORING: un giusto avvertimento che questi nomi rispecchiano i meccanismi interni di Databricks e non i nomi di prodotto con cui li si conosce.
Tabelle managed e predictive optimization
La Predictive Optimization è quella che la maggior parte delle persone incontra senza accorgersene. Esegue per conto Suo compattazione, pulizia, clustering e raccolta di statistiche sulle tabelle managed, e viene fatturata.
Di solito è un buon compromesso: se non vengono eseguite, quelle operazioni producono storage gonfiato, data skipping peggiore e query più lente, costi che si pagano comunque in compute, spalmati su ogni query anziché dettagliati in fattura. È attiva di default per gli account creati da novembre 2024, con un rollout agli account esistenti previsto intorno ad agosto 2026: conviene quindi definirne l'ambito a livello di catalogo o di schema anziché accettare ovunque il default di account.
Perché il layout è una decisione di costo
La maggior parte dei costi di un layout sbagliato non compare mai in fattura. È la persona che mantiene i grant su singole tabelle, e la revisione trimestrale che non si può automatizzare perché il modello esiste solo nella testa di qualcuno. Quel lavoro cresce con il divario tra il namespace e il pattern di accesso, e non finisce mai. Anche il controllo degli accessi fine-grained deve girare da qualche parte, quindi ogni query su un row filter o una column mask comporta compute che altrimenti non si pagherebbe. Un layout che permette di concedere i grant a livello di schema è quello in cui nessuno dei due costi esiste.
Da dove cominciare, quindi?
Scelga il layout più semplice adatto al Suo team di oggi, usi un prefisso nei nomi dei cataloghi così che il prossimo trovi posto, e accetti che prima o poi dovrà ristrutturare. Ciò che non può fare è rinviare la decisione, perché il default non è "nessuna struttura": è ciò che si accumula mentre si guarda altrove — grant individuali, viste una tantum e convenzioni di denominazione che, prese singolarmente, sembravano tutte ragionevoli. I team che restano un passo avanti osservano quanto costa loro la propria struttura finché c'è ancora tempo per cambiarla. È per questo che abbiamo costruito SELECT per Databricks. Prenoti una demo per vedere cosa trova nel Suo ambiente.
FAQ
Unity Catalog ha un costo aggiuntivo?
No. Unity Catalog è incluso nei piani Databricks Premium e superiori, e non ci sono costi per metastore, cataloghi, schemi, grant, lineage, audit log o system table. A costare è ciò che abilita: Predictive Optimization, quality monitor, vector search e controllo degli accessi fine-grained vengono tutti fatturati, ed è facile non notarli a meno di raggruppare system.billing.usage per billing_origin_product, dove compaiono sotto nomi che non corrispondono ai prodotti con cui li si conosce.
Le tabelle bronze, silver e gold devono vivere in schemi separati?
Solo se servono livelli di accesso diversi tra bronze e silver. Mettere il layer medallion nel nome della tabella (brz_, slv_) e usare gli schemi per producer e prodotti è il default migliore, perché mantiene i grant allineati all'ownership. Con quel layout il gold è già separato: si trova nello schema della business unit o del prodotto, non accanto alle tabelle grezze e pulite del producer.
La conseguenza che si scopre tardi è che chiunque abbia SELECT su uno schema producer vede il bronze esattamente con la stessa chiarezza del silver. Se il bronze contiene PII grezze che certi utenti non devono raggiungere, non è una modifica di permessi fattibile in seguito: è una ristrutturazione. In quel caso, si promuova il layer a schema (brz_sap, slv_sap, gld_finance) fin dall'inizio.
Qual è la differenza tra tabelle managed ed external in Unity Catalog?
Per una tabella managed, Unity Catalog determina il percorso di storage. I dati continuano a risiedere nel proprio account cloud, ma Databricks ne controlla layout e ciclo di vita: eliminare la tabella cancella i file e la Predictive Optimization può effettuarne la manutenzione in automatico. Per una tabella external, è l'utente a specificare il percorso: Unity Catalog governa metadati e accessi, ma ciclo di vita e ottimizzazione restano in capo all'utente, ed eliminare la tabella lascia i file al loro posto. Managed è il default ed è la scelta migliore, a meno che un sistema esterno non debba leggere i file direttamente.