
TL;DR
O Databricks Unity Catalog é a camada de governança acima dos seus workspaces: um metastore por região de nuvem, um namespace de três níveis e um único conjunto de grants que vale em todos os lugares onde esse metastore está anexado. O que decide se ele funciona para você não é a lista de recursos, e sim como você organiza catálogos e schemas. Essa resposta é específica da sua organização — e muda conforme você cresce.
Introdução
A maioria das explicações sobre o Databricks Unity Catalog para na definição. Você aprende que é uma camada unificada de governança, que o namespace tem três níveis em vez de dois e que a linhagem vem de graça. Tudo verdade, e nada disso responde a pergunta que surge vinte segundos depois: o que um catálogo deve representar? Bronze, silver e gold ficam em schemas separados? E o que tudo isso faz com a fatura? Este post cobre o que é o Unity Catalog e como ele funciona, e depois dedica a maior parte do tempo à parte sobre a qual ninguém escreve: como organizá-lo, e por que essa decisão tem consequências de custo que vão pegar você de surpresa.
O que é o Databricks Unity Catalog e por que ele importa?
A lacuna de governança que o Unity Catalog nasceu para resolver
Antes do Unity Catalog, o metastore vivia dentro do workspace. O namespace tinha dois níveis (schema.table), sem nenhum lugar para expressar ambiente ou propriedade além do próprio nome. Os grupos eram locais ao workspace, então o acesso de um usuário precisava ser reconstruído em cada workspace que ele tocava. O controle de acesso ficava preso ao compute, não ao objeto de dados, então a mesma tabela podia ser legível ou não dependendo de qual cluster você usava para abri-la. Linhagem e auditoria não existiam.
O Unity Catalog leva o metastore para o nível da conta, com escopo em uma região de nuvem. Um metastore se anexa a muitos workspaces, um privilégio concedido em um vale em todos eles, e o grant vive no objeto de dados, não no compute que estiver lendo.
O que realmente mora no namespace de três níveis
O terceiro nível de catalog.schema.table guarda mais do que tabelas: views (incluindo materialized views e metric views), volumes e funções, o que cobre UDFs, stored procedures e modelos do MLflow. Um conjunto adicional de objetos protegíveis fica diretamente sob o metastore: storage credentials, external locations, connections, shares e clean rooms.
Os volumes merecem um segundo olhar, porque estendem o mesmo modelo de grants a arquivos no armazenamento em nuvem. READ VOLUME se comporta como SELECT em uma tabela: anexado ao objeto, não ao compute que está lendo — exatamente o que os mounts nunca conseguiram fazer.
Por que o Unity Catalog deixou de ser opcional
O que importa é o atrativo. Compute serverless, Lakeflow, Genie, model serving, vector search e Lakebase exigem Unity Catalog. As system tables também. Ficar no Hive metastore não significa só uma governança pior: significa ficar de fora da maior parte do que a Databricks lançou nos últimos três anos. Já a pressão é menor: a partir de 30 de setembro de 2026, a Databricks provisionará novos workspaces sem Hive metastore, embora workspaces existentes não sejam afetados.
Como você deve organizar seus catálogos e schemas?
Aqui a documentação se cala. A Databricks diz que catálogos são "tipicamente" organizados por unidade organizacional ou escopo de ciclo de vida, e para por aí. Três coisas valem ser ditas antes de qualquer recomendação:
A resposta certa é específica da sua organização. Nenhum layout generaliza entre um time de plataforma de cinco pessoas e uma organização federada com engenheiros em cada unidade de negócio. É por isso que tão pouca gente escreve sobre isso.
A resposta certa muda. Acreditar que sua primeira implementação sobrevive a um crescimento indefinido é utopia. A meta não é uma estrutura que nunca muda, e sim uma cujas mudanças saem baratas.
O tamanho e a maturidade do seu time definem seu ponto de partida. Um time centralizado de seis pessoas não precisa do que uma organização distribuída de sessenta precisa, e adotar isso cedo demais custa mais do que economiza.
O que vem a seguir é onde eu sempre acabo chegando com clientes de finanças, aeroespacial e energia, com o raciocínio junto — assim você pode discutir com o raciocínio, não com a conclusão.
Como a herança funciona, e por que ela guia todas as outras decisões
Duas regras moldam o layout inteiro.
A localização de armazenamento é definida por padrão no metastore e pode ser sobrescrita nos níveis de catálogo e schema. Todo objeto herda do pai mais próximo.
Os grants são herdados para baixo a partir de catálogos e schemas. SELECT em um catálogo alcança toda tabela, view e volume atuais e futuros dentro dele. Não existe DENY no modelo de grants, então um grant herdado não pode ser revogado em um único objeto filho. Políticas de ABAC e filtros de linha oferecem algo com cara de DENY, e são genuinamente úteis, mas são menos óbvias e menos robustas do que um grant: o grant diz sim enquanto uma política diz não discretamente em outro lugar, e quem lê o grant não consegue enxergar isso. Use-as de forma deliberada, não como remendo sobre um layout que não serve.
A consequência é o argumento inteiro: o nível em que você quer conceder acesso é o nível que o seu layout precisa tornar significativo. Se os seus schemas não correspondem a grupos de pessoas que devem ver os mesmos dados, você vai acabar concedendo acesso tabela por tabela.
Catálogos por ambiente, na maioria das vezes
Para um time de dados centralizado, alinhe os catálogos aos ambientes de deploy.
- Localização de armazenamento. Armazenamento separado por ambiente é prática comum e, muitas vezes, exigência regulatória. Defina uma vez no catálogo e toda tabela herda.
- CI/CD. O ambiente no nível mais alto transforma a promoção em uma substituição de variável, não em uma reescrita.
- Alinhamento de workspaces. A maioria dos times já alinha workspaces a ambientes, e o binding de workspace a catálogo pode garantir isso.
- Linhagem. Qualquer outro componente no nível do catálogo produz grafos de linhagem entre catálogos mais difíceis de ler.
A nuance é a topologia do time. Se cada unidade de negócio tem seus próprios engenheiros de dados construindo seus próprios pipelines, um catálogo por unidade de negócio funciona melhor, porque a fronteira do catálogo passa a coincidir com a fronteira de propriedade. A recomendação de um catálogo por ambiente vale para um time centralizado e deixa de valer no momento em que os produtores se multiplicam.
Duas coisas ajudam a sobreviver a essa transição. Use prefixos desde o início: não nomeie seu primeiro catálogo de prd. Chame-o de edp_prd, pelo time de plataforma, ou de algo genérico como analytics_prd. Não custa nada no primeiro dia, e significa que, quando finance_prd e hr_prd chegarem depois, o modelo continua consistente — em vez de um catálogo de ambiente sem prefixo ao lado de uma família de catálogos de unidades de negócio. Escolha nomes que sobrevivam a uma reorganização: um catálogo com o nome de um departamento que é renomeado a cada dezoito meses é uma renomeação que você nunca vai fazer, e por isso vira uma mentira no seu namespace.
Schemas por produtor de dados e produto de dados
A parte mais debatida. Meu padrão é um híbrido: tabelas bronze e silver vivem em um schema com o nome do produtor de dados, e tabelas gold vivem em um schema com o nome da unidade de negócio ou do produto de dados.
O instinto é colocar um fluxo inteiro sob um único schema. Funciona em casos simples e fica devendo na maioria:
- Segregação de propriedade. Muitos times dividem o trabalho: um grupo central constrói bronze e silver com disciplina de engenharia, enquanto analistas e especialistas de domínio constroem as agregações gold. A fronteira do schema coincide com a fronteira de propriedade.
- Controle de acesso. Quem opera um sistema de origem geralmente deve ver os dados que ele produz. Usuários de negócio devem ver o que a unidade deles agrega. Aqui, ambos são grants no nível do schema. Em um layout baseado em fluxo, nenhum dos dois é.
- Qualidade de dados. Todo dataset voltado ao negócio é construído a partir dos dados limpos do produtor, não dos dados crus.
Deixe os dois papéis explícitos no nome: source_<source_name> para produtores, bu_<bu_name> para unidades de negócio e produtos. Às vezes você vai acabar com source_hr e bu_hr ao mesmo tempo, e tudo bem. Muitas vezes é exatamente o que você quer, porque separa o feed cru de RH das tabelas gold de propriedade do RH construídas em cima dele.
Vale conhecer uma terceira opção. Se a sua organização realmente exige níveis de acesso diferentes por camada medallion, promova a camada ao schema: brz_sap, slv_sap, gld_finance. É a única estrutura que permite conceder silver a um analista sem conceder bronze, e é o caminho quando o bronze carrega PII crua. Para a maioria das organizações é mais estrutura do que o problema justifica, e manter bronze e silver juntos com proteção no nível de coluna via ABAC é a melhor troca.
Camadas medallion como prefixos de tabela
A menos que você tenha promovido a camada ao schema, ela vive no nome da tabela: brz_*, slv_*, gld_*. A essa altura, a localização de armazenamento está definida no catálogo e o controle de acesso no schema, então uma tabela nova não precisa de nenhum dos dois. O único motivo para configurar algo no nível da tabela é segurança em nível de linha ou mascaramento de colunas.
Três pontos de partida, e dois layouts reais
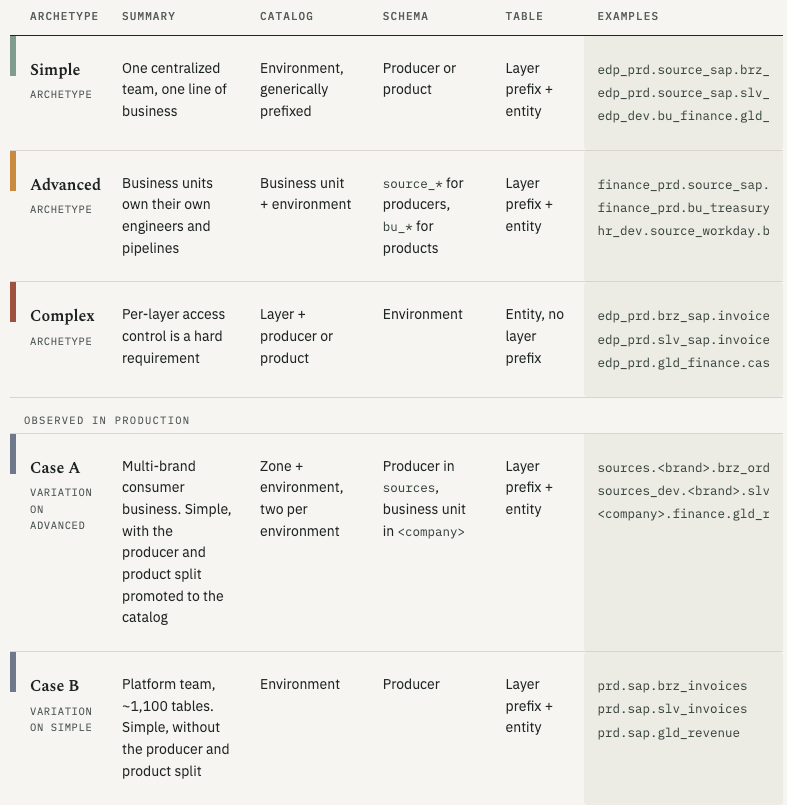
As três primeiras linhas são arquétipos. As duas últimas são estruturas com as quais trabalhei, colocadas na mesma grade para você ver de qual arquétipo cada uma é variação.
O que os dois layouts reais custam aos seus times
Caso A. O detalhe que vale a discussão é o _prd ausente. Removê-lo faz do catálogo em que todo mundo vive o mais curto de digitar, o que é uma gentileza real com quem o navega todos os dias. Também significa que _ deixa de ser um template. Produção vira um caso especial em todo deploy, e alguém mantém essa exceção para sempre. Bom para os usuários, uma dor de cabeça para os engenheiros, e não é uma troca que eu faria.
Caso B. Olhe a terceira linha dos exemplos: bronze, silver e gold em um único schema. Nada obrigava gold a ficar onde deveria, então alguns schemas guardam as três camadas. Parece cosmético. Não é. Um analista que deveria ver só gold não pode receber esse acesso no nível do schema, porque o mesmo schema também guarda bronze. O grant que você quer não existe, então você o constrói tabela por tabela, para sempre.
Eles também codificam o consumidor pretendido no nome da tabela: [], hoje 181 objetos espalhados por 27 destinos. Veio de um sistema legado do qual as tabelas foram migradas, e na época foi a decisão certa. Continua sendo o formato errado, porque o colchete não concede nada e não impõe nada: registra uma intenção sobre a qual a plataforma não consegue agir. A substituição ainda está em debate por lá. A versão mais promissora são tags nas tabelas combinadas com um job agendado que as lê e emite os grants, o que transforma uma convenção de nomes em algo que realmente muda o acesso.
Pronto para ver para onde o seu gasto com Unity Catalog está indo de verdade?
Agrupar billing_origin_product na mão diz que a otimização preditiva custou alguma coisa no mês passado. Não diz qual tabela, qual usuário ou qual decisão estrutural de três anos atrás causou isso. O SELECT dá aos times de plataforma de dados atribuição no nível da query em todo o ambiente, incluindo os itens de cobrança que, em qualquer outro lugar, viram uma única linha. Veja o que ele revela no seu workspace.
Quanto o Databricks Unity Catalog custa de verdade?
A camada de governança em si é gratuita
O Unity Catalog não tem cobrança separada. Catálogos, schemas, grants, linhagem, logs de auditoria e system tables não custam nada além do plano em que você já está, e a Databricks abriu o código do projeto sob a Linux Foundation em junho de 2024.
As system tables merecem uma nota, porque só existem dentro de um metastore do Unity Catalog e só podem ser consultadas a partir de um workspace com Unity Catalog habilitado, mesmo que também reportem workspaces sem UC. Toda query de custo do nosso ebook de otimização de custos do Databricks e todo controle de Databricks Pricing Explained passa por elas, o que torna o Unity Catalog o requisito de entrada para conseguir gerenciar custos do Databricks.
O que custa dinheiro é o que o Unity Catalog habilita, e essas cobranças passam batido com facilidade porque não se parecem com nada que você tenha lançado. A coluna billing_origin_product em system.billing.usage as separa. Agrupe por ela e linhas como PREDICTIVE_OPTIMIZATION e VECTOR_SEARCH aparecem ao lado do compute que você reconhece. O monitoramento de qualidade aparece duas vezes, sob LAKEHOUSE_MONITORING e DATA_QUALITY_MONITORING — um bom aviso de que esses nomes acompanham a estrutura interna da Databricks, não os nomes de produto pelos quais você os conhece.
Tabelas gerenciadas e Predictive Optimization
A Predictive Optimization é a que a maioria das pessoas encontra sem perceber. Ela executa compactação, limpeza, clustering e coleta de estatísticas em tabelas gerenciadas no seu lugar — e cobra por isso.
Costuma ser uma boa troca: sem rodar essas operações, o resultado é armazenamento inchado, pior data skipping e queries mais lentas, que você paga de qualquer jeito em compute, diluído em cada query em vez de itemizado. Ela vem ativada por padrão para contas criadas desde novembro de 2024, com rollout para contas existentes previsto por volta de agosto de 2026, então defina o escopo no nível do catálogo ou do schema em vez de aceitar o padrão da conta em todo lugar.
Por que o seu layout é uma decisão de custo
A maior parte do que um layout ruim custa nunca aparece em uma fatura. É a pessoa mantendo grants em tabelas individuais e a revisão trimestral que não pode ser automatizada porque o modelo só existe na cabeça de alguém. Esse trabalho escala com a distância entre o seu namespace e o seu padrão de acesso, e nunca para. O controle de acesso refinado também precisa rodar em algum lugar, então toda query contra um filtro de linha ou uma máscara de coluna carrega um compute que você não pagaria de outra forma. Um layout que permite conceder acesso no nível do schema é aquele em que nenhum desses dois custos existe.
Então, por onde começar?
Escolha o layout mais simples que corresponda ao seu time hoje, prefixe seus catálogos para que o próximo encaixe e aceite que você vai reestruturar. O que você não pode fazer é adiar a decisão, porque o padrão não é "nenhuma estrutura": é o que for se acumulando enquanto você não está olhando — grants individuais, views pontuais e convenções de nome que, isoladamente, pareciam razoáveis. Os times que ficam à frente disso observam o que a estrutura custa enquanto ainda dá tempo de mudá-la. Foi por isso que construímos o SELECT para Databricks. Agende uma demo para ver o que ele encontra no seu ambiente.
FAQ
O Unity Catalog tem custo extra?
Não. O Unity Catalog está incluído nos planos Premium do Databricks e superiores, e não há cobrança pelo metastore, catálogos, schemas, grants, linhagem, logs de auditoria ou system tables. O que custa dinheiro é o que ele habilita: Predictive Optimization, monitores de qualidade, vector search e controle de acesso refinado são todos cobrados, e passam batido com facilidade a menos que você agrupe system.billing.usage por billing_origin_product, onde aparecem sob nomes que não batem com os produtos pelos quais você os conhece.
As tabelas bronze, silver e gold devem viver em schemas separados?
Só se você precisar de níveis de acesso diferentes entre bronze e silver. Colocar a camada medallion no nome da tabela (brz_, slv_) e usar schemas para produtores e produtos é o melhor padrão, porque mantém os grants alinhados à propriedade. Gold já fica separado nesse layout: vive no schema da unidade de negócio ou do produto, não ao lado das tabelas cruas e limpas do produtor.
A consequência que as pessoas descobrem tarde é que qualquer um com SELECT em um schema de produtor vê bronze com a mesma clareza que vê silver. Se o bronze carrega PII crua que certos usuários não podem acessar, isso não é uma mudança de permissão que você faz depois: é uma reestruturação. Nesse caso, promova a camada ao schema (brz_sap, slv_sap, gld_finance) desde o início.
Qual é a diferença entre tabelas gerenciadas e externas no Unity Catalog?
Em uma tabela gerenciada, o Unity Catalog determina o caminho de armazenamento. Os dados continuam na sua conta de nuvem, mas o Databricks controla layout e ciclo de vida, então apagar a tabela apaga os arquivos, e a Predictive Optimization pode mantê-la automaticamente. Em uma tabela externa, você especifica o caminho: o Unity Catalog governa metadados e acesso, mas ciclo de vida e otimização continuam com você, e apagar a tabela deixa os arquivos para trás. Gerenciada é o padrão e a melhor escolha, a menos que um sistema externo precise ler os arquivos diretamente.