
TL;DR
Databricks Unity Catalog est la couche de gouvernance au-dessus de vos workspaces : un metastore par région cloud, un namespace à trois niveaux et un ensemble unique de grants qui s'applique partout où ce metastore est attaché. Ce qui détermine si la solution fonctionne pour vous, ce n'est pas la liste des fonctionnalités, c'est la façon dont vous organisez catalogues et schémas. Cette réponse est propre à votre organisation, et elle évolue à mesure que vous grandissez.
Introduction
La plupart des explications sur Databricks Unity Catalog s'arrêtent à la définition. Vous apprenez qu'il s'agit d'une couche de gouvernance unifiée, que le namespace compte trois niveaux au lieu de deux, et que le lineage est fourni d'office. Tout cela est vrai, et rien de tout cela ne répond à la question que vous vous posez vingt secondes plus tard : que doit représenter un catalogue ? Les tables bronze, silver et gold doivent-elles vivre dans des schémas séparés ? Et quel est l'impact de tout cela sur la facture ? Cet article explique ce qu'est Unity Catalog et comment il fonctionne, puis consacre l'essentiel de son propos à ce dont personne ne parle : comment l'organiser, et pourquoi cette décision a des conséquences financières que vous ne verrez pas venir.
Qu'est-ce que Databricks Unity Catalog et pourquoi est-ce important ?
Le déficit de gouvernance qu'Unity Catalog est venu combler
Avant Unity Catalog, le metastore vivait à l'intérieur du workspace. Le namespace comptait deux niveaux (schema.table), sans aucun moyen d'exprimer l'environnement ou la propriété ailleurs que dans le nom lui-même. Les groupes étaient locaux au workspace : les accès d'un utilisateur devaient être reconstruits dans chaque workspace qu'il touchait. Le contrôle d'accès était attaché au compute plutôt qu'à l'objet de données, si bien qu'une même table pouvait être lisible ou non selon le cluster depuis lequel on l'ouvrait. Le lineage et l'audit n'existaient pas.
Unity Catalog déplace le metastore au niveau du compte, avec un périmètre limité à une région cloud. Un metastore s'attache à plusieurs workspaces, un privilège accordé dans l'un vaut dans tous, et le grant est porté par l'objet de données plutôt que par le compute qui le lit.
Ce que contient réellement le namespace à trois niveaux
Le troisième niveau de catalog.schema.table abrite plus que des tables : des vues (y compris les vues matérialisées et les metric views), des volumes et des fonctions, ce qui couvre les UDF, les procédures stockées et les modèles MLflow. Un autre ensemble d'objets sécurisables se situe directement sous le metastore : credentials de stockage, external locations, connexions, shares et clean rooms.
Les volumes méritent qu'on s'y attarde, car ils étendent le même modèle de grants aux fichiers du stockage cloud. READ VOLUME se comporte comme SELECT sur une table : attaché à l'objet, et non au compute qui le lit — précisément ce que les mounts n'ont jamais permis.
Pourquoi Unity Catalog n'est plus optionnel
C'est l'incitation qui compte. Le compute serverless, Lakeflow, Genie, le model serving, la recherche vectorielle et Lakebase exigent tous Unity Catalog. Les system tables aussi. Rester sur le metastore Hive ne signifie pas seulement une gouvernance dégradée : c'est se couper de l'essentiel de ce que Databricks a livré ces trois dernières années. La contrainte, elle, est plus modeste : à partir du 30 septembre 2026, Databricks provisionnera les nouveaux workspaces sans metastore Hive, les workspaces existants n'étant pas concernés.
Comment organiser vos catalogues et vos schémas ?
C'est ici que la documentation devient muette. Databricks indique que les catalogues sont généralement organisés par unité organisationnelle ou par périmètre de cycle de vie, et vous laisse là. Trois points méritent d'être posés avant toute recommandation :
La bonne réponse est propre à votre organisation. Aucune structure ne se généralise d'une équipe plateforme de cinq personnes à une organisation fédérée avec des ingénieurs dans chaque business unit. C'est pourquoi si peu de gens écrivent sur le sujet.
La bonne réponse évolue. Croire que votre première implémentation survivra à une croissance indéfinie relève de l'utopie. L'objectif n'est pas une structure qui ne change jamais, mais une structure dont les changements coûtent peu.
La taille et la maturité de votre équipe déterminent votre point de départ. Une équipe centralisée de six personnes n'a pas besoin de ce dont une organisation distribuée de soixante personnes a besoin, et l'adopter trop tôt coûte plus que cela ne rapporte.
Ce qui suit correspond à ce vers quoi je reviens systématiquement chez mes clients de la finance, de l'aérospatiale et de l'énergie, avec le raisonnement à l'appui, pour que vous puissiez débattre du raisonnement plutôt que de la conclusion.
Comment fonctionne l'héritage, et pourquoi il conditionne toutes les autres décisions
Deux règles façonnent toute la structure.
L'emplacement de stockage est défini par défaut au niveau du metastore et peut être redéfini au niveau du catalogue et du schéma. Chaque objet hérite de son parent le plus proche.
Les grants se propagent vers le bas depuis les catalogues et les schémas. Un SELECT sur un catalogue atteint chaque table, vue et volume présents et futurs qu'il contient. Le modèle ne comporte pas de DENY : un grant hérité ne peut donc pas être révoqué sur un seul objet enfant. Les politiques ABAC et les filtres de lignes offrent quelque chose qui ressemble à un DENY, et ils sont réellement utiles, mais ils sont moins visibles et moins robustes qu'un grant : le grant dit oui pendant qu'une politique dit discrètement non ailleurs, et personne ne le voit en lisant le grant. Utilisez-les à dessein, pas comme un pansement sur une structure inadaptée.
La conséquence résume tout l'argument : le niveau auquel vous voulez accorder des droits est celui auquel votre structure doit donner du sens. Si vos schémas ne correspondent pas à des groupes de personnes censées voir les mêmes données, vous finirez par accorder vos droits table par table.
Des catalogues par environnement, le plus souvent
Pour une équipe data centralisée, alignez les catalogues sur les environnements de déploiement.
- Emplacement de stockage. Un stockage distinct par environnement est une pratique courante, et souvent une exigence réglementaire. Définissez-le une fois au niveau du catalogue et chaque table en hérite.
- CI/CD. L'environnement au premier niveau fait de la promotion une substitution de variable plutôt qu'une réécriture.
- Alignement des workspaces. La plupart des équipes alignent déjà leurs workspaces sur les environnements, et le binding workspace-catalogue peut l'imposer.
- Lineage. Tout autre composant au niveau du catalogue produit des graphes de lineage inter-catalogues plus difficiles à lire.
La nuance tient à la topologie des équipes. Si chaque business unit a ses propres data engineers qui construisent leurs propres pipelines, un catalogue par business unit convient mieux, car la frontière du catalogue correspond alors à la frontière de propriété. La recommandation d'un catalogue unique par environnement vaut pour une équipe centralisée et cesse de valoir dès que les producteurs se multiplient.
Deux choses rendent cette transition supportable. Préfixez dès le départ : ne nommez pas votre premier catalogue prd. Nommez-le edp_prd d'après l'équipe plateforme, ou choisissez un nom générique comme analytics_prd. Cela ne coûte rien le premier jour, et quand finance_prd et hr_prd arriveront plus tard, le modèle restera cohérent, au lieu de voir un catalogue d'environnement nu côtoyer une famille de catalogues de business units. Choisissez des noms qui survivent à une réorganisation : un catalogue nommé d'après un département rebaptisé tous les dix-huit mois est un renommage que vous ne ferez jamais, et devient donc un mensonge dans votre namespace.
Des schémas par producteur de données et par data product
C'est la partie la plus débattue. Mon choix par défaut est hybride : les tables bronze et silver vivent dans un schéma nommé d'après le producteur de données, et les tables gold dans un schéma nommé d'après la business unit ou le data product.
L'instinct pousse à placer un flux entier sous un même schéma. Cela fonctionne dans les cas simples et échoue dans la plupart des autres :
- Séparation de la propriété. Beaucoup d'équipes répartissent le travail : un noyau construit bronze et silver avec une rigueur d'ingénierie, pendant que des analystes et des experts métier construisent les agrégations gold. La frontière du schéma épouse celle de la propriété.
- Contrôle d'accès. Les personnes qui exploitent un système source devraient en général voir les données qu'il produit. Les utilisateurs métier devraient voir ce que leur unité agrège. Les deux correspondent ici à des grants au niveau du schéma. Aucun des deux ne l'est dans une structure par flux.
- Qualité des données. Chaque jeu de données destiné au métier se construit à partir des données producteur nettoyées plutôt qu'à partir du brut.
Rendez les deux rôles explicites dans le nom : source_<source_name> pour les producteurs, bu_<bu_name> pour les business units et les produits. Il vous arrivera d'avoir à la fois source_hr et bu_hr, et c'est très bien. C'est souvent exactement ce que vous voulez, car cela sépare le flux RH brut des tables gold détenues par les RH et construites par-dessus.
Une troisième option mérite d'être connue. Si votre organisation exige réellement des niveaux d'accès différents par couche médaillon, élevez la couche au rang de schéma : brz_sap, slv_sap, gld_finance. C'est la seule structure qui permet d'accorder silver à un analyste sans lui accorder bronze, et c'est celle à adopter quand bronze contient des PII brutes. Pour la plupart des organisations, c'est plus de structure que le problème ne le justifie, et garder bronze et silver ensemble avec une protection au niveau des colonnes via ABAC est le meilleur compromis.
Les couches médaillon en préfixes de tables
Sauf si vous avez élevé la couche au rang de schéma, elle vit dans le nom de la table : brz_*, slv_*, gld_*. À ce stade, l'emplacement de stockage est défini au niveau du catalogue et le contrôle d'accès au niveau du schéma : une nouvelle table n'a besoin ni de l'un ni de l'autre. La seule raison de configurer quoi que ce soit au niveau de la table est la sécurité au niveau des lignes ou le masquage de colonnes.
Trois points de départ, et deux structures réelles
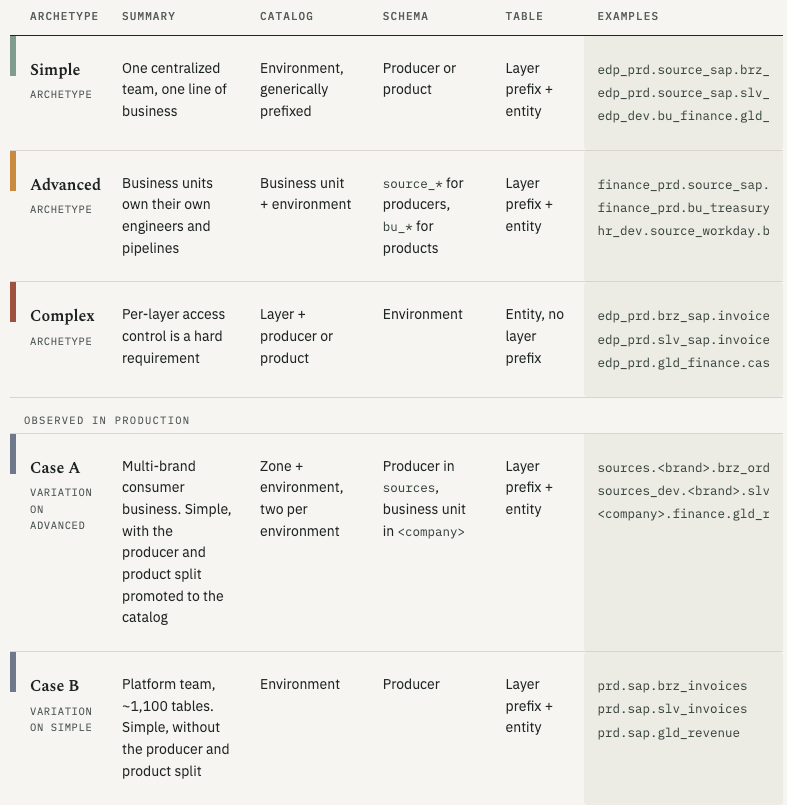
Les trois premières lignes sont des archétypes. Les deux dernières sont des structures avec lesquelles j'ai travaillé, placées dans la même grille pour que vous voyiez de quel archétype chacune est une variation.
Ce que les deux structures réelles coûtent à leurs équipes
Cas A. Le détail qui mérite débat est le _prd manquant. Le supprimer fait du catalogue dans lequel tout le monde vit le plus court à taper, un vrai confort pour ceux qui y naviguent chaque jour. Mais _ n'est alors plus un gabarit. La production devient un cas particulier dans chaque déploiement, et quelqu'un devra maintenir cette exception indéfiniment. Agréable pour les utilisateurs, un casse-tête pour les ingénieurs — pas un compromis que je ferais.
Cas B. Regardez la troisième ligne de ses exemples : bronze, silver et gold dans un même schéma. Rien n'imposait l'emplacement du gold, si bien que certains schémas contiennent les trois couches. Cela paraît cosmétique. Ça ne l'est pas. Un analyste qui ne devrait voir que gold ne peut pas recevoir ce droit au niveau du schéma, car le même schéma contient aussi bronze. Le grant que vous voulez n'existe pas : vous le reconstruisez donc table par table, indéfiniment.
Ils encodent aussi le consommateur visé dans le nom de la table : [], soit désormais 181 objets répartis sur 27 cibles. Cela vient d'un système legacy dont les tables ont été reprises, et à l'époque c'était le bon choix. Cela reste la mauvaise approche, car le crochet n'accorde rien et n'impose rien : il consigne une intention sur laquelle la plateforme ne peut pas agir. Le remplacement y est encore en débat. La piste la plus prometteuse : des tags sur les tables, plus un job planifié qui les lit et émet les grants — ce qui transforme une convention de nommage en quelque chose qui modifie réellement les accès.
Envie de voir où partent réellement vos dépenses Unity Catalog ?
Regrouper billing_origin_product à la main vous apprend que l'optimisation prédictive vous a coûté quelque chose le mois dernier. Mais pas quelle table, quel utilisateur, ni quelle décision structurelle prise il y a trois ans en est la cause. SELECT offre aux équipes data platform une attribution au niveau de la requête sur l'ensemble de l'environnement, y compris les lignes de facturation qui se réduisent à une seule ligne partout ailleurs. Découvrez ce qu'il révèle dans votre workspace.
Combien coûte réellement Databricks Unity Catalog ?
La couche de gouvernance elle-même est gratuite
Unity Catalog n'entraîne aucun coût distinct. Catalogues, schémas, grants, lineage, journaux d'audit et system tables ne coûtent rien au-delà de votre plan, et Databricks a ouvert le code du projet sous l'égide de la Linux Foundation en juin 2024.
Les system tables méritent une remarque : elles n'existent qu'au sein d'un metastore Unity Catalog et ne peuvent être interrogées que depuis un workspace activé pour Unity Catalog, alors même qu'elles rendent compte aussi des workspaces non UC. Chaque requête de coûts de notre ebook sur l'optimisation des coûts Databricks et chaque levier de notre décryptage de la tarification Databricks passe par elles — ce qui fait d'Unity Catalog le prérequis de toute gestion des coûts Databricks.
Ce qui coûte, c'est ce qu'Unity Catalog rend possible, et ces frais passent facilement inaperçus parce qu'ils ne ressemblent à rien de ce que vous avez lancé. La colonne billing_origin_product de system.billing.usage les isole. Groupez sur cette colonne, et des lignes comme PREDICTIVE_OPTIMIZATION et VECTOR_SEARCH apparaissent à côté du compute que vous reconnaissez. La surveillance de la qualité apparaît deux fois, sous LAKEHOUSE_MONITORING et DATA_QUALITY_MONITORING — signe que ces noms reflètent la tuyauterie interne de Databricks, pas les noms de produits sous lesquels vous les connaissez.
Tables managées et optimisation prédictive
Predictive Optimization est celle que la plupart des gens croisent sans s'en apercevoir. Elle exécute pour vous compaction, nettoyage, clustering et collecte de statistiques sur les tables managées, et elle est facturée.
C'est généralement un bon compromis : si ces opérations ne sont pas exécutées, le stockage gonfle, le data skipping se dégrade et les requêtes ralentissent — autant de coûts que vous payez de toute façon en compute, dilués dans chaque requête au lieu d'être détaillés. Elle est activée par défaut pour les comptes créés depuis novembre 2024, avec un déploiement sur les comptes existants attendu autour d'août 2026 : définissez-en donc le périmètre au niveau du catalogue ou du schéma plutôt que d'accepter partout le réglage par défaut du compte.
Pourquoi votre structure est une décision de coût
L'essentiel de ce que coûte une mauvaise structure n'apparaît jamais sur une facture. C'est la personne qui maintient des grants sur des tables individuelles, et la revue trimestrielle impossible à automatiser parce que le modèle n'existe que dans la tête de quelqu'un. Ce travail croît avec l'écart entre votre namespace et votre modèle d'accès, et il ne s'arrête jamais. Le contrôle d'accès fin doit aussi s'exécuter quelque part : chaque requête passant par un filtre de lignes ou un masque de colonne consomme du compute que vous ne paieriez pas autrement. Une structure qui vous permet d'accorder les droits au niveau du schéma est celle où aucun de ces deux coûts n'existe.
Par où commencer ?
Choisissez la structure la plus simple qui correspond à votre équipe d'aujourd'hui, préfixez vos catalogues pour que le suivant s'y insère, et acceptez l'idée que vous devrez restructurer. Ce que vous ne pouvez pas faire, c'est différer la décision, car l'option par défaut n'est pas l'absence de structure : c'est ce qui s'accumule pendant que vous regardez ailleurs — grants individuels, vues ponctuelles et conventions de nommage qui, chacune, paraissaient raisonnables isolément. Les équipes qui gardent une longueur d'avance surveillent ce que leur structure leur coûte tant qu'il est encore temps d'en changer. C'est pour cela que nous avons construit SELECT pour Databricks. Réservez une démo pour voir ce qu'il détecte dans votre environnement.
FAQ
Unity Catalog entraîne-t-il un coût supplémentaire ?
Non. Unity Catalog est inclus dans les plans Databricks Premium et supérieurs, et ni le metastore, ni les catalogues, schémas, grants, lineage, journaux d'audit ou system tables ne sont facturés. Ce qui coûte, c'est ce qu'il rend possible : Predictive Optimization, moniteurs de qualité, recherche vectorielle et contrôle d'accès fin sont tous facturés, et ils passent facilement inaperçus à moins de grouper system.billing.usage par billing_origin_product, où ils apparaissent sous des noms qui ne correspondent pas aux produits que vous connaissez.
Les tables bronze, silver et gold doivent-elles vivre dans des schémas séparés ?
Uniquement si vous avez besoin de niveaux d'accès différents entre bronze et silver. Placer la couche médaillon dans le nom de la table (brz_, slv_) et réserver les schémas aux producteurs et aux produits est le meilleur choix par défaut, car les grants restent alignés sur la propriété. Gold est déjà séparé dans cette structure : il vit dans le schéma de la business unit ou du produit, pas à côté des tables brutes et nettoyées du producteur.
La conséquence que l'on découvre tard : quiconque dispose de SELECT sur un schéma producteur voit bronze aussi clairement que silver. Si bronze contient des PII brutes que certains utilisateurs ne doivent pas pouvoir consulter, ce n'est pas un changement de permissions que vous pourrez faire plus tard, c'est une restructuration. Dans ce cas, élevez la couche au rang de schéma (brz_sap, slv_sap, gld_finance) dès le départ.
Quelle est la différence entre tables managées et tables externes dans Unity Catalog ?
Pour une table managée, Unity Catalog détermine le chemin de stockage. Les données restent dans votre compte cloud, mais Databricks contrôle l'agencement et le cycle de vie : supprimer la table supprime les fichiers, et Predictive Optimization peut la maintenir automatiquement. Pour une table externe, c'est vous qui spécifiez le chemin : Unity Catalog gouverne les métadonnées et les accès, mais le cycle de vie et l'optimisation restent à votre charge, et supprimer la table laisse les fichiers en place. La table managée est le choix par défaut, et le meilleur, sauf si un système externe doit lire les fichiers directement.