
TL;DR
Databricks Unity Catalogは、ワークスペースの上位に位置するガバナンスレイヤーです。クラウドリージョンごとに1つのメタストア、3階層の名前空間、そしてそのメタストアが接続されたすべての場所に適用される1つの権限セットで構成されます。うまく機能するかどうかを左右するのは機能一覧ではなく、カタログとスキーマをどう構成するかです。その答えは組織ごとに異なり、成長とともに変化していきます。
はじめに
Databricks Unity Catalogの解説の多くは、定義の説明で終わってしまいます。統合ガバナンスレイヤーであること、名前空間が2階層ではなく3階層であること、リネージが標準で付いてくること——どれも事実ですが、20秒後に浮かぶ疑問には何も答えてくれません。カタログは何を表すべきなのか? ブロンズ・シルバー・ゴールドは別々のスキーマに置くべきなのか? そして、これらは請求額にどう影響するのか? 本記事ではUnity Catalogとは何か、どう動作するかを押さえたうえで、誰も書かない部分——どう構成するか、そしてその判断が思いもよらないコストにつながる理由——に多くの紙面を割きます。
Databricks Unity Catalogとは何か、なぜ重要なのか
Unity Catalogが解決するために生まれたガバナンスの空白
Unity Catalog以前、メタストアはワークスペースの中にありました。名前空間は2階層(schema.table)しかなく、環境や所有者を表現する場所は名前そのもの以外にありませんでした。グループはワークスペースローカルだったため、ユーザーのアクセス権は触れるワークスペースごとに作り直す必要がありました。アクセス制御はデータオブジェクトではなくコンピュートに紐づいていたため、同じテーブルでも開くクラスターによって読めたり読めなかったりしました。リネージや監査は存在しませんでした。
Unity Catalogはメタストアをアカウントレベルに移し、クラウドリージョン単位のスコープにしました。1つのメタストアが多数のワークスペースに接続され、1か所で付与した権限はすべてのワークスペースで有効になり、権限はデータを読み取るコンピュートではなくデータオブジェクト側に保持されます。
3階層の名前空間に実際に格納されるもの
catalog.schema.tableの第3階層に格納されるのはテーブルだけではありません。ビュー(マテリアライズドビューやメトリックビューを含む)、ボリューム、そして関数——UDF、ストアドプロシージャ、MLflowモデルを含みます——も対象です。さらに、ストレージ認証情報、外部ロケーション、接続、共有、クリーンルームといったセキュリティ保護可能なオブジェクトがメタストア直下に存在します。
ボリュームには改めて注目する価値があります。クラウドストレージ上のファイルにも同じ権限モデルを拡張するからです。READ VOLUMEはテーブルに対するSELECTと同様に振る舞い、読み取るコンピュートではなくオブジェクトに紐づきます。これこそ、マウントには決してできなかったことです。
Unity Catalogがもはや「選択肢」ではない理由
重要なのは「引力」の方です。サーバーレスコンピュート、Lakeflow、Genie、モデルサービング、ベクトル検索、LakebaseはすべてUnity Catalogを必要とします。システムテーブルも同様です。Hiveメタストアに留まることは、単にガバナンスが劣るだけでなく、Databricksがこの3年間にリリースしてきた機能の大半から締め出されることを意味します。「押し出す力」は比較的小さく、2026年9月30日以降、Databricksは新規ワークスペースをHiveメタストアなしでプロビジョニングしますが、既存のワークスペースには影響しません。
カタログとスキーマをどう構成すべきか
ここから先、ドキュメントは沈黙します。Databricksはカタログを「一般的に」組織単位やライフサイクルのスコープで構成すると述べるだけで、そこから先は示してくれません。推奨に入る前に、3つの前提を述べておきます。
正解は組織ごとに異なります。 5人のプラットフォームチームと、各事業部門にエンジニアを抱える分権型の組織の両方に通用するレイアウトは存在しません。だからこそ、このテーマについて書く人がほとんどいないのです。
正解は変化します。 最初の実装が無限の成長に耐えると信じるのは理想論にすぎません。目指すべきは変化しない構造ではなく、変更コストが低い構造です。
チームの規模と成熟度が出発点を決めます。 6人の中央集権型チームには、60人の分散型組織が必要とするものは不要であり、早すぎる導入は得られるものより失うものの方が大きくなります。
以下は、金融・航空宇宙・エネルギーのクライアントを通じて私が繰り返し行き着いている構成です。結論ではなく理由付けに対して反論できるよう、理由も添えています。
継承の仕組みと、それが他のすべての判断を左右する理由
レイアウト全体を形づくるのは2つのルールです。
ストレージロケーションはメタストアでデフォルトが設定され、カタログおよびスキーマレベルで上書きできます。すべてのオブジェクトは最も近い親から継承します。
**権限(grant)**はカタログとスキーマから下方向に継承されます。カタログに対するSELECT権限は、その中の現在および将来のすべてのテーブル、ビュー、ボリュームに及びます。権限モデルにDENYは存在しないため、継承された権限を単一の子オブジェクトだけ取り消すことはできません。ABACポリシーと行フィルターはDENYに似た働きを提供し、実際に有用ですが、grantほど明示的でも堅牢でもありません。grantが「可」と言う一方で、ポリシーがどこか別の場所でひっそりと「不可」と言っており、grantを読んだ人にはそれが見えないのです。レイアウトの不備を繕うパッチとしてではなく、意図を持って使うべきものです。
この帰結こそが、本記事の主張の核心です。権限を付与したいレベルこそ、レイアウトが意味を持たせるべきレベルです。 スキーマが「同じデータを見るべき人々のグループ」に対応していなければ、結局テーブル単位で権限を付与する羽目になります。
カタログは原則として環境単位で
中央集権型のデータチームなら、カタログをデプロイ環境に合わせましょう。
- ストレージロケーション。 環境ごとのストレージ分離は一般的なプラクティスであり、規制要件であることも少なくありません。カタログで一度設定すれば、すべてのテーブルがそれを継承します。
- CI/CD。 環境を最上位に置けば、昇格は書き換えではなく変数の置換で済みます。
- ワークスペースとの整合。 ほとんどのチームはすでにワークスペースを環境に合わせており、ワークスペースとカタログのバインディングでそれを強制できます。
- リネージ。 カタログレベルに他の要素を置くと、カタログをまたぐリネージグラフが生まれ、読み解きにくくなります。
ただし、チームトポロジーには注意が必要です。各事業部門が自前のデータエンジニアを抱え、それぞれがパイプラインを構築しているなら、事業部門ごとに1カタログの方が適しています。カタログの境界が所有権の境界に一致するからです。「環境ごとに1カタログ」という推奨は中央集権型チームには当てはまりますが、データの作り手が増えた瞬間に成り立たなくなります。
この移行を乗り切るための工夫が2つあります。最初からプレフィックスを付けること。 最初のカタログをprdと名付けてはいけません。プラットフォームチームにちなんでedp_prdとするか、analytics_prdのような汎用名にしましょう。初日のコストはゼロですが、後からfinance_prdやhr_prdが登場したとき、裸の環境カタログの横に事業部門カタログ群が並ぶのではなく、モデルの一貫性が保たれます。組織再編を生き延びる名前を選ぶこと。 18か月ごとに改称される部門名を冠したカタログは、実行されないリネームとなり、名前空間の中の嘘になります。
スキーマはデータプロデューサーとデータプロダクト単位で
最も議論が分かれる部分です。私のデフォルトはハイブリッド型です。ブロンズとシルバーのテーブルはデータプロデューサー名のスキーマに、ゴールドのテーブルは事業部門またはデータプロダクト名のスキーマに置きます。
直感的には、ひとつのフロー全体を1つのスキーマに収めたくなります。シンプルなケースでは機能しますが、大半のケースでは破綻します。
- 所有権の分離。 多くのチームでは作業が分担されています。コアグループがエンジニアリングの規律をもってブロンズとシルバーを構築し、アナリストやドメインエキスパートがゴールドの集計を構築します。スキーマの境界が所有権の境界に一致します。
- アクセス制御。 ソースシステムを運用する人々は、一般にそのシステムが生成するデータを見られるべきです。ビジネスユーザーは自部門が集計したデータを見られるべきです。この構成なら、どちらもスキーマレベルの権限付与で済みます。フローベースのレイアウトでは、どちらも実現できません。
- データ品質。 ビジネス向けのデータセットはすべて、生データではなくクレンジング済みのプロデューサーデータから構築されます。
2つの役割を名前で明示しましょう。プロデューサーはsource_<source_name>、事業部門やプロダクトはbu_<bu_name>です。source_hrとbu_hrの両方が存在する場合もありますが、それで問題ありません。生のHRフィードと、その上に構築されたHR所有のゴールドテーブルを分離できるため、むしろ望ましい形であることが多いのです。
第3の選択肢も知っておく価値があります。メダリオンレイヤーごとに異なるアクセスレベルが本当に必要な組織なら、レイヤーをスキーマに昇格させます。brz_sap、slv_sap、gld_financeという形です。アナリストにブロンズを付与せずにシルバーだけを付与できる唯一の構造であり、ブロンズに生のPIIが含まれる場合に選ぶべき形です。ただし大半の組織にとっては問題に対して過剰な構造であり、ブロンズとシルバーをまとめたままABACでカラムレベルの保護をかける方が良いトレードオフです。
メダリオンレイヤーはテーブル名のプレフィックスに
レイヤーをスキーマに昇格させていない限り、レイヤーはテーブル名に置きます。brz_*、slv_*、gld_*です。この時点でストレージロケーションはカタログに、アクセス制御はスキーマに設定済みなので、新しいテーブルにはどちらも不要です。テーブルレベルで何かを設定する理由は、行レベルセキュリティとカラムマスキングだけです。
3つの出発点と、2つの実在するレイアウト
最初の3行は典型パターンです。残りの2行は私が実際に関わった構造で、同じ表に並べることで、それぞれがどの典型パターンの変形なのかが分かるようにしています。
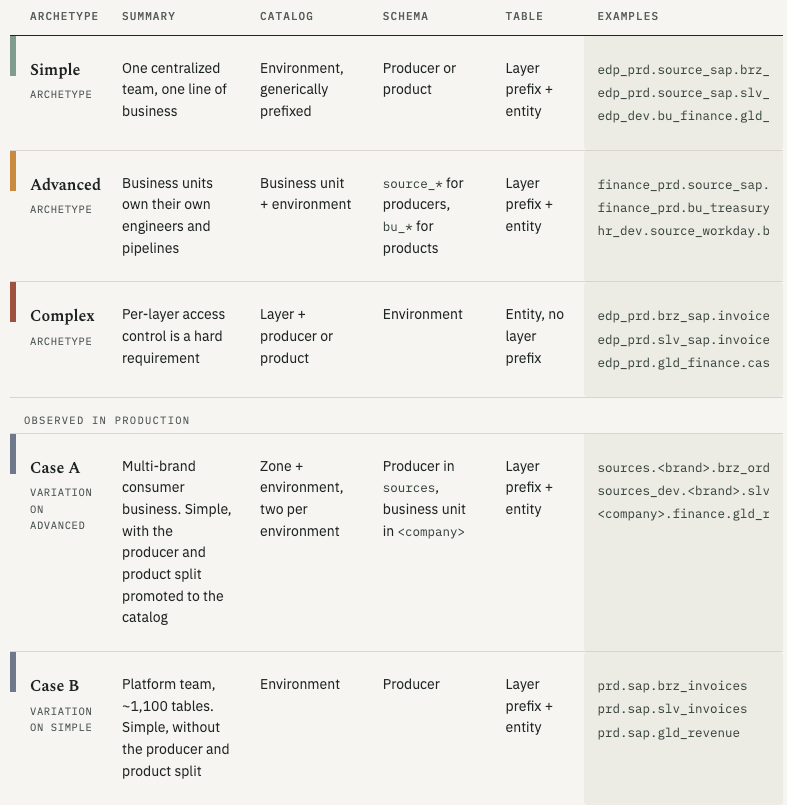
2つの実在レイアウトがチームに課したコスト
ケースA。 議論に値するのは、_prdが欠けている点です。これを省くと、全員が日常的に使うカタログが最も短く入力できるようになります。毎日そこを行き来する人々への、まぎれもない配慮です。しかし同時に、_がテンプレートとして機能しなくなります。本番環境があらゆるデプロイで特例となり、その分岐を誰かが永遠にメンテナンスし続けることになります。ユーザーには親切、エンジニアには頭痛の種で、私なら選ばないトレードオフです。
ケースB。 例の3行目を見てください。ブロンズ、シルバー、ゴールドが1つのスキーマに同居しています。ゴールドの置き場所を強制する仕組みがなかったため、一部のスキーマには3層すべてが入っています。見た目だけの問題に聞こえますが、違います。ゴールドだけを見るべきアナリストに、スキーマレベルで権限を付与できないのです。同じスキーマにブロンズも含まれているからです。欲しい権限付与が存在しないため、テーブル単位で延々と構築し続けることになります。
さらにこのレイアウトでは、想定コンシューマーをテーブル名に埋め込んでいます。[]という形式で、現在27のターゲットにまたがる181オブジェクトに及びます。テーブルの移行元であるレガシーシステムに由来するもので、当時としては正しい判断でした。しかし形としては今も間違っています。この角括弧は何の権限も付与せず、何も強制しません。プラットフォームが実行できない「意図」を記録しているだけです。代替案は現在も議論中です。最も有望なのは、テーブルにタグを付け、スケジュールジョブがそれを読み取って権限を発行する方式で、これなら命名規則が実際にアクセスを変えるものになります。
Unity Catalogのコストが実際にどこへ流れているか、確かめてみませんか?
billing_origin_productを手作業でグルーピングすれば、先月、予測最適化に何らかの費用がかかったことは分かります。しかし、どのテーブルか、どのユーザーか、3年前のどの構造上の判断が原因なのかまでは分かりません。SELECTは、他では1行にまとめられてしまう明細も含め、環境全体にわたるクエリレベルのコスト帰属をデータプラットフォームチームに提供します。あなたのワークスペースで何が見えるかをご確認ください。
Databricks Unity Catalogの実際のコストは?
ガバナンスレイヤー自体は無料
Unity Catalogに個別の課金はありません。カタログ、スキーマ、権限付与、リネージ、監査ログ、システムテーブルには、契約中のプラン以外の費用は一切かからず、Databricksは2024年6月にこのプロジェクトをLinux Foundation傘下でオープンソース化しました。
システムテーブルには注記が必要です。これらはUnity Catalogメタストアの中にしか存在せず、Unity Catalog対応のワークスペースからしかクエリできません——非UCワークスペースについてもレポートされるにもかかわらず、です。弊社のDatabricksコスト最適化ebookに掲載したすべてのコストクエリも、Databricks Pricing Explainedで紹介したすべてのコントロールも、システムテーブルを経由します。つまりUnity Catalogは、Databricksのコストを管理するための、そもそもの前提条件なのです。
費用が発生するのはUnity Catalogが可能にする機能の側であり、これらの請求は見落としやすいものです。自分で起動した覚えのあるものには見えないからです。system.billing.usageのbilling_origin_product列がそれらを分離してくれます。この列でグルーピングすると、見覚えのあるコンピュートの隣に、PREDICTIVE_OPTIMIZATIONやVECTOR_SEARCHといった行が現れます。品質モニタリングはLAKEHOUSE_MONITORINGとDATA_QUALITY_MONITORINGの2つの名前で二重に登場します。これらの名称が、皆さんの知る製品名ではなくDatabricksの内部構造を反映していることへの、分かりやすい警告と言えるでしょう。
マネージドテーブルと予測最適化
予測最適化(Predictive Optimization)は、多くの人が気づかないうちに出会う代表格です。マネージドテーブルに対してコンパクション、クリーンアップ、クラスタリング、統計収集を代行し、その分が課金されます。
通常は割に合う選択です。これらの処理を怠ると、ストレージの肥大化、データスキッピングの劣化、クエリの低速化を招き、結局はコンピュート費用として——明細に載ることなく、すべてのクエリに薄く広がる形で——支払うことになるからです。2024年11月以降に作成されたアカウントではデフォルトで有効になっており、既存アカウントへの展開は2026年8月頃と見込まれています。アカウントのデフォルトをそのまま全面的に受け入れるのではなく、カタログまたはスキーマレベルでスコープを定めましょう。
レイアウトがコスト上の意思決定である理由
不適切なレイアウトのコストの大半は、請求書には一切現れません。それは、個々のテーブルの権限を保守し続ける担当者であり、モデルが誰かの頭の中にしか存在しないために自動化できない四半期レビューです。この作業は名前空間とアクセスパターンの乖離に比例して膨らみ、終わることがありません。きめ細かなアクセス制御もどこかで実行する必要があるため、行フィルターやカラムマスクを伴うすべてのクエリには、本来なら不要なコンピュート費用が上乗せされます。スキーマレベルで権限を付与できるレイアウトとは、この2つのコストがどちらも存在しないレイアウトのことです。
では、どこから始めるべきか
今日のチームに合った最もシンプルなレイアウトを選び、次のカタログが収まるようにプレフィックスを付け、いずれ再構築することを受け入れましょう。ただし、判断の先送りだけはできません。デフォルトは「無構造」ではなく、目を離している間に積もっていく何か——個別の権限付与、場当たり的なビュー、単体では妥当に見えた命名規則——だからです。先手を打ち続けるチームは、構造がまだ変えられるうちに、それがどれだけのコストを生んでいるかを把握し続けています。私たちがSELECT for Databricksを作ったのはそのためです。あなたの環境で何が見つかるか、デモを予約してご確認ください。
FAQ
Unity Catalogに追加費用はかかりますか?
いいえ。Unity CatalogはDatabricksのPremiumプラン以上に含まれており、メタストア、カタログ、スキーマ、権限付与、リネージ、監査ログ、システムテーブルに課金はありません。費用が発生するのはUnity Catalogが可能にする機能の側です。予測最適化、品質モニター、ベクトル検索、きめ細かなアクセス制御はいずれも課金対象であり、system.billing.usageをbilling_origin_productでグルーピングしない限り見落としがちです。しかもそこでは、皆さんが知る製品名とは一致しない名称で表示されます。
ブロンズ、シルバー、ゴールドのテーブルは別々のスキーマに置くべきですか?
ブロンズとシルバーの間で異なるアクセスレベルが必要な場合に限ります。メダリオンレイヤーをテーブル名(brz_、slv_)に置き、スキーマをプロデューサーとプロダクトに使うのがより良いデフォルトです。権限付与が所有権と揃うからです。このレイアウトではゴールドはすでに分離されています。プロデューサーの生テーブルやクレンジング済みテーブルの横ではなく、事業部門またはプロダクトのスキーマに置かれるためです。
後になって気づきがちなのは、プロデューサースキーマにSELECT権限を持つ人には、ブロンズもシルバーとまったく同じように見えてしまうという点です。特定のユーザーに触れさせてはならない生のPIIがブロンズに含まれる場合、それは後から変更できる権限設定ではなく、構造の作り直しになります。その場合は、最初からレイヤーをスキーマに昇格させてください(brz_sap、slv_sap、gld_finance)。
Unity Catalogにおけるマネージドテーブルと外部テーブルの違いは何ですか?
マネージドテーブルでは、ストレージパスをUnity Catalogが決定します。データは引き続き自社のクラウドアカウント内にありますが、レイアウトとライフサイクルはDatabricksが管理するため、テーブルを削除するとファイルも削除され、予測最適化が自動でメンテナンスできます。外部テーブルではパスを自分で指定します。Unity Catalogがメタデータとアクセスを統制する一方、ライフサイクルと最適化は自分の責任のままで、テーブルを削除してもファイルは残ります。デフォルトはマネージドであり、外部システムがファイルを直接読む必要がない限り、マネージドがより良い選択です。